आज, उच्च-प्रदर्शन करने वाले बीमा संगठन प्रतिस्पर्धी माहौल में अपने व्यवसायों को आगे बढ़ाने के लिए डेटा साइंस का उपयोग कर रहे हैं। एक हालिया वेबिनार में, Allianz Benelux के रीजनल चीफ डेटा एंड एनालिटिक्स ऑफिसर सुडमन थोप्पन मोहनचंद्रलाल ने बीमा में डेटा साइंस की वर्तमान स्थिति और उद्योग में मशीन लर्निंग के रोचक उपयोग मामलों पर चर्चा की।
आज बीमा उद्योग में डेटा साइंस क्यों मूल्यवान है
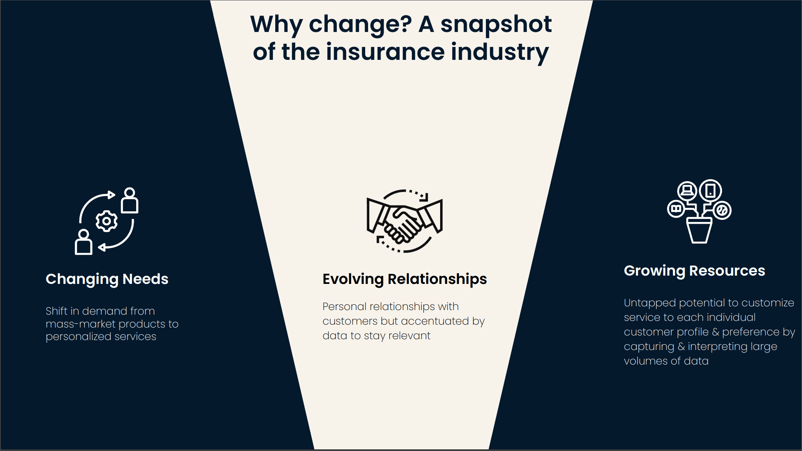
हाल के दिनों में, उद्योग की मांग जन-बाज़ार को लुभाने वाली सेवाओं से हटकर अधिक वैयक्तिकृत सेवाओं की ओर मुड़ गई है। McKinsey की यह रिपोर्ट उसी परिवर्तन का वर्णन करती है जिसका सुडमन उल्लेख करते हैं। यह बताती है कि रणनीतिक वैयक्तिकृत मार्केटिंग और सेवा प्रसाद के माध्यम से बड़े पैमाने पर उपभोक्ताओं के साथ गहरे एक-से-एक संबंध कैसे बनाए जा सकते हैं।
ज़रूरतों और संबंधों में यह बदलाव व्यक्तिगत ग्राहकों के लिए उपलब्ध डेटा में भारी वृद्धि और मशीन लर्निंग व संसाधनों में प्रगति के कारण संभव हुआ है। इस लेख में, IBM बताता है कि वैयक्तिकृत सेवाएँ बनाने पर बीमाकर्ता लाभप्रदता तक पहुँचने के समय में 22–25% सुधार देखते हैं, जब उनकी तुलना जन-बाज़ार अपील वाले उत्पादों से की जाती है। ये उत्पाद केवल मशीन लर्निंग का उपयोग कर बड़े पैमाने पर विकसित किए जा सकते हैं।
बीमा में डेटा साइंस की स्थिति
वेबिनार में सुडमन समझाते हैं कि मशीन लर्निंग तब मूल्य देती है जब इसे कारण-निष्कर्ष के बजाय पूर्वानुमान के लिए इस्तेमाल किया जाता है और जब समस्या पर्याप्त रूप से स्व-निहित हो। आज की तारीख में, जब संगठन इन एल्गोरिद्मों को एक क्रिस्टल बॉल या ब्लैक बॉक्स की तरह इस्तेमाल करने की कोशिश करते हैं, न कि मनुष्यों को खोज की दिशा सुझाने वाले एक औज़ार की तरह, तो मशीन लर्निंग विफल रहती है। वेबिनार में शामिल कुछ उपयोग मामलों की एक झलक यहाँ दी गई है:
1. बीमा दावों में धोखाधड़ी का पता लगाना
बहुत अधिक डेटा के साथ पूर्वानुमान कार्यों पर मशीन लर्निंग बहुत अच्छा प्रदर्शन करती है। इसलिए, धोखाधड़ी का पता लगाना लॉजिस्टिक रिग्रेशन या डिसीजन ट्री जैसे वर्गीकरण एल्गोरिद्म को प्रशिक्षित और परिनियोजित करने का एक उत्कृष्ट उपयोग मामला है। इस प्रणाली का उपयोग संदिग्ध दिखने वाले दावों को फ़्लैग करने के लिए किया जा सकता है। इससे किसी विश्लेषक के लिए धोखाधड़ी की रोकथाम को काफी अधिक सुगम बनाया जा सकता है, क्योंकि यह उनके वर्कफ़्लो को ऐसे दावों को सामने लाकर सशक्त करेगा जो सबसे अधिक धोखाधड़ीपूर्ण होने की संभावना रखते हैं।
2. रिटेंशन गतिविधियों के लिए ग्राहकों की पहचान
किसी भी संगठन के विस्तार के लिए एक और महत्वपूर्ण उपयोग मामला है ग्राहक रिटेंशन में सुधार। मशीन लर्निंग यह पहचानने में मदद कर सकती है कि कौन से ग्राहक आपके संगठन को छोड़ने के जोखिम में हैं। इन ग्राहकों की बड़े पैमाने पर पहचान करना और उन्हें बने रहने के लिए प्रोत्साहन देना, दीर्घकाल में बेहतर ग्राहक आजीवन मूल्य की ओर ले जाएगा—और गहरी वैयक्तिकरण को सक्षम करेगा।
3. टाइम सीरीज़ डेटा के साथ मूल्य निर्धारण का अनुकूलन (रिस्क प्रीमियम मॉडलिंग)
किसी ग्राहक द्वारा दावा दाखिल करने के जोखिम को समझना, उन्हें दिए जाने वाले प्लान के सही मूल्य और संरचना को निर्धारित करने में महत्वपूर्ण है। सभी बीमाकर्ता किसी न किसी स्तर पर यह करते हैं। उपलब्ध डेटा के विस्तार के साथ, किसी ग्राहक की जोखिम प्रोफ़ाइल निर्धारित करने में मॉडल की सटीकता में सुधार किया जा सकता है, ताकि व्यक्तियों को अधिक प्रतिस्पर्धी मूल्य निर्धारण की पेशकश की जा सके।
4. भविष्य की बीमारियों का पूर्वानुमान
पिछले उपयोग मामले के समान, भविष्य की बीमारी के जोखिमों को समझना पोर्टफोलियो अनुकूलन और मूल्य निर्धारण में महत्वपूर्ण है। यह चर्चा होती है कि बीमा उद्योग को COVID-संबंधित दावों में 100 बिलियन डॉलर से अधिक का भुगतान करना पड़ेगा। यद्यपि महामारी का पहले से पूर्वानुमान लगाना चुनौतीपूर्ण होता, स्वास्थ्य परिणामों को समझना और उनका पूर्वानुमान लगाना बीमाकर्ताओं को अपनी सेवाओं को प्राथमिकता देने और वैयक्तिकृत करने में सक्षम करेगा।
5. पोर्टफोलियो अनुकूलन
अंतिम उपयोग मामला है पोर्टफोलियो अनुकूलन। पोर्टफोलियो प्रबंधन में कुछ चरण शामिल होते हैं: विश्लेषण के लिए जोखिम के सार्थक समूहों की पहचान करना, सर्वोत्तम निर्णयों की जानकारी देना, और अवसरों की पहचान करना। इन प्रत्येक उप-कार्यों को डेटा साइंस के अनुकूलन तकनीकों के माध्यम से हल किया जा सकता है।
यदि आप बीमा में डेटा साइंस के भविष्य के बारे में अधिक जानना चाहते हैं, तो अवश्य यहाँ वेबिनार देखें।

आज, उच्च-प्रदर्शन करने वाले बीमा संगठन प्रतिस्पर्धी माहौल में अपने व्यवसायों को आगे बढ़ाने के लिए डेटा साइंस का उपयोग कर रहे हैं। एक हालिया वेबिनार में, Allianz Benelux के रीजनल चीफ डेटा एंड एनालिटिक्स ऑफिसर सुडमन थोप्पन मोहनचंद्रलाल ने बीमा में डेटा साइंस की वर्तमान स्थिति और उद्योग में मशीन लर्निंग के रोचक उपयोग मामलों पर चर्चा की।
आज बीमा उद्योग में डेटा साइंस क्यों मूल्यवान है
हाल के दिनों में, उद्योग की मांग जन-बाज़ार को लुभाने वाली सेवाओं से हटकर अधिक वैयक्तिकृत सेवाओं की ओर मुड़ गई है। McKinsey की यह रिपोर्ट उसी परिवर्तन का वर्णन करती है जिसका सुडमन उल्लेख करते हैं। यह बताती है कि रणनीतिक वैयक्तिकृत मार्केटिंग और सेवा प्रसाद के माध्यम से बड़े पैमाने पर उपभोक्ताओं के साथ गहरे एक-से-एक संबंध कैसे बनाए जा सकते हैं।
ज़रूरतों और संबंधों में यह बदलाव व्यक्तिगत ग्राहकों के लिए उपलब्ध डेटा में भारी वृद्धि और मशीन लर्निंग व संसाधनों में प्रगति के कारण संभव हुआ है। इस लेख में, IBM बताता है कि वैयक्तिकृत सेवाएँ बनाने पर बीमाकर्ता लाभप्रदता तक पहुँचने के समय में 22–25% सुधार देखते हैं, जब उनकी तुलना जन-बाज़ार अपील वाले उत्पादों से की जाती है। ये उत्पाद केवल मशीन लर्निंग का उपयोग कर बड़े पैमाने पर विकसित किए जा सकते हैं।
बीमा में डेटा साइंस की स्थिति
वेबिनार में सुडमन समझाते हैं कि मशीन लर्निंग तब मूल्य देती है जब इसे कारण-निष्कर्ष के बजाय पूर्वानुमान के लिए इस्तेमाल किया जाता है और जब समस्या पर्याप्त रूप से स्व-निहित हो। आज की तारीख में, जब संगठन इन एल्गोरिद्मों को एक क्रिस्टल बॉल या ब्लैक बॉक्स की तरह इस्तेमाल करने की कोशिश करते हैं, न कि मनुष्यों को खोज की दिशा सुझाने वाले एक औज़ार की तरह, तो मशीन लर्निंग विफल रहती है। वेबिनार में शामिल कुछ उपयोग मामलों की एक झलक यहाँ दी गई है:
1. बीमा दावों में धोखाधड़ी का पता लगाना
बहुत अधिक डेटा के साथ पूर्वानुमान कार्यों पर मशीन लर्निंग बहुत अच्छा प्रदर्शन करती है। इसलिए, धोखाधड़ी का पता लगाना लॉजिस्टिक रिग्रेशन या डिसीजन ट्री जैसे वर्गीकरण एल्गोरिद्म को प्रशिक्षित और परिनियोजित करने का एक उत्कृष्ट उपयोग मामला है। इस प्रणाली का उपयोग संदिग्ध दिखने वाले दावों को फ़्लैग करने के लिए किया जा सकता है। इससे किसी विश्लेषक के लिए धोखाधड़ी की रोकथाम को काफी अधिक सुगम बनाया जा सकता है, क्योंकि यह उनके वर्कफ़्लो को ऐसे दावों को सामने लाकर सशक्त करेगा जो सबसे अधिक धोखाधड़ीपूर्ण होने की संभावना रखते हैं।
2. रिटेंशन गतिविधियों के लिए ग्राहकों की पहचान
किसी भी संगठन के विस्तार के लिए एक और महत्वपूर्ण उपयोग मामला है ग्राहक रिटेंशन में सुधार। मशीन लर्निंग यह पहचानने में मदद कर सकती है कि कौन से ग्राहक आपके संगठन को छोड़ने के जोखिम में हैं। इन ग्राहकों की बड़े पैमाने पर पहचान करना और उन्हें बने रहने के लिए प्रोत्साहन देना, दीर्घकाल में बेहतर ग्राहक आजीवन मूल्य की ओर ले जाएगा—और गहरी वैयक्तिकरण को सक्षम करेगा।
3. टाइम सीरीज़ डेटा के साथ मूल्य निर्धारण का अनुकूलन (रिस्क प्रीमियम मॉडलिंग)
किसी ग्राहक द्वारा दावा दाखिल करने के जोखिम को समझना, उन्हें दिए जाने वाले प्लान के सही मूल्य और संरचना को निर्धारित करने में महत्वपूर्ण है। सभी बीमाकर्ता किसी न किसी स्तर पर यह करते हैं। उपलब्ध डेटा के विस्तार के साथ, किसी ग्राहक की जोखिम प्रोफ़ाइल निर्धारित करने में मॉडल की सटीकता में सुधार किया जा सकता है, ताकि व्यक्तियों को अधिक प्रतिस्पर्धी मूल्य निर्धारण की पेशकश की जा सके।
4. भविष्य की बीमारियों का पूर्वानुमान
पिछले उपयोग मामले के समान, भविष्य की बीमारी के जोखिमों को समझना पोर्टफोलियो अनुकूलन और मूल्य निर्धारण में महत्वपूर्ण है। यह चर्चा होती है कि बीमा उद्योग को COVID-संबंधित दावों में 100 बिलियन डॉलर से अधिक का भुगतान करना पड़ेगा। यद्यपि महामारी का पहले से पूर्वानुमान लगाना चुनौतीपूर्ण होता, स्वास्थ्य परिणामों को समझना और उनका पूर्वानुमान लगाना बीमाकर्ताओं को अपनी सेवाओं को प्राथमिकता देने और वैयक्तिकृत करने में सक्षम करेगा।
5. पोर्टफोलियो अनुकूलन
अंतिम उपयोग मामला है पोर्टफोलियो अनुकूलन। पोर्टफोलियो प्रबंधन में कुछ चरण शामिल होते हैं: विश्लेषण के लिए जोखिम के सार्थक समूहों की पहचान करना, सर्वोत्तम निर्णयों की जानकारी देना, और अवसरों की पहचान करना। इन प्रत्येक उप-कार्यों को डेटा साइंस के अनुकूलन तकनीकों के माध्यम से हल किया जा सकता है।
यदि आप बीमा में डेटा साइंस के भविष्य के बारे में अधिक जानना चाहते हैं, तो अवश्य यहाँ वेबिनार देखें।