Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Melatih jaringan saraf dalam (deep neural networks) bisa menantang karena gradien yang menghilang atau meledak serta pergeseran kovariat internal (internal covariate shift). Faktor-faktor ini dapat memperlambat proses pelatihan secara signifikan dan menghambat kemampuan jaringan untuk belajar secara efektif. Untungnya, kita dapat mengatasi masalah ini dengan teknik normalisasi.
Meskipun ada banyak teknik normalisasi, batch normalization adalah salah satu yang paling populer dan telah menjadi komponen standar dalam banyak arsitektur deep learning. Teknik ini berkontribusi pada konvergensi yang lebih cepat, stabilitas pelatihan yang lebih baik, dan performa generalisasi yang meningkat.
Dalam tutorial ini, kami akan menjelaskan batch normalization, cara kerjanya secara matematis, dan cara mengimplementasikannya menggunakan TensorFlow dan Keras.
Jika Anda ingin mempelajari dasar-dasar jaringan saraf menggunakan Keras, lihat kursus Introduction to Deep Learning in Python ini.
Normalisasi adalah langkah prapemrosesan penting dalam machine learning yang bertujuan menstandarkan data masukan.
Berbagai teknik normalisasi, seperti penskalaan min-maks, normalisasi z-score, dan transformasi log, umum digunakan untuk mengubah skala fitur ke rentang atau distribusi yang konsisten. Teknik-teknik ini membantu mengurangi dampak pencilan, meningkatkan konvergensi, dan memastikan perbandingan yang adil antarfitur.
Menormalisasi data masukan sangat penting untuk pelatihan model yang efektif karena memastikan semua fitur berkontribusi secara setara dalam proses pembelajaran. Tanpa normalisasi, fitur dengan skala atau varians yang lebih besar dapat mendominasi proses optimisasi, sehingga menghasilkan performa model yang kurang optimal.
Normalisasi memungkinkan model mempelajari pola dan hubungan yang bermakna dari data dengan membawa semua fitur ke skala yang serupa.
Jika Anda ingin mempelajari tentang normalisasi secara umum, lihat tutorial ini: What is Normalization in Machine Learning.
Melatih jaringan saraf dalam menghadirkan beberapa tantangan yang dapat menghambat konvergensi dan generalisasi:
Batch normalization mengatasi tantangan-tantangan ini dengan menormalisasi aktivasi dalam setiap mini-batch, membantu menstabilkan proses pelatihan dan meningkatkan performa model.
Batch normalization adalah teknik yang menormalisasi aktivasi suatu lapisan dalam mini-batch selama pelatihan jaringan saraf dalam.
Teknik ini bekerja dengan menghitung rata-rata dan varians aktivasi untuk setiap fitur dalam mini-batch dan kemudian menormalisasi aktivasi menggunakan statistik tersebut.
Aktivasi yang telah dinormalisasi kemudian diskalakan dan digeser menggunakan parameter yang dapat dipelajari, sehingga model dapat beradaptasi dengan distribusi aktivasi yang optimal.
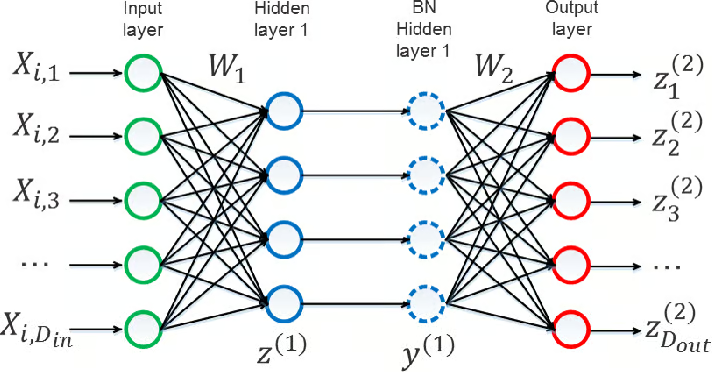
Sumber: Yintai Ma dan Diego Klabjan.
Batch Normalization biasanya diterapkan setelah transformasi linear suatu lapisan (misalnya setelah perkalian matriks pada fully connected layer atau setelah operasi konvolusi pada convolutional layer) dan sebelum fungsi aktivasi non-linear (misalnya ReLU).
Komponen kunci batch normalization adalah:
Salah satu tantangan saat melatih jaringan saraf dalam adalah pergeseran kovariat internal. Ini terjadi ketika distribusi aktivasi (keluaran) dari satu lapisan berubah sepanjang proses pelatihan seiring pembaruan bobot pada lapisan sebelumnya. Pergeseran ini dapat membuat pelatihan sulit dan lambat.
Batch normalization mengurangi pergeseran ini dengan menormalisasi aktivasi dalam setiap mini-batch, sehingga masukan ke lapisan berikutnya menjadi lebih stabil dan konsisten.
Menormalisasi aktivasi memungkinkan konvergensi lebih cepat dengan laju pembelajaran yang lebih tinggi dan membuat model kurang sensitif terhadap pilihan inisialisasi.
Selain itu, teknik ini memperkenalkan efek regularisasi yang membantu mencegah overfitting dengan mengurangi ketergantungan model pada pola aktivasi tertentu.
Kombinasi manfaat ini menjadikan batch normalization alat yang ampuh untuk melatih model deep learning yang lebih andal. Untuk mempelajari lebih lanjut tentang membangun model yang tangguh, lihat kursus Machine Learning Monitoring Concepts ini.
Sekarang kita memahami “mengapa” di balik batch normalization, mari kita dalami “bagaimana”-nya.
Batch normalization beroperasi berbeda pada tahap pelatihan dan inferensi, jadi mari kita jelaskan matematika di balik tiap tahap.
Mari mulai dengan langkah normalisasi. Kita terlebih dahulu menghitung rata-rata dan varians untuk setiap fitur dalam mini-batch. Berikut rumus yang dapat kita gunakan untuk rata-rata dan varians.


Kita kemudian menggunakan rata-rata dan varians tersebut untuk menormalisasi aktivasi. Ini adalah rumus yang dapat kita gunakan, di mana ε (epsilon huruf kecil) adalah konstanta kecil yang ditambahkan untuk stabilitas numerik:

Setelah selesai dengan langkah normalisasi, kita lanjut ke langkah penskalaan dan penggeseran. Menggunakan parameter yang dapat dipelajari γ dan β, kita menggeser aktivasi yang dinormalisasi menggunakan rumus ini:

Parameter-parameter ini memungkinkan model mempelajari distribusi aktivasi yang optimal.
Saat inferensi, kita mengganti statistik batch (rata-rata dan varians) dengan statistik berjalan (running) yang dihitung selama pelatihan. Statistik berjalan biasanya diperbarui menggunakan rata-rata bergerak dengan faktor momentum.
Untuk menghitung rata-rata dan varians berjalan, kita dapat menggunakan dua rumus ini, di mana α adalah faktor momentum yang mengendalikan laju pembaruan statistik berjalan:


Rata-rata dan varians berjalan disimpan sebagai parameter model dan digunakan untuk normalisasi saat inferensi. Parameter penskalaan dan penggeseran (γ dan β) yang dipelajari selama pelatihan juga digunakan saat inferensi.
Selanjutnya, mari pelajari cara mengimplementasikan batch normalization menggunakan TensorFlow.
Mari mulai dengan mengimpor pustaka yang diperlukan:
import tensorflow as tf
from tensorflow import keras
Selanjutnya, mari memuat dataset MNIST, yang terdiri dari 60.000 gambar pelatihan dan 10.000 gambar uji dari digit tulisan tangan. Kita memuat dataset menggunakan fungsi keras.datasets.mnist.load_data() dan membaginya menjadi data pelatihan (x_train, y_train) dan data uji (x_test, y_test):
# Load the MNIST dataset
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
Untuk melakukan prapemrosesan data, kita melakukan langkah-langkah berikut:
(num_samples, 28, 28, 1), di mana num_samples adalah jumlah gambar, dan setiap gambar adalah citra skala abu-abu 28x28 dengan satu kanal.keras.utils.to_categorical(), yang mengonversi label bilangan bulat menjadi vektor one-hot.# Preprocess the data
x_train = x_train.reshape((60000, 28, 28, 1)) / 255.0 # Reshape and normalize training images
x_test = x_test.reshape((10000, 28, 28, 1)) / 255.0 # Reshape and normalize test images
y_train = keras.utils.to_categorical(y_train) # Convert training labels to categorical format
y_test = keras.utils.to_categorical(y_test) # Convert test labels to categorical formatSekarang, kita beralih ke langkah berikutnya: mendefinisikan arsitektur model. Untuk itu, kita melakukan langkah-langkah berikut:
keras.Sequential, yang memungkinkan penumpukan lapisan secara berurutan.Conv2D) untuk ekstraksi fitur, diikuti oleh lapisan batch normalization (BatchNormalization) untuk menormalisasi aktivasi.MaxPooling2D) untuk menurunkan sampel peta fitur.Flatten) sebelum meneruskannya ke lapisan dense.# Define the model architecture
model = keras.Sequential([
keras.layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
keras.layers.BatchNormalization(),
keras.layers.Conv2D(64, (3, 3), activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.MaxPooling2D((2, 2)),
keras.layers.Flatten(),
keras.layers.Dense(128, activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.Dense(10, activation='softmax')
])Selanjutnya, kita kompilasi model menggunakan metode .compile(), dengan menentukan optimizer, fungsi loss, dan metrik evaluasi. Kita menggunakan:
'adam') untuk optimisasi.'categorical_crossentropy') sebagai fungsi loss karena masalahnya adalah tugas klasifikasi multikelas.'accuracy') sebagai metrik evaluasi untuk mengukur performa model.# Compile the model
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics=['accuracy'])Berikutnya, mari latih model menggunakan metode .fit():
(x_train, y_train), ukuran batch, jumlah epoch, dan data validasi (x_test, y_test).batch_size menentukan jumlah sampel per pembaruan gradien.epochs menentukan berapa kali model akan mengiterasi seluruh data pelatihan.# Train the model
model.fit(x_train, y_train, batch_size=128, epochs=5, validation_data=(x_test, y_test))Dengan mengikuti langkah-langkah ini dan memasukkan lapisan batch normalization ke dalam arsitektur model, kita dapat melatih model secara efisien pada dataset MNIST, memperoleh manfaat dari normalisasi aktivasi dan stabilitas pelatihan yang meningkat.
Sekarang setelah kita mempelajari tentang batch normalization dan cara mengimplementasikannya, mari kita tinjau manfaatnya.
Sekarang, mari meninjau lebih dalam penerapan batch normalization dalam arsitektur deep learning.
Lapisan batch normalization paling efektif saat ditempatkan secara strategis dalam jaringan. Biasanya, lapisan ini ditempatkan setelah transformasi linear (misalnya, lapisan konvolusi atau fully connected) dan sebelum fungsi aktivasi non-linear.
Dalam jaringan konvolusional, ini berarti menempatkan batch normalization setelah setiap lapisan konvolusi dan sebelum fungsi aktivasi.
Demikian pula, dalam jaringan fully connected, umum untuk menambahkan batch normalization setelah transformasi linear dan sebelum fungsi aktivasi di setiap lapisan tersembunyi.
Penempatan lapisan Batch Normalization dapat memengaruhi performa dan dinamika pelatihan model. Diperlukan eksperimen untuk menemukan konfigurasi optimal bagi setiap arsitektur jaringan tertentu.
Ukuran batch yang digunakan selama pelatihan dapat memengaruhi efektivitas batch normalization. Ukuran batch yang lebih besar memberikan estimasi statistik batch (rata-rata dan varians) yang lebih akurat, menghasilkan normalisasi yang lebih baik dan pelatihan yang lebih stabil.
Namun, meningkatkan ukuran batch juga meningkatkan konsumsi memori dan kebutuhan komputasi, yang mungkin menjadi batasan tergantung sumber daya perangkat keras yang tersedia.
Penting untuk menyeimbangkan ukuran batch dan kelayakan komputasi sambil memastikan statistik batch tetap andal untuk normalisasi.
Batch normalization secara inheren memperkenalkan efek regularisasi karena noise yang ditimbulkan oleh statistik mini-batch. Sifat stokastik dari statistik batch bertindak sebagai bentuk regularisasi, mengurangi overfitting dan meningkatkan generalisasi.
Namun, efek regularisasi ini dapat berinteraksi dengan teknik regularisasi lain, seperti dropout atau regularisasi L2.
Saat menggunakan batch normalization, penting untuk mempertimbangkan interaksi antar metode regularisasi dan menyesuaikannya agar terhindar dari regularisasi berlebihan atau penurunan performa.
Eksperimen dan pemantauan performa model pada data validasi dapat membantu menemukan keseimbangan yang tepat dari teknik regularisasi saat menggunakan batch normalization.
Meskipun batch normalization adalah teknik yang bermanfaat, ada beberapa keterbatasan dan tantangan yang perlu kita ketahui.
Batch Normalization awalnya dirancang untuk convolutional neural networks (CNN) dan sangat berhasil di ranah ini.
Namun, efektivitasnya dalam arsitektur non-konvolusional, seperti recurrent neural networks (RNN) atau transformer, mungkin terbatas.
Sifat berurutan RNN dan mekanisme atensi pada transformer dapat membuat penerapan batch normalization menjadi lebih menantang.
Teknik normalisasi alternatif, seperti layer normalization atau instance normalization, mungkin lebih cocok untuk arsitektur tersebut.
Batch normalization mengandalkan statistik batch yang dihitung selama pelatihan untuk menormalisasi aktivasi. Ketika ukuran batch kecil, statistik batch bisa menjadi kurang andal dan memperkenalkan noise atau ketidakstabilan dalam proses normalisasi.
Hal ini dapat menyebabkan performa kurang optimal atau bahkan kesulitan pelatihan, terutama ketika ukuran batch dikurangi untuk menyesuaikan batasan memori.
Selama inferensi, batch normalization menggunakan statistik berjalan yang dihitung selama pelatihan, yang mungkin tidak secara akurat merepresentasikan statistik dari sampel individu atau batch kecil. Ini dapat menghasilkan ketidaksesuaian antara distribusi pelatihan dan inferensi, yang berpotensi memengaruhi performa model.
Batch normalization menambahkan beban komputasi tambahan selama pelatihan karena perhitungan statistik batch dan operasi normalisasi. Beban ini dapat meningkatkan kebutuhan memori dan waktu pelatihan, terutama untuk model atau dataset besar.
Batch normalization mungkin tidak cocok untuk jenis data atau tugas tertentu di mana proses normalisasi dapat mendistorsi informasi penting atau menghilangkan variasi yang bermakna.
Sebagai contoh, batch normalization dapat berdampak kurang diinginkan pada tugas yang melibatkan detail halus atau informasi spasial yang presisi, seperti segmentasi atau lokalisasi.
Efek regularisasi Batch Normalization terkadang dapat berinteraksi dengan teknik regularisasi lain, seperti dropout, dengan cara yang tidak terduga, sehingga memerlukan penyetelan dan pertimbangan yang cermat.
Terlepas dari keterbatasan dan tantangannya, batch normalization tetap menjadi teknik yang banyak digunakan dan efektif dalam deep learning. Peneliti dan praktisi terus mengeksplorasi cara untuk mengatasi masalah ini dan meningkatkan formulasi aslinya.
Mari pertimbangkan beberapa pendekatan untuk mengurangi keterbatasan batch normalization:
Sekarang mari kita lihat berbagai varian dan ekstensi batch normalization yang juga dapat digunakan untuk mengatasi potensi tantangan yang ditimbulkannya.
Layer normalization beroperasi pada aktivasi di seluruh kanal dalam satu lapisan, bukan di sepanjang dimensi batch.
Teknik ini menormalisasi aktivasi berdasarkan rata-rata dan varians yang dihitung untuk setiap sampel individu dalam batch.
Layer normalization sangat berguna untuk recurrent neural networks (RNN) dan skenario di mana ukuran batch kecil atau bervariasi.
Group normalization membagi kanal menjadi beberapa grup dan menghitung statistik normalisasi dalam setiap grup.
Teknik ini menyeimbangkan layer normalization dan batch normalization dengan menormalisasi subset kanal secara bersama-sama.
Group normalization efektif dalam skenario di mana ukuran batch terbatas, seperti pada lingkungan dengan keterbatasan memori atau saat memproses gambar beresolusi tinggi.
Instance normalization menerapkan normalisasi pada setiap kanal individual dari setiap sampel dalam batch.
Teknik ini umum digunakan dalam tugas transfer gaya (style transfer) dan pembuatan gambar, di mana tujuannya adalah menormalisasi konten sambil mempertahankan informasi gaya.
Instance normalization terbukti meningkatkan kualitas dan stabilitas gambar yang dihasilkan pada aplikasi semacam itu.
Batch renormalization memperluas batch normalization dengan memperkenalkan istilah koreksi tambahan ke dalam proses normalisasi.
Tujuannya adalah mengatasi ketidaksesuaian antara statistik batch dan statistik populasi, khususnya ketika ukuran batch kecil.
Batch renormalization membantu menstabilkan pelatihan dan meningkatkan kemampuan model untuk melakukan generalisasi, terutama dalam skenario dengan ukuran batch terbatas.
Weight Normalization adalah teknik yang memparametrisasi ulang bobot jaringan saraf untuk memisahkan magnitudo dan arah bobot.
Teknik ini menormalisasi bobot dengan membaginya dengan norma Euclidean-nya dan memperkenalkan parameter skala yang dapat dipelajari.
Weight normalization dapat digunakan bersama Batch Normalization atau sebagai metode normalisasi alternatif.
Teknik ini terbukti dapat memperbaiki pengkondisian masalah optimisasi dan mempercepat konvergensi dalam beberapa kasus.
Varian dan ekstensi batch normalization ini menawarkan alat dan teknik tambahan untuk mengatasi tantangan tertentu serta meningkatkan pelatihan dan performa model deep learning. Setiap varian memiliki kelebihan dan pertimbangannya masing-masing, dan pemilihannya bergantung pada kebutuhan spesifik tugas, arsitektur model, serta sumber daya komputasi yang tersedia.
Batch normalization telah menjadi teknik penting dalam deep learning, menawarkan manfaat besar untuk melatih jaringan saraf dalam.
Dengan menormalisasi aktivasi dalam mini-batch, kita dapat mengatasi pergeseran kovariat internal, meningkatkan konvergensi, dan memperkuat generalisasi. Sebagai praktisi data pemula atau junior, ingat poin-poin kunci berikut:
Jika Anda ingin menjadi machine learning engineer, pertimbangkan jalur karier 12 kursus tentang menjadi Machine Learning Engineer ini.
Pelajari lebih lanjut tentang AI dan machine learning!
Program
Program
Program
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



