
Kursus
Machine Learning dengan Model Berbasis Pohon di Python
5 jam
119.2K
Dalam machine learning, fondasi model yang sukses dibangun di atas kualitas data yang digunakan untuk melatihnya. Meskipun sorotan sering tertuju pada algoritma dan model yang kompleks dan canggih, pahlawan tanpa tanda jasa sering kali adalah prapemrosesan data. Prapemrosesan data merupakan langkah penting yang mengubah data mentah menjadi fitur yang kemudian digunakan untuk machine learning yang efektif.
Algoritma machine learning sering dilatih dengan asumsi bahwa semua fitur berkontribusi secara setara terhadap prediksi akhir. Namun, asumsi ini tidak berlaku ketika fitur berbeda dalam jangkauan dan satuan, sehingga memengaruhi tingkat kepentingannya.
Di sinilah normalization berperan – langkah vital dalam prapemrosesan data yang memastikan keseragaman besaran numerik fitur. Keseragaman ini mencegah dominasi fitur yang memiliki nilai lebih besar dibandingkan fitur atau variabel lainnya.
Dalam artikel ini, kita akan membahas normalization, teknik penskalaan fitur yang menawarkan cara untuk menyeimbangkan skala fitur.
Normalization adalah bentuk spesifik dari penskalaan fitur yang mengubah rentang fitur ke skala standar. Normalization, dan pada dasarnya teknik penskalaan data apa pun, diperlukan hanya ketika dataset Anda memiliki fitur dengan rentang yang bervariasi. Normalization mencakup beragam teknik yang disesuaikan dengan distribusi data dan kebutuhan model yang berbeda.
Normalization tidak terbatas hanya pada data numerik. Namun, dalam artikel ini, kita akan berfokus pada contoh numerik. Pastikan untuk melihat tutorial Datacamp’s Textacy: pengantar pembersihan dan normalisasi data teks di Python jika Anda berencana melakukan prapemrosesan pada data teks untuk machine learning.
Data yang dinormalisasi meningkatkan kinerja model dan meningkatkan akurasi model. Ini membantu algoritma yang bergantung pada metrik jarak, seperti k-nearest neighbors atau support vector machines, dengan mencegah fitur berskala besar mendominasi proses pembelajaran.
Normalization mendorong stabilitas dalam proses optimasi, mempromosikan konvergensi yang lebih cepat selama pelatihan berbasis gradien. Ini mengurangi masalah terkait gradien yang menghilang atau meledak, sehingga model dapat mencapai solusi optimal dengan lebih efisien.
Data yang dinormalisasi juga mudah diinterpretasikan dan, karenanya, lebih mudah dipahami. Ketika semua fitur dalam sebuah dataset berada pada skala yang sama, akan lebih mudah untuk mengidentifikasi dan memvisualisasikan hubungan antarfitur serta membuat perbandingan yang bermakna.
Mari ambil contoh sederhana untuk menyoroti pentingnya menormalisasi data. Kita mencoba memprediksi harga rumah berdasarkan berbagai fitur seperti luas bangunan, jumlah kamar tidur, dan jarak ke supermarket, dan lain-lain. Dataset berisi beragam fitur dengan skala yang bervariasi, misalnya:
Saat Anda memasukkan data ini tanpa prapemrosesan langsung ke model machine learning, algoritma mungkin memberikan bobot lebih pada fitur dengan skala besar, seperti luas bangunan. Selama pelatihan, algoritma mengasumsikan bahwa perubahan pada total luas bangunan akan berdampak signifikan pada harga rumah. Algoritma mungkin mengabaikan nuansa fitur yang relatif kecil, seperti jumlah kamar tidur dan jarak ke supermarket. Penekanan yang tidak seimbang ini dapat menyebabkan kinerja model yang kurang optimal dan prediksi yang bias.
Dengan menormalisasi fitur, kita dapat memastikan setiap fitur berkontribusi secara proporsional terhadap proses pembelajaran model. Model kini dapat mempelajari pola di semua fitur secara lebih efektif, menghasilkan representasi yang lebih akurat dari hubungan mendasar dalam data.
Min-max scaling dan normalisasi Z-score (standardization) adalah dua teknik dasar untuk normalization. Selain itu, kita juga akan membahas normalisasi penskalaan desimal, normalisasi penskalaan log, dan robust scaling, yang mengatasi tantangan unik dalam prapemrosesan data.
Min-max scaling sering kali disebut sederhana sebagai ‘normalization.’ Teknik ini mengubah fitur ke rentang tertentu, biasanya antara 0 dan 1. Rumus min-max scaling adalah:
Xnormalized = X – Xmin / Xmax – Xmin
Di mana X adalah nilai fitur acak yang akan dinormalisasi. Xmin adalah nilai fitur minimum dalam dataset, dan Xmax adalah nilai fitur maksimum.
Min-max scaling adalah pilihan yang baik ketika:
Normalisasi Z-score (standardization) mengasumsikan distribusi data Gaussian (kurva lonceng) dan mengubah fitur sehingga memiliki mean (μ) 0 dan standar deviasi (σ) 1. Rumus standardization adalah:
Xstandardized = X−μ / σ
Teknik ini sangat berguna saat bekerja dengan algoritma yang mengasumsikan data terdistribusi normal, seperti banyak model linear. Berbeda dengan teknik min-max scaling, nilai fitur tidak dibatasi pada rentang tertentu dalam teknik standardization. Teknik normalization ini pada dasarnya merepresentasikan fitur dalam jumlah standar deviasi dari mean.
Sebelum kita menyelami teknik transformasi data lainnya, mari bandingkan normalization (min-max scaling) dan standardization.
|
Normalization |
Standardization |
|
Tujuannya adalah membawa nilai suatu fitur ke dalam rentang tertentu, sering kali antara 0 dan 1 |
Tujuannya adalah mengubah nilai suatu fitur agar memiliki mean 0 dan standar deviasi 1 |
|
Sensitif terhadap outlier dan rentang data |
Kurang sensitif terhadap outlier karena menggunakan mean dan standar deviasi |
|
Berguna ketika menjaga rentang asli itu penting |
Efektif ketika algoritma mengasumsikan distribusi normal standar |
|
Tidak ada asumsi tentang distribusi data |
Mengasumsikan distribusi normal atau pendekatannya |
|
Cocok untuk algoritma di mana nilai absolut dan hubungannya penting (mis., k-nearest neighbors, neural networks) |
Sangat berguna untuk algoritma yang mengasumsikan data terdistribusi normal, seperti regresi linear dan support vector machines |
|
Mempertahankan keterbacaan nilai asli dalam rentang yang ditentukan |
Mengubah nilai asli, sehingga interpretasi menjadi lebih menantang karena pergeseran skala dan satuan |
|
Dapat menghasilkan konvergensi lebih cepat, terutama pada algoritma yang bergantung pada gradient descent |
Juga berkontribusi pada konvergensi lebih cepat, khususnya pada algoritma yang sensitif terhadap skala fitur masukan |
|
Kasus penggunaan: Pemrosesan citra, neural networks, algoritma yang sensitif terhadap skala fitur |
Kasus penggunaan: Regresi linear, support vector machines, algoritma yang mengasumsikan distribusi normal |
Tujuan normalisasi penskalaan desimal adalah menskalakan nilai fitur dengan pangkat 10, memastikan bahwa nilai absolut terbesar pada setiap fitur menjadi kurang dari 1. Ini berguna ketika rentang nilai dalam sebuah dataset diketahui, tetapi rentang tersebut bervariasi antarfitur. Rumus normalisasi penskalaan desimal adalah:
Xdecimal = X / 10d
Di mana X adalah nilai fitur asli, dan d adalah bilangan bulat terkecil sehingga nilai absolut terbesar pada fitur menjadi kurang dari 1.
Sebagai contoh, jika nilai absolut terbesar pada suatu fitur adalah 3500, maka d adalah 3, dan fitur tersebut akan diskalakan dengan 103.
Normalisasi penskalaan desimal menguntungkan ketika berhadapan dengan dataset di mana besaran absolut nilai lebih penting daripada skala spesifiknya.
Normalisasi penskalaan log mengonversi data ke skala logaritmik, dengan mengambil log dari setiap titik data. Ini sangat berguna saat menangani data yang mencakup beberapa orde besaran. Rumus normalisasi penskalaan log adalah:
Xlog = log(X)
Normalisasi ini berguna untuk data yang mengikuti pola pertumbuhan atau peluruhan eksponensial. Teknik ini mengompresi skala dataset, sehingga lebih mudah bagi model untuk menangkap pola dan hubungan dalam data. Ukuran populasi sepanjang tahun adalah contoh yang baik dari dataset di mana beberapa fitur menunjukkan pertumbuhan eksponensial. Normalisasi penskalaan log dapat membuat fitur-fitur ini lebih mudah dimodelkan.
Normalisasi robust scaling berguna saat bekerja dengan dataset yang memiliki outlier. Teknik ini menggunakan median dan interquartile range (IQR) alih-alih mean dan standar deviasi untuk menangani outlier. Rumus robust scaling adalah:
Xrobust = X – median/ IQR
Karena robust scaling tahan terhadap pengaruh outlier, teknik ini cocok untuk dataset dengan nilai yang miring atau anomalous.
Kita telah membahas normalization dan mengapa teknik ini berguna dalam machine learning. Meskipun kuat, normalization tidak lepas dari tantangan. Dari menangani outlier hingga memilih teknik yang paling tepat berdasarkan dataset Anda, mengatasi isu-isu ini penting untuk membuka potensi penuh model machine learning Anda.
Outlier adalah titik data dalam dataset Anda yang menyimpang secara signifikan dari norma dan mengganggu efektivitas teknik normalization. Jika Anda tidak menangani outlier dalam data, hal ini dapat menyebabkan transformasi yang bias. Anda dapat menggunakan teknik normalisasi robust scaling yang telah kita bahas sebelumnya untuk menangani outlier.
Strategi lain adalah menerapkan trimming atau winsorizing, yaitu mengidentifikasi dan memangkas atau membatasi semua nilai fitur di atas (atau di bawah) nilai tertentu ke nilai tetap.
Kita telah membahas teknik normalization yang paling berguna, tetapi masih banyak lagi pilihan lainnya. Memilih teknik yang tepat memerlukan pemahaman yang bernuansa tentang dataset. Saat melakukan prapemrosesan data, Anda perlu mencoba beberapa teknik normalization dan menilai dampaknya terhadap kinerja model. Eksperimen memungkinkan Anda mengamati bagaimana setiap metode memengaruhi proses pembelajaran.
Anda perlu memperoleh pemahaman mendalam tentang karakteristik data. Pertimbangkan apakah asumsi dari teknik normalization tertentu selaras dengan distribusi dan pola yang ada dalam dataset.
Normalization dapat menjadi tantangan saat menangani data sparse di mana banyak nilai fitur bernilai nol. Menerapkan teknik normalization standar secara langsung dapat menyebabkan konsekuensi yang tidak diinginkan. Terdapat versi dari teknik normalization yang kita bahas di atas yang dirancang khusus untuk data sparse, seperti ‘sparse min-max scaling.’
Sebelum normalization, pertimbangkan untuk melakukan imputasi atau menangani nilai hilang dalam dataset Anda. Ini sering menjadi salah satu langkah pertama saat Anda mengeksplorasi dataset dan membersihkannya untuk digunakan dalam model machine learning.
Pastikan untuk melihat DataCamp’s Feature Engineering for Machine Learning course, yang memberi Anda pengalaman praktik tentang cara menyiapkan data apa pun untuk model machine learning Anda sendiri. Dalam kursus ini, Anda akan bekerja dengan survei Stack Overflow Developers, dan pidato pelantikan presiden AS bersejarah untuk memahami cara terbaik melakukan prapemrosesan dan merekayasa fitur dari data kategorikal, kontinu, dan tidak terstruktur.
Dalam machine learning, overfitting terjadi ketika model tidak hanya mempelajari pola mendasar dalam data pelatihan tetapi juga menangkap noise dan fluktuasi acak. Ini dapat menyebabkan model yang berkinerja sangat baik pada data pelatihan tetapi gagal melakukan generalisasi ke data baru yang belum pernah dilihat.
Normalization saja mungkin tidak menyebabkan overfitting. Namun, ketika normalization digabungkan dengan faktor lain, seperti kompleksitas model atau regularisasi yang tidak memadai, hal ini dapat berkontribusi pada overfitting. Ketika parameter normalization dihitung menggunakan seluruh dataset (termasuk set validasi atau uji), dapat terjadi kebocoran data. Model mungkin tanpa sengaja mempelajari informasi dari set validasi atau uji, sehingga mengompromikan kemampuannya untuk melakukan generalisasi.
Karena itu, untuk mengurangi risiko overfitting, normalisasikan set pelatihan dan terapkan parameter normalization yang sama ke set validasi dan uji. Ini memastikan bahwa model belajar melakukan generalisasi dari data pelatihan tanpa dipengaruhi oleh informasi dalam set validasi atau uji.
Anda perlu menerapkan teknik regularisasi yang tepat untuk memberi penalti pada model yang terlalu kompleks. Regularisasi membantu mencegah model menyesuaikan noise dalam data pelatihan. Gunakan teknik validasi yang tepat, seperti cross-validation, untuk menilai kinerja model pada data yang belum pernah dilihat. Jika overfitting terdeteksi selama validasi, penyesuaian dapat dilakukan, seperti mengurangi kompleksitas model atau meningkatkan regularisasi.
Scikit-learn adalah pustaka Python serbaguna yang dirancang untuk menyederhanakan seluk-beluk machine learning. Pustaka ini menyediakan seperangkat alat dan fungsionalitas yang kaya untuk prapemrosesan data, seleksi fitur, reduksi dimensi, pembuatan dan pelatihan model, evaluasi model, penyetelan hyperparameter, serialisasi model, konstruksi pipeline, dan sebagainya. Desain modularnya mendorong eksperimen dan eksplorasi, memungkinkan pengguna beralih mulus dari konsep dasar ke metodologi lanjutan.
Kita akan menggunakan scikit-learn untuk mempraktikkan apa yang telah kita pelajari. Kita akan menggunakan `Iris dataset` yang klasik dan banyak digunakan. Dataset ini diperkenalkan oleh ahli biologi dan statistik Inggris Ronald A. Fisher pada tahun 1936. Iris dataset terdiri atas pengukuran empat fitur dari tiga spesies bunga iris yang berbeda: setosa, versicolor, dan virginica.
Ada empat fitur yang diukur untuk setiap bunga, yaitu panjang sepal, lebar sepal, panjang petal, dan lebar petal — semuanya dalam sentimeter. Terdapat 150 instance (sampel) dalam dataset, dengan 50 sampel dari masing-masing tiga spesies. Iris dataset biasanya digunakan untuk tugas klasifikasi, di mana tujuannya adalah memprediksi spesies yang benar di antara tiga kelas. Namun, hari ini, kita akan menggunakan dataset ini untuk menunjukkan transformasi data saat menerapkan normalization (min-max scaling) dan standardization.
Anda dapat mengeksekusi kode Python yang dibahas di bawah ini di Datacamp’s workspace untuk menjelajahi dataset sendiri.
Mari mulai dengan mengimpor pustaka yang kita butuhkan….
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
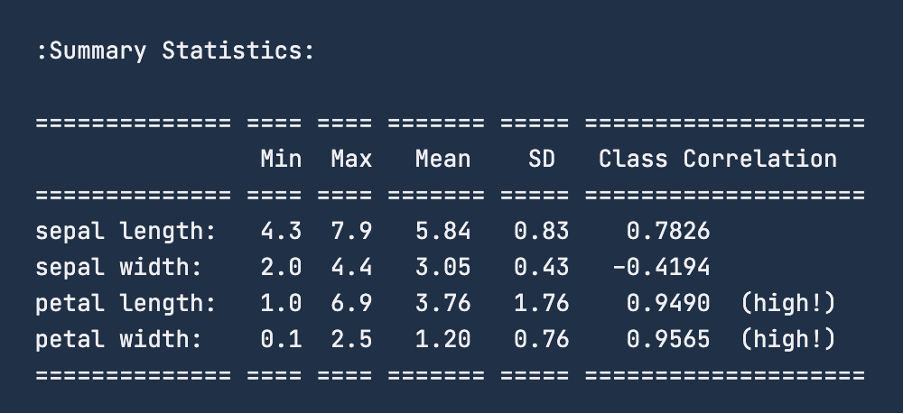
Saat Anda memeriksa statistik ringkasan untuk data menggunakan print(iris.DESCR), gambar di bawah ini adalah ringkasan yang akan Anda terima. Untuk fitur ‘sepal length’, rentangnya adalah 4,3 – 7,9 sentimeter. Demikian pula, untuk ‘sepal width’, rentangnya adalah 2 – 4,4 sentimeter. Untuk ‘petal length’ rentangnya 1 – 6,9 sentimeter dan terakhir, untuk ‘petal width’ rentangnya 0,1 – 2,5 sentimeter.
Sebelum kita menerapkan normalization, praktik yang baik adalah membagi dataset menjadi set pelatihan dan uji. Kita akan menggunakan fungsionalitas train_test_split dari sklearn.model_selection untuk melakukannya. Kita tidak membuat set validasi karena kita tidak akan melakukan pemodelan machine learning sebenarnya dalam latihan ini. Kita akan membuat pembagian 80-20 pada dataset, yang berarti set pelatihan akan memiliki 120 baris, dan set uji akan memiliki 30 titik data sisanya.
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
Langkah yang biasa dilakukan setelah memuat data dan membaginya menjadi set pelatihan-pengujian adalah melakukan pembersihan data, imputasi data untuk menangani nilai hilang, dan menangani outlier data. Namun, karena fokus artikel ini adalah pada normalization – kita akan melewati langkah-langkah prapemrosesan ini dan langsung melihat normalization dalam aksi.
Sekarang kita akan mentransformasikan data ini agar berada pada rentang 0 – 1 sentimeter menggunakan teknik min-max normalization. Untuk menormalkan data, kita akan menggunakan fungsionalitas MinMaxScaler dari pustaka sklearn dan menerapkannya pada dataset kita; kita sudah mengimpor pustaka yang diperlukan sebelumnya.
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
Kita dapat mencetak data pelatihan untuk melihat transformasi yang terjadi. Namun, mari konversi set tersebut menjadi pandas dataframe lalu periksa deskripsi statistiknya menggunakan fungsionalitas describe().
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
Ini akan memberikan hasil berikut untuk normalization:
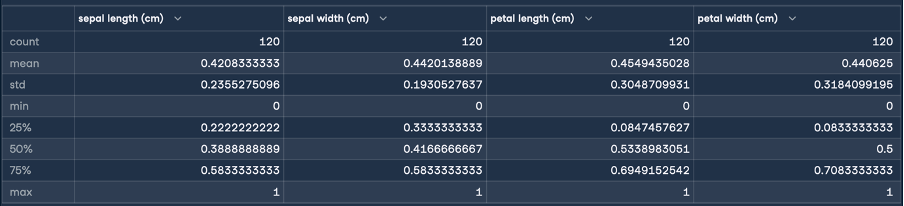
Di sini, statistik min dan max menunjukkan bahwa rentang semua fitur telah ditransformasikan ke rentang 0 – 1 sentimeter. Ini adalah transformasi yang kita tuju! Sekarang kita akan melakukan standardization (normalisasi Z-score) dengan mengikuti langkah yang sama seperti saat melakukan normalization:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
Ini akan memberikan hasil berikut untuk standardization:
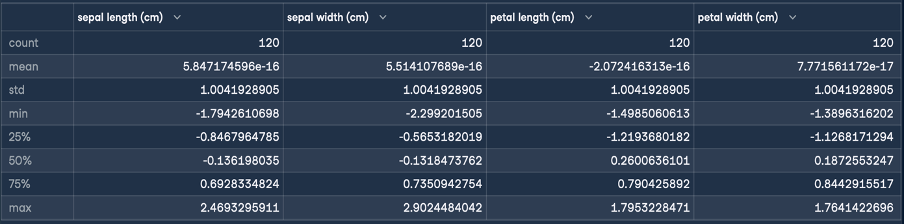
Tujuan Z-normalization adalah mengubah nilai suatu fitur agar memiliki mean 0 dan standar deviasi 1. Seperti yang dapat Anda lihat dari deskripsi dataframe yang dihasilkan, mean untuk keempat fitur adalah angka kecil yang mendekati nol, dan standar deviasinya adalah 1.
Sekarang kita dapat mengambil data yang telah ditransformasikan ini dan memberikannya ke algoritma machine learning untuk pelatihan.
Dalam artikel ini, kita telah menelusuri min-max scaling, Z-normalization, penskalaan desimal, dan normalisasi penskalaan log. Masing-masing teknik menunjukkan kekuatan dan kegunaannya yang unik. Anda juga telah membaca beberapa jebakan umum dan praktik terbaik saat melakukan normalization. Terakhir, kita menutup dengan menerapkan sebagian dari pengetahuan baru ini menggunakan scikit-learn.
Untuk mempelajari lebih lanjut tentang konsep dan proses yang telah kita bahas, lihat kursus kami tentang Feature Engineering for Machine Learning in Python dan Textacy: An Introduction to Text Data Cleaning and Normalization in Python.
Pelajari Machine Learning!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



