Cursus
Principes fondamentaux de l'IA
10 h
L'entraînement de réseaux de neurones profonds peut s'avérer complexe en raison des gradients évanescents ou explosifs et du décalage de covariables interne. Ces phénomènes ralentissent fortement l'apprentissage et nuisent à la capacité du réseau à généraliser. Heureusement, des techniques de normalisation permettent d'y remédier.
Parmi les nombreuses techniques, la batch normalization est l'une des plus répandues et constitue désormais un composant standard de nombreuses architectures de deep learning. Elle favorise une convergence plus rapide, une stabilité d'entraînement accrue et de meilleures performances en généralisation.
Dans ce tutoriel, nous expliquons le principe de la batch normalization, son fonctionnement mathématique, et son implémentation avec TensorFlow et Keras.
Pour maîtriser les fondamentaux des réseaux de neurones avec Keras, consultez ce cours Introduction to Deep Learning in Python.
La normalisation est une étape de prétraitement essentielle qui vise à standardiser les données d'entrée.
Plusieurs techniques sont couramment utilisées : mise à l'échelle min‑max, normalisation z‑score, transformation logarithmique, etc. Elles permettent de ramener les variables sur une même échelle ou distribution, de limiter l'effet des valeurs aberrantes, d'améliorer la convergence et d'assurer une comparaison équitable entre caractéristiques.
Normaliser les données d'entrée est crucial pour entraîner efficacement un modèle, car cela garantit que toutes les variables contribuent de façon comparable au processus d'apprentissage. Sans normalisation, les variables à grande échelle ou variance peuvent dominer l'optimisation et dégrader les performances.
La normalisation ramène les variables sur une échelle similaire, ce qui permet au modèle d'apprendre des motifs et relations pertinents.
Pour une vue d'ensemble de la normalisation, consultez ce tutoriel : What is Normalization in Machine Learning.
Former des réseaux de neurones profonds présente plusieurs défis qui peuvent freiner la convergence et la généralisation :
La batch normalization répond à ces défis en normalisant les activations à l'intérieur de chaque mini-lot, ce qui stabilise l'entraînement et améliore les performances du modèle.
La batch normalization est une technique qui normalise les activations d'une couche au sein d'un mini-lot pendant l'entraînement des réseaux de neurones profonds.
Elle calcule la moyenne et la variance des activations pour chaque variable du mini-lot, puis normalise ces activations à partir de ces statistiques.
Les activations normalisées sont ensuite redimensionnées et décalées via des paramètres apprenables, ce qui permet au modèle d'adapter la distribution d'activation optimale.
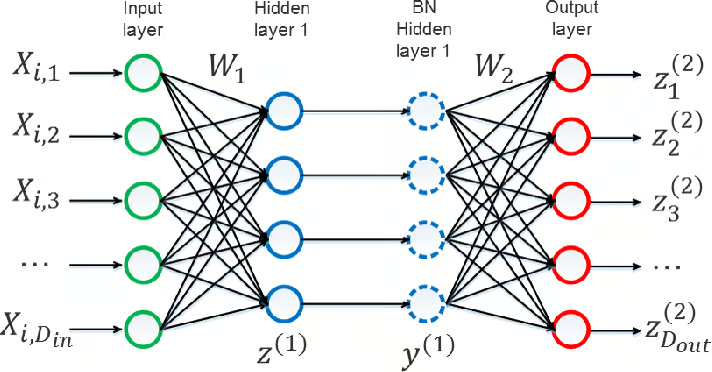
Source : Yintai Ma and Diego Klabjan.
La batch normalization s'applique généralement après la transformation linéaire d'une couche (p. ex. après la multiplication matrice × vecteur dans une couche totalement connectée, ou après la convolution) et avant la fonction d'activation non linéaire (p. ex. ReLU).
Ses éléments clés sont :
L'un des défis lors de l'entraînement de réseaux profonds est le décalage de covariables interne : la distribution des activations d'une couche évolue au fil des époques à mesure que les poids précédents changent, ce qui complique et ralentit l'apprentissage.
La batch normalization atténue ce phénomène en normalisant les activations de chaque mini-lot, rendant les entrées des couches suivantes plus stables et cohérentes.
Normaliser les activations permet d'utiliser des taux d'apprentissage plus élevés et d'accélérer la convergence tout en rendant le modèle moins sensible à l'initialisation.
Elle introduit également un effet de régularisation qui limite le sur-apprentissage en réduisant la dépendance à des schémas d'activation spécifiques.
Cette combinaison d'atouts fait de la batch normalization un outil puissant pour entraîner des modèles de deep learning plus robustes. Pour aller plus loin sur la robustesse, consultez le cours Machine Learning Monitoring Concepts.
Maintenant que l'on comprend le « pourquoi », voyons le « comment ».
La batch normalization fonctionne différemment en phase d'entraînement et en phase d'inférence ; voici les éléments mathématiques de chaque étape.
Commençons par l'étape de normalisation. Pour chaque variable dans un mini-lot, on calcule la moyenne et la variance. Voici les formules de la moyenne et de la variance.


On utilise ensuite ces valeurs pour normaliser les activations. Voici la formule utilisée, où ε (epsilon minuscule) est une petite constante ajoutée pour la stabilité numérique :

Après la normalisation, on passe à l'étape de redimensionnement et de décalage. Grâce aux paramètres apprenables γ et β, on transforme les activations normalisées selon la formule suivante :

Ces paramètres permettent au modèle d'apprendre la distribution d'activation optimale.
En inférence, on remplace les statistiques de lot (moyenne et variance) par des statistiques cumulées calculées pendant l'entraînement. Ces statistiques sont généralement mises à jour par moyenne mobile avec un facteur de momentum.
Pour calculer la moyenne et la variance cumulées, on utilise les deux formules suivantes, où α est le facteur de momentum qui contrôle la vitesse de mise à jour :


La moyenne et la variance cumulées sont stockées comme paramètres du modèle et utilisées pour la normalisation en inférence. Les paramètres de redimensionnement et décalage (γ et β) appris à l'entraînement sont également appliqués.
Voyons maintenant comment implémenter la batch normalization avec TensorFlow.
Commençons par importer les bibliothèques nécessaires :
import tensorflow as tf
from tensorflow import keras
Chargeons ensuite le jeu de données MNIST, qui contient 60 000 images d'entraînement et 10 000 images de test de chiffres manuscrits. Nous le chargeons via la fonction keras.datasets.mnist.load_data() et le scindons en données d'entraînement (x_train, y_train) et de test (x_test, y_test) :
# Load the MNIST dataset
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
Pour prétraiter les données, nous procédons ainsi :
(num_samples, 28, 28, 1), où num_samples est le nombre d'images, chacune étant une image 28×28 en niveaux de gris avec un seul canal.keras.utils.to_categorical(), qui transforme les étiquettes entières en vecteurs one-hot.# Preprocess the data
x_train = x_train.reshape((60000, 28, 28, 1)) / 255.0 # Reshape and normalize training images
x_test = x_test.reshape((10000, 28, 28, 1)) / 255.0 # Reshape and normalize test images
y_train = keras.utils.to_categorical(y_train) # Convert training labels to categorical format
y_test = keras.utils.to_categorical(y_test) # Convert test labels to categorical formatPassons maintenant à la définition de l'architecture du modèle, en suivant ces étapes :
keras.Sequential, qui empile les couches séquentiellement.Conv2D) pour l'extraction de caractéristiques, suivies de couches de batch normalization (BatchNormalization) pour normaliser les activations.MaxPooling2D) pour réduire la dimension spatiale.Flatten) avant de les passer aux couches denses.# Define the model architecture
model = keras.Sequential([
keras.layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
keras.layers.BatchNormalization(),
keras.layers.Conv2D(64, (3, 3), activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.MaxPooling2D((2, 2)),
keras.layers.Flatten(),
keras.layers.Dense(128, activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.Dense(10, activation='softmax')
])Nous compilons ensuite le modèle avec .compile(), en précisant l'optimiseur, la fonction de perte et la métrique d'évaluation. Nous utilisons :
'adam').'categorical_crossentropy') car il s'agit d'une classification multi-classes.'accuracy') comme métrique d'évaluation.# Compile the model
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics=['accuracy'])Enchaînons avec l'entraînement via la méthode .fit() :
(x_train, y_train), la taille de lot, le nombre d'époques et les données de validation (x_test, y_test).batch_size définit le nombre d'échantillons par mise à jour du gradient.epochs indique le nombre de passages sur l'ensemble des données d'entraînement.# Train the model
model.fit(x_train, y_train, batch_size=128, epochs=5, validation_data=(x_test, y_test))En intégrant des couches de batch normalization dans l'architecture, on entraîne efficacement le modèle sur MNIST, en bénéficiant d'activations normalisées et d'une meilleure stabilité d'entraînement.
Maintenant que nous avons vu le principe et l'implémentation, examinons ses bénéfices.
Approfondissons l'intégration de la batch normalization dans les architectures de deep learning.
Les couches de batch normalization sont plus efficaces lorsqu'elles sont positionnées stratégiquement. En règle générale, on les place après la transformation linéaire (p. ex. couches convolutionnelles ou totalement connectées) et avant l'activation non linéaire.
Dans les réseaux convolutionnels, on les insère donc après chaque couche de convolution et avant la fonction d'activation.
De même, dans les réseaux totalement connectés, il est courant d'ajouter la batch normalization après la transformation linéaire et avant l'activation de chaque couche cachée.
Le placement de ces couches peut influer sur les performances et la dynamique d'entraînement. Des expérimentations sont souvent nécessaires pour trouver la configuration optimale selon l'architecture.
La taille de lot pendant l'entraînement influe sur l'efficacité de la normalisation. Des lots plus grands fournissent des estimations plus fiables des statistiques de lot (moyenne et variance), ce qui améliore la normalisation et la stabilité.
Toutefois, augmenter la taille de lot accroît la consommation mémoire et le coût de calcul, ce qui peut être limitant selon les ressources matérielles disponibles.
Il faut donc trouver un équilibre entre taille de lot et faisabilité de calcul, tout en conservant des statistiques de lot suffisamment fiables.
La batch normalization induit naturellement un effet de régularisation, lié au bruit apporté par l'estimation sur mini-lots. Cette stochasticité agit comme une régularisation, réduisant le sur-apprentissage et améliorant la généralisation.
Cependant, cet effet peut interagir avec d'autres techniques (dropout, régularisation L2, etc.).
Lorsque vous l'utilisez, tenez compte des interactions entre méthodes de régularisation et ajustez-les pour éviter une sur-régularisation ou une baisse de performance.
Des expérimentations et un suivi sur les données de validation aident à trouver le bon compromis.
Malgré son intérêt, la batch normalization présente certaines limites et points de vigilance.
Initialement conçue pour les réseaux de neurones convolutionnels (CNN), elle y a montré une grande efficacité.
Son efficacité peut toutefois être moindre dans des architectures non convolutionnelles comme les réseaux récurrents (RNN) ou les transformers.
La nature séquentielle des RNN et les mécanismes d'attention des transformers compliquent son application.
Des alternatives comme la layer normalization ou l'instance normalization peuvent être plus adaptées.
La batch normalization repose sur des statistiques de lot estimées à l'entraînement. Avec de petits lots, ces estimations deviennent moins fiables et peuvent introduire du bruit ou de l'instabilité.
Cela peut dégrader les performances, voire perturber l'entraînement lorsque la taille de lot est réduite pour des raisons mémoire.
En inférence, on utilise des statistiques cumulées apprises à l'entraînement, qui ne reflètent pas toujours fidèlement les statistiques d'échantillons isolés ou de petits lots. Ce décalage entre distribution d'entraînement et d'inférence peut affecter les résultats.
La batch normalization ajoute un surcoût de calcul à l'entraînement (calcul des statistiques de lot et opération de normalisation), ce qui peut alourdir la mémoire et la durée d'entraînement, notamment pour de grands modèles ou jeux de données.
Elle peut être défavorable pour certains types de données ou tâches si la normalisation altère des informations fines ou des variations pertinentes.
Par exemple, en segmentation ou localisation, elle peut nuire à la préservation de détails spatiaux très fins.
Son effet de régularisation peut parfois interagir de façon inattendue avec d'autres méthodes (dropout, etc.), nécessitant un réglage soigné.
Malgré ces limites, la batch normalization reste très utilisée et efficace. La recherche continue d'améliorer sa formulation et de traiter ses points faibles.
Voici quelques approches pour en atténuer les limites :
Passons en revue des variantes et extensions qui permettent aussi de contourner certains défis.
La layer normalization opère sur les activations de toutes les canaux d'une couche, plutôt qu'au niveau du lot.
Elle normalise les activations à partir de la moyenne et de la variance calculées pour chaque échantillon individuellement.
Particulièrement utile pour les RNN et lorsque la taille de lot est faible ou variable.
La group normalization partitionne les canaux en groupes et calcule les statistiques au sein de chaque groupe.
Elle se situe entre layer normalization et batch normalization en normalisant des sous-ensembles de canaux.
Efficace lorsque la taille de lot est limitée, par exemple en environnement contraint en mémoire ou avec des images haute résolution.
L'instance normalization applique la normalisation à chaque canal de chaque échantillon.
Fréquente en transfert de style et génération d'images, où l'on souhaite normaliser le contenu tout en préservant le style.
Elle améliore qualité et stabilité des images générées dans ces applications.
La batch renormalization étend la batch normalization en introduisant des termes correctifs supplémentaires.
Elle vise à réduire l'écart entre statistiques de lot et statistiques de population, notamment avec de petits lots.
Elle stabilise l'entraînement et améliore la généralisation, surtout quand la taille de lot est restreinte.
La weight normalization reparamètre les poids d'un réseau pour découpler magnitude et direction.
Elle normalise les poids par leur norme euclidienne et introduit un paramètre d'échelle apprenable.
Elle peut être utilisée avec la batch normalization ou en alternative.
Elle améliore parfois le conditionnement du problème d'optimisation et accélère la convergence.
Ces variantes offrent des leviers supplémentaires pour répondre à des besoins spécifiques et améliorer l'entraînement et les performances. Le choix dépendra de la tâche, de l'architecture et des ressources disponibles.
La batch normalization est devenue un pilier du deep learning, avec des bénéfices notables pour l'entraînement des réseaux profonds.
En normalisant les activations au sein des mini-lots, on réduit le décalage de covariables interne, on améliore la convergence et on renforce la généralisation. En tant que praticien ou praticienne débutant·e, retenez :
Si vous visez une carrière d'ingénieur·e en machine learning, découvrez ce parcours de 12 cours : Machine Learning Engineer.
Approfondissez vos connaissances en IA et en machine learning !
Cursus
Cursus
Cursus