Lernpfad
Grundlagen der KI
10 Std.
Das Training tiefer neuronaler Netze ist herausfordernd: verschwindende oder explodierende Gradienten und interner Kovariatendrift können das Lernen stark verlangsamen und die Leistung beeinträchtigen. Zum Glück lassen sich diese Probleme mit Normalisierungstechniken in den Griff bekommen.
Unter den vielen Normalisierungsverfahren ist die Batch-Normalization eines der beliebtesten und inzwischen Standard in vielen Deep-Learning-Architekturen. Sie sorgt für schnellere Konvergenz, stabileres Training und bessere Generalisierung.
In diesem Tutorial erklären wir Batch-Normalization, wie sie mathematisch funktioniert und wie du sie mit TensorFlow und Keras implementierst.
Wenn du die Grundlagen neuronaler Netze mit Keras lernen möchtest, schau dir diesen Kurs an: Introduction to Deep Learning in Python.
Normalisierung ist ein entscheidender Preprocessing-Schritt im Machine Learning, der Eingabedaten auf einen Standard bringt.
Verschiedene Verfahren wie Min-Max-Skalierung, z-Score-Normalisierung oder Log-Transformation werden genutzt, um Merkmale auf einen einheitlichen Wertebereich oder eine konsistente Verteilung zu skalieren. So lassen sich Ausreißer abmildern, die Konvergenz verbessern und Merkmale fair vergleichen.
Normalisierte Eingaben sind für effektives Modelltraining essenziell, weil alle Features gleich stark in den Lernprozess einfließen. Ohne Normalisierung dominieren Merkmale mit großen Skalen oder Varianzen die Optimierung und verschlechtern die Modellleistung.
Durch die Anpassung auf eine ähnliche Skala kann das Modell aussagekräftige Muster und Zusammenhänge in den Daten erkennen.
Wenn du dich grundsätzlich in das Thema Normalisierung einarbeiten willst, lies dieses Tutorial: What is Normalization in Machine Learning.
Beim Training tiefer Netze treten mehrere Hürden auf, die Konvergenz und Generalisierung erschweren:
Batch-Normalization begegnet diesen Problemen, indem sie Aktivierungen innerhalb jeder Mini-Batch normalisiert. Das stabilisiert das Training und verbessert die Modellleistung.
Batch-Normalization normalisiert die Aktivierungen einer Schicht innerhalb einer Mini-Batch während des Trainings tiefer neuronaler Netze.
Dazu werden Mittelwert und Varianz der Aktivierungen pro Feature in der Mini-Batch berechnet und die Aktivierungen anhand dieser Statistiken normalisiert.
Anschließend werden die normalisierten Aktivierungen mit lernbaren Parametern skaliert und verschoben, sodass sich die optimale Aktivierungsverteilung einstellen kann.
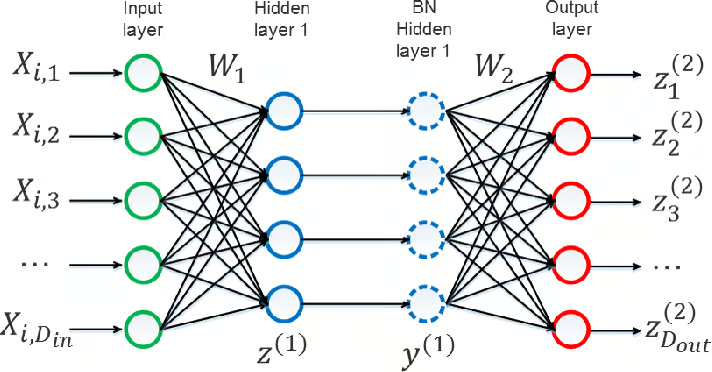
Quelle: Yintai Ma und Diego Klabjan.
Batch-Normalization wird typischerweise nach der linearen Transformation einer Schicht (z. B. nach der Matrixmultiplikation in einer Fully-Connected-Schicht oder nach der Faltung in einer Convolution-Schicht) und vor der nichtlinearen Aktivierungsfunktion (z. B. ReLU) angewendet.
Die Kernelemente der Batch-Normalization sind:
Eine zentrale Herausforderung beim Training tiefer Netze ist der interne Kovariatendrift. Während des Trainings ändern sich durch Gewichtsupdates in früheren Schichten die Verteilungen der Aktivierungen nachgelagerter Schichten. Das macht das Training zäh und fehleranfällig.
Batch-Normalization reduziert diesen Drift, indem sie die Aktivierungen innerhalb jeder Mini-Batch normalisiert und so die Eingaben für folgende Schichten stabiler macht.
Normalisierte Aktivierungen ermöglichen höhere Lernraten und schnellere Konvergenz und machen das Modell weniger empfindlich gegenüber der Initialisierung.
Zudem wirkt sie regulärisierend: Sie verringert die Abhängigkeit des Modells von spezifischen Aktivierungsmustern und beugt Overfitting vor.
Diese Kombination macht Batch-Normalization zu einem starken Werkzeug für robustere Deep-Learning-Modelle. Mehr zu robusten Modellen erfährst du im Kurs Machine Learning Monitoring Concepts.
Nachdem das „Warum“ klar ist, schauen wir uns das „Wie“ an.
Batch-Normalization verhält sich im Training und bei der Inferenz unterschiedlich. Im Folgenden die Mathematik beider Phasen.
Wir starten mit dem Normalisierungsschritt. Zuerst berechnen wir Mittelwert und Varianz für jedes Feature in einer Mini-Batch. Diese Formeln verwenden wir für Mittelwert und Varianz.


Anschließend normalisieren wir die Aktivierungen mithilfe von Mittelwert und Varianz. Dafür nutzen wir folgende Formel, wobei ε (kleines Epsilon) eine kleine Konstante für numerische Stabilität ist:

Nach der Normalisierung folgt das Skalieren und Verschieben. Mit den lernbaren Parametern γ und β verschieben und skalieren wir die normalisierten Aktivierungen gemäß:

Diese Parameter erlauben es dem Modell, die optimale Aktivierungsverteilung zu lernen.
Während der Inferenz ersetzen wir die Batch-Statistiken (Mittelwert und Varianz) durch die während des Trainings fortgeschriebenen Laufstatistiken. Diese werden typischerweise als gleitender Mittelwert mit einem Momentum-Faktor aktualisiert.
Zur Berechnung von laufendem Mittelwert und Varianz nutzen wir diese Formeln, wobei α das Momentum ist und die Aktualisierungsrate steuert:


Laufender Mittelwert und Varianz werden als Modellparameter gespeichert und bei der Inferenz zur Normalisierung verwendet. Die während des Trainings gelernten Skalierungs- und Verschiebungsparameter (γ und β) kommen ebenfalls zum Einsatz.
Als Nächstes schauen wir uns die Implementierung mit TensorFlow an.
Los geht’s mit dem Import der benötigten Bibliotheken:
import tensorflow as tf
from tensorflow import keras
Als Nächstes laden wir den MNIST-Datensatz mit 60.000 Trainings- und 10.000 Testbildern handgeschriebener Ziffern. Wir verwenden keras.datasets.mnist.load_data() und teilen in Trainingsdaten (x_train, y_train) und Testdaten (x_test, y_test) auf:
# Load the MNIST dataset
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
Für das Preprocessing gehen wir so vor:
(num_samples, 28, 28, 1), wobei num_samples die Bildanzahl ist und jedes Bild 28x28 Graustufen mit einem Kanal hat.keras.utils.to_categorical() in kategoriales One-Hot-Format.# Preprocess the data
x_train = x_train.reshape((60000, 28, 28, 1)) / 255.0 # Reshape and normalize training images
x_test = x_test.reshape((10000, 28, 28, 1)) / 255.0 # Reshape and normalize test images
y_train = keras.utils.to_categorical(y_train) # Convert training labels to categorical format
y_test = keras.utils.to_categorical(y_test) # Convert test labels to categorical formatJetzt definieren wir die Modellarchitektur. Dazu:
keras.Sequential-API, um Schichten sequentiell zu stapeln.Conv2D) zur Merkmalsextraktion, gefolgt von Batch-Normalization-Schichten (BatchNormalization) zur Normalisierung der Aktivierungen.MaxPooling2D) dient zum Downsampling der Feature-Maps.Flatten abgeflacht.# Define the model architecture
model = keras.Sequential([
keras.layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
keras.layers.BatchNormalization(),
keras.layers.Conv2D(64, (3, 3), activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.MaxPooling2D((2, 2)),
keras.layers.Flatten(),
keras.layers.Dense(128, activation='relu'),
keras.layers.BatchNormalization(),
keras.layers.Dense(10, activation='softmax')
])Anschließend kompilieren wir das Modell mit .compile() und legen Optimierer, Verlustfunktion und Metrik fest. Wir verwenden:
'adam') für die Optimierung.'categorical_crossentropy') als Verlustfunktion, da es sich um eine Multiklassifikation handelt.'accuracy') als Metrik zur Bewertung der Modellleistung.# Compile the model
model.compile(optimizer='adam',
loss='categorical_crossentropy',
metrics=['accuracy'])Jetzt trainieren wir das Modell mit .fit():
(x_train, y_train), Batch-Größe, Anzahl Epochen und Validierungsdaten (x_test, y_test).batch_size bestimmt die Anzahl Samples pro Gradienten-Update.epochs legt fest, wie oft das Modell über alle Trainingsdaten iteriert.# Train the model
model.fit(x_train, y_train, batch_size=128, epochs=5, validation_data=(x_test, y_test))Mit diesen Schritten und eingebauten Batch-Normalization-Schichten trainierst du das Modell effizient auf MNIST – mit stabileren Aktivierungen und robusterem Training.
Nachdem wir Funktionsweise und Implementierung gesehen haben, schauen wir uns die Vorteile im Detail an.
Werfen wir nun einen genaueren Blick auf die Integration von Batch-Normalization in Deep-Learning-Architekturen.
Batch-Normalization-Schichten wirken am besten, wenn sie gezielt positioniert werden. Üblich ist die Platzierung nach der linearen Transformation (z. B. Convolution- oder Fully-Connected-Schichten) und vor der nichtlinearen Aktivierung.
In Convolutional Networks heißt das: BN nach jeder Convolution-Schicht und vor der Aktivierungsfunktion.
In vollständig verbundenen Netzen ist es ebenso üblich, BN nach der linearen Transformation und vor der Aktivierung jeder Hidden Layer einzufügen.
Die Platzierung kann das Trainingsverhalten und die Leistung merklich beeinflussen. Oft ist Experimentieren nötig, um die optimale Konfiguration für eine gegebene Architektur zu finden.
Die Trainings-Batch-Größe beeinflusst die Wirksamkeit der Batch-Normalization. Größere Batches liefern präzisere Schätzungen für Mittelwert und Varianz und damit stabilere Normalisierung und Konvergenz.
Allerdings steigen mit größerer Batch-Größe Speicherbedarf und Rechenaufwand, was je nach Hardware Grenzen setzt.
Finde eine Balance zwischen praktikabler Batch-Größe und verlässlichen Statistiken für die Normalisierung.
Batch-Normalization bringt durch die stochastischen Mini-Batch-Statistiken einen inhärenten Regulärisierungseffekt mit. Diese Zufallskomponente wirkt regulärisierend, reduziert Overfitting und verbessert die Generalisierung.
Dieser Effekt kann jedoch mit anderen Methoden wie Dropout oder L2-Regularisierung interagieren.
Achte bei BN auf das Zusammenspiel der Regulärisierer und stimme sie ab, um Überregularisierung oder Leistungseinbußen zu vermeiden.
Experimentiere und überwache die Validierungsleistung, um die richtige Balance der Techniken zu finden.
So nützlich Batch-Normalization ist, es gibt ein paar Grenzen und Stolpersteine, die du kennen solltest.
Batch-Normalization wurde ursprünglich für Convolutional Neural Networks (CNNs) entwickelt und ist dort besonders erfolgreich.
In nicht-konvolutionalen Architekturen wie rekurrenten Netzen (RNNs) oder Transformern kann die Wirksamkeit begrenzt sein.
Die Sequenzialität von RNNs und die Aufmerksamkeitsmechanismen von Transformern erschweren den Einsatz von BN.
Alternative Verfahren wie Layer-Normalization oder Instance-Normalization sind hier oft geeigneter.
BN stützt sich auf während des Trainings berechnete Batch-Statistiken. Bei kleinen Batches werden diese Schätzungen unzuverlässiger und können Rauschen oder Instabilität einführen.
Das kann zu suboptimaler Leistung oder Trainingsproblemen führen, insbesondere wenn die Batch-Größe aus Speichergründen reduziert wird.
Zur Inferenz nutzt BN laufende Statistiken aus dem Training, die einzelne Samples oder sehr kleine Batches nicht unbedingt gut repräsentieren. Das kann zu einem Mismatch zwischen Trainings- und Inferenzverteilung führen und die Leistung beeinträchtigen.
BN verursacht zusätzlichen Rechenaufwand im Training durch das Bestimmen der Batch-Statistiken und die Normalisierung. Das erhöht Speicherbedarf und Trainingszeit, besonders bei großen Modellen oder Datensätzen.
Für bestimmte Daten oder Aufgaben ist BN weniger geeignet, wenn die Normalisierung wichtige Informationen verzerrt oder Variationen glättet.
Bei Aufgaben mit feinen Details oder präziser räumlicher Information, etwa Segmentierung oder Lokalisierung, kann BN unerwünschte Effekte haben.
Der Regulärisierungseffekt von BN kann zudem auf unerwartete Weise mit anderen Verfahren wie Dropout interagieren und erfordert sorgfältiges Tuning.
Trotz ihrer Grenzen bleibt Batch-Normalization eine weit verbreitete und wirksame Technik. Forschung und Praxis arbeiten kontinuierlich an Verbesserungen und Abhilfen.
Einige Ansätze zur Abmilderung der Limitierungen:
Schauen wir uns Varianten und Erweiterungen an, die Herausforderungen der klassischen Batch-Normalization adressieren.
Layer-Normalization operiert über alle Kanäle innerhalb einer Schicht statt über die Batch-Dimension.
Sie normalisiert Aktivierungen anhand von Mittelwert und Varianz pro einzelnes Sample in der Batch.
Layer-Normalization ist besonders nützlich für RNNs und Szenarien mit kleinen oder variablen Batch-Größen.
Group-Normalization teilt die Kanäle in Gruppen und berechnet Statistiken innerhalb jeder Gruppe.
Sie bildet einen Mittelweg zwischen Layer- und Batch-Normalization, indem Teilmengen von Kanälen gemeinsam normalisiert werden.
Group-Normalization eignet sich bei begrenzten Batch-Größen, etwa in speicherarmen Umgebungen oder bei hochauflösenden Bildern.
Instance-Normalization normalisiert jeden Kanal eines einzelnen Samples separat.
Sie wird häufig bei Style-Transfer und Bildgenerierung eingesetzt, wo Inhalte normalisiert, aber Stilinformationen erhalten bleiben sollen.
In solchen Anwendungen verbessert Instance-Normalization Qualität und Stabilität der generierten Bilder.
Batch-Renormalization erweitert BN um zusätzliche Korrekturterme.
Ziel ist es, die Diskrepanz zwischen Batch- und Populationsstatistiken zu verringern, insbesondere bei kleinen Batch-Größen.
Batch-Renormalization stabilisiert das Training und verbessert die Generalisierung in Szenarien mit begrenzten Batches.
Weight-Normalization parametrisiert Gewichte neu, um Betrag und Richtung zu entkoppeln.
Dazu werden die Gewichte durch ihre euklidische Norm geteilt und ein lernbarer Skalierungsparameter eingeführt.
Weight-Normalization kann neben Batch-Normalization oder alternativ eingesetzt werden.
In einigen Fällen verbessert sie die Konditionierung des Optimierungsproblems und beschleunigt die Konvergenz.
Diese Varianten erweitern deinen Werkzeugkasten, um trainings- und aufgabenspezifische Anforderungen besser zu erfüllen. Welche Methode passt, hängt von Aufgabe, Architektur und verfügbaren Ressourcen ab.
Batch-Normalization ist zu einer Schlüsseltechnik im Deep Learning geworden und bringt handfeste Vorteile für das Training tiefer Netze.
Durch die Normalisierung innerhalb von Mini-Batches reduzieren wir internen Kovariatendrift, beschleunigen die Konvergenz und verbessern die Generalisierung. Wenn du als angehende oder Junior-Fachkraft im Datenbereich arbeitest, merk dir Folgendes:
Wenn du Machine-Learning-Engineer werden willst, sieh dir diesen 12-Kurs-Lernpfad an: Machine Learning Engineer.
Erfahre mehr über KI und Machine Learning!
Lernpfad
Lernpfad
Lernpfad