
Last chance! 50% off DataCamp Premium
Sale ends in
Qwen Image 2.1 adalah model generasi dan pengeditan gambar terpadu.
Komponen generasi visualnya berisi 7 miliar parameter. Model ini mendukung pembuatan gambar dari teks, transparansi native, beberapa gambar referensi, dan pengeditan lokal yang dipandu oleh anotasi atau mask. Tutorial ini berfokus pada pengeditan RGB dengan satu referensi.
Model ini sudah menyediakan kemampuan pengeditan. Aplikasi kita menambahkan alur kerjanya: memilih input, meninjau kandidat, mengelola frame yang diterima, dan mengekspornya. Kita tidak melatih model baru atau menambahkan modul gerak.
GIF yang dihasilkan memutar gambar statis yang dibangkitkan secara independen. Ini dapat menunjukkan perubahan pose dan variasi visual, tetapi tidak setara dengan pembuatan video yang konsisten secara temporal.
Deskripsi arsitektur resmi mengidentifikasi empat komponen utama:
|
Komponen |
Spesifikasi |
Peran |
|
Visual transformer |
32 lapis, 7B parameter single-stream diffusion transformer (DiT) |
Memproses token conditioning dan target-image dalam satu aliran bersama |
|
Encoder teks dan gambar |
Qwen3-VL 8B |
Menkode instruksi dan gambar referensi ke representasi terpadu |
|
Image autoencoder (VAE) |
64 kanal laten, dukungan RGBA, kompresi spasial 16× |
Mengonversi gambar ke laten kompak dan mendekode laten yang dihasilkan menjadi piksel |
|
Proses generasi |
Flow matching dengan penjadwalan Euler diskret dan dynamic shifting |
Memperbarui laten target-image secara iteratif menuju gambar yang dihasilkan |
Visual transformer berisi 7 miliar parameter. Jumlah ini tidak termasuk encoder teks-dan-gambar dan VAE.
64 kanal VAE merujuk pada representasi latent-nya, bukan 64 kanal warna output.
Output RGBA berisi kanal merah, hijau, biru, dan alfa. Aplikasi meratakan unggahan menjadi RGB, sehingga tidak mendemonstrasikan dukungan transparansi native model.
Qwen Image 2.1 menggunakan masker attention berbutir-campuran di mana sel berwarna mengizinkan attention, sementara sel abu-abu memblokirnya.
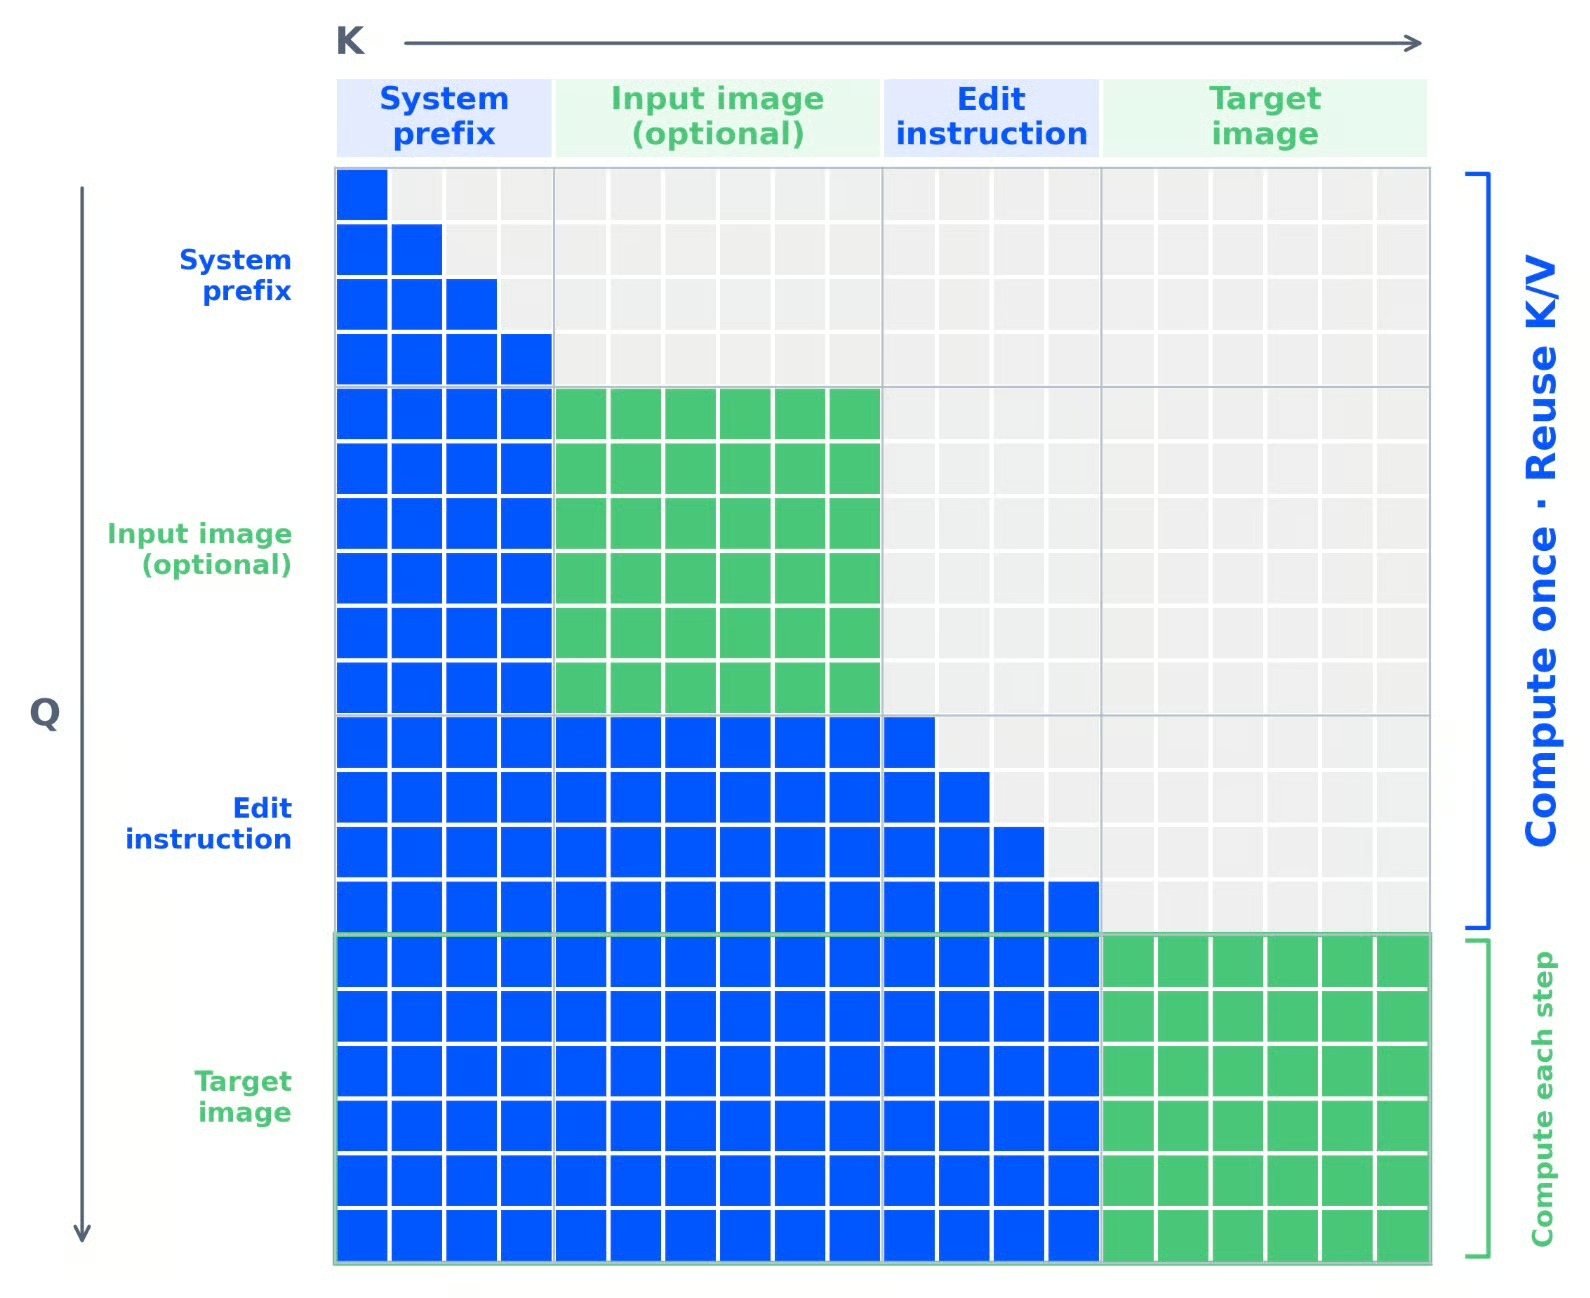
Gambar 1: Arsitektur attention berbutir-campuran Qwen Image 2.1 (Postingan blog Qwen)
Baca diagram per baris: Q mewakili token query, dan K mewakili token yang dapat di-attend olehnya. Urutan berisi prefix sistem, gambar input opsional, instruksi pengeditan, dan gambar target.
Teks menggunakan causal attention karena token teks dapat attend ke dirinya sendiri dan posisi sebelumnya. Token dalam blok gambar yang sama dapat saling attend dua arah.
Ini menghasilkan wilayah teks berbentuk segitiga dan blok gambar solid seperti pada gambar 1.
Aturan mask mengekspresikan kombinasi itu sebagai:
allowed = (q_idx >= kv_idx) or same_image_blockIni adalah aturan konseptual untuk sepasang posisi token, bukan pengaturan tambahan untuk ditempel ke notebook. Aturan ini mengizinkan attention ke posisi sebelumnya dan memungkinkan attention all-to-all dalam setiap blok gambar.
Prefix sistem, gambar referensi, dan instruksi tidak dapat attend ke blok target-image yang lebih akhir.
Representasinya, oleh karena itu, tidak perlu berubah saat gambar target diperbarui.
Qwen menghitung kunci dan nilai attention-nya sekali pada langkah denoising pertama dan menggunakannya kembali di langkah-langkah berikutnya. Token target-image masih memerlukan komputasi di setiap langkah, dengan attend ke prefix cache dan satu sama lain.
Dengan 40 langkah, prefix tetap dapat digunakan kembali setelah langkah pertama; ini tidak berarti percepatan 40× karena komputasi target-image masih signifikan.
Penggunaan ulang cache ini terjadi di seluruh langkah denoising dalam satu generasi. Ini tidak berarti model mengingat permintaan pengguna sebelumnya, atau bahwa aplikasi kita secara otomatis menggunakan cache yang sama di antara edit yang diajukan secara terpisah.
Sebelum membangun aplikasi, mari pisahkan pengaturan model dari keputusan aplikasi. Perhatikan bahwa menambah jumlah langkah tidak akan memperbaiki pipeline yang terus memberi makan gambar rusak kembali ke model.
|
Pengaturan |
Nilai yang digunakan |
Alasan penting |
|
Gambar referensi |
Gambar asli untuk setiap edit di aplikasi final |
Menghindari penerusan artefak dari satu frame ke frame berikutnya |
|
Resolusi |
1024 |
Kira-kira target pengeditan satu megapiksel di backend ini |
|
Langkah inferensi |
40 |
Anggaran sampling yang digunakan di seluruh eksperimen utama |
|
Seed |
42 |
Menjaga seed sampling tetap saat menguji instruksi |
|
CFG |
1.0 |
Sesuai workflow yang disediakan; panduan cabang negatif standar tidak berkontribusi pada nilai ini |
|
Sampler/scheduler |
Euler / simple |
Menjaga konfigurasi sampling yang disediakan tanpa perubahan |
|
Denoise |
1.0 |
Sesuai workflow edit-instruksi ini; bukan resep img2img low-denoise konvensional |
|
Decoding VAE |
Tidak ditile pada konfigurasi final |
Dipilih setelah peningkatan kualitatif selama pengembangan |
|
Bobot |
Model gambar dan encoder teks INT8 ConvRot; VAE BF16 |
Backend hemat memori yang digunakan untuk demo |
|
Offload encoder/cache referensi ke CPU |
Awalnya dinonaktifkan |
Jalankan A100 muat tanpa mengaktifkan pengaturan offload tambahan ini |
Ini adalah pengaturan kerja untuk proyek ini, namun bukan konfigurasi optimal secara umum. Kami tidak menjalankan penyapuan sistematis atas langkah, CFG, sampler, atau format kuantisasi.
Nilai sampler berasal dari workflow image-edit, yang memungkinkan saya menjalankan model ini pada VRAM rendah.
Runtime yang direkam menggunakan NVIDIA A100-SXM4-40GB, dengan RAM host 83,5 GiB.
Saya menggunakan paket instalasi alesha-pro untuk memasang ComfyUI dan mengunduh bobot terkuantisasi.
Perhatikan bahwa Anda perlu menyiapkan sekitar 45 GB penyimpanan kosong, termasuk environment, model, cache, dan output.
Runtime dengan RAM tinggi memberi ruang selama pemuatan dan offloading.
Pertama, tetapkan path dan periksa GPU:
import sys, os, json, time, uuid, shutil, subprocess, copy, io, threading
from pathlib import Path
from PIL import Image, ImageDraw, ImageFilter, ImageOps
import numpy as np
import requests
import gradio as gr
from IPython.display import display, Image as DisplayImage

ROOT = Path('/content/qwen_gif_demo')
ROOT.mkdir(parents=True, exist_ok=True)
TOOLS = ROOT / 'tools'
COMFY = ROOT / 'ComfyUI'
RUNS = ROOT / 'runs'
RUNS.mkdir(exist_ok=True)
REPO_REV = 'dc0083c0d17581f04ebbca962771e36f82f31af8'
BASE = 'http://127.0.0.1:8188'

def run_cmd(args, **kwargs):
    print('Running:', ' '.join(map(str, args)), flush=True)
    subprocess.run(list(map(str, args)), check=True, **kwargs)

if not shutil.which('nvidia-smi'):
    raise RuntimeError('Select a GPU runtime before continuing.')
print(subprocess.check_output(['nvidia-smi'], text=True))
Pemeriksaan GPU menghentikan eksekusi jika Colab masih menggunakan runtime CPU, dan kami juga mencetak detail tentang RAM host dan ruang disk kosong sebelum instalasi.
Impor cukup dasar, termasuk pustaka standar Python, yang menangani path file, workflow JSON, proses backend, penentuan waktu, dan pemantauan latar belakang.
Pillow dan NumPy menangani pemrosesan gambar, Requests berkomunikasi dengan ComfyUI, Gradio menyediakan antarmuka, dan IPython menampilkan gambar di notebook.
ComfyUI berjalan di environment virtualnya sendiri. Kernel notebook menangani unggahan, permintaan HTTP, dan Gradio.
if not TOOLS.exists():
    run_cmd(['git', 'init', TOOLS])
    run_cmd(['git', '-C', TOOLS, 'remote', 'add', 'origin', 'https://github.com/alesha-pro/tools.git'])
    run_cmd(['git', '-C', TOOLS, 'fetch', '--depth', '1', 'origin', REPO_REV])
    run_cmd(['git', '-C', TOOLS, 'checkout', '--detach', 'FETCH_HEAD'])
assert subprocess.check_output(['git', '-C', str(TOOLS), 'rev-parse', 'HEAD'], text=True).strip() == REPO_REV
PKG = TOOLS / 'qwen-image-2.1'
VERSIONS = json.loads((PKG / 'install/versions.json').read_text())
print('Pinned backend:', VERSIONS)
driver = subprocess.check_output(['nvidia-smi', '--query-gpu=driver_version', '--format=csv,noheader'], text=True).splitlines()[0]
# Conservative selector; the backend CUDA smoke test is authoritative.
TORCH_INDEX = 'https://download.pytorch.org/whl/cu130' if int(driver.split('.')[0]) >= 580 else 'https://download.pytorch.org/whl/cu128'
print('Driver:', driver, '| wheel index:', TORCH_INDEX)
run_cmd([sys.executable, PKG / 'install/setup.py', 'install', '--dir', COMFY, '--torch-index', TORCH_INDEX])
BACKEND_PY = COMFY / '.venv/bin/python'
run_cmd([BACKEND_PY, '-c', "import torch; print(torch.__version__, torch.version.cuda); print(torch.cuda.get_device_name(0)); x=torch.ones(16,device='cuda'); print(x.sum().item())"])
run_cmd([BACKEND_PY, PKG / 'install/download_models.py', '--models-dir', COMFY / 'models'])
Kode ini mengambil sumber yang dipatok, membaca konfigurasi versinya, memasang backend, menguji operasi tensor CUDA, dan mengunduh model.
Pemilihan wheel CUDA menggunakan versi driver sebagai heuristik awal.
Uji asap CUDA penting untuk verifikasi karena A100 saja tidak menjamin kompatibilitas dengan setiap build PyTorch. Sesi saya menggunakan driver 580.82.07.
Sel startup meluncurkan ComfyUI pada 127.0.0.1:8188, menunggu hingga siap, dan mengambil definisi node yang tersedia.
Kode berkomunikasi dengannya melalui helper HTTP kecil:
def api(path, body=None):
    r = requests.get(BASE + path, timeout=30) if body is None else requests.post(BASE + path, json=body, timeout=30)
    if not r.ok:
        raise RuntimeError(f'{path}: HTTP {r.status_code}: {r.text[:3000]}')
    return r.json()
Helper ini mengubah kegagalan sisi server menjadi pengecualian yang mudah dibaca. Setelah startup, skema node tersedia melalui:
INFO = api('/object_info')Kode startup memeriksa server yang sudah ada sebelum meluncurkan proses lain. Jadi tidak ada terowongan ComfyUI publik terpisah dalam setup ini.
Sekarang atur parameter yang akan kita gunakan untuk pengeditan:
CPU_ENCODER = False
CPU_REFERENCE_CACHE = False
TILED_VAE = False
STEPS = 40
SIZE = 1024
SEED = 42
Berikut cara menafsirkan pengaturan ini:
STEPS: Lebih banyak iterasi sampling umumnya memakan waktu lebih lama. Kami menggunakan 40.SIZE: Dalam grafik edit, resolusi 1024 menargetkan kira-kira satu megapiksel sambil menyesuaikan dimensi dengan referensi. Ini tidak memaksa output persegi.SEED: Seed tetap memudahkan perbandingan dalam setup yang sama. Ini tidak menjamin pelestarian identitas atau transisi mulus antar prompt berbeda.TILED_VAE: Decoding tanpa tile memproses gambar tanpa jalur decode tile kecil yang dikonfigurasi. Mungkin memerlukan lebih banyak memori. Preferensi kami muncul dari pengujian visual, bukan bukti terkontrol bahwa tiling menyebabkan setiap artefak.Demikian pula, negative prompt bukan kontrol utama untuk diutak-atik pada CFG 1. Biarkan kosong alih-alih berharap daftar panjang sifat yang tidak diinginkan dapat memperbaiki edit yang lemah.
Pembangun workflow memuat grafik API dan mengganti input spesifik permintaan. Cuplikan berikut menunjukkan jalur pengeditan:
g = json.loads((PKG / 'workflows/api/03-image-edit.json').read_text())
g['4']['inputs'].update(prompt=prompt, resolution=SIZE)
g['6']['inputs'].update(seed=int(seed), steps=int(STEPS))
g['9']['inputs']['image'] = upload_image(image_path)

if CPU_REFERENCE_CACHE:
    g['11']['inputs']['device'] = 'cpu'
if CPU_ENCODER:
    g['2']['inputs']['device'] = 'cpu'
Di sini, Node 4 menerima instruksi pengeditan dan resolusi.
Node 6 mengontrol sampling, dan node 9 memuat referensi yang diunggah.
Dua override lainnya secara opsional memindahkan pekerjaan encoder atau cache referensi ke memori host.
Helper inferensi kemudian mengirimkan grafik dan menunggu ID permintaannya sendiri:
response = api('/prompt', {
    'prompt': g,
    'client_id': uuid.uuid4().hex,
})
result = collect_result(response['prompt_id'], folder)
Di sini, folder adalah direktori output per permintaan yang dibuat di dalam infer().
Kolektor melakukan polling riwayat dan mengunduh PNG yang dihasilkan saat pekerjaan yang cocok selesai.
Kami juga menyimpan input, grafik, pengajuan, riwayat, dan metrik. Itu memungkinkan inspeksi permintaan aktual saat output terlihat salah.
Timeout tidak secara otomatis membatalkan pekerjaan GPU, jadi simpan ID permintaan sebelum memutuskan untuk mencoba lagi.
Aplikasi final selalu memerlukan referensi yang tidak berubah untuk kembali. Jalur unggahan berikut menerapkan koreksi orientasi, meratakan transparansi, dan menambahkan gambar ke kanvas persegi sebelum diteruskan ke model:
python
from google.colab import files
uploaded = files.upload()
assert len(uploaded) == 1, 'Upload exactly one image.'
with Image.open(io.BytesIO(next(iter(uploaded.values())))) as image:
    rgba = ImageOps.exif_transpose(image).convert('RGBA')
    background = Image.new('RGBA', rgba.size, (250, 240, 230, 255))
    original = Image.alpha_composite(background, rgba).convert('RGB')
    original = ImageOps.pad(original, (SIZE, SIZE), color=(250, 240, 230))

BASE_FRAME = ROOT / f'original-{uuid.uuid4().hex[:8]}.png'
original.save(BASE_FRAME)
Padding mempertahankan rasio aspek alih-alih meregangkan subjek. Namun dapat menambahkan bingkai tepi.
Unggahan langsung di editor Gradio mengikuti handler unggahnya sendiri dan dapat mempertahankan dimensi unggahan. Itulah mengapa aplikasi juga memeriksa dimensi kandidat sebelum ekspor.
Untuk pengeditan pose, pilih gambar dengan ruang yang cukup untuk pergerakan yang diminta dan tambahkan instruksi sesuai batasannya.
Gambar coretan berguna saat target bisa ambigu, seperti memilih satu lengan atau satu objek dalam adegan yang ramai.
Ini sepenuhnya opsional dalam aplikasi kami.
Editor Gradio menyediakan latar, lapisan gambar, dan gambar komposit, dan aturan penting untuk desain final kami adalah memuat yang asli dan hanya menambahkan lapisan gambar:
layers = editor_data.get('layers') or []
has_marks = any(
    np.any(np.asarray(layer.convert('RGBA'))[..., 3] > 0)
    for layer in layers if layer is not None
)
with Image.open(original_path) as image:
    source = image.convert('RGBA').copy()
if has_marks:
    for layer in layers:
        if layer is None:
            continue
        layer = layer.convert('RGBA')
        if layer.size != source.size:
            raise ValueError('Clear the drawing and redraw on the original.')
        source = Image.alpha_composite(source, layer)
Ini adalah logika inti di dalam callback edit.
Kanal alfa menunjukkan apakah suatu lapisan berisi tanda terlihat, seperti Anda menggambar lingkaran, persegi panjang, atau goresan kasar, yang semuanya dapat berfungsi sebagai panduan visual.
Tanda-tanda ini bukan mask inpainting yang keras. Tanda tersebut memberi tahu model di mana harus fokus, tetapi tidak menjamin piksel lain tetap tidak berubah.
Kita dapat menambahkan penjelasan wilayah hanya saat tanda ada:
region_instruction = (
    'The red hand-drawn marks identify the target region. '
    'For an outline, edit the enclosed area; for painted strokes, '
    'edit the indicated area. Remove the annotation marks '
    'from the final result. '
) if has_marks else ''

prompt = (
    'Edit <image1>. '
    + region_instruction
    + f'Requested change: {instruction.strip()} '
    + "Preserve unrelated content and the image's framing. "
    + "Keep the subject's identity and visual style consistent "
    + 'unless the requested change explicitly alters them.'
)
Klausul pelestarian memberi tahu model hal-hal yang penting, namun tetap merupakan instruksi alih-alih jaminan.
Untuk uji yang lebih eksplisit, tentukan sisi relatif gambar dan pose akhir, seperti:
instruction = (
    'Lower the arm on the right side of the image so it extends '
    'diagonally downward. Keep the other arm, face, body position, '
    'camera framing, and background unchanged.'
)
Hindari “gerakkan sedikit lagi” ketika setiap permintaan dimulai dari yang asli.
Model tidak menerima percakapan sebelumnya atau pose terakhir yang diterima.
Versi pertama proyek ini menghasilkan urutan dengan memberi makan setiap output ke permintaan berikutnya:
result = edit_frame(manifest['frames'][-1], POSES[pose_index])
Inilah perilaku yang saya ubah untuk aplikasi final karena pengeditan berulang dapat menyebarkan artefak, sebab setiap permintaan baru dimulai dari output model sebelumnya.
Dalam urutan tanaman awal kami, gambar-gambar belakangan menjadi jauh lebih berisik.
Jalur generasi final menggunakan referensi asli, dengan anotasi opsional, sebagai gantinya:
input_path = ROOT / f'edit-input-{uuid.uuid4().hex[:8]}.png'
source.convert('RGB').save(input_path)
result_path = infer(
    'edit',
    prompt,
    seed=int(seed),
    image_path=input_path,
)
Ini menghapus jalur umpan balik melalui gambar yang dihasilkan sebelumnya.
Ini tidak menghilangkan artefak dalam output individual, dan tidak memaksa frame yang dihasilkan secara independen untuk cocok dengan sempurna.
Jika satu gambar yang diterima memuat mawar, permintaan berikutnya tidak otomatis mewarisinya. Untuk mempertahankan mawar sambil mengubah pose, kita perlu menyertakan kedua persyaratan:
instruction = (
    'Make the character hold a red rose in the hand on the right '
    'side of the image, with that arm extended downward. '
    'Preserve the other hand, face, background, and camera framing.'
)
Kompromi ini berguna untuk menghasilkan variasi dari referensi yang sama.
Untuk tugas yang memerlukan edit kumulatif, workflow berurutan mungkin tetap tepat, tetapi membutuhkan ekspektasi berbeda tentang perubahan yang terakumulasi.
Aplikasi memisahkan yang asli, urutan yang diterima, dan hasil tertunda menggunakan fungsi State Gradio:
original_state = gr.State(initial_path)
frames_state = gr.State(initial_frames)
pending_state = gr.State(None)
Urutan dimulai dengan yang asli dan bertambah hanya saat pengguna menerima kandidat. State tertunda menampung berkas yang dihasilkan yang belum diterima.
Operasi penerimaan utama diberikan oleh:
updated_frames = list(frames) + [pending_path]Setelah pembaruan ini, callback lengkap membersihkan kandidat tertunda dan prompt, mengembalikan editor ke yang asli.
Discard membersihkan hasil tertunda tanpa mengubah frame yang diterima. Reset mengembalikan urutan ke satu frame asli dan membersihkan instruksi saat ini dan output unduhan. Tidak ada tindakan yang memerlukan pemuatan ulang model.
Antarmuka final memisahkan pengeditan, frame tersimpan, dan ekspor ke dalam tiga tab.
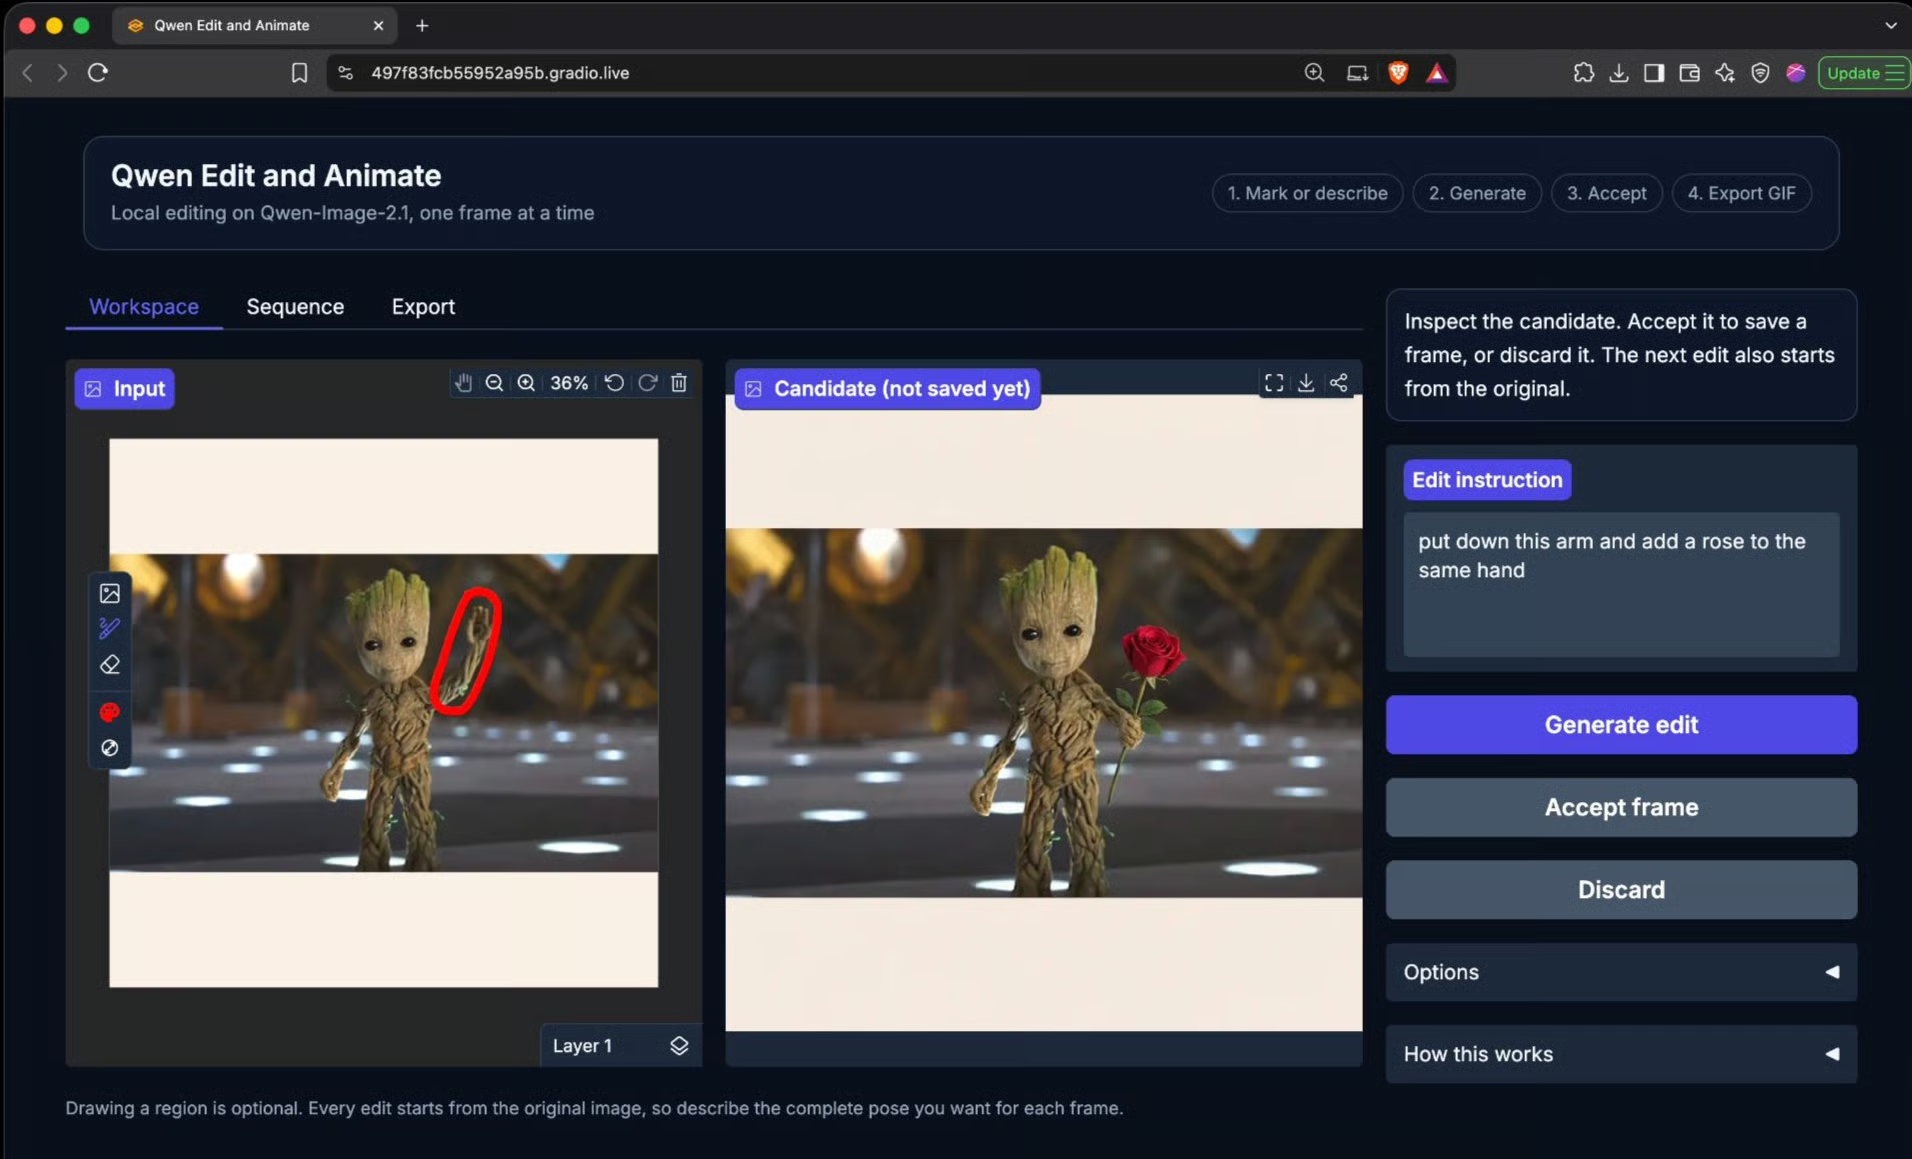
Komponen kuncinya adalah editor gambar:
editor = gr.ImageEditor(
    value=initial_editor,
    type='pil',
    image_mode='RGBA',
    label='Input',
    height=480,
    brush=gr.Brush(
        colors=['#ff0000'],
        color_mode='fixed',
        default_size=8,
    ),
    eraser=gr.Eraser(default_size=20),
    transforms=(),
)
Warna kuas tetap sesuai dengan instruksi anotasi.
Penghapus memungkinkan pengguna memperbaiki wilayah kasar, sementara transformasi yang dinonaktifkan menjaga cropping dan rotasi keluar dari interaksi ini.
Peristiwa generasi meneruskan state asli ke callback:
event_options = {
    'concurrency_id': 'edit_workflow',
    'concurrency_limit': 1,
}

generate_button.click(
    fn=generate_edit,
    inputs=[editor, instruction, seed, original_state],
    outputs=[candidate, pending_state, status],
    **event_options,
)
Cuplikan kode ini berada di dalam tata letak Blocks lengkap.
Grup konkurensi bersama mensérialkan generasi dan perubahan state dalam demo ini. Reset menunggu gilirannya; ini bukan kontrol pembatalan pekerjaan GPU.
Setelah handler dan komponen didefinisikan, luncurkan aplikasi dengan menjalankan:
demo.queue(default_concurrency_limit=1).launch(
    share=True,
    debug=True,
)
Tautan berbagi Gradio mengekspos frontend, sementara backend tetap di localhost. Perubahan tema dan CSS meningkatkan presentasi, namun tidak mengubah kualitas gambar.
Eksporter hanya menggunakan frame yang diterima karena membuat palet bersama dan secara opsional memutar urutan mundur setelah frame terakhir:
def export_gif(paths, destination, duration_ms=300, ping_pong=True):
    frames = []
    for path in paths:
        with Image.open(path) as image:
            frames.append(image.convert('RGB').copy())
    if len(frames) < 2:
        raise ValueError('Accept at least one edit first.')
    if len({frame.size for frame in frames}) != 1:
        raise ValueError('Frame dimensions must match.')

    atlas = Image.new('RGB', (128 * len(frames), 128))
    for i, frame in enumerate(frames):
        atlas.paste(frame.resize((128, 128)), (128 * i, 0))
    palette = atlas.quantize(colors=256)
    converted = [
        frame.quantize(palette=palette, dither=Image.Dither.NONE)
        for frame in frames
    ]
    if ping_pong:
        converted += converted[-2:0:-1]
    converted[0].save(
        destination,
        save_all=True,
        append_images=converted[1:],
        duration=int(duration_ms),
        loop=0,
        disposal=2,
        optimize=False,
    )
    return str(destination)
Palet bersama mengurangi satu sumber potensial flicker terkait palet.
Menonaktifkan dithering menghindari penambahan pola dither saat konversi, meski reduksi warna masih dapat memperkenalkan banding.
Durasi diukur dalam milidetik, dan pengaturan loop=0 meminta pemutaran berkelanjutan. Untuk empat frame, pemutaran ping-pong menggunakan urutan 0, 1, 2, 3, 2, 1.
Irisan balik mengecualikan titik akhir yang berulang. Ini tidak melakukan interpolasi pergerakan karena animasi yang lebih halus memerlukan pose perantara yang sesuai, bukan hanya kecepatan putar yang berbeda.
Kami membangun editor Qwen Image 2.1 yang menerima instruksi teks dan coretan opsional, memungkinkan pengguna mengkurasi hasil individual, dan mengekspornya sebagai GIF.
Keputusan kualitas kunci adalah mempertahankan referensi asli yang tetap alih-alih berulang kali mengedit output yang dihasilkan.
Mulailah dengan konfigurasi sampling yang berfungsi, buat perubahan yang diminta secara eksplisit, dan periksa kandidat mentah sebelum mengubah lebih banyak pengaturan.
Setelah bagian-bagian itu stabil, bereksperimenlah dengan resolusi atau decoding satu variabel pada satu waktu. Hasilnya adalah alur kerja pengeditan gambar yang berguna dengan penjelasan jelas tentang kemampuan dan keterbatasannya.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt





