
{count, plural, one {Cursus} other {Cursussen}}
AI-ondersteund coderen voor developers
{hours} uur {minutes} min
11K
Qwen Image 2.1 is een uniform model voor beeldgeneratie en -bewerking.
De visuele generatiecomponent bevat 7 miljard parameters. Het model ondersteunt tekst-naar-beeldgeneratie, native transparantie, meerdere referentieafbeeldingen en lokale bewerking gestuurd door annotaties of maskers. Deze tutorial richt zich op RGB-bewerking met één referentie.
Het model biedt de bewerkmogelijkheid al. Onze applicatie voegt de workflow eromheen toe: het selecteren van de input, het beoordelen van kandidaten, het beheren van geaccepteerde frames en het exporteren daarvan. We trainen geen nieuw model en voegen geen motionmodule toe.
De resulterende GIF speelt onafhankelijk gegenereerde stilstaande beelden af. Het kan poseveranderingen en visuele variaties tonen, maar is niet gelijk aan temporeel consistente videogeneratie.
De officiële architectuurbeschrijving noemt vier hoofdcomponenten:
|
Component |
Specificatie |
Rol |
|
Visuele transformer |
32-laags, 7B-parameter single-stream diffusion transformer (DiT) |
Verwerkt conditioning- en doelafbeeldingstokens in één gedeelde stroom |
|
Tekst- en afbeeldingsencoder |
Qwen3-VL 8B |
Encodeert instructies en referentieafbeeldingen tot één uniforme representatie |
|
Beeldautoencoder (VAE) |
64 latente kanalen, RGBA-ondersteuning, 16× ruimtelijke compressie |
Zet afbeeldingen om naar compacte latents en decodeert gegenereerde latents naar pixels |
|
Generatieproces |
Flow matching met Euler discrete scheduling en dynamische shifting |
Werkt de doelafbeelding-latents iteratief bij richting de gegenereerde afbeelding |
De visuele transformer bevat 7 miljard parameters. Deze telling sluit de tekst-en-afbeeldingsencoder en de VAE uit.
De 64 kanalen van de VAE verwijzen naar de latente representatie, niet naar 64 uitvoer-kleurkanalen.
RGBA-uitvoer bevat rode, groene, blauwe en alphakanalen. De app vlakt uploads af naar RGB, dus hij demonstreert niet de native transparantie-ondersteuning van het model.
Qwen Image 2.1 gebruikt een attentionmasker met gemengde granulariteit waarbij gekleurde cellen aandacht toestaan, terwijl de grijze cellen die blokkeren.
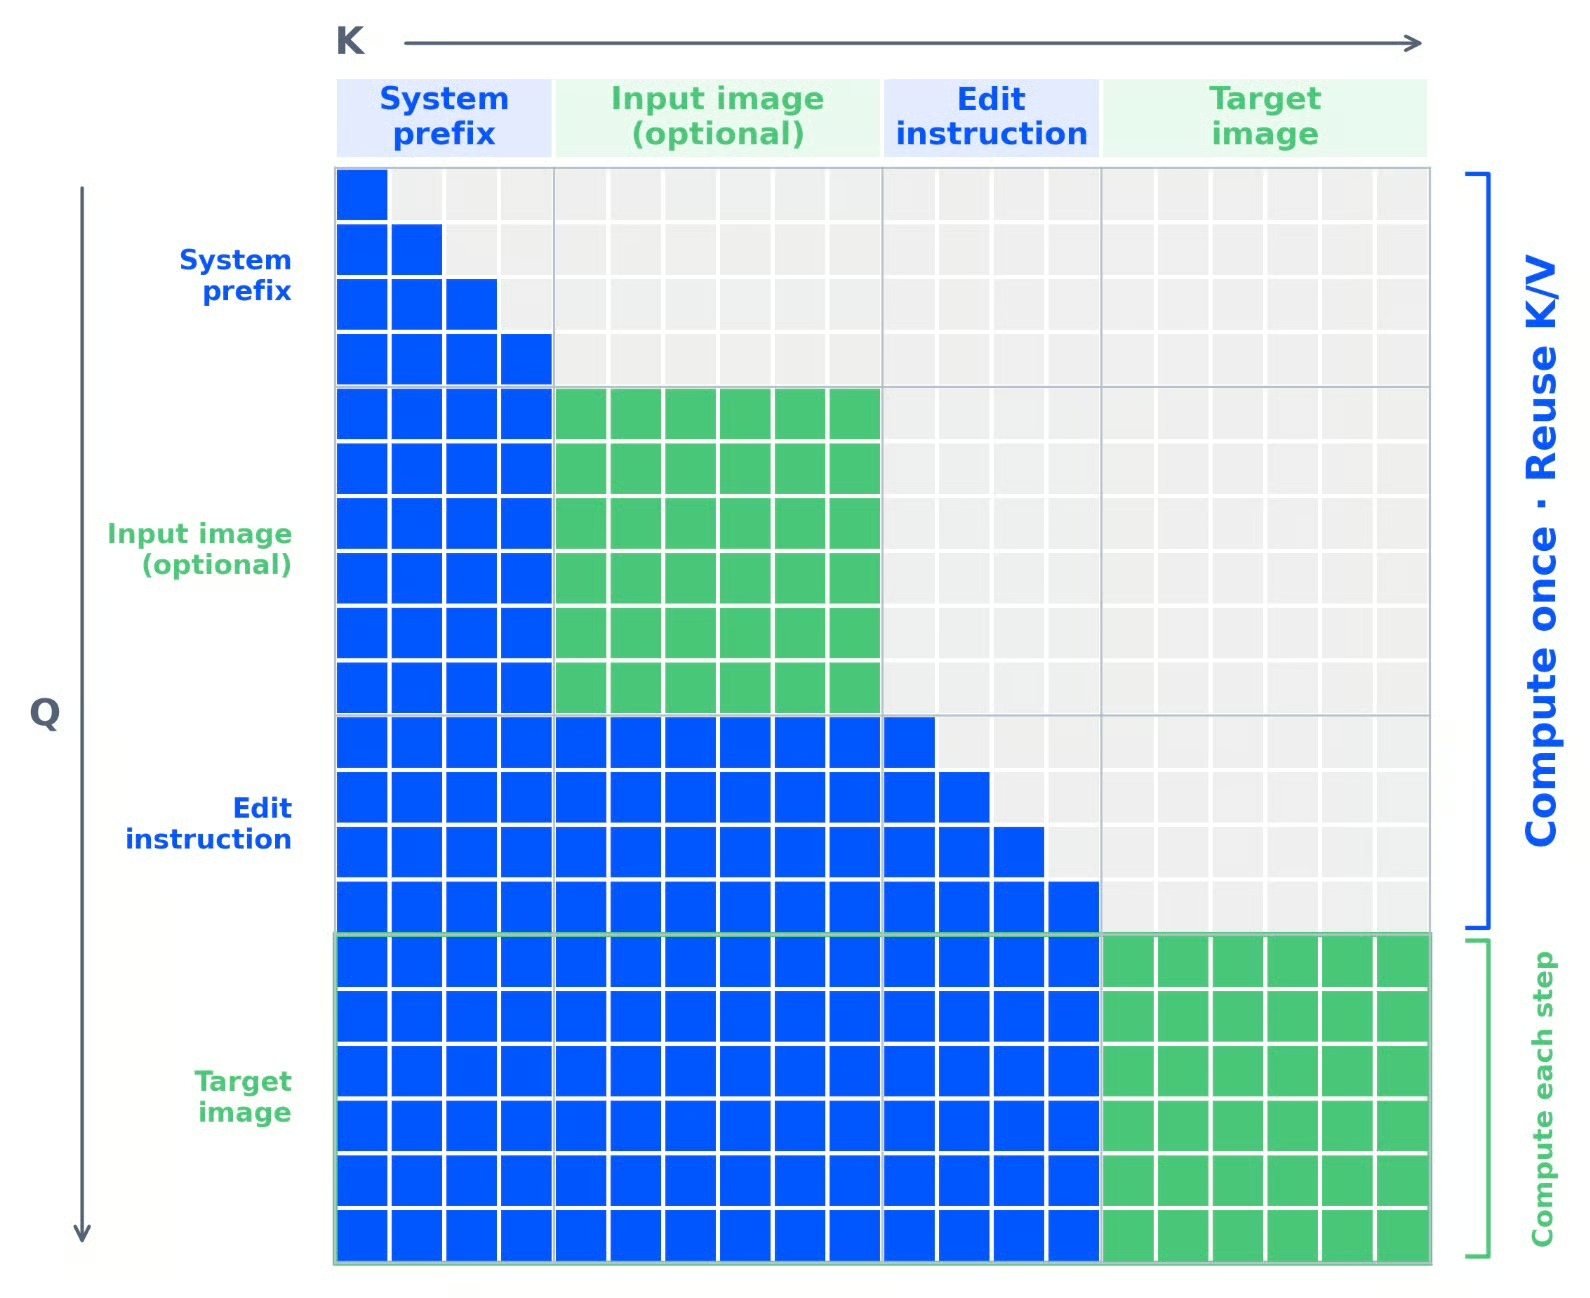
Figuur 1: Qwen Image 2.1 mixed-granularity attention-architectuur(Qwen-blogpost)
Lees het diagram per rij: Q staat voor de querytokens, en K voor de tokens waarnaar ze mogen attenderen. De sequentie bevat een systeemprefix, een optionele invoerafbeelding, een bewerkingsinstructie en de doelafbeelding.
Tekst gebruikt causale aandacht omdat een teksttoken naar zichzelf en eerdere posities kan attenderen. Tokens binnen hetzelfde afbeeldingsblok kunnen in beide richtingen naar elkaar attenderen.
Dit levert de driehoeksvormige tekstregio's en solide afbeeldingsblokken op die in figuur 1 te zien zijn.
De maskerregel drukt die combinatie uit als:
allowed = (q_idx >= kv_idx) or same_image_blockDit is een conceptuele regel voor een paar tokenposities, geen extra instelling om in de notebook te plakken. Het staat aandacht naar eerdere posities toe en laat all-to-all aandacht toe binnen elk afbeeldingsblok.
De systeemprefix, referentieafbeelding en instructie kunnen niet attenderen naar het latere doelafbeeldingsblok.
Hun representaties hoeven daarom niet te veranderen terwijl de doelafbeelding wordt bijgewerkt.
Qwen berekent hun attention keys en values één keer bij de eerste denoisingstap en hergebruikt ze in volgende stappen. De doelafbeeldingtokens vereisen nog steeds berekening bij elke stap, met aandacht voor de gecachete prefix en voor elkaar.
Met 40 stappen kan de vaste prefix na de eerste stap worden hergebruikt; dit betekent geen 40× snelheidswinst omdat er nog aanzienlijke doelafbeeldingberekening overblijft.
Dit cachehergebruik gebeurt over denoisingstappen binnen één generatie. Het betekent niet dat het model eerdere gebruikersverzoeken onthoudt, of dat onze app automatisch dezelfde cache hergebruikt over afzonderlijk ingediende bewerkingen.
Voordat we de app bouwen, scheiden we modelinstellingen van applicatiebeslissingen. Let op dat het verhogen van het aantal stappen geen pipeline repareert die steeds beschadigde afbeeldingen terug het model in voert.
|
Instelling |
Gebruikte waarde |
Waarom het ertoe doet |
|
Referentieafbeelding |
Originele afbeelding voor elke bewerking in de uiteindelijke app |
Voorkomt dat artefacten van het ene gegenereerde frame naar het volgende worden doorgegeven |
|
Resolutie |
1024 |
Ongeveer een bewerkingsdoel van één megapixel in deze backend |
|
Inferentiestappen |
40 |
Het samplingbudget dat in de hoofdexperimenten is gebruikt |
|
Seed |
42 |
Houdt de samplingseed vast tijdens het testen van instructies |
|
CFG |
1,0 |
Komt overeen met de geleverde workflow; standaard negative-branch guidance draagt niet bij bij deze waarde |
|
Sampler/scheduler |
Euler / simple |
Houdt de geleverde samplingconfiguratie ongewijzigd |
|
Denoise |
1,0 |
Past bij deze instructie-bewerkingsworkflow; het is geen conventioneel low-denoise img2img-recept |
|
VAE-decoding |
Niet getiled in de uiteindelijke configuratie |
Gekozen na een kwalitatieve verbetering tijdens de ontwikkeling |
|
Weights |
INT8 ConvRot imagemodel en tekstencoder; BF16 VAE |
De geheugenbewuste backend die in de demo is gebruikt |
|
CPU offload van encoder/referentiecache |
Aanvankelijk uitgeschakeld |
De A100-run paste zonder deze extra offload-instellingen in te schakelen |
Dit zijn werkende instellingen voor dit project, maar geen globaal optimale configuratie. We hebben geen systematische sweep gedaan van stappen, CFG, samplers of quantisatieformaten.
De samplervalidaties komen uit de image-edit-workflow, die me in staat stelde dit model met weinig VRAM te draaien.
De opgenomen runtime gebruikte een NVIDIA A100-SXM4-40GB, met 83,5 GiB host-RAM.
Ik gebruikte het alesha-pro-installatiepakket om ComfyUI te installeren en de gequantiseerde gewichten te downloaden.
Let op dat je grofweg 45 GB vrije opslagruimte moet inplannen, inclusief de omgeving, modellen, caches en outputs.
Een high-RAM-runtime geeft extra marge tijdens het laden en offloaden.
Stel eerst de paden in en controleer de GPU:
import sys, os, json, time, uuid, shutil, subprocess, copy, io, threading
from pathlib import Path
from PIL import Image, ImageDraw, ImageFilter, ImageOps
import numpy as np
import requests
import gradio as gr
from IPython.display import display, Image as DisplayImage

ROOT = Path('/content/qwen_gif_demo')
ROOT.mkdir(parents=True, exist_ok=True)
TOOLS = ROOT / 'tools'
COMFY = ROOT / 'ComfyUI'
RUNS = ROOT / 'runs'
RUNS.mkdir(exist_ok=True)
REPO_REV = 'dc0083c0d17581f04ebbca962771e36f82f31af8'
BASE = 'http://127.0.0.1:8188'

def run_cmd(args, **kwargs):
    print('Running:', ' '.join(map(str, args)), flush=True)
    subprocess.run(list(map(str, args)), check=True, **kwargs)

if not shutil.which('nvidia-smi'):
    raise RuntimeError('Select a GPU runtime before continuing.')
print(subprocess.check_output(['nvidia-smi'], text=True))
De GPU-check stopt de uitvoering als Colab nog een CPU-runtime gebruikt, en we printen ook details over host-RAM en vrije schijfruimte vóór de installatie.
De imports zijn vrij basic, inclusief Python's standaardbibliotheken, die padnamen, JSON-workflows, backendprocessen, timing en achtergrondmonitoring afhandelen.
Pillow en NumPy verwerken beeldbewerking, Requests communiceert met ComfyUI, Gradio levert de interface en IPython toont afbeeldingen in de notebook.
ComfyUI draait in een eigen virtuele omgeving. De notebookkernel verzorgt uploads, HTTP-verzoeken en Gradio.
if not TOOLS.exists():
    run_cmd(['git', 'init', TOOLS])
    run_cmd(['git', '-C', TOOLS, 'remote', 'add', 'origin', 'https://github.com/alesha-pro/tools.git'])
    run_cmd(['git', '-C', TOOLS, 'fetch', '--depth', '1', 'origin', REPO_REV])
    run_cmd(['git', '-C', TOOLS, 'checkout', '--detach', 'FETCH_HEAD'])
assert subprocess.check_output(['git', '-C', str(TOOLS), 'rev-parse', 'HEAD'], text=True).strip() == REPO_REV
PKG = TOOLS / 'qwen-image-2.1'
VERSIONS = json.loads((PKG / 'install/versions.json').read_text())
print('Pinned backend:', VERSIONS)
driver = subprocess.check_output(['nvidia-smi', '--query-gpu=driver_version', '--format=csv,noheader'], text=True).splitlines()[0]
# Conservative selector; the backend CUDA smoke test is authoritative.
TORCH_INDEX = 'https://download.pytorch.org/whl/cu130' if int(driver.split('.')[0]) >= 580 else 'https://download.pytorch.org/whl/cu128'
print('Driver:', driver, '| wheel index:', TORCH_INDEX)
run_cmd([sys.executable, PKG / 'install/setup.py', 'install', '--dir', COMFY, '--torch-index', TORCH_INDEX])
BACKEND_PY = COMFY / '.venv/bin/python'
run_cmd([BACKEND_PY, '-c', "import torch; print(torch.__version__, torch.version.cuda); print(torch.cuda.get_device_name(0)); x=torch.ones(16,device='cuda'); print(x.sum().item())"])
run_cmd([BACKEND_PY, PKG / 'install/download_models.py', '--models-dir', COMFY / 'models'])
Deze code haalt de gepinde bron op, leest de versieconfiguratie, installeert de backend, test een CUDA-tensoroperatie en downloadt de modellen.
De CUDA-wielselectie gebruikt de driverversie als eerste heuristiek.
De CUDA smoke test is een belangrijke verificatie, omdat een A100 op zich geen compatibiliteit met elke PyTorch-build garandeert. Mijn sessie gebruikte driver 580.82.07.
De opstartcel start ComfyUI op 127.0.0.1:8188, wacht tot het klaar is en haalt de beschikbare nodedefinities op.
De code communiceert ermee via een kleine HTTP-helper:
def api(path, body=None):
    r = requests.get(BASE + path, timeout=30) if body is None else requests.post(BASE + path, json=body, timeout=30)
    if not r.ok:
        raise RuntimeError(f'{path}: HTTP {r.status_code}: {r.text[:3000]}')
    return r.json()
Deze helper zet server-side fouten om in leesbare exceptions. Na opstart is het nodeschema beschikbaar via:
INFO = api('/object_info')De opstartcode controleert op een bestaande server voordat er een nieuw proces wordt gestart. Er is dus geen aparte publieke ComfyUI-tunnel in deze setup.
Stel nu de parameters in die we voor het bewerken gebruiken:
CPU_ENCODER = False
CPU_REFERENCE_CACHE = False
TILED_VAE = False
STEPS = 40
SIZE = 1024
SEED = 42
Zo interpreteer je deze instellingen:
STEPS: Meer samplingiteraties kosten doorgaans meer tijd. Wij gebruikten 40.SIZE: In de edit-graph target resolutie 1024 ongeveer één megapixel, terwijl de afmetingen zich aanpassen aan de referentie. Het forceert geen vierkante output.SEED: Een vaste seed maakt vergelijkingen binnen dezelfde setup eenvoudiger. Het garandeert geen identiteitsbehoud of vloeiende overgangen tussen verschillende prompts.TILED_VAE: Niet-getilede decoding verwerkt de afbeelding zonder het geconfigureerde small-tile decode-pad. Het kan meer geheugen vereisen. Onze voorkeur kwam voort uit visuele tests, niet uit een gecontroleerd bewijs dat tiling elk artefact veroorzaakte.Een negatieve prompt is evenmin de primaire regelaar bij CFG 1. Laat die leeg in plaats van te verwachten dat een lange lijst ongewenste eigenschappen een zwakke bewerking repareert.
De workflowbouwer laadt een API-graph en vervangt de verzoekspecifieke inputs. De volgende snippet toont het bewerkingspad:
g = json.loads((PKG / 'workflows/api/03-image-edit.json').read_text())
g['4']['inputs'].update(prompt=prompt, resolution=SIZE)
g['6']['inputs'].update(seed=int(seed), steps=int(STEPS))
g['9']['inputs']['image'] = upload_image(image_path)

if CPU_REFERENCE_CACHE:
    g['11']['inputs']['device'] = 'cpu'
if CPU_ENCODER:
    g['2']['inputs']['device'] = 'cpu'
Hier ontvangt node 4 de bewerkingsinstructie en resolutie.
Node 6 regelt het samplen, en node 9 laadt de geüploade referentie.
De andere twee overrides verplaatsen optioneel encoder- of referentiecachewerk naar het hostgeheugen.
De inferentiehelper dient vervolgens de graph in en wacht op zijn eigen request-ID:
response = api('/prompt', {
    'prompt': g,
    'client_id': uuid.uuid4().hex,
})
result = collect_result(response['prompt_id'], folder)
Hier is folder de outputmap per verzoek die binnen infer() wordt aangemaakt.
De collector pollt de geschiedenis en downloadt de gegenereerde PNG zodra de bijbehorende job is voltooid.
We slaan ook de input, graph, inzending, geschiedenis en metrics op. Zo kun je het daadwerkelijke verzoek inspecteren wanneer een output er verkeerd uitziet.
Een timeout annuleert de GPU-job niet automatisch, dus bewaar de request-ID voordat je besluit opnieuw te proberen.
De uiteindelijke app heeft altijd een ongewijzigde referentie nodig om op terug te vallen. Het volgende uploadpad past oriëntatiecorrectie toe, vlakt transparantie af en voegt de afbeelding toe aan een vierkant canvas voordat deze aan het model wordt doorgegeven:
python
from google.colab import files
uploaded = files.upload()
assert len(uploaded) == 1, 'Upload exactly one image.'
with Image.open(io.BytesIO(next(iter(uploaded.values())))) as image:
    rgba = ImageOps.exif_transpose(image).convert('RGBA')
    background = Image.new('RGBA', rgba.size, (250, 240, 230, 255))
    original = Image.alpha_composite(background, rgba).convert('RGB')
    original = ImageOps.pad(original, (SIZE, SIZE), color=(250, 240, 230))

BASE_FRAME = ROOT / f'original-{uuid.uuid4().hex[:8]}.png'
original.save(BASE_FRAME)
Padding bewaart de beeldverhouding in plaats van het onderwerp uit te rekken. Maar het kan randen introduceren.
Een directe upload in de Gradio-editor volgt zijn eigen uploadhandler en kan de geüploade afmetingen behouden. Daarom controleert de app ook de kandidaatdimensies vóór export.
Kies voor het bewerken van poses een afbeelding met genoeg ruimte voor de gevraagde beweging en voeg een instructie toe passend bij de begrenzing.
Een tekening is nuttig wanneer het doel ambigu kan zijn, zoals het kiezen van één arm of één object in een drukke scène.
Het is volledig optioneel in onze applicatie.
De editor van Gradio levert de achtergrond, tekenlagen en samengestelde afbeelding, en de belangrijke regel voor ons eindontwerp is om de originele te laden en alleen de tekenlagen toe te voegen:
layers = editor_data.get('layers') or []
has_marks = any(
    np.any(np.asarray(layer.convert('RGBA'))[..., 3] > 0)
    for layer in layers if layer is not None
)
with Image.open(original_path) as image:
    source = image.convert('RGBA').copy()
if has_marks:
    for layer in layers:
        if layer is None:
            continue
        layer = layer.convert('RGBA')
        if layer.size != source.size:
            raise ValueError('Clear the drawing and redraw on the original.')
        source = Image.alpha_composite(source, layer)
Dit is de kernlogica binnen de edit-callback.
Het alphakanaal laat zien of een laag zichtbare markeringen bevat, zoals een cirkel, rechthoek of grove streek die je tekende; die kunnen allemaal als visuele aanwijzing dienen.
Deze markeringen zijn geen harde inpaintingmasker. Ze vertellen het model waar het zich op moet richten, maar garanderen niet dat pixels elders ongewijzigd blijven.
We kunnen de regiouitleg alleen toevoegen wanneer er markeringen bestaan:
region_instruction = (
    'The red hand-drawn marks identify the target region. '
    'For an outline, edit the enclosed area; for painted strokes, '
    'edit the indicated area. Remove the annotation marks '
    'from the final result. '
) if has_marks else ''

prompt = (
    'Edit <image1>. '
    + region_instruction
    + f'Requested change: {instruction.strip()} '
    + "Preserve unrelated content and the image's framing. "
    + "Keep the subject's identity and visual style consistent "
    + 'unless the requested change explicitly alters them.'
)
De bewaarclausule geeft het model aan wat belangrijk is, maar het blijft een instructie en geen garantie.
Voor een explicietere test, specificeer de beeldrelatieve zijde en de uiteindelijke pose, zoals:
instruction = (
    'Lower the arm on the right side of the image so it extends '
    'diagonally downward. Keep the other arm, face, body position, '
    'camera framing, and background unchanged.'
)
Vermijd "move it a little more" wanneer elk verzoek van het origineel start.
Het model ontvangt niet het eerdere gesprek of de laatst geaccepteerde pose.
De eerste versie van dit project genereerde een reeks door elke output als input voor het volgende verzoek te gebruiken:
result = edit_frame(manifest['frames'][-1], POSES[pose_index])
Dit gedrag heb ik voor de uiteindelijke app aangepast, omdat herhaald bewerken artefacten kan doorgeven: elk nieuw verzoek start immers met de vorige modeloutput.
In onze vroege plantenreeks werden latere afbeeldingen aanzienlijk rumoeriger.
Het uiteindelijke generatiepad gebruikt in plaats daarvan de originele referentie, optioneel geannoteerd:
input_path = ROOT / f'edit-input-{uuid.uuid4().hex[:8]}.png'
source.convert('RGB').save(input_path)
result_path = infer(
    'edit',
    prompt,
    seed=int(seed),
    image_path=input_path,
)
Dit verwijdert het feedbackpad via eerder gegenereerde afbeeldingen.
Het elimineert geen artefacten in individuele outputs, en het dwingt onafhankelijk gegenereerde frames niet om perfect te matchen.
Als één geaccepteerde afbeelding een roos bevat, erft het volgende verzoek die niet automatisch. Om de roos te behouden terwijl je de pose verandert, moeten we beide eisen opnemen:
instruction = (
    'Make the character hold a red rose in the hand on the right '
    'side of the image, with that arm extended downward. '
    'Preserve the other hand, face, background, and camera framing.'
)
Deze trade-off is nuttig voor het genereren van variaties vanuit een gemeenschappelijke referentie.
Voor taken die cumulatieve bewerkingen vereisen, kan een sequentiële workflow nog steeds passend zijn, maar die vraagt andere verwachtingen over geaccumuleerde wijzigingen.
De app scheidt het origineel, de geaccepteerde reeks en het in behandeling zijnde resultaat met behulp van Gradio's State-functie:
original_state = gr.State(initial_path)
frames_state = gr.State(initial_frames)
pending_state = gr.State(None)
De reeks start met het origineel en groeit alleen wanneer de gebruiker een kandidaat accepteert. De pending state bevat een gegenereerd bestand dat nog niet is geaccepteerd.
De centrale acceptatiebewerking is gegeven door:
updated_frames = list(frames) + [pending_path]Na deze update wist de volledige callback de in behandeling zijnde kandidaat en prompt, en zet de editor terug naar het origineel.
Verwerpen wist het in behandeling zijnde resultaat zonder geaccepteerde frames te wijzigen. Reset brengt de reeks terug naar één origineel frame en wist de huidige instructie en downloadoutput. Geen van beide acties vereist herladen van het model.
De uiteindelijke interface scheidt bewerken, opgeslagen frames en export in drie tabbladen.
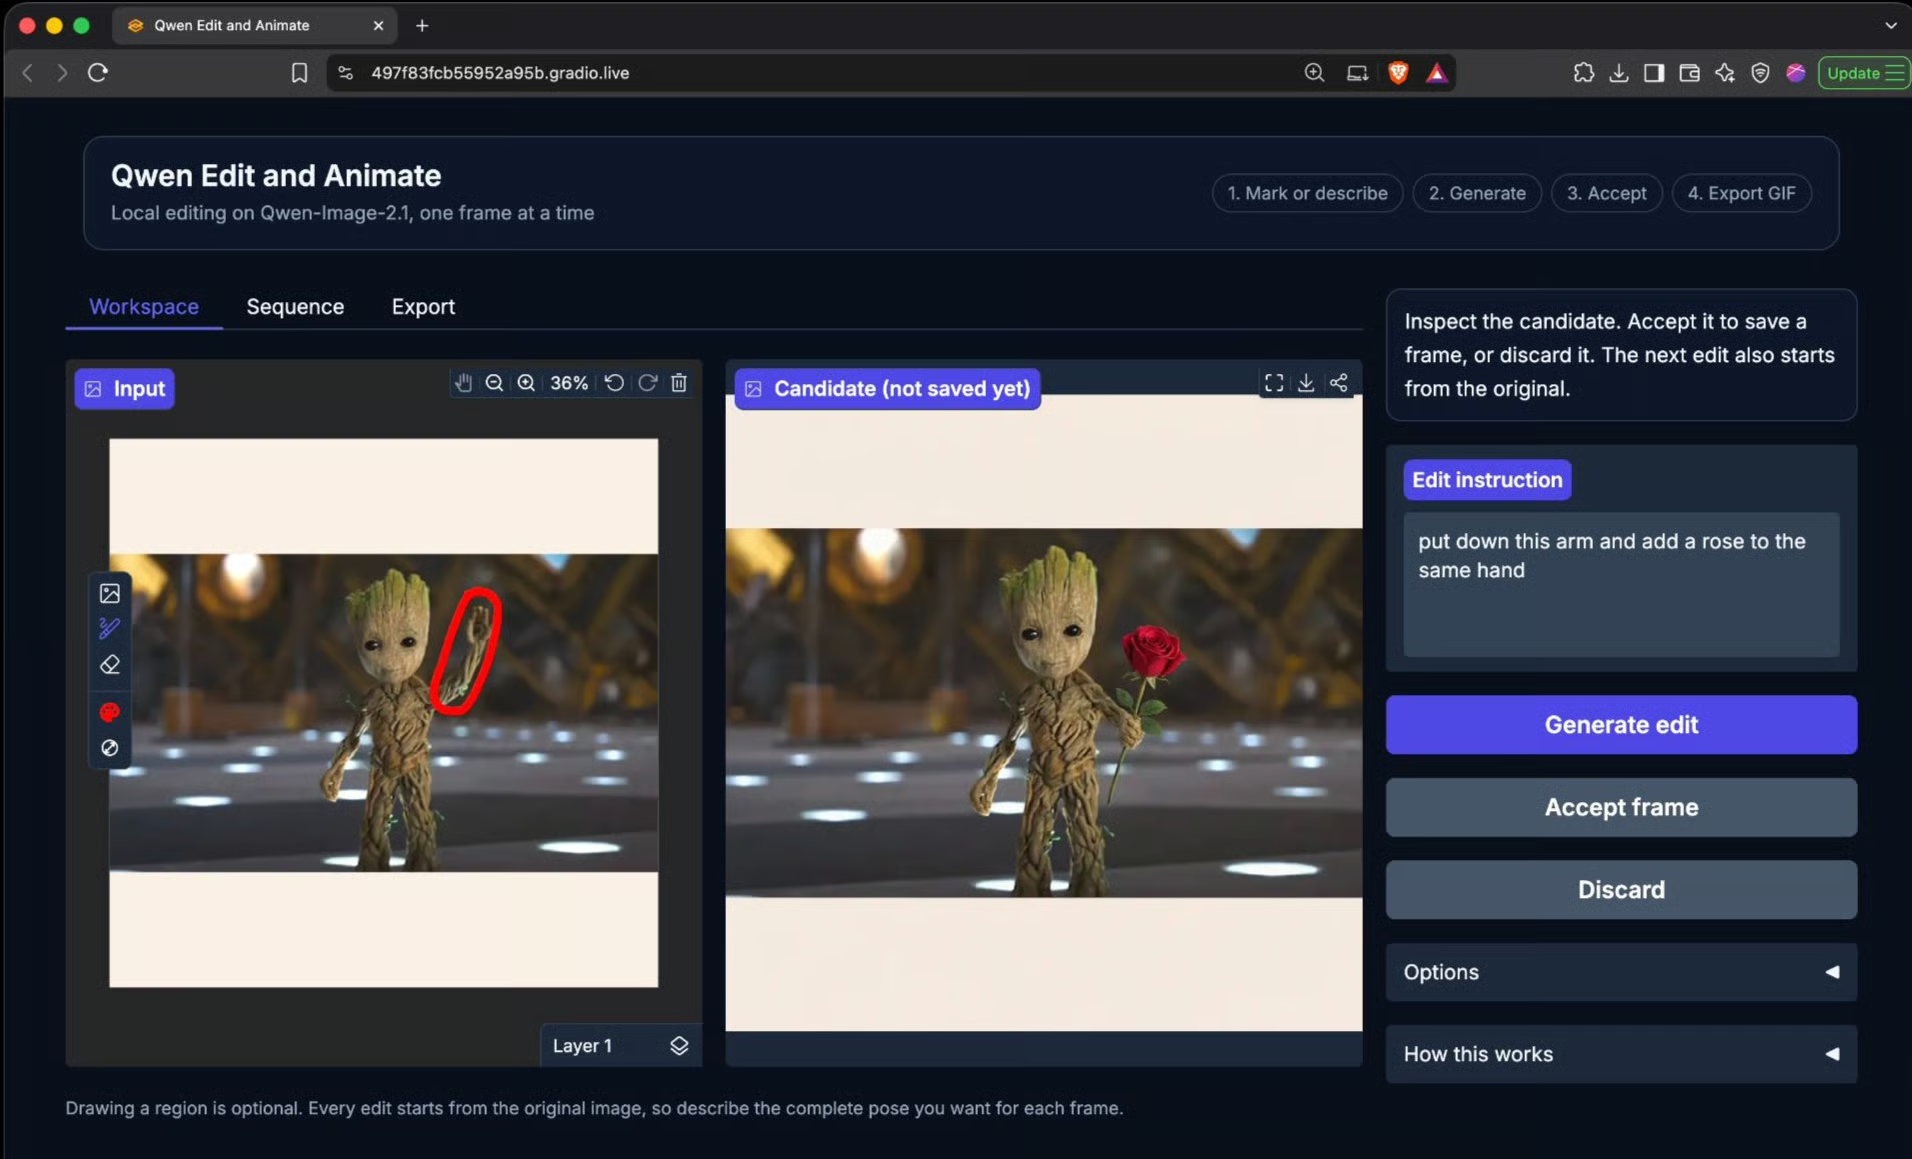
Het sleutelcomponent is de afbeeldingseditor:
editor = gr.ImageEditor(
    value=initial_editor,
    type='pil',
    image_mode='RGBA',
    label='Input',
    height=480,
    brush=gr.Brush(
        colors=['#ff0000'],
        color_mode='fixed',
        default_size=8,
    ),
    eraser=gr.Eraser(default_size=20),
    transforms=(),
)
De vaste penseelkleur sluit aan bij de annotatie-instructie.
De gum laat gebruikers ruwe regio's verfijnen, terwijl uitgeschakelde transformaties croppen en roteren buiten deze interactie houden.
De genereergebeurtenis geeft de originele state door aan de callback:
event_options = {
    'concurrency_id': 'edit_workflow',
    'concurrency_limit': 1,
}

generate_button.click(
    fn=generate_edit,
    inputs=[editor, instruction, seed, original_state],
    outputs=[candidate, pending_state, status],
    **event_options,
)
Deze codefragmenten horen binnen de complete Blocks-layout.
De gedeelde concurrencygroep serializeert generatie en statuswijzigingen in deze demo. Reset wacht op zijn beurt; het is geen GPU-jobannulering.
Zodra de handlers en componenten zijn gedefinieerd, start je de app met:
demo.queue(default_concurrency_limit=1).launch(
    share=True,
    debug=True,
)
De Gradio share-link stelt de frontend bloot, terwijl de backend op localhost blijft. Thema- en CSS-wijzigingen verbeteren de presentatie, maar veranderen de beeldkwaliteit niet.
De exporter gebruikt alleen geaccepteerde frames omdat hij een gemeenschappelijk palet maakt en de sequentie optioneel achterwaarts afspeelt na het laatste frame:
def export_gif(paths, destination, duration_ms=300, ping_pong=True):
    frames = []
    for path in paths:
        with Image.open(path) as image:
            frames.append(image.convert('RGB').copy())
    if len(frames) < 2:
        raise ValueError('Accept at least one edit first.')
    if len({frame.size for frame in frames}) != 1:
        raise ValueError('Frame dimensions must match.')

    atlas = Image.new('RGB', (128 * len(frames), 128))
    for i, frame in enumerate(frames):
        atlas.paste(frame.resize((128, 128)), (128 * i, 0))
    palette = atlas.quantize(colors=256)
    converted = [
        frame.quantize(palette=palette, dither=Image.Dither.NONE)
        for frame in frames
    ]
    if ping_pong:
        converted += converted[-2:0:-1]
    converted[0].save(
        destination,
        save_all=True,
        append_images=converted[1:],
        duration=int(duration_ms),
        loop=0,
        disposal=2,
        optimize=False,
    )
    return str(destination)
Een gedeeld palet vermindert een mogelijke bron van paletgerelateerde flikkering.
Dithering uitschakelen voorkomt dat er tijdens de conversie een ditherpatroon wordt toegevoegd, hoewel kleurreductie nog steeds banding kan introduceren.
Duration wordt gemeten in milliseconden, en door loop=0 in te stellen vraag je om continue weergave. Voor vier frames gebruikt pingpong-weergave de volgorde 0, 1, 2, 3, 2, 1.
De omgekeerde slice sluit herhaalde eindpunten uit. Dit interpoleert de beweging niet: voor vloeiendere animatie zijn geschikte tussenposes nodig, niet alleen een andere afspeelsnelheid.
We hebben een Qwen Image 2.1-editor gebouwd die tekstinstructies en optionele tekeningen accepteert, gebruikers afzonderlijke resultaten laat cureren en ze als een GIF exporteert.
De belangrijkste kwaliteitsbeslissing was om een vaste originele referentie te behouden in plaats van herhaaldelijk gegenereerde outputs te bewerken.
Begin met de werkende samplingconfiguratie, maak de gevraagde wijziging expliciet en inspecteer ruwe kandidaten voordat je meer instellingen aanpast.
Als die onderdelen stabiel zijn, experimenteer dan met resolutie of decoding, één variabele tegelijk. Het resultaat is een bruikbare workflow voor beeldbewerking met een helder beeld van zowel de mogelijkheden als de beperkingen.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

