

Program
Mengembangkan Aplikasi dengan LangChain
9 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleQwythos-9B-Claude-Mythos-5-1M adalah model penalaran open-weight 9B berbasis Qwen3.5-9B dan dilatih pada Claude Mythos dan jejak penalaran Fable.
Model ini menonjol karena menggabungkan kemampuan penalaran dan penggunaan alat yang kuat dengan jendela konteks 1M token, function calling native, serta penerapan lokal yang praktis melalui kuantisasi GGUF.
Versi MTP juga mendukung prediksi multi-token dan speculative decoding pada build llama.cpp terbaru, membantu meningkatkan kecepatan generasi untuk alur kerja agen lokal.
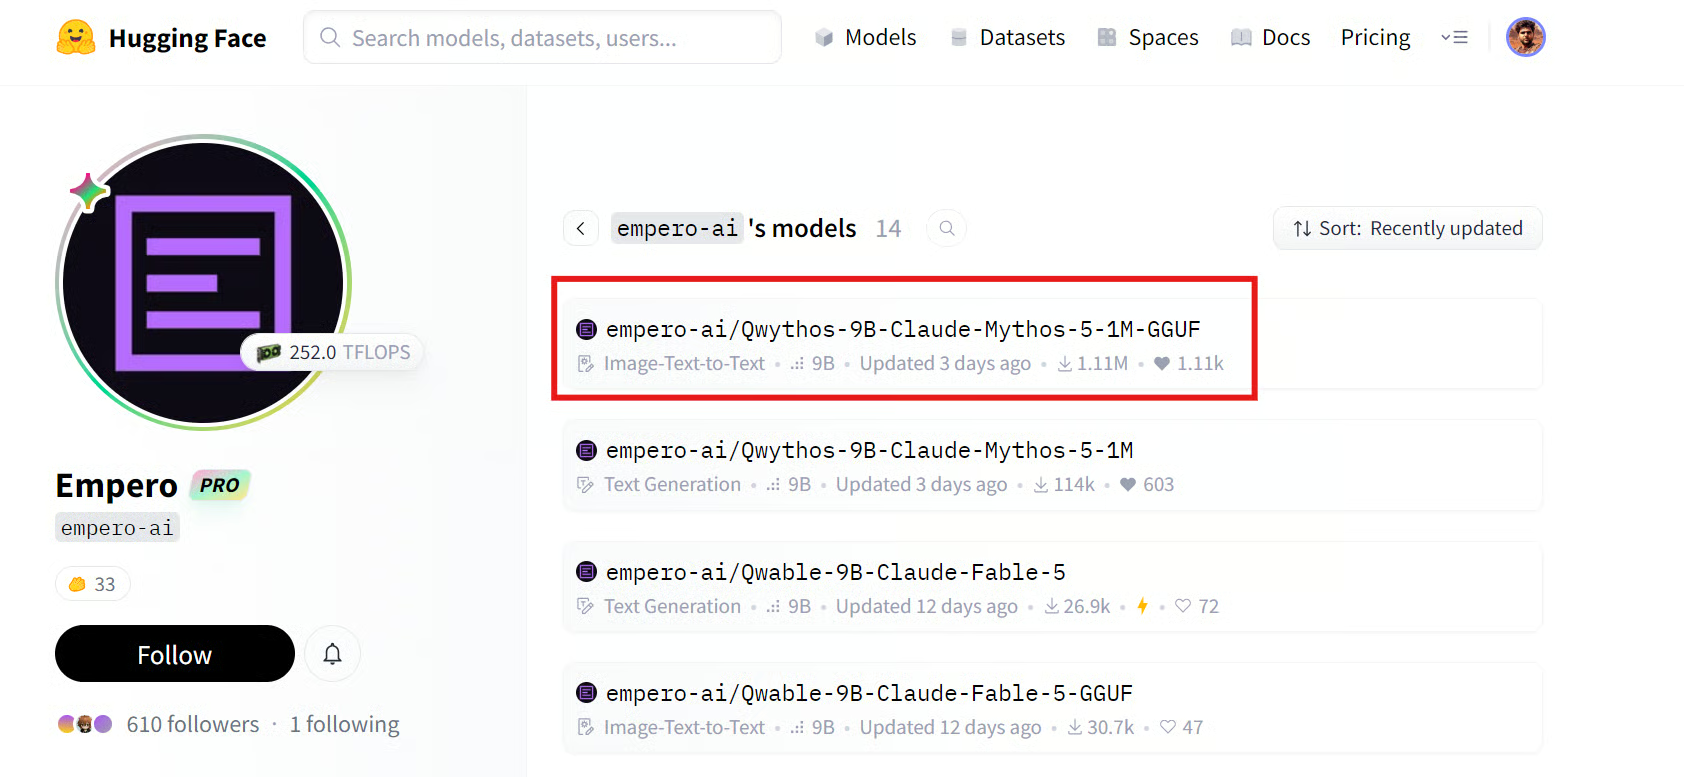
Sumber: empero-ai (Empero)
Dalam panduan ini, saya akan menunjukkan cara menjalankan Qwythos-9B MTP Q6_K GGUF secara lokal dengan llama.cpp dan menghubungkannya ke Hermes Agent di terminal, browser, dan Discord.
Anda akan mengunduh model, meluncurkan endpoint lokal yang kompatibel dengan OpenAI, mengonfigurasi Hermes untuk menggunakannya, menyiapkan Hermes Messaging Gateway untuk akses Discord, dan menyiapkan Hermes WebUI.
Untuk setelan ini, saya menggunakan RTX 5060 Ti dengan VRAM 16 GB. Qwythos 9B Q6_K MTP quant dapat berjalan secara lokal pada GPU ini, meskipun panjang konteks yang dapat digunakan akan bergantung pada VRAM yang tersedia dan pengaturan KV-cache.
Instal build llama.cpp terbaru menggunakan penginstal resmi:
curl -LsSf https://llama.app/install.sh | shTambahkan biner llama.cpp ke path shell Anda dan mulai ulang terminal:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
Verifikasi bahwa instalasi berhasil:
llama helpInstal Hugging Face CLI dan hf-xet, yang dapat mempercepat unduhan untuk repositori yang menggunakan penyimpanan Xet:
pip install -U "huggingface_hub[cli]" hf-xetBuat folder untuk file model:
MODEL_DIR="/workspace/qwythos"
mkdir -p "$MODEL_DIR"
Sebagian besar laptop dengan GPU dedicated memiliki sekitar 6–8 GB VRAM, sehingga Q4 MTP quant menjadi pilihan yang lebih praktis untuk sistem tersebut. Ini menggunakan lebih sedikit VRAM sekaligus tetap memberi Anda kepala prediksi MTP yang diperlukan untuk speculative decoding.
Saya menggunakan RTX 5060 Ti dengan VRAM 16 GB, yang memberi saya ruang lebih untuk menjalankan Q6_K quant berkualitas lebih tinggi dan bereksperimen dengan jendela konteks yang lebih besar.
Aktifkan transfer berperforma tinggi, lalu unduh Q6_K MTP quant:
export HF_XET_HIGH_PERFORMANCE=1Unduh file GGUF model Qwythos 6-bit:
hf download \
  empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF \
  --include "Qwythos-9B-Claude-Mythos-5-1M-MTP-Q6_K.gguf" \
  --local-dir "$MODEL_DIR"
File Q6_K MTP adalah versi kuantisasi Qwythos yang lebih berkualitas yang menyertakan kepala prediksi multi-token yang diperlukan untuk speculative decoding.
Buka terminal baru dan arahkan ke folder tempat Anda mengunduh model:
MODEL_DIR="/workspace/qwythos"Lalu mulai llama.cpp dengan model Qwythos MTP:
llama serve \
  -m "$MODEL_DIR/Qwythos-9B-Claude-Mythos-5-1M-MTP-Q6_K.ggUF" \
  --alias qwythos-9b-mtp \
  --host 0.0.0.0 \
  --port 8910 \
  --n-gpu-layers all \
  --ctx-size 100000 \
  --parallel 1 \
  --batch-size 1024 \
  --ubatch-size 512 \
  --flash-attn on \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 6 \
  --threads 12 \
  --threads-batch 24 \
  --temp 0.6 \
  --top-p 0.95 \
  --top-k 20 \
  --repeat-penalty 1.05 \
  --jinja \
  --perf
Pengaturan terpenting adalah --n-gpu-layers all dan --ctx-size 100000. Yang pertama memindahkan seluruh model ke GPU Anda untuk inferensi yang jauh lebih cepat, sementara yang kedua memberikan Qwythos jendela konteks 100K token yang besar. Jendela konteks yang lebih besar membutuhkan lebih banyak VRAM, jadi kurangi ini menjadi 32768 atau lebih rendah pada GPU dengan memori terbatas.
Qwythos menggunakan prediksi multi-token, sehingga --spec-type draft-mtp diperlukan untuk model MTP ini. Pengaturan --spec-draft-n-max 6 memungkinkan llama.cpp mencoba memprediksi hingga enam token ke depan, yang dapat meningkatkan kecepatan generasi, terutama untuk tugas terstruktur seperti pengkodean.
--flash-attn on meningkatkan efisiensi attention, sementara pengaturan KV-cache Q8 membantu menjaga kualitas untuk prompt yang lebih panjang. Opsi --temp, --top-p, dan --top-k mengontrol kreativitas respons, dengan nilai-nilai ini memberikan hasil yang seimbang untuk tugas pengkodean dan agen.
Endpoint lokal yang kompatibel dengan OpenAI akan tersedia di:
http://127.0.0.1:8910/v1Anda juga dapat menempelkan URL http://localhost:8910 ke browser untuk membuka antarmuka web llama.cpp dan menguji model secara langsung. Ini berguna untuk cepat memeriksa respons sebelum menghubungkan model ke Hermes.
Untuk uji dasar, saya meminta Qwythos berbagi fakta menarik acak. Model merespons dengan fakta tentang Bima Sakti dan menghasilkan sekitar 64 token per detik rata-rata.
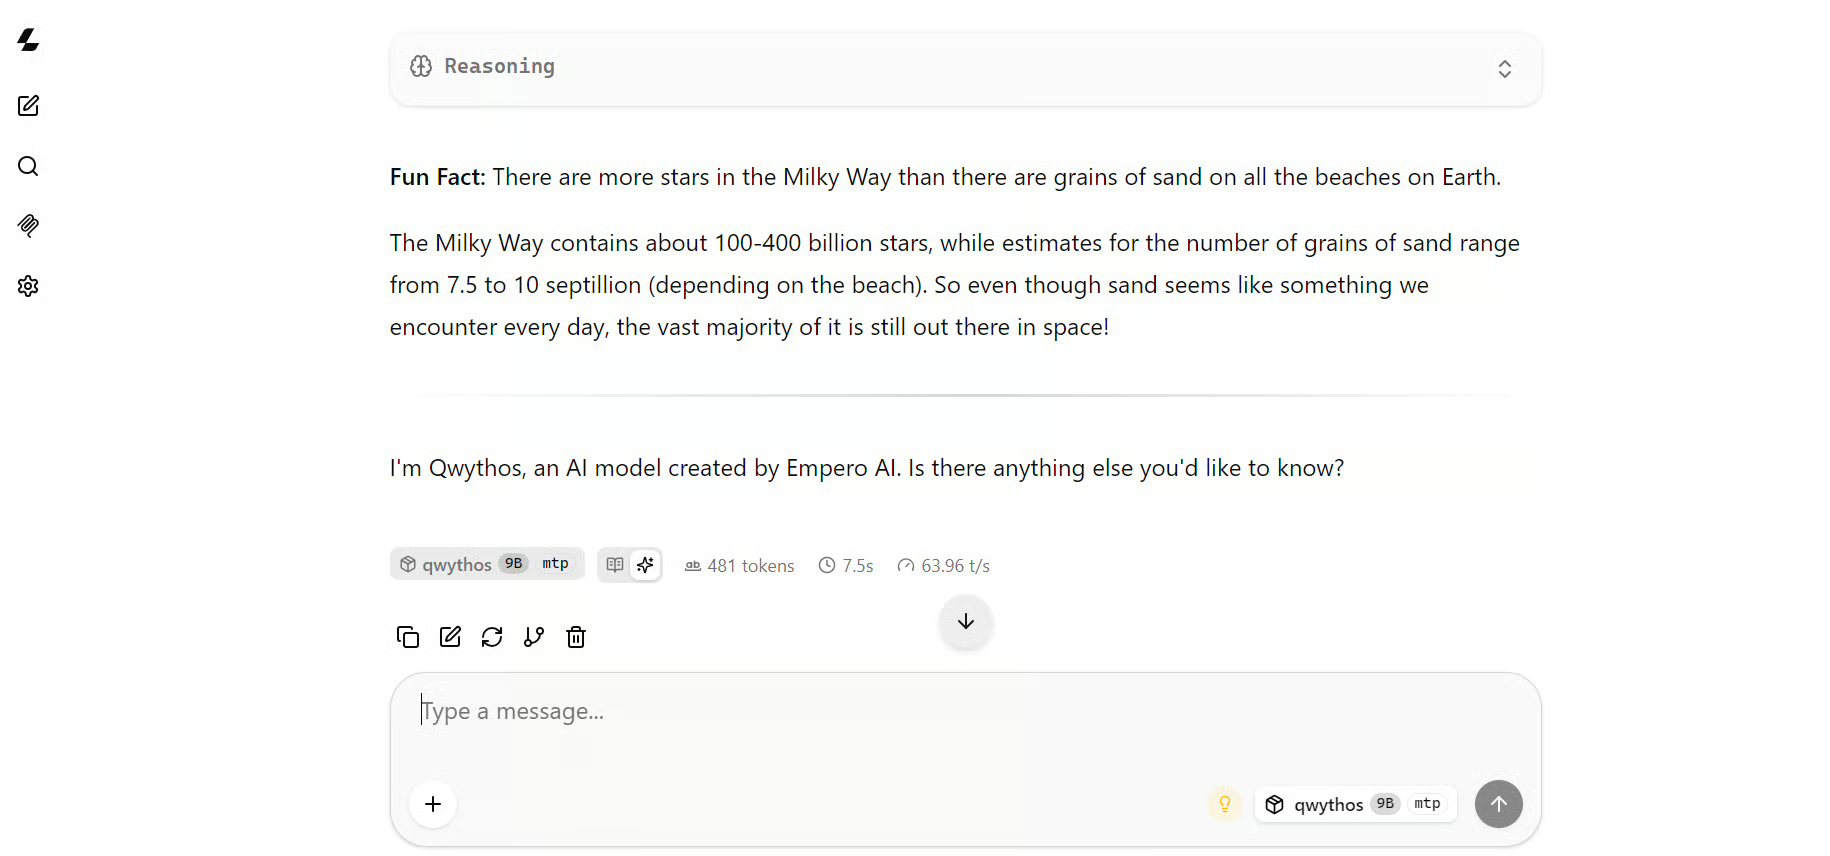
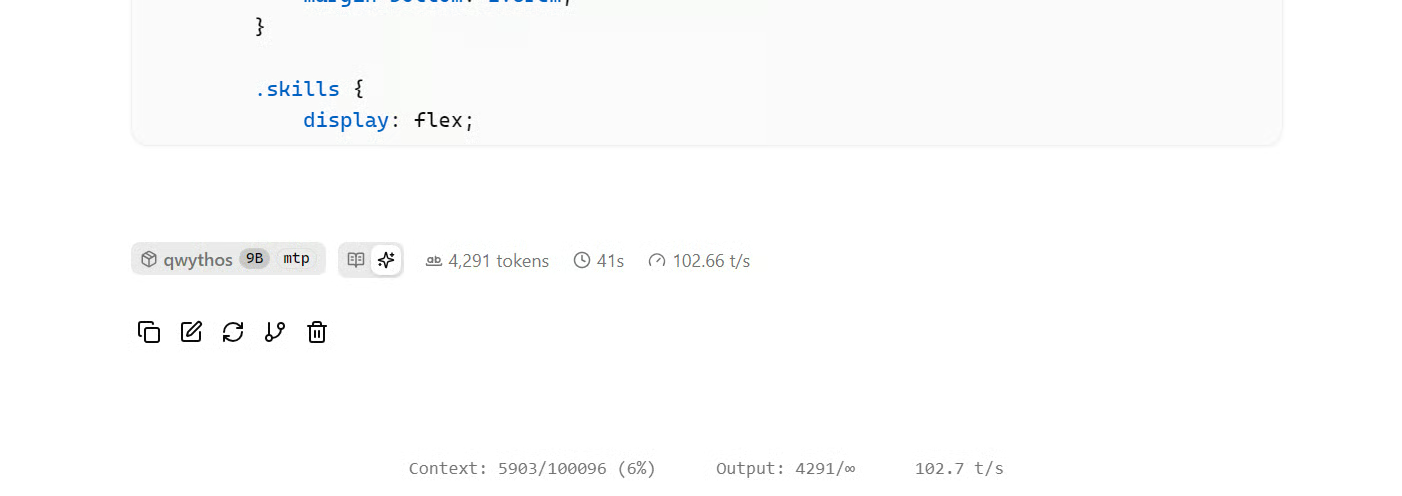
Kemudian saya memintanya membangun situs web portofolio HTML lengkap.
Selama pengkodean, kecepatan generasi meningkat menjadi sekitar 102 token per detik, kemungkinan karena model MTP dapat memprediksi beberapa token berikutnya yang mungkin dengan lebih efektif pada kode terstruktur.
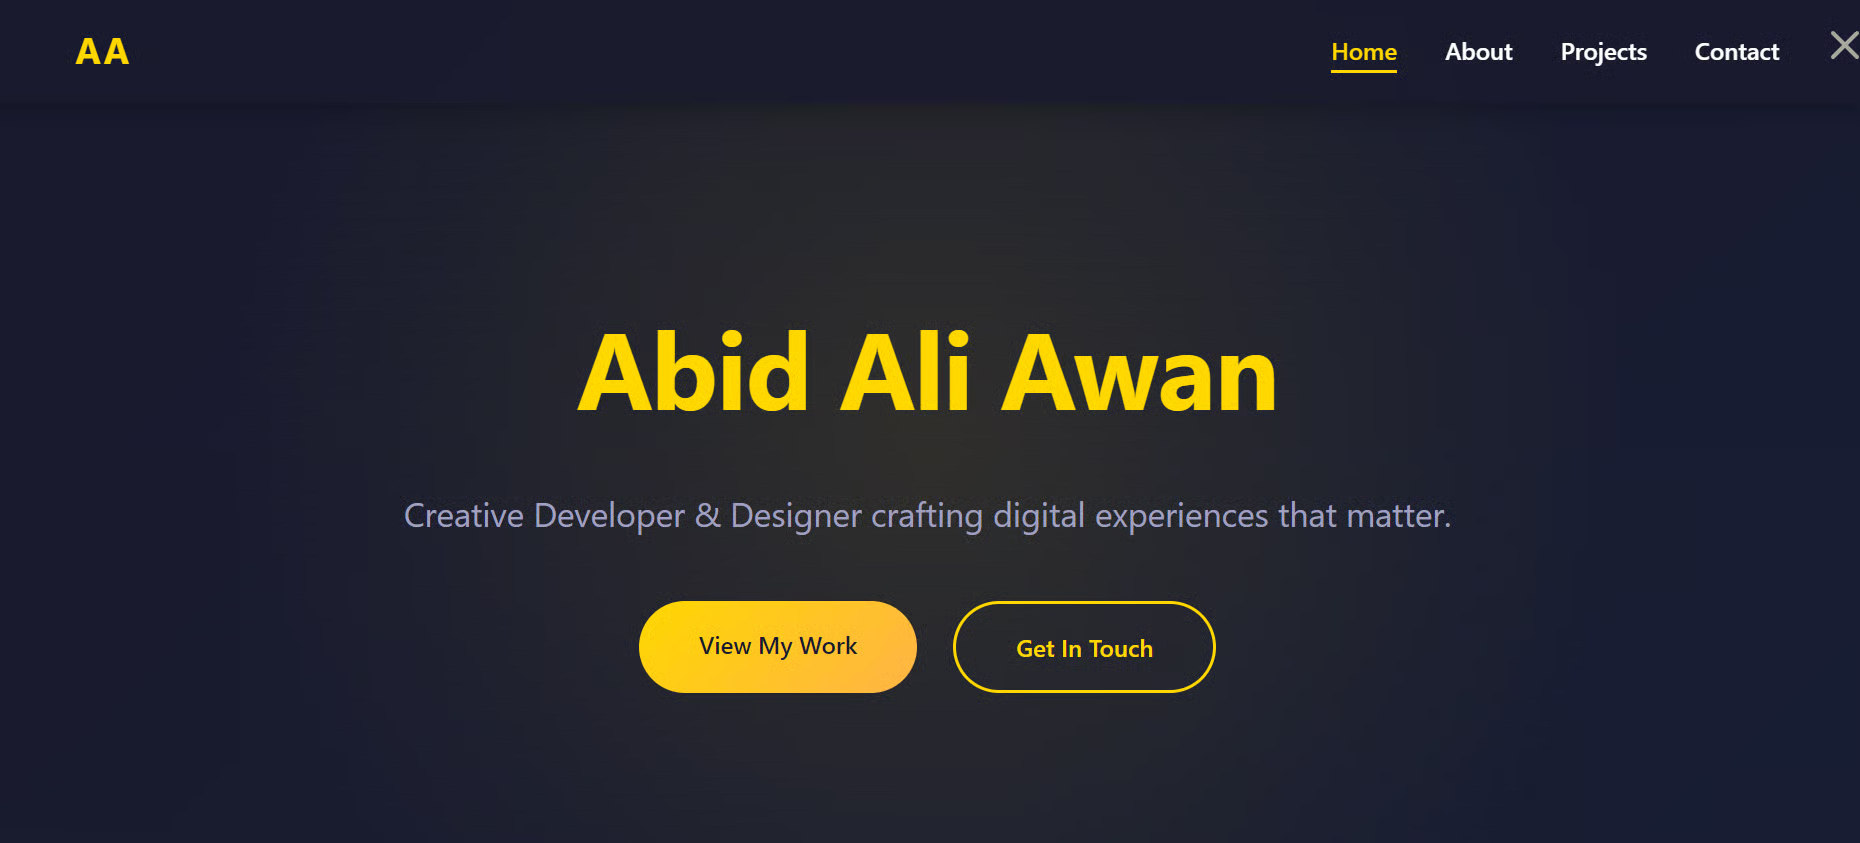
Hasil akhirnya adalah situs web portofolio yang rapi dan berfungsi dengan tata letak yang kuat dan gaya yang bersih. Untuk model 9B yang berjalan lokal, kualitas outputnya benar-benar mengesankan.
Buka terminal lain dan instal Hermes Agent:
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bashSelama penyiapan, pilih Full Setup agar Anda dapat mengonfigurasi endpoint lokal kustom.
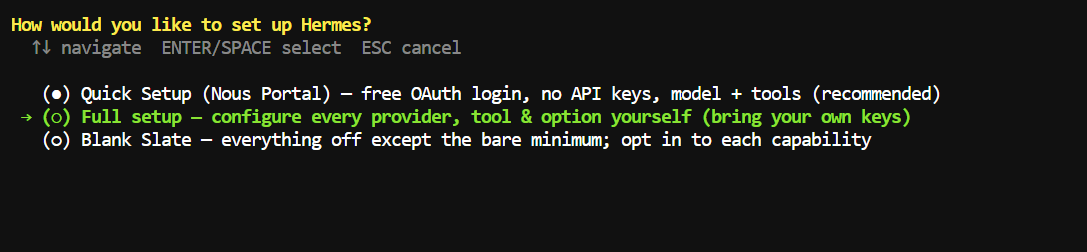
Lalu pilih Custom endpoint dan masukkan alamat server llama.cpp Anda:
Base URL: http://127.0.0.1:8910/v1
API key: leave blank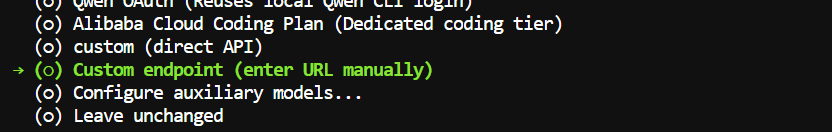
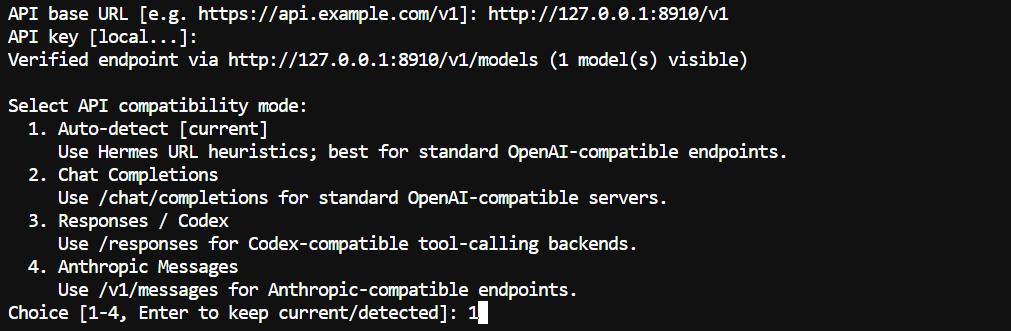
Hermes harus memverifikasi endpoint dan mendeteksi model Qwythos yang berjalan dari llama.cpp.
Untuk mode kompatibilitas API, biarkan opsi default Auto-detect. Ini bekerja baik dengan endpoint standar yang kompatibel dengan OpenAI seperti llama.cpp.
Selanjutnya, pilih Local sebagai backend terminal.
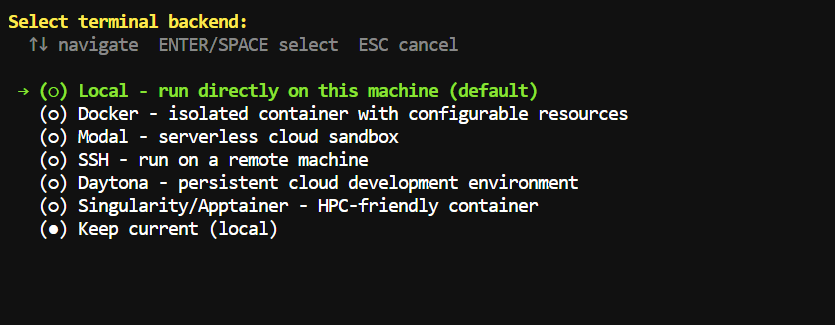
Ini memungkinkan Hermes berjalan langsung di mesin Anda dan mengakses folder tempat Anda meluncurkannya.
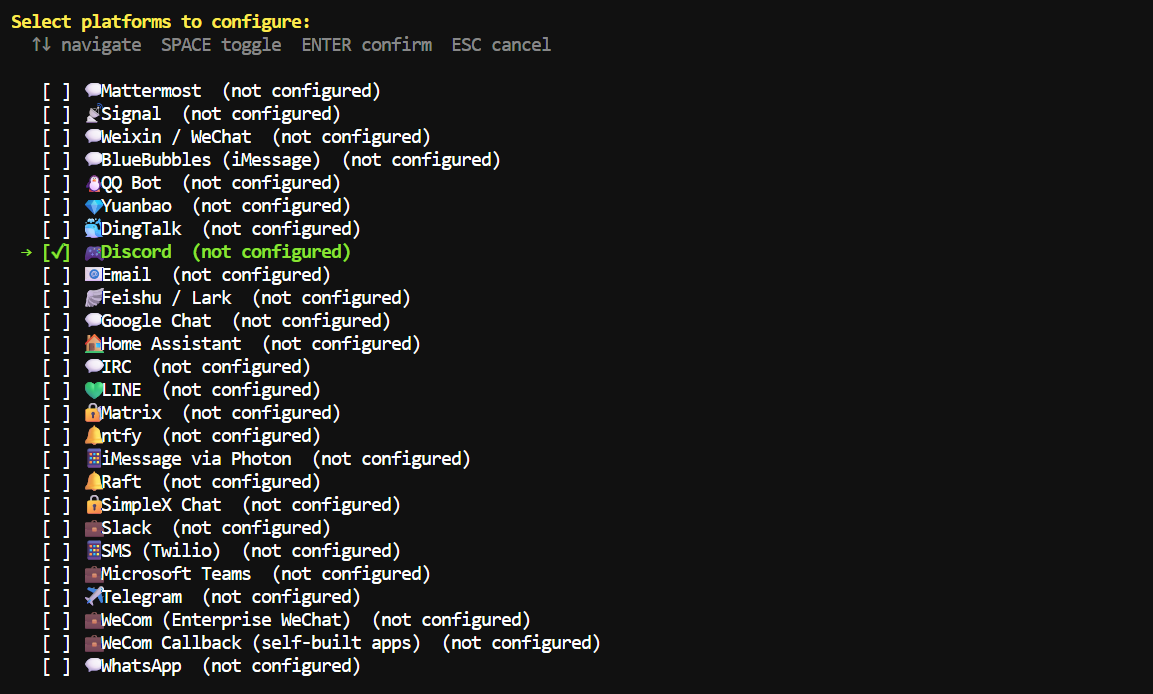
Anda juga dapat memilih Discord selama penyiapan platform jika ingin mengonfigurasi messaging gateway sekarang, tetapi Anda bisa melewatinya dan menambahkannya nanti.
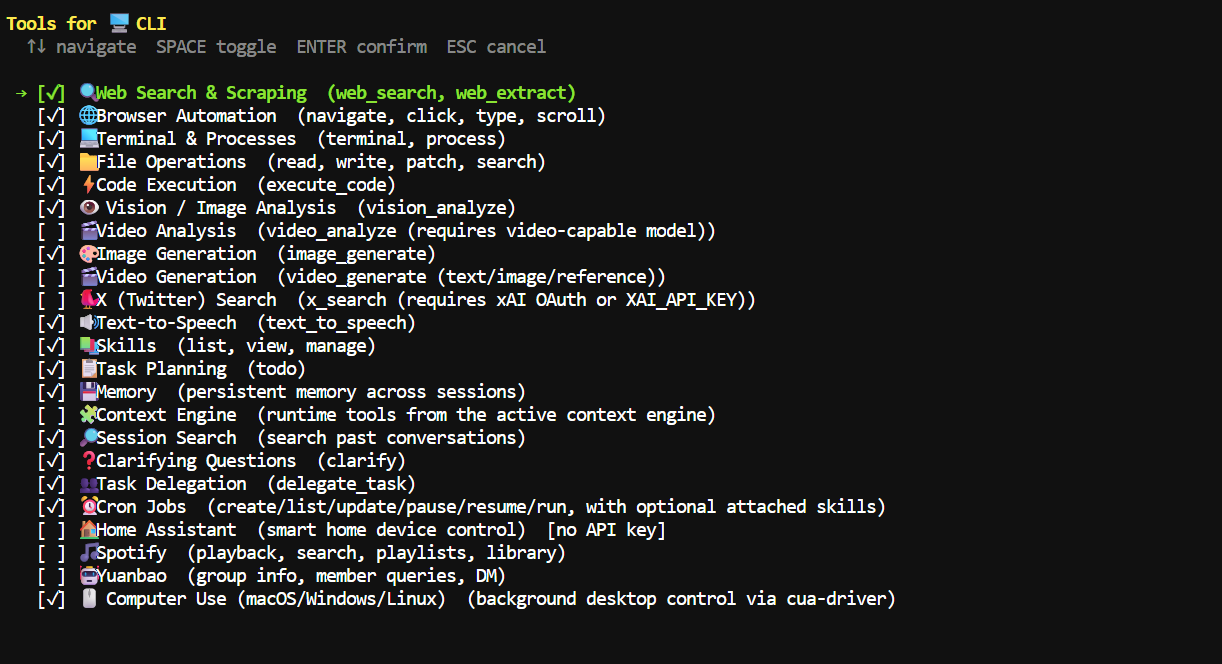
Saat memilih alat, aktifkan yang Anda perlukan untuk alur kerja Anda.
Untuk tugas pengkodean, yang utama adalah File Operations, Terminal & Processes, Code Execution, dan opsional Web Search & Scraping.
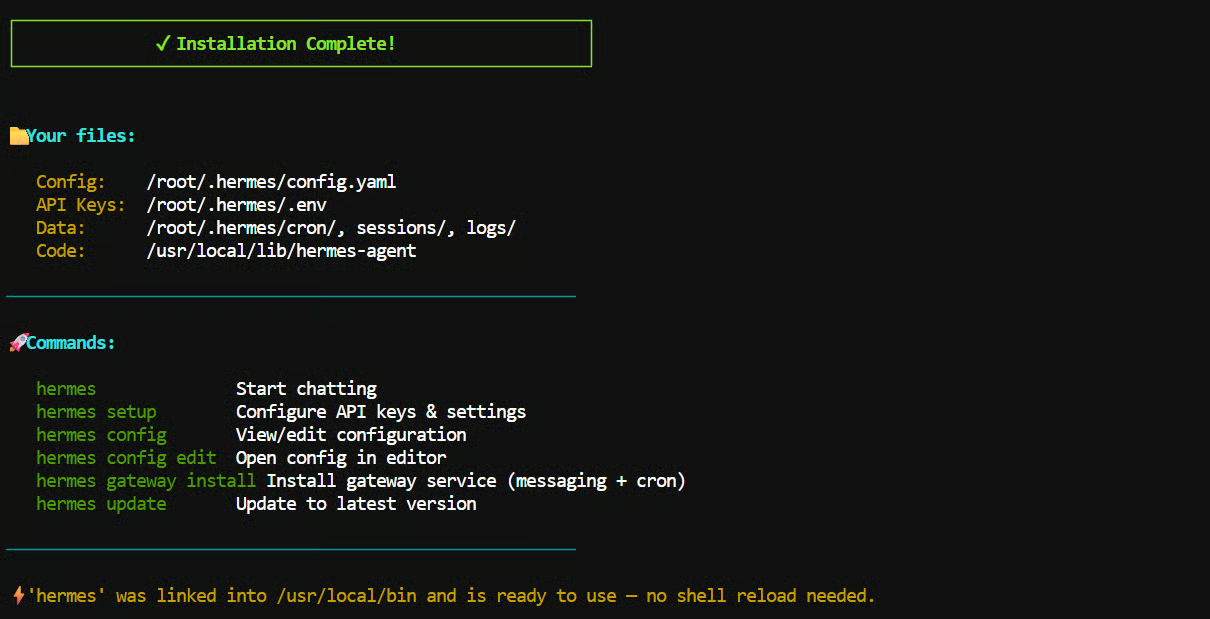
Hermes kemudian akan menyelesaikan instalasi dan menyimpan konfigurasinya di ~/.hermes/.
Jika Anda mengonfigurasi layanan API nanti, simpan kunci API-nya sebagai variabel lingkungan alih-alih menambahkannya langsung ke perintah atau file konfigurasi.
Misalnya, untuk OpenAI dan Tavily:
export OPENAI_API_KEY="your_openai_api_key"
export TAVILY_API_KEY="your_tavily_api_key"
Hermes sekarang siap.
Pindah ke folder yang berisi proyek yang ingin Anda kerjakan dengan Hermes.
Untuk contoh ini, saya membuat workspace baru:
mkdir /workspace/nonus
cd /workspace/nonus
Lalu jalankan Hermes:
hermes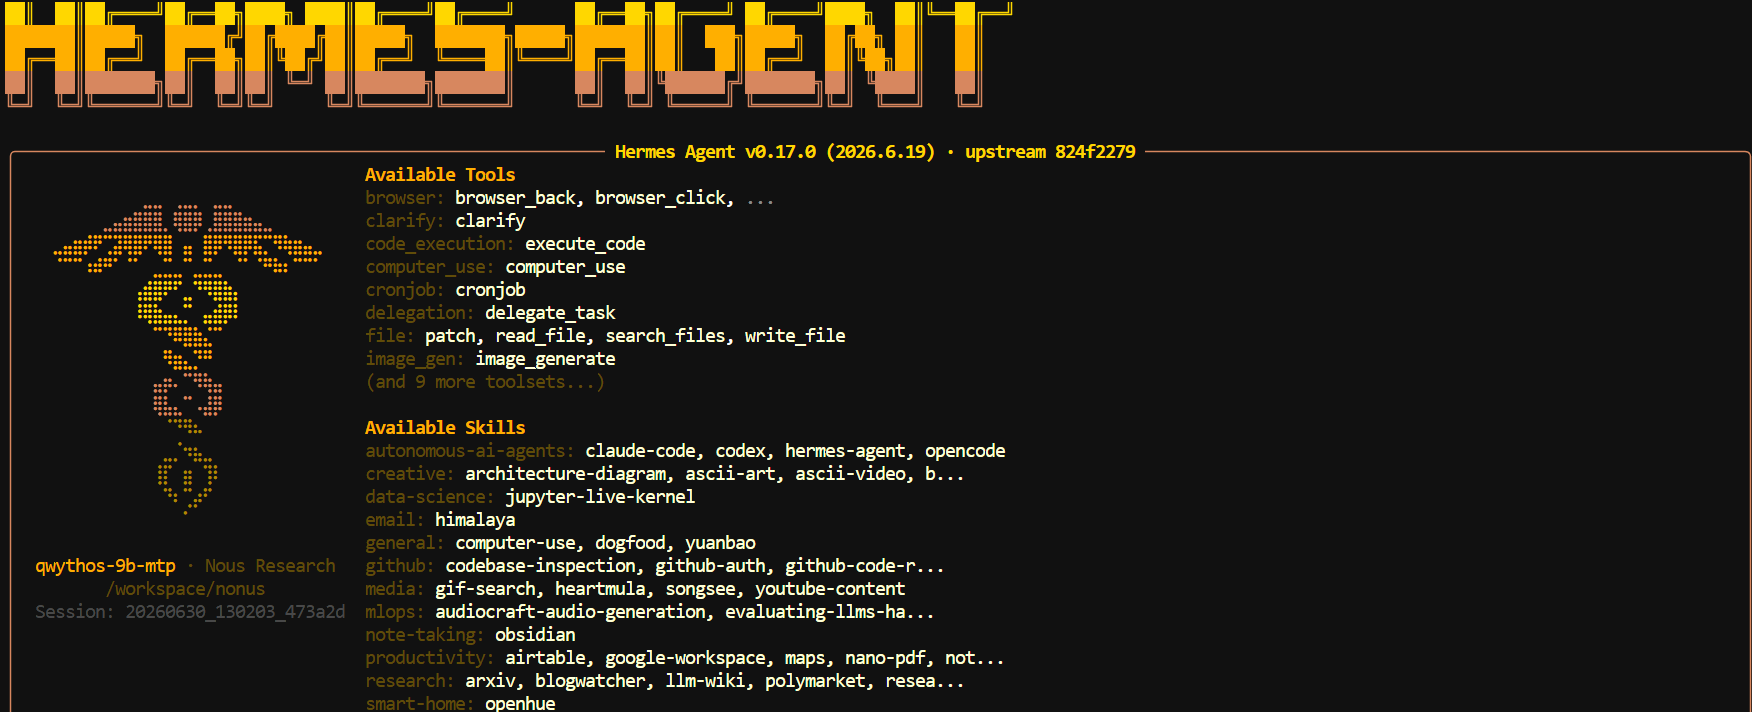
Hermes terbuka langsung di dalam folder proyek Anda dan terhubung ke model Qwythos lokal melalui endpoint llama.cpp yang Anda konfigurasikan sebelumnya.
Ia dapat memeriksa file, menulis kode, menjalankan perintah terminal, dan menggunakan alat yang Anda aktifkan saat penyiapan.
Pertama saya meminta Hermes membangun aplikasi prediksi saham kecil berbasis Flask dengan antarmuka HTML.
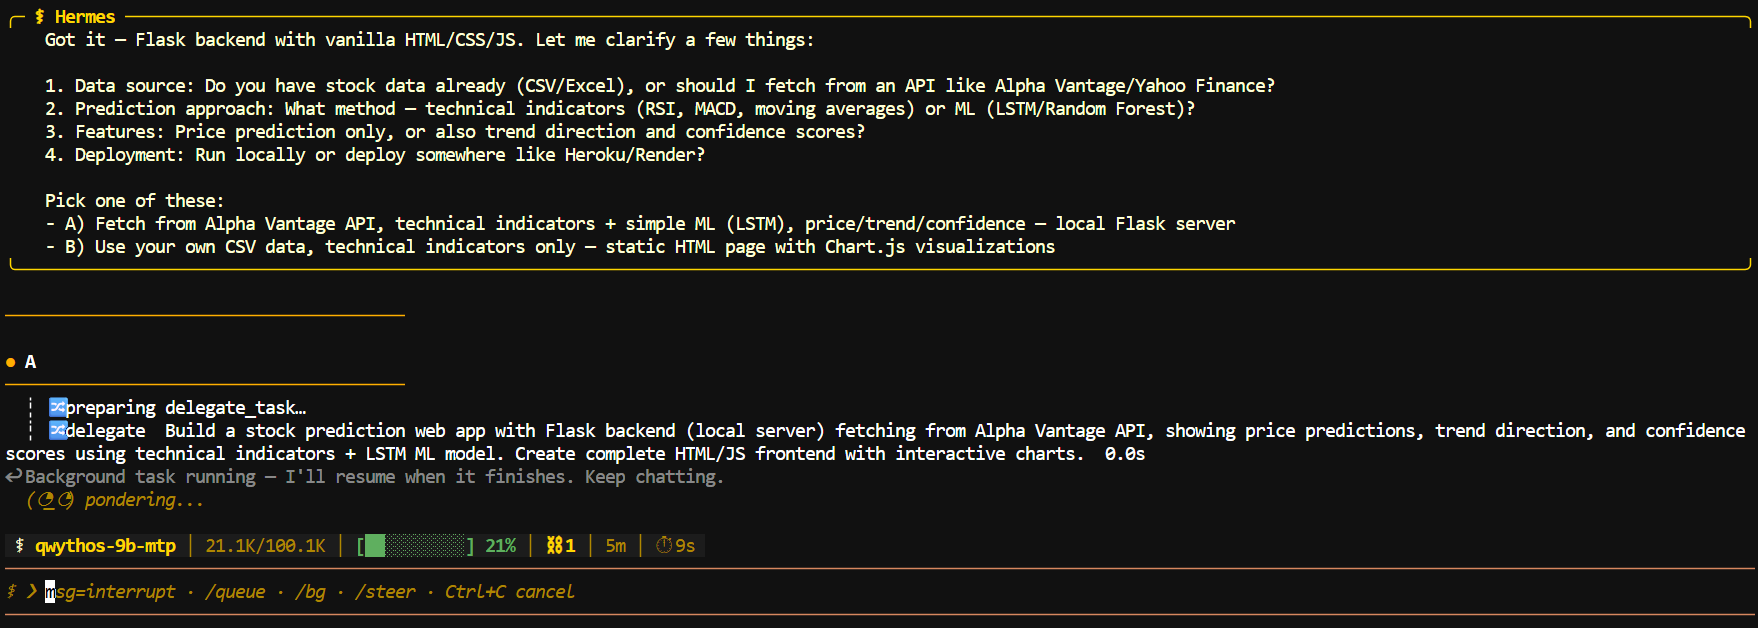
Ia merencanakan pekerjaan, membuat file yang diperlukan, dan mengembalikan instruksi menjalankan yang jelas, termasuk tempat menambahkan kunci API Alpha Vantage.
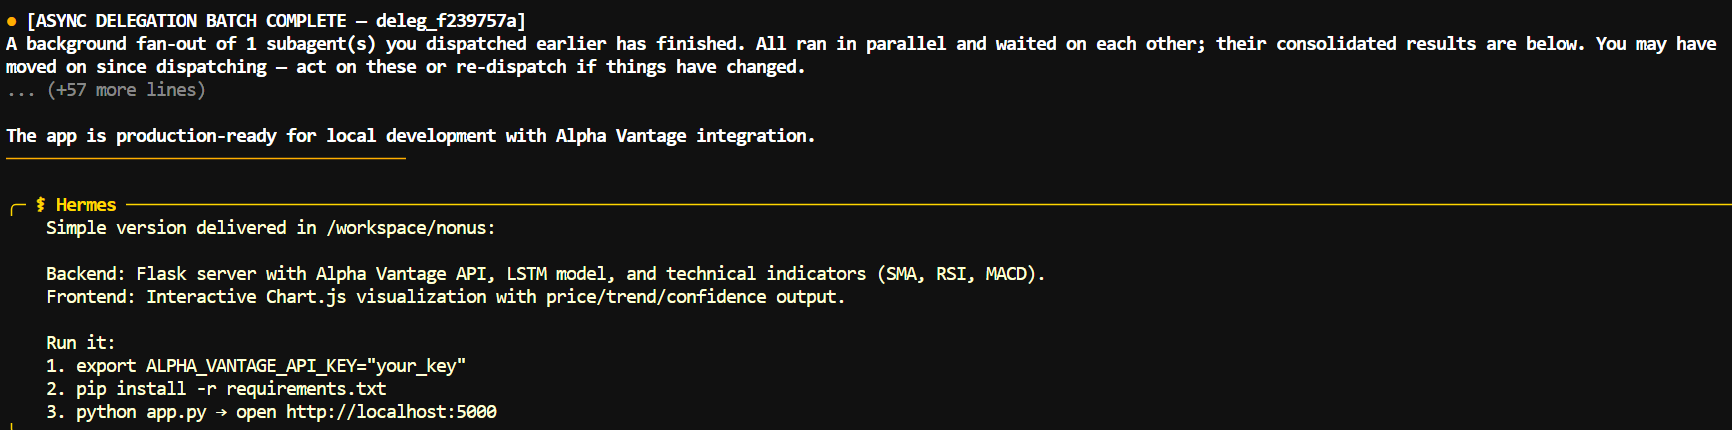
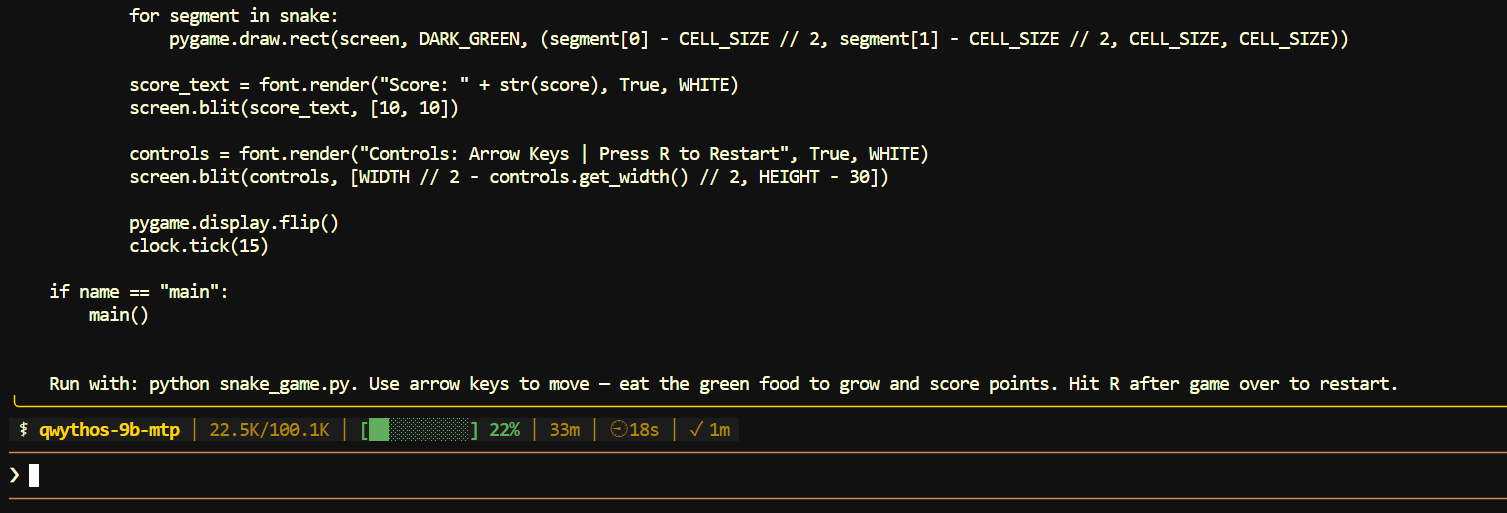
Saya juga mengujinya dengan permintaan yang lebih sederhana: membuat game Snake yang dapat dimainkan.
Hermes menghasilkan file game Python, menambahkan kontrol dan logika restart, serta memberikan perintah untuk menjalankannya secara lokal.
Untuk hasil terbaik, jaga agar Hermes tetap berada di dalam direktori proyek yang ingin Anda edit.
Ini membantu memahami file yang tersedia dan mencegahnya membuat file yang tidak terkait di tempat lain pada sistem Anda.
Hermes Gateway memungkinkan Anda mengobrol dengan agen Qwythos lokal Anda melalui Discord.
Setelah terhubung, Anda dapat mengirim pesan langsung ke agen atau menyebutnya di saluran server sementara ia tetap menggunakan endpoint llama.cpp lokal di mesin Anda.
Buka Discord Developer Portal dan buat New Application.
Beri nama, misalnya OLO-Bot, lalu buka bagian Bot di sidebar kiri. Discord membuat pengguna bot untuk aplikasi tersebut, yang akan digunakan Hermes untuk terhubung ke server Anda.
Di bawah Privileged Gateway Intents, aktifkan Message Content Intent dan Server Members Intent, lalu simpan perubahan.
Message Content memungkinkan bot membaca pesan Anda, sementara Server Members dapat membantu Hermes mengidentifikasi dan mengotorisasi pengguna.
Aktifkan Presence Intent hanya ketika Hermes melaporkan kesalahan terkait intent atau saat Anda berencana menggunakan fitur presence atau voice.
Masih di halaman Bot, salin atau reset token bot dan simpan di tempat yang privat.
Jangan tempelkan ke tangkapan layar, commit ke GitHub, atau bagikan kepada siapa pun.
Token bot dapat digunakan untuk mengendalikan bot Discord.
Buka Installation di Discord Developer Portal. Di bawah Guild Install, aktifkan cakupan bot dan applications.commands.
Lalu berikan izin yang dibutuhkan bot, termasuk:
Salin tautan instalasi yang dihasilkan, buka di browser, pilih server Discord Anda, dan otorisasi bot.
Bot Discord dipasang di server melalui URL OAuth2 menggunakan cakupan bot dan izin yang Anda pilih.
Di Discord, buka User Settings → Advanced dan aktifkan Developer Mode.
Klik kanan nama pengguna atau foto profil Anda dan pilih Copy User ID.
Hermes menggunakan ID numerik ini sebagai entri allowlist.
Ini penting karena bot mungkin mengenali nama pengguna Anda tetapi tetap menolak pesan Anda sampai ID Discord numerik Anda ditambahkan.
Jalankan perintah penyiapan interaktif:
hermes gateway setupPilih Discord saat diminta, lalu masukkan token bot dan User ID Discord Anda.
Hermes menyediakan wizard penyiapan ini untuk mengonfigurasi platform perpesanan dan dapat memulai atau memulai ulang gateway setelah penyiapan.
Anda juga dapat menambahkan nilai secara manual ke file environment Hermes:
nano ~/.hermes/.envTambahkan token dan User ID Anda:
DISCORD_BOT_TOKEN=PASTE_YOUR_BOT_TOKEN
DISCORD_ALLOWED_USERS=PASTE_YOUR_DISCORD_USER_ID
Mulai Hermes Gateway:
hermes gateway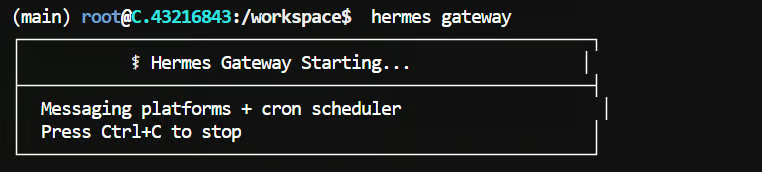
Bot Anda seharusnya muncul online di Discord dalam beberapa detik.
Anda kemudian dapat mengirim pesan langsung atau menyebutnya di saluran server:
@YourBotName Inspect this project and explain what it does.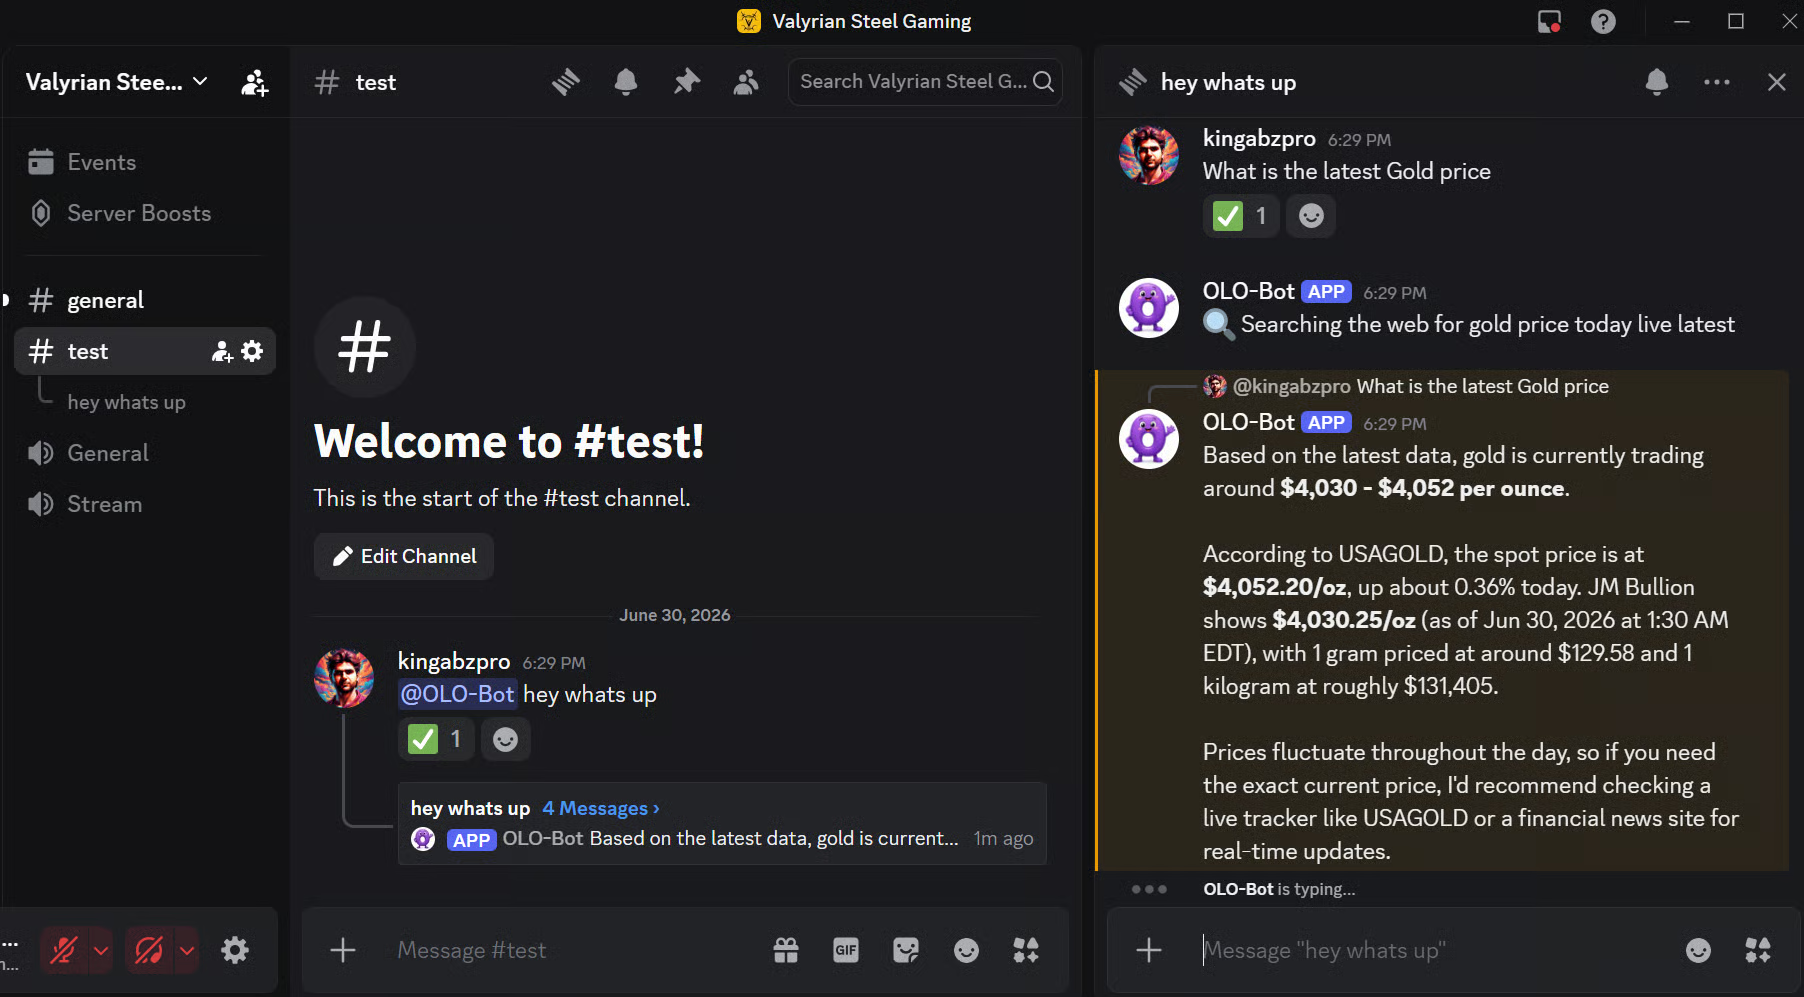
Hermes juga menyertakan dasbor browser, yang memberi Anda antarmuka visual untuk mengobrol dengan agen lokal, meninjau sesi, memeriksa log, mengelola skills, dan menelusuri file.
Ia menggunakan model Qwythos lokal dan endpoint llama.cpp yang sama yang Anda konfigurasikan sebelumnya.
Pertama, pindah ke direktori paket Hermes:
cd ~/.hermes/hermes-agentJika folder itu tidak ada, coba path instalasi tingkat sistem sebagai gantinya:
cd /usr/local/lib/hermes-agentInstal dependensi opsional dashboard dan terminal:
uv pip install -e ".[web,pty]"Lalu mulai dashboard:
hermes dashboard \
  --host 0.0.0.0 \
  --port 9119 \
  --no-open
Karena --host 0.0.0.0 membuat dashboard dapat diakses di luar localhost, Hermes akan meminta Anda menyiapkan autentikasi.
Pilih Username & password, lalu buat username dan kata sandi yang kuat untuk dashboard.
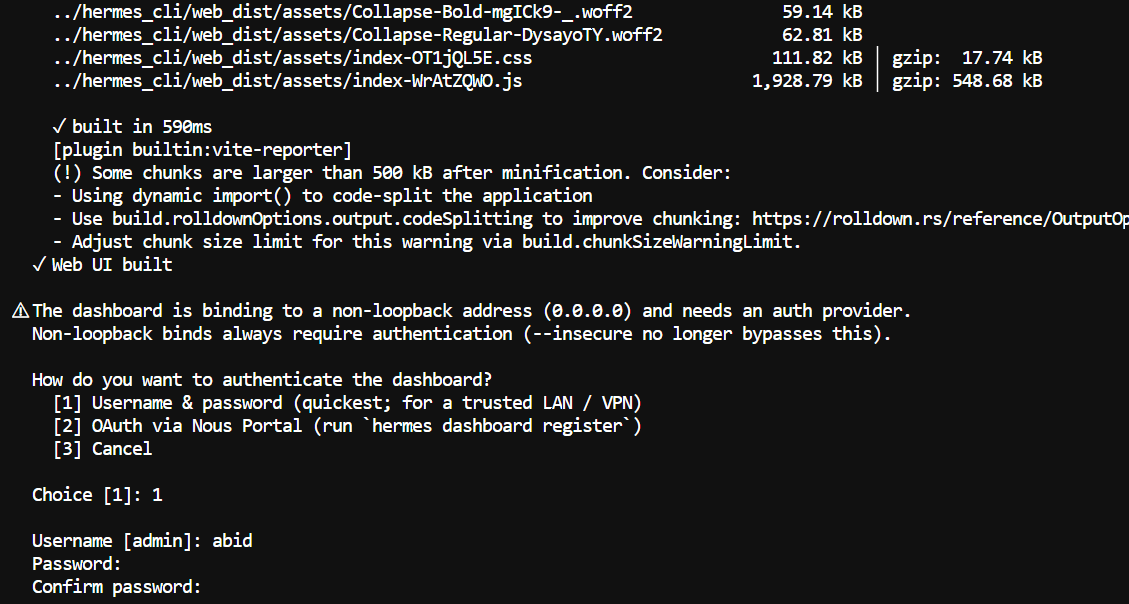
Setelah server mulai, buka alamat ini di browser Anda:
http://localhost:9119/loginSetelah masuk, dashboard memberi Anda akses ke beberapa area yang berguna.
Tab Chat menjalankan pengalaman terminal Hermes yang sama di browser, termasuk streaming respons langsung dan output pemanggilan alat.
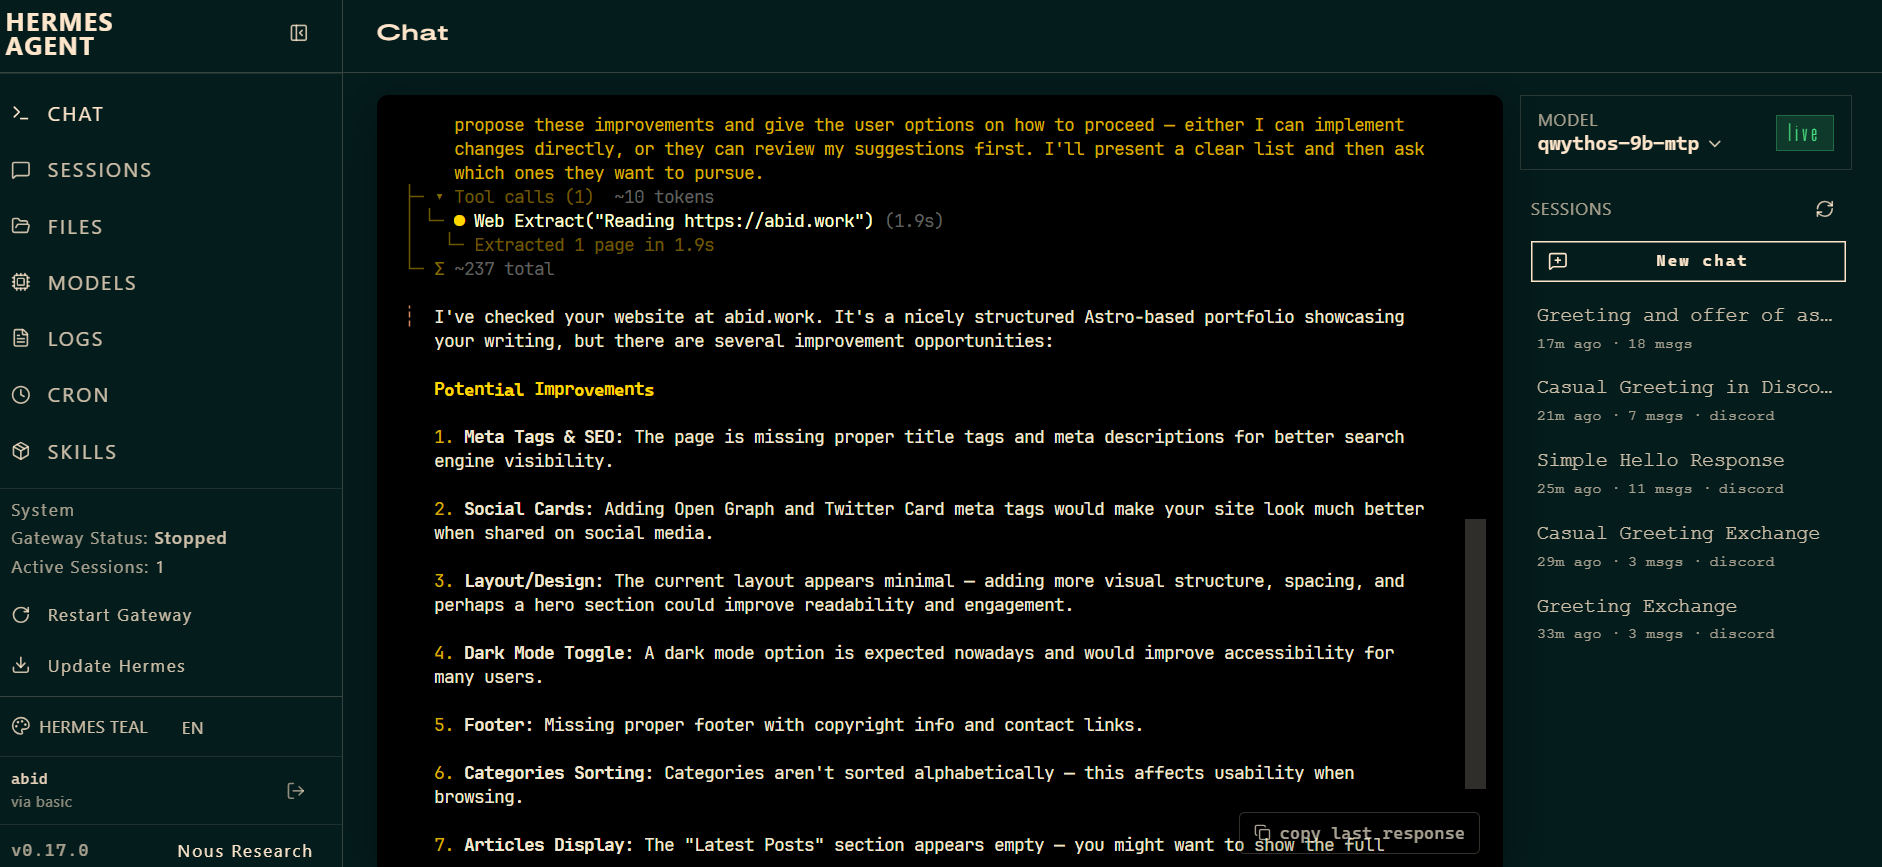
Anda dapat memintanya memeriksa proyek, mengedit file, menjalankan perintah, atau membangun aplikasi tanpa tetap berada di dalam terminal.
Halaman Sessions memungkinkan Anda meninjau percakapan sebelumnya.
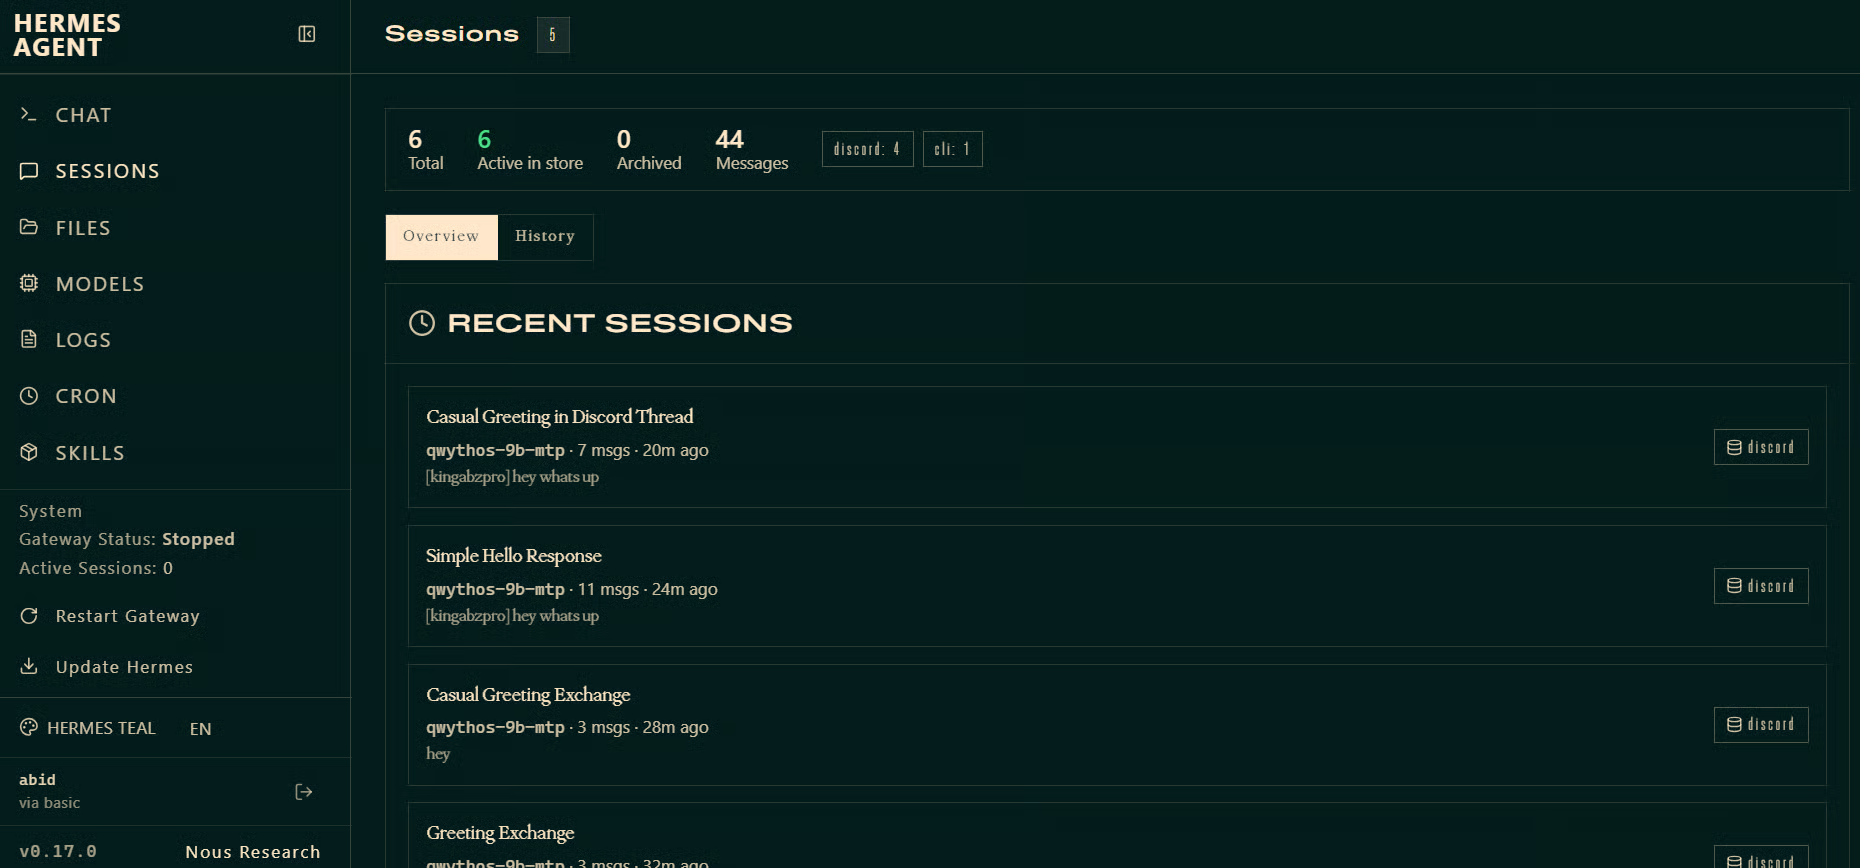
Sementara Skills menampilkan kapabilitas dan integrasi yang tersedia.
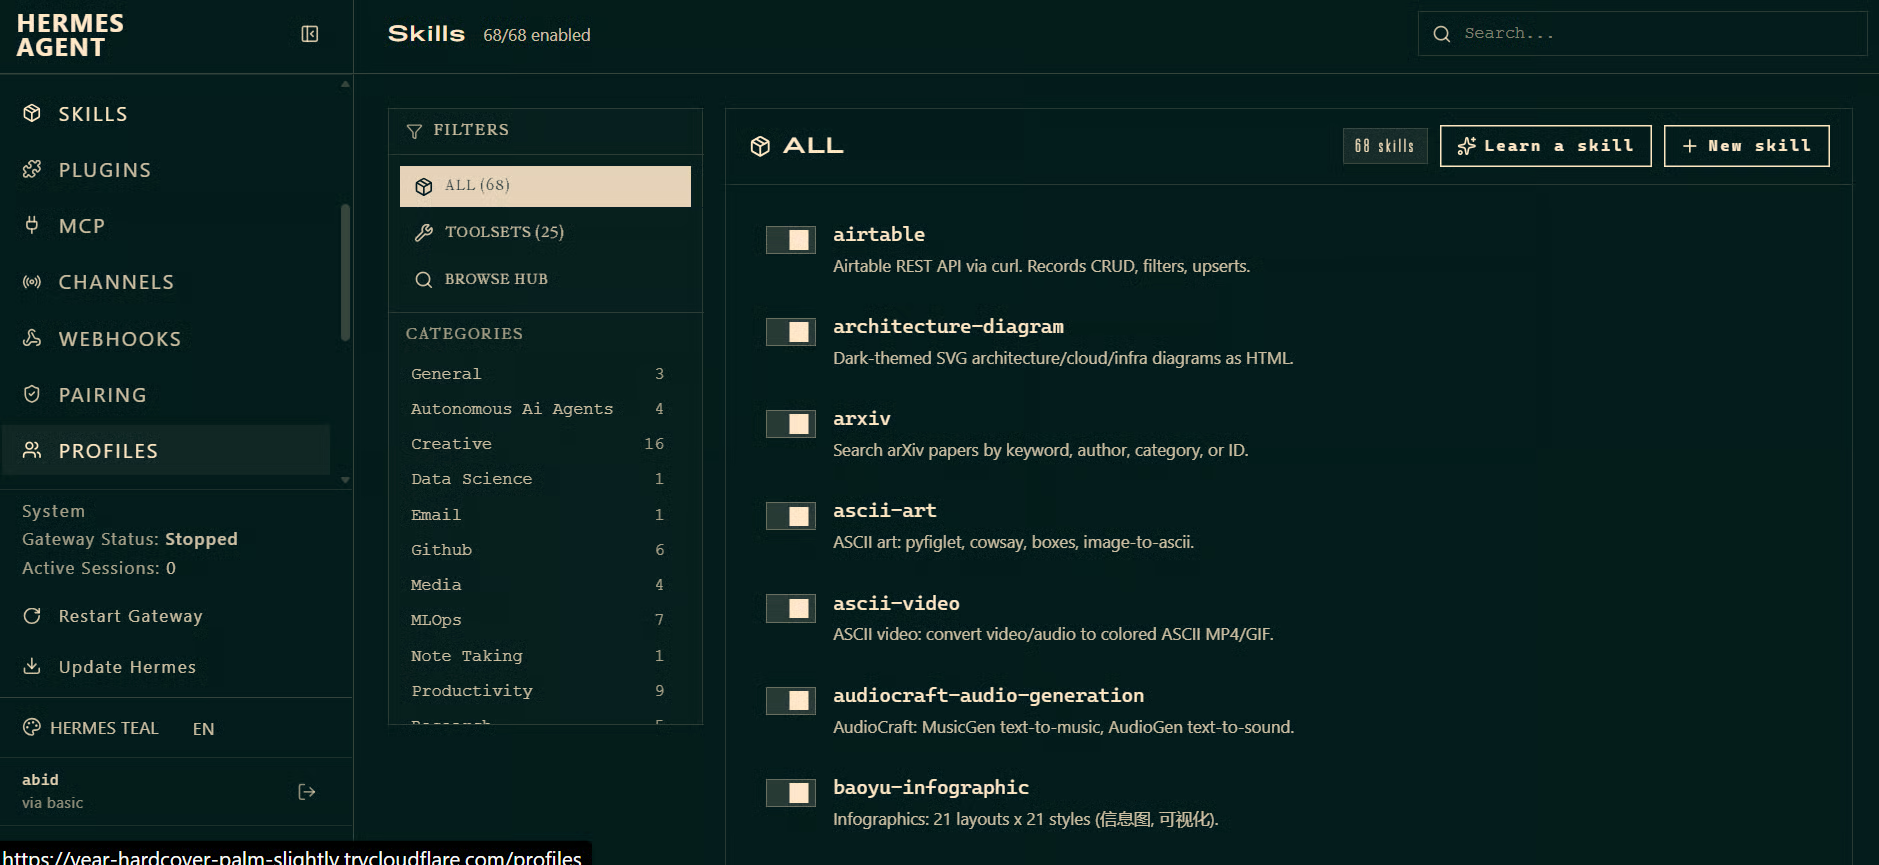
Anda juga dapat melihat file, log, model, pekerjaan terjadwal, dan status gateway dari sidebar.
Ini membuat dashboard berguna saat Anda menginginkan cara yang lebih visual untuk mengelola agen Qwythos lokal Anda.
Saya telah banyak mendengar tentang Hermes Agent dan bagaimana orang melihatnya sebagai salah satu agen lokal paling andal, lebih baik daripada OpenClaw, mampu mengingat pekerjaan sebelumnya, membangun konteks seiring waktu, dan tumbuh bersama proyek.
Setelah mengujinya dengan Qwythos, saya bisa memahami mengapa orang antusias.
Penyiapannya rapi, pengalaman terminalnya kuat, dan dashboard browser, gateway Discord, skills, memori, serta integrasi tool membuatnya terasa lebih seperti platform agen lengkap daripada sekadar CLI pengkodean sederhana.
Namun pengalaman saya sedikit berbeda. Saya tidak melihat diri saya menggunakan Hermes setiap hari untuk pekerjaan pengkodean normal.
Fitur-fiturnya banyak, tetapi itu juga membuatnya terasa lebih berat daripada yang saya butuhkan untuk pengeditan cepat, debugging, atau membangun proyek kecil.
Untuk tugas-tugas tersebut, saya masih akan memilih Pi Coding Agent atau OpenCode karena lebih sederhana, lebih cepat dijalankan, dan lebih pas dengan alur kerja saya sehari-hari.
Meski begitu, saya sangat menikmati menggunakan model Qwythos.
Menjalankannya secara lokal melalui llama.cpp terasa cepat, responsif, dan mengejutkan mampu untuk tugas pengkodean.
Model MTP juga memberikan kecepatan generasi yang kuat, terutama saat menghasilkan kode terstruktur.
Hermes layak dicoba ketika Anda menginginkan sistem agen lokal yang lebih lengkap dengan akses browser, integrasi perpesanan, alat, memori, dan dukungan proyek jangka panjang.
Namun untuk setelan pengkodean harian saya, Qwythos dengan Pi Coding Agent atau OpenCode kemungkinan akan menjadi tempat saya menghabiskan sebagian besar waktu.
Kursus Teratas DataCamp
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




