
Last chance! 50% off DataCamp Premium
Sale ends in
Mythos 5 mewakili lompatan dari Mythos Preview di setiap area kapabilitas utama yang diuji Anthropic. Peningkatan paling terlihat pada pekerjaan otonom jangka panjang, terutama di domain ilmiah yang melibatkan penalaran ilmiah dan tugas visi. Berikut wujudnya dalam praktik.
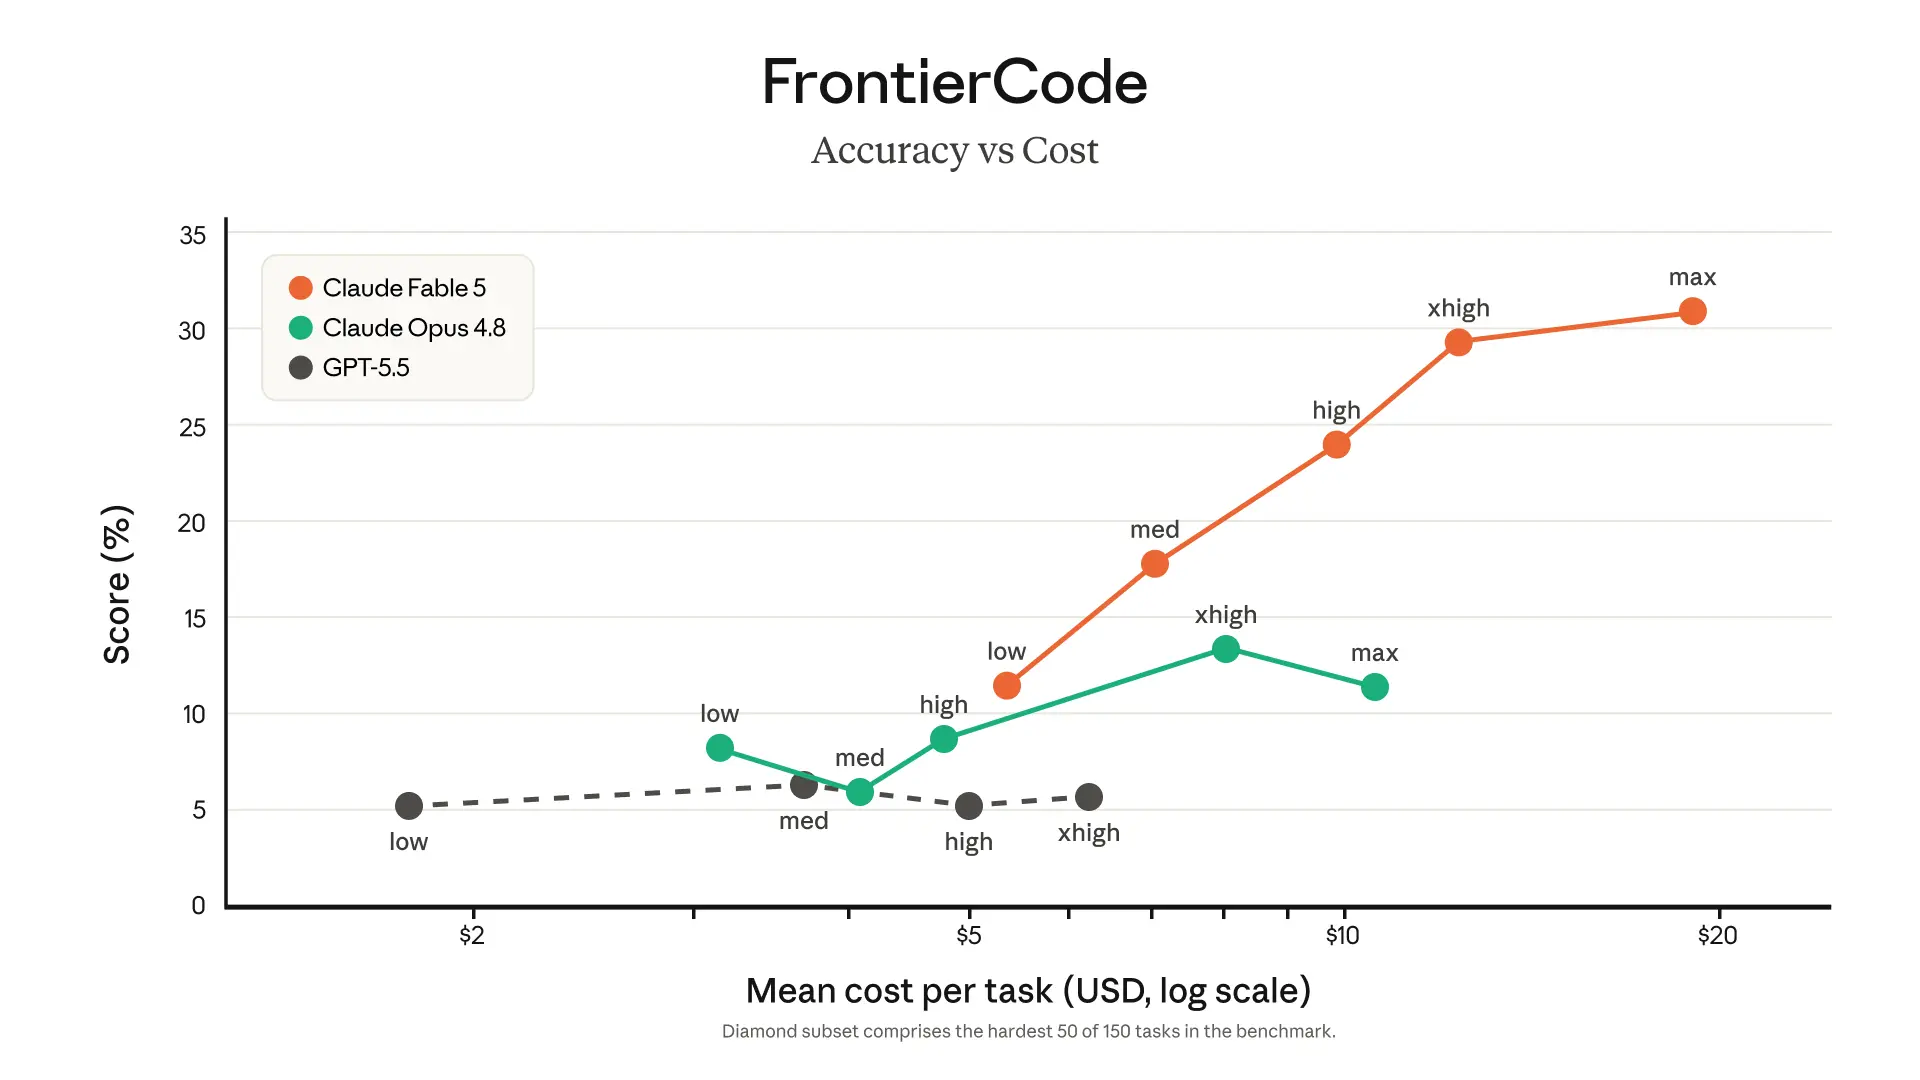
Mythos 5 dapat bekerja secara otonom pada basis kode besar lebih lama daripada model Claude sebelumnya. Stripe melaporkan model ini memadatkan pekerjaan rekayasa selama berbulan-bulan menjadi hitungan hari, menyelesaikan migrasi lintas basis kode pada basis kode Ruby 50 juta baris dalam satu hari. Pada FrontierCode (Diamond), model ini meraih skor tertinggi di antara model frontier bahkan pada tingkat upaya menengah.
Untuk pekerjaan keamanan, Mythos 5 memperluas kapabilitas yang membuat Mythos Preview bernilai bagi mitra Project Glasswing. Mitra tersebut menggunakan Mythos Preview untuk mengidentifikasi lebih dari 10.000 kerentanan keamanan tingkat tinggi dan kritis di sistem produksi.
Tim desain protein internal Anthropic menggunakan Mythos 5 untuk mempercepat desain obat sekitar sepuluh kali. Dalam perbandingan terkontrol, Mythos 5 menyamai atau melampaui operator manusia terampil pada 14 target protein untuk seluruh pipeline:
Sembilan di antaranya menghasilkan kandidat desain obat kuat yang saat ini sedang diteliti.
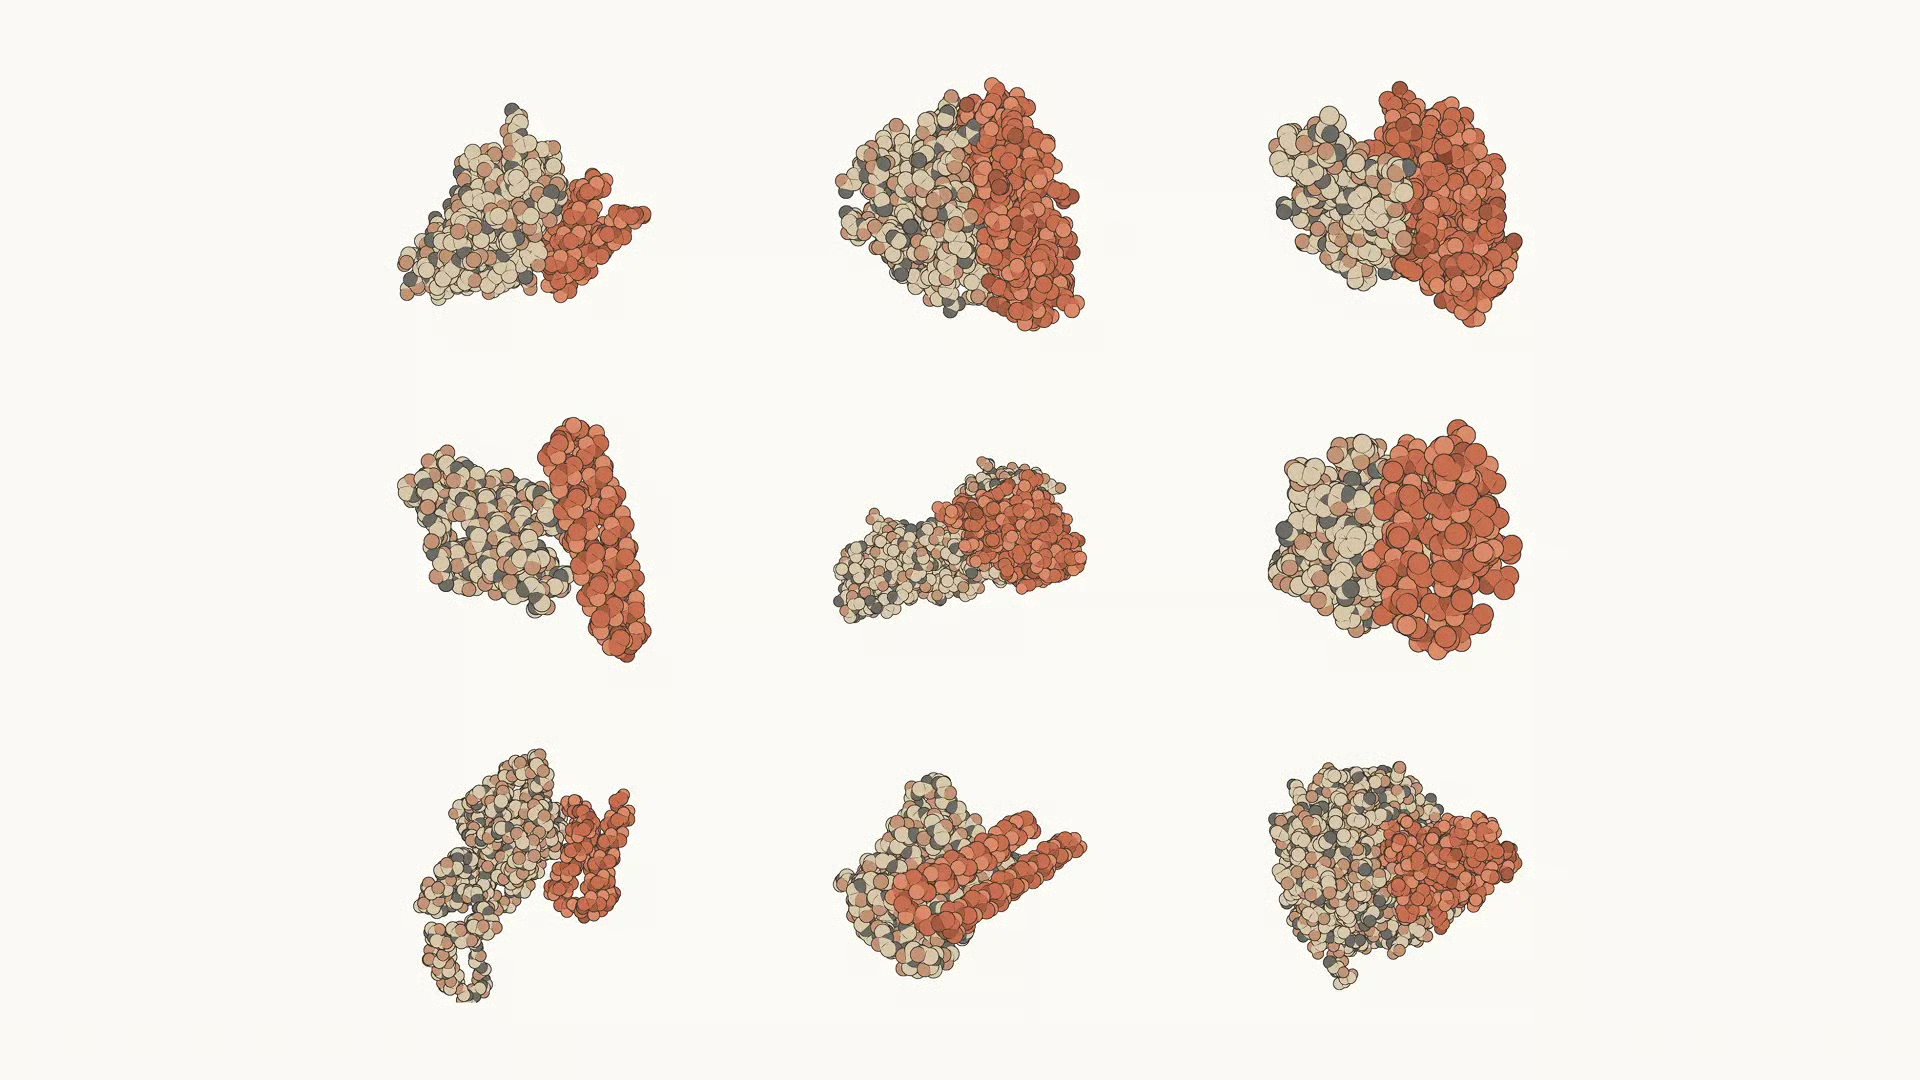
Mythos 5 adalah model pertama Anthropic yang secara konsisten menghasilkan hipotesis ilmiah baru alih-alih merangkum literatur yang ada. Dalam perbandingan buta, para ilmuwan Anthropic lebih menyukai hipotesis biologi molekuler dari model ini sekitar 80% waktu, dan beberapa telah dilanjutkan ke evaluasi eksperimental. Satu hipotesis tentang mekanisme protein E. coli yang baru dikukuhkan secara independen oleh laboratorium yang mengerjakan masalah yang sama.
Mythos 5 melakukan riset genomik baru selama lebih dari seminggu kerja yang sebagian besar otonom, menyusun data sel tunggal untuk jutaan sel di 138 spesies hewan dan melatih model ML kustom untuk mengidentifikasi tipe sel ekuivalen pada organisme yang berkerabat jauh. Model terlatih tersebut mengungguli model yang dipublikasikan di Science baru-baru ini meski ukurannya 100 kali lebih kecil.
Mythos 5 mencetak 93,2% pada CharXiv Reasoning dengan alat dan dapat mengekstrak angka presisi dari figur ilmiah yang detail atau membangun ulang aplikasi web hanya dari tangkapan layar. Pada tugas konteks panjang, pemberian memori berbasis berkas ke Mythos 5 meningkatkan kinerjanya tiga kali lebih besar dibanding peningkatan yang sama pada Opus 4.8, dan model ini mencapai babak final Slay the Spire tiga kali lebih sering.
Mythos 5 memimpin atau seri pada hampir setiap tolok ukur yang diuji Anthropic, dengan peningkatan atas Opus 4.8 yang konsisten di berbagai kategori, bukan hanya terkonsentrasi pada satu area. Tabel perbandingan menyandingkannya dengan Claude Mythos Preview, Claude Opus 4.8, GPT 5.5, dan Gemini 3.1 Pro.
| Kategori | Tolok Ukur | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Koding agentik | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| Koding agentik | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Pekerjaan pengetahuan | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Visi pekerjaan pengetahuan | GDP.pdf | 29.8% (tanpa alat) | — | 22.5% (tanpa alat) | 24.9% (tanpa alat) | 16.7% (tanpa alat) |
| Penalaran spasial | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Penggunaan alat | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Penggunaan komputer | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Hukum | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Penalaran multidisipliner | Humanity's Last Exam (tanpa alat) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Penalaran multidisipliner | Humanity's Last Exam (dengan alat) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologi | BioMysteryBench (sulit) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologi | BioMysteryBench (terpecahkan manusia) | 83.9%* | 82.6% | 80.4% | — | — |
| Koding agentik | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Keamanan siber | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Kesehatan | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Anthropic melaporkan skor Mythos 5 dan Fable 5 bersama-sama, dengan catatan keduanya berselisih dalam kisaran 1–3 poin persentase pada sebagian besar kasus. Tolok ukur bertanda asterisk (*) menunjukkan jarak yang lebih besar karena pengklasifikasi keselamatan Fable 5 mengalihkan kueri sensitif ke Opus 4.8; pada tolok ukur tersebut, Fable 5 berkinerja lebih dekat ke kelas Opus.
Pada SWE-Bench Pro, Mythos 5 mencetak 80,3%, dibanding 77,8% untuk Mythos Preview, 69,2% untuk Opus 4.8, 58,6% untuk GPT 5.5, dan 54,2% untuk Gemini 3.1 Pro. Selisih 11 poin atas Opus 4.8 cukup besar pada tolok ukur yang dirancang untuk menahan kebocoran ground-truth.
Untuk kualitas dan keterpeliharaan kode agentik alih-alih sekadar penyelesaian tugas mentah, yang diukur oleh FrontierCode (Diamond), jaraknya bahkan lebih tajam. Mythos 5 meraih 29,3% pada tingkat upaya xhigh, dibanding 13,4% untuk Opus 4.8 dan 5,7% untuk GPT 5.5.
Untuk pekerjaan terminal, Mythos 5 mengembalikan mahkota ke Anthropic dari OpenAI: Mythos 5 mencetak 88,0%* pada Terminal-Bench 2.1, dibanding 82,7% untuk Opus 4.8, 83,4% untuk GPT 5.5 (Codex CLI), dan 70,7% untuk Gemini 3.1 Pro (dengan Gemini CLI).
GDPval-AA mengukur kinerja pekerjaan pengetahuan pada skala numerik. Mythos 5 mencetak 1932, dibanding 1890 untuk Opus 4.8, 1769 untuk GPT 5.5, dan 1314 untuk Gemini 3.1 Pro.
Jarak ini makin besar untuk pekerjaan pengetahuan pada dokumen PDF tanpa akses alat. Mythos 5 mencetak 29,8% pada GDPpdf, dibanding 22,5% untuk Opus 4.8, 24,9% untuk GPT 5.5, dan 16,7% untuk Gemini 3.1 Pro.
Humanity's Last Exam (HLE) menguji penalaran tingkat pascasarjana di sains, matematika, dan humaniora. Mythos 5 mencetak 59,0%* tanpa alat dan 64,5%* dengan alat. Mythos Preview masing-masing mencetak 56,8% dan 64,7%—praktis seri dengan alat namun tertinggal 2 poin tanpa alat. Jarak ke Opus 4.8 sudah signifikan (49,8% tanpa, 57,9% dengan), dan bahkan lebih besar dibanding model pesaing unggulan (GPT 5.5: 41,4% dan 52,2%, Gemini 3.1 Pro: 44,4% dan 51,4%).
Jarak antara Mythos 5 dan yang lain paling jelas pada kondisi tanpa alat, di mana ia unggul atas Opus 4.8 lebih dari 9 poin. Ini adalah skor bertanda bintang, artinya Fable 5 berkinerja agak lebih rendah karena pengklasifikasi keselamatannya.
Pada OSWorld-Verified, yang menguji kemampuan model menyelesaikan tugas pada antarmuka komputer nyata, Mythos 5 mencetak 85,0%. Mythos Preview sedikit unggul di 85,4%, menjadikannya satu-satunya tolok ukur yang dipimpin Mythos Preview. Opus 4.8 cukup dekat (83,4%), sementara para pesaing sedikit tertinggal. GPT 5.5 mencetak 78,7%, dan Gemini 3.1 Pro 76,2%.
AutomationBench mengukur kapabilitas penggunaan alat. Mythos 5 mencetak 17,4%, dibanding 15,5% untuk Opus 4.8, 12,9% untuk GPT 5.5, dan 9,6% untuk Gemini 3.1 Pro. Angka absolut yang rendah di semua model menunjukkan penggunaan alat masih menjadi masalah sulit bagi semua model frontier.
Penalaran spasial adalah salah satu area dengan keunggulan terbesar Mythos 5. Model ini mencetak 38,6% di Blueprint-Bench 2, lebih dari dua kali lipat 14,5% milik Opus 4.8. GPT 5.5 lebih dekat di 36,2%, dan Gemini 3.1 Pro mencetak 26,5%.
Keduanya mungkin area yang paling mendapat sorotan pada catatan rilis, dan hasilnya menunjukkan alasannya.
ExploitBench mengukur fraksi eksploit yang berhasil direproduksi model (Cap%). Mythos 5 mencetak 78,0%*, peningkatan signifikan bahkan dibanding Mythos Preview (69,0%), dan lonjakan dramatis dibanding 40,0% milik Opus 4.8 serta 34,0% milik GPT 5.5.
Jarak 38 poin atas Opus 4.8 adalah keunggulan terbesar pada satu tolok ukur dalam tabel perbandingan, dan ini menjelaskan mengapa pagar pengaman siber ada pada Fable 5. Red-teaming eksternal Anthropic tidak menemukan jailbreak universal pada tugas agentik bentuk panjang, meskipun UK AISI mencatat kemajuan menuju satu jailbreak dalam jendela pengujian awal.
BioMysteryBench menguji penalaran biologis pada dua tingkat kesulitan. Pada subset sulit, Mythos 5 mencetak 46,1%*, dibanding 29,6% untuk Mythos Preview dan 40,0% untuk Opus 4.8. Pada subset yang terpecahkan manusia, Mythos 5 mencetak 83,9%*, Mythos Preview 82,6%, dan Opus 4.8 80,4%. GPT 5.5 dan Gemini 3.1 Pro tidak memiliki skor yang dilaporkan pada kedua subset tersebut.
Seperti pada ExploitBench, skor Fable 5 lebih dekat ke Opus 4.8 karena pengklasifikasi keselamatan terkait biologi.
Claude Mythos 5 menunjukkan kekuatan yang menonjol pada dua domain profesional berisiko tinggi di mana akurasi dan kualitas penalaran berdampak pada dunia nyata: medis dan hukum.
Pada HealthBench Professional, Mythos 5 mencetak 66,0%*, sedikit di atas 64,7% milik Mythos Preview. Opus 4.8 mencetak 56,9%, dan GPT 5.5 mencetak 51,8%.
Pada Legal Agent Benchmark, Mythos 5 mencetak 13,3%, dibanding 10,4% untuk Opus 4.8, dan hanya 2,1% untuk GPT 5.5. Skor absolutnya rendah, tetapi jarak antara Mythos 5 dan GPT 5.5 atau Gemini sangat jelas. Penalaran hukum tetap menjadi frontier yang menantang bagi semua model.
Claude Mythos 5 dihargai $10 per satu juta token input dan $50 per satu juta token output. Ini kurang dari setengah harga Claude Mythos Preview ($25/$125), sehingga peningkatannya mudah bagi mitra Glasswing yang sudah ada. Pengembang dapat mengakses model melalui Claude API menggunakan ID model claude-mythos-5.
Akses saat ini dibatasi untuk dua kelompok:
Anthropic berencana memperluas kedua program dari waktu ke waktu.
Program akses tepercaya yang lebih luas direncanakan agar organisasi keamanan siber dapat mendaftar secara lebih sistematis, bekerja sama dengan Pemerintah AS. Anthropic belum mengumumkan jadwal ketersediaan umum. Bagi sebagian besar pengembang, Claude Fable 5 adalah opsi praktis saat ini, dengan model dasar yang sama dan akses melalui paket langganan serta API standar.
Satu detail operasional yang perlu dicatat: Anthropic memperkenalkan kebijakan retensi data 30 hari untuk semua lalu lintas model kelas Mythos. Data tidak digunakan untuk pelatihan dan dihapus setelah 30 hari pada hampir semua kasus, namun disimpan untuk pemantauan keselamatan. Jika Anda membangun di atas Mythos 5 dengan data sensitif, tinjau dokumentasi dukungan Anthropic tentang kebijakan ini sebelum menerapkan.
Claude Mythos 5 adalah pernyataan paling jelas dari Anthropic sejauh ini bahwa perusahaan serius menerapkan AI frontier dalam konteks profesional berisiko tinggi, dan hasilnya mendukung hal itu.
Jarak pada SWE-bench Pro (80,3% vs 69,2%), Terminal-Bench 2.1 (88,0% vs 82,7%), dan ExploitBench (78,0% vs 40,0%) semuanya menunjukkan model yang menangani tugas tersulit dengan lebih andal dibanding apa pun yang tersedia.
Model akses terbatas merupakan pendekatan yang masuk akal mengingat risiko penggunaan ganda, dan skor ExploitBench memberikan alasan kuat bahwa alat keamanan ofensif paling canggih sebaiknya tidak tersedia untuk publik. Pertanyaan yang lebih sulit adalah apakah Anthropic dapat memperluas program akses tepercaya cukup cepat agar bermanfaat bagi komunitas keamanan dan riset biomedis yang lebih luas sebelum para pesaing menutup jarak.
Bagi organisasi yang memenuhi syarat, peningkatan dari Mythos Preview sangat mudah dengan harga kurang dari setengahnya.
Kursus AI Teratas
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




