
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
La maggior parte dei lanci di modelli che ho trattato quest'anno inseguono lo stesso obiettivo: una finestra di contesto più ampia, un punteggio SWE-bench più alto, un altro trilione di parametri.
PrismML va nella direzione opposta.
Il 17 settembre 2026, il team ha rilasciato Ternary Bonsai 2 27B, una versione compressa di Qwen3.8 27B che entra in 5,9 GB e gira su un laptop.
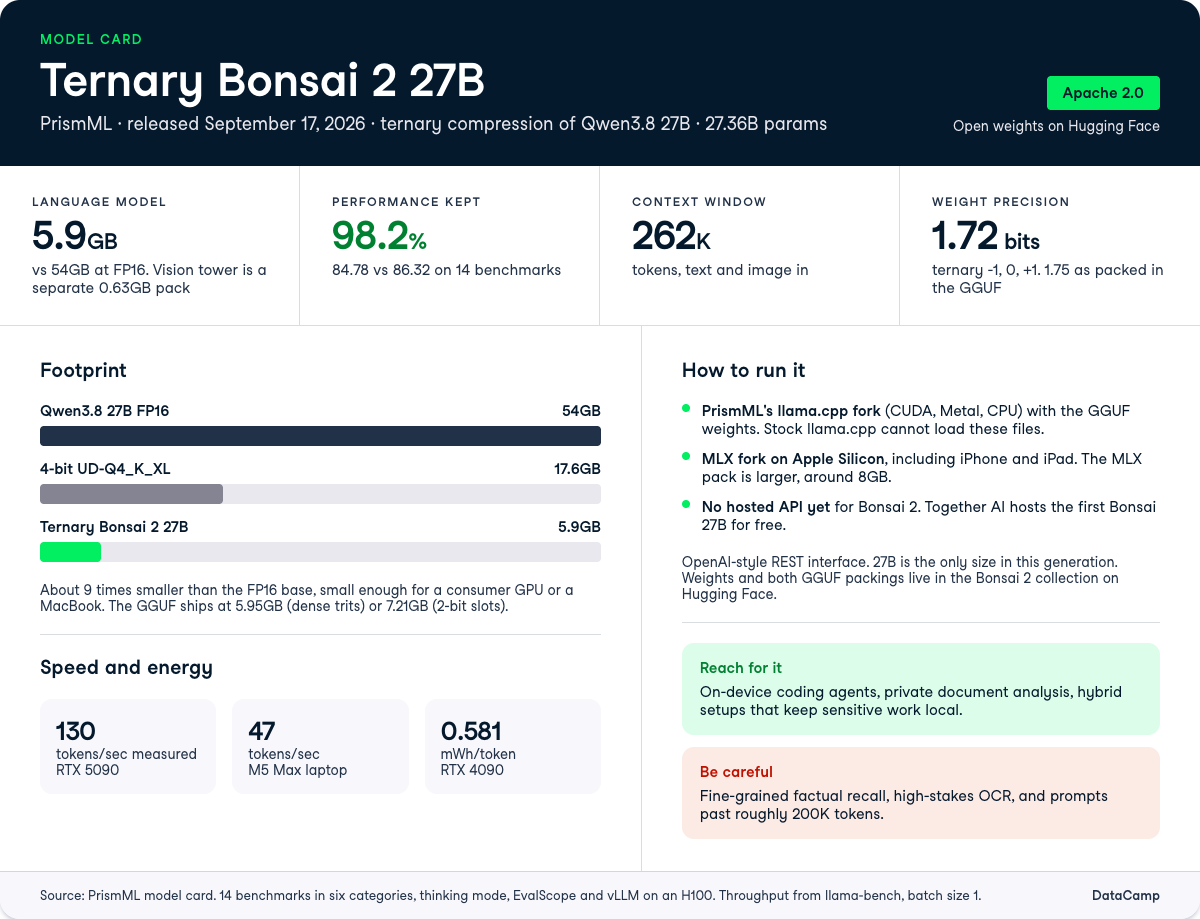
Comprimendo in modo intensivo il modo in cui memorizza le informazioni, PrismML ha reso Bonsai 2 27B oltre 9 volte più piccolo della versione Qwen originale. Eppure conserva il 98,2% delle prestazioni originali e la finestra di contesto da 262k token, elaborando testo e immagini.
In questo articolo, vedrò tutte le novità di Bonsai 2 27B, esaminando le nuove funzionalità, i benchmark e i dettagli su prezzi e accesso.
Se vuoi eseguire tu stesso il primo modello Bonsai, abbiamo una guida passo-passo nel nostro tutorial per l'installazione locale di Bonsai 27B.
Bonsai 2 27B è il modello multimodale compresso di punta di PrismML, costruito applicando la quantizzazione ternaria end-to-end sul language model di Qwen3.8 27B.
Dove Qwen3.8 27B in piena precisione occupa 54 GB in FP16 (la versione non compressa e a grandezza piena del modello), Bonsai 2 27B arriva a 5,9 GB solo testo, un ingombro abbastanza ridotto da stare su una GPU consumer o un MacBook.
Secondo PrismML, la compressione usa pesi ternari limitati a −1, 0 e +1, abbinati a scaling per gruppi in FP16. Questo equivale a 1,72 bit effettivi per peso secondo il conteggio di PrismML, contro i 16 bit della referenza FP16.
Il modello mantiene la finestra di contesto da 262K token e l'input multimodale testo+immagini della base.
Il dato di punta è il numero sulla retention.
Su una suite che PrismML descrive come 14 benchmark in sei categorie di abilità, valutata in thinking mode con EvalScope e vLLM su una H100, Bonsai 2 27B fa una media di 84,78 contro gli 86,32 della baseline FP16, ovvero il 98,2%.
Per un modello sotto i 2 bit, è un divario molto più piccolo di quanto offra la quantizzazione convenzionale.
Quello che puoi fare con Bonsai 2 27B si riduce a eseguire capacità di classe 27B in posti dove un modello 27B normalmente non può andare.
Ecco le caratteristiche che lo definiscono.
Bonsai 2 27B entra in 5,9 GB, il che rende un modello di classe 27B alla portata di hardware consumer invece che di un datacenter.
La rappresentazione a pochi bit è applicata all'intero language model, non solo ad alcuni layer, quindi la riduzione dell'ingombro è reale e non cosmetica.
Per i practitioner, questo cambia il significato di "locale".
Invece di scendere a un modello da 8B per il lavoro on-device, puoi eseguirne uno con le capacità di ragionamento e coding di un 27B e avere ancora RAM libera.
La clausola è che resta comunque un 27B a livello architetturale, quindi l'hardware molto entry-level sentirà la pressione sulla memoria.
Il modello offre una finestra di contesto da 262K token, sufficiente per contenere un intero codebase, un lungo contratto legale o una pila di PDF di ricerca in un unico prompt.
Conta soprattutto per i setup di retrieval-augmented generation in cui vuoi mantenere grandi quantità di contesto residenti invece di fare chunking aggressivo.
I report dalla community segnalano un caveat: alcuni utenti notano un degrado in richiamo e coerenza all'estremo della finestra, oltre circa 200K token.
Se ti avvicini al limite, testa il richiamo sui tuoi dati prima di fidarti in produzione.
Bonsai 2 27B è pensato per reggere in loop agentici, dove piccoli errori si sommano su molti passaggi.
PrismML ha mostrato la sua capacità di guidare agenti di coding tramite Cline ed eseguire workflow di computer use, entrambi su una RTX 5090.
Questa è l'area in cui la compressione di solito crolla, perché un singolo passaggio degradato può far deragliare l'intera esecuzione di un agente.
Bonsai 2 27B ottiene 90,07 su LiveCodeBench e 74,92 su BFCL v3, vicino ai numeri FP16, ed è questo che rende il lavoro agent locale plausibile qui invece che aspirazionale.
Il modello accetta immagini insieme al testo, coprendo visual question answering, document understanding e OCR.
Questo apre workflow multimodali privati come il debug da uno screenshot o l'analisi di un documento scansionato senza inviarlo al cloud.
La visione è anche dove il costo della compressione si nota più chiaramente.
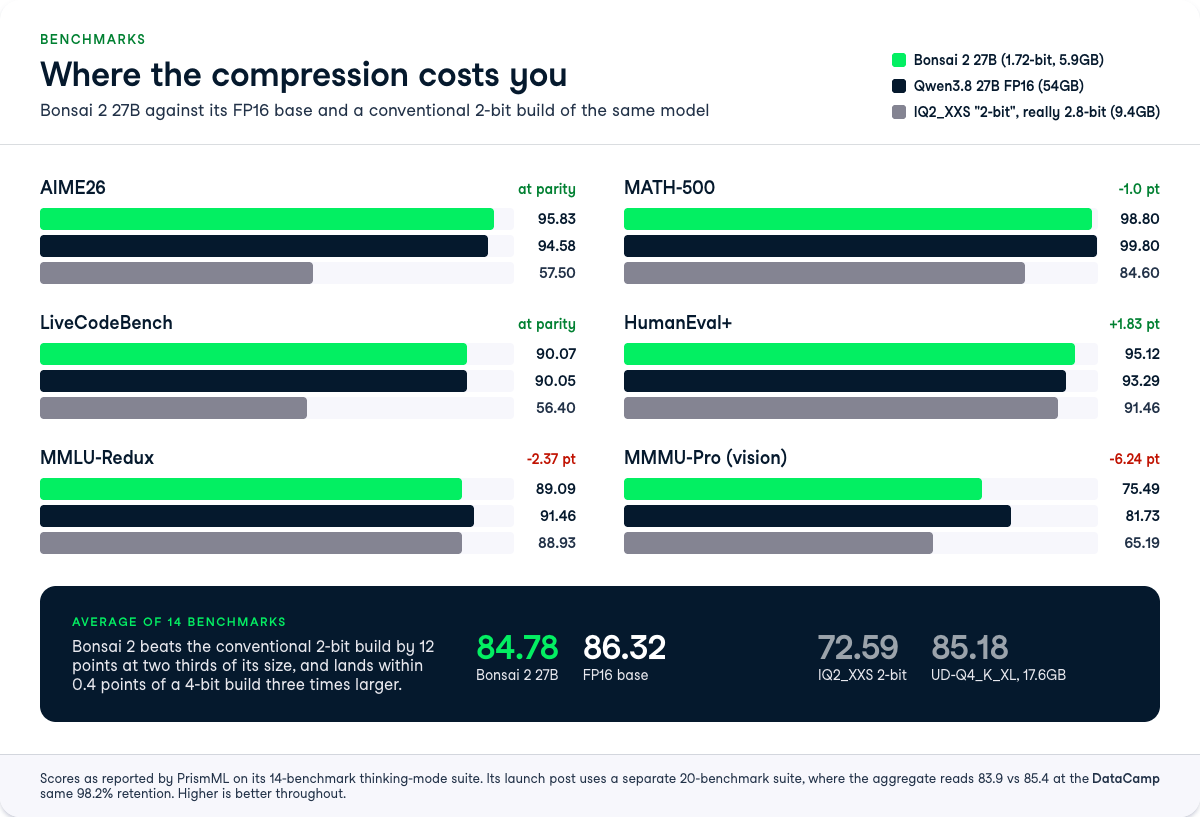
Su MMMU-Pro, Bonsai 2 27B segna 75,49 contro gli 81,73 del modello FP16, e su OCR Bench v2 scende a 56,88 contro 60,99.
Per l'elaborazione di documenti ad alta criticità, diagrammi complessi o testo a bassa risoluzione, tratterei la visione come l'anello debole e verificherei i risultati.
La storia aggregata è 84,78 contro 86,32 per FP16, ma l'aggregato sottostima ciò che conta davvero.
Le build convenzionali sotto i 4 bit collassano selettivamente proprio sui benchmark che richiedono ragionamento sostenuto, e Bonsai 2 27B è progettato per reggere lì.
Il confronto tracciato da PrismML è contro una build convenzionale a 2 bit dello stesso modello base, Qwen3.8-27B IQ2_XXS, che fa 72,59 di media.
Bonsai 2 27B la supera di oltre 12 punti con meno di due terzi della dimensione, e arriva a 0,4 punti da una build a 4 bit molto più grande (UD-Q4_K_XL a 85,18) pur essendo un terzo del suo ingombro.
La matematica è dove Bonsai 2 27B è quasi indistinguibile dal modello a piena precisione.
Ottiene 95,83 su AIME26 e 98,80 su MATH-500, contro punteggi FP16 di 94,58 e 99,80.
Il contrasto con la quantizzazione convenzionale è netto: IQ2_XXS scende a 57,50 su AIME26, un crollo di 37 punti che i test casuali su domande facili non coglierebbero.
 Sul fronte della conoscenza generale e del ragionamento, il quadro è più sfumato.
Bonsai 2 27B ottiene 89,09 su MMLU-Redux contro 91,46 di FP16, e recensioni di terze parti collocano la categoria composita conoscenza+ragionamento intorno a 79,9 contro 85,6 di FP16.
Il richiamo fattuale fine-grained è dove la compressione ternaria costa di più.
Il coding resta in parità e in alcuni casi supera leggermente il modello base. Bonsai 2 27B ottiene 95,12 su HumanEval+ e 90,07 su LiveCodeBench, contro i 93,29 e 90,05 di FP16.
La media composita sul coding a 89,42 contro 89,07 di FP16 è una piccola vittoria per il modello compresso.
Sul tool calling agentico, BFCL v3 è a 74,92 contro 76,74 per FP16, un divario modesto.
Per confronto, quando abbiamo recensito Qwen3.8-Max, il modello ben più grande da 2,4T ha totalizzato 86,1 su OSWorld-Verified per l'uso del computer agentico, quindi Bonsai 2 27B non compete con i flagship cloud sulla pura capacità agentica.
Compete sul fatto di far girare l'agente in locale, punto.
L'instruction following è una delle poche categorie dove Bonsai 2 27B supera direttamente il modello a piena precisione.
Ottiene 91,31 su IFEval contro 91,50 per FP16, e 74,00 su IFBench prompt-loose contro 71,00 di FP16.
| Benchmark | Bonsai 2 27B | Qwen3.8 27B FP16 | IQ2_XXS (2-bit) |
|---|---|---|---|
| AIME26 | 95.83 | 94.58 | 57.50 |
| MATH-500 | 98.80 | 99.80 | 84.60 |
| LiveCodeBench | 90.07 | 90.05 | 56.40 |
| HumanEval+ | 95.12 | 93.29 | 91.46 |
| MMLU-Redux | 89.09 | 91.46 | 88.93 |
| MMMU-Pro | 75.49 | 81.73 | 65.19 |
| Media (14) | 84.78 | 86.32 | 72.59 |
La velocità fa parte della storia dei benchmark qui, perché determina se i loop agent locali sono utilizzabili.
Bonsai 2 27B raggiunge fino a 143 token/secondo su una NVIDIA GeForce RTX 5090 e 46,8 token/secondo su un M5 Max.
Sull'energia, PrismML riporta 0,581 mWh per token su una RTX 4090, che sostiene sia il 40% più efficiente di un modello da 8B in piena precisione.
Per gli assistenti di coding, un throughput più alto significa cicli di modifica-debug più rapidi; per gli assistenti in background su un laptop, un'energia per token più bassa significa maggiore autonomia senza chiamare continuamente il cloud.
Bonsai 2 27B è rilasciato sotto licenza Apache 2.0, quindi i pesi sono scaricabili gratuitamente e utilizzabili a fini commerciali.
PrismML lo posiziona innanzitutto come modello self-hosted, e la documentazione ufficiale si concentra sul serving locale piuttosto che su una API a consumo per token.
I pesi sono disponibili oggi su Hugging Face nella collezione Bonsai 2.
Le build GGUF si attestano intorno a 5,93–5,95 GB per la variante ternaria PTQ1_0, con una build MLX che gira più grande. Nota che Ternary Bonsai 2 è solo 27B, senza compagni da 8B, 4B o 1,7B in questa generazione.
Bonsai 2 27B è open-weight sotto Apache 2.0, quindi lo esegui tu stesso invece di chiamare una API proprietaria.
Gira su GPU NVIDIA via CUDA e su dispositivi Apple (Mac, iPhone, iPad) via MLX, usando i kernel low-bit personalizzati di PrismML.
Le vie principali sono:
http://localhost:8080/v1.http://localhost:8081/v1, tenendo presente che i Mac più vecchi potrebbero incappare in limiti di RAM dato che la variante MLX è più grande della GGUF.Prism-ML/Ternary-Bonsai-27B o tramite Puter, entrambi al momento gratuiti.PrismML espone un'interfaccia REST in stile OpenAI, quindi si integra negli strumenti esistenti che si aspettano un endpoint di chat-completions.
Per una guida locale completa al primo modello, vedi la nostra guida generale all'installazione locale di Bonsai.
Bonsai 2 27B punta sul fatto che il fronte interessante sia l'intelligenza per gigabyte, non la capacità grezza.
Chiudere il gap di retention dal 95% della prima generazione a oltre il 98% è ciò che rende credibile, e non marketing, l'inquadramento "quasi lossless", e il grafico della densità lo pone ben avanti alle build low-bit convenzionali della stessa base.
Lo sceglierei se stai costruendo agenti di coding on-device, analisi di documenti privati o sistemi ibridi che mantengono in locale il lavoro sensibile.
Sarei più cauto per QA ad alta intensità di conoscenza e OCR ad alta criticità, dove il costo della compressione è reale e misurabile.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



