
Last chance! 50% off DataCamp Premium
Sale ends in
Aggiornamento: 2 settembre 2026: Alibaba ha rilasciato Qwen3.8-Max-0902, uno snapshot potenziato di Qwen3.8-Max incentrato su performance di coding e agent. La sezione qui sotto è stata aggiunta per riflettere i nuovi benchmark.
Il 2 settembre 2026, Alibaba ha rilasciato Qwen3.8-Max-0902, un aggiornamento post-training di Qwen3.8-Max. L'architettura non cambia: 2,4 trilioni di parametri, contesto da 1M di token e stesso pricing ($2/1M input, $6/1M output). Il focus è chiaramente sul coding e sul lavoro agent a lungo orizzonte.
Il risultato più rilevante è su Code Arena WebDev, dove Qwen3.8-Max-0902 è primo assoluto con 1.691 punti, 3 in più di Claude Opus 5 Max (1.687), 17 in più di Kimi K3 Max (1.674) e 22 in più del precedente Qwen3.8-Max (1.669). Detiene anche la prima posizione sulla frontiera di Pareto a un costo combinato di $5 per milione di token.
Tutti e 8 i benchmark di coding sono migliorati. I progressi maggiori sono su TerminalBench 3.0 (da 11,3 a 29,0) e ProgramBench Almost Solved (da 10,5 a 28,0), entrambi più che raddoppiati. La tabella seguente mostra il quadro completo tra categorie di coding, agent e multimodale.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Coding | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agent | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodale | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
In grassetto indica che Qwen3.8-Max-0902 supera Claude Opus 5 su quel benchmark. Tutti i risultati provengono dalla tabella comparativa pubblicata da Alibaba.
Contro Claude Opus 5, l'aggiornamento 0902 è in testa su tre benchmark di coding (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) e vince su WorkArena e su entrambe le valutazioni multimodali pubblicate. Claude resta avanti su TerminalBench 3.0, DeepSWE 1.1 e i benchmark di coordinamento degli agent. I prezzi non cambiano, quindi se già usavi Qwen3.8-Max, questo è un upgrade gratuito con un miglioramento significativo nel coding. Qwen ha anche rilasciato Qwen3.8-Omni-Flash il 18 settembre.
Articolo originale
Il team Qwen di Alibaba ha rilasciato Qwen3.8-Max il 3 agosto 2026, puntando dritto nell'area più contesa del mercato di frontiera: l'ingegneria del software autonoma e il lavoro enterprise a lungo orizzonte. È la prima volta che Qwen prevede di open-sourcizzare un modello di classe Max, con i pesi in uscita la prossima settimana insieme a un più piccolo Qwen3.8-27B.
Qwen3.8-Max è un modello mixture-of-experts (MoE) sparso da 2,4 trilioni di parametri con 95B parametri attivi, finestra di contesto da 1M di token e input nativo di testo, immagini e video. Il claim principale è un punteggio di 86,1 su OSWorld-Verified, davanti a GPT-5.6 Sol Max a 83,2, Claude Fable 5 a 85,0 e Gemini 3.1 Pro a 76,2. Segna anche il punteggio PaperBench più alto riportato a 93,0 e costa $2/$6 per milione di token input/output.
In questo articolo, ti racconto tutte le novità di Qwen3.8-Max, tra funzionalità di coding e agent, benchmark e setup per test pratici che puoi eseguire. Per approfondimenti correlati, vedi le nostre guide a Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5 e la nostra guida completa all'API di Claude. Puoi anche leggere del nuovo Qwen3.8-Flash.
Qwen3.8-Max è il modello più capace della famiglia Qwen, un'architettura MoE sparsa con 2,4 trilioni di parametri totali e circa 95B attivi per passaggio forward.
Si basa sulle fondamenta architetturali di Qwen 3.5 e punta specificamente a quattro filoni:
Il cambiamento strutturale più grande rispetto a Qwen3.7-Max è la scala e l'impegno a rilasciare i pesi. Qwen non ha mai rilasciato i pesi di un modello di classe Max, e l'azienda afferma che sia Qwen3.8-Max sia Qwen3.8-27B arriveranno su Hugging Face e ModelScope la prossima settimana.
Alibaba non ha ancora comunicato la licenza, quindi non è chiaro se verrà distribuito sotto qualcosa di permissivo come Apache 2.0 o una licenza personalizzata più restrittiva.
La notizia più importante sul fronte benchmark che conta davvero è l'uso agentico del computer.
Su OSWorld-Verified, che misura quanto bene un agent opera in un ambiente desktop reale, Qwen3.8-Max supera tutti i modelli proprietari contro cui Qwen lo ha testato.
Per un modello che sarà self-hostable, è una proposta davvero diversa dalle solite release open-weight che inseguono la frontiera con una generazione di ritardo.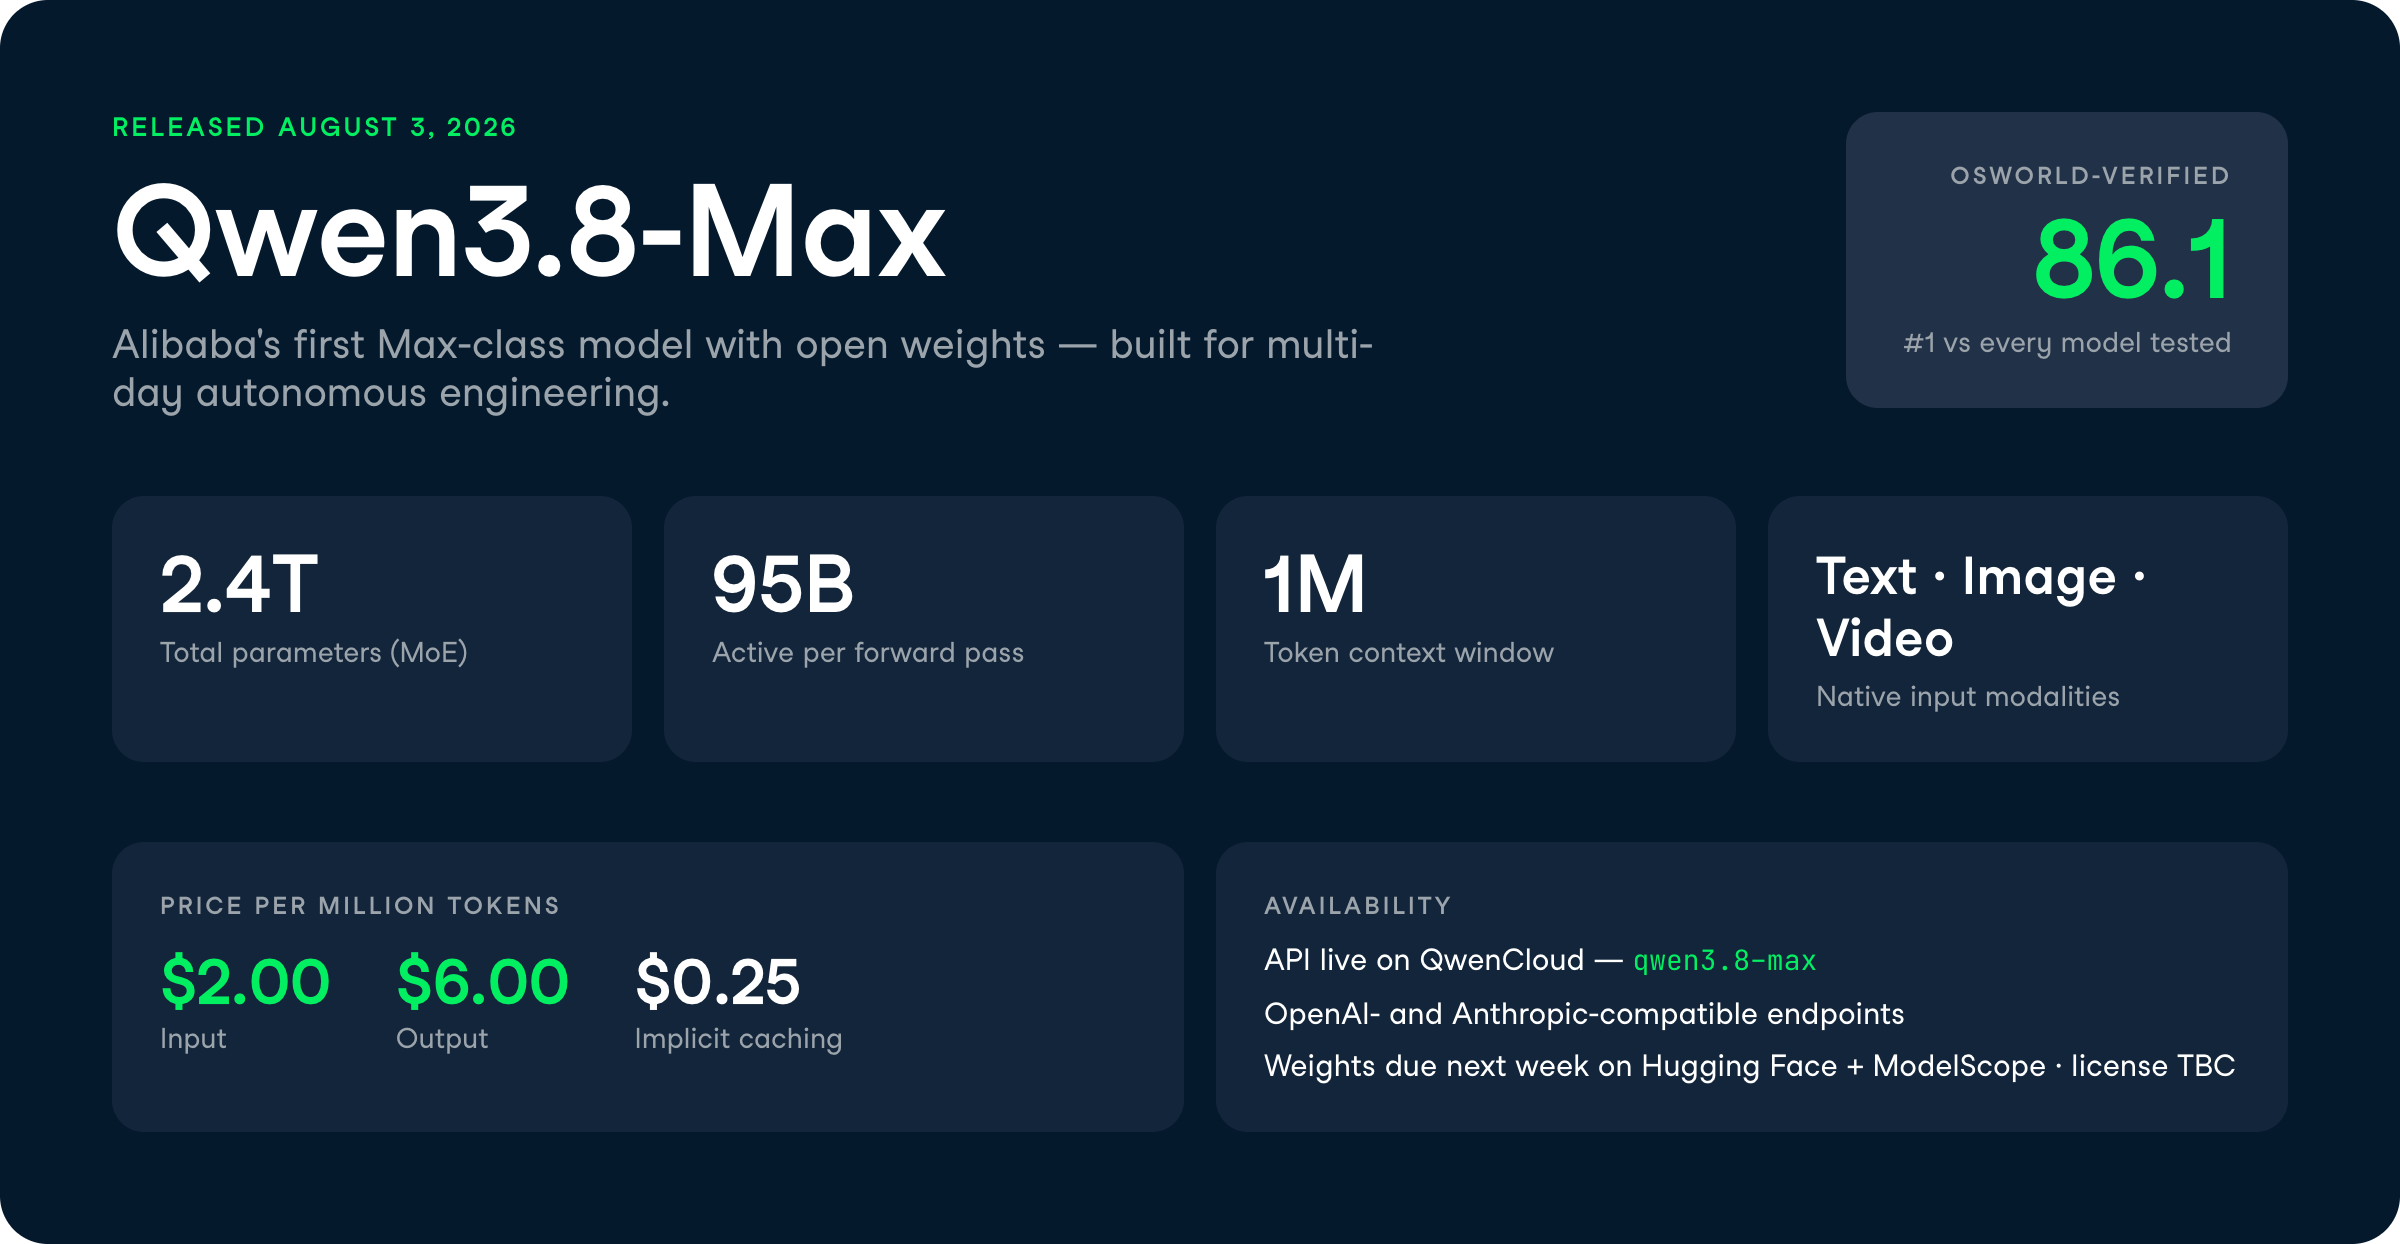
Il filo conduttore in Qwen3.8-Max è l'autonomia su lunghi orizzonti.
Qwen inquadra ogni capacità nella stessa idea: il modello non segue un piano fisso; si autocorregge tramite cicli di feedback nell'arco di giorni di lavoro continuo.
Ecco le funzionalità che mi colpiscono di più.
Qwen3.8-Max può portare un progetto di coding da una cartella vuota a un deliverable finito in giorni di lavoro continuo senza una persona nel loop.
La dimostrazione di punta dell'azienda è durata circa 16 giorni di operatività completamente autonoma, costruendo un harness CLI autoevolutivo che ha accumulato 265 commit, 127 PR e 151 issue.
Il meccanismo è un ciclo di feedback: i requisiti entrano come issue su GitHub, gli agent le prendono in carico ed eseguono, poi attivano build, unit test, test end-to-end e check CI prima del merge.
Per i praticanti, questo indica un modello progettato per far girare pipeline di engineering senza supervisione, più che per rispondere a singole domande di codice.
La riserva ovvia è che questi sono showcase gestiti dal vendor.
Un run autonomo di 16 giorni in un ambiente controllato non è come puntarlo sul tuo monorepo di produzione e andartene.
Qwen3.8-Max può leggere un paper, riprodurne gli esperimenti in codice da zero e poi provare a battere il metodo originale.
Nell'esempio di Qwen, il modello ha lavorato per circa 5 giorni (~125 ore), scritto circa 7.600 righe di codice, compiuto oltre 1.100 azioni ed eseguito 33 round di training GPU senza codice di partenza.
Prima ha riprodotto i sei risultati principali del paper, poi ha eseguito un ciclo auto-migliorante di ipotesi, codice, run su GPU e analisi su 4 round e 18 idee.
Il metodo finale che ha inventato ha superato l'approccio del paper di 2,71 punti su AIME24, un benchmark di matematica a livello competitivo.
Questo è il tipo di workflow che normalmente impegna una settimana di setup di un team di ricerca prima ancora di iniziare gli esperimenti.
Dynamic Workflows consentono a Qwen3.8-Max di pianificare un task in modo programmatico e distribuire in parallelo un gran numero di sub-agent.
In una demo di ricerca quantitativa, il modello ha scomposto 6 brevi descrizioni di fattori in 50 direzioni di ricerca ciascuna, ha distribuito circa 330 sub-agent e completato circa 6.000 backtest, adattando il workflow durante l'esecuzione.
Ciò che lo rende diverso da uno script fisso è che il modello ha agito in base all'evidenza.
Quando ha individuato segnali di overfitting, ha potato fattori ridondanti round dopo round; quando l'ensembling a tre modelli sembrava meno robusto della sintesi a direzione fissa su piccole cross-section, ha cambiato framework da solo.
I fattori selezionati hanno raggiunto Sharpe extra da 0,64 a 1,48, un esito concreto e verificabile, non solo una sensazione.
Qwen3.8-Max usa la visione durante l'esecuzione, non solo per leggere gli input.
Durante un task, ispeziona i propri output intermedi, individua problemi come un'interfaccia disallineata o un oggetto rivolto nel verso sbagliato e rivede il piano per correggerli.
Dal lato input, gestisce PDF oltre 200 pagine tra testo, grafici e layout, e può processare video più lunghi di 100 ore costruendo un grafo di memoria video di persone, eventi e timestamp.
Qwen ha anche rilasciato Qwen-MM-Plugins, una libreria di estensioni per harness che aggiunge elaborazione di immagini e video, memoria multimodale e uso di strumenti visivi ai framework di agent esistenti.
Per chi costruisce agent che lavorano molto con documenti o video, il grafo di memoria è il pezzo da tenere d'occhio.
Qwen3.8-Max espone un parametro reasoning_effort per scambiare costo e profondità. I tre livelli ti permettono di regolare quanto il modello pensa prima di rispondere:
xhigh (default): per task complessi che richiedono analisi approfonditamedium: bilancia accuratezza e velocitàlow: ragionamento efficiente ottimizzato per velocità e costoNota utile: un commento su r/LocalLLaMA ha osservato che i modelli Qwen tendono a "overthink", e che DeepSeek V4 Flash impiega meno tempo a ragionare anche quando produce output di qualità inferiore. Se il tuo carico è sensibile alla latenza, imposta low prima di dare per scontato che il default sia la scelta giusta.
La suite di benchmark di Qwen è fortemente orientata all'esecuzione a lungo orizzonte invece che agli esami statici, in linea con il posizionamento del modello.
Nei tavoli pubblicati, Qwen3.8-Max guida o resta altamente competitivo su uso agentico del computer, riproduzione della ricerca e coding, pur restando dietro a GPT-5.6 Sol Max e Fable 5 su alcune valutazioni di ingegneria del software.
Offre uno dei profili più equilibrati e ampi, senza dominare ogni categoria.
| Benchmark (Categoria) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (Software Engineering) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (Terminal Agent) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (Research Reproduction) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (Software Engineering) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (React Frontend) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (Professional Cowork Tasks) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (Agents Empower Human Workflows) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (Long-Horizon Valuable Tasks) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (Visual Reasoning)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (Chart Reasoning)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (Embodied Reasoning) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (Visual Perception) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (Long Video Understanding) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (Visual Web Development) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (Agentic Mobile Use) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (Agentic Computer Use) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Note importanti:
* Punteggi doppi: Per i benchmark con doppia metrica (BabyVision e CharXiv), i valori sono formattati come w/o python / w/ python in base ai numeri interni e superiori mostrati su quelle specifiche barre.
* Dati mancanti (-): I trattini indicano benchmark in cui il modello specifico non è stato testato o il punteggio è stato escluso dai grafici.
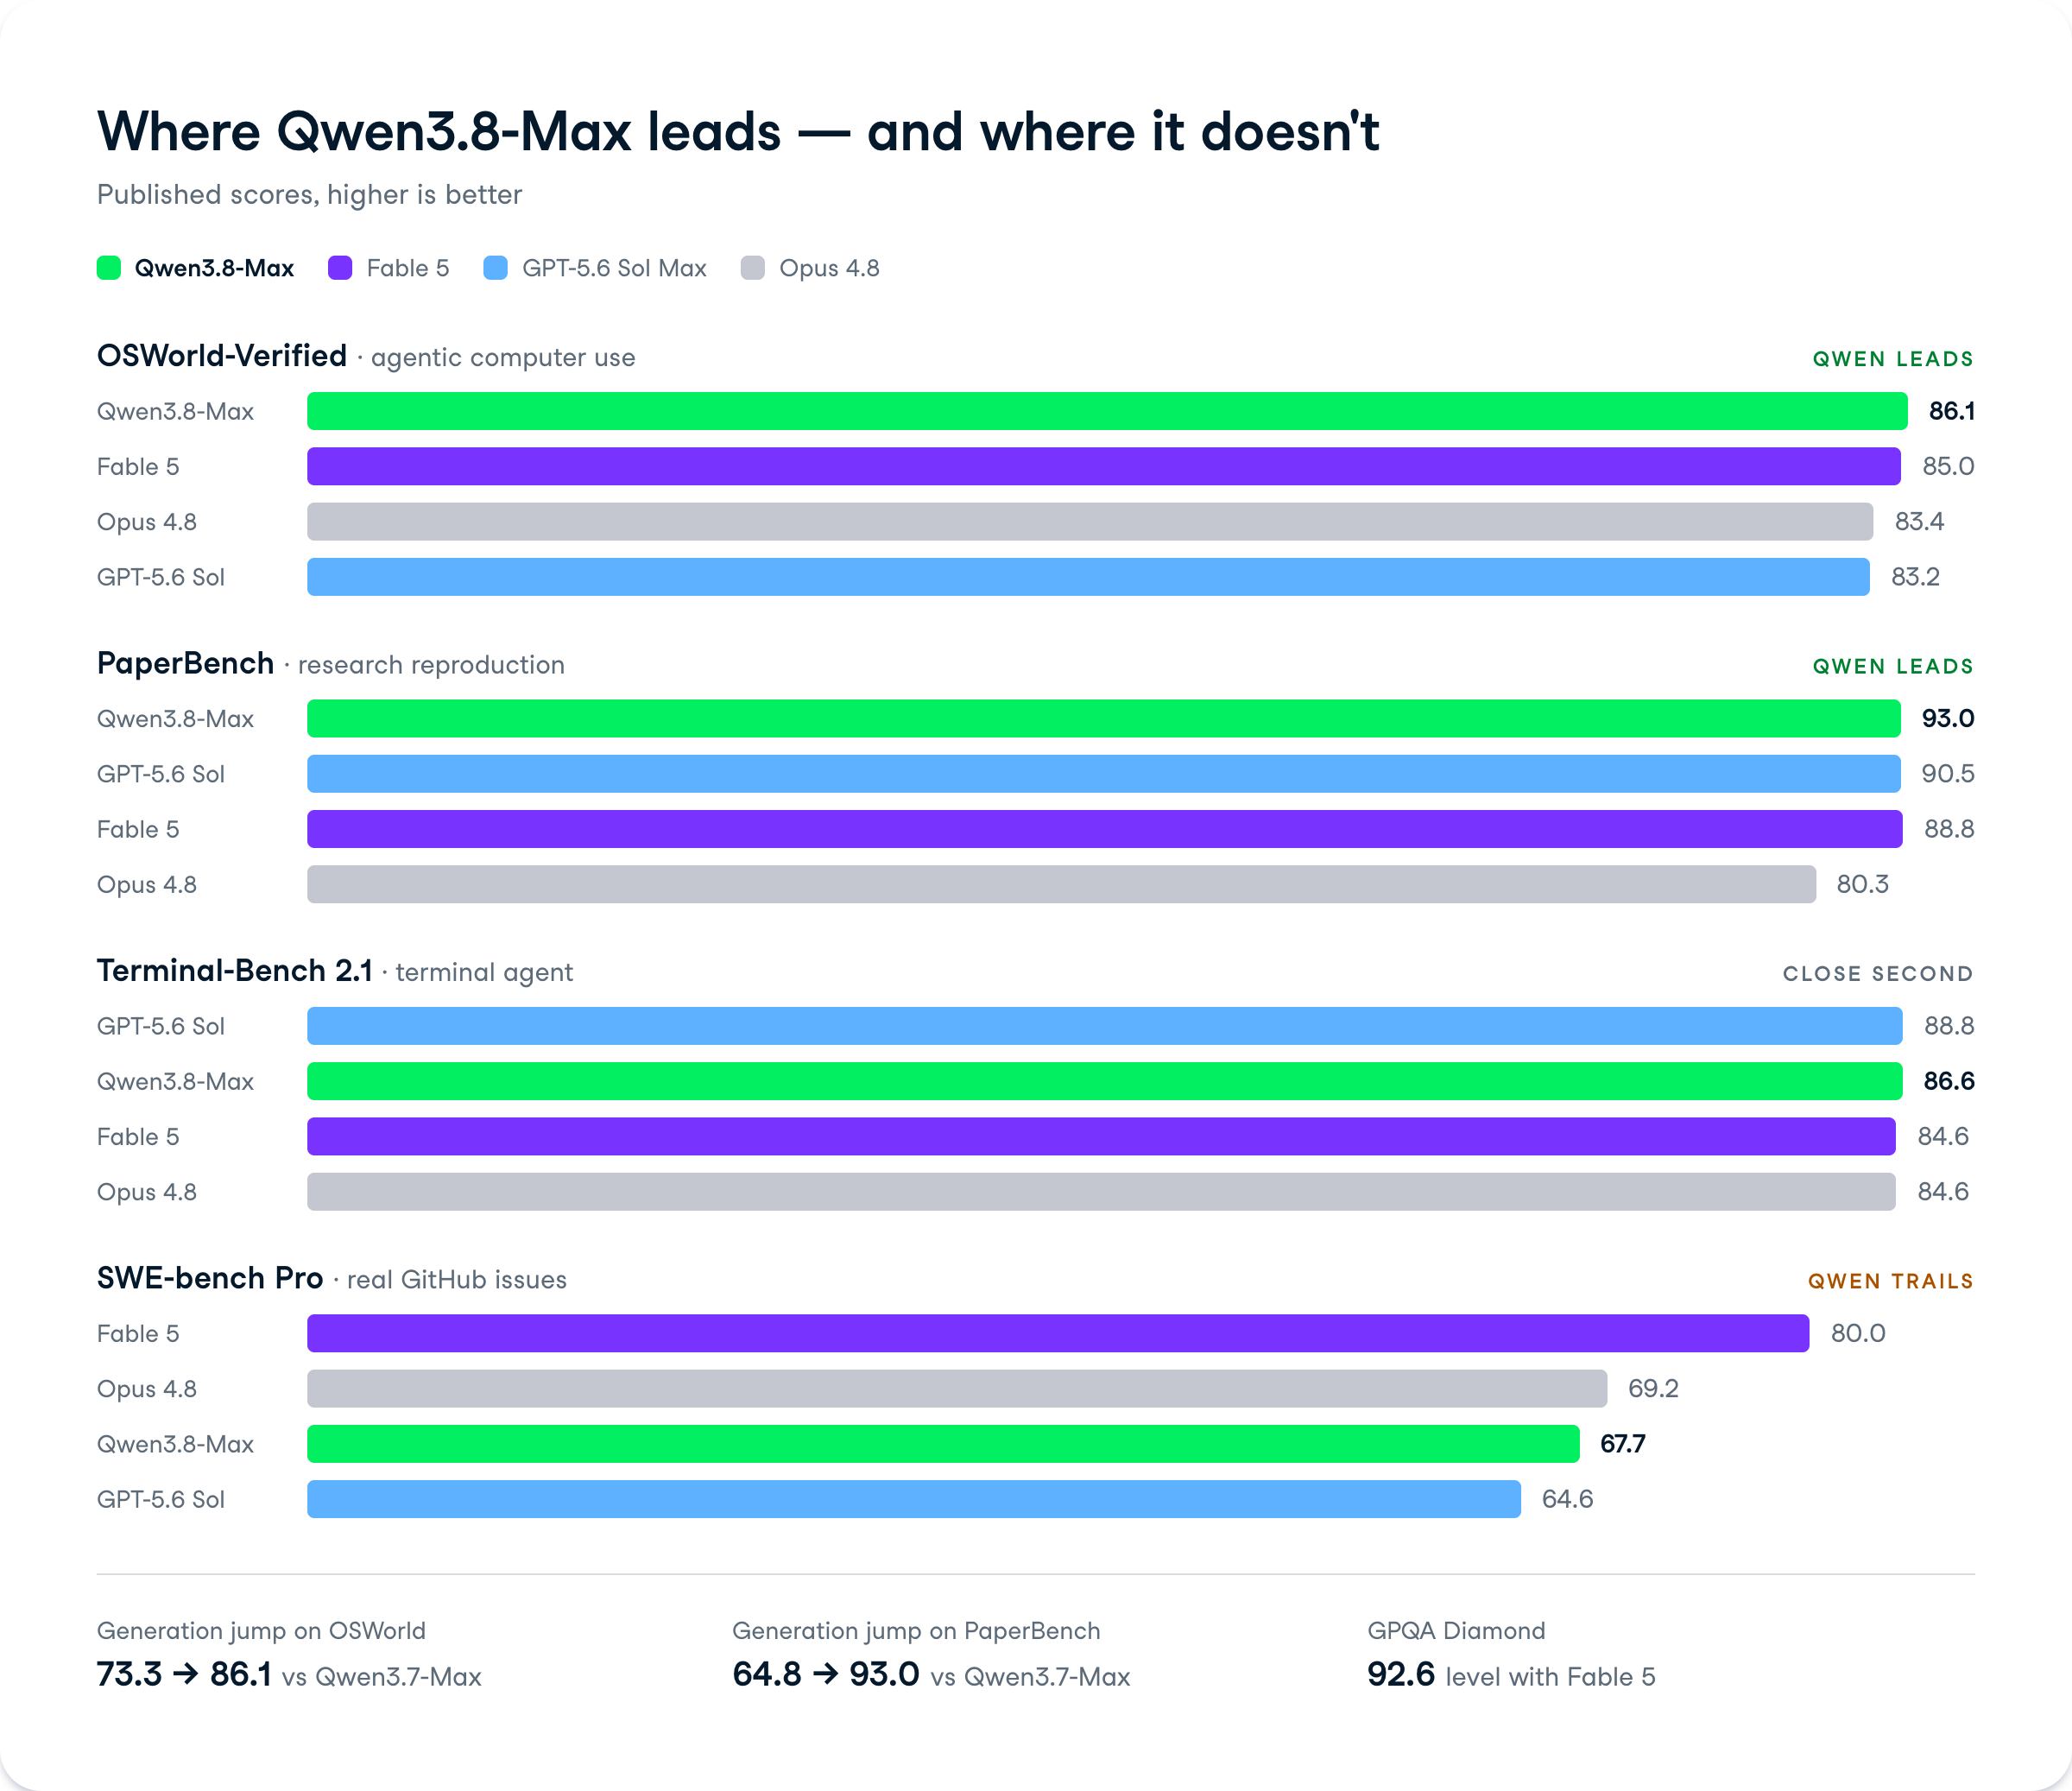
Qwen3.8-Max segna 86,1 su OSWorld-Verified, davanti a Fable 5 (85,0), GPT-5.6 Sol Max (83,2) e Gemini 3.1 Pro (76,2).
Questo benchmark misura quanto in modo affidabile un agent per l'uso del computer opera in un ambiente desktop reale, cliccando tra le interfacce e completando task multi-step.
Per chi costruisce agent che guidano applicazioni reali invece di chiamare API, questo è il numero che conta di più. Qwen3.7-Max segnava solo 73,3 qui, quindi il salto è significativo all'interno della famiglia.
Su PaperBench, Qwen3.8-Max ottiene 93,0, il punteggio più alto riportato, davanti a GPT-5.6 Sol a 90,5 e Fable 5 a 88,8.
PaperBench misura la capacità di un modello di riprodurre in codice gli esperimenti di un paper, mappando direttamente sulla demo di riproduzione di ricerca di 5 giorni.
È un ampio distacco rispetto a Qwen3.7-Max a 64,8. Se il tuo lavoro prevede trasformare paper in pipeline operative, è un segnale forte.
Qwen3.8-Max ottiene 86,6 su Terminal-Bench 2.1, tra GPT-5.6 Sol a 88,8 e gli 84,6 registrati sia da Opus 4.8 sia da Fable 5.
Questo benchmark testa un agent che lavora in un terminale per completare task di engineering entro un limite di tempo.
È un vero miglioramento rispetto ai 74,5 di Qwen3.7-Max, e porta un modello open-weight a ridosso dei migliori punteggi proprietari sul lavoro agentico da riga di comando.
Qui Qwen3.8-Max è indietro. Segna 67,7 su SWE-bench Pro, dietro a Fable 5 a 80,0 e Opus 4.8 a 69,2, ma davanti a GPT-5.6 Sol a 64,6.
SWE-bench Pro misura la risoluzione di issue reali su GitHub in codebase professionali.
Questo è il punto debole onesto. Quando abbiamo recensito Grok 4.5, Fable 5 guidava anche SWE-Bench Pro a 80,4, quindi il modello di Anthropic resta quello da battere su questa valutazione specifica.
Su GPQA Diamond, un benchmark di ragionamento scientifico a livello graduate, Qwen3.8-Max segna 92,6, alla pari con Fable 5 (92,6) e appena dietro GPT-5.6 Sol a 94,1. Guida anche su IFBench (instruction following) a 82,8, HealthBench a 60,2 e PRBench-Finance a 58,3.
Il pattern si conferma: forte su lavoro agentico e applicato, competitivo sul ragionamento e talvolta dietro sul test di ragionamento più difficile, Humanity's Last Exam, dove segna 43,6 contro i 53,3 di Fable 5.
Qwen3.8-Max è disponibile ora tramite QwenCloud con l'ID modello API qwen3.8-max. L'API supporta gli endpoint chat completions e responses compatibili con OpenAI, oltre a un'interfaccia compatibile con Anthropic, così puoi puntare strumenti come Claude Code o Codex con modifiche minime di configurazione.
Il pricing è a metà fascia e batte i principali modelli proprietari USA contro cui viene messo a confronto:
Quel totale combinato di $8 è meno di un terzo dei $30 di Claude Opus 5 e meno di un quarto dei $35 della modalità Standard di GPT-5.6 Sol. Eguaglia Grok 4.5, anch'esso a $2/$6, come notato nella nostra copertura su Grok 4.5. I pesi open di Qwen3.8-Max e Qwen3.8-27B sono attesi su Hugging Face e ModelScope la prossima settimana, anche se i termini di licenza non sono ancora pubblici.
Qwen3.8-Max è la dichiarazione di Alibaba su dove gli open weight possono competere. Guidare OSWorld-Verified e PaperBench contro Fable 5 e GPT-5.6 Sol Max, con un modello self-hostable prezzato a $2/$6, è il tipo di mossa che mette pressione a tutto il tier proprietario sul costo per task agentico.
Le cautele sono reali. Il run di 16 giorni di coding autonomo e i 5 giorni di riproduzione della ricerca sono showcase del vendor, non riproduzioni indipendenti, e la licenza dei pesi della prossima settimana è ancora sconosciuta. Su r/LocalLLaMA, il dibattito più interessante riguardava il più piccolo Qwen3.8-27B, con diversi commentatori più entusiasti di comprimere l'intelligenza su una singola GPU consumer che di un behemoth da 2,4T che solo pochi setup possono eseguire.
La mia opinione: se stai costruendo agent che operano interfacce reali o riproducono pipeline di ricerca, vale la pena testare seriamente Qwen3.8-Max, soprattutto quando usciranno i pesi e potrai fare self-hosting. Se il tuo lavoro è pura ingegneria software professionale su issue ostiche di GitHub, Fable 5 guida ancora SWE-bench Pro, quindi prova entrambi prima di decidere.
Se vuoi prendere dimestichezza con modelli come questo tramite le loro API, ti consiglio il nostro percorso di skill AI Fundamentals per costruire prima le basi.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




