今年我报道的大多数模型发布都在追同一个目标:更大的上下文窗口、更高的 SWE-bench 分数、再添一万亿参数。
PrismML 则走向了另一端。
2026 年 9 月 17 日,团队发布了 Ternary Bonsai 2 27B,这是 Qwen3.8 27B 的压缩版本,仅占 5.9GB,可在笔记本上运行。
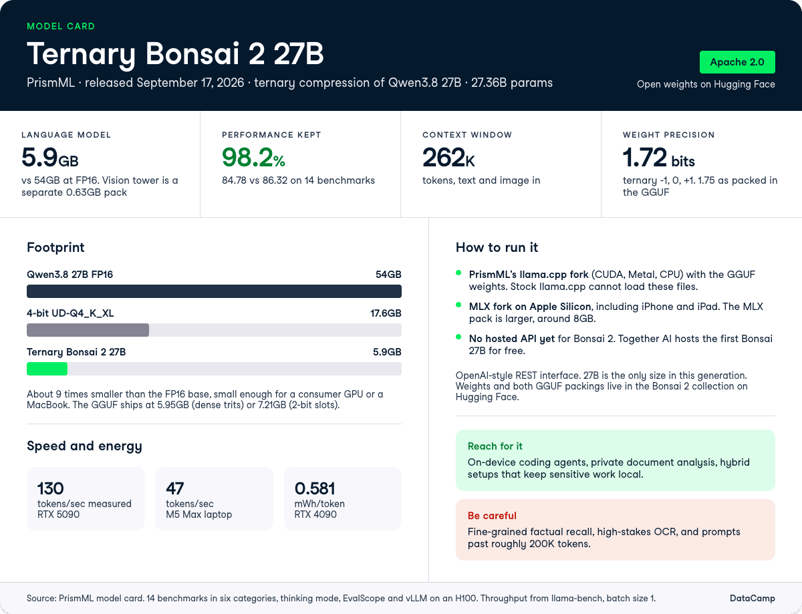
通过对信息存储进行高强度压缩,PrismML 让 Bonsai 2 27B 比原始 Qwen 版本小了 9 倍以上。同时,它仍保留了98.2% 的原始性能以及 262k 令牌的上下文窗口,支持处理文本和图像。
本文将全面介绍 Bonsai 2 27B 的新变化,涵盖新特性、基准测试表现,以及定价与获取方式。
如果您想自己运行第一代 Bonsai 模型,我们在Bonsai 27B 本地搭建教程中提供了循序渐进的操作指南。
要点速览
- Bonsai 2 27B 将 Qwen3.8 27B 压缩至 5.9GB,同时保留其综合基准性能的 98.2%。
- 关键在于能力保留的分布:数学与编程基本持平,而知识与视觉是受影响最大的部分。
- 可通过 CUDA 在 NVIDIA GPU 上本地运行,也可通过 MLX 在 Apple 设备上运行,在 RTX 5090 上可达每秒 143 个 token。
- 以 Apache 2.0 许可发布,权重可在 Hugging Face 获取,当前有第三方提供商免费托管。
- 如果您需要本地的编程代理或私有文档处理,值得一试;若依赖细粒度知识召回或高风险 OCR,请另寻他法。
什么是 Bonsai 2 27B?
Bonsai 2 27B 是 PrismML 的旗舰压缩多模态模型,通过在 Qwen3.8 27B 的语言模型中端到端应用三值量化构建而成。
在 FP16(未压缩的完整版)中,Qwen3.8 27B 需要 54GB;而 Bonsai 2 27B 的纯文本版本仅 5.9GB,小到足以放在消费级 GPU 或一台 MacBook 上。
据 PrismML 介绍,该压缩使用仅限于 −1、0、+1 的三值权重,并配合 FP16 分组缩放。在 PrismML 的核算下,相当于每个权重 1.72 个有效比特,而 FP16 参考为 16 比特。
该模型保留了 262K 令牌的上下文窗口和其基础模型的文本-图像多模态输入。
最醒目的结果就是保留率。
在 PrismML 描述的一套 6 个能力类别、14 个基准的测试中,使用 EvalScope 和 vLLM 在 H100 上以思维模式评测,Bonsai 2 27B 的平均分为 84.78,而 FP16 基线为 86.32,达到 98.2%。
对于一个低于 2 比特的模型来说,这比传统量化带来的差距小得多。
Bonsai 2 27B 的关键特性
使用 Bonsai 2 27B 的意义在于:在原本 27B 模型无法触及的环境中,运行 27B 级能力。
以下是它的核心特性。
在笔记本上运行 27B 多模态模型
Bonsai 2 27B 仅占 5.9GB,让 27B 级模型从数据中心走向消费级硬件。
低比特表示应用于整个语言模型,而非少数层,因而体积缩减是真实可感的,而非“装饰性”。
对从业者而言,这改变了“本地”的含义。
您无需为本地任务降到 8B,可以运行具有 27B 水平推理与编码能力的模型,同时还留有部分内存余量。
需要注意的是,架构上它仍是 27B 模型,因此在非常低端的硬件上仍会有内存压力。
用于长文档工作的 262K 令牌上下文
该模型提供 262K 令牌上下文窗口,足以在一个提示中容纳整个代码库、一份长篇法律合同或一摞研究类 PDF。
这对 RAG(检索增强生成)尤为重要,因为您可以将大量上下文常驻,而无需过度切片。
社区反馈也给出一个注意点:有用户指出,在接近窗口上限(约 200K 令牌之后)时,召回与连贯性会有所下降。
如果您要逼近上限,请在自己的数据上测试召回效果,再投入生产使用。
编程代理与工具调用
Bonsai 2 27B 专为代理式循环而构建,在多步过程中,细小错误可能会层层放大。
PrismML 展示了它通过 Cline 驱动编程代理,并运行电脑操作类工作流的能力,测试设备为 RTX 5090。
这通常是压缩最容易“失手”的领域,因为一步退化就可能让整个代理流程脱轨。
Bonsai 2 27B 在 LiveCodeBench 上得分 90.07、在 BFCL v3 上为 74.92,接近 FP16 水平,这使得本地代理工作不再只是“想象”,而是可行。
多模态文本与图像输入
模型可同时接受图像与文本,覆盖视觉问答、文档理解与 OCR。
这使得诸如从截图调试、分析扫描文档等私有多模态流程可以在本地完成,而无需上云。
但视觉也是压缩代价最明显的地方。
在 MMMU-Pro 上,Bonsai 2 27B 得分 75.49,而 FP16 为 81.73;在 OCR Bench v2 上则为 56.88 对 60.99。
对于高风险的文档处理、复杂图表或低分辨率文本,我会将视觉视为最薄弱环节,并对结果进行核验。
Bonsai 2 27B 的基准表现如何?
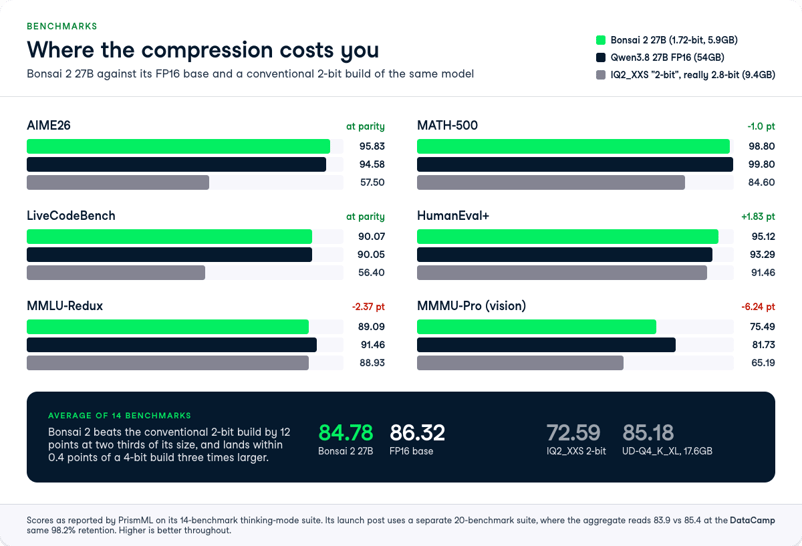
总体数据是 84.78 对 86.32(FP16),但汇总均值往往掩盖了关键差异。
传统的亚 4 比特构建会在需要持续性推理的基准上选择性坍塌,而 Bonsai 2 27B 正是为稳住这些项目而设计。
PrismML 的对比对象是同底座的传统 2 比特构建 Qwen3.8-27B IQ2_XXS,其综合得分为 72.59。
Bonsai 2 27B 在更小的体积(不足其三分之二)下高出 12 分以上,并与更大的 4 比特构建(UD-Q4_K_XL,85.18)仅差 0.4 分,同时体积只有后者的三分之一。
推理与数学
在数学上,Bonsai 2 27B 与全精度模型几乎无异。
它在 AIME26 上得分 95.83、在 MATH-500 上为 98.80,对应 FP16 的 94.58 与 99.80。
与传统量化的对比非常鲜明:IQ2_XXS 在 AIME26 上仅 57.50,暴跌 37 分,而这种差距在随手做几道简单题时很容易被忽略。
 在更广泛的知识与推理上,表现则略显温和。
Bonsai 2 27B 在 MMLU-Redux 上得分 89.09,而 FP16 为 91.46;第三方评测给出的知识与推理合成分约为 79.9,对比 FP16 的 85.6。
细粒度事实召回是三值压缩代价最大的地方。
编程与代理式工作流
编程表现基本持平,部分项目略有领先。Bonsai 2 27B 在 HumanEval+ 上得分 95.12、在 LiveCodeBench 上为 90.07,对应 FP16 的 93.29 与 90.05。
综合编程平均分为 89.42,对比 FP16 的 89.07,略胜一筹。
在代理式工具调用上,BFCL v3 为 74.92,对比 FP16 的 76.74,差距不大。
供参考,我们此前评测的Qwen3.8-Max(体量更大的 2.4T 模型)在 OSWorld-Verified 上拿到 86.1 的电脑操作代理分数,因此在原始代理能力上,Bonsai 2 27B 并非与云端旗舰竞争。
它竞争的是“能否在本地运行代理”本身。
指令跟随
指令跟随是少数几个 Bonsai 2 27B 能直接压过全精度模型的类别之一。
它在 IFEval 上得分 91.31(FP16 为 91.50),在 IFBench prompt-loose 上为 74.00(FP16 为 71.00)。
| 基准 | Bonsai 2 27B | Qwen3.8 27B FP16 | IQ2_XXS(2 比特) |
|---|
| AIME26 | 95.83 | 94.58 | 57.50 |
| MATH-500 | 98.80 | 99.80 | 84.60 |
| LiveCodeBench | 90.07 | 90.05 | 56.40 |
| HumanEval+ | 95.12 | 93.29 | 91.46 |
| MMLU-Redux | 89.09 | 91.46 | 88.93 |
| MMMU-Pro | 75.49 | 81.73 | 65.19 |
| 平均(14) | 84.78 | 86.32 | 72.59 |
吞吐与能效
速度也是这里基准故事的一部分——它决定了本地代理循环是否可用。
Bonsai 2 27B 在 NVIDIA GeForce RTX 5090 上最高可达每秒 143 个 token,在 M5 Max 上为每秒 46.8 个 token。
在能耗方面,PrismML 报告称 RTX 4090 上每个 token 为 0.581 mWh,据称比全精度运行的 8B 模型高效 40%。
对于编程助手,更高吞吐意味着更快的编辑-调试循环;对于笔记本上的后台助手,更低的每 token 能耗意味着更长的续航,同时减少频繁调用云端。
Bonsai 2 27B 的定价与可用性
Bonsai 2 27B 以 Apache 2.0 许可证发布,权重可免费下载并用于商业用途。
PrismML 将其定位为优先自托管的模型,官方文档侧重本地部署,而非按 token 计费的 API。
权重现已在 Hugging Face 的 Bonsai 2 合集中提供。
GGUF 构建的三值 PTQ1_0 变体约为 5.93 至 5.95GB,并提供体积更大的 MLX 构建。需要注意的是,Ternary Bonsai 2 仅有 27B,本代没有 8B、4B 或 1.7B 的同门。
如何获取 Bonsai 2 27B
Bonsai 2 27B 以 Apache 2.0 开放权重发布,通常是自行运行,而非调用专有 API。
它通过 CUDA 在 NVIDIA GPU 上运行,通过 MLX 在 Apple 设备(Mac、iPhone、iPad)上运行,使用 PrismML 的自定义低比特内核。
主要路径包括:
- 使用 PrismML 的 llama.cpp 分支自托管:从Hugging Face 合集拉取 GGUF 权重并部署;本地 API 基址默认为
http://localhost:8080/v1。
- 在 Apple Silicon 上用 MLX 自托管:部署 MLX 构建,本地 API 基址为
http://localhost:8081/v1;请注意,较旧的 Mac 可能因 MLX 变体大于 GGUF 而触及内存上限。
- 托管推理:通过 Together AI(模型名
Prism-ML/Ternary-Bonsai-27B)或 Puter 访问,目前均为免费。
PrismML 提供 OpenAI 风格的 REST 接口,可直接接入期望 chat-completions 端点的现有工具链。
如需第一代模型的本地完整演示,请参见我们的通用 Bonsai 本地搭建指南。
结语
Bonsai 2 27B 把赌注下在“每 GB 智能密度”而非“原始能力”上。
把保留率从第一代的 95% 拉到 98% 以上,让“近乎无损”的表述更像事实而非营销,密度图也显示其远超同底座的常规低比特构建。
如果您在构建本地编程代理、私有文档分析,或需要将敏感工作留在本地的混合系统,我会优先考虑它。
对于重知识问答与高风险 OCR,我会更为谨慎,因为压缩的代价真实且可测。


今年我报道的大多数模型发布都在追同一个目标:更大的上下文窗口、更高的 SWE-bench 分数、再添一万亿参数。
PrismML 则走向了另一端。
2026 年 9 月 17 日,团队发布了 Ternary Bonsai 2 27B,这是 Qwen3.8 27B 的压缩版本,仅占 5.9GB,可在笔记本上运行。
通过对信息存储进行高强度压缩,PrismML 让 Bonsai 2 27B 比原始 Qwen 版本小了 9 倍以上。同时,它仍保留了98.2% 的原始性能以及 262k 令牌的上下文窗口,支持处理文本和图像。
本文将全面介绍 Bonsai 2 27B 的新变化,涵盖新特性、基准测试表现,以及定价与获取方式。
如果您想自己运行第一代 Bonsai 模型,我们在Bonsai 27B 本地搭建教程中提供了循序渐进的操作指南。
要点速览
什么是 Bonsai 2 27B?
Bonsai 2 27B 是 PrismML 的旗舰压缩多模态模型,通过在 Qwen3.8 27B 的语言模型中端到端应用三值量化构建而成。
在 FP16(未压缩的完整版)中,Qwen3.8 27B 需要 54GB;而 Bonsai 2 27B 的纯文本版本仅 5.9GB,小到足以放在消费级 GPU 或一台 MacBook 上。
据 PrismML 介绍,该压缩使用仅限于 −1、0、+1 的三值权重,并配合 FP16 分组缩放。在 PrismML 的核算下,相当于每个权重 1.72 个有效比特,而 FP16 参考为 16 比特。
该模型保留了 262K 令牌的上下文窗口和其基础模型的文本-图像多模态输入。
最醒目的结果就是保留率。
在 PrismML 描述的一套 6 个能力类别、14 个基准的测试中,使用 EvalScope 和 vLLM 在 H100 上以思维模式评测,Bonsai 2 27B 的平均分为 84.78,而 FP16 基线为 86.32,达到 98.2%。
对于一个低于 2 比特的模型来说,这比传统量化带来的差距小得多。
Bonsai 2 27B 的关键特性
使用 Bonsai 2 27B 的意义在于:在原本 27B 模型无法触及的环境中,运行 27B 级能力。
以下是它的核心特性。
在笔记本上运行 27B 多模态模型
Bonsai 2 27B 仅占 5.9GB,让 27B 级模型从数据中心走向消费级硬件。
低比特表示应用于整个语言模型,而非少数层,因而体积缩减是真实可感的,而非“装饰性”。
对从业者而言,这改变了“本地”的含义。
您无需为本地任务降到 8B,可以运行具有 27B 水平推理与编码能力的模型,同时还留有部分内存余量。
需要注意的是,架构上它仍是 27B 模型,因此在非常低端的硬件上仍会有内存压力。
用于长文档工作的 262K 令牌上下文
该模型提供 262K 令牌上下文窗口,足以在一个提示中容纳整个代码库、一份长篇法律合同或一摞研究类 PDF。
这对 RAG(检索增强生成)尤为重要,因为您可以将大量上下文常驻,而无需过度切片。
社区反馈也给出一个注意点:有用户指出,在接近窗口上限(约 200K 令牌之后)时,召回与连贯性会有所下降。
如果您要逼近上限,请在自己的数据上测试召回效果,再投入生产使用。
编程代理与工具调用
Bonsai 2 27B 专为代理式循环而构建,在多步过程中,细小错误可能会层层放大。
PrismML 展示了它通过 Cline 驱动编程代理,并运行电脑操作类工作流的能力,测试设备为 RTX 5090。
这通常是压缩最容易“失手”的领域,因为一步退化就可能让整个代理流程脱轨。
Bonsai 2 27B 在 LiveCodeBench 上得分 90.07、在 BFCL v3 上为 74.92,接近 FP16 水平,这使得本地代理工作不再只是“想象”,而是可行。
多模态文本与图像输入
模型可同时接受图像与文本,覆盖视觉问答、文档理解与 OCR。
这使得诸如从截图调试、分析扫描文档等私有多模态流程可以在本地完成,而无需上云。
但视觉也是压缩代价最明显的地方。
在 MMMU-Pro 上,Bonsai 2 27B 得分 75.49,而 FP16 为 81.73;在 OCR Bench v2 上则为 56.88 对 60.99。
对于高风险的文档处理、复杂图表或低分辨率文本,我会将视觉视为最薄弱环节,并对结果进行核验。
Bonsai 2 27B 的基准表现如何?
总体数据是 84.78 对 86.32(FP16),但汇总均值往往掩盖了关键差异。
传统的亚 4 比特构建会在需要持续性推理的基准上选择性坍塌,而 Bonsai 2 27B 正是为稳住这些项目而设计。
PrismML 的对比对象是同底座的传统 2 比特构建 Qwen3.8-27B IQ2_XXS,其综合得分为 72.59。
Bonsai 2 27B 在更小的体积(不足其三分之二)下高出 12 分以上,并与更大的 4 比特构建(UD-Q4_K_XL,85.18)仅差 0.4 分,同时体积只有后者的三分之一。
推理与数学
在数学上,Bonsai 2 27B 与全精度模型几乎无异。
它在 AIME26 上得分 95.83、在 MATH-500 上为 98.80,对应 FP16 的 94.58 与 99.80。
与传统量化的对比非常鲜明:IQ2_XXS 在 AIME26 上仅 57.50,暴跌 37 分,而这种差距在随手做几道简单题时很容易被忽略。
Bonsai 2 27B 在 MMLU-Redux 上得分 89.09,而 FP16 为 91.46;第三方评测给出的知识与推理合成分约为 79.9,对比 FP16 的 85.6。
细粒度事实召回是三值压缩代价最大的地方。
编程与代理式工作流
编程表现基本持平,部分项目略有领先。Bonsai 2 27B 在 HumanEval+ 上得分 95.12、在 LiveCodeBench 上为 90.07,对应 FP16 的 93.29 与 90.05。
综合编程平均分为 89.42,对比 FP16 的 89.07,略胜一筹。
在代理式工具调用上,BFCL v3 为 74.92,对比 FP16 的 76.74,差距不大。
供参考,我们此前评测的Qwen3.8-Max(体量更大的 2.4T 模型)在 OSWorld-Verified 上拿到 86.1 的电脑操作代理分数,因此在原始代理能力上,Bonsai 2 27B 并非与云端旗舰竞争。
它竞争的是“能否在本地运行代理”本身。
指令跟随
指令跟随是少数几个 Bonsai 2 27B 能直接压过全精度模型的类别之一。
它在 IFEval 上得分 91.31(FP16 为 91.50),在 IFBench prompt-loose 上为 74.00(FP16 为 71.00)。
吞吐与能效
速度也是这里基准故事的一部分——它决定了本地代理循环是否可用。
Bonsai 2 27B 在 NVIDIA GeForce RTX 5090 上最高可达每秒 143 个 token,在 M5 Max 上为每秒 46.8 个 token。
在能耗方面,PrismML 报告称 RTX 4090 上每个 token 为 0.581 mWh,据称比全精度运行的 8B 模型高效 40%。
对于编程助手,更高吞吐意味着更快的编辑-调试循环;对于笔记本上的后台助手,更低的每 token 能耗意味着更长的续航,同时减少频繁调用云端。
Bonsai 2 27B 的定价与可用性
Bonsai 2 27B 以 Apache 2.0 许可证发布,权重可免费下载并用于商业用途。
PrismML 将其定位为优先自托管的模型,官方文档侧重本地部署,而非按 token 计费的 API。
权重现已在 Hugging Face 的 Bonsai 2 合集中提供。
GGUF 构建的三值 PTQ1_0 变体约为 5.93 至 5.95GB,并提供体积更大的 MLX 构建。需要注意的是,Ternary Bonsai 2 仅有 27B,本代没有 8B、4B 或 1.7B 的同门。
如何获取 Bonsai 2 27B
Bonsai 2 27B 以 Apache 2.0 开放权重发布,通常是自行运行,而非调用专有 API。
它通过 CUDA 在 NVIDIA GPU 上运行,通过 MLX 在 Apple 设备(Mac、iPhone、iPad)上运行,使用 PrismML 的自定义低比特内核。
主要路径包括:
http://localhost:8080/v1。http://localhost:8081/v1;请注意,较旧的 Mac 可能因 MLX 变体大于 GGUF 而触及内存上限。Prism-ML/Ternary-Bonsai-27B)或 Puter 访问,目前均为免费。PrismML 提供 OpenAI 风格的 REST 接口,可直接接入期望 chat-completions 端点的现有工具链。
如需第一代模型的本地完整演示,请参见我们的通用 Bonsai 本地搭建指南。
结语
Bonsai 2 27B 把赌注下在“每 GB 智能密度”而非“原始能力”上。
把保留率从第一代的 95% 拉到 98% 以上,让“近乎无损”的表述更像事实而非营销,密度图也显示其远超同底座的常规低比特构建。
如果您在构建本地编程代理、私有文档分析,或需要将敏感工作留在本地的混合系统,我会优先考虑它。
对于重知识问答与高风险 OCR,我会更为谨慎,因为压缩的代价真实且可测。