
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.5K
De meeste modellanceringen die ik dit jaar heb behandeld, jagen hetzelfde doel na: een grotere contextwindow, een hogere SWE-benchscore, nog een biljoen parameters.
PrismML gaat de andere kant op.
Op 17 september 2026 bracht het team Ternary Bonsai 2 27B uit, een gecomprimeerde versie van Qwen3.8 27B die in 5,9GB past en op een laptop draait.
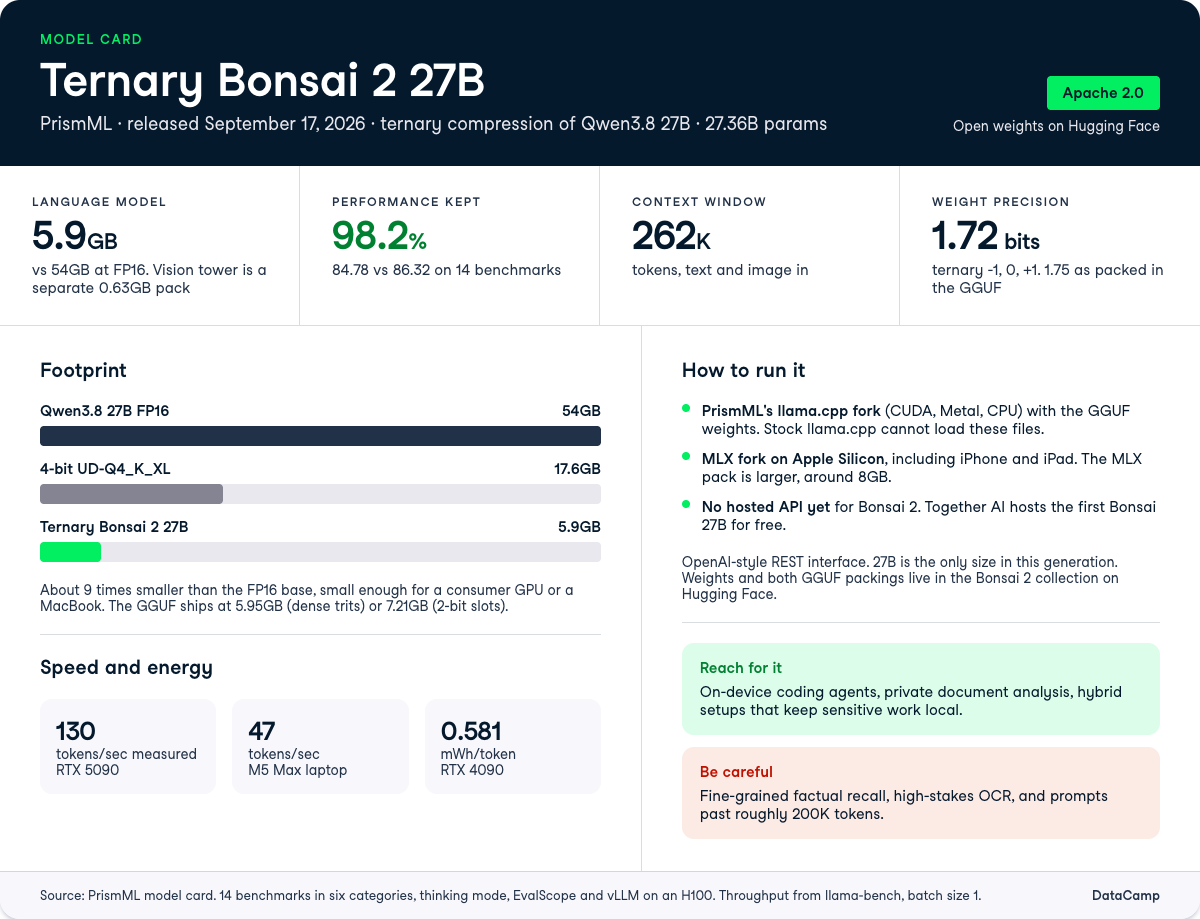
Door extreem te comprimeren hoe informatie wordt opgeslagen, maakte PrismML Bonsai 2 27B meer dan 9 keer kleiner dan de originele Qwen-versie. Toch behoudt het 98,2% van de oorspronkelijke prestaties en het 262k-token contextwindow, met verwerking van tekst en afbeeldingen.
In dit artikel bespreek ik alles wat nieuw is aan Bonsai 2 27B: de nieuwe features, de benchmarks, en de prijs en toegang.
Wil je zelf het eerste Bonsai-model draaien? We hebben een stapsgewijze handleiding in onze Bonsai 27B local setup-tutorial.
Bonsai 2 27B is PrismML’s vlaggenschip voor gecomprimeerde multimodale modellen, gebouwd door ternary kwantisatie end-to-end toe te passen op het taalmodel van Qwen3.8 27B.
Waar de full-precision Qwen3.8 27B 54GB inneemt in FP16 (de ongecomprimeerde, full-size versie van het model), komt Bonsai 2 27B uit op 5,9GB voor alleen tekst, klein genoeg voor een consument-GPU of een MacBook.
Volgens PrismML gebruikt de compressie ternary gewichten beperkt tot −1, 0 en +1, gecombineerd met FP16 group-wise scaling. Dat komt neer op 1,72 echte bits per gewicht volgens PrismML’s eigen berekening, tegenover 16 bits voor de FP16-referentie.
Het model behoudt het 262K-token contextwindow en multimodale invoer van tekst en afbeelding van zijn basis.
Het belangrijkste resultaat is het retentiegetal.
Over een suite die PrismML beschrijft als 14 benchmarks in zes vaardigheidscategorieën, geëvalueerd in thinking mode met EvalScope en vLLM op een H100, scoort Bonsai 2 27B gemiddeld 84,78 tegenover 86,32 voor de FP16-baseline, oftewel 98,2%.
Voor een model onder de 2 bits is dat een veel kleinere kloof dan conventionele kwantisatie oplevert.
Wat je met Bonsai 2 27B kunt doen, komt neer op 27B-klasse capaciteiten draaien op plekken waar een 27B-model normaal niet past.
Dit zijn de kenmerken die het model definiëren.
Bonsai 2 27B past in 5,9GB, waardoor een 27B-klasse model bereikbaar wordt op consumentenhardware in plaats van een datacenter.
De low-bit representatie wordt toegepast over het hele taalmodel, niet slechts enkele lagen, dus de footprintreductie is echt in plaats van cosmetisch.
Voor practitioners verandert dit wat “lokaal” betekent.
In plaats van terug te schakelen naar een 8B-model voor on-device werk, kun je iets draaien met het redeneer- en codeervermogen van een 27B-model en nog steeds RAM overhouden.
Het addertje is dat het architectonisch nog steeds een 27B-model is, dus op zeer low-end hardware zal de geheugendruk voelbaar zijn.
Het model biedt een 262K-token contextwindow, genoeg voor een volledige codebase, een lang juridisch contract of een stapel onderzoeks-pdf’s in één prompt.
Dat is vooral belangrijk voor retrieval-augmented generation opstellingen waarin je veel context resident wilt houden in plaats van agressief te chunken.
Communityrapporten melden hier één kanttekening: sommige gebruikers zien een achteruitgang in recall en samenhang aan het uiterste einde van het window, voorbij grofweg 200K tokens.
Als je tegen de limiet aan duwt, test de recall dan op je eigen data voordat je het in productie vertrouwt.
Bonsai 2 27B is gebouwd om stand te houden in agentic loops, waar kleine fouten zich over veel stappen opstapelen.
PrismML demonstreerde het aansturen van codeeragents via Cline en het draaien van computer-use workflows, beide op een RTX 5090.
Dit is juist het gebied waar compressie meestal uit elkaar valt, omdat één gedegradeerde stap een hele agent-run kan ontsporen.
Bonsai 2 27B scoort 90,07 op LiveCodeBench en 74,92 op BFCL v3, dicht bij de FP16-cijfers, wat lokaal agentwerk hier plausibel maakt in plaats van aspiratief.
Het model accepteert afbeeldingen naast tekst, voor visual question answering, documentbegrip en OCR.
Dit opent privé multimodale workflows zoals debuggen vanaf een screenshot of een gescand document analyseren zonder het naar de cloud te sturen.
Visie is ook waar de compressiekosten het duidelijkst zichtbaar zijn.
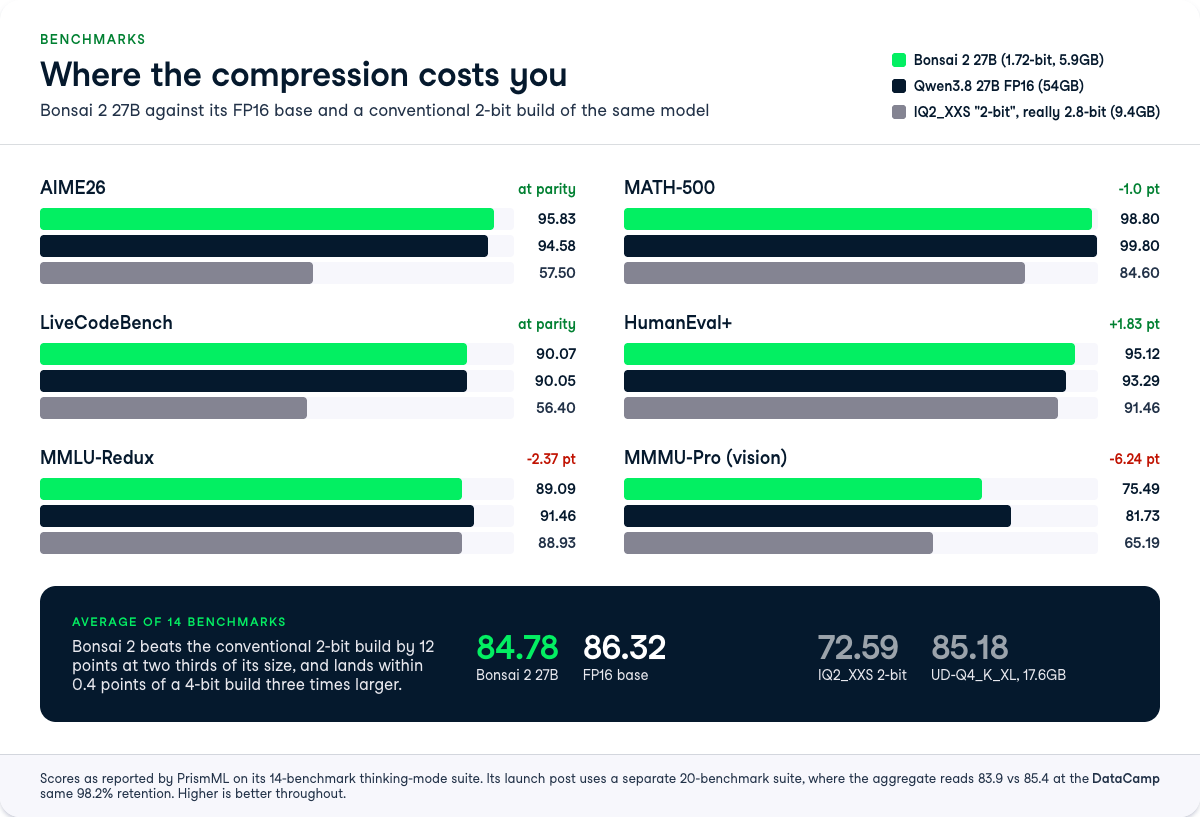
Op MMMU-Pro scoort Bonsai 2 27B 75,49 tegenover 81,73 voor het FP16-model, en op OCR Bench v2 zakt het naar 56,88 tegenover 60,99.
Voor documentverwerking met hoge inzet, complexe diagrammen of laag-resolutie tekst zou ik visie als de zwakste schakel behandelen en resultaten verifiëren.
Het aggregate verhaal is 84,78 versus 86,32 voor FP16, maar dat cijfer vertelt niet wat er echt toe doet.
Conventionele sub-4-bit builds storten selectief in op precies de benchmarks die langdurig redeneren vereisen, en Bonsai 2 27B is ontworpen om daar stand te houden.
De vergelijking die PrismML maakt, is met een conventionele 2-bit build van hetzelfde basismodel, Qwen3.8-27B IQ2_XXS, die 72,59 aggregate scoort.
Bonsai 2 27B scoort meer dan 12 punten hoger met minder dan twee derde van de grootte, en komt binnen 0,4 punt van een veel grotere 4-bit build (UD-Q4_K_XL op 85,18) terwijl het een derde van de footprint heeft.
Wiskunde is waar Bonsai 2 27B bijna niet te onderscheiden is van het full-precision model.
Het scoort 95,83 op AIME26 en 98,80 op MATH-500, tegenover FP16-scores van 94,58 en 99,80.
Het contrast met conventionele kwantisatie is scherp: IQ2_XXS zakt naar 57,50 op AIME26, een instorting van 37 punten die je met casual testen op makkelijke vragen totaal zou missen.
 Bij bredere kennis en redeneren is het beeld zachter.
Bonsai 2 27B scoort 89,09 op MMLU-Redux tegenover 91,46 voor FP16, en externe reviews plaatsen de samengestelde kennis-en-redeneren-categorie rond 79,9 tegenover 85,6 voor FP16.
Fijnmazige feitelijke recall is waar ternary compressie je het meest kost.
Coderen blijft gelijk, en op sommige punten net boven het basismodel. Bonsai 2 27B scoort 95,12 op HumanEval+ en 90,07 op LiveCodeBench, tegenover FP16-scores van 93,29 en 90,05.
Het samengestelde gemiddelde voor coderen op 89,42 versus 89,07 voor FP16 is een kleine winst voor het gecomprimeerde model.
Bij agentic tool calling zit BFCL v3 op 74,92 tegenover 76,74 voor FP16, een bescheiden kloof.
Ter vergelijking: toen we Qwen3.8-Max beoordeelden, scoorde het veel grotere 2,4T-model 86,1 op OSWorld-Verified voor agentic computer use, dus Bonsai 2 27B concurreert niet met cloudvlaggenschepen op pure agentcapaciteit.
Het concurreert erop dat je de agent überhaupt lokaal kunt draaien.
Instructievolging is een van de weinige categorieën waar Bonsai 2 27B het full-precision model rechtstreeks voorbijgaat.
Het scoort 91,31 op IFEval versus 91,50 voor FP16, en 74,00 op IFBench prompt-loose tegenover 71,00 voor FP16.
| Benchmark | Bonsai 2 27B | Qwen3.8 27B FP16 | IQ2_XXS (2-bit) |
|---|---|---|---|
| AIME26 | 95.83 | 94.58 | 57.50 |
| MATH-500 | 98.80 | 99.80 | 84.60 |
| LiveCodeBench | 90.07 | 90.05 | 56.40 |
| HumanEval+ | 95.12 | 93.29 | 91.46 |
| MMLU-Redux | 89.09 | 91.46 | 88.93 |
| MMMU-Pro | 75.49 | 81.73 | 65.19 |
| Average (14) | 84.78 | 86.32 | 72.59 |
Snelheid is hier onderdeel van het benchmarkverhaal, omdat het bepaalt of lokale agent-loops bruikbaar zijn.
Bonsai 2 27B haalt tot 143 tokens/seconde op een NVIDIA GeForce RTX 5090 en 46,8 tokens/seconde op een M5 Max.
Qua energie rapporteert PrismML 0,581 mWh per token op een RTX 4090, wat volgens hen 40% efficiënter is dan een 8B-model op full precision.
Voor codeerassistenten betekent hogere throughput snellere edit-debug-loops; voor achtergrondassistenten op een laptop betekent lagere energie per token een langere batterijduur zonder voortdurend de cloud aan te roepen.
Bonsai 2 27B is uitgebracht onder de Apache 2.0-licentie, dus de gewichten zijn gratis te downloaden en commercieel te gebruiken.
PrismML positioneert het primair als een self-hosted model, en de officiële docs richten zich op lokaal serven in plaats van een per-token API.
De gewichten zijn vandaag beschikbaar op Hugging Face in de Bonsai 2-collectie.
GGUF-builds komen uit rond 5,93 tot 5,95GB voor de ternary PTQ1_0-variant, met een MLX-build die groter draait. Let op: Ternary Bonsai 2 is alleen 27B, zonder 8B-, 4B- of 1,7B-varianten in deze generatie.
Bonsai 2 27B heeft open gewichten onder Apache 2.0, dus je draait het zelf in plaats van een propriëtaire API aan te roepen.
Het draait op NVIDIA GPU’s via CUDA en op Apple-apparaten (Mac, iPhone, iPad) via MLX, met PrismML’s custom low-bit kernels.
De belangrijkste routes zijn:
http://localhost:8080/v1.http://localhost:8081/v1; houd er rekening mee dat oudere Macs RAM-limieten kunnen raken omdat de MLX-variant groter is dan de GGUF.Prism-ML/Ternary-Bonsai-27B of via Puter, beide momenteel gratis.PrismML biedt een OpenAI-achtige REST-interface, zodat het naadloos past in bestaande tooling die een chat-completions endpoint verwacht.
Voor een volledige lokale walkthrough van het eerste model, zie onze algemene Bonsai local setup-gids.
Bonsai 2 27B is een gok dat de interessante frontier intelligentie per gigabyte is, niet pure capaciteit.
De retentiekloof dichten van 95% in de eerste generatie naar meer dan 98% is wat de “bijna verliesloze” framing geloofwaardig maakt in plaats van marketing, en de dichtheidsgrafiek zet het ruim voor op conventionele low-bit builds van dezelfde basis.
Ik zou hiervoor kiezen als je on-device codeeragents, privé documentanalyse of hybride systemen bouwt die gevoelig werk lokaal houden.
Ik zou voorzichtiger zijn bij kennisintensieve QA en high-stakes OCR, waar de compressiekost reëel en meetbaar is.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

