ディープニューラルネットワークを学習していて、損失がNaNになるのを何度見たことがありますか?
何時間も学習させて損失曲線は順調そうに見えるのに、突然どこからともなく無限大に跳ね上がる。たいていの原因は爆発的勾配です—逆伝播の過程で勾配が非常に大きくなり、パラメータ更新が不安定になってモデルが壊れてしまう現象です。これは再帰型ネットワークで特に起こりやすいですが、トランスフォーマーや深いフィードフォワードネットワークでも発生します。
グラディエントクリッピングは、オプティマイザに渡る前に勾配の大きさを制限することでこれを防ぎます。学習ループに1行加えるだけで、モデル自体を変えずに更新の大きさを抑えられます。
本記事では、グラディエントクリッピングの直感的な理解、2つの主要手法、しきい値の決め方、そしてPyTorchとTensorFlowでの実装方法を解説します。
ところで、データサイエンスにおける「損失」とは正確には何でしょうか?詳しくは 機械学習の損失関数 の記事をご覧ください。
グラディエントクリッピングとは?
グラディエントクリッピングは、学習中の勾配の大きさを制限し、不安定なパラメータ更新を防ぐための手法です。
勾配が大きくなりすぎると、オプティマイザはパラメータ空間で巨大な一歩を踏み出し、損失が発散する領域に重みを押しやってしまいます。クリッピングは、その前にステップサイズを上限で切り詰めることで被害を防ぎます。
重要なのは、グラディエントクリッピングはモデルのアーキテクチャに影響しないという点です。層を追加したり活性化関数を変えたりはしません。逆伝播とオプティマイザのステップの間で勾配を横取りして調整するだけで、学習プロセスのみを変更します。
そのため試しやすく、外すのも簡単です。後述のとおり、実装はたった1行です。
グラディエントクリッピングの仕組み
メカニズムは単純です。クリッピングはバックワードパスとオプティマイザのステップの間に置かれ、各イテレーションで以下の4手順を踏みます。
- 勾配を計算: 順伝播を実行し、損失を計算し、逆伝播を流します。ここは何も変わりません。勾配はいつも通りネットワークを流れます。
- 勾配の大きさを確認: 勾配がどれだけ大きいかを測定します。手法によって、個々の値を見るか、全パラメータにわたる全体ノルムを計算します。
- しきい値超過時に勾配を減少: 大きさが設定した上限を超えた場合は勾配を縮小します。超えなければそのままにします。
- モデルパラメータを更新: クリップ後の勾配をオプティマイザに渡して重み更新を適用します。
多くの場合、勾配はしきい値未満に収まり、クリッピングがなくても学習は通常通り進みます。スパイクが発生したときだけ、オプティマイザが反応する前にクリッピングが捕まえます。
以上です。
一般的なグラディエントクリッピング手法
勾配のクリッピングには2通りがあり、違いは何を測って何をスケールするかにあります。
値によるクリッピング
値によるクリッピングは、各勾配要素を個別に上限・下限で抑えます。
たとえば範囲を [-1.0, 1.0] と決めると、その範囲外の勾配値は最も近い境界に丸められます。勾配が 2.5 なら 1.0 に、-2.5 なら -1.0 になります。もともと範囲内の値は変更されません。
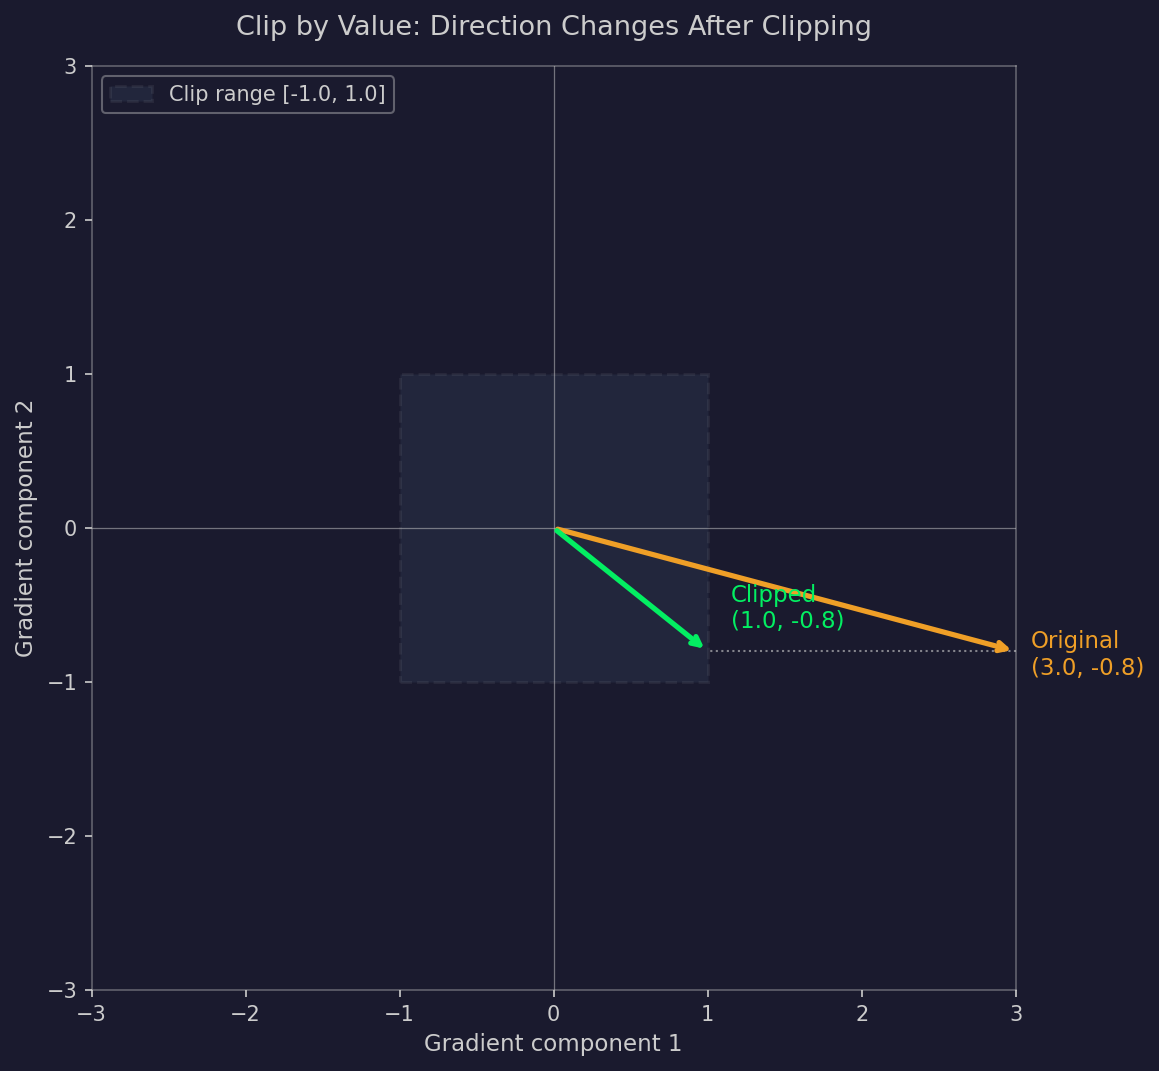
値によるクリッピングの例
魅力はその簡単さです。min/maxの操作以上の数学は不要で、高速に実行できます。
ただし欠点もあります。各要素を個別にクリップすると、勾配ベクトルの方向が変わってしまいます。ある成分だけがクリップされ他がされないと、更新後のベクトルは逆伝播が示した方向を向かなくなります。結果としてオプティマイザはやや誤った方向へ進んでしまいます。
そのため、実務では値によるクリッピングはあまり一般的ではありません。
ノルムによるクリッピング
ノルムによるクリッピングは、勾配全体の大きさがしきい値を超えたときに、勾配ベクトル全体をスケールします。
個々の値を見るのではなく、全勾配のノルム(通常はL2ノルム)を計算して最大値と比較します。ノルムがしきい値未満なら何も起こりません。超えていれば、全ての勾配に同じ係数を掛けてノルムを上限まで引き下げます。
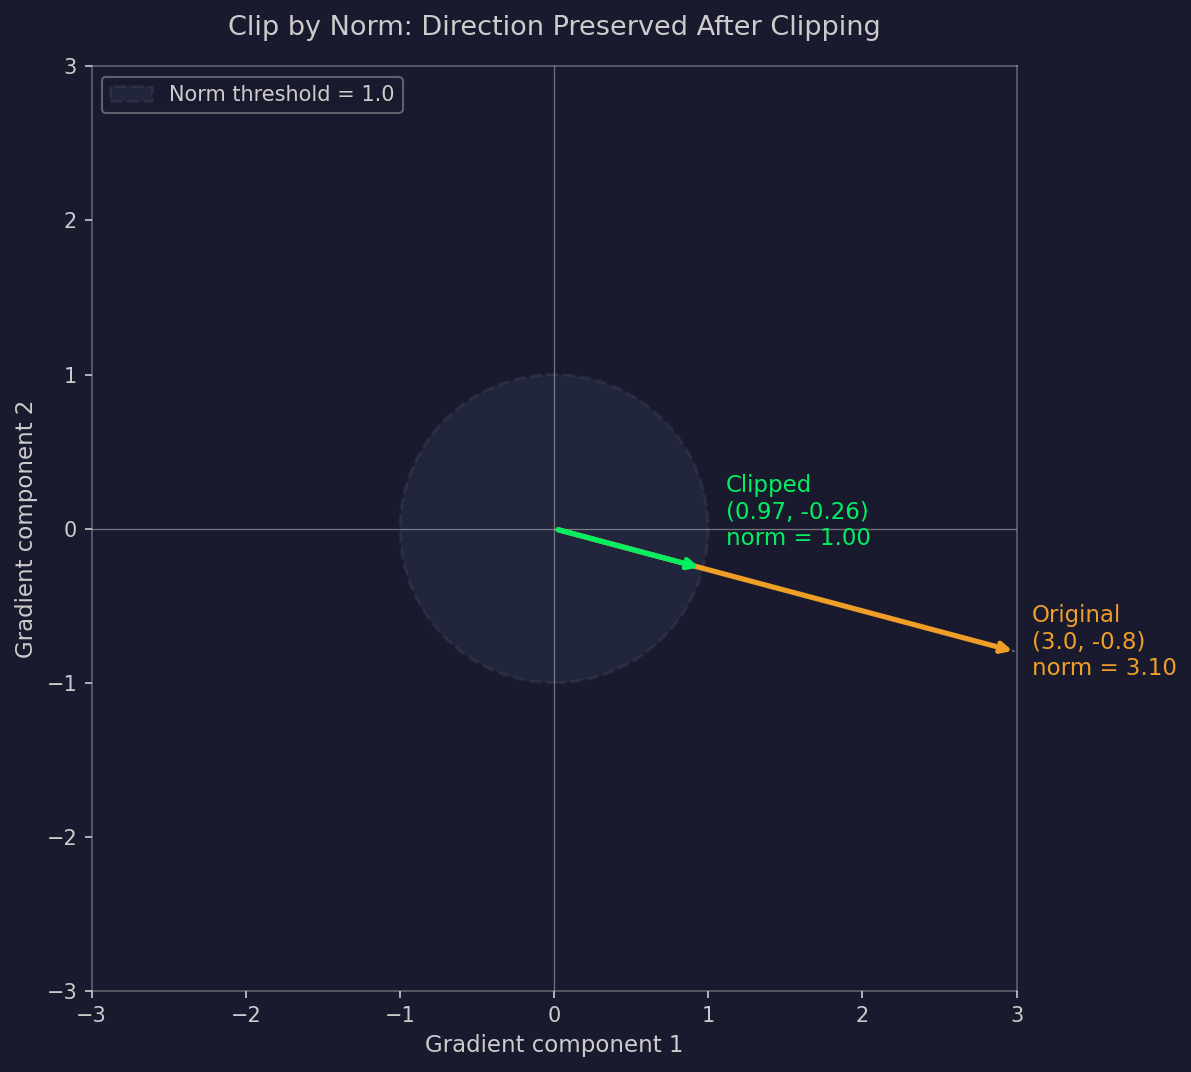
ノルムによるクリッピングの例
利点は方向が保たれることです。すべての成分が同じ割合で縮むため、勾配ベクトルは元の方向を向いたままです。ステップを短くするだけで、向きを変えてはいません。
このため、ノルムによるクリッピングが標準となりました。PyTorchの clip_grad_norm_ やTensorFlowの clipnorm はいずれもこの手法を実装しており、現代的な学習パイプラインの多くでデフォルトとして用いられます。
爆発的勾配と消失勾配
爆発的勾配と消失勾配はいずれもディープラーニングで一般的な問題ですが、グラディエントクリッピングが解決するのは前者だけです。
爆発的勾配
爆発的勾配は、逆伝播の過程で勾配の値が大きくなりすぎると起こります。
これは多層のネットワークや再帰型アーキテクチャでよく見られ、勾配が多くの層やタイムステップをまたいで掛け合わされます。掛け合わせが悪い方向に積み重なると、勾配の大きさが膨れ上がります。するとオプティマイザは巨大な更新を行い、重みが極端な値に飛び、損失が NaN や Inf になることがあります。
突然の損失スパイクや、急に発散するモデルとして現れます。
消失勾配
消失勾配はその逆の問題です。勾配の値がネットワークを逆向きに伝わるにつれてゼロに近づきます。
勾配が小さくなりすぎると重み更新が極小になり、初期層は学習をやめ、深い層の学習は遅くなり、実質的に学習が止まります。損失曲線は横ばいになり、多くのエポックを重ねても改善しません。
これは、LSTMやGRUが登場する前にRNNが長い系列で苦戦した主な理由でした。
グラディエントクリッピングの位置づけ
グラディエントクリッピングが対処するのは爆発的勾配であり、消失勾配ではありません。
クリッピングは大きすぎる勾配を縮小しますが、小さすぎる勾配には何もできません。消失勾配には、より良い重み初期化、残差接続、バッチ正規化、あるいは勾配フローを保つ設計のアーキテクチャを使う必要があります。
ノルムによるグラディエントクリッピングの解説
ノルムによるクリッピングは、読者が「グラディエントクリッピング」を検索したときに実際に求めている方法です。
手順は3つです。まず、全勾配をまとめたノルムを計算します。次に、そのノルムを選んだしきい値と比較します。最後に、ノルムが大きすぎる場合は勾配を再スケーリングします。
ノルムは通常L2ノルムで、各勾配値を二乗して合計し平方根を取ります。モデル全体のパラメータにまたがる勾配 g_1, g_2, ..., g_n があるとすると、L2ノルムは次の通りです。
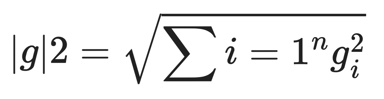
ノルムによるクリッピングの式
ノルムを得たら、しきい値 c と比較します。||g|| <= c なら勾配はそのまま通過し、||g|| > c なら全ての勾配にスケーリング係数 c / ||g|| を掛けます。これで新しいノルムはちょうど c になります。
重要なのは、すべての成分が同じ割合で縮むことです。勾配値同士の相対比は変わらず、ベクトルは元の方向を向いたまま。オプティマイザのステップの長さだけを短くし、行き先は変えません。
この方向保持の性質こそが、ノルムクリッピングがデフォルトの選択肢である理由です。値によるクリッピングは勾配ベクトルの向きをねじ曲げることがあります。ノルムによるクリッピングは長さだけを変えます。
PyTorchの clip_grad_norm_ とTensorFlowの clipnorm はまさにこれを行います。誰かが「グラディエントクリッピングを使っている」と言うとき、ほとんど常にノルムによるクリッピングを指します。
グラディエントクリッピングのしきい値の選び方
しきい値はハイパーパラメータです。あらゆるモデルで通用する普遍的な値はありません。
高く設定しすぎると、クリッピングはほとんど発動しません。勾配はほとんど常に上限未満に収まるため、安全網は何も捕まえられません。クリッピングがないのと同様に学習が進み、勾配が爆発すると損失スパイクが発生します。
低く設定しすぎると、過度にクリップされます。すべてのバッチで勾配が縮小され、本来よりも更新が小さくなります。学習が遅くなり、収束に時間がかかることがあります。
一般的な出発点は 1.0 で、多くのアーキテクチャでうまく機能します。実用上は 0.5 から 5.0 の範囲でほとんどをカバーできます。
より良い方法は、学習中に勾配ノルムを監視することです。各ステップでクリップ前のノルムをログに記録し、分布を確認します。ほとんどのノルムが 0.3 前後で、ときどき 50 まで跳ねるなら、通常域より少し上でスパイクよりは十分低い位置、例えば 2.0 や 3.0 に設定するのが妥当です。
他のハイパーパラメータと同様に扱ってください。まずは 1.0 で始め、挙動を見て調整します。
再帰型ニューラルネットワークにおけるグラディエントクリッピング
RNNは、グラディエントクリッピングが標準手法として定着した最初の領域です。
理由は、RNNが時間方向に勾配を伝播する仕組みにあります。時間方向の逆伝播では同じ重み行列が多くのタイムステップで繰り返し掛け合わされ、その積み重ねが巨大な値に膨れ上がることがあります。系列が長いほど問題は悪化します。
LSTMやGRUはゲーティング機構で問題を緩和しましたが、完全には解消していません。特に長い系列や高い学習率での学習では、両者ともクリッピングの恩恵を受けます。
RNNの学習では、しきい値 1.0〜5.0 のノルムクリッピングが典型的なデフォルトです。PyTorchの nn.LSTM や nn.GRU を使っていて学習中に損失が発散するなら、まず clip_grad_norm_ を追加するのが定石です。
現代のディープラーニングにおけるグラディエントクリッピング
RNNがトランスフォーマーに置き換わっても、グラディエントクリッピングは姿を消していません。
GPTやBERTのような大規模言語モデルは、事前学習やファインチューニングでクリッピングを使用します。ビジョントランスフォーマー、拡散モデル、数百層のディープアーキテクチャでも同様です。現代の学習で主流のAdamやAdamWは、多くの場合しきい値 1.0 前後のノルムクリッピングと組み合わされます。
理由はRNNと同じです。深いネットワークでは多くの層にわたり勾配が掛け合わされ、大きなバッチサイズと高い学習率の組み合わせで、ときどきスパイクが生じます。クリッピングは通常の学習ステップに影響せずに、それらのスパイクだけを処理します。
多くのリファレンス実装でクリッピングはデフォルトです。Hugging Faceの Trainer、PyTorch Lightning、DeepSpeedはいずれも標準の設定項目として露出しています。小さなお試しモデル以上を学習するなら、クリッピングはまず確実にパイプラインの一部です。
学習ループに1行足すだけでコストはほぼゼロ、何時間もの計算の末に学習がクラッシュするのを防げます。これが今でも使われ続ける理由です。
PyTorchでのグラディエントクリッピング
PyTorchでは、torch.nn.utils.clip_grad_norm_ というユーティリティ関数1つでグラディエントクリッピングを扱います。
クリッピングの呼び出しは loss.backward() と optimizer.step() の間に置きます。まず逆伝播で勾配を埋め、その後必要に応じてクリッピングで縮め、最後にオプティマイザが更新を適用します。これ以外の場所に置いても動作しません。
以下は、合成の回帰データで小さなMLPを学習し、グラディエントクリッピングを有効化した、完全に実行可能な学習スクリプトです:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
torch.manual_seed(42)
n_samples = 1000
n_features = 20
inputs = torch.randn(n_samples, n_features)
targets = (inputs.sum(dim=1, keepdim=True) * 2.0 + torch.randn(n_samples, 1) * 0.1)
dataset = TensorDataset(inputs, targets)
dataloader = DataLoader(dataset, batch_size=32, shuffle=True)
model = nn.Sequential(
nn.Linear(n_features, 64),
nn.ReLU(),
nn.Linear(64, 64),
nn.ReLU(),
nn.Linear(64, 1),
)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_fn = nn.MSELoss()
n_epochs = 5
max_grad_norm = 1.0
for epoch in range(n_epochs):
epoch_loss = 0.0
for batch_inputs, batch_targets in dataloader:
optimizer.zero_grad()
predictions = model(batch_inputs)
loss = loss_fn(predictions, batch_targets)
loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=max_grad_norm)
optimizer.step()
epoch_loss += loss.item()
print(f"Epoch {epoch + 1}: loss = {epoch_loss / len(dataloader):.4f}")提供:
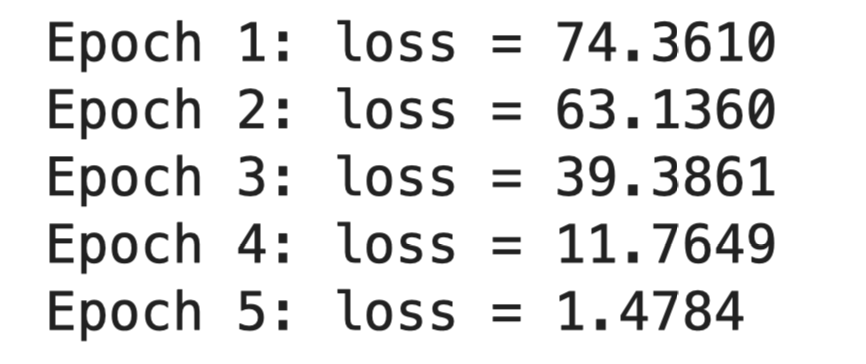
PyTorchの出力
clip_grad_norm_ 関数は主に2つの引数を取ります。
任意引数の norm_type は既定でL2ノルムの 2.0 です。変更が必要になることはまれです。
関数名末尾のアンダースコア clip_grad_norm_ はインプレース操作を意味します。各パラメータの .grad 属性内の勾配が直接変更されるため、戻り値を追跡する必要はありません。戻り値にはクリップ前の総ノルムが返るので、ログに使うには便利です。
値によるクリッピングを使う場合は、PyTorchには torch.nn.utils.clip_grad_value_ があります:
torch.nn.utils.clip_grad_value_(model.parameters(), clip_value=0.5)提供:
ただし前述のとおり、これを使う場面はほとんど(あるいは全く)ありません。
設定は以上です。学習ループに2行足すだけです。
TensorFlowでのグラディエントクリッピング
TensorFlowでは、クリッピングは別関数ではなくオプティマイザ側で扱います。
オプティマイザ作成時に clipnorm または clipvalue を引数として渡します。オプティマイザが各ステップ内で内部的にクリッピングを適用するため、学習ループを変更する必要はありません。
以下はKeras APIを使い、合成の回帰データでの完全な動作例です:
import numpy as np
import tensorflow as tf
tf.random.set_seed(42)
np.random.seed(42)
n_samples = 1000
n_features = 20
x_train = np.random.randn(n_samples, n_features).astype(np.float32)
y_train = (x_train.sum(axis=1, keepdims=True) * 2.0
+ np.random.randn(n_samples, 1).astype(np.float32) * 0.1)
model = tf.keras.Sequential([
tf.keras.layers.Dense(64, activation="relu", input_shape=(n_features,)),
tf.keras.layers.Dense(64, activation="relu"),
tf.keras.layers.Dense(1),
])
optimizer = tf.keras.optimizers.Adam(learning_rate=1e-3, clipnorm=1.0)
model.compile(optimizer=optimizer, loss="mse")
model.fit(x_train, y_train, epochs=5, batch_size=32)提供:
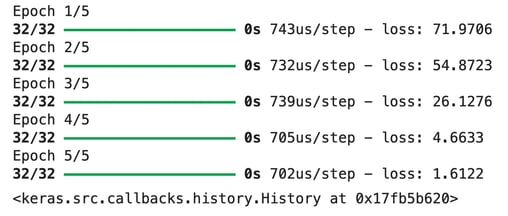
TensorFlowの出力
2つの引数は次のように異なります。
ノルムクリッピングから値クリッピングへの切り替えは、引数を入れ替えるだけです:
optimizer = tf.keras.optimizers.Adam(learning_rate=1e-3, clipvalue=0.5)提供:
これらの引数は、Adam、SGD、RMSprop、AdamWなど、すべてのKerasオプティマイザで機能します。全勾配をまとめたノルムに基づいてクリップする global_clipnorm もあり、こちらのほうがPyTorchのデフォルト挙動に近いです。
もし tf.GradientTape を使ってカスタム学習ループを書く場合でも、apply_gradients の呼び出し時にオプティマイザがクリッピングを処理します:
for epoch in range(5):
    for batch_x, batch_y in zip(np.array_split(x_train, 32), np.array_split(y_train, 32)):
        with tf.GradientTape() as tape:
            predictions = model(batch_x, training=True)
            loss = tf.reduce_mean(tf.square(predictions - batch_y))

        gradients = tape.gradient(loss, model.trainable_variables)
        optimizer.apply_gradients(zip(gradients, model.trainable_variables))提供:
フレームワーク間の違いはここです。PyTorchはループ内での明示的な呼び出しをユーザーに委ね、TensorFlowはオプティマイザに組み込みます。根底のロジックは同一です。
グラディエントクリッピングと他の安定化手法
グラディエントクリッピングは学習を安定化する唯一の方法ではなく、常に最適な道具とも限りません。
他の手法は関連する別の問題を扱います。大きな勾配の発生自体を抑えるもの、勾配の消失を防ぐもの、損失面を最適化しやすくするものなどです。いくつか紹介します。
バッチ正規化
バッチ正規化は、学習中に各ミニバッチ内で活性化を正規化します。
層の出力を安定範囲に保ち、勾配の大きさを予測しやすくします。バッチ正規化を用いたネットワークは高い学習率に耐え、収束も速く、初期化の影響も受けにくくなります。
ただし、バッチ正規化は爆発的勾配を直接止めるわけではありません。発生頻度を減らすだけで、起きたときの対処にはなりません。そのため多くのモデルがバッチ正規化とグラディエントクリッピングを併用します。
残差接続
残差接続は、1層以上をスキップするショートカットを追加し、後段から前段へ勾配が直接流れる経路を作ります。
これにより深いネットワークでの消失勾配問題が解決されます。残差接続がないと、20〜30層を超えるネットワークの学習は、勾配が逆伝播でゼロに近づくため困難になります。残差接続があれば、数百層のネットワークでも問題なく学習できます。
残差接続は、クリッピングとは反対側の勾配問題を対象にします。クリッピングは大きすぎる勾配に対処し、残差は小さすぎる勾配に対処します。
丁寧な重み初期化
重みの初期値は、活性化と勾配の初期の大きさを決めます。悪い初期化は、最初のステップから勾配の爆発や消失を引き起こします。
XavierやHe初期化のような方法は、層のサイズに応じて初期重みをスケーリングします。これにより学習開始時に層をまたいだ活性化の分散が安定し、多くの勾配問題を未然に防ぎます。
適切な初期化でクリッピングの必要性は減りますが、完全には無くなりません。特に高い学習率や特異なバッチでは、学習の後半でも勾配スパイクは起こり得ます。
組み合わせ方
ここで挙げた手法は代替関係ではありません。同じ全体問題の異なる側面を解く、補完的な道具です。
現代的な学習設定の典型例は、開始時の丁寧な初期化、アーキテクチャ内の残差接続、ネットワーク内部のバッチ正規化(またはレイヤー正規化)、そして最適化段階での安全網としてのグラディエントクリッピングを組み合わせます。各手法が特定の故障モードを扱い、総合的にディープネットワークを学習可能にします。
まとめ
グラディエントクリッピングはディープラーニングでもっとも簡単な対策の一つで、1回のステップで何時間もの学習を台無しにする問題を解決します。
良い知らせは、モデルのアーキテクチャを変えたり学習コードを書き直したりする必要がないことです。PyTorchなら1行、TensorFlowなら1つの引数で十分に実装できます。
最大の効果は大きな枠組みの一部として使うときに発揮されます。丁寧な初期化、残差接続、バッチ(またはレイヤー)正規化と組み合わせれば、さまざまな角度から不安定性に対処できる学習パイプラインになります。
損失が発散するなら、まずはクリッピングから。消失しているなら別の手段を。小さなモデル以上を学習するなら、デフォルトでクリッピングを組み込んで、あとは忘れてしまって構いません。
グラディエントクリッピングは、機械学習エンジニアなら知っておくべき多数の用語の一つにすぎません。他も学んで2026年に備えたい方は、ぜひ Machine Learning Engineer トラックに本日登録してください。


ディープニューラルネットワークを学習していて、損失がNaNになるのを何度見たことがありますか?
何時間も学習させて損失曲線は順調そうに見えるのに、突然どこからともなく無限大に跳ね上がる。たいていの原因は爆発的勾配です—逆伝播の過程で勾配が非常に大きくなり、パラメータ更新が不安定になってモデルが壊れてしまう現象です。これは再帰型ネットワークで特に起こりやすいですが、トランスフォーマーや深いフィードフォワードネットワークでも発生します。
グラディエントクリッピングは、オプティマイザに渡る前に勾配の大きさを制限することでこれを防ぎます。学習ループに1行加えるだけで、モデル自体を変えずに更新の大きさを抑えられます。
本記事では、グラディエントクリッピングの直感的な理解、2つの主要手法、しきい値の決め方、そしてPyTorchとTensorFlowでの実装方法を解説します。
ところで、データサイエンスにおける「損失」とは正確には何でしょうか?詳しくは 機械学習の損失関数 の記事をご覧ください。
グラディエントクリッピングとは?
グラディエントクリッピングは、学習中の勾配の大きさを制限し、不安定なパラメータ更新を防ぐための手法です。
勾配が大きくなりすぎると、オプティマイザはパラメータ空間で巨大な一歩を踏み出し、損失が発散する領域に重みを押しやってしまいます。クリッピングは、その前にステップサイズを上限で切り詰めることで被害を防ぎます。
重要なのは、グラディエントクリッピングはモデルのアーキテクチャに影響しないという点です。層を追加したり活性化関数を変えたりはしません。逆伝播とオプティマイザのステップの間で勾配を横取りして調整するだけで、学習プロセスのみを変更します。
そのため試しやすく、外すのも簡単です。後述のとおり、実装はたった1行です。
グラディエントクリッピングの仕組み
メカニズムは単純です。クリッピングはバックワードパスとオプティマイザのステップの間に置かれ、各イテレーションで以下の4手順を踏みます。
多くの場合、勾配はしきい値未満に収まり、クリッピングがなくても学習は通常通り進みます。スパイクが発生したときだけ、オプティマイザが反応する前にクリッピングが捕まえます。
以上です。
一般的なグラディエントクリッピング手法
勾配のクリッピングには2通りがあり、違いは何を測って何をスケールするかにあります。
値によるクリッピング
値によるクリッピングは、各勾配要素を個別に上限・下限で抑えます。
たとえば範囲を
[-1.0, 1.0]と決めると、その範囲外の勾配値は最も近い境界に丸められます。勾配が2.5なら1.0に、-2.5なら-1.0になります。もともと範囲内の値は変更されません。値によるクリッピングの例
魅力はその簡単さです。min/maxの操作以上の数学は不要で、高速に実行できます。
ただし欠点もあります。各要素を個別にクリップすると、勾配ベクトルの方向が変わってしまいます。ある成分だけがクリップされ他がされないと、更新後のベクトルは逆伝播が示した方向を向かなくなります。結果としてオプティマイザはやや誤った方向へ進んでしまいます。
そのため、実務では値によるクリッピングはあまり一般的ではありません。
ノルムによるクリッピング
ノルムによるクリッピングは、勾配全体の大きさがしきい値を超えたときに、勾配ベクトル全体をスケールします。
個々の値を見るのではなく、全勾配のノルム(通常はL2ノルム)を計算して最大値と比較します。ノルムがしきい値未満なら何も起こりません。超えていれば、全ての勾配に同じ係数を掛けてノルムを上限まで引き下げます。
ノルムによるクリッピングの例
利点は方向が保たれることです。すべての成分が同じ割合で縮むため、勾配ベクトルは元の方向を向いたままです。ステップを短くするだけで、向きを変えてはいません。
このため、ノルムによるクリッピングが標準となりました。PyTorchの
clip_grad_norm_やTensorFlowのclipnormはいずれもこの手法を実装しており、現代的な学習パイプラインの多くでデフォルトとして用いられます。爆発的勾配と消失勾配
爆発的勾配と消失勾配はいずれもディープラーニングで一般的な問題ですが、グラディエントクリッピングが解決するのは前者だけです。
爆発的勾配
爆発的勾配は、逆伝播の過程で勾配の値が大きくなりすぎると起こります。
これは多層のネットワークや再帰型アーキテクチャでよく見られ、勾配が多くの層やタイムステップをまたいで掛け合わされます。掛け合わせが悪い方向に積み重なると、勾配の大きさが膨れ上がります。するとオプティマイザは巨大な更新を行い、重みが極端な値に飛び、損失が
NaNやInfになることがあります。突然の損失スパイクや、急に発散するモデルとして現れます。
消失勾配
消失勾配はその逆の問題です。勾配の値がネットワークを逆向きに伝わるにつれてゼロに近づきます。
勾配が小さくなりすぎると重み更新が極小になり、初期層は学習をやめ、深い層の学習は遅くなり、実質的に学習が止まります。損失曲線は横ばいになり、多くのエポックを重ねても改善しません。
これは、LSTMやGRUが登場する前にRNNが長い系列で苦戦した主な理由でした。
グラディエントクリッピングの位置づけ
グラディエントクリッピングが対処するのは爆発的勾配であり、消失勾配ではありません。
クリッピングは大きすぎる勾配を縮小しますが、小さすぎる勾配には何もできません。消失勾配には、より良い重み初期化、残差接続、バッチ正規化、あるいは勾配フローを保つ設計のアーキテクチャを使う必要があります。
ノルムによるグラディエントクリッピングの解説
ノルムによるクリッピングは、読者が「グラディエントクリッピング」を検索したときに実際に求めている方法です。
手順は3つです。まず、全勾配をまとめたノルムを計算します。次に、そのノルムを選んだしきい値と比較します。最後に、ノルムが大きすぎる場合は勾配を再スケーリングします。
ノルムは通常L2ノルムで、各勾配値を二乗して合計し平方根を取ります。モデル全体のパラメータにまたがる勾配
g_1, g_2, ..., g_nがあるとすると、L2ノルムは次の通りです。ノルムによるクリッピングの式
ノルムを得たら、しきい値
cと比較します。||g|| <= cなら勾配はそのまま通過し、||g|| > cなら全ての勾配にスケーリング係数c / ||g||を掛けます。これで新しいノルムはちょうどcになります。重要なのは、すべての成分が同じ割合で縮むことです。勾配値同士の相対比は変わらず、ベクトルは元の方向を向いたまま。オプティマイザのステップの長さだけを短くし、行き先は変えません。
この方向保持の性質こそが、ノルムクリッピングがデフォルトの選択肢である理由です。値によるクリッピングは勾配ベクトルの向きをねじ曲げることがあります。ノルムによるクリッピングは長さだけを変えます。
PyTorchの
clip_grad_norm_とTensorFlowのclipnormはまさにこれを行います。誰かが「グラディエントクリッピングを使っている」と言うとき、ほとんど常にノルムによるクリッピングを指します。グラディエントクリッピングのしきい値の選び方
しきい値はハイパーパラメータです。あらゆるモデルで通用する普遍的な値はありません。
高く設定しすぎると、クリッピングはほとんど発動しません。勾配はほとんど常に上限未満に収まるため、安全網は何も捕まえられません。クリッピングがないのと同様に学習が進み、勾配が爆発すると損失スパイクが発生します。
低く設定しすぎると、過度にクリップされます。すべてのバッチで勾配が縮小され、本来よりも更新が小さくなります。学習が遅くなり、収束に時間がかかることがあります。
一般的な出発点は
1.0で、多くのアーキテクチャでうまく機能します。実用上は0.5から5.0の範囲でほとんどをカバーできます。より良い方法は、学習中に勾配ノルムを監視することです。各ステップでクリップ前のノルムをログに記録し、分布を確認します。ほとんどのノルムが
0.3前後で、ときどき50まで跳ねるなら、通常域より少し上でスパイクよりは十分低い位置、例えば2.0や3.0に設定するのが妥当です。他のハイパーパラメータと同様に扱ってください。まずは
1.0で始め、挙動を見て調整します。再帰型ニューラルネットワークにおけるグラディエントクリッピング
RNNは、グラディエントクリッピングが標準手法として定着した最初の領域です。
理由は、RNNが時間方向に勾配を伝播する仕組みにあります。時間方向の逆伝播では同じ重み行列が多くのタイムステップで繰り返し掛け合わされ、その積み重ねが巨大な値に膨れ上がることがあります。系列が長いほど問題は悪化します。
LSTMやGRUはゲーティング機構で問題を緩和しましたが、完全には解消していません。特に長い系列や高い学習率での学習では、両者ともクリッピングの恩恵を受けます。
RNNの学習では、しきい値
1.0〜5.0のノルムクリッピングが典型的なデフォルトです。PyTorchのnn.LSTMやnn.GRUを使っていて学習中に損失が発散するなら、まずclip_grad_norm_を追加するのが定石です。現代のディープラーニングにおけるグラディエントクリッピング
RNNがトランスフォーマーに置き換わっても、グラディエントクリッピングは姿を消していません。
GPTやBERTのような大規模言語モデルは、事前学習やファインチューニングでクリッピングを使用します。ビジョントランスフォーマー、拡散モデル、数百層のディープアーキテクチャでも同様です。現代の学習で主流のAdamやAdamWは、多くの場合しきい値
1.0前後のノルムクリッピングと組み合わされます。理由はRNNと同じです。深いネットワークでは多くの層にわたり勾配が掛け合わされ、大きなバッチサイズと高い学習率の組み合わせで、ときどきスパイクが生じます。クリッピングは通常の学習ステップに影響せずに、それらのスパイクだけを処理します。
多くのリファレンス実装でクリッピングはデフォルトです。Hugging Faceの
Trainer、PyTorch Lightning、DeepSpeedはいずれも標準の設定項目として露出しています。小さなお試しモデル以上を学習するなら、クリッピングはまず確実にパイプラインの一部です。学習ループに1行足すだけでコストはほぼゼロ、何時間もの計算の末に学習がクラッシュするのを防げます。これが今でも使われ続ける理由です。
PyTorchでのグラディエントクリッピング
PyTorchでは、
torch.nn.utils.clip_grad_norm_というユーティリティ関数1つでグラディエントクリッピングを扱います。クリッピングの呼び出しは
loss.backward()とoptimizer.step()の間に置きます。まず逆伝播で勾配を埋め、その後必要に応じてクリッピングで縮め、最後にオプティマイザが更新を適用します。これ以外の場所に置いても動作しません。以下は、合成の回帰データで小さなMLPを学習し、グラディエントクリッピングを有効化した、完全に実行可能な学習スクリプトです:
PyTorchの出力
clip_grad_norm_関数は主に2つの引数を取ります。parameters: クリップ対象とするモデルパラメータ。モデル全体を対象にするにはmodel.parameters()を渡します。max_norm: 勾配ノルムのしきい値。1.0は一般的な出発点です。任意引数の
norm_typeは既定でL2ノルムの2.0です。変更が必要になることはまれです。関数名末尾のアンダースコア
clip_grad_norm_はインプレース操作を意味します。各パラメータの.grad属性内の勾配が直接変更されるため、戻り値を追跡する必要はありません。戻り値にはクリップ前の総ノルムが返るので、ログに使うには便利です。値によるクリッピングを使う場合は、PyTorchには
torch.nn.utils.clip_grad_value_があります:ただし前述のとおり、これを使う場面はほとんど(あるいは全く)ありません。
設定は以上です。学習ループに2行足すだけです。
TensorFlowでのグラディエントクリッピング
TensorFlowでは、クリッピングは別関数ではなくオプティマイザ側で扱います。
オプティマイザ作成時に
clipnormまたはclipvalueを引数として渡します。オプティマイザが各ステップ内で内部的にクリッピングを適用するため、学習ループを変更する必要はありません。以下はKeras APIを使い、合成の回帰データでの完全な動作例です:
TensorFlowの出力
2つの引数は次のように異なります。
clipnormは各勾配テンソルのL2ノルムでクリップします。ノルムがしきい値を超えると、そのテンソルは比例的に縮小されます。clipvalueは各勾配要素を個別にクリップします。しきい値を超える値は上限に、負のしきい値を下回る値は下限にクランプされます。ノルムクリッピングから値クリッピングへの切り替えは、引数を入れ替えるだけです:
これらの引数は、Adam、SGD、RMSprop、AdamWなど、すべてのKerasオプティマイザで機能します。全勾配をまとめたノルムに基づいてクリップする
global_clipnormもあり、こちらのほうがPyTorchのデフォルト挙動に近いです。もし
tf.GradientTapeを使ってカスタム学習ループを書く場合でも、apply_gradientsの呼び出し時にオプティマイザがクリッピングを処理します:フレームワーク間の違いはここです。PyTorchはループ内での明示的な呼び出しをユーザーに委ね、TensorFlowはオプティマイザに組み込みます。根底のロジックは同一です。
グラディエントクリッピングと他の安定化手法
グラディエントクリッピングは学習を安定化する唯一の方法ではなく、常に最適な道具とも限りません。
他の手法は関連する別の問題を扱います。大きな勾配の発生自体を抑えるもの、勾配の消失を防ぐもの、損失面を最適化しやすくするものなどです。いくつか紹介します。
バッチ正規化
バッチ正規化は、学習中に各ミニバッチ内で活性化を正規化します。
層の出力を安定範囲に保ち、勾配の大きさを予測しやすくします。バッチ正規化を用いたネットワークは高い学習率に耐え、収束も速く、初期化の影響も受けにくくなります。
ただし、バッチ正規化は爆発的勾配を直接止めるわけではありません。発生頻度を減らすだけで、起きたときの対処にはなりません。そのため多くのモデルがバッチ正規化とグラディエントクリッピングを併用します。
残差接続
残差接続は、1層以上をスキップするショートカットを追加し、後段から前段へ勾配が直接流れる経路を作ります。
これにより深いネットワークでの消失勾配問題が解決されます。残差接続がないと、20〜30層を超えるネットワークの学習は、勾配が逆伝播でゼロに近づくため困難になります。残差接続があれば、数百層のネットワークでも問題なく学習できます。
残差接続は、クリッピングとは反対側の勾配問題を対象にします。クリッピングは大きすぎる勾配に対処し、残差は小さすぎる勾配に対処します。
丁寧な重み初期化
重みの初期値は、活性化と勾配の初期の大きさを決めます。悪い初期化は、最初のステップから勾配の爆発や消失を引き起こします。
XavierやHe初期化のような方法は、層のサイズに応じて初期重みをスケーリングします。これにより学習開始時に層をまたいだ活性化の分散が安定し、多くの勾配問題を未然に防ぎます。
適切な初期化でクリッピングの必要性は減りますが、完全には無くなりません。特に高い学習率や特異なバッチでは、学習の後半でも勾配スパイクは起こり得ます。
組み合わせ方
ここで挙げた手法は代替関係ではありません。同じ全体問題の異なる側面を解く、補完的な道具です。
現代的な学習設定の典型例は、開始時の丁寧な初期化、アーキテクチャ内の残差接続、ネットワーク内部のバッチ正規化(またはレイヤー正規化)、そして最適化段階での安全網としてのグラディエントクリッピングを組み合わせます。各手法が特定の故障モードを扱い、総合的にディープネットワークを学習可能にします。
まとめ
グラディエントクリッピングはディープラーニングでもっとも簡単な対策の一つで、1回のステップで何時間もの学習を台無しにする問題を解決します。
良い知らせは、モデルのアーキテクチャを変えたり学習コードを書き直したりする必要がないことです。PyTorchなら1行、TensorFlowなら1つの引数で十分に実装できます。
最大の効果は大きな枠組みの一部として使うときに発揮されます。丁寧な初期化、残差接続、バッチ(またはレイヤー)正規化と組み合わせれば、さまざまな角度から不安定性に対処できる学習パイプラインになります。
損失が発散するなら、まずはクリッピングから。消失しているなら別の手段を。小さなモデル以上を学習するなら、デフォルトでクリッピングを組み込んで、あとは忘れてしまって構いません。
グラディエントクリッピングは、機械学習エンジニアなら知っておくべき多数の用語の一つにすぎません。他も学んで2026年に備えたい方は、ぜひ Machine Learning Engineer トラックに本日登録してください。