

ランダムフォレスト回帰とは?
ランダムフォレスト回帰は、アンサンブル手法であり、複数のランダム化された決定木を構築してその出力を組み合わせ、連続値の予測を行います。単一のモデルに頼るのではなく、多数の木の予測を集約し、一般的にはその平均をとります。
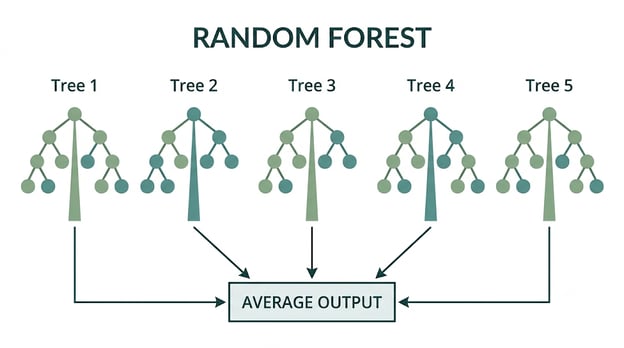
なぜ複数の木が必要なのでしょうか?単一の決定木は過学習しやすいからです。特に現実の乱雑なデータでは、シグナルとともにノイズまで取り込んでしまいます。
ブートストラップ集約と特徴量のランダム性
ランダムフォレスト回帰の強みは、各段階でランダム性を導入し、その結果を集約して分散を減らす点にあります。仕組みを見ていきましょう。
ブートストラップ集約(バギング)は、各決定木をデータの異なるランダムサブセットで学習させます。これにより木ごとにばらつきが生まれ、過学習のリスクが低減します。
特徴量のランダム性は、各分割でランダムな特徴量サブセットのみを候補とすることで多様性をさらに高めます。これらを組み合わせることで予測が安定し、汎化性能が向上します。
ブートストラップサンプリングと特徴量のランダム性
ランダムフォレストは、バギングとも呼ばれるブートストラップサンプリングから始まります。各木は元のデータセットからランダムに抽出したサブセットで学習します。その結果、同じ構造を繰り返すのではなく、異なるパターンを学習します。
また、各分割で利用可能なすべての特徴量ではなく、ランダムに選んだ一部の特徴量のみを検討します。これにより、少数の支配的な特徴量が常にすべての木を左右することを防ぎます。
バギングと特徴量のランダム性を組み合わせることで、誤差の相関が低い木の集合ができ、個々が異なる誤りを犯すため、集約時にノイズが打ち消され、全体の精度が向上します。
木の成長と予測の集約
フォレスト内の各木は、しばしば剪定せずに深く成長します。これにより、データ内の複雑なパターン、相互作用、非線形関係を捉えられます。
個々の木は過学習するかもしれませんが、ランダムフォレストがそれらの出力を集約することで、その影響は軽減されます。
バイアス-バリアンスのトレードオフ
ランダムフォレストは、個々の木の強さとフォレスト全体の多様性という2つの重要な要素のバランスをとります。
深い木は学習データに密着して当てはめられるため、バイアスが小さくなります。同時に、データのサンプリングや特徴量選択のランダム性が木同士の相関を減らします。バイアスの小さい相関の低い木を多数平均することで、モデルはバイアスを増やさずに全体の分散を下げます。
データ前処理と実装ワークフロー
次に、これらの概念を実践に落とし込み、生データからランダムフォレストモデルを動作させるための手法を見ていきます。
データクリーニングと特徴量エンジニアリング
ランダムフォレスト向けのデータ準備は、通常はカテゴリ変数の処理から始まります。
- カテゴリが少ない場合は、ワンホットエンコーディングが有効で信頼できます
- 高カーディナリティの特徴量には、ターゲットエンコーディングの方が効率的なことが多く、次元を大きく増やさずにカテゴリレベルの信号を捉えられます
次に欠損値の処理です。方法は使用するライブラリに依存します。実装によっては分割時に欠損値を直接扱えるものもあれば、事前に補完が必要なものもあります。多くの場合、中央値や最頻値による単純代入で十分です。ランダムフォレストは厳密な分布仮定に依存しないため、こうした単純な方法でも実務で良好に機能します。
最終的により大きな影響を与えるのは特徴量エンジニアリングです。たとえば、ラグ特徴量で時間依存性を導入し、ローリング集計で局所的な傾向を捉え、グループ化統計で高次のパターンを符号化します。これらの設計特徴量により、モデルは情報をより適切に表現でき、予測性能が向上します。
詳しくは、私の機械学習における特徴量エンジニアリングのチュートリアルをご覧ください。
ベースラインの確立と分割戦略
チューニングに入る前に、まずは正しくデータを分割することが重要です。
標準的な表形式の問題では、通常、データセットを学習・検証・テストに分割します。モデルは一つの分割で学習し、別の分割で調整し、最後の未使用分割で評価します。
この分離により、新しいデータに対するモデルの挙動を現実的に把握できます。
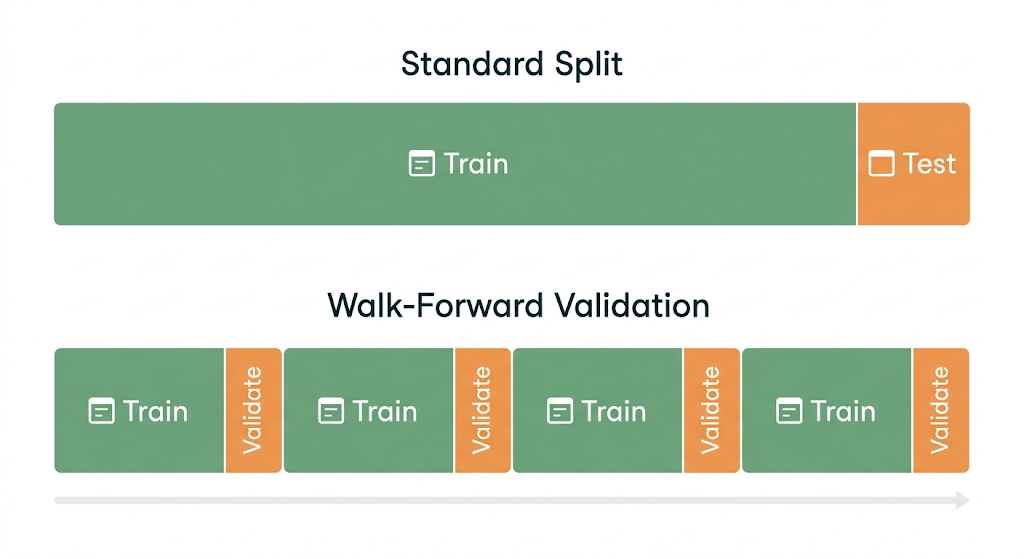
時系列では、分割戦略が変わります。ランダムに分割すると未来の情報が過去へ漏れ、実際より性能が良く見えてしまいます。
ウォークフォワード検証は、初期の時間窓で学習し、次の窓で検証し、その後も一歩ずつ前進させることで、この問題を回避します。運用時の利用方法と評価方法を一致させられます。
エンドツーエンドのPython実装
実装はシンプルなscikit-learnの流れに従います。
- モデルをインポート
- データを分割
- 推定器を学習
- 予測を生成
- 出力を評価
典型的なセットアップは実務では次のようになります。
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error, root_mean_squared_error
import matplotlib.pyplot as plt
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
model = RandomForestRegressor(random_state=42)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)
rmse = root_mean_squared_error(y_test, y_pred)モデルを学習・評価したら、次のステップは予測値と実測値の可視化です。
散布図を使うと、常に過大評価や過小評価に偏るといった系統的なバイアスを見つけやすくなります。また、不均一分散性(目的変数が大きくなるにつれて予測誤差が広がる現象)も明らかになります。
ハイパーパラメータのチューニングと評価
モデルを学習したら、次は主要パラメータの調整と性能評価です。代表的な手法を紹介します。
回帰指標の選択と解釈
RMSE(二乗平均平方根誤差)、MAE(平均絶対誤差)、R²は、それぞれ異なる観点から性能を測定します。
- RMSEは残差を二乗するため、大きな誤差をより強く罰します。大きなミスのコストが高く、最小化したい場合に有用です
- MAEはすべての誤差を等しく扱うため、外れ値があるデータや、たまのスパイクよりも一貫した平均誤差が重要な場合に安定した見方を提供します
- R²は目的変数の分散のうちモデルが説明する割合を測り、全体適合度の比較には役立ちますが、予測誤差を直接反映しません
集計指標だけでなく、誤差分析はより深い洞察を与えます。残差(実測値と予測値の差)は、データのさまざまな切り口で確認すべきです。
残差を予測値や実測値に対してプロットすると、パターンが見えてきます。たとえば、目的変数が大きくなるにつれて誤差が増えるなら不均一分散性の兆候です。対角線より常に上下どちらかに外れていれば、系統的なバイアスが示唆されます。
特徴量のグループや目的変数のレンジで誤差を分割して見ることも、失敗パターンの特定に役立ちます。中間値ではうまくいくが極端な値で苦戦する、あるいはセグメントごとに挙動が異なるといった可能性があります。
アウトオブバッグ(OOB)評価の活用
ランダムフォレストは、アウトオブバッグサンプリングによる内蔵の検証機構を提供します。各木はブートストラップサンプルで学習するため、学習に使われないデータが一部残ります。これらのOOBサンプルを用いて、別途検証セットを作らずにモデルを評価できます。これがOOBスコアです。
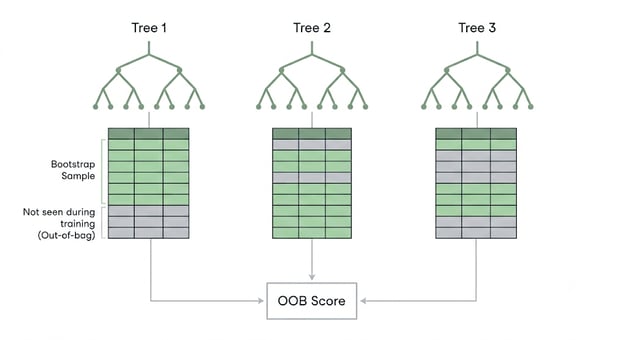
ただし、OOB評価だけでは不十分な場合があります。特に重要度の高い場面やデータリークの懸念がある場合、最終検証には厳密なホールドアウトのテストセットが必要です。
チューニングで優先すべき主要ハイパーパラメータ
ランダムフォレストでは、max_featuresとn_estimatorsが性能に最も顕著な影響を与えることが多いです。
-
max_featuresは各分割で検討する特徴量の最大数を制御します。値を小さくするとランダム性が増し、木同士の相関が下がって汎化が向上することがあります。値を大きくすると木は強くなりますが互いに似通いやすくなり、分散が増える可能性があります。 -
n_estimatorsはフォレスト内の木の本数を制御します。増やすと予測が安定して性能が向上するのが一般的ですが、計算時間も増えます。ある程度を超えると改善は頭打ちになるため、そのプラトーを見極めることが重要です。
これらのパラメータは、モデルの複雑さ、学習時間、交差検証、および予測性能のバランスをとるためにチューニングしてください。
特徴量重要度と解釈可能性
ランダムフォレストはブラックボックス扱いされがちですが、特徴量が予測にどう影響するかを理解する手段が複数あります。重要なものを見ていきましょう。
不純度に基づく重要度
ランダムフォレストは、MDI(不純度減少の平均)で特徴量重要度を計算します。ある特徴量でノードを分割するたびに、その分割が不純度(回帰では分散など)をどれだけ減らしたかを測定します。これらの減少量をすべての木で累積し、予測改善への寄与度を示すスコアとします。
この方法は高速でモデル内蔵ですが、既知の限界があります。MDIは連続値の特徴量や一意の値が多いカテゴリ特徴量を過大評価しがちです。分割候補点が多いほど重要度が膨らむ可能性があり、実際の予測力以上に見えてしまう場合があります。
パーミュテーション重要度
パーミュテーション重要度は、ホールドアウトデータである特徴量の値をランダムにシャッフルしたときに性能がどのように変化するかを測ります。シャッフルで性能が大きく低下すれば、その特徴量は重要であり、影響が小さければ予測価値は限定的と考えられます。
この手法は実際のモデル挙動を反映するため、分析において信頼性が高いとされています。
ただし、相関した特徴量があると複雑になります。2つの特徴量が同様の情報を持つ場合、一方をシャッフルしても他方がシグナルを提供し続けるため、性能への影響が小さく見えることがあります。結果として重要度が相関特徴量間で分散して見えるため、解釈には注意が必要です。
SHAP値
SHAP値(Shapley Additive Explanations)は、個々の予測に対して各特徴量がどれだけ寄与したかを説明します。ベースラインから予測値をどれだけ押し上げ/押し下げたかを表す値を各特徴量に割り当てます。
この方法はモデルの意思決定を説明し、信頼を築くためによく用いられます。詳しくは、機械学習におけるSHAP値のチュートリアルをご覧ください。
制約とよくある失敗ケース
ランダムフォレスト回帰は多くの場面で堅牢ですが、明確な限界もあります。これを理解することで、いつ使うべきか、別手法に切り替えるべきかを判断できます。
外挿の限界とエッジケース
ランダムフォレストは学習データの範囲外へ外挿できません。
各木は学習時に観測した分割に基づいて予測するため、最終的な出力は常にデータセットで見た目的変数の最小値と最大値に挟まれます。もし学習で10から100の範囲しか見ていなければ、入力のシグナルがどれほど強くても120を予測することはできません。これは成長予測やトレンド駆動のシステムなどで問題になります。
また、テキスト表現や数千列に及ぶワンホットベクトルのような、極端に高次元でスパースなデータも苦手です。こうした場合、木は非効率になり、有意な分割を捉えにくくなります。実務的な回避策には、
解釈可能性のトレードオフ
単一の決定木は、入力から予測までの経路が明確で説明しやすい一方、フォレストは多数の木を集約するため、個々の意思決定の追跡が難しくなります。
厳格な規制環境では、このトレードオフが重要です。説明が単純で追跡可能である必要があるなら、単一の決定木や線形モデルの方が適切な場合があります。性能を優先し、特徴量重要度やSHAPなどで補助的に説明できるなら、ランダムフォレストは有力な選択肢です。
計算・メモリ・レイテンシの制約
ランダムフォレストの計算量は、木の本数とデータサイズに概ね比例して増加します。データセットが大きくなると、各木の構築と保存が必要なため、学習時間とメモリ使用量が増加します。また、推論時もすべての木の出力を集約する必要があるため、フォレストが大きいと遅くなることがあります。
レイテンシやコスト制約が厳しい本番環境では、これがボトルネックになり得ます。木の本数を減らす、木の深さを制限する、各分割で検討する特徴量数を抑えるといった方法でリソース使用を制御できます。これらの調整は、ある程度の精度低下と引き換えに学習・予測を高速化します。
ランダムフォレスト回帰と代替手法:どう選ぶか
ランダムフォレスト回帰がユースケースに適しているのか、あるいは検討すべき代替手法は何か、迷うことがあるかもしれません。
モデル比較フレームワークの構築
ユースケースは様々ですが、常に役立つアプローチが一つあります。それは、ランダムフォレスト回帰器と並行して、線形回帰やサポートベクター回帰、勾配ブースティングなど異なるモデルの性能を同一データセットで比較することです。
つまり、すべてのモデルでまったく同じ学習・検証・テスト分割を用い、同一の誤差指標とビジネス前提で評価します。
ランダムフォレスト回帰 vs. 線形回帰・サポートベクター回帰
ランダムフォレストと線形回帰は、課題設定が大きく異なります。線形回帰は、入力と目的変数の関係がほぼ線形で、係数をわかりやすく説明したいときに最適です。また、観測レンジ外への厳密な外挿が重要な場合にも適しており、その点で優位です。
一方、ランダムフォレストは非線形パターン、特徴量間の相互作用、不規則な境界の捉え方に優れます。これにより複雑な実世界のシステムに強い一方、トレンド中心の予測では弱くなることがあります。
サポートベクター回帰(SVR)は、また別の立ち位置にあります。小規模データで高い性能を発揮することがありますが、特徴量スケーリングに非常に敏感で、慎重なチューニングが必要になりがちです。ランダムフォレストは標準化入力に依存しないため、典型的な表形式ワークフローでは扱いやすい傾向にあります。
SVRはデータセットがコンパクトで特徴空間が限定的な場合に有力ですが、データ量や特徴の複雑さ、運用上のプレッシャーが増すほど維持が難しくなります。
ランダムフォレスト回帰 vs. 勾配ブースティング・単一決定木
ランダムフォレストは木を独立に構築して予測を平均します。勾配ブースティングは木を逐次的に構築し、各木が前の木の誤差を修正していきます。
XGBoostなどの勾配ブースティングは、特に構造化された表形式データで、より高い精度上限に到達することが多いです。ただし、より綿密なチューニングが必要で、ハイパーパラメータに敏感です。逐次学習の性質上、学習が遅くなることもあります。ランダムフォレストは学習が容易で、デフォルトでも安定し、設定に対して頑健です。
単一の決定木と比べると、ランダムフォレストははるかに安定かつ高精度です。単一の木は意思決定経路をすべて追えるため解釈しやすい一方、データの微小な変化に非常に敏感です。ランダムフォレストは多数の木の平均化でこの不安定さを抑えますが、直接の解釈可能性は失われます。
モデル比較のまとめ
|
モデル |
非線形への対応 |
外挿 |
解釈可能性 |
チューニングの複雑さ |
学習コスト |
|
ランダムフォレスト回帰 |
強い |
弱い |
中 |
中程度 |
中程度 |
|
線形回帰 |
弱〜中 |
強い |
高い |
低い |
低い |
|
サポートベクター回帰 |
強い |
弱〜中 |
低い |
高い |
高い(大規模データで) |
|
勾配ブースティング(XGBoost) |
非常に強い |
弱い |
低〜中 |
高い |
高い |
|
単一の決定木 |
中程度 |
弱い |
高い |
低い |
低い |
まとめ
ランダムフォレスト回帰は、データが乱雑で関係が非線形、かつ重い前処理なしに強力なベースラインが必要なときの既定モデルとして最適です。混在する特徴量型を扱え、相互作用を捉え、最小限のセットアップで安定した性能を発揮します。
一般的なワークフローは明確です。過度な前処理は避け、まずは適切なデータ構造化に注力します。デフォルトのランダムフォレストでベースラインを構築し、一貫した指標で評価します。その後、木の本数や特徴量サンプリング戦略など主要ハイパーパラメータを調整して性能を高めます。
モデルが安定したら、残差分析や誤差のスライシング、必要に応じたSHAPによる説明など、より深い評価へ進みます。
次のステップとして、より深い理解と実践には、Machine Learning with Tree-Based Models in Pythonのコースをご覧ください。
ランダムフォレスト回帰に関するFAQ
ランダムフォレストモデルの制限は何ですか?
ランダムフォレストは学習データの範囲外に外挿できず、非常に高次元でスパースなデータセットでは苦戦することがあります。また、単一の決定木に比べて解釈性が低く、木の本数が増えると計算コストが高くなる可能性があります。
ランダムフォレストモデルが過学習しているかどうかはどう判断しますか?
学習と検証の性能を比較してください。学習誤差が低いのに検証誤差が大幅に高ければ、過学習です。また、木の深さを増やしても検証指標が改善しない場合も過学習の兆候です。
XGBoostとランダムフォレストはどちらが優れていますか?
XGBoostは木を逐次的に構築して各段階で誤差を修正するため、通常はより高い精度を達成します。ハイパーパラメータの調整に時間を投資できる場合に最適です。一方、ランダムフォレストは木を独立に構築して予測を平均します。より安定しており、チューニングが少なくて済み、ベースラインとして優れています。
ランダムフォレストは時系列データを扱えますか?
そのままでは扱えません。ラグ特徴量、ローリング統計、ウィンドウ変換などを用いて、時系列を表形式に変換してから学習させる必要があります。
ランダムフォレスト回帰は、非線形の表形式データを最小限の準備でモデリングするうえで最も信頼できる手法の一つです。データにノイズが多かったり、関係性が明確でない場合でも、すばやく動作するモデルを得られます。
本ガイドでは、ランダムフォレスト回帰のワークフロー全体を順を追って説明します。アルゴリズムの仕組みを理解し、Pythonで実装します。さらに、評価手法や性能向上のためのチューニングについても解説します。