courses
Claude 모델 입문
3
14.2K
Fable 5는 Anthropic의 Claude 5 제품군 중 코딩 특화 모델로, 2026년 6월 9일에 출시되었습니다. 안전 분류기가 없는 형제 모델 Mythos 5와 함께 제공되었으며, Anthropic은 이를 소수의 신중히 심사된 기관에만 제공했습니다. 출시 개요와 벤치마크 전반에서의 Fable 5 성능은 전용 Fable 5 가이드에서 확인하세요.
Fable 5는 가격대가 Opus 5보다 높으며 더 어려운 코딩 작업을 목표로 합니다. 체감되는 가장 큰 차이는 모든 요청에서 사고 과정을 실행하며 이를 끌 수 없다는 점입니다. 그래서 더 느리고 신중하게 보입니다. Opus 5는 프롬프트가 추가 사고를 할 가치가 있는지 스스로 판단합니다.
두 모델은 컨텍스트 윈도우와 최대 출력 크기를 공유합니다. 가격과 사고 과정 작동 방식에서 차이가 있습니다.
|
|
Fable 5 |
Opus 5 |
|
입력 가격(100만 토큰당) |
$10 |
$5 |
|
출력 가격(100만 토큰당) |
$50 |
$25 |
|
컨텍스트 윈도우 |
100만 토큰 |
100만 토큰 |
|
요청당 최대 출력 |
12.8만 토큰 |
12.8만 토큰 |
|
사고 과정 |
항상 활성(비활성화 불가) |
적응형(옵트인) |
|
거부 동작 |
|
표준 |
Fable 5는 토큰당 비용이 Opus 5의 약 두 배입니다. 사고 과정이 항상 켜져 있기 때문에 한 번의 실행에서도 더 많은 토큰을 배출하는 경향이 있어, 실제 사용 시 가격 차이는 토큰당 요율이 주는 인상보다 더 큽니다. 이 가이드 후반의 맞대결 빌드에서 Fable은 더 작은 프로그램임에도 Opus보다 출력 토큰을 74% 더 많이 배출했습니다.
벤치마크 차이를 포함한 심층 비교는 Claude Opus 5 vs Claude Fable 5 가이드를 읽어보세요.
Fable 5에서 보편적으로 불편한 점은 내장 안전 분류기입니다. 이 모델이 너무 강력하다고 판단되어 생물학이나 사이버보안 같은 분야와 아주 약간이라도 관련된 요청은 처리하지 못하게 막습니다.
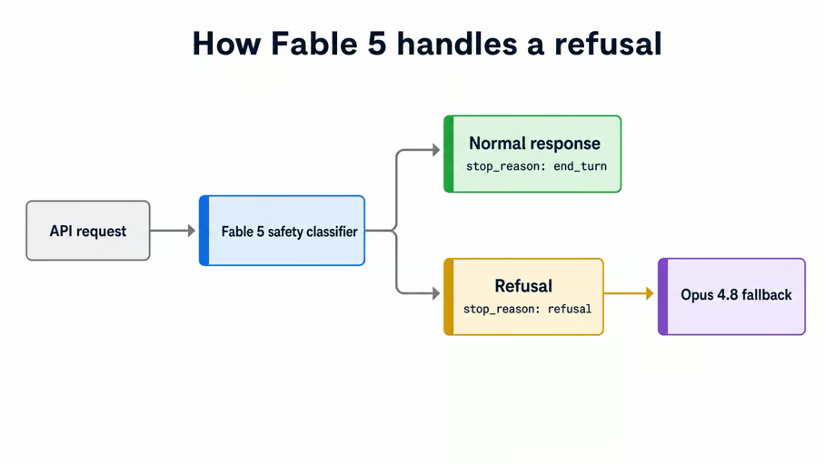
한 면역학자의 경우, "cancer"라는 단어 하나만으로도 생물보안 필터에 걸려 Claude Code가 Opus 4.8로 폴백되었습니다.
저도 개인 프로젝트의 로그인 버그에서 직접 겪었습니다. Telegram Gateway API로 OTP 로그인 흐름을 썼는데, Fable 5는 해당 작업을 전면 거부했습니다. Opus 5는 문제없이 해결했죠. 바로 이게 문제입니다. 그 버그에는 보안 리스크가 전혀 없었습니다.
자동 폴백은 Claude Code와 Claude 앱 내부에서만, 별도 설정 없이 작동합니다. API로 Fable을 사용하는 경우, 200 성공 코드를 받더라도 응답에 stop_reason 필드가 포함됩니다.
응답은 다음과 같습니다.
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
따라서 응답 본문을 사용하기 전에 stop_reason을 확인해야 합니다.
서버 측 폴백을 활성화하려면 fallbacks 배열(예: "fallbacks": [{"model": "claude-opus-4-8"}])을 전달하고 anthropic-beta: server-side-fallback-2026-06-01 헤더를 함께 보내세요. 계정 단위 스위치는 없으니, 모든 요청에 설정해야 합니다.
어떤 자료는 Fable 5가 Opus 4.8로, 다른 자료는 Opus 5로 폴백한다고 하는 이유가 궁금할 수 있습니다. 둘 다 맞습니다. 카테고리와 사용하는 표면(surface)에 따라 대상이 달라집니다.
Claude Code에서는 생물학으로 플래그된 요청은 이제 Opus 5로 재실행되고, 사이버보안으로 플래그된 요청은 여전히 Opus 4.8로 재실행됩니다. API에서는 서버 측 fallbacks 기능이 현재 Opus 4.8만 지원합니다.
이 분리는 시점의 문제입니다. Fable이 6월에 출시되었을 때는 전부 Opus 4.8로 폴백되었고, 7월 24일 Opus 5가 출시된 뒤 생물학 경로만 Opus 5로 전환되었습니다.
안전 분류기 문제를 빼더라도, Fable 5의 출발은 순탄치 않았습니다.
출시 며칠 후, Fortune 보도에 따르면 Anthropic이 아무에게도 알리지 않고 AI와 ML 인프라 트래픽의 약 0.03%에서 Fable 5의 응답을 은밀히 약화시켰다고 합니다.
연구자와 개발자들은 큰 불만을 터뜨렸습니다. 월 $200 구독료를 내는 만큼, 어떤 작업도 처리할 수 있는 프런티어 모델을 기대했기 때문입니다.
Anthropic은 하루 만에 커뮤니티 압력에 굴복하며 "잘못된 절충을 했다"고 밝혔습니다. 바뀐 것은 스로틀 자체가 아니라 가시성이었습니다. 이제 플래그된 요청은 거부와 같은 방식으로 표면화되고, 성능 저하는 그대로 유지되었습니다. Anthropic의 논리는 자사 약관이 이미 경쟁 AI 시스템 구축을 금지하고 있으니 방어할 수 있다는 것입니다. 다만 한 달 동안 이를 조용히 진행한 점은 옳지 않았습니다.
그다음 더 큰 일이 일어났습니다. 공개된 탈옥(jailbreak)으로 6월 12일 상무부의 수출 통제 명령이 발동되었고, Anthropic은 전 세계에서 19일간 Fable 5와 Mythos 5를 오프라인으로 전환했습니다.
Anthropic은 내내 리콜 조치에 강하게 반발했습니다. 해당 탈옥은 보편적이라기보다 협소하며, 더 약한 모델로도 찾을 수 있었다고 주장했기 때문입니다. 그래서 리콜 기준이 자사 입장에서는 불투명해 보였다는 것이죠. 기준 자체에 대한 문제 제기는 일리가 있었습니다. 보편적 탈옥이 완성된 적은 없고, 오늘날 어떤 모델도 그 기준을 통과하지 못합니다. 영국 AI 안전 연구소가 그 방향으로 진전을 보고했지만 실제로 작동하는 것은 없습니다.
다만 표현 방식은 별개로, 기준 자체에 대한 지적은 일리가 있었습니다. 보편적 탈옥은 존재합니다. 영국 AI 보안 연구소 보고서에 따르면 테스트한 모든 프런티어 시스템에서 그런 탈옥을 발견했으며, Fable 5 자체에 대해서도 레드팀이 단일 턴에서 몇 시간 내 만들어냈고 며칠 내 다중 턴 에이전트형 워크플로우로 확장했다고 Fable 5 모델 카드에 적혀 있습니다.
실제로 논쟁적인 것은 그런 기준이 리콜을 촉발해야 하는지 여부이지, 그런 탈옥의 가능성 자체가 아닙니다.
Anthropic은 더 강력한 분류기를 배포했고 99% 이상의 차단율을 보고했으며, 이를 근거로 6월 30일 무렵 상무부가 통제를 해제했습니다.
일반 접근은 7월 1일에 재개되었지만 조건이 더 엄격해졌습니다. 약속했던 2주 무제한 기간은 약 1주로 줄었고, 새 주간 50% 상한이 도입되어 이를 넘으면 Fable 5 추가 사용분이 100만 토큰당 $10/$50의 정가 크레딧으로 청구되었습니다. 이로 인해 구독자들의 불만이 Reddit에서 이어졌습니다.
Anthropic은 마감 기한을 두 차례 연장한 뒤, 7월 20일 요금제별로 정책을 분리했습니다. Max와 Team Premium은 종료일 없이 Fable 5를 주간 한도의 50%에서 유지하고, Pro와 Team Standard는 1회성 $100 크레딧을 받고 이후에는 API 요율을 적용받습니다. Mythos 5는 미국 내 약 100개 심사 완료 기관에만 재제공되었으며, 이전의 더 넓은 국제 프로그램에서 축소되었습니다.
결국 Fable 5는 강력한 모델이지만 접근 정책이 달마다 계속 바뀌는 상황입니다. 가끔 발생하는 오탐 거부에 대비하고, 이번 달의 사용 한도가 다음 달에도 유지된다고 가정하지 마세요.
두 모델의 동작 방식을 동일한 조건에서 보기 위해, 각 모델에 새 Claude Code 세션에서 똑같은 작업을 맡겼습니다. 이후 전체 세션 기록과 내부 JSONL 파일을 읽고, 두 완성 앱을 브라우저에서 채점했습니다.
처음에는 URL 단축기를 과제로 썼는데, 실수였습니다. URL 단축기는 모든 모델의 학습 데이터에 있는 정답이 명확한 과제라 두 모델 모두 테마와 기능까지 거의 동일한 앱을 만들었습니다. 그 테스트는 아무 것도 측정하지 못했습니다.
그래서 정답이 없는 과제를 골랐습니다. 살아 있는 생태계 시뮬레이션. 먹이그물의 세 종, 떼 지어 이동하고 사냥하고 굶주리는 에이전트들, 화면에 동시에 5000개, 시드에서 결정적으로 재현 가능. 어려운 부분을 처리할 라이브러리는 금지하여, 각 모델이 자체 공간 질의, 조향, 개체군 동역학을 직접 작성하도록 했습니다.
두 모델이 똑같이 받은 프롬프트는 다음과 같습니다.
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
질문 금지 규칙이 핵심입니다. 잘못된 방향을 아무도 잡아주지 않을 때, 각 모델이 얼마나 멀리 스스로 빌드를 끌고 가는지 보여줍니다. 각 모델은 서로 같은 작업을 했다는 힌트가 전혀 없는, 빈 디렉터리에서 각각 실행되었습니다.
또한 이 과제는 겉으로 보기엔 시각적 결과처럼 보이지만, 네 가지 객관적 테스트가 숨어 있습니다.
이런 실패는 모두 화면에서 눈에 띕니다. 보기 좋은 데모를 채점할 수 있게 만드는 이유입니다.
두 빌드는 실제로 실행 중이니, 제 말을 믿지 않고 직접 비교하셔도 됩니다. 두 앱을 나란히 열고 각각 리시드를 해보세요.
아래에 두 앱의 스크린샷도 있습니다. 클릭 대신 읽고 싶다면 참고하세요. 다만 공정한 주의 사항: 화면 전체에 맞추기 위해 축소되어 있어 세부가 또렷하지 않을 수 있습니다.
결과로 넘어가기 전, 해석에 중요한 방법론적 메모를 하나 남깁니다.
Claude Code는 Fable 5의 안전 분류기가 요청을 거부하면 Opus로 폴백할 수 있으므로, Fable로 표시된 실행이 전부 Fable이라고 단정할 수는 없습니다. 가정하지 않기 위해, 두 기록의 모든 assistant 이벤트에서 model 필드를 기록했습니다.
다행히 제 비교에서는, Fable 실행의 모든 이벤트가 claude-fable-5로 돌아왔습니다(총 103개). Opus 실행의 모든 이벤트는 claude-opus-5로 돌아왔습니다(총 247개). 어느 쪽에서도 폴백이 발생하지 않았습니다. 아래 수치는 표기된 모델 자체를 설명합니다.
Fable은 조용히 작업했습니다. 도구 호출 56회를 실행했고, 전체 빌드에서 2개의 텍스트 블록으로 429단어의 코멘트를 출력했습니다.
Opus는 공개적으로 작업했습니다. 도구 호출 137회로 두 배 이상 많았고, 110개의 블록에 걸쳐 4,808단어를 출력했습니다. 파일당 수정 빈도를 고려하면 두 모델 모두 비슷한 수준으로, 작성된 파일당 약 2회 수정했습니다.
도구 선택도 갈렸습니다. Fable은 python3 -m http.server 시작 스크립트를 갖춘 순수 ES 모듈을 배포했고 node_modules가 전혀 없습니다. Opus는 Vite와 Vitest를 설치해 실제 툴체인에 맞춰 빌드했습니다.
아래 빌드 시간은 활성 작업만 측정합니다. 각 실행에서 첫 assistant 이벤트부터 마지막 이벤트까지 측정하고, 빌드가 아닌 대기 시간은 제외했습니다.
|
항목 |
Fable 5 |
Opus 5 |
|
Assistant 이벤트 수 |
103 |
247 |
|
활성 빌드 시간 |
25분 |
48분 |
|
출력 토큰 |
243,442 |
139,920 |
|
캐시 읽기 |
1,130만 |
2,640만 |
|
도구 호출 |
56회( Bash 24, Edit 19, Write 10) |
137회( Bash 60, Edit 51, Write 20) |
|
출력된 가시 텍스트 |
429단어(2블록) |
4,808단어(110블록) |
|
총 비용 |
$28.70 |
$20.07 |
|
배포 파일 |
9개, 의존성 0 |
13개, Vite + Vitest |
|
코드 줄 수 |
약 1,010 |
약 1,746 |
|
테스트 |
16개, 모두 통과 |
58개, 모두 통과 |
|
|
아니오 |
예 |
|
시뮬레이션 속도 |
3,510 에이전트에서 3.14 ms/틱 |
4,368 에이전트에서 1.35 ms/틱 |
|
GitHub 배포 |
예 |
예 |
Fable 은 비용이 43% 더 들었고, 더 작은 프로그램임에도 출력 토큰을 74% 더 많이 생성했습니다. 사고 과정을 끌 수 없기 때문에 일이 그 정도로 필요하지 않아도 비용이 계속 청구됩니다.
두 모델은 다음의 객관적 체크를 모두 통과했습니다.
NaN이 발생하지 않습니다.Opus의 시뮬레이션은 틱당 2.3배 빠릅니다. 속성당 하나의 플랫 타입드 배열에 에이전트를 저장하고, 종별로 별도의 공간 그리드를 유지합니다. Fable은 에이전트마다 객체를 두고, 세 종이 하나의 균일 그리드를 공유합니다. 둘 다 정답이지만, Opus의 데이터 레이아웃이 더 빠릅니다.
Fable의 npm test 스크립트는 실행되지 않습니다. node --test test/로 배포했는데, Node 26에서는 이를 디렉터리가 아닌 모듈 경로로 해석하여 단 하나의 테스트도 실행되기 전에 명령이 실패합니다. 하위의 16개 테스트 자체는 정상이며 파일명을 명시하면 통과합니다. package.json의 엔트리 포인트가 잘못되었습니다.
작은 버그지만 비용은 큽니다. 독자가 실제로 입력할 유일한 명령이 실패하기 때문입니다. Fable은 이를 끝내 잡아내지 못했는데, 이것이 중요한 부분입니다. 프롬프트는 테스트를 요구했고, 사용자들이 사용할 경로가 아닌 방식으로 스스로 검증했습니다.
Opus에는 이런 실패가 없습니다. 58개 테스트가 npm test로 실행되며 통과합니다. 두 테스트 스위트 모두 여기서 중요한 것들, 즉 시드에 따른 결정적 동작, 에너지 보존, 토러스 래핑, 장기적인 종 생존을 검사합니다. 차이는 종류가 아니라 깊이입니다. Opus만 작성한 체크는 5000 에이전트 스트레스 테스트로, 요구사항 중 가장 깨지기 쉬운 항목이기도 합니다.
두 앱은 생김새가 전혀 다릅니다. 과제를 바꾼 이유가 바로 이것입니다.
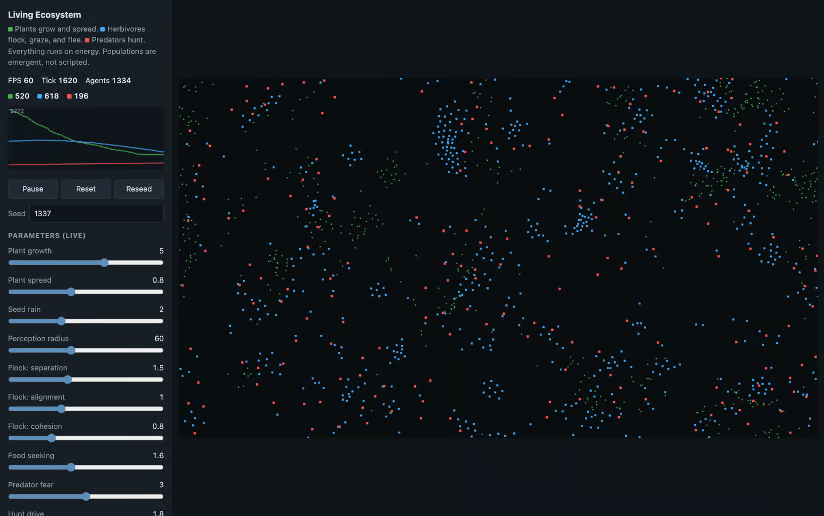
Fable 5: 좌측에 컨트롤, 에이전트는 평평한 사각형, 종 이름은 Plants, Herbivores, Predators.
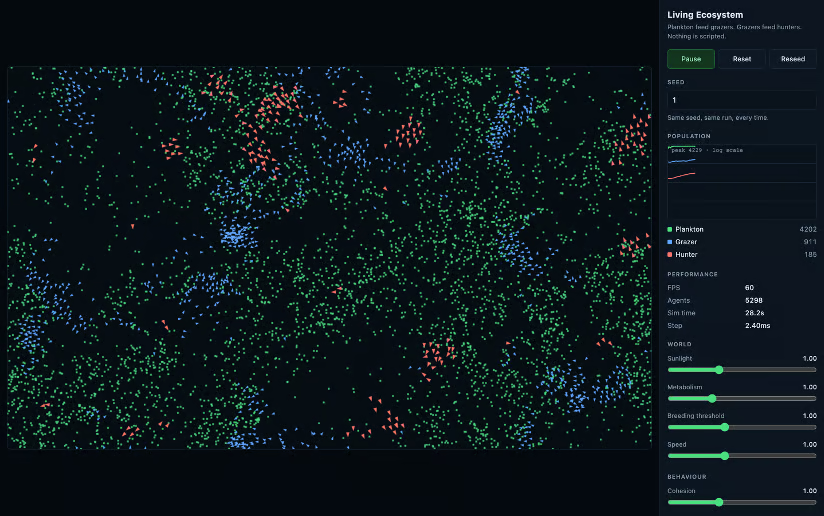
Opus 5: 우측에 컨트롤, 에이전트는 진행 방향을 가리키는 삼각형, 종 이름은 Plankton, Grazers, Hunters.
UI 측면의 주요 차이는 다음과 같습니다.
개체군 그래프에서 설계 차이가 선명해집니다.
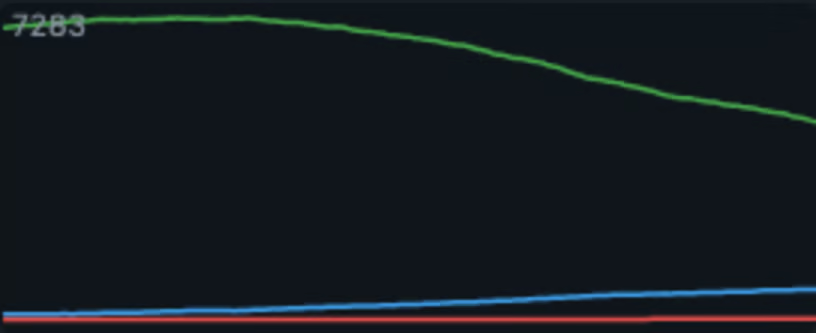
Fable 5의 그래프(선형 축). 식물 라인이 전체 높이를 차지하고 포식자 라인은 바닥에 붙어 있습니다.
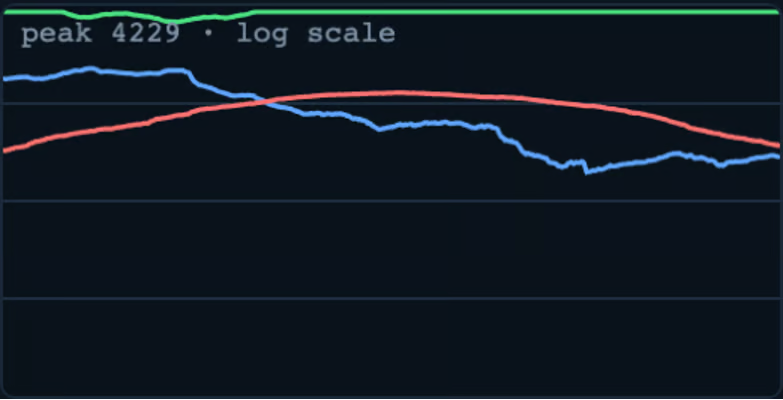
Opus 5의 그래프(로그 축). 세 종 모두 읽기 쉬우며, 헌터 라인이 그레이저 라인을 교차합니다.
두 시뮬레이션은 포식-피식 관계에서 기대되는 진동을 보입니다. Fable의 식물은 5분 동안 520에서 7,061 사이를 오가고, 초식동물과 포식자는 그 뒤를 따라 순환합니다. 포식자는 초식이 119로 바닥을 칠 때 정확히 248에서 정점을 찍습니다.
선형 축에서는 식물 라인이 세로 범위를 전부 차지하고, 초식은 얇은 띠로 압축되며, 포식자는 축에 붙습니다.
그래서 Opus는 로그 축을 쓰고 피크에 라벨을 붙였습니다. 세 종 모두 가독성이 유지되고, 헌터 라인이 상승해 그레이저 라인을 교차한 뒤 그레이저가 회복하면서 하강하는 모습을 볼 수 있습니다. 같은 종류의 데이터지만 두 차트 중 하나만 읽을 만합니다.
기저 생태계도 다릅니다. Opus는 생산자 층을 플랑크톤 4,229개로 상한을 두어, 그 개체군은 천장에 고정되고 상위 두 종만 순환합니다. Fable은 세 층을 모두 결합 상태로 두어 변동 폭이 더 크고 세계가 더 역동적입니다. 프롬프트에 없던 안정성 대 역동성의 차이를 보았습니다.
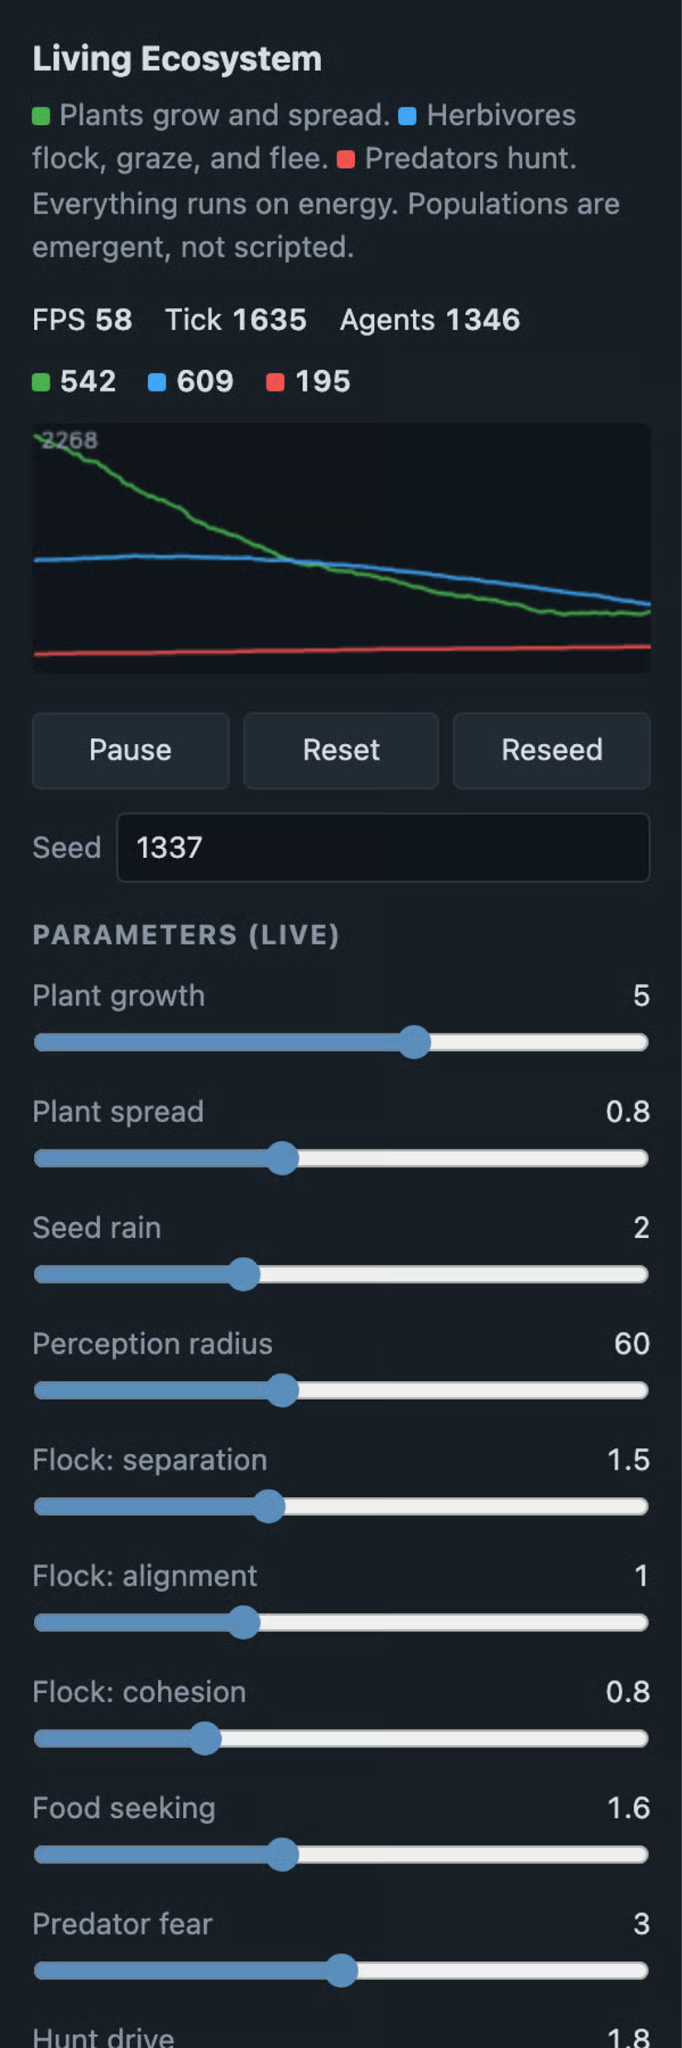
Fable 5의 파라미터 패널: 시뮬레이션 고유 단위의 13개 슬라이더.
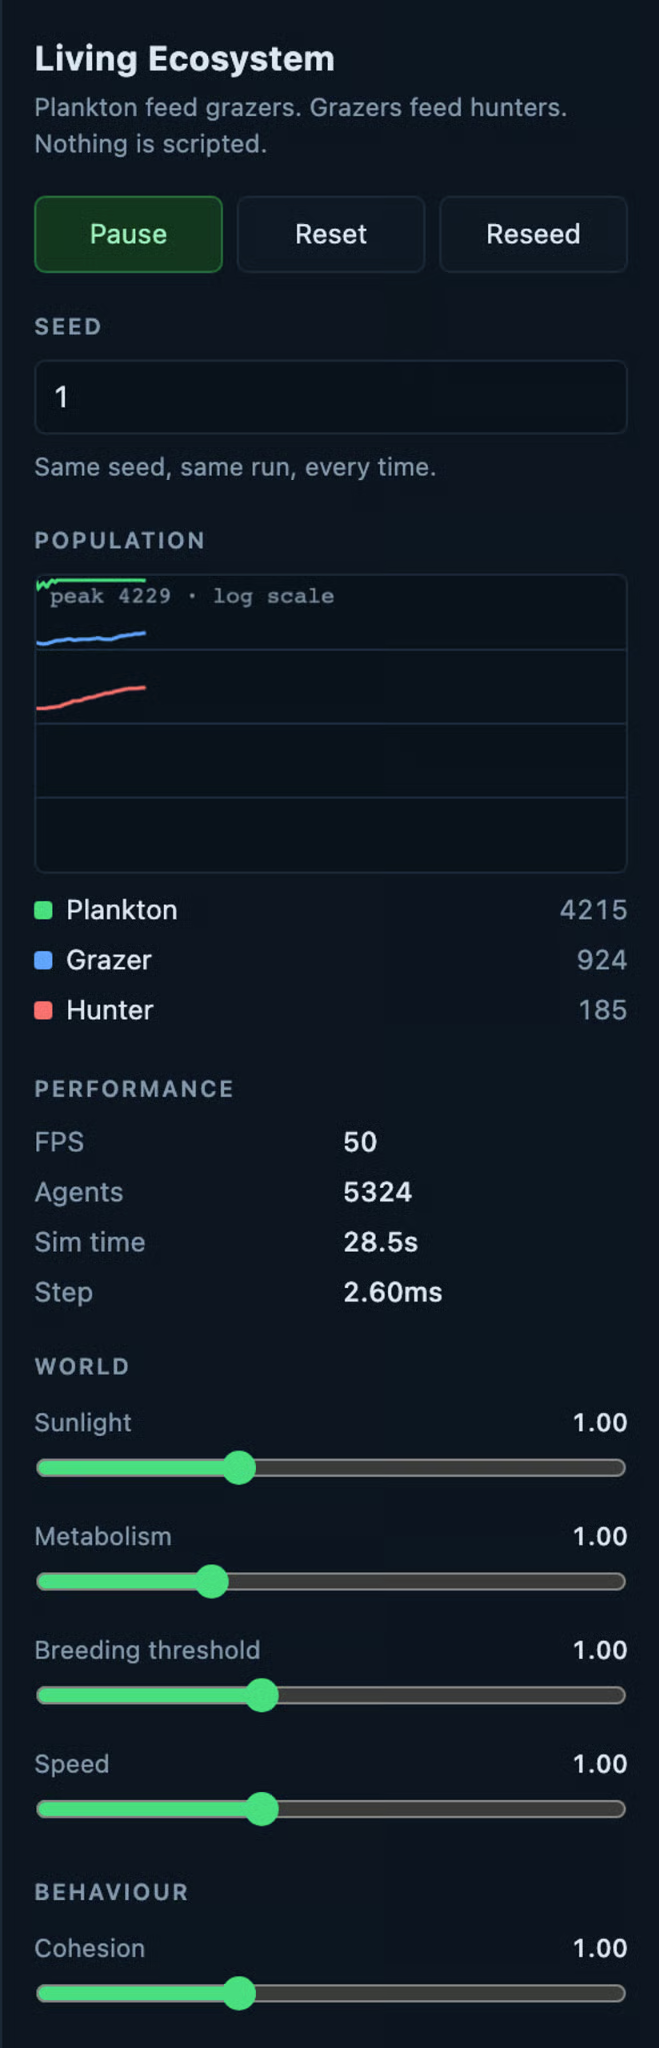
Opus 5의 파라미터 패널: 1.00 배수로 정규화된 9개 슬라이더, World와 Behaviour 그룹으로 구성.
Fable은 실제 단위의 13개 파라미터를 노출합니다. 예: 식물 성장 5, 지각 반경 60, 분리 1.5, 종별 대사 등. Opus는 모두 1.00에서 시작하는 정규화된 배수 9개를 World와 Behaviour 그룹으로 나눠 노출합니다.
한 문장으로 요약하면: Fable은 더 많은 제어권을 주고, Opus는 생태계 균형을 쉽게 깨뜨리지 않도록 한 패널을 제공합니다.
기본값으로는 Opus 5를 사용하세요. 이번 빌드에서 비용은 30% 저렴했고, 시뮬레이션은 2.3배 빠르며, 테스트 커버리지도 더 좋았습니다. Fable은 속도에서 이겼고, 약 절반의 시간에 마쳤습니다.
감독을 최소화해 한 번에 빌드를 끝내고 싶거나, 의존성 풋프린트가 중요할 때는 Fable 5로 가세요. Fable은 의존성이 전혀 없는 대안을 42% 더 작은 크기로 배포했으며, 247회 대비 103회의 assistant 턴으로 도달했습니다. 이 간결함은 이후에 직접 코드를 읽을 계획인 작업에서 큰 가치가 있습니다.
같은 유형의 프로젝트 두 번으로는 여전히 벤치마크가 되지 않습니다. 실제 성능은 기존 벤치마크와 무관하게 크게 달라질 수 있습니다.
예를 들어, 이번 비교에서는 Fable이 Opus보다 더 많은 토큰을 사용했지만, 대부분의 개발자는 반대 사례를 공유합니다. 유사한 작업에서 Opus 5가 Fable이나 Sol보다 훨씬 더 많은 토큰을 태운다는 것입니다. Opus 5의 RL 사전 학습이 간결하면서도 도움 되는 방향이 아니라 토큰 비용을 늘리는 쪽으로 과적합되었다는 의심이 있습니다. 제 작업에서도 확실히 그렇게 느꼈습니다. Opus 계열 모델은 점점 표면적으로 장황해지고 읽기 어려워지고 있습니다.
개인적으로는 대부분의 코딩 프로젝트(클라이언트 작업 포함)에 계속 Fable 5를 사용할 생각입니다. 장기적으로 정확도에서 이기기 때문입니다. 저는 최신 Max 요금제를 쓰고 있고, 여러 세션에서 Fable을 사용해도 아직 사용 한도에 도달한 적이 없습니다(Claude Code를 계속 돌리지는 않습니다). 토큰 비용이 중요하거나, 제 이해를 위해 진행 중 작업에 대한 실시간 해설이 필요할 때 Opus를 쓰겠습니다.
모델과 주변 도구에 대해 더 알고 싶다면, 전체 Claude Fable 5 가이드와 Claude Code 튜토리얼, Claude Code 모범 사례를 읽어보시길 권합니다.
DataCamp와 함께 Claude Code를 배우세요!
courses
courses
courses