Corso
Introduzione ai modelli Claude
3 ore
14.9K
Fable 5 è un modello incentrato sul coding della famiglia Claude 5 di Anthropic, rilasciato il 9 giugno 2026. È stato lanciato insieme a Mythos 5, un modello gemello senza classificatori di sicurezza che Anthropic ha offerto solo a un piccolo gruppo di organizzazioni verificate. Per una panoramica completa del rilascio e di come Fable 5 si posiziona nei benchmark, consulta la nostra guida dedicata a Fable 5.
Fable 5 è più costoso di Opus 5 ed è pensato per lavori di coding più difficili. La differenza principale, a livello di sensazione d'uso, è che esegue il "pensiero" su ogni richiesta e non lo si può disattivare, quindi risulta più lento e ponderato. Opus 5 decide da sé se un prompt merita o meno il pensiero extra.
I due modelli condividono finestra di contesto e dimensione massima dell'output. Differiscono per prezzo e per il modo in cui funziona il pensiero.
|
|
Fable 5 |
Opus 5 |
|
Prezzo input (per 1M token) |
$10 |
$5 |
|
Prezzo output (per 1M token) |
$50 |
$25 |
|
Finestra di contesto |
1M token |
1M token |
|
Output max per richiesta |
128K token |
128K token |
|
Pensiero |
Sempre attivo (non disattivabile) |
Adattivo (opt-in) |
|
Comportamento di rifiuto |
|
Standard |
Fable 5 costa circa il doppio per token rispetto a Opus 5. Poiché il pensiero è sempre attivo, una singola esecuzione tende anche a emettere più token, quindi il divario di prezzo nell'uso reale è più ampio di quanto suggerisca la tariffa per token. Nel confronto diretto più avanti in questa guida, Fable ha emesso il 74% di token in output in più rispetto a Opus per un programma più piccolo.
Per un confronto approfondito, inclusi i differenziali di benchmark, leggi la nostra guida Claude Opus 5 vs Claude Fable 5.
Un aspetto universalmente fastidioso di Fable 5 è il classificatore di sicurezza integrato. Poiché il modello è considerato troppo potente, il classificatore non gli consente di gestire richieste anche solo vagamente legate a campi come biologia o cybersecurity.
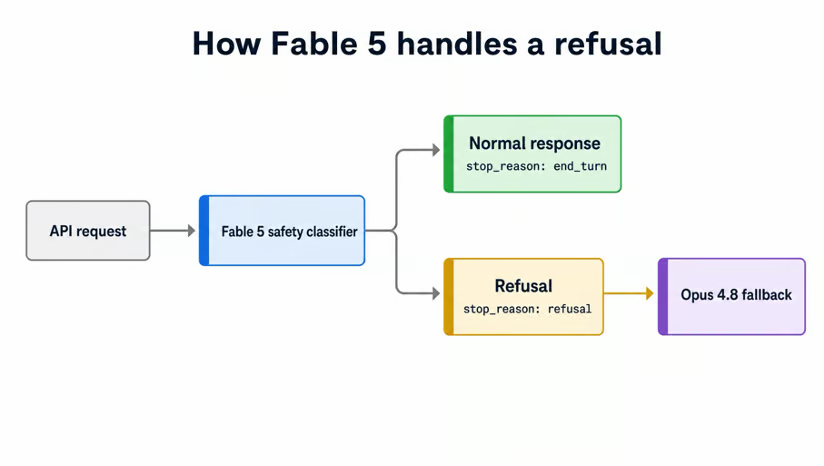
Per un immunologo, la sola parola "cancer" ha fatto scattare un filtro di biosicurezza, facendo sì che Claude Code ripiegasse su Opus 4.8.
Mi è capitato di recente con un bug di login in un progetto personale. Il flusso usava la Telegram Gateway API per l'accesso OTP e Fable 5 si è rifiutato del tutto di toccarlo. Opus 5 ha portato a termine il lavoro, ed è proprio questo il problema: nulla in quel bug costituiva un rischio di sicurezza.
Il fallback automatico, senza configurazione, avviene solo dentro Claude Code e le app Claude. Se stai usando Fable tramite API, riceverai un campo stop_reason nella risposta pur avendo un codice di successo 200.
La risposta appare così:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
Quindi devi controllare stop_reason prima di usare il contenuto della risposta.
Per abilitare il fallback lato server, passa un array fallbacks (es. "fallbacks": [{"model": "claude-opus-4-8"}]) e invia l'header anthropic-beta: server-side-fallback-2026-06-01. Impostalo su ogni richiesta; non esiste un interruttore a livello di account.
Potresti chiederti perché alcune fonti dicono che Fable 5 fa fallback su Opus 4.8 mentre altre indicano Opus 5. Hanno ragione entrambe, perché la destinazione dipende dalla categoria e dalla superficie.
In Claude Code, una richiesta contrassegnata come biologia ora viene rilanciata su Opus 5, mentre una contrassegnata come cybersecurity viene ancora rilanciata su Opus 4.8. Sull'API, la funzione lato server fallbacks attualmente supporta solo Opus 4.8.
La divisione è un artefatto temporale: al lancio di giugno di Fable, tutto faceva fallback su Opus 4.8, e il percorso biologia è stato reindirizzato su Opus 5 in seguito, quando quel modello è uscito il 24 luglio.
Fable 5 ha avuto un avvio turbolento, anche a prescindere dal classificatore di sicurezza.
Giorni dopo il lancio, Fortune ha riportato che Anthropic aveva silenziosamente indebolito le risposte di Fable 5 su circa lo 0,03% del traffico relativo a infrastrutture di AI e ML senza dirlo a nessuno.
Molti ricercatori, e anche sviluppatori, si sono infuriati perché si aspettavano un modello di frontiera tuttofare capace di affrontare qualsiasi task, specie se stanno pagando l'abbonamento da 200 dollari per averlo.
Anthropic ha ceduto alla pressione della community in un giorno, dicendo di aver "fatto il compromesso sbagliato". Ciò che è cambiato è stata la visibilità, non il throttling. Le richieste contrassegnate ora vengono mostrate allo stesso modo di un rifiuto, e il degrado in sé è rimasto. Secondo Anthropic, i suoi termini già vietano l'uso di Claude per costruire sistemi di IA concorrenti, il che è difendibile. Farlo in silenzio per un mese non lo era.
Poi è arrivata la più grossa. Un jailbreak reso pubblico ha innescato il 12 giugno un ordine di controllo all'esportazione del Commerce, e Anthropic ha messo offline in tutto il mondo per 19 giorni sia Fable 5 che Mythos 5.
Anthropic ha contestato duramente il richiamo per tutto il tempo. Ha sostenuto che il jailbreak fosse circoscritto e non universale, e rilevabile anche da modelli più deboli, quindi lo standard di richiamo appariva opaco dal suo punto di vista. Aveva un punto ragionevole sull'asticella in sé. Nessuno ha mai costruito un jailbreak universale e nessun modello oggi supera quello standard. Il UK AI Safety Institute ha riportato progressi verso uno, ma nulla che funzioni davvero.
Aveva un punto ragionevole sull'asticella in sé, anche se non su come l'ha presentato. I jailbreak universali esistono: il UK AI Security Institute riferisce di averne trovati per ogni sistema di frontiera testato, e i suoi red team ne hanno costruito uno contro lo stesso Fable 5, a singolo turno in poche ore ed esteso a workflow agentici multi-turno in pochi giorni, secondo la scheda del modello di Fable 5.
La vera questione dibattuta è se quell'asticella debba far scattare un richiamo, non se tali jailbreak siano possibili.
Anthropic ha rilasciato un classificatore più forte e ha riportato un tasso di blocco sopra il 99%; sulla base di ciò, il Commerce ha revocato i controlli intorno al 30 giugno.
L'accesso generale è tornato il 1° luglio, ma a condizioni più rigide. La finestra senza restrizioni promessa di due settimane si è ridotta a circa una, e un nuovo tetto settimanale del 50% significava che, una volta superato, ulteriore uso di Fable 5 veniva fatturato come crediti alla tariffa piena di $10 e $50. Tanto è bastato per far brontolare gli abbonati su Reddit.
Anthropic ha prorogato la scadenza due volte, poi il 20 luglio ha diviso la policy per piano: Max e Team Premium mantengono Fable 5 al 50% dei limiti settimanali senza data di fine, mentre Pro e Team Standard ricevono un credito una tantum di $100 e poi pagano la tariffa API. Mythos 5 è tornato disponibile solo per circa 100 organizzazioni statunitensi verificate, in calo rispetto a un programma internazionale più ampio.
Tutto ciò lascia Fable 5 come un modello valido avvolto in una policy di accesso che cambia di mese in mese. Metti in conto qualche rifiuto falso e non dare per scontato che i limiti di questo mese restino tali anche il prossimo.
Per vedere come si comportano i due modelli in condizioni identiche, ho dato a ciascuno lo stesso incarico in una nuova sessione di Claude Code. Poi ho letto le trascrizioni complete delle sessioni, i file JSONL interni e ho valutato entrambe le app finite in un browser.
Il mio primo tentativo di confronto usava uno shortener di URL. È stato un errore. Entrambi i modelli hanno prodotto app quasi identiche, fino al tema e al set di funzionalità, perché uno shortener ha una risposta ovvia presente nei dati di training di ogni modello. Il test non misurava nulla.
Così ho scelto un task senza risposta canonica: una simulazione di ecosistema vivente. Tre specie in una rete trofica, agenti che si raggruppano, cacciano e muoiono di fame, 5000 sullo schermo contemporaneamente, tutto deterministico a partire da un seed. Il prompt vieta le librerie che gestirebbero le parti difficili, quindi ogni modello deve scrivere da sé query spaziali, steering e dinamiche di popolazione.
Ecco il prompt ricevuto da entrambi i modelli, parola per parola:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
La regola del “niente domande” è il punto chiave. Mostra fino a dove ciascun modello porta avanti il build da solo, senza nessuno che corregga eventuali deviazioni. Ognuno ha lavorato nella propria directory vuota, senza indizi che un secondo modello avesse lo stesso compito.
Il task nasconde anche quattro test oggettivi dentro un output che sembra puramente visivo.
Ognuno di questi fallimenti è visibile sullo schermo, ed è questo che rende valutabile una demo carina.
Entrambi i build sono online, quindi puoi rifare il confronto da solo invece di fidarti sulla parola. Aprili affiancati e fai il reseed di ciascuno:
Più sotto trovi gli screenshot di entrambi, se preferisci leggere invece di cliccare. Nota però che gli screenshot sono rimpiccioliti per far entrare tutto lo schermo, quindi i dettagli potrebbero non essere chiarissimi.
Prima dei risultati, una nota metodologica importante per interpretarli.
Claude Code può fare fallback su Opus quando il classificatore di sicurezza di Fable 5 rifiuta una richiesta, quindi una run etichettata Fable non è garantito che sia tutta Fable. Invece di presumere, ho registrato il campo model su ogni evento dell'assistente in entrambe le trascrizioni.
Per fortuna, nel mio confronto, ogni evento della run Fable è tornato claude-fable-5, tutti e 103. Ogni evento della run Opus è tornato claude-opus-5, tutti e 247. Nessun fallback è scattato in nessuna direzione. I numeri sotto descrivono i modelli in etichetta.
Fable ha lavorato in silenzio. Ha eseguito 56 chiamate agli strumenti e stampato 429 parole di commento in tutto il build, in 2 blocchi di testo.
Opus ha lavorato alla luce del sole. Ha eseguito 137 chiamate agli strumenti, più del doppio, e stampato 4.808 parole in 110 blocchi. Entrambi i modelli hanno rivisto a un ritmo simile, una volta considerato il volume, vicino a 2 modifiche per file scritto.
Si sono divisi anche sugli strumenti. Fable ha consegnato semplici moduli ES con uno script di avvio python3 -m http.server e senza node_modules. Opus ha installato Vite e Vitest e ha costruito con una toolchain vera.
I tempi di build sotto misurano solo il lavoro attivo. Ho preso ogni run dal primo evento dell'assistente all'ultimo e ho sottratto le pause in cui la sessione restava in attesa invece di costruire.
|
Dimensione |
Fable 5 |
Opus 5 |
|
Eventi dell'assistente |
103 |
247 |
|
Tempo di build attivo |
25 min |
48 min |
|
Token di output |
243.442 |
139.920 |
|
Letture cache |
11,3M |
26,4M |
|
Chiamate agli strumenti |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
Testo visibile stampato |
429 parole (2 blocchi) |
4.808 parole (110 blocchi) |
|
Costo totale |
$28,70 |
$20,07 |
|
File consegnati |
9, zero dipendenze |
13, Vite + Vitest |
|
Righe di codice |
~1.010 |
~1.746 |
|
Test |
16, tutti superati |
58, tutti superati |
|
|
No |
Sì |
|
Velocità simulazione |
3,14 ms/tick a 3.510 agenti |
1,35 ms/tick a 4.368 agenti |
|
Caricato su GitHub |
Sì |
Sì |
Fable è costato il 43% in più e ha prodotto il 74% di token in output in più per un programma più piccolo. Non potendo disattivare il suo pensiero, continua a fatturare anche quando il lavoro non ne ha bisogno.
Entrambi i modelli hanno superato ogni verifica oggettiva:
NaN.La simulazione di Opus è 2,3 volte più veloce per tick. Memorizza gli agenti in typed array, un array piatto per proprietà, e mantiene una griglia spaziale separata per specie. Fable dà a ogni agente un proprio oggetto e condivide una griglia uniforme tra tutte e tre le specie. Entrambe le scelte sono corrette, ma quella di Opus è un layout dati più veloce.
Lo script npm test di Fable non gira. Ha consegnato node --test test/, che Node 26 interpreta come un percorso di modulo e non come directory, quindi il comando muore prima di eseguire un singolo test. I 16 test sottostanti vanno bene e passano quando nomini esplicitamente i file. Il punto di ingresso in package.json è rotto.
È un bug piccolo con un costo sproporzionato, perché l'unico comando che un lettore digiterà davvero è quello che fallisce. Fable inoltre non l'ha mai intercettato, ed è questo che conta: il prompt chiedeva i test, e li ha verificati per una via che i suoi utenti non percorreranno.
Opus non ha un fallimento equivalente. I suoi 58 test girano da npm test e passano. Entrambe le suite testano ciò che conta qui: determinismo con seed, conservazione dell'energia, wrapping a toro e sopravvivenza delle specie sul lungo periodo; il divario è di profondità, non di natura. L'unico controllo scritto solo da Opus è lo stress test a 5000 agenti, che è anche il requisito più facile da rompere.
Le due app non si somigliano affatto, ed è proprio il motivo del cambio di task.
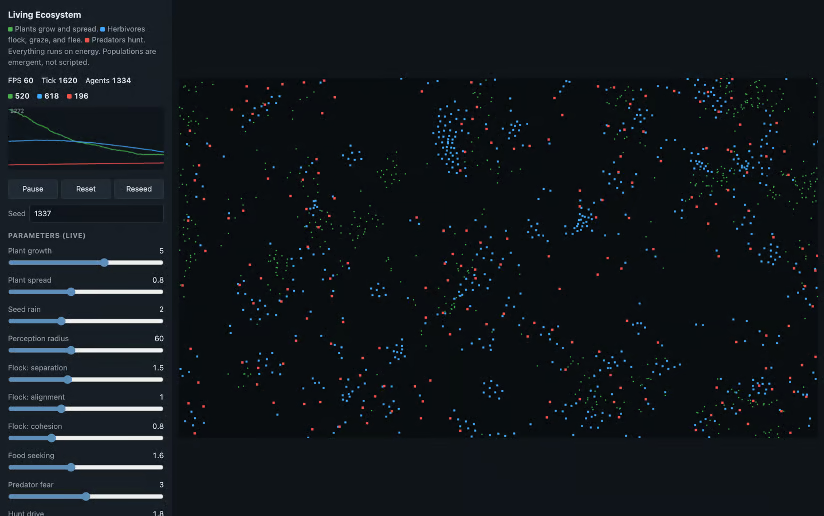
Fable 5: controlli a sinistra, agenti come quadrati piatti, specie chiamate Plants, Herbivores e Predators.
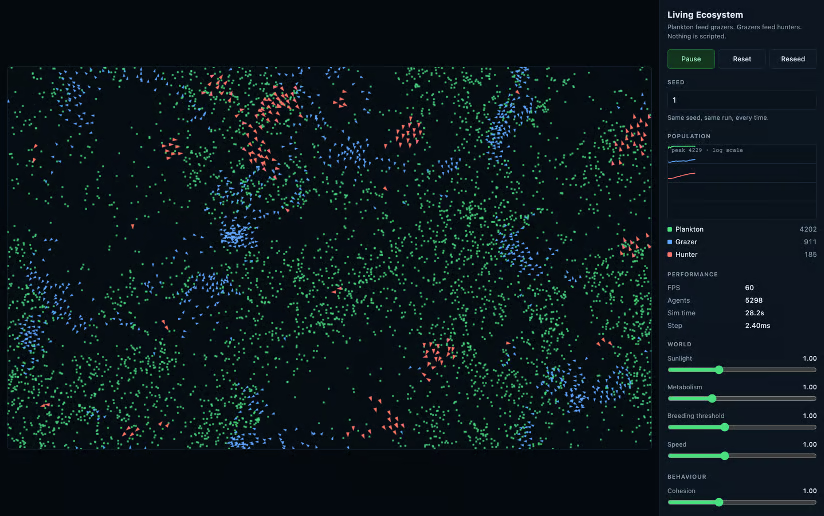
Opus 5: controlli a destra, agenti come triangoli direzionali che indicano dove sono diretti, specie chiamate Plankton, Grazers e Hunters.
Sul lato UI, queste sono le differenze maggiori:
I grafici di popolazione sono dove la differenza di design diventa netta.
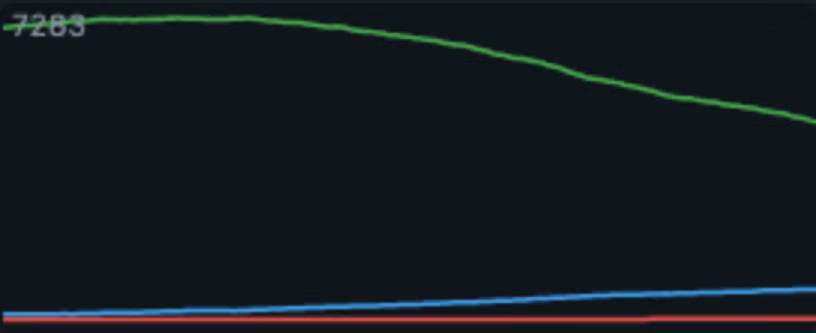
Il grafico di Fable 5, scala lineare. La linea delle piante occupa tutta l'altezza e la linea dei predatori è schiacciata in basso.
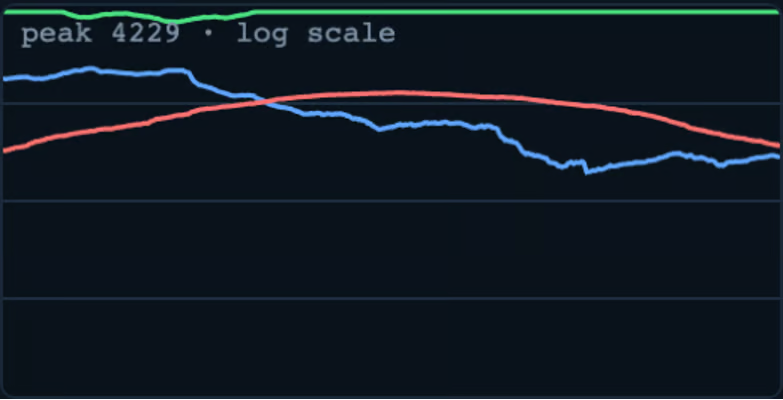
Il grafico di Opus 5, scala logaritmica. Tutte e tre le specie restano leggibili e la linea dei cacciatori incrocia quella dei brucatori.
Entrambe le simulazioni oscillano come dovrebbe fare un sistema preda-predatore. Le piante di Fable oscillano tra 520 e 7.061 in 5 minuti mentre erbivori e predatori seguono a ruota, con i predatori che raggiungono il picco a 248 proprio quando gli erbivori toccano il minimo a 119.
Su una scala lineare, la linea delle piante si prende tutta la gamma verticale, gli erbivori si comprimono in una banda sottile e i predatori restano piatti sull'asse.
Ecco perché Opus ha messo il suo grafico su scala log e ha etichettato il picco. Tutte e tre le specie restano leggibili, e puoi vedere la linea dei cacciatori salire, incrociare quella dei brucatori e scendere mentre i brucatori si riprendono. Stessa classe di dati, ma solo uno dei due grafici è leggibile.
Anche gli ecosistemi sottostanti differiscono. Opus limita il livello dei produttori a 4.229 plancton, quindi quella popolazione resta al soffitto e ciclicizzano solo le due specie superiori. Fable lascia accoppiate tutte e tre, il che dà oscillazioni più ampie e un mondo più vivace. Senza chiederlo nel prompt, abbiamo ottenuto stabilità contro dinamismo.
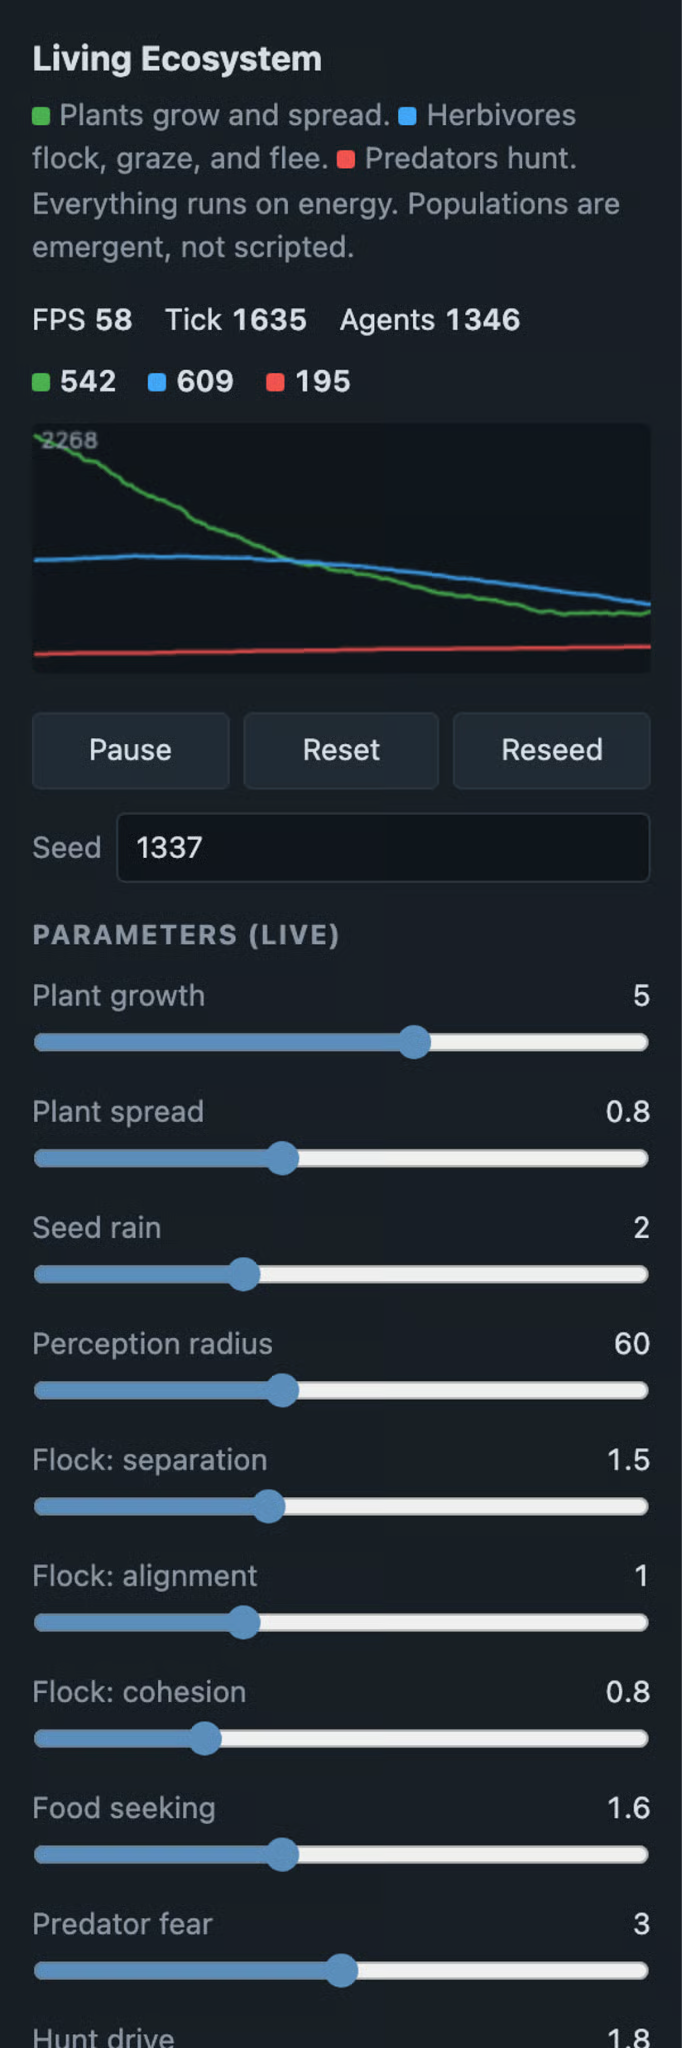
Pannello dei parametri di Fable 5: 13 slider nelle unità proprie della simulazione.
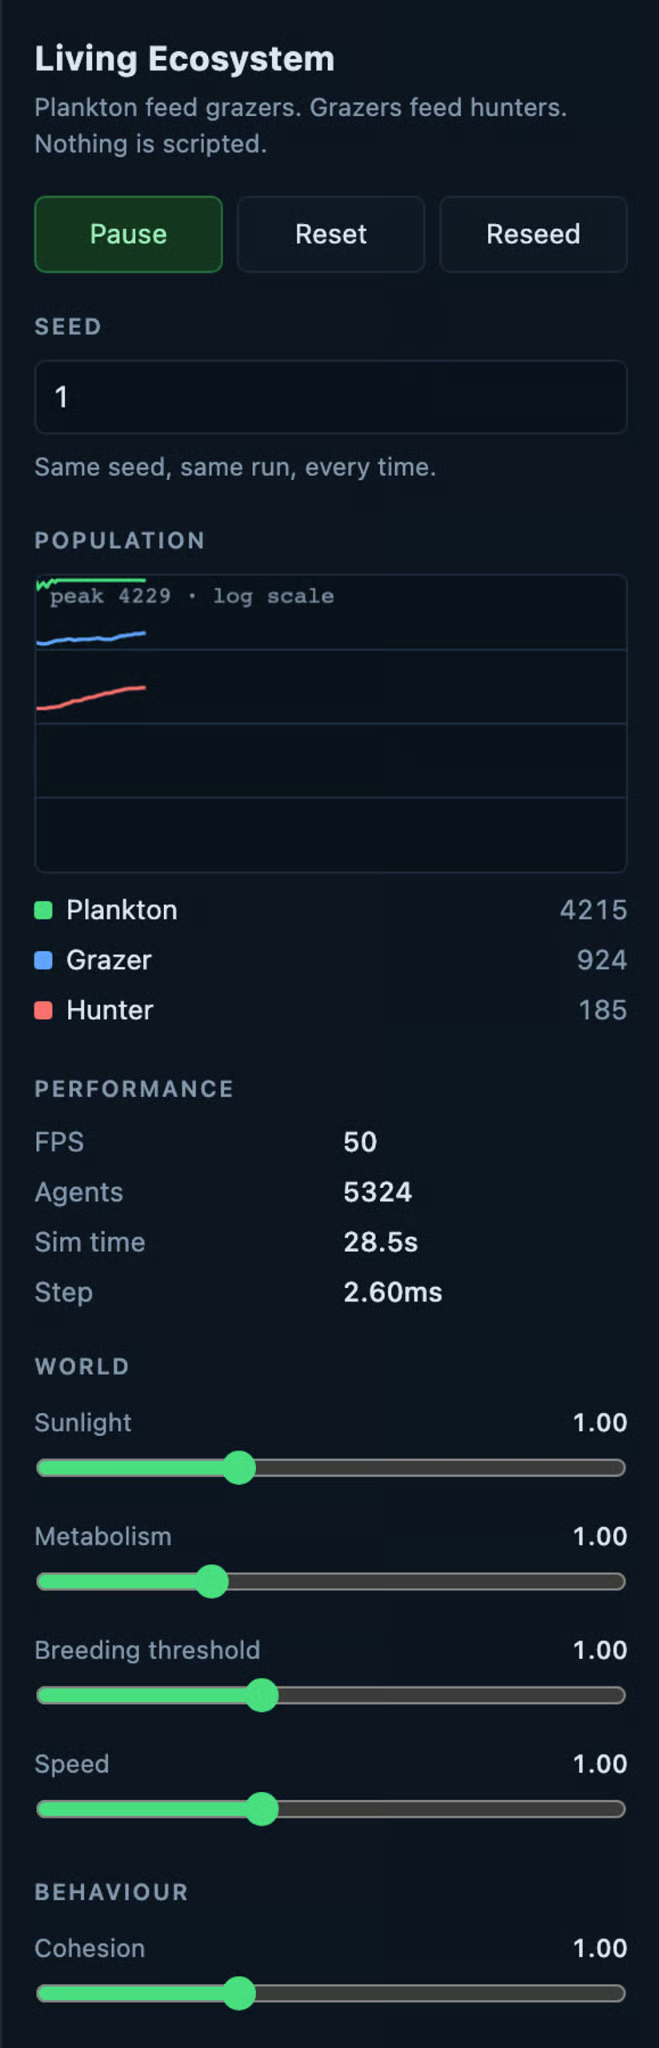
Pannello dei parametri di Opus 5: 9 slider, ciascuno un moltiplicatore che parte da 1,00, raggruppati in World e Behaviour.
Fable espone 13 parametri in unità reali: crescita piante 5, raggio di percezione 60, separazione 1,5 e metabolismo per specie. Opus ne espone 9, tutti moltiplicatori normalizzati che partono da 1,00, divisi in gruppi World e Behaviour.
In una frase: Fable ti dà più controllo, mentre Opus ti dà un pannello che non ti permette di rompere facilmente l'equilibrio dell'ecosistema.
Usa Opus 5 come default. In questo build è costato il 30% in meno, ha eseguito una simulazione 2,3 volte più veloce e ha scritto una copertura di test migliore. Fable ha vinto in velocità, finendo in circa metà del tempo.
Passa a Fable 5 quando vuoi un build finito in un solo passaggio con supervisione minima, o quando contano le dipendenze. Fable ha consegnato un programma senza dipendenze, più piccolo del 42% rispetto all'alternativa, e ci è arrivato con 103 turni dell'assistente contro 247. Questa sintesi ha un valore reale in un task che poi intendi leggere da solo.
Due build di un solo tipo di progetto non sono comunque un benchmark. Le prestazioni nel mondo reale possono variare parecchio, a dispetto dei benchmark esistenti.
Per esempio, anche se il nostro confronto ha mostrato Fable usare più token di Opus, la maggior parte degli sviluppatori condivide l'inverso: Opus 5 brucia molti più token di Fable o Sol su task simili. Il sospetto è che il pre-training RL di Opus 5 l'abbia ottimizzato troppo per accumulare costi di token invece di essere utile restando conciso. Al di fuori del confronto, l'ho percepito anch'io nel mio lavoro. I modelli della famiglia Opus sono sempre più verbosi in superficie e più difficili da leggere.
Personalmente continuerò a usare Fable 5 per quasi tutti i miei progetti di coding, anche per i clienti, perché sul lungo periodo vince in accuratezza. Sono sul piano Max più recente e non ho ancora toccato i limiti d'uso, anche usando Fable in più sessioni (anche se non tengo Claude Code sempre in esecuzione). Userò Opus quando il conto dei token conta, o quando voglio un commento in tempo reale sul task in corso per capirlo meglio.
Per approfondire i modelli e gli strumenti attorno a loro, consiglio di leggere la nostra guida a Claude Fable 5, insieme ai tutorial su Claude Code e sulle best practice di Claude Code.
Impara a usare Claude Code con DataCamp!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min