
Last chance! 50% off DataCamp Premium
Sale ends in
Fable 5, Anthropic के Claude 5 परिवार का एक कोडिंग-केंद्रित मॉडल है, जो 9 जून, 2026 को जारी हुआ। यह Mythos 5 के साथ आया था—एक जुड़वां मॉडल जिसमें कोई सेफ्टी क्लासिफायर नहीं था और जिसे Anthropic ने केवल कुछ छांटी हुई संगठनों को पेश किया। रिलीज़ के पूरे वॉकथ्रू और बेंचमार्क्स पर Fable 5 की स्थिति देखने के लिए हमारा समर्पित Fable 5 गाइड पढ़ें।
कीमत के मामले में Fable 5, Opus 5 से ऊपर बैठता है और कठिन कोडिंग कार्यों के लिए लक्षित है। अनुभव में मुख्य फर्क यह है कि यह हर रिक्वेस्ट पर सोचने की प्रक्रिया चलाता है और इसे बंद नहीं कर सकता, इसलिए यह धीमा और अधिक सोच-समझकर काम करने वाला लगता है। Opus 5 खुद तय करता है कि किसी प्रॉम्प्ट पर अतिरिक्त सोच की जरूरत है या नहीं।
दोनों मॉडलों का कॉन्टेक्स्ट विंडो और अधिकतम आउटपुट आकार समान है। वे कीमत और सोचने की प्रक्रिया के तरीके पर अलग हैं।
|
|
Fable 5 |
Opus 5 |
|
इनपुट कीमत (प्रति 1M टोकन) |
$10 |
$5 |
|
आउटपुट कीमत (प्रति 1M टोकन) |
$50 |
$25 |
|
कॉन्टेक्स्ट विंडो |
1M टोकन |
1M टोकन |
|
प्रति रिक्वेस्ट अधिकतम आउटपुट |
128K टोकन |
128K टोकन |
|
सोचने की प्रक्रिया |
हमेशा चालू (अक्षम नहीं कर सकते) |
अनुकूली (opt-in) |
|
इंकार का व्यवहार |
|
मानक |
Fable 5 की प्रति टोकन कीमत Opus 5 से करीब दोगुनी है। क्योंकि इसकी सोचने की प्रक्रिया हमेशा चालू रहती है, एक रन में आमतौर पर अधिक टोकन निकलते हैं, इसलिए वास्तविक उपयोग में कीमत का अंतर प्रति-टोकन दर से भी ज़्यादा हो जाता है। इस गाइड के आगे दिए गए हेड-टू-हेड बिल्ड में, छोटे प्रोग्राम के लिए Fable ने Opus से 74% अधिक आउटपुट टोकन निकाले।
बेंचमार्क अंतर समेत गहराई से तुलना के लिए हमारा Claude Opus 5 बनाम Claude Fable 5 गाइड पढ़ें।
Fable 5 का एक सार्वभौमिक रूप से झुंझलाने वाला पहलू इसका बिल्ट-इन सेफ्टी क्लासिफायर है। मॉडल को अतिशय शक्तिशाली मानते हुए, क्लासिफायर उन रिक्वेस्ट्स को भी नहीं लेने देता जो जरा-सा भी बायोलॉजी या साइबरसिक्योरिटी जैसे क्षेत्रों से संबंधित हों।
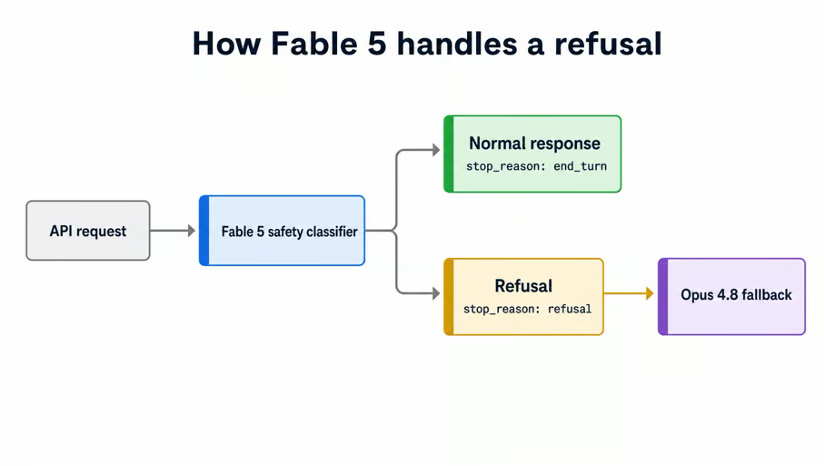
एक इम्यूनोलॉजिस्ट के लिए, सिर्फ "cancer" शब्द ने ही बायोसिक्योरिटी फ़िल्टर को ट्रिगर कर दिया, जिससे Claude Code ने Opus 4.8 पर फॉलबैक कर लिया।
मुझे खुद भी यह एक निजी प्रोजेक्ट के लॉगिन बग पर झेलना पड़ा। फ्लो में OTP साइन-इन के लिए Telegram Gateway API था, और Fable 5 ने इसे छूने से भी इनकार कर दिया। Opus 5 ने काम कर दिया—यही असल समस्या है: उस बग में सुरक्षा जोखिम जैसा कुछ था ही नहीं।
स्वचालित, ज़ीरो-कॉन्फ़िग फॉलबैक केवल Claude Code और Claude ऐप्स के भीतर होता है। अगर आप API के जरिए Fable का उपयोग कर रहे हैं, तो 200 सक्सेस कोड मिलने के बावजूद आपको रिस्पॉन्स में stop_reason फ़ील्ड मिलेगा।
रिस्पॉन्स कुछ ऐसा दिखता है:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
तो, आपको रिस्पॉन्स कंटेंट को छूने से पहले stop_reason चेक करना होगा।
सर्वर-साइड फॉलबैक सक्षम करने के लिए, fallbacks ऐरे पास करें (उदाहरण: "fallbacks": [{"model": "claude-opus-4-8"}]) और anthropic-beta: server-side-fallback-2026-06-01 हेडर भेजें। इसे हर रिक्वेस्ट पर सेट करें; कोई अकाउंट-स्तरीय स्विच नहीं है।
आप सोच सकते हैं कि कुछ स्रोत Fable 5 के Opus 4.8 पर फॉलबैक की बात करते हैं, तो कुछ Opus 5 की। दोनों सही हैं, क्योंकि टार्गेट कैटेगरी और सतह (surface) पर निर्भर करता है।
Claude Code में, बायोलॉजी-फ्लैग्ड रिक्वेस्ट अब Opus 5 पर फिर से चलती है, जबकि साइबरसिक्योरिटी-फ्लैग्ड रिक्वेस्ट अब भी Opus 4.8 पर जाती है। API पर, सर्वर-साइड fallbacks फीचर फिलहाल केवल Opus 4.8 को सपोर्ट करता है।
यह बंटवारा टाइमिंग आर्टिफैक्ट है: Fable के जून लॉन्च पर सब कुछ Opus 4.8 पर फॉलबैक करता था, और 24 जुलाई को Opus 5 आने के बाद बायोलॉजी पाथ को Opus 5 की ओर मोड़ दिया गया।
सेफ्टी क्लासिफायर के अलावा भी, Fable 5 की शुरुआत उथल-पुथल भरी रही है।
लॉन्च के कुछ दिनों बाद, Fortune ने रिपोर्ट किया कि Anthropic ने बिना बताए Fable 5 के जवाबों को AI और ML इंफ्रास्ट्रक्चर ट्रैफिक के लगभग 0.03% पर चुपचाप कमजोर कर दिया था।
कई शोधकर्ता और डेवलपर्स नाराज़ हो गए क्योंकि वे $200 सब्सक्रिप्शन देकर एक ऐसे फ्रंटियर मॉडल की उम्मीद कर रहे थे जो कोई भी काम संभाल सके।
Anthropic ने एक दिन के भीतर सामुदायिक दबाव के आगे झुकते हुए कहा कि उसने "गलत समझौता" किया। पर बदलाव दृश्यता का हुआ, थ्रॉटल का नहीं। अब फ्लैग्ड रिक्वेस्ट्स उसी तरह दिखाई देती हैं जैसे इंकार, जबकि गिरावट खुद जस की तस रही। Anthropic की दलील थी कि उसके नियम पहले से ही Claude का उपयोग प्रतिस्पर्धी AI सिस्टम बनाने के लिए निषिद्ध करते हैं, जो बचाव योग्य है। पर एक महीने तक इसे चुपचाप करना नहीं।
फिर बड़ा झटका आया। एक सार्वजनिक जेलब्रेक के चलते 12 जून को वाणिज्य विभाग का एक्सपोर्ट-कंट्रोल आदेश लगा, और Anthropic ने Fable 5 और Mythos 5 दोनों को 19 दिनों के लिए दुनिया भर में ऑफलाइन कर दिया।
Anthropic ने पूरे समय रिकॉल का कड़ा विरोध किया। उसका तर्क था कि जेलब्रेक व्यापक नहीं, बल्कि संकीर्ण था, और कमजोर मॉडल भी उसे ढूंढ सकते थे, इसलिए रिकॉल मानदंड उसे अपारदर्शी लगा। मानक की ऊंचाई पर उसका तर्क उचित था। किसी ने भी अब तक सार्वभौमिक जेलब्रेक नहीं बनाया है, और आज कोई मॉडल उस कसौटी पर खरा नहीं उतरता। UK AI सेफ्टी इंस्टीट्यूट ने इस दिशा में प्रगति की रिपोर्ट की है, पर कुछ भी व्यावहारिक नहीं।
हालांकि, बात को रखने का तरीका पूरी तरह सटीक नहीं था। सार्वभौमिक जेलब्रेक मौजूद हैं: UK AI सिक्योरिटी इंस्टीट्यूट की रिपोर्ट कहती है कि उसने अपने हर फ्रंटियर सिस्टम के लिए ऐसे पाए हैं, और इसके रेड-टीमर ने खुद Fable 5 पर भी एक बनाया—सिंगल-टर्न में घंटों के भीतर, और Fable 5 के मॉडल कार्ड के मुताबिक कुछ दिनों में मल्टीटर्न एजेंटिक वर्कफ़्लोज़ तक बढ़ाया।
असल विवाद इस पर है कि क्या ऐसी कसौटी रिकॉल ट्रिगर करे या नहीं, न कि ऐसे जेलब्रेक संभव हैं या नहीं।
Anthropic ने एक मजबूत क्लासिफायर जारी किया और 99% से अधिक ब्लॉक दर की रिपोर्ट दी, और उसी के आधार पर लगभग 30 जून को वाणिज्य विभाग ने नियंत्रण हटा लिए।
1 जुलाई को सामान्य एक्सेस लौट आया, पर कड़ी शर्तों के साथ। वादा किया गया दो-सप्ताह का अनियंत्रित विंडो लगभग एक सप्ताह रह गया, और नए 50% साप्ताहिक कैप का मतलब था कि इसे पार करते ही Fable 5 का आगे का उपयोग पूरे $10 और $50 रेट पर क्रेडिट्स के रूप में बिल किया गया। Reddit पर सब्सक्राइबर्स नाराज़ होने को यही काफी था।
Anthropic ने समयसीमा दो बार बढ़ाई, फिर 20 जुलाई को प्लान के अनुसार नीति बांट दी: Max और Team Premium में Fable 5 साप्ताहिक लिमिट्स के 50% पर बिना अंत-तिथि के रहेगा, जबकि Pro और Team Standard को एक बार का $100 क्रेडिट मिलेगा और उसके बाद API रेट देना होगा। Mythos 5 अब केवल लगभग 100 चुनी हुई अमेरिकी संगठनों तक सीमित होकर लौटा, जो पहले के व्यापक अंतरराष्ट्रीय कार्यक्रम से कम है।
इन सबका नतीजा यह है कि Fable 5 एक मजबूत मॉडल है, जिसे ऐसी एक्सेस नीति में लपेटा गया है जो महीने-दर-महीने बदलती रहती है। कभी-कभार होने वाले गलत इंकार के लिए तैयार रहें, और यह न मानें कि इस महीने की रेट लिमिट्स अगले महीने भी वैसी ही रहेंगी।
यह देखने के लिए कि समान परिस्थितियों में दोनों मॉडल कैसे बर्ताव करते हैं, मैंने एक नई Claude Code सेशन में दोनों को एक ही काम दिया। बाद में, मैंने दोनों के पूरे सेशन ट्रांसक्रिप्ट्स, आंतरिक JSONL फाइलें पढ़ीं, और दोनों तैयार ऐप्स को ब्राउज़र में ग्रेड किया।
इस तुलना का मेरा पहला प्रयास एक URL शॉर्टनर पर था। वह गलती थी। दोनों मॉडलों ने लगभग एक जैसे ऐप बनाए—थीम और फीचर सेट तक—क्योंकि URL शॉर्टनर का एक ही स्पष्ट समाधान हर मॉडल के प्रशिक्षण डेटा में पड़ा है। टेस्ट ने कुछ नापा ही नहीं।
तो मैंने एक ऐसा काम चुना जिसका कोई मानक जवाब न हो: एक लिविंग इकोसिस्टम सिमुलेशन। एक फूड वेब में तीन प्रजातियां, एजेंट जो झुंड बनाते, शिकार करते, भूख से मरते हैं, एक साथ स्क्रीन पर 5000 एजेंट, और यह सब किसी सीड से निर्धारक (deterministic) हो। प्रॉम्प्ट उन लाइब्रेरीज़ पर पाबंदी लगाता है जो मुश्किल हिस्सों को संभाल लेंगी, इसलिए हर मॉडल को अपने स्पैटियल क्वेरी, स्टीयरिंग और पॉपुलेशन डायनेमिक्स खुद लिखने होंगे।
दोनों मॉडलों को मिला प्रॉम्प्ट हूबहू यह था:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
कोई-प्रश्न-नहीं नियम ही असल बात है। यह दिखाता है कि बिना किसी के दखल के, हर मॉडल खुद से बिल्ड को कितनी दूर तक ले जाता है। हर रन अपनी-अपनी खाली डायरेक्टरी में चला, और किसी को यह इशारा नहीं था कि दूसरे मॉडल के पास भी वही काम है।
यह टास्क दिखने में भले विज़ुअल लगे, पर आउटपुट के भीतर चार ऑब्जेक्टिव टेस्ट छिपे हैं।
इनमें से हर विफलता स्क्रीन पर दिख जाती है—इसीलिए एक सुंदर डेमो भी ग्रेड किया जा सकता है।
दोनों बिल्ड लाइव हैं, इसलिए आप मेरे शब्दों पर भरोसा करने के बजाय खुद यह तुलना चला सकते हैं। दोनों को साथ खोलें और हर एक को रिसीड करें:
दोनों के स्क्रीनशॉट नीचे हैं, अगर आप क्लिक करने के बजाय पढ़ना चाहें। लेकिन एक बात ध्यान दें: स्क्रीनशॉट पूरी स्क्रीन में फिट करने के लिए ज़ूम-आउट हैं, इसलिए बारीकियां बिल्कुल साफ़ नहीं दिख सकतीं।
नतीजों से पहले, उन्हें पढ़ने के लिहाज से एक कार्य-पद्धति नोट।
जब Fable 5 का सेफ्टी क्लासिफायर किसी रिक्वेस्ट को मना करता है, तो Claude Code Opus पर फॉलबैक कर सकता है—यानी Fable लेबल लगा रन पूरी तरह Fable होने की गारंटी नहीं। मान लेने के बजाय, मैंने दोनों ट्रांसक्रिप्ट्स में हर असिस्टेंट इवेंट पर model फ़ील्ड दर्ज किया।
खुशकिस्मती से, मेरी तुलना में, Fable रन के हर इवेंट का जवाब claude-fable-5 के रूप में आया—कुल 103। Opus रन का हर इवेंट claude-opus-5 के रूप में—कुल 247। किसी दिशा में फॉलबैक नहीं चला। नीचे दिए गए आंकड़े लेबल वाले मॉडलों का ही वर्णन करते हैं।
Fable चुपचाप काम करता रहा। उसने 56 टूल कॉल चलाए और पूरे बिल्ड में सिर्फ 2 टेक्स्ट ब्लॉक्स में 429 शब्दों की टिप्पणी छापी।
Opus खुले में काम करता रहा। उसने 137 टूल कॉल चलाए—दो गुना से भी ज्यादा—और 110 ब्लॉक्स में 4,808 शब्द छापे। वॉल्यूम को ध्यान में रखें तो दोनों ने लगभग समान गति से संशोधन किए—प्रति लिखी गई फाइल करीब 2 एडिट।
टूलिंग पर भी फर्क दिखा। Fable ने सादा ES मॉड्यूल्स शिप किए, python3 -m http.server स्टार्ट स्क्रिप्ट के साथ और बिल्कुल भी node_modules नहीं। Opus ने Vite और Vitest इंस्टॉल किए और असली टूलचेन पर बिल्ड किया।
नीचे दिए गए बिल्ड समय केवल सक्रिय काम को मापते हैं। मैंने हर रन को उसके पहले असिस्टेंट इवेंट से आखिरी तक लिया और बीच का वह खाली समय घटाया जब सेशन इंतजार में था, बिल्ड नहीं कर रहा था।
|
आयाम |
Fable 5 |
Opus 5 |
|
असिस्टेंट इवेंट्स |
103 |
247 |
|
सक्रिय बिल्ड समय |
25 मिनट |
48 मिनट |
|
आउटपुट टोकन |
243,442 |
139,920 |
|
कैश रीड्स |
11.3M |
26.4M |
|
टूल कॉल्स |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
दिखने वाला प्रिंटेड टेक्स्ट |
429 शब्द (2 ब्लॉक्स) |
4,808 शब्द (110 ब्लॉक्स) |
|
कुल लागत |
$28.70 |
$20.07 |
|
शिप की गई फाइलें |
9, शून्य डिपेंडेंसी |
13, Vite + Vitest |
|
कोड की लाइनें |
~1,010 |
~1,746 |
|
टेस्ट |
16, सभी पास |
58, सभी पास |
|
|
नहीं |
हाँ |
|
सिमुलेशन स्पीड |
3.14 ms/tick @ 3,510 एजेंट |
1.35 ms/tick @ 4,368 एजेंट |
|
GitHub पर शिप |
हाँ |
हाँ |
Fable की लागत 43% अधिक आई और छोटे प्रोग्राम के लिए 74% अधिक आउटपुट टोकन निकले। क्योंकि यह अपनी सोच बंद नहीं कर सकता, काम की जरूरत न होने पर भी बिलिंग चलती रहती है।
दोनों मॉडल हर ऑब्जेक्टिव चेक पर खरे उतरे:
NaN तक नहीं पहुंचता।Opus का सिमुलेशन प्रति टिक 2.3 गुना तेज है। यह एजेंट्स को टाइप्ड ऐरे में स्टोर करता है—हर प्रॉपर्टी के लिए एक फ्लैट ऐरे—और हर प्रजाति के लिए अलग स्पैटियल ग्रिड रखता है। Fable हर एजेंट को अपना ऑब्जेक्ट देता है और तीनों प्रजातियों के लिए एक समान ग्रिड साझा करता है। दोनों सही हैं, पर Opus का डाटा लेआउट तेज है।
Fable की npm test स्क्रिप्ट चलती नहीं। इसने node --test test/ शिप किया, जिसे Node 26 डायरेक्टरी के बजाय मॉड्यूल पाथ समझता है, इसलिए कमांड एक भी टेस्ट चलने से पहले ही मर जाता है। अंदर के 16 टेस्ट ठीक हैं और फाइलें स्पष्ट रूप से नाम देने पर पास हो जाते हैं। package.json में एंट्री पॉइंट टूटा है।
यह छोटा बग है, पर कीमत बड़ी है, क्योंकि पाठक जो एक कमांड सच में टाइप करेगा, वही फेल होता है। Fable ने इसे पकड़ा भी नहीं—और यही अहम है: प्रॉम्प्ट ने टेस्ट मांगे थे, और उसने उन्हें ऐसे रास्ते से वेरिफाई किया जिसे उसके अपने यूज़र नहीं अपनाएंगे।
Opus में ऐसा कोई असफलता नहीं। इसके 58 टेस्ट npm test से चलते और पास होते हैं। दोनों सूट्स वही चीजें टेस्ट करते हैं जो यहां मायने रखती हैं—सीडेड निर्धारकता, ऊर्जा संरक्षण, टोरस रैपिंग, और लंबे समय में प्रजातियों का टिकना—इसलिए अंतर प्रकार में नहीं, गहराई में है। Opus का एकमात्र अतिरिक्त चेक 5000-एजेंट स्ट्रेस टेस्ट है, जो वैसे भी सबसे ज्यादा टूटने वाला रिक्वायरमेंट है।
दोनों ऐप्स एक-दूसरे से बिल्कुल अलग दिखते हैं—और यही काम बदलने की वजह थी।
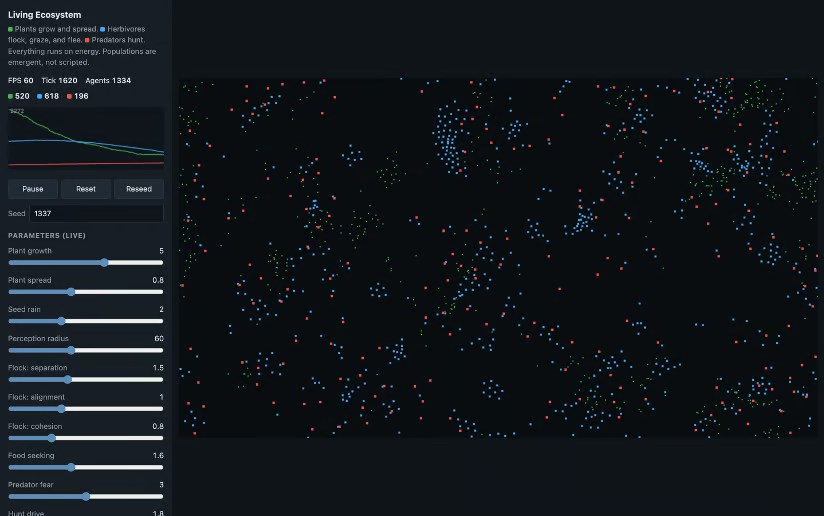
Fable 5: बाईं ओर कंट्रोल्स, एजेंट समतल वर्गों के रूप में, प्रजातियों के नाम Plants, Herbivores, और Predators।
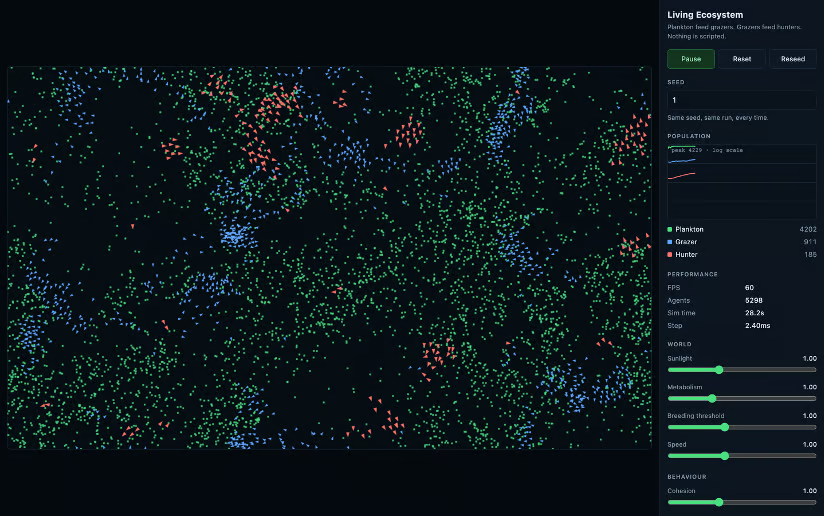
Opus 5: दाईं ओर कंट्रोल्स, एजेंट त्रिभुजों के रूप में जो दिशा दर्शाते हैं, प्रजातियों के नाम Plankton, Grazers, और Hunters।
UI की तरफ, सबसे बड़े अंतर ये हैं:
पॉपुलेशन ग्राफ में डिजाइन का फर्क तीखा हो जाता है।
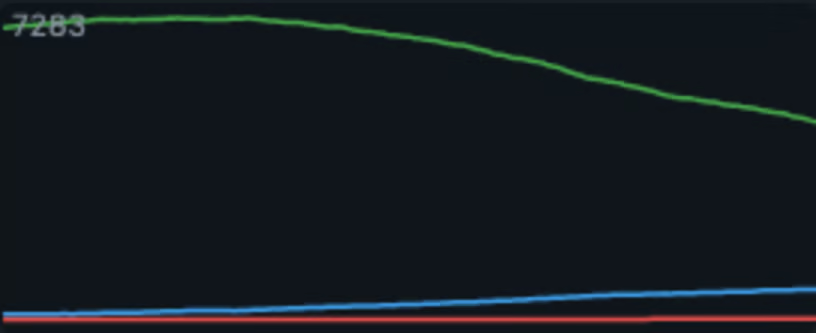
Fable 5 का ग्राफ, रैखिक स्केल। पौधों की रेखा पूरी ऊंचाई लेती है और शिकारी की रेखा नीचे जमी रहती है।
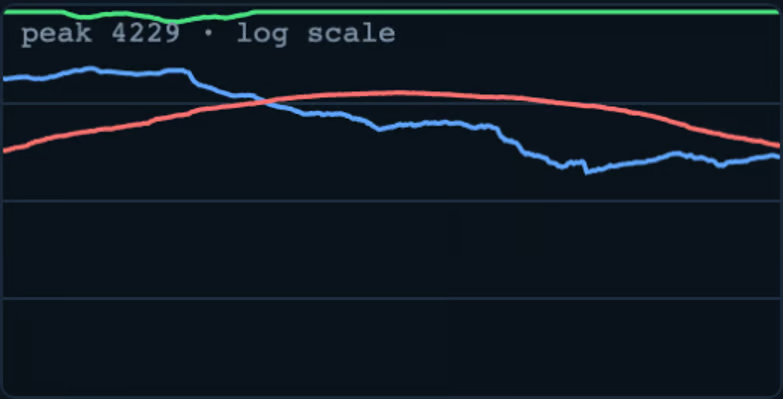
Opus 5 का ग्राफ, लॉग स्केल। तीनों प्रजातियां पढ़ने योग्य रहती हैं, और हंटर की रेखा ग्रेज़र की रेखा को पार करती दिखती है।
दोनों सिमुलेशन एक शिकारी-शिकार प्रणाली की तरह दोलन करते हैं। Fable में 5 मिनट में पौधे 520 से 7,061 तक झूलते हैं, जबकि शाकाहारी और शिकारी उनके पीछे-पीछे चक्र में चलते हैं—शिकारी ठीक उसी समय 248 पर चरम पर पहुंचते हैं जब शाकाहारी 119 पर न्यूनतम होते हैं।
रैखिक स्केल पर, पौधों की रेखा पूरी ऊंचाई निगल जाती है, शाकाहारी पतली पट्टी में सिमटते हैं, और शिकारी अक्ष से चिपके रहते हैं।
यही कारण है कि Opus ने ग्राफ को लॉग स्केल पर रखा और पीक लेबल किया। तीनों प्रजातियां पढ़ने योग्य रहती हैं, और आप देख सकते हैं कैसे हंटर की रेखा ऊपर उठती है, ग्रेज़र को पार करती है, और फिर ग्रेज़र के उबरने पर गिरती है। डेटा की श्रेणी एक ही है, और दोनों में से सिर्फ एक चार्ट पढ़ने योग्य है।
आंतरिक इकोसिस्टम भी अलग हैं। Opus अपने प्रोड्यूसर लेयर को 4,229 प्लवक (plankton) पर कैप करता है, तो वह पॉपुलेशन छत से सटी रहती है और केवल ऊपरी दो प्रजातियां चक्र में चलती हैं। Fable तीनों को युग्मित छोड़ता है, जिससे झूले व्यापक होते हैं और दुनिया ज्यादा जीवंत लगती है। प्रॉम्प्ट में कहे बिना हमें स्थिरता बनाम गतिशीलता का अंतर मिल गया।
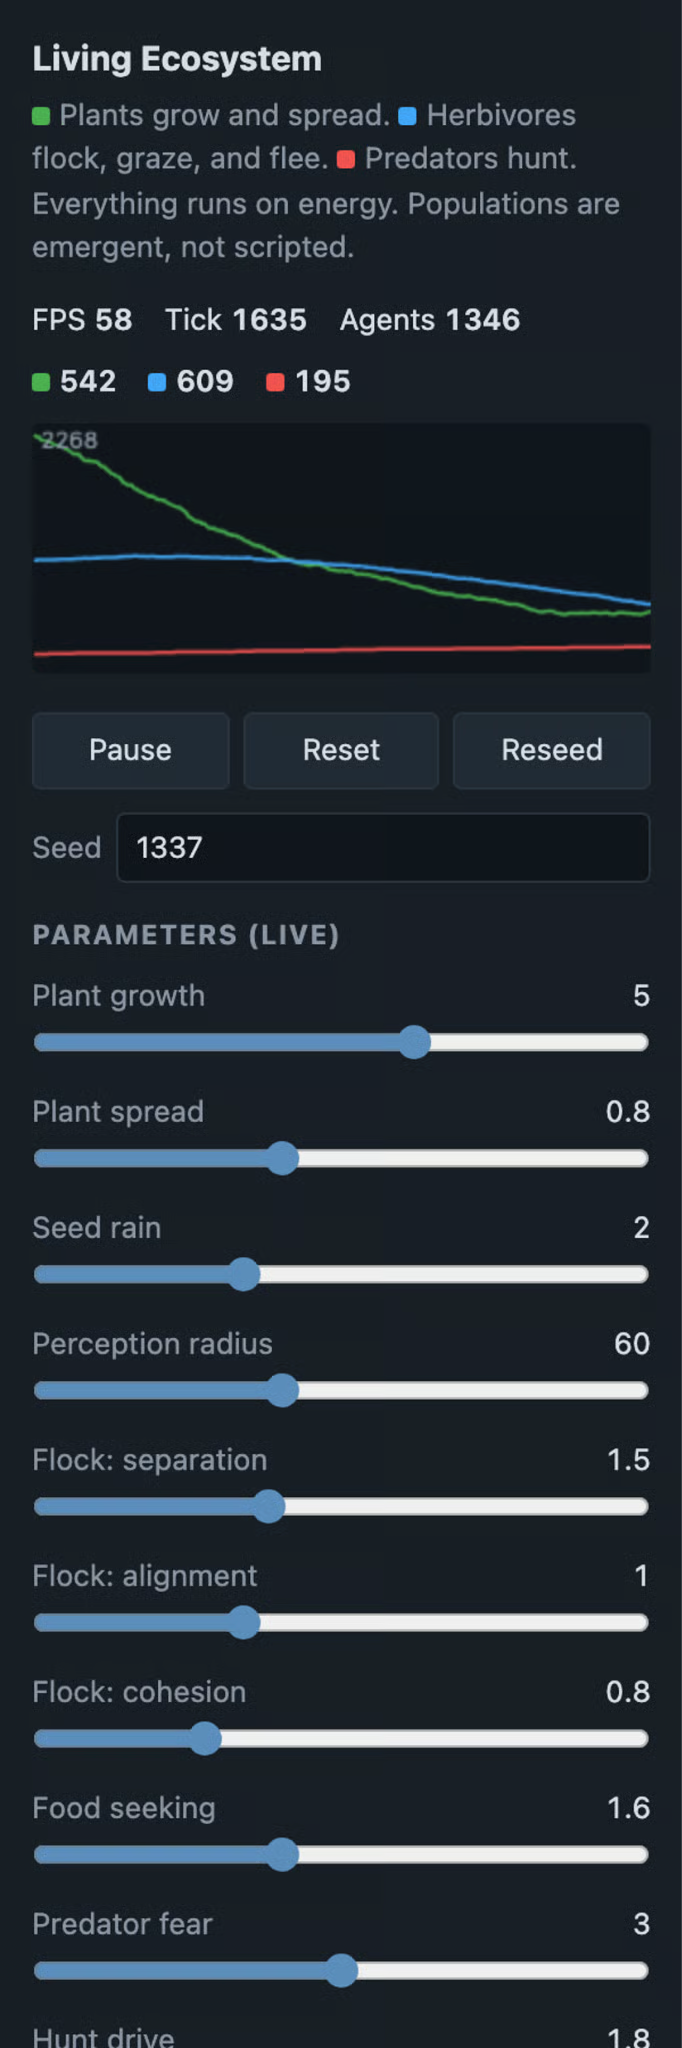
Fable 5 का पैरामीटर पैनल: सिमुलेशन की अपनी इकाइयों में 13 स्लाइडर।
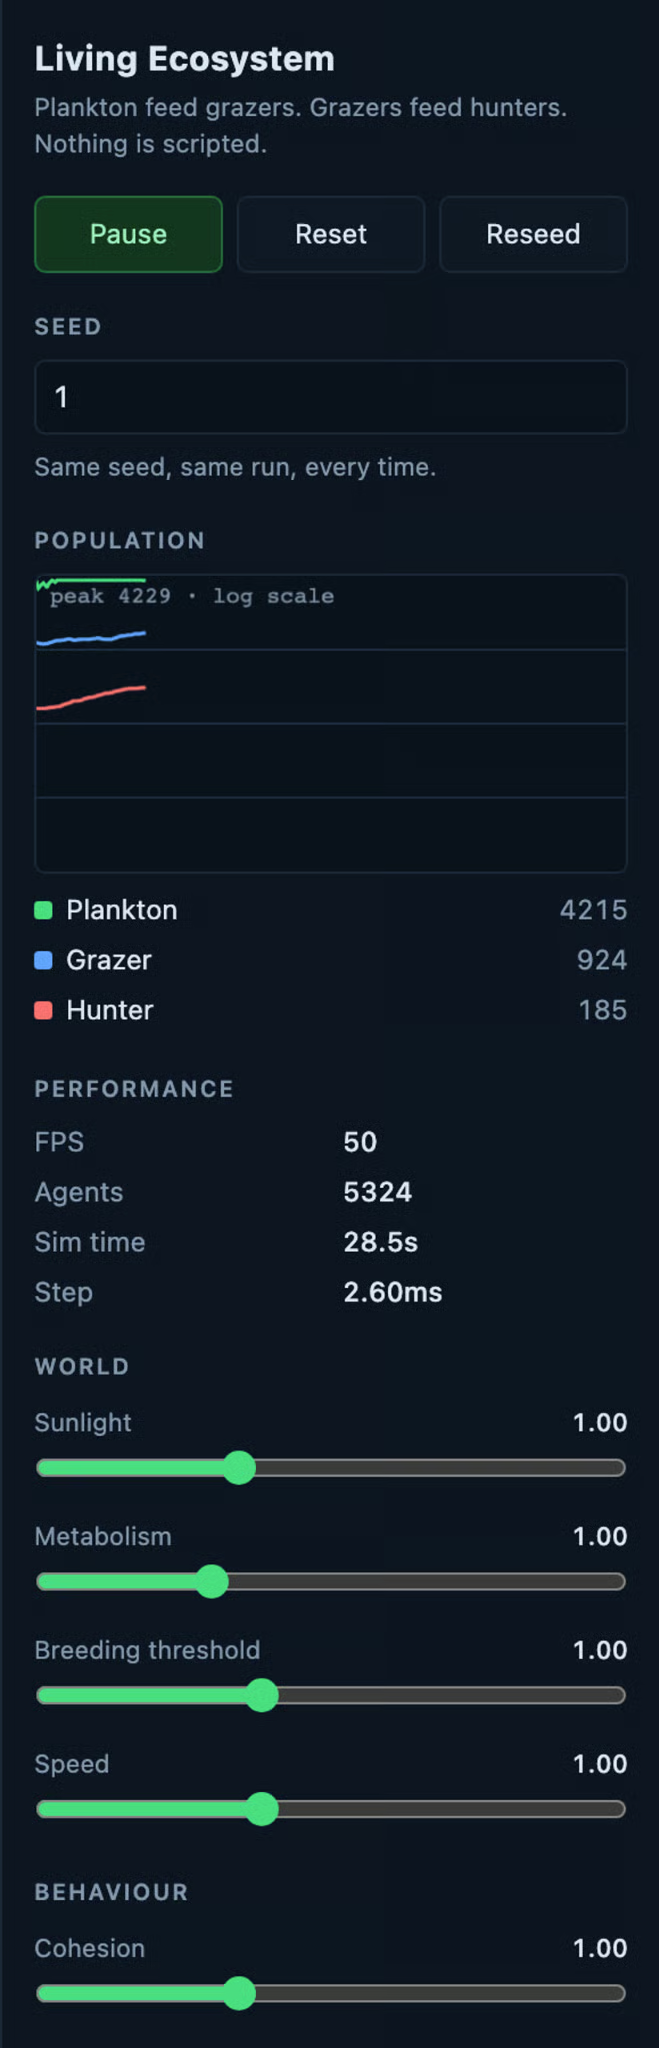
Opus 5 का पैरामीटर पैनल: 9 स्लाइडर, हर एक 1.00 से शुरू होने वाला मल्टीप्लायर, World और Behaviour समूहों में।
Fable वास्तविक इकाइयों में 13 पैरामीटर्स दिखाता है: plant growth 5, perception radius 60, separation 1.5, और प्रति-प्रजाति मेटाबोलिज़्म। Opus 9 दिखाता है—सभी 1.00 से शुरू होने वाले सामान्यीकृत मल्टीप्लायर—World और Behaviour समूहों में बंटे हुए।
एक वाक्य में: Fable आपको ज्यादा नियंत्रण देता है, जबकि Opus ऐसा पैनल देता है जो आपको इकोसिस्टम का संतुलन आसानी से बिगाड़ने नहीं देगा।
डिफॉल्ट के रूप में Opus 5 का उपयोग करें। इस बिल्ड में, इसकी लागत 30% कम आई, इसने 2.3x तेज सिमुलेशन चलाया, और बेहतर टेस्ट कवरेज लिखा। Fable स्पीड पर जीता—करीब आधे समय में खत्म किया।
जब आप एक बार में, न्यूनतम निगरानी के साथ, पूरा बिल्ड चाहते हों—या जब डिपेंडेंसी फुटप्रिंट मायने रखता हो—तब Fable 5 पर जाएं। Fable ने शून्य-डिपेंडेंसी प्रोग्राम शिप किया जो विकल्प से 42% छोटा था, और वहां तक 103 असिस्टेंट टर्न्स में पहुंचा, जबकि Opus में 247 लगे। यह संक्षिप्तता उस काम में सचमुच मायने रखती है जिसे आप बाद में खुद पढ़ने वाले हों।
एक ही प्रोजेक्ट प्रकार के दो बिल्ड अब भी बेंचमार्क नहीं हैं। वास्तविक दुनिया का प्रदर्शन मौजूदा बेंचमार्क्स से अलग काफी बदल सकता है।
उदाहरण के लिए, भले हमारी तुलना में Fable ने Opus से अधिक टोकन उपयोग किए हों, अधिकांश डेवलपर उलटा साझा कर रहे हैं: समान कार्यों पर Opus 5, Fable या Sol की तुलना में काफी अधिक टोकन जला रहा है। शक यह है कि Opus 5 के RL प्री-ट्रेनिंग ने उसे मददगार और संक्षिप्त होने के बजाय टोकन लागत बढ़ाने के लिए ज़्यादा अनुकूलित कर दिया। तुलना के बाहर, मुझे अपने काम में यह अहसास जरूर हुआ है। Opus परिवार के मॉडल सतह पर लगातार ज्यादा वर्बोज़ होते जा रहे हैं और पढ़ने में कठिन।
व्यक्तिगत रूप से, मैं अपने लगभग सभी कोडिंग प्रोजेक्ट्स—क्लाइंट्स के लिए भी—Fable 5 ही इस्तेमाल करता रहूंगा, क्योंकि लंबे समय में यह शुद्धता में जीतता है। मैं नवीनतम Max प्लान पर हूं, और अब तक अपनी उपयोग सीमा नहीं छुई, भले कई सेशन्स में Fable इस्तेमाल करता हूं (हालांकि मैं Claude Code लगातार नहीं चलाता)। जब टोकन बिल मायने रखे, या जब मुझे चल रहे काम पर रनिंग कमेंट्री चाहिए हो, तब मैं Opus का उपयोग करूंगा।
मॉडलों और उनके आसपास के टूलिंग पर अधिक पढ़ने के लिए, हमारा पूरा Claude Fable 5 गाइड पढ़ने की सलाह देता हूं, साथ में Claude Code और Claude Code सर्वोत्तम अभ्यास पर ट्यूटोरियल्स भी देखें।
DataCamp के साथ Claude Code का उपयोग करना सीखें!
कोर्स
कोर्स
कोर्स