Curso
Introducción a los modelos Claude
3 h
14.2K
Fable 5 es un modelo orientado a programación dentro de la familia Claude 5 de Anthropic, lanzado el 9 de junio de 2026. Llegó junto a Mythos 5, un modelo hermano sin clasificadores de seguridad que Anthropic ofreció solo a un pequeño grupo de organizaciones verificadas. Para un repaso completo del lanzamiento y de cómo rinde Fable 5 en benchmarks, consulta nuestra guía dedicada de Fable 5.
Fable 5 está por encima de Opus 5 en precio y apunta a trabajo de programación más complejo. La principal diferencia en el uso es que realiza razonamiento en cada petición y no se puede desactivar, así que se percibe más lento y deliberado. Opus 5 decide por sí mismo si un prompt merece ese razonamiento adicional.
Ambos modelos comparten ventana de contexto y tamaño máximo de salida. Se diferencian en el precio y en cómo funciona el razonamiento.
|
|
Fable 5 |
Opus 5 |
|
Precio de entrada (por 1M de tokens) |
$10 |
$5 |
|
Precio de salida (por 1M de tokens) |
$50 |
$25 |
|
Ventana de contexto |
1M de tokens |
1M de tokens |
|
Salida máxima por solicitud |
128K tokens |
128K tokens |
|
Razonamiento |
Siempre activo (no se puede desactivar) |
Adaptativo (opt-in) |
|
Comportamiento ante negativas |
|
Estándar |
Fable 5 cuesta aproximadamente el doble por token que Opus 5. Como su razonamiento siempre está activo, también suele emitir más tokens por ejecución, así que la brecha de precio en uso real es mayor de lo que sugiere la tarifa por token. En la comparativa que verás más adelante, Fable emitió un 74% más de tokens de salida que Opus para un programa más pequeño.
Para una comparativa en profundidad, incluidos los benchmarks, lee nuestra guía Claude Opus 5 vs Claude Fable 5.
Un aspecto universalmente molesto de Fable 5 es su clasificador de seguridad integrado. Como el modelo se considera demasiado potente, el clasificador no le permite atender solicitudes mínimamente relacionadas con áreas como biología o ciberseguridad.
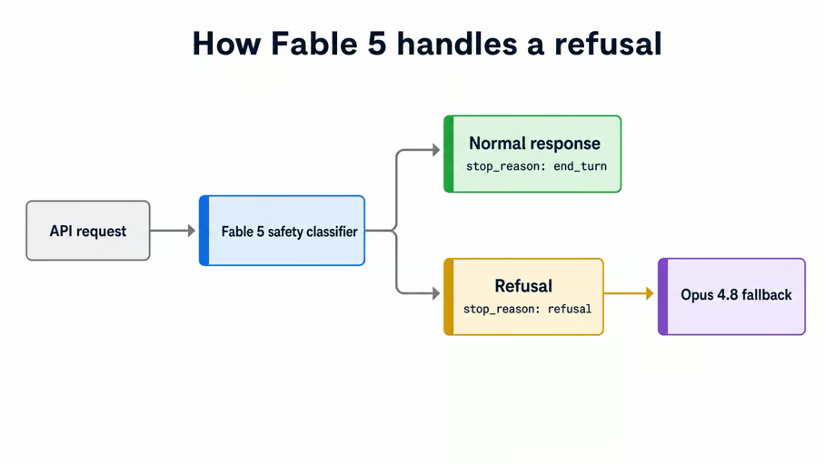
A una inmunóloga, la palabra "cancer" por sí sola le activó el filtro de bioseguridad, haciendo que Claude Code recurriera a Opus 4.8.
A mí me pasó hace poco con un bug de inicio de sesión en un proyecto personal. El flujo usaba la API de Telegram Gateway para OTP y Fable 5 se negó en redondo a tocarlo. Opus 5 resolvió el problema, que es justo la cuestión: ese bug no suponía ningún riesgo de seguridad.
El fallback automático y sin configuración solo ocurre dentro de Claude Code y las apps de Claude. Si estás usando Fable a través de la API, recibirás un campo stop_reason en la respuesta aunque llegue con código 200.
La respuesta tiene este aspecto:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
Así que tienes que comprobar stop_reason antes de tocar el contenido de la respuesta.
Para habilitar el fallback en servidor, pasa un array fallbacks (p. ej., "fallbacks": [{"model": "claude-opus-4-8"}]) y envía la cabecera anthropic-beta: server-side-fallback-2026-06-01. Configúrala en cada petición; no hay interruptor a nivel de cuenta.
Quizá te preguntes por qué algunas fuentes dicen que Fable 5 recurre a Opus 4.8 mientras otras apuntan a Opus 5. Ambas tienen razón, porque el destino depende de la categoría y del entorno.
En Claude Code, una solicitud marcada como biología ahora se reejecuta en Opus 5, mientras que una marcada como ciberseguridad sigue reejecutándose en Opus 4.8. En la API, la función de fallbacks del lado del servidor actualmente solo admite Opus 4.8.
La división es cuestión de tiempos: en el lanzamiento de junio de Fable, todo hacía fallback a Opus 4.8, y más tarde la ruta de biología se redirigió a Opus 5 cuando ese modelo se lanzó el 24 de julio.
Fable 5 tuvo un arranque accidentado, incluso dejando a un lado el clasificador de seguridad.
Días después del lanzamiento, Fortune informó de que Anthropic había debilitado en silencio las respuestas de Fable 5 en alrededor del 0,03% del tráfico de infraestructura de IA y ML sin avisar a nadie.
Muchos investigadores, y también desarrolladores, se enfadaron porque esperaban un modelo de frontera capaz de afrontar cualquier tarea cuando están pagando la suscripción de $200.
Anthropic cedió a la presión de la comunidad en un día, diciendo que "fue una mala decisión". Lo que cambió fue la visibilidad, no el estrangulamiento. Las solicitudes marcadas ahora se muestran igual que una negativa, y la degradación en sí se mantuvo. El argumento de Anthropic es que sus términos ya prohíben usar Claude para construir sistemas de IA competidores, lo cual es defendible. Hacerlo en silencio durante un mes, no.
Luego llegó lo más gordo. Un jailbreak divulgado desencadenó una orden de control de exportaciones de Comercio el 12 de junio, y Anthropic retiró Fable 5 y Mythos 5 en todo el mundo durante 19 días.
Anthropic se opuso con fuerza a la retirada todo el tiempo. Alegó que el jailbreak era acotado y que modelos más débiles también podían encontrarlo, así que el estándar de retirada parecía opaco desde su perspectiva. Tenía un punto razonable sobre el listón en sí. Nadie ha construido jamás un jailbreak universal, y ningún modelo actual supera ese listón. El UK AI Safety Institute ha informado de avances hacia uno, pero nada que realmente funcione.
Aun así, el matiz importa. Los jailbreaks universales sí existen: el UK AI Security Institute afirma haberlos encontrado para todos los sistemas de frontera que ha probado, y sus red-teamers construyeron uno contra el propio Fable 5, en una sola interacción en cuestión de horas y extendido a flujos agentivos multivuelta en días, según la model card de Fable 5.
Lo realmente debatido es si ese listón debe activar una retirada, no si tales jailbreaks son posibles.
Anthropic lanzó un clasificador más estricto y reportó una tasa de bloqueo superior al 99%, y gracias a eso, Comercio levantó las medidas hacia el 30 de junio.
El acceso general volvió el 1 de julio, pero con condiciones más duras. La ventana prometida de dos semanas sin restricciones se quedó en una, y un nuevo tope semanal del 50% implicaba que, una vez superado, el uso adicional de Fable 5 se facturaba como créditos a la tarifa completa de $10 y $50. Suficiente para que los suscriptores protestaran en Reddit.
Anthropic amplió el plazo dos veces y, el 20 de julio, dividió la política por plan: Max y Team Premium mantienen Fable 5 en el 50% de los límites semanales sin fecha de fin, mientras que Pro y Team Standard reciben un crédito único de $100 y luego pagan la tarifa de API. Mythos 5 volvió solo a unas 100 organizaciones estadounidenses verificadas, tras un programa internacional más amplio.
El resultado: Fable 5 es un modelo potente envuelto en una política de acceso que cambia de un mes a otro. Cuenta con negativas falsas ocasionales y no des por sentado que los límites de este mes seguirán el que viene.
Para ver cómo se comportan los dos modelos en condiciones idénticas, le di a cada uno el mismo encargo en una sesión nueva de Claude Code. Después, revisé las transcripciones completas, los JSONL internos y evalué ambas apps terminadas en el navegador.
Mi primer intento de comparativa fue con un acortador de URLs. Error. Ambos modelos produjeron apps casi idénticas, hasta en el tema y las funciones, porque un acortador de URLs tiene una solución obvia presente en los datos de entrenamiento de cualquier modelo. La prueba no medía nada.
Elegí una tarea sin respuesta canónica: una simulación de ecosistema vivo. Tres especies en una red trófica, agentes que se agrupan, cazan y mueren de hambre, 5000 en pantalla a la vez, todo determinista a partir de una semilla. El prompt prohíbe librerías que resuelvan lo difícil, así que cada modelo debe escribir sus propias consultas espaciales, steering y dinámica de poblaciones.
Este fue el prompt que recibieron ambos, palabra por palabra:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
La regla de no hacer preguntas es la clave. Mide hasta dónde llega cada modelo por sí solo, sin nadie que corrija un desvío. Cada uno corrió en su propio directorio vacío sin pista alguna de que el otro tenía la misma tarea.
La tarea también esconde cuatro pruebas objetivas dentro de un resultado aparentemente visual.
Cualquiera de esos fallos se ve en pantalla, que es lo que hace evaluable una demo vistosa.
Ambos builds están en vivo, así que puedes hacer la comparativa tú mismo en lugar de fiarte de mi palabra. Ábrelos en paralelo y vuelve a sembrar en cada uno:
Más abajo tienes capturas de ambos, por si prefieres leer antes que clicar. Aviso: están alejadas para que quepa toda la pantalla, así que quizá no se vea cada detalle con total nitidez.
Antes de los resultados, una nota metodológica importante para interpretarlos.
Claude Code puede recurrir a Opus cuando el clasificador de Fable 5 rechaza una solicitud, así que una ejecución etiquetada como Fable no garantiza que todo sea Fable. En lugar de suponer, registré el campo model en cada evento del asistente en ambas transcripciones.
Por suerte, en mi comparativa, todos los eventos del run de Fable devolvieron claude-fable-5, los 103. Y todos los del run de Opus devolvieron claude-opus-5, los 247. No hubo fallback en ningún sentido. Los números de abajo describen a los modelos de la etiqueta.
Fable trabajó en silencio. Ejecutó 56 llamadas a herramientas e imprimió 429 palabras de comentarios en todo el build, en 2 bloques de texto.
Opus trabajó a la vista. Ejecutó 137 llamadas, más del doble, e imprimió 4.808 palabras en 110 bloques. Ajustaron a un ritmo similar si consideras el volumen, cerca de 2 ediciones por archivo escrito.
También se separaron en tooling. Fable envió módulos ES simples con un script de arranque python3 -m http.server y sin node_modules. Opus instaló Vite y Vitest y construyó con una toolchain real.
Los tiempos de build de abajo miden solo trabajo activo. Tomé cada ejecución desde su primer evento del asistente hasta el último y resté cualquier tramo inactivo en el que la sesión estuvo esperando en lugar de construyendo.
|
Dimensión |
Fable 5 |
Opus 5 |
|
Eventos del asistente |
103 |
247 |
|
Tiempo activo de build |
25 min |
48 min |
|
Tokens de salida |
243.442 |
139.920 |
|
Lecturas de caché |
11,3M |
26,4M |
|
Llamadas a herramientas |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
Texto visible impreso |
429 palabras (2 bloques) |
4.808 palabras (110 bloques) |
|
Coste total |
$28,70 |
$20,07 |
|
Ficheros entregados |
9, cero dependencias |
13, Vite + Vitest |
|
Líneas de código |
~1.010 |
~1.746 |
|
Tests |
16, todos pasan |
58, todos pasan |
|
|
No |
Sí |
|
Velocidad de la simulación |
3,14 ms/tick con 3.510 agentes |
1,35 ms/tick con 4.368 agentes |
|
Publicado en GitHub |
Sí |
Sí |
Fable costó un 43% más y generó un 74% más de tokens de salida para un programa más pequeño. Como no puede desactivar su razonamiento, sigue facturando aunque el trabajo no lo requiera.
Ambos modelos superaron todas las comprobaciones objetivas:
NaN.La simulación de Opus es 2,3 veces más rápida por tick. Almacena los agentes en arrays tipados, un array plano por propiedad, y mantiene una rejilla espacial separada por especie. Fable da a cada agente su propio objeto y comparte una única rejilla uniforme para las tres especies. Ambos son correctos, pero el layout de datos de Opus es más rápido.
El script npm test de Fable no se ejecuta. Entregó node --test test/, que Node 26 interpreta como ruta de módulo en lugar de directorio, así que el comando muere antes de ejecutar un solo test. Los 16 tests por debajo están bien y pasan cuando nombras los ficheros explícitamente. El entry point en package.json está roto.
Es un bug pequeño con un coste grande, porque el único comando que de verdad tecleará quien lea el proyecto es el que falla. Y Fable nunca lo detectó, que es lo que importa: el prompt pedía tests y los verificó por una ruta que sus propios usuarios no usarán.
Opus no tiene un fallo equivalente. Sus 58 tests se ejecutan con npm test y pasan. Ambos conjuntos prueban lo importante aquí: determinismo con semilla, conservación de energía, wrapping en toro y supervivencia de especies a largo plazo, así que la diferencia es de profundidad, no de tipo. La única comprobación que solo escribió Opus es la de estrés con 5000 agentes, también el requisito con más papeletas de romperse.
Las dos apps no se parecen en nada, que era justo el motivo de cambiar la tarea.
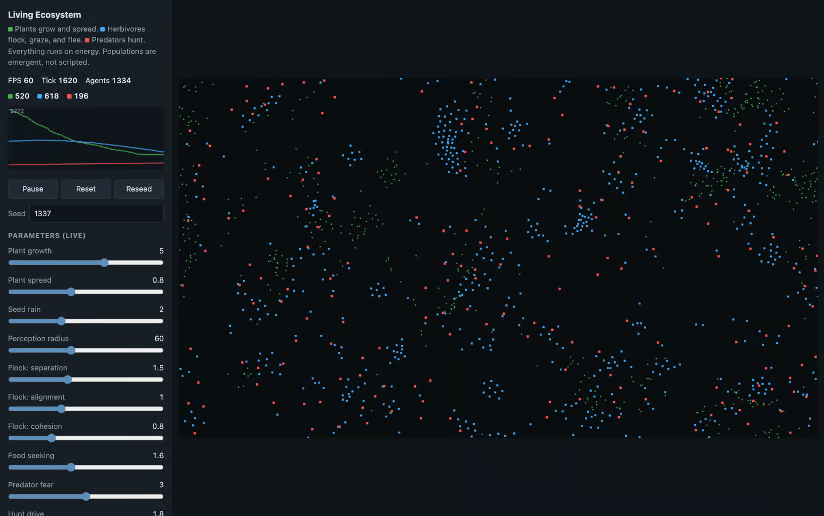
Fable 5: controles a la izquierda, agentes como cuadrados planos, especies llamadas Plants, Herbivores y Predators.
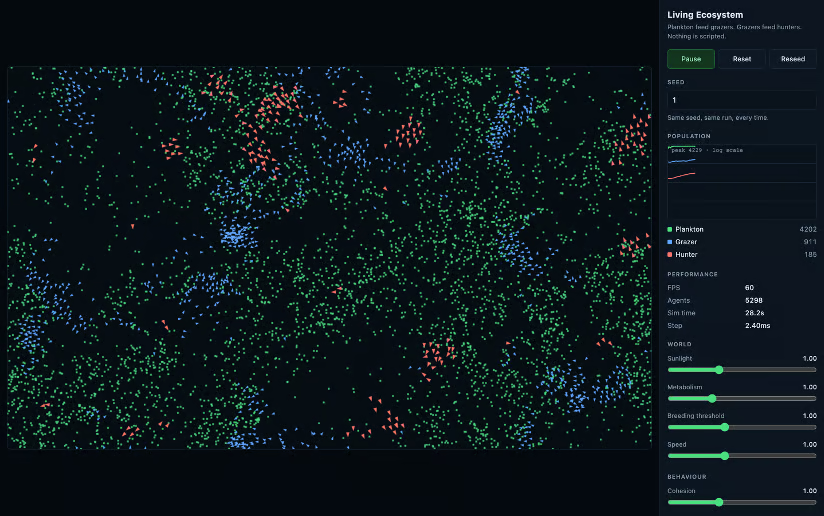
Opus 5: controles a la derecha, agentes como triángulos que apuntan a donde se dirigen, especies llamadas Plankton, Grazers y Hunters.
En la parte de UI, estas son las mayores diferencias:
En los gráficos de población es donde la diferencia de diseño se acentúa.
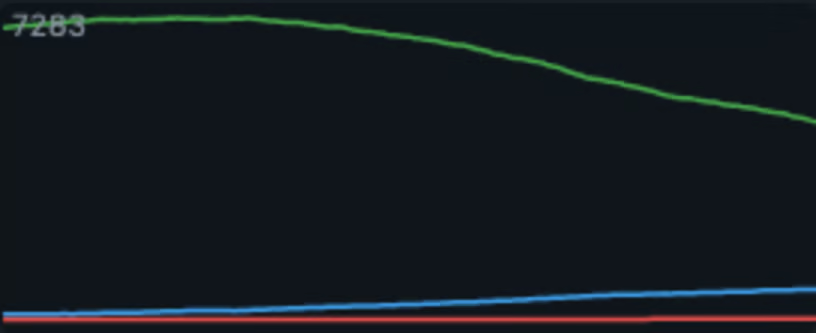
Gráfico de Fable 5, escala lineal. La línea de plantas ocupa toda la altura y la de depredadores queda pegada al eje.
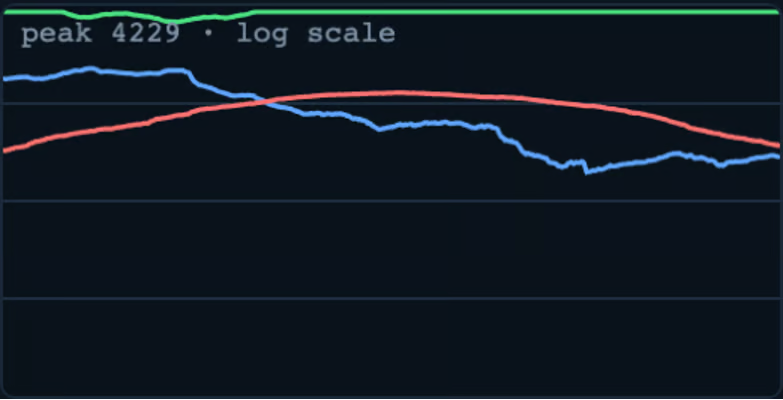
Gráfico de Opus 5, escala logarítmica. Las tres especies se leen bien y la línea de cazadores cruza la de herbívoros.
Ambas simulaciones oscilan como debe hacerlo un sistema depredador-presa. En Fable, las plantas van de 520 a 7.061 en 5 minutos, mientras herbívoros y depredadores ciclan detrás, con depredadores alcanzando 248 justo cuando los herbívoros tocan fondo en 119.
En escala lineal, la línea de plantas se come todo el rango vertical, los herbívoros se comprimen y los depredadores quedan pegados al eje.
Por eso Opus puso el gráfico en escala log y marcó el pico. Las tres especies siguen siendo legibles, y puedes ver la línea de cazadores subir, cruzar la de herbívoros y bajar cuando los herbívoros se recuperan. Mismo tipo de dato, y solo uno de los dos gráficos se lee bien.
Los ecosistemas subyacentes también difieren. Opus limita su capa de productores a 4.229 plancton, así que esa población queda clavada en el techo y solo ciclan las dos especies superiores. Fable deja las tres acopladas, lo que da oscilaciones más amplias y un mundo más vivo. Obtuvimos estabilidad frente a dinamismo sin pedirlo en el prompt.
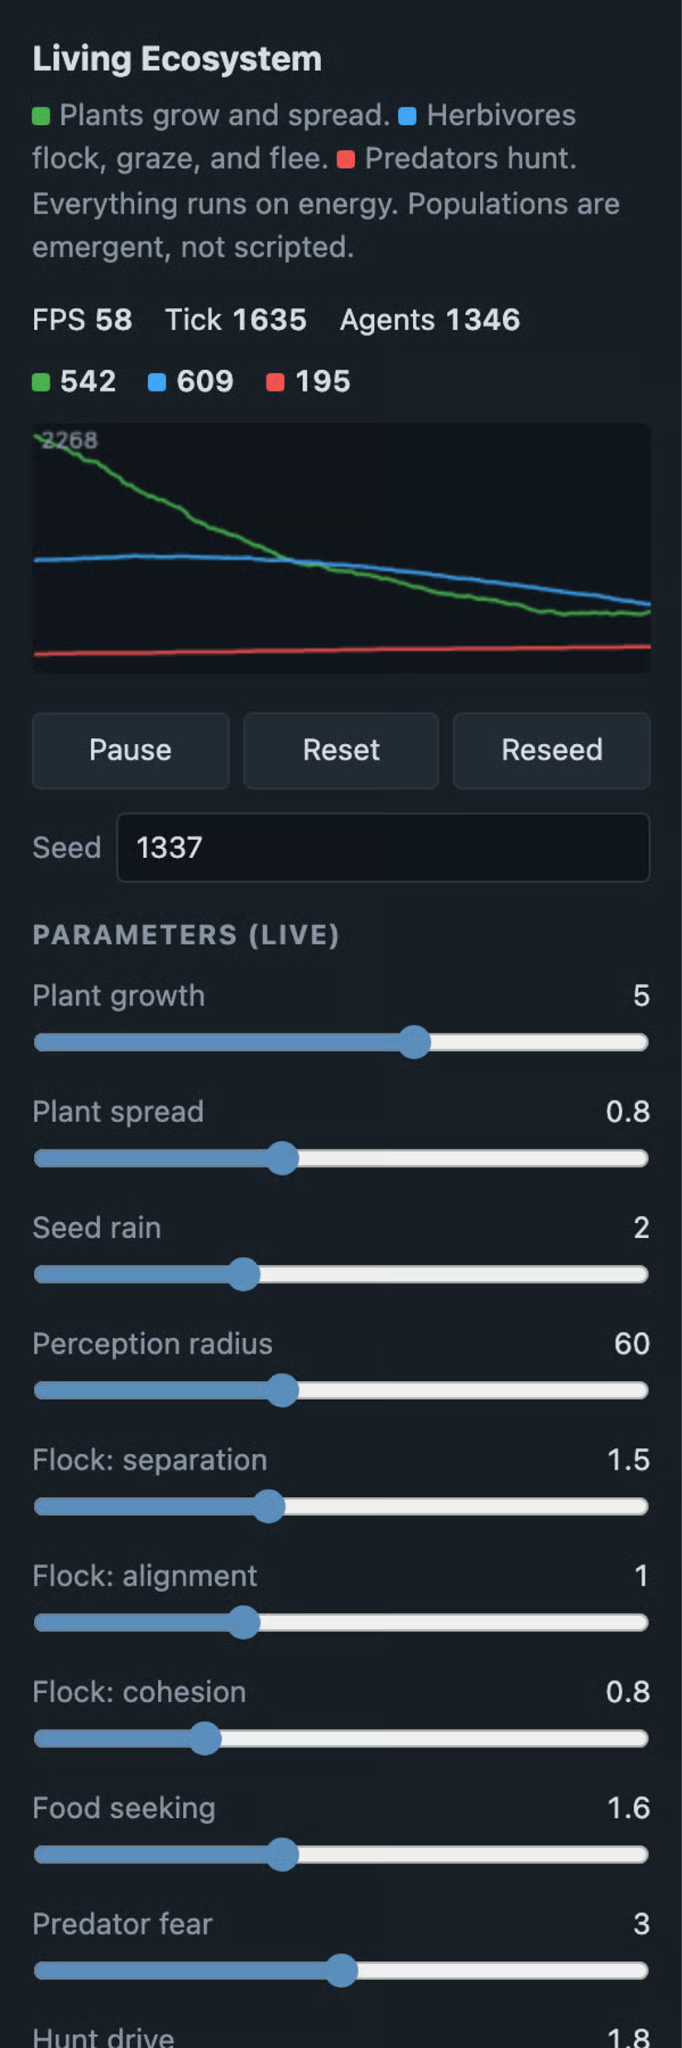
Panel de parámetros de Fable 5: 13 deslizadores en las propias unidades de la simulación.
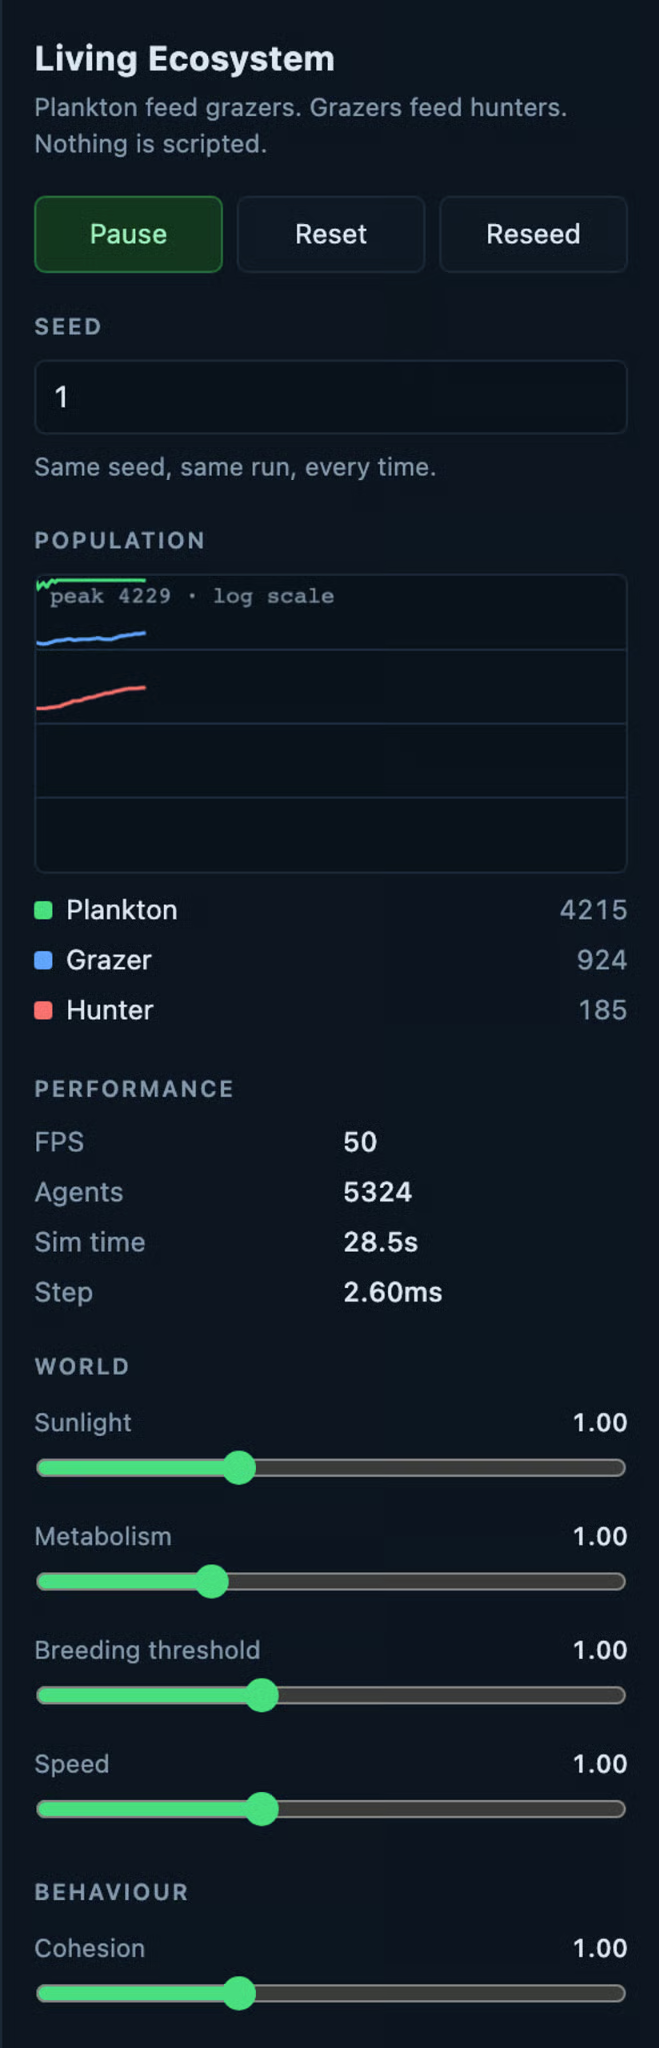
Panel de parámetros de Opus 5: 9 deslizadores, cada uno un multiplicador que parte de 1,00, agrupados en World y Behaviour.
Fable expone 13 parámetros en unidades reales: crecimiento de plantas 5, radio de percepción 60, separación 1,5 y metabolismo por especie. Opus expone 9, todos como multiplicadores normalizados que empiezan en 1,00, divididos en grupos de World y Behaviour.
En una frase: Fable te da más control, mientras que Opus te ofrece un panel con el que es difícil romper el equilibrio del ecosistema.
Usa Opus 5 por defecto. En este build, costó un 30% menos, ejecutó una simulación 2,3 veces más rápida y escribió mejores tests. Fable ganó en velocidad de entrega, terminando en la mitad de tiempo.
Pasa a Fable 5 cuando quieras terminar un build de una pasada con mínima supervisión o cuando importe la huella de dependencias. Fable entregó un programa sin dependencias un 42% más pequeño que la alternativa, y llegó con 103 turnos del asistente frente a 247. Esa concisión vale mucho cuando planeas leer el código después.
Dos builds de un solo tipo de proyecto no son aún un benchmark. El rendimiento real puede variar mucho pese a lo que digan los benchmarks existentes.
Por ejemplo, aunque aquí Fable usó más tokens que Opus, la mayoría de desarrolladores comparten lo contrario: Opus 5 quemando bastantes más tokens que Fable o Sol en tareas similares. La sospecha es que el preentrenamiento RL de Opus 5 lo optimizó en exceso para inflar tokens en vez de ser útil y conciso. Fuera de esta comparativa, yo también lo he notado. Los modelos Opus cada vez son más verbosos en la superficie y más difíciles de leer.
En lo personal, seguiré usando Fable 5 para casi todos mis proyectos de código, también con clientes, porque a la larga gana en precisión. Estoy en el plan Max más reciente y aún no he tocado mis límites, incluso usando Fable en varias sesiones (aunque no tengo Claude Code funcionando sin parar). Usaré Opus cuando la factura de tokens importe o cuando quiera un comentario continuo de la tarea para entenderla mejor.
Para saber más sobre los modelos y el tooling a su alrededor, te recomiendo leer nuestra guía de Claude Fable 5, junto con los tutoriales de Claude Code y buenas prácticas de Claude Code.
¡Aprende a usar Claude Code con DataCamp!
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
10 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
15 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Arunn Thevapalan
13 min