Curso
Introdução aos modelos Claude
3 h
14.3K
O Fable 5 é um modelo focado em programação da família Claude 5 da Anthropic, lançado em 9 de junho de 2026. Ele chegou junto com o Mythos 5, um modelo-irmão sem classificadores de segurança, oferecido pela Anthropic apenas a um pequeno conjunto de organizações avaliadas. Para um detalhamento completo do lançamento e de como o Fable 5 se sai nos benchmarks, confira nosso guia dedicado do Fable 5.
O Fable 5 fica acima do Opus 5 em preço e mira trabalhos de código mais difíceis. A principal diferença na prática é que ele roda raciocínio em toda solicitação e não dá para desligar, então parece mais lento e deliberado. O Opus 5 decide sozinho se um prompt merece o raciocínio extra.
Os dois modelos têm a mesma janela de contexto e o mesmo tamanho máximo de saída. Eles diferem no preço e em como o raciocínio funciona.
|
|
Fable 5 |
Opus 5 |
|
Preço de entrada (por 1M de tokens) |
$10 |
$5 |
|
Preço de saída (por 1M de tokens) |
$50 |
$25 |
|
Janela de contexto |
1M de tokens |
1M de tokens |
|
Saída máxima por solicitação |
128K tokens |
128K tokens |
|
Raciocínio |
Sempre ativo (não pode desativar) |
Adaptativo (opt-in) |
|
Comportamento de recusa |
|
Padrão |
O Fable 5 custa cerca do dobro por token em relação ao Opus 5. Como seu raciocínio está sempre ativo, uma única execução também tende a emitir mais tokens, então a diferença de preço no uso real é maior do que a tarifa por token sugere. No confronto direto mais adiante neste guia, o Fable emitiu 74% mais tokens de saída do que o Opus para um programa menor.
Para uma comparação profunda, incluindo diferenças em benchmarks, leia nosso guia Claude Opus 5 vs Claude Fable 5.
Um ponto universalmente irritante do Fable 5 é seu classificador de segurança embutido. Como o modelo é considerado poderoso demais, o classificador não deixa ele lidar com solicitações minimamente relacionadas a áreas como biologia ou cibersegurança.
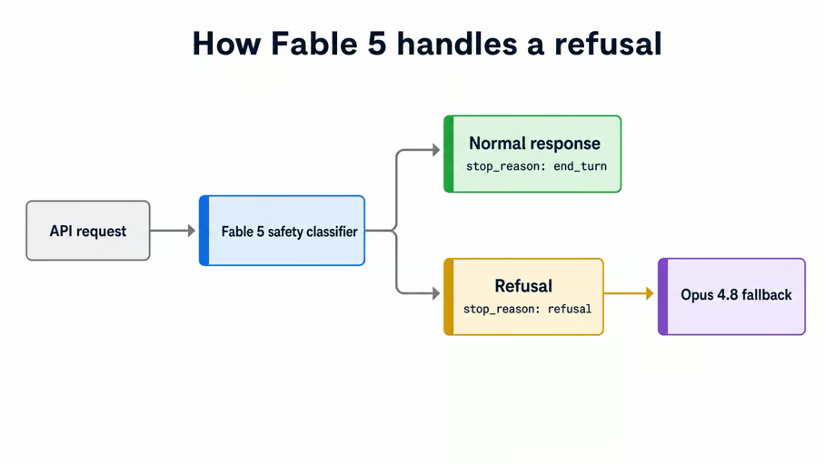
Para um imunologista, a palavra \"cancer\" sozinha acionou um filtro de biossegurança, fazendo o Claude Code recorrer ao Opus 4.8.
Eu mesmo esbarrei nisso recentemente com um bug de login em um projeto pessoal. O fluxo usava a API do Telegram Gateway para login por OTP, e o Fable 5 simplesmente se recusou a tocar nele. O Opus 5 resolveu o problema, o que é justamente a questão: nada naquele bug era um risco de segurança.
O fallback automático, sem configuração, só acontece dentro do Claude Code e dos apps do Claude. Se você estiver usando o Fable pela API, receberá um campo stop_reason na resposta mesmo com código 200 de sucesso.
A resposta é assim:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
Então você precisa checar stop_reason antes de usar o conteúdo da resposta.
Para habilitar o fallback no servidor, passe um array fallbacks (por exemplo, \"fallbacks\": [{\"model\": \"claude-opus-4-8\"}]) e envie o header anthropic-beta: server-side-fallback-2026-06-01. Defina isso em toda solicitação; não há uma chave em nível de conta.
Você pode se perguntar por que algumas fontes dizem que o Fable 5 cai para o Opus 4.8 enquanto outras apontam para o Opus 5. As duas estão certas, porque o destino depende da categoria e da superfície.
No Claude Code, uma solicitação marcada como biologia agora é reexecutada no Opus 5, enquanto uma marcada como cibersegurança ainda é reexecutada no Opus 4.8. Na API, o recurso de fallbacks no servidor atualmente dá suporte apenas ao Opus 4.8.
A divisão é um efeito de timing: no lançamento do Fable, em junho, tudo fazia fallback para o Opus 4.8, e o caminho de biologia foi redirecionado depois para o Opus 5 quando esse modelo foi lançado, em 24 de julho.
O Fable 5 teve um começo turbulento, mesmo deixando de lado o classificador de segurança.
Dias após o lançamento, a Fortune noticiou que a Anthropic havia enfraquecido silenciosamente as respostas do Fable 5 em cerca de 0,03% do tráfego de infraestrutura de IA e ML sem avisar ninguém.
Muitos pesquisadores — e desenvolvedores também — ficaram furiosos porque esperavam um modelo de fronteira para trabalho pesado, capaz de encarar qualquer tarefa, já que estão pagando a assinatura de $200 por ele.
A Anthropic cedeu à pressão da comunidade em um dia, dizendo que \"fez a troca errada\". O que mudou foi a visibilidade, não o estrangulamento. Solicitações sinalizadas agora aparecem do mesmo jeito que uma recusa, e a degradação em si permaneceu. O argumento da Anthropic é que seus termos já proíbem usar o Claude para construir sistemas de IA concorrentes, o que é defensável. Fazer isso silenciosamente por um mês não foi.
Aí veio a maior. Um jailbreak divulgado acionou uma ordem de controle de exportação do Departamento de Comércio em 12 de junho, e a Anthropic tirou do ar mundialmente o Fable 5 e o Mythos 5 por 19 dias.
A Anthropic contestou fortemente o recall o tempo todo. Argumentou que o jailbreak era estreito, não universal, e podia ser encontrado também por modelos mais fracos, então o padrão de recall parecia opaco do ponto de vista dela. Havia um ponto justo sobre a barra em si. Ninguém jamais construiu um jailbreak universal, e nenhum modelo hoje atinge esse padrão. O UK AI Safety Institute relatou progressos rumo a um, mas nada que realmente funcione.
Havia um ponto justo sobre a barra em si, mas não sobre a forma como isso foi colocado. Jailbreaks universais existem: o UK AI Security Institute relata encontrá-los para todos os sistemas de fronteira que testou, e seus red-teamers criaram um contra o próprio Fable 5, em uma única rodada em poucas horas, estendido a fluxos de trabalho multi-rodada com agentes em dias, segundo o model card do Fable 5.
O que está realmente em disputa é se essa barra deveria acionar um recall, não se tais jailbreaks são possíveis.
A Anthropic lançou um classificador mais forte e reportou taxa de bloqueio acima de 99% e, com base nisso, o Departamento de Comércio suspendeu os controles por volta de 30 de junho.
O acesso geral voltou em 1º de julho, mas com termos mais rígidos. A janela prometida de duas semanas sem restrições encolheu para cerca de uma, e um novo teto semanal de 50% significava que, ao ultrapassá-lo, mais uso do Fable 5 era cobrado como créditos às tarifas cheias de $10 e $50. Foi o suficiente para deixar assinantes reclamando no Reddit.
A Anthropic prorrogou o prazo duas vezes e depois dividiu a política por plano em 20 de julho: Max e Team Premium mantêm o Fable 5 em 50% dos limites semanais sem data para acabar, enquanto Pro e Team Standard recebem um crédito único de $100 e passam a pagar a tarifa da API depois disso. O Mythos 5 voltou apenas para cerca de 100 organizações avaliadas nos EUA, abaixo de um programa internacional mais amplo.
Tudo isso deixa o Fable 5 como um modelo forte envolto por uma política de acesso que muda de mês em mês. Planeje lidar com recusas indevidas de vez em quando e não conte que os limites de taxa deste mês continuem iguais no próximo.
Para ver como os dois modelos se comportam nas mesmas condições, dei a cada um o mesmo trabalho em uma sessão nova do Claude Code. Depois, li as transcrições completas das sessões, os arquivos JSONL internos e avaliei os dois apps prontos no navegador.
Minha primeira tentativa dessa comparação usou um encurtador de URLs. Foi um erro. Ambos os modelos produziram apps quase idênticos, até o tema e o conjunto de recursos, porque um encurtador de URLs tem uma resposta óbvia presente nos dados de treino de qualquer modelo. O teste não mediu nada.
Então escolhi uma tarefa sem resposta canônica: uma simulação de ecossistema vivo. Três espécies em uma teia alimentar, agentes que se agrupam, caçam e morrem de fome, 5000 deles na tela ao mesmo tempo, tudo determinístico a partir de uma semente. O prompt proíbe bibliotecas que resolveriam as partes difíceis, então cada modelo precisa escrever suas próprias consultas espaciais, steering e dinâmica populacional.
Aqui está o prompt que os dois modelos receberam, palavra por palavra:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
A regra de não fazer perguntas é o ponto central. Ela mostra até onde cada modelo leva um build sozinho, sem ninguém por perto para corrigir uma virada errada. Cada um rodou em seu próprio diretório vazio, sem pista de que um segundo modelo tinha a mesma tarefa.
A tarefa também esconde quatro testes objetivos dentro de uma saída que parece puramente visual.
Cada uma dessas falhas é visível na tela, o que torna um demo bonito avaliável.
Ambos os builds estão no ar, então você pode rodar esta comparação por conta própria, em vez de apenas acreditar em mim. Abra lado a lado e gere novas sementes em cada um:
As capturas de tela de ambos estão mais abaixo, caso você prefira ler a clicar. Mas um aviso justo: as imagens estão com zoom reduzido para caber a tela inteira, então os detalhes podem não estar cristalinos.
Antes dos resultados, uma nota metodológica que importa para a leitura.
O Claude Code pode recorrer ao Opus quando o classificador de segurança do Fable 5 recusa uma solicitação, então uma execução rotulada como Fable não é garantidamente 100% Fable. Em vez de supor, registrei o campo model em todo evento do assistente nas duas transcrições.
Felizmente, na minha comparação, todo evento na execução do Fable voltou como claude-fable-5, todos os 103. Todo evento na execução do Opus voltou como claude-opus-5, todos os 247. Não houve fallback em nenhuma direção. Os números abaixo descrevem os modelos do rótulo.
O Fable trabalhou em silêncio. Executou 56 chamadas de ferramenta e imprimiu 429 palavras de comentários ao longo do build inteiro, em 2 blocos de texto.
O Opus trabalhou às claras. Executou 137 chamadas de ferramenta, mais que o dobro, e imprimiu 4.808 palavras em 110 blocos. Ambos revisaram em ritmo similar quando você considera o volume, perto de 2 edições por arquivo escrito.
Eles também divergiram no ferramental. O Fable entregou ES modules puros com um script de início python3 -m http.server e sem node_modules nenhum. O Opus instalou Vite e Vitest e compilou com uma toolchain de verdade.
Os tempos de build abaixo medem apenas o trabalho ativo. Peguei cada execução do primeiro evento do assistente ao último e subtraí qualquer período ocioso em que a sessão ficou esperando em vez de construindo.
|
Dimensão |
Fable 5 |
Opus 5 |
|
Eventos do assistente |
103 |
247 |
|
Tempo ativo de build |
25 min |
48 min |
|
Tokens de saída |
243.442 |
139.920 |
|
Leituras de cache |
11,3M |
26,4M |
|
Chamadas de ferramenta |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
Texto visível impresso |
429 palavras (2 blocos) |
4.808 palavras (110 blocos) |
|
Custo total |
$28,70 |
$20,07 |
|
Arquivos entregues |
9, zero dependências |
13, Vite + Vitest |
|
Linhas de código |
~1.010 |
~1.746 |
|
Testes |
16, todos passam |
58, todos passam |
|
|
Não |
Sim |
|
Velocidade da simulação |
3,14 ms/tick com 3.510 agentes |
1,35 ms/tick com 4.368 agentes |
|
Enviado ao GitHub |
Sim |
Sim |
O Fable custou 43% a mais e produziu 74% mais tokens de saída para um programa menor. Como ele não consegue desligar o raciocínio, continua cobrando mesmo quando o trabalho não precisa disso.
Ambos os modelos passaram em todos os cheques objetivos:
NaN.A simulação do Opus é 2,3x mais rápida por tick. Ele armazena agentes em typed arrays, um array plano por propriedade, e mantém uma grade espacial separada por espécie. O Fable dá a cada agente seu próprio objeto e compartilha uma grade uniforme entre as três espécies. Ambos estão corretos, mas o layout de dados do Opus é mais rápido.
O script npm test do Fable não roda. Ele entregou node --test test/, que o Node 26 resolve como caminho de módulo e não diretório, então o comando morre antes de executar um teste sequer. Os 16 testes abaixo estão ok e passam quando você nomeia os arquivos explicitamente. O entry point no package.json é que está quebrado.
É um bug pequeno com custo desproporcional, porque o único comando que o leitor realmente vai digitar é o que falha. O Fable também nunca detectou isso, que é o que importa: o prompt pediu testes e os verificou por uma rota que seus próprios usuários não vão usar.
O Opus não tem falha equivalente. Seus 58 testes rodam a partir do npm test e passam. As duas suítes testam o que importa aqui: determinismo com semente, conservação de energia, envolvimento toroidal e sobrevivência de espécies no longo prazo, então a diferença é de profundidade, não de natureza. A única verificação que só o Opus escreveu é o teste de estresse com 5000 agentes, que também é o requisito mais propenso a quebrar.
Os dois apps não se parecem em nada, que é justamente o motivo de mudar a tarefa.
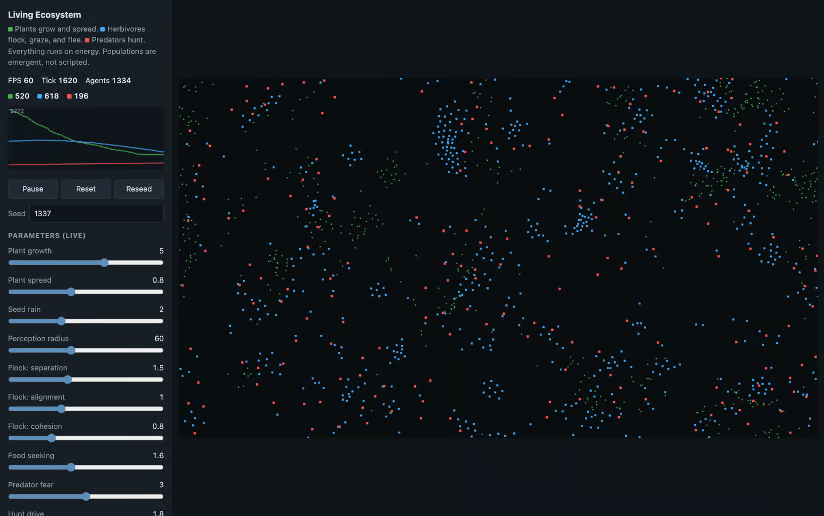
Fable 5: controles à esquerda, agentes como quadrados planos, espécies chamadas Plants, Herbivores e Predators.
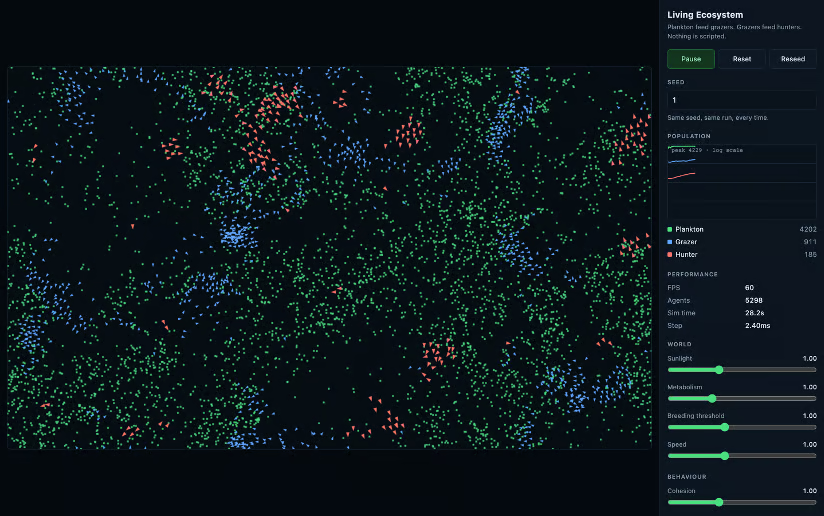
Opus 5: controles à direita, agentes como triângulos que apontam para onde estão indo, espécies chamadas Plankton, Grazers e Hunters.
No lado de UI, estas são as maiores diferenças:
Os gráficos de população são onde a diferença de design fica nítida.
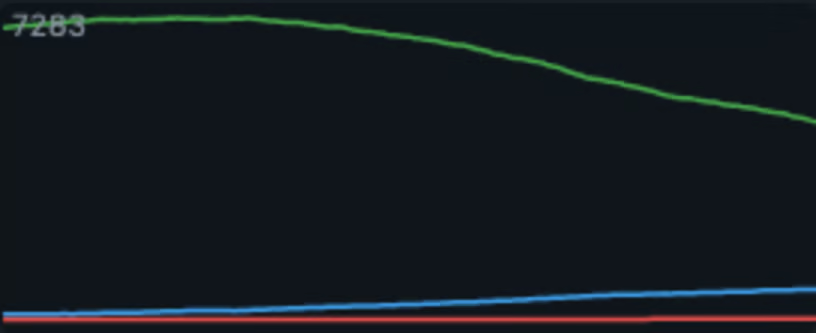
Gráfico do Fable 5, escala linear. A linha de plantas ocupa toda a altura e a de predadores fica colada no eixo inferior.
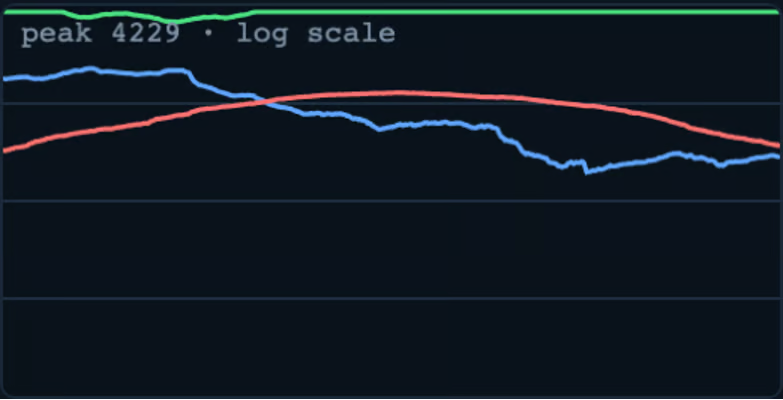
Gráfico do Opus 5, escala logarítmica. As três espécies permanecem legíveis, e a linha dos caçadores cruza a dos pastadores.
Ambas as simulações oscilam como um sistema predador-presa deve. As plantas do Fable variam entre 520 e 7.061 ao longo de 5 minutos, enquanto herbívoros e predadores ciclam atrás delas, com predadores atingindo 248 exatamente quando herbívoros chegam ao mínimo de 119.
Em escala linear, a linha de plantas ocupa todo o alcance vertical, herbívoros comprimem para uma faixa fina e predadores ficam colados no eixo.
É por isso que o Opus colocou seu gráfico em escala log e marcou o pico. As três espécies permanecem legíveis, e você consegue ver a linha dos caçadores subir, cruzar a dos pastadores e cair enquanto os pastadores se recuperam. Mesma classe de dados, e só um dos dois gráficos é legível.
Os ecossistemas subjacentes também diferem. O Opus limita sua camada de produtores a 4.229 plânctons, então essa população bate no teto e apenas as duas camadas superiores ciclam. O Fable mantém as três acopladas, o que dá oscilações maiores e um mundo mais vivo. Tivemos estabilidade versus dinamismo sem pedir isso no prompt.
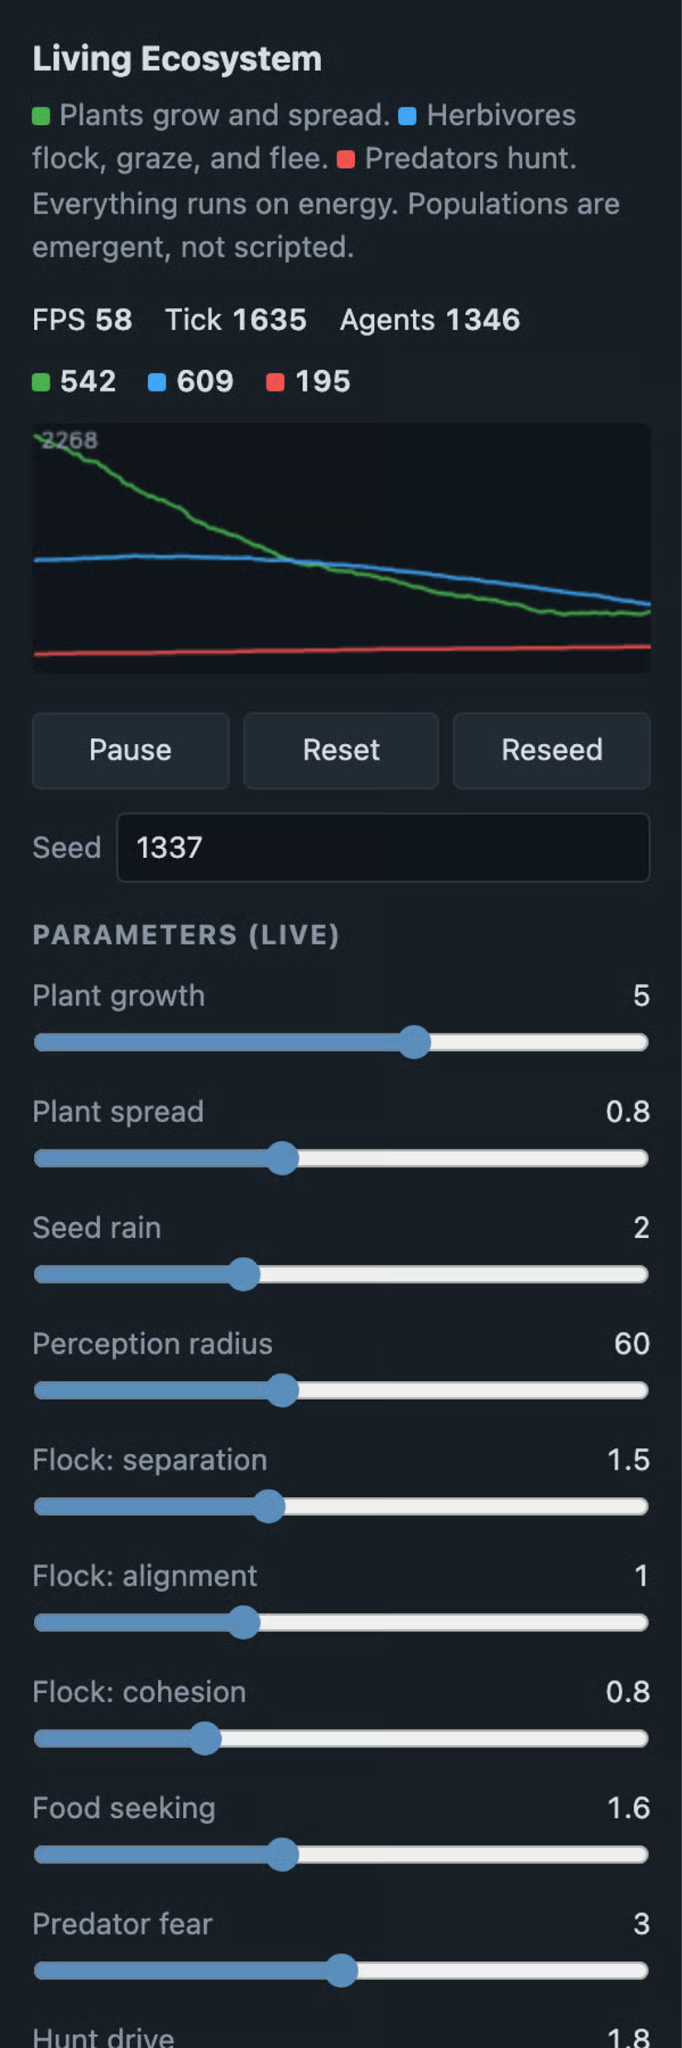
Painel de parâmetros do Fable 5: 13 sliders nas unidades próprias da simulação.
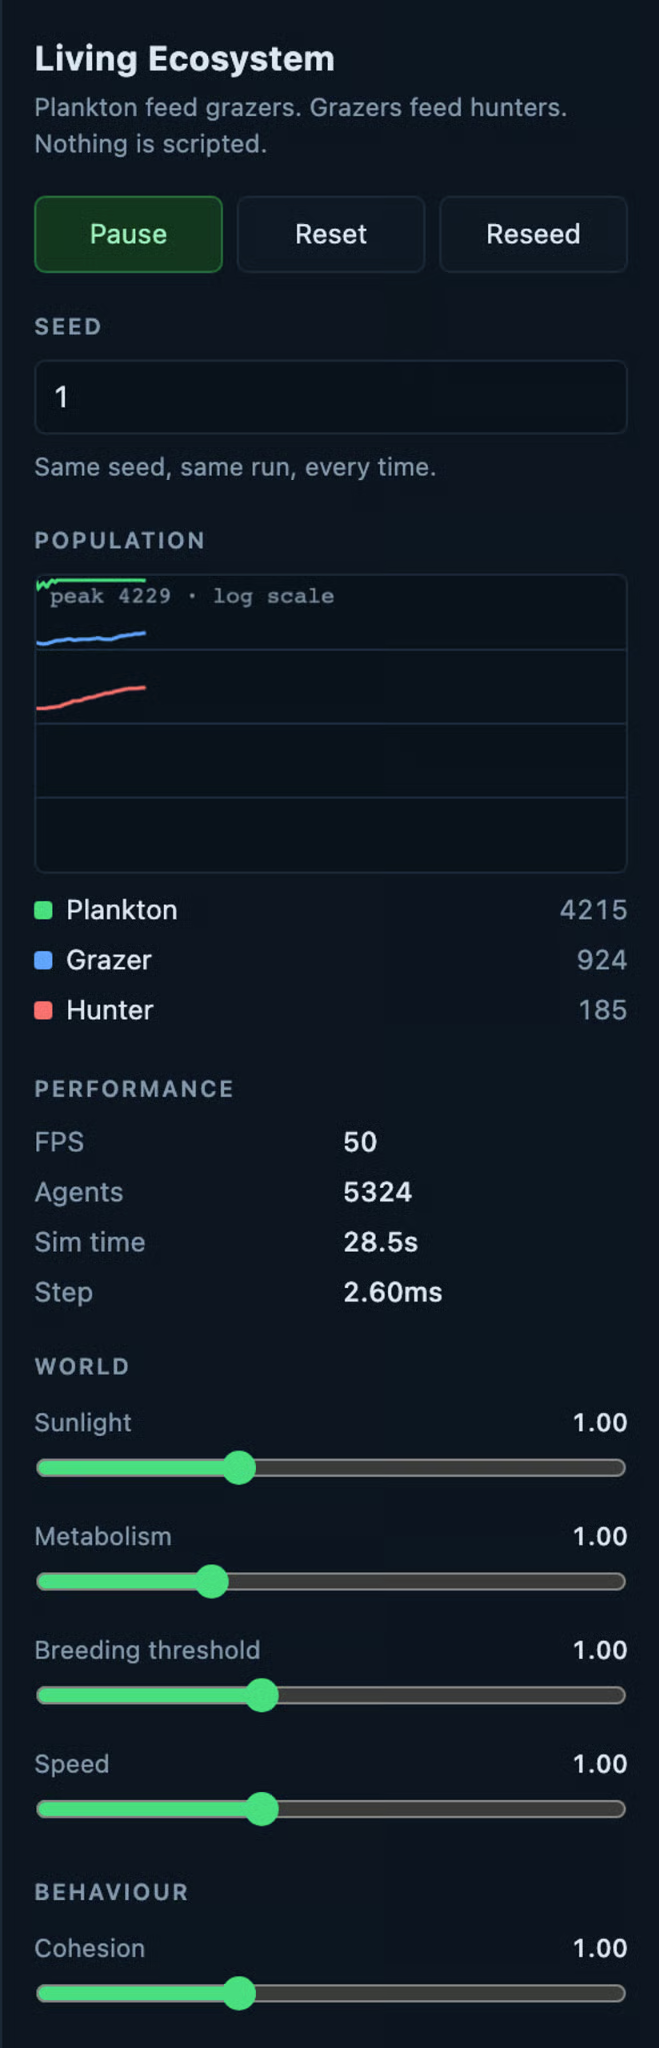
Painel de parâmetros do Opus 5: 9 sliders, cada um um multiplicador começando em 1,00, agrupados em World e Behaviour.
O Fable expõe 13 parâmetros em unidades reais: crescimento de plantas 5, raio de percepção 60, separação 1,5 e metabolismo por espécie. O Opus expõe 9, todos multiplicadores normalizados começando em 1,00, divididos em grupos World e Behaviour.
Em uma frase: o Fable dá mais controle, enquanto o Opus traz um painel que não deixa você desequilibrar o ecossistema com facilidade.
Use o Opus 5 como padrão. Neste build, ele custou 30% menos, rodou uma simulação 2,3x mais rápida e escreveu uma cobertura de testes melhor. O Fable venceu em tempo de conclusão, finalizando em cerca de metade do tempo.
Vá de Fable 5 quando você quiser um build concluído em uma passada com supervisão mínima, ou quando o peso de dependências importar. O Fable entregou um programa sem dependências 42% menor que a alternativa e chegou lá em 103 turnos do assistente contra 247. Essa concisão tem valor real em tarefas que você pretende ler depois.
Dois builds de um tipo de projeto ainda não são um benchmark. O desempenho no mundo real pode variar bastante, apesar do que os benchmarks existentes dizem.
Por exemplo, embora nossa comparação tenha mostrado o Fable usando mais tokens que o Opus, a maioria dos desenvolvedores está compartilhando o inverso: o Opus 5 queimando bem mais tokens do que Fable ou Sol em tarefas similares. A suspeita é que o pré-treinamento por RL do Opus 5 o deixou otimizado demais para inflar custo de tokens em vez de ser útil e conciso. Fora da comparação, eu mesmo senti isso no meu trabalho. A família Opus está ficando cada vez mais verbosa na superfície e difícil de ler.
Pessoalmente, vou continuar usando o Fable 5 na maioria dos meus projetos de código, inclusive para clientes, porque ele vence em precisão no longo prazo. Estou no plano Max mais recente e ainda não bati nos meus limites de uso, mesmo usando o Fable em várias sessões (embora eu não rode o Claude Code sem parar). Vou usar o Opus quando a conta de tokens pesar, ou quando eu quiser um comentário corrido sobre a tarefa em andamento para o meu próprio entendimento.
Para saber mais sobre os modelos e as ferramentas ao redor, recomendo ler nosso guia do Claude Fable 5 completo, além dos tutoriais sobre o Claude Code e as boas práticas do Claude Code.
Aprenda a usar o Claude Code com a DataCamp!
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Khalid Abdelaty
15 min
blog
Josep Ferrer
8 min
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
12 min




