Courses
Claude 模型入门
3小时
14.2K
Fable 5 是 Anthropic Claude 5 家族中聚焦编程的模型,发布于 2026 年 6 月 9 日。它与 Mythos 5 一同推出,后者是一个不含安全分类器的姊妹模型,Anthropic 仅向少数经审核的机构提供。若想完整了解版本发布及 Fable 5 在各项基准中的表现,请查看我们的 Fable 5 专题指南。
Fable 5 的定价高于 Opus 5,定位于更难的编程工作。使用体验上的主要差异在于它每次请求都会启用“思考”,且无法关闭,因此显得更慢、更谨慎。Opus 5 会自行判断提示是否值得投入额外思考。
两者的上下文窗口与最大输出一致。不同之处在于价格以及“思考”机制。
|
|
Fable 5 |
Opus 5 |
|
输入价格(每 100 万 tokens) |
$10 |
$5 |
|
输出价格(每 100 万 tokens) |
$50 |
$25 |
|
上下文窗口 |
100 万 tokens |
100 万 tokens |
|
单次请求最大输出 |
128K tokens |
128K tokens |
|
思考模式 |
始终开启(无法禁用) |
自适应(可选) |
|
拒绝行为 |
|
标准 |
Fable 5 的每 token 成本约为 Opus 5 的两倍。由于其思考始终开启,单次运行往往会输出更多 tokens,因此真实使用中的价差会比单价更大。在本指南后面的正面对比中,Fable 为更小的程序输出了比 Opus 多 74% 的 tokens。
如需更深度的对比(含基准差异),请阅读我们的 Claude Opus 5 与 Claude Fable 5 对比 指南。
Fable 5 最普遍恼人的一点在于其内置安全分类器。由于该模型被认为过于强大,分类器会拒绝处理哪怕与生物学或网络安全等领域略有关联的请求。
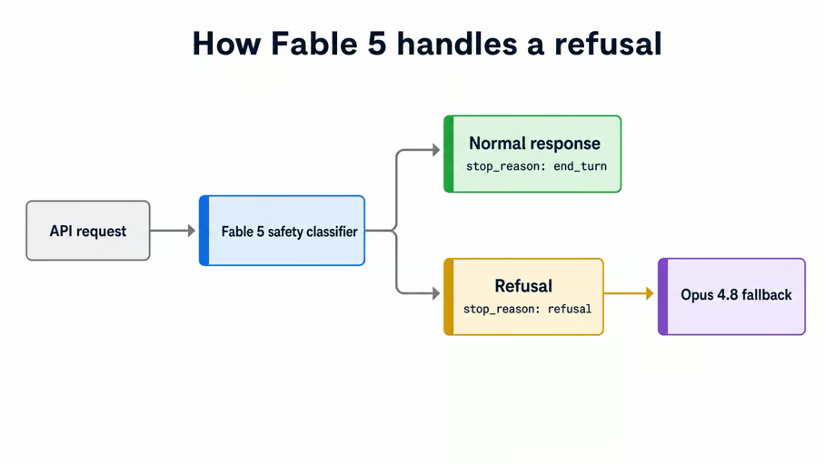
有位免疫学家仅仅因为出现了“cancer”一词就触发了生物安全过滤,导致 Claude Code 回退到 Opus 4.8。
我自己最近也踩到过一次:个人项目中的登录缺陷。该流程使用 Telegram Gateway API 进行一次性验证码登录,Fable 5 直接拒绝处理。Opus 5 完成了任务,而这正是问题所在:这个缺陷与安全风险毫无关系。
自动、零配置回退仅在 Claude Code 和 Claude 应用中发生。如果您通过 API 使用 Fable,即便返回 200 成功码,响应中也会带有 stop_reason 字段。
响应如下所示:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
因此,在处理响应内容之前,您必须先检查 stop_reason。
若要启用服务端回退,请传入 fallbacks 数组(例如 "fallbacks": [{"model": "claude-opus-4-8"}]),并添加 anthropic-beta: server-side-fallback-2026-06-01 头。每个请求都要设置;没有账号级开关。
您或许会疑惑:为何有的来源说 Fable 5 回退到 Opus 4.8,另一些则指向 Opus 5。两者都没错,因为目标取决于类别与使用场景。
在 Claude Code 中,被生物学标记的请求如今会在 Opus 5 上重新运行,而被网络安全标记的仍会回到 Opus 4.8。在 API 上,服务端 fallbacks 功能目前仅支持 Opus 4.8。
这种分裂是时间差造成的:Fable 在 6 月发布时,所有回退都指向 Opus 4.8,而生物学路径在 7 月 24 日 Opus 5 上线后才被改指向它。
即便撇开安全分类器,Fable 5 的起步也并不顺利。
发布后数日,《财富》报道称 Anthropic 在未告知的情况下,悄悄削弱了 Fable 5 在约 0.03% 与 AI/ML 基础设施相关流量上的回答能力。
许多研究人员和开发者都很愤怒,因为他们为此支付了 200 美元订阅,原本期待的是一款能承担任何任务的前沿“劳模”级模型。
Anthropic 在一天内顶不住社区压力,表示自己“做了错误的权衡”。它改变的是可见性,而不是限速本身。被标记的请求如今会像拒绝一样被提示,但降级仍然存在。Anthropic 的理由是其条款本就禁止使用 Claude 构建竞争性 AI 系统,这一立场可以辩护。但悄无声息地做了一个月,这点难以接受。
随后出现了更大的事件。一次公开的越狱在 6 月 12 日触发了美国商务部的出口管制令,Anthropic 因此在全球下线了 Fable 5 与 Mythos 5,共计 19 天。
Anthropic 在整个召回期间强烈反对。它认为该越狱并非通用,而是窄域,弱一些的模型也能找到,所以从它的角度看,召回标准显得不透明。对于门槛本身,它的观点有一定道理。没有人真的构建出通用越狱,今天也没有任何模型能通过这道标准。英国 AI 安全研究所曾报告在这方面有所进展,但没有真正可用的成果。
它对门槛本身的看法有一定道理,但表述方式并不准确。通用越狱确实存在:英国 AI 安全研究所报告称,他们在测试的每个前沿系统上都找到了此类方法,而且根据 Fable 5 的模型卡,他们的红队在数小时内就在 Fable 5 上实现了单轮通用越狱,并在数日内扩展到多轮代理式工作流。
真正存在争议的是:这道门槛是否应当触发召回,而不是此类越狱能否实现。
Anthropic 上线了更强的分类器,并报告拦截率超过 99%,基于此,商务部于 6 月 30 日前后解除管制。
7 月 1 日恢复一般访问,但条款更严。此前承诺的两周不受限窗口缩短为约一周,同时新增周度 50% 的上限:一旦超过,更多 Fable 5 的使用将按全价 $10/$50 计入额度。这已足以让订阅者在 Reddit 上抱怨。
Anthropic 两次延长期限,随后在 7 月 20 日按套餐拆分政策:Max 与 Team Premium 将 Fable 5 维持在周度限额的 50%,无截止日期;Pro 与 Team Standard 获得一次性 $100 额度,之后按 API 价计费。Mythos 5 仅面向约 100 家经审核的美国机构恢复,相较此前更广泛的国际项目有所收紧。
总的来看,Fable 5 是一款强劲的模型,但其访问政策月月在变。请预留偶发误拒绝的空间,并不要指望本月的限额能延续到下月。
为观察两者在相同条件下的表现,我在全新的 Claude Code 会话中给它们同一项任务。之后,我阅读了完整的会话记录、内部 JSONL 文件,并在浏览器中评测了两个成品应用。
我最初用 URL 短链器做对比,这是个错误。两个模型产出的应用几乎一模一样,连主题和功能都一致,因为 URL 短链器在所有模型的训练数据中都几乎有唯一答案。这个测试测不出差异。
于是我选了一个没有标准答案的任务:活体生态系统仿真。由三种物种构成食物网,个体会群集、捕猎、饥饿,屏幕上同时显示 5000 个体,从同一个种子出发保证确定性。提示中禁止使用能处理关键难点的库,因此每个模型都必须自己写空间查询、转向与种群动力学。
以下是两个模型收到的逐字提示:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
禁止提问的规则正是要点。它能显示每个模型在无人纠偏时能独立推进到什么程度。两者分别在各自的空目录中运行,彼此毫无暗示。
这项任务还把四个客观测试藏在看似纯视觉的输出里:
上述每个失败都会在屏幕上可见,这正是为什么漂亮的演示也能被打分。
两个构建都已上线,您可以自行运行对比,而非只听我一面之词。并排打开并分别重新设定种子:
下文还有两者的截图,如果您更愿意阅读而非点击。但需说明:截图为了全屏展示而缩放,细节可能不够清晰。
在结果之前,先给出一个与解读相关的方法说明。
当 Fable 5 的安全分类器拒绝请求时,Claude Code 可能回退到 Opus,因此标注为 Fable 的运行并不保证全程都是 Fable。为避免假设,我记录了两个会话中每个 assistant 事件里的 model 字段。
幸运的是,在我的对比中,Fable 运行的每个事件都返回了 claude-fable-5,共 103 个。Opus 运行的每个事件都返回了 claude-opus-5,共 247 个。两边都没有触发回退。下文的数字与标签一致。
Fable 工作得很安静。整个构建期间调用了 56 次工具,仅输出 429 个词的说明,分两段。
Opus 则“开麦实况”。它调用了 137 次工具,是前者的两倍多,并在 110 段输出中写了 4,808 个词。若按规模折算,二者的修订频率接近,约为每个写入文件 2 次编辑。
工具链上也分道扬镳。Fable 使用原生 ES 模块,python3 -m http.server 启动脚本,完全没有 node_modules。Opus 安装了 Vite 与 Vitest,基于完整工具链构建。
下方的构建时间仅统计活跃工作。我取每次运行从首个 assistant 事件到最后一个事件的区间,并剔除了会话空等不构建的时间段。
|
维度 |
Fable 5 |
Opus 5 |
|
Assistant 事件数 |
103 |
247 |
|
活跃构建时间 |
25 分钟 |
48 分钟 |
|
输出 tokens |
243,442 |
139,920 |
|
缓存读取 |
11.3M |
26.4M |
|
工具调用 |
56(Bash 24、Edit 19、Write 10) |
137(Bash 60、Edit 51、Write 20) |
|
可见文字输出 |
429 词(2 段) |
4,808 词(110 段) |
|
总成本 |
$28.70 |
$20.07 |
|
交付文件 |
9,零依赖 |
13,Vite + Vitest |
|
代码行数 |
约 1,010 |
约 1,746 |
|
测试 |
16,全通过 |
58,全通过 |
|
|
否 |
是 |
|
仿真速度 |
3.14 ms/步(3,510 个体) |
1.35 ms/步(4,368 个体) |
|
已推送至 GitHub |
是 |
是 |
Fable 成本高出 43%,为更小的程序输出了多 74% 的 tokens。由于无法关闭思考,即便工作并不需要,它也会持续计费。
两个模型都通过了所有客观检查:
NaN。Opus 的仿真每步快 2.3 倍。它将个体存入 typed arrays,每个属性一条扁平数组,并为每个物种单独维护空间网格。Fable 为每个个体使用对象,并在三种物种间共享统一网格。两者都正确,但 Opus 的数据布局更快。
Fable 的 npm test 脚本无法运行。它交付的是 node --test test/,Node 26 会将其解析为模块路径而非目录,导致命令在任何测试执行前就失败。底下的 16 个测试本身没问题,显式指定文件时能通过。问题出在 package.json 的入口配置。
这是一个小 bug,却带来不小的代价,因为读者最可能输入的那条命令正好失败。Fable 也从未发现这一点,这才是关键:提示要求编写测试,但它验证测试的方式与用户的实际路径并不一致。
Opus 没有同类问题。它的 58 个测试可从 npm test 运行并通过。两套测试都覆盖了这里的关键点:带种子的确定性、能量守恒、圆环包裹以及长期物种存活,因此差距在深度而非种类。只有 Opus 编写了 5000 个体的压力测试,这也是最容易出问题的要求。
两个应用的外观完全不同,这也正是更换任务的意义所在。
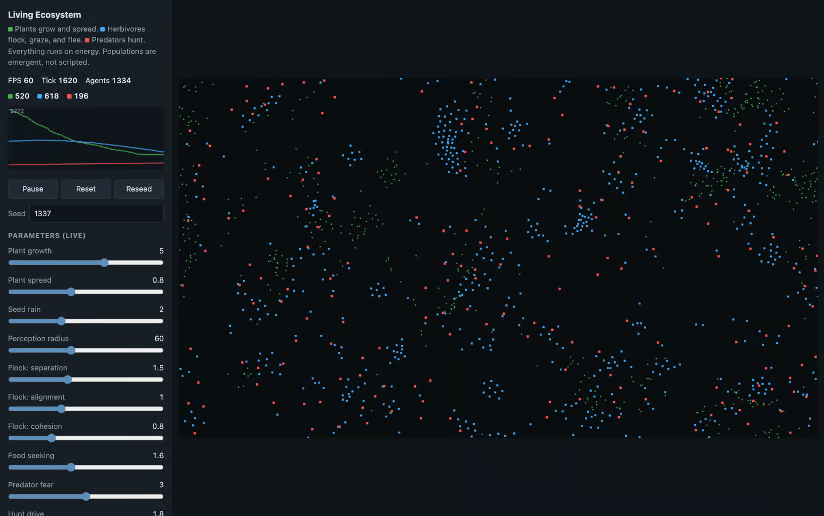
Fable 5:左侧控制区,个体绘制为扁平方块,物种命名为 Plants、Herbivores、Predators。
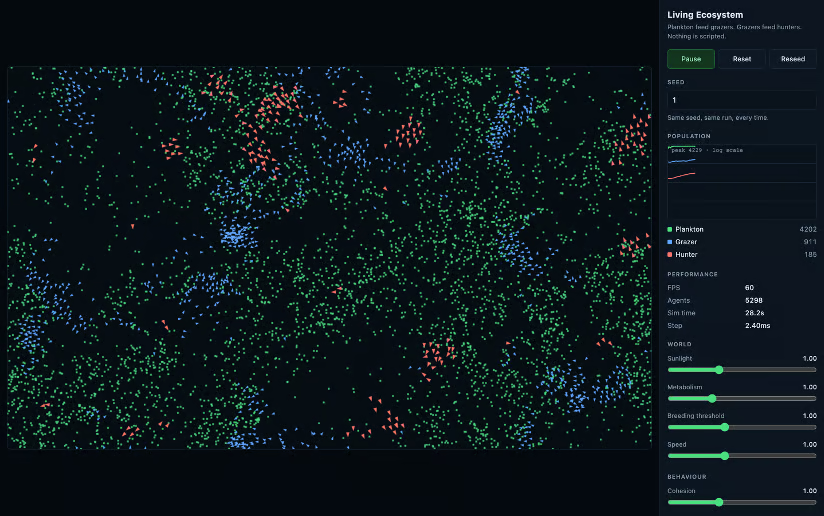
Opus 5:右侧控制区,个体为指向三角形,可读出群体移动方向,物种命名为 Plankton、Grazers、Hunters。
在 UI 层面,差异主要体现在:
种群曲线是设计差异最明显的地方。
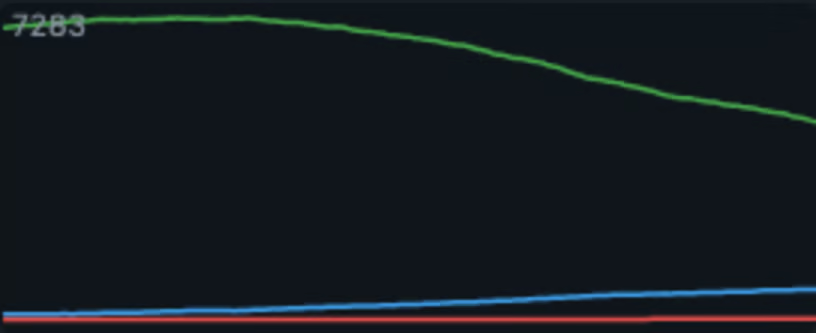
Fable 5 的曲线,线性刻度。植物线占满纵轴,捕食者线贴着底部。
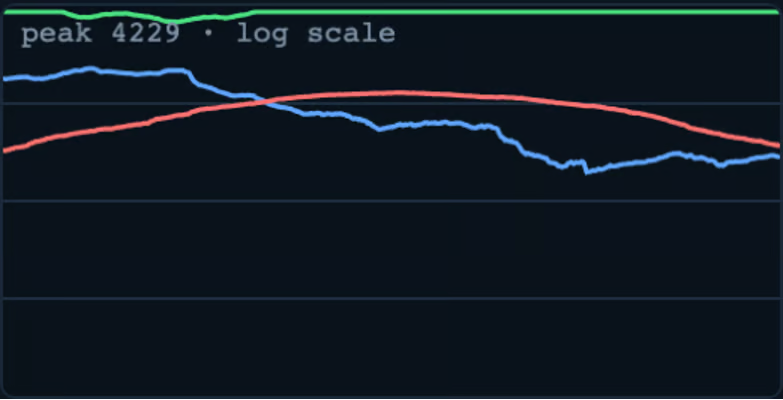
Opus 5 的曲线,对数刻度。三种物种均清晰可辨,猎食者曲线与食草者曲线交叉。
两套仿真都呈现出捕食—被捕食系统应有的振荡。Fable 的植物在 5 分钟内在 520 与 7,061 之间波动,食草者与捕食者随后跟随,捕食者在食草者跌至 119 时恰好达到 248 的峰值。
在线性刻度下,植物线吞噬了整个纵向范围,食草者被压成细带,捕食者则贴在坐标轴上。
这就是 Opus 采用对数刻度并标注峰值的原因。三条曲线都保持可读,您可以看到猎食者线升起、穿过食草者线、再在食草者恢复时回落。数据同类,只有一张图可读。
底层生态系统也不同。Opus 将生产者层封顶在 4,229 个浮游生物,因此该群体顶到上限,只有上层两类在循环。Fable 保持三层耦合,带来更大的波动与更鲜活的世界。我们在未提示的情况下获得了“稳态 vs. 动态”的分野。
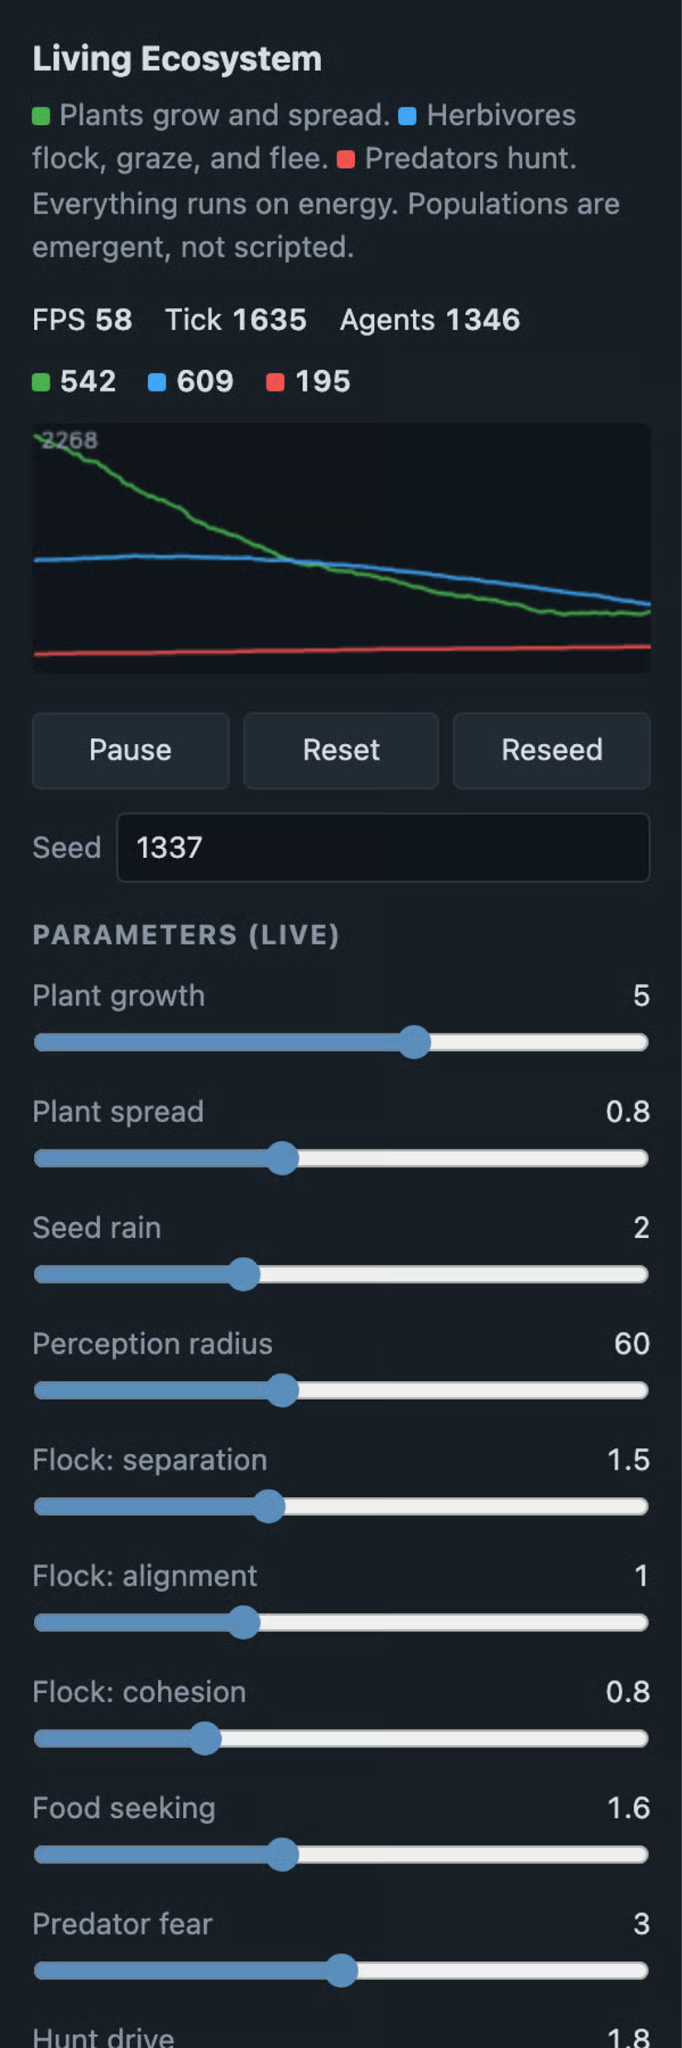
Fable 5 的参数面板:13 个滑块,使用仿真自身单位。
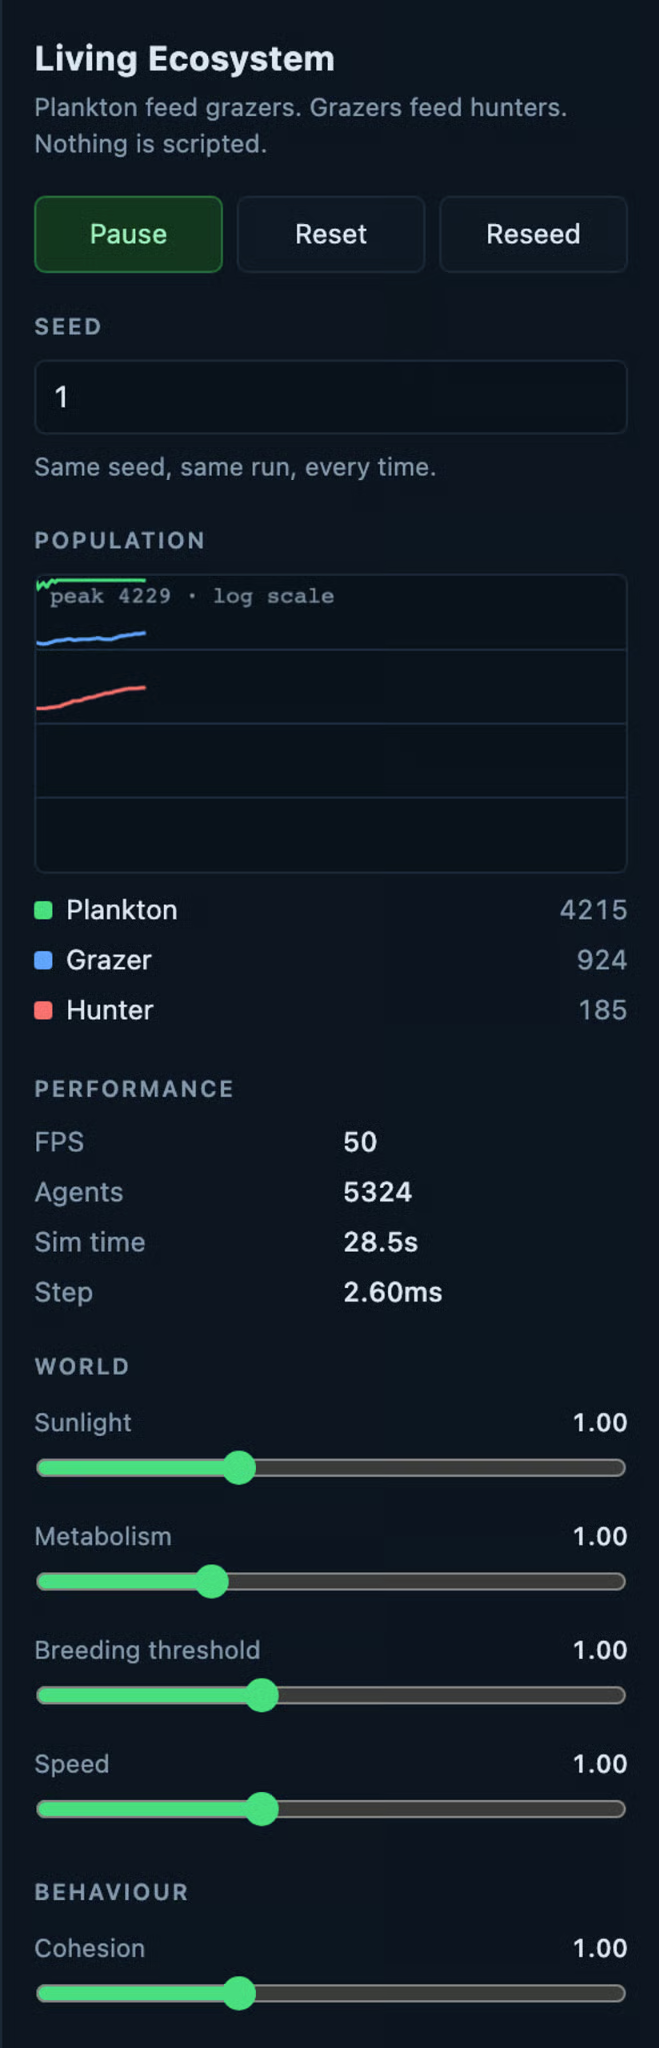
Opus 5 的参数面板:9 个滑块,均为从 1.00 起的倍率,分为 World 与 Behaviour 两组。
Fable 暴露了 13 个真实单位的参数:如植物生长 5、感知半径 60、分离 1.5,以及分物种的新陈代谢。Opus 暴露 9 个参数,均为从 1.00 起的归一化倍率,分为 World 与 Behaviour 组。
一句话总结:Fable 给予您更多可控性;Opus 提供的面板更不易被用户轻易调坏生态平衡。
默认请选择 Opus 5。在这次构建中,它成本低 30%,仿真每步快 2.3 倍,测试覆盖也更好。Fable 的优势在于用时,约为对方的一半。
当您希望在最少监督下一次性完成构建,或当依赖体积很重要时,转用 Fable 5。Fable 交付了一个零依赖、体积比备选小 42% 的程序,并以 103 次 assistant 轮次对 247 次取胜。这种“简洁”在您计划事后亲自阅读项目时很有价值。
对同一项目类型的两次构建仍谈不上是基准。尽管已有基准在先,真实世界的表现仍可能大相径庭。
例如,虽然我们的对比显示 Fable 用的 tokens 多于 Opus,但大多数开发者分享的是相反的经历:在类似任务中,Opus 5 消耗的 tokens 远多于 Fable 或 Sol。有人怀疑 Opus 5 的 RL 预训练让它过度优化于堆积 token 成本,而非既有帮助又简洁。在对比之外,我在自己的工作中确实有这种感受。Opus 系列在表面上日益冗长,也更难读。
就我个人而言,我会在几乎所有编程项目(包括客户项目)中继续使用 Fable 5,因为长期来看它在准确性上更占优。我目前使用最新的 Max 套餐,即便同时在多个会话中使用 Fable,也尚未触达限额(虽然我不会让 Claude Code 不停运行)。当 token 账单更重要,或我想获取任务过程的实时讲解以便理解时,我会使用 Opus。
关于模型及其配套工具的更多信息,推荐阅读我们的 Claude Fable 5 指南,以及 Claude Code 与 Claude Code 最佳实践教程。
使用 DataCamp 学习 Claude Code!
Courses
Courses
Courses