Kurs
Wprowadzenie do modeli Claude
3 godz.
14.9K
Fable 5 to model skupiony na kodowaniu z rodziny Claude 5 od Anthropic, wydany 9 czerwca 2026. Zadebiutował wraz z Mythos 5, bliźniaczym modelem bez klasyfikatorów bezpieczeństwa, który Anthropic udostępnił wyłącznie wąskiej grupie zweryfikowanych organizacji. Pełny przegląd wydania i porównanie Fable 5 na benchmarkach znajdziesz w naszym dedykowanym przewodniku Fable 5.
Fable 5 jest droższy od Opus 5 i celuje w trudniejsze zadania programistyczne. Główna różnica w odczuciu polega na tym, że myślenie uruchamia przy każdym żądaniu i nie da się go wyłączyć, więc sprawia wrażenie wolniejszego i bardziej rozważnego. Opus 5 sam decyduje, czy dany prompt jest wart dodatkowego rozumowania.
Oba modele mają ten sam kontekst i maksymalny rozmiar odpowiedzi. Różnią się ceną i tym, jak działa myślenie.
|
|
Fable 5 |
Opus 5 |
|
Cena wejścia (za 1 mln tokenów) |
$10 |
$5 |
|
Cena wyjścia (za 1 mln tokenów) |
$50 |
$25 |
|
Okno kontekstu |
1 mln tokenów |
1 mln tokenów |
|
Maks. wyjście na żądanie |
128 tys. tokenów |
128 tys. tokenów |
|
Myślenie |
Zawsze włączone (nie da się wyłączyć) |
Adaptacyjne (na żądanie) |
|
Zachowanie przy odmowie |
|
Standardowe |
Fable 5 kosztuje około dwa razy więcej za token niż Opus 5. Ponieważ jego myślenie jest zawsze włączone, pojedyncze uruchomienie zwykle emituje też więcej tokenów, więc różnica cenowa w praktyce jest większa, niż sugeruje stawka per token. W bezpośrednim starciu później w tym przewodniku Fable wyemitował o 74% więcej tokenów wyjściowych niż Opus dla mniejszego programu.
Po głębokie porównanie, w tym różnice w benchmarkach, zajrzyj do naszego przewodnika Claude Opus 5 vs Claude Fable 5.
Jednym powszechnie irytującym aspektem Fable 5 jest wbudowany klasyfikator bezpieczeństwa. Ponieważ model uznano za zbyt potężny, klasyfikator nie pozwala mu obsługiwać żądań choćby odrobinę powiązanych z dziedzinami takimi jak biologia czy cyberbezpieczeństwo.
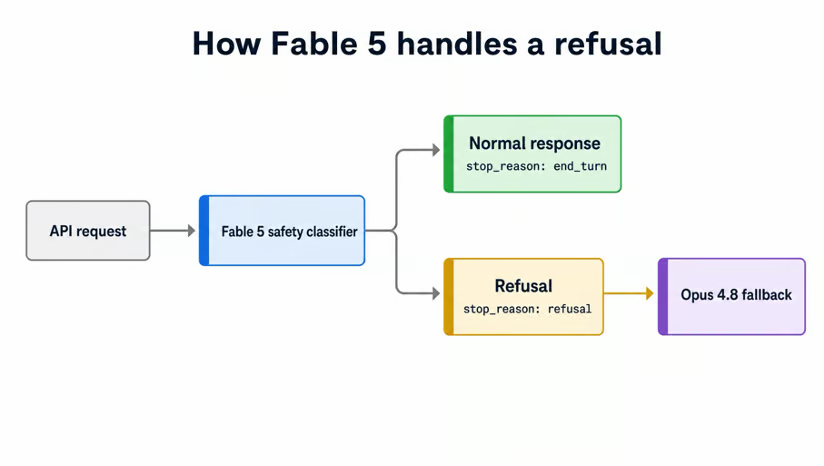
U jednego immunologa samo słowo „cancer” wywołało filtr biosecurity, przez co Claude Code spadł do Opus 4.8.
Mnie trafiło się to niedawno przy błędzie logowania w prywatnym projekcie. Przepływ używał Telegram Gateway API do logowania OTP i Fable 5 kategorycznie odmówił dotknięcia tematu. Opus 5 zrobił robotę — i w tym cały problem: w tym błędzie nie było żadnego ryzyka bezpieczeństwa.
Automatyczny fallback bez konfiguracji działa tylko w Claude Code i aplikacjach Claude. Jeśli korzystasz z Fable przez API, dostaniesz pole stop_reason w odpowiedzi mimo kodu powodzenia 200.
Odpowiedź wygląda tak:
{
  "stop_reason": "refusal",
  "stop_details": {
	"category": "bio",
	"explanation": "The request was declined by a safety classifier."
  }
}
Więc musisz sprawdzić stop_reason, zanim w ogóle dotkniesz treści odpowiedzi.
Aby włączyć fallback po stronie serwera, przekaż tablicę fallbacks (np. "fallbacks": [{"model": "claude-opus-4-8"}]) i wyślij nagłówek anthropic-beta: server-side-fallback-2026-06-01. Ustawiaj go przy każdym żądaniu; nie ma przełącznika na poziomie konta.
Możesz się zastanawiać, czemu niektóre źródła mówią, że Fable 5 spada do Opus 4.8, a inne wskazują na Opus 5. Oba mają rację, bo cel zależy od kategorii i powierzchni.
W Claude Code prośba oznaczona jako biologiczna jest teraz ponownie uruchamiana na Opus 5, a ta z cyberbezpieczeństwa wciąż na Opus 4.8. W API funkcja fallbacks po stronie serwera obecnie wspiera tylko Opus 4.8.
Podział to artefakt czasowy: przy czerwcowej premierze Fable wszystko spadało do Opus 4.8, a ścieżkę biologii później przełączono na Opus 5, gdy ten model zadebiutował 24 lipca.
Fable 5 miał trudny start — nawet pomijając kwestię klasyfikatora bezpieczeństwa.
Kilka dní po premierze Fortune doniósł, że Anthropic po cichu osłabił odpowiedzi Fable 5 na ok. 0,03% ruchu dotyczącego infrastruktury AI i ML, nie informując o tym nikogo.
Wielu badaczy — i deweloperów — było wściekłych, bo spodziewali się roboczego modelu frontier, który poradzi sobie z każdym zadaniem, skoro płacą za niego 200 dolarów abonamentu.
Anthropic ugiął się pod presją społeczności w ciągu dnia, mówiąc, że „zrobił zły trade-off”. Zmieniła się widoczność, nie throttling. Oznaczone żądania są teraz ujawniane tak jak odmowy, a sama degradacja została. Uzasadnienie Anthropic brzmi, że jego warunki i tak zabraniają używania Claude do budowy konkurencyjnych systemów AI — co da się obronić. Robienie tego po cichu przez miesiąc — nie.
Potem przyszło większe. Ujawniony jailbreak wywołał 12 czerwca nakaz kontroli eksportu od Departamentu Handlu i Anthropic zdjął zarówno Fable 5, jak i Mythos 5 z sieci na całym świecie na 19 dni.
Anthropic przez cały czas mocno się sprzeciwiał odwołaniu. Argumentował, że jailbreak był wąski, a nie uniwersalny, i że słabsze modele też potrafią go znaleźć, więc z ich perspektywy standard odwołania wyglądał na nieprzejrzysty. Miał mocny punkt co do samej poprzeczki. Nikt nigdy nie zbudował uniwersalnego jailbreaka i żaden dzisiejszy model tej poprzeczki nie przeskakuje. UK AI Safety Institute raportował postępy w tym kierunku, ale nic działającego.
Miał mocny punkt co do samej poprzeczki, choć nie co do sposobu jej ujęcia. Uniwersalne jailbreaki istnieją: UK AI Security Institute raportuje, że znajduje je dla każdego testowanego systemu frontier, a jego red-teamerzy zbudowali taki przeciw Fable 5 — jednokrokowy w kilka godzin i rozszerzony do wielokrokowych agentowych workflowów w kilka dni, według karty modelu Fable 5.
To, co jest realnie sporne, to czy taka poprzeczka powinna wywoływać odwołanie — nie to, czy takie jailbreaki są możliwe.
Anthropic wdrożył mocniejszy klasyfikator i zgłosił odsetek blokad powyżej 99%, i na tej podstawie Departament Handlu zniósł ograniczenia około 30 czerwca.
Dostęp ogólny wrócił 1 lipca, ale na ostrzejszych warunkach. Obiecane dwutygodniowe okno bez ograniczeń skurczyło się do około tygodnia, a nowy tygodniowy limit 50% oznaczał, że po jego przekroczeniu dalsze użycie Fable 5 było rozliczane jako kredyty po pełnej stawce $10 i $50. To wystarczyło, by subskrybenci zaczęli pomstować na Reddicie.
Anthropic dwukrotnie wydłużył termin, a 20 lipca rozdzielił politykę według planu: Max i Team Premium utrzymują Fable 5 na poziomie 50% tygodniowych limitów bez daty końcowej, a Pro i Team Standard dostają jednorazowy kredyt $100 i potem płacą stawkę API. Mythos 5 wrócił tylko do ok. 100 zweryfikowanych organizacji w USA, z szerszego wcześniej programu międzynarodowego.
W efekcie Fable 5 pozostaje mocnym modelem owiniętym polityką dostępu, która zmienia się z miesiąca na miesiąc. Planuj okazjonalne fałszywe odmowy i nie zakładaj, że limity z tego miesiąca utrzymają się w kolejnym.
Żeby zobaczyć, jak oba modele zachowują się w identycznych warunkach, dałem każdemu to samo zadanie w świeżej sesji Claude Code. Potem przeczytałem pełne transkrypcje sesji, wewnętrzne pliki JSONL i oceniłem obie gotowe aplikacje w przeglądarce.
Pierwsze podejście do tego porównania używało skracacza URL. To był błąd. Oba modele zbudowały niemal identyczne aplikacje — łącznie z motywem i zestawem funkcji — bo skracacz URL ma jedną oczywistą odpowiedź, obecną w danych treningowych każdego modelu. Test nie mierzył niczego.
Wybrałem więc zadanie bez kanonicznej odpowiedzi: symulację żyjącego ekosystemu. Trzy gatunki w sieci troficznej, agenci, którzy tworzą stada, polują i głodują, 5000 jednocześnie na ekranie, wszystko deterministyczne od ziarna. Prompt zakazuje bibliotek, które załatwiłyby trudne części, więc każdy model musi napisać własne zapytania przestrzenne, sterowanie i dynamikę populacji.
Oto prompt, który oba modele dostały, słowo w słowo:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
Zasada „bez pytań” jest tu kluczowa. Pokazuje, jak daleko każdy model pociągnie build samodzielnie, bez nikogo, kto wyłapie zły skręt. Każdy działał we własnym pustym katalogu, bez podpowiedzi, że drugi model dostał to samo zadanie.
Zadanie ukrywa też cztery obiektywne testy w wyjściu, które wygląda na czysto wizualne.
Każda z tych porażek jest widoczna na ekranie — dlatego ładne demo da się ocenić.
Oba buildy są na żywo, więc możesz sam przeprowadzić to porównanie zamiast wierzyć mi na słowo. Otwórz je obok siebie i zrób reseed w każdym:
Zrzuty obu są niżej, jeśli wolisz czytać niż klikać. Uczciwie uprzedzam: zrzuty są pomniejszone, żeby zmieścić cały ekran, więc detale mogą nie być idealnie czytelne.
Zanim wyniki — ważna uwaga metodologiczna, która pomaga w ich lekturze.
Claude Code może spadać do Opus, gdy klasyfikator Fable 5 odmawia, więc przebieg oznaczony jako Fable nie musi być w 100% Fable. Zamiast zakładać, zapisywałem pole model przy każdym zdarzeniu asystenta w obu transkryptach.
Na szczęście w moim porównaniu każde zdarzenie w przebiegu Fable wróciło jako claude-fable-5 — wszystkie 103. Każde zdarzenie w przebiegu Opus wróciło jako claude-opus-5 — wszystkie 247. Żaden fallback się nie uruchomił. Poniższe liczby opisują modele z etykiety.
Fable pracował po cichu. Wykonał 56 wywołań narzędzi i wypisał 429 słów komentarza przez cały build, w 2 blokach tekstu.
Opus pracował na wierzchu. Wykonał 137 wywołań narzędzi — ponad dwa razy więcej — i wypisał 4808 słów w 110 blokach. Oba modele poprawiały w podobnym tempie po uwzględnieniu wolumenu — blisko 2 edycje na zapisany plik.
Różniły się też w narzędziach. Fable dostarczył czyste moduły ES ze skryptem startowym python3 -m http.server i bez node_modules. Opus zainstalował Vite i Vitest i budował na prawdziwym toolchainie.
Poniższe czasy budowy mierzą tylko aktywną pracę. Wziąłem każdy przebieg od pierwszego zdarzenia asystenta do ostatniego i odjąłem każdy okres bezczynności, w którym sesja czekała zamiast budować.
|
Wymiar |
Fable 5 |
Opus 5 |
|
Zdarzenia asystenta |
103 |
247 |
|
Aktywny czas budowy |
25 min |
48 min |
|
Tokeny wyjściowe |
243 442 |
139 920 |
|
Odczyty z cache |
11,3 mln |
26,4 mln |
|
Wywołania narzędzi |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
Widoczny tekst |
429 słów (2 bloki) |
4808 słów (110 bloków) |
|
Całkowity koszt |
$28.70 |
$20.07 |
|
Pliki w paczce |
9, zero zależności |
13, Vite + Vitest |
|
Linie kodu |
~1 010 |
~1 746 |
|
Testy |
16, wszystkie przechodzą |
58, wszystkie przechodzą |
|
|
Nie |
Tak |
|
Szybkość symulacji |
3,14 ms/tick przy 3510 agentach |
1,35 ms/tick przy 4368 agentach |
|
Wysłane na GitHub |
Tak |
Tak |
Fable kosztował o 43% więcej i wyprodukował o 74% więcej tokenów wyjściowych dla mniejszego programu. Ponieważ nie może wyłączyć myślenia, nalicza opłaty nawet wtedy, gdy praca tego nie wymaga.
Oba modele zaliczyły wszystkie obiektywne sprawdzenia:
NaN.Symulacja Opusa jest 2,3x szybsza na tick. Przechowuje agentów w tablicach typowanych — po jednej płaskiej tablicy na właściwość — i trzyma osobną siatkę przestrzenną dla każdego gatunku. Fable daje każdemu agentowi własny obiekt i współdzieli jedną jednolitą siatkę dla trzech gatunków. Oba podejścia są poprawne, ale układ danych Opusa jest szybszy.
Skrypt npm test w Fable nie działa. Dostarczył node --test test/, co Node 26 rozpoznaje jako ścieżkę do modułu, a nie katalog, więc polecenie pada, zanim wykona się choćby jeden test. 16 testów pod spodem jest OK i przechodzi po podaniu nazw plików. Punkt wejścia w package.json jest zepsuty.
To drobny bug o ponadprzeciętnym koszcie, bo jedyne polecenie, które czytelnik faktycznie wpisze, to to, które pada. Fable też nigdy go nie wyłapał — i to jest istotne: prompt prosił o testy, a on je zweryfikował ścieżką, której jego użytkownicy nie wybiorą.
Opus nie ma analogicznej porażki. Jego 58 testów uruchamia się z npm test i przechodzi. Obie paczki testują to, co się tu liczy: deterministykę z ziarnem, bilans energii, zawijanie torusa i długoterminowe przetrwanie gatunków — więc różnica polega na głębokości, nie rodzaju. Jedyny check, który napisał tylko Opus, to test obciążeniowy na 5000 agentów — i to też wymóg, który najłatwiej złamać.
Obie aplikacje nie wyglądają do siebie podobnie — i o to chodziło przy zmianie zadania.
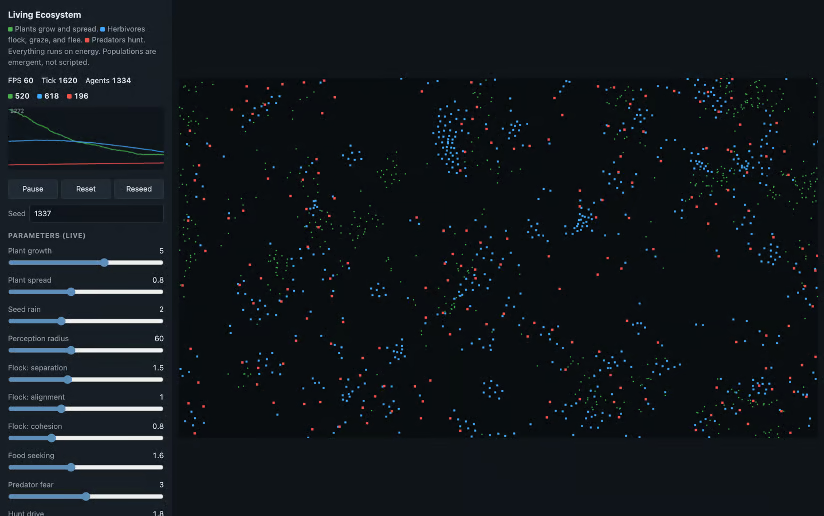
Fable 5: sterowanie po lewej, agenci jako płaskie kwadraty, gatunki nazwane Plants, Herbivores i Predators.
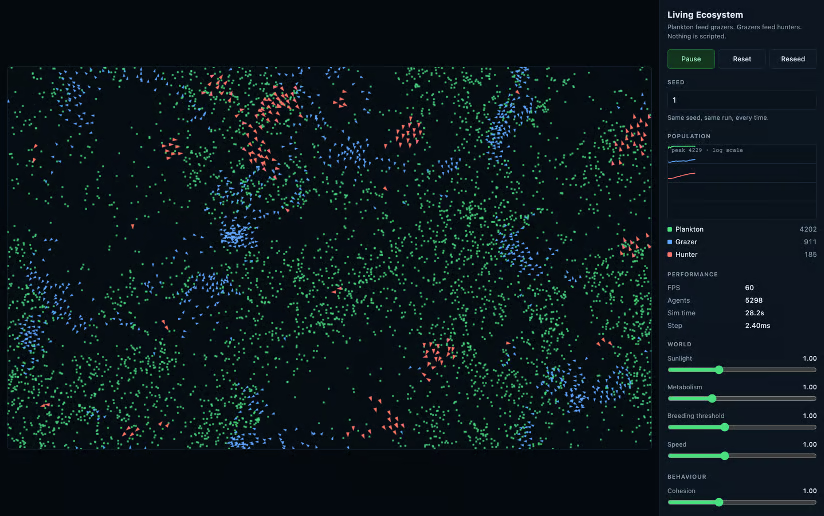
Opus 5: sterowanie po prawej, agenci jako trójkąty wskazujące kierunek, gatunki nazwane Plankton, Grazers i Hunters.
Po stronie UI to największe różnice:
Na wykresach populacji różnica projektowa staje się ostra.
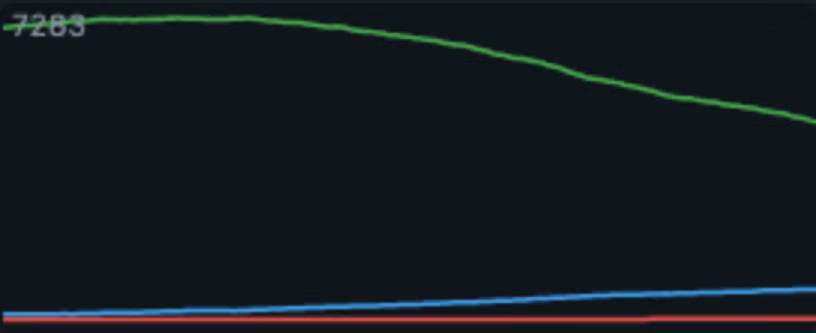
Wykres Fable 5, skala liniowa. Linia roślin zajmuje całą wysokość, a linia drapieżników jest przyklejona do osi.
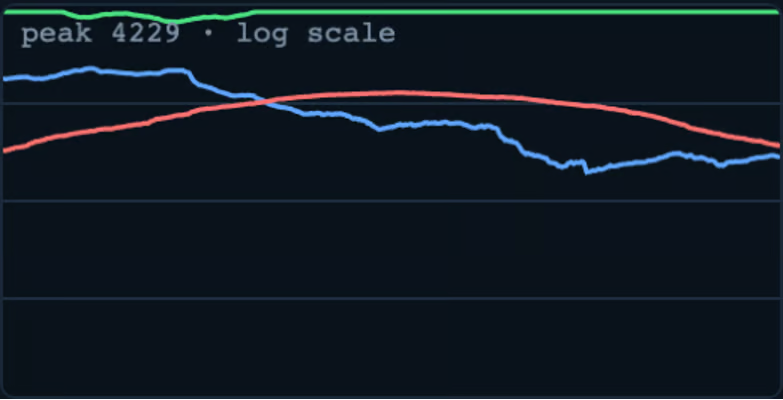
Wykres Opus 5, skala logarytmiczna. Wszystkie trzy gatunki są czytelne, a linia łowców przecina linię roślinożerców.
Obie symulacje oscylują tak, jak powinien system drapieżnik–ofiara. Rośliny Fable wahają się między 520 a 7061 przez 5 minut, podczas gdy roślinożercy i drapieżnicy cyklują za nimi; drapieżnicy szczytują na 248, dokładnie gdy roślinożercy dołują na 119.
W skali liniowej linia roślin zjada cały zakres pionowy, roślinożercy kompresują się do cienkiego pasa, a drapieżnicy siedzą przy osi.
Dlatego Opus dał wykres w skali log i oznaczył szczyt. Wszystkie trzy gatunki pozostają czytelne i możesz obserwować, jak linia łowców rośnie, przecina linię roślinożerców i opada, gdy tamci się odbudowują. Ten sam rodzaj danych, a tylko jeden z dwóch wykresów da się czytać.
Różni się też mechanika ekosystemów. Opus ogranicza warstwę producentów do 4229 planktonu, więc ta populacja przykleja się do sufitu i cyklują tylko dwa górne gatunki. Fable zostawia sprzężenie trzech, co daje szersze wahania i żywszy świat. Bez proszenia w promcie dostaliśmy stabilność kontra dynamika.
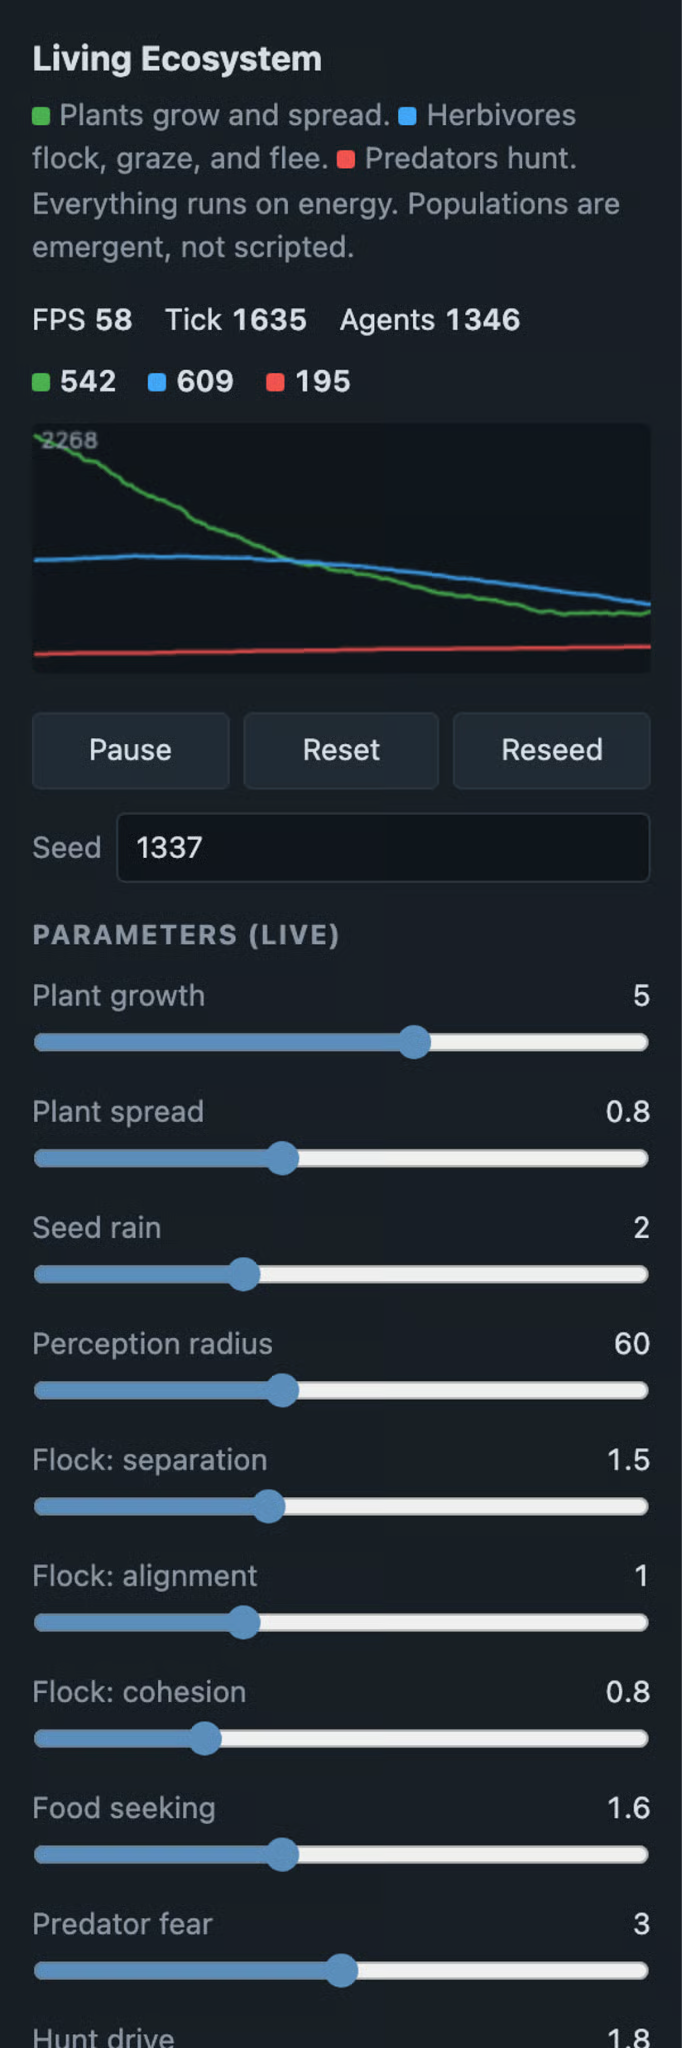
Panel parametrów Fable 5: 13 suwaków w jednostkach samej symulacji.
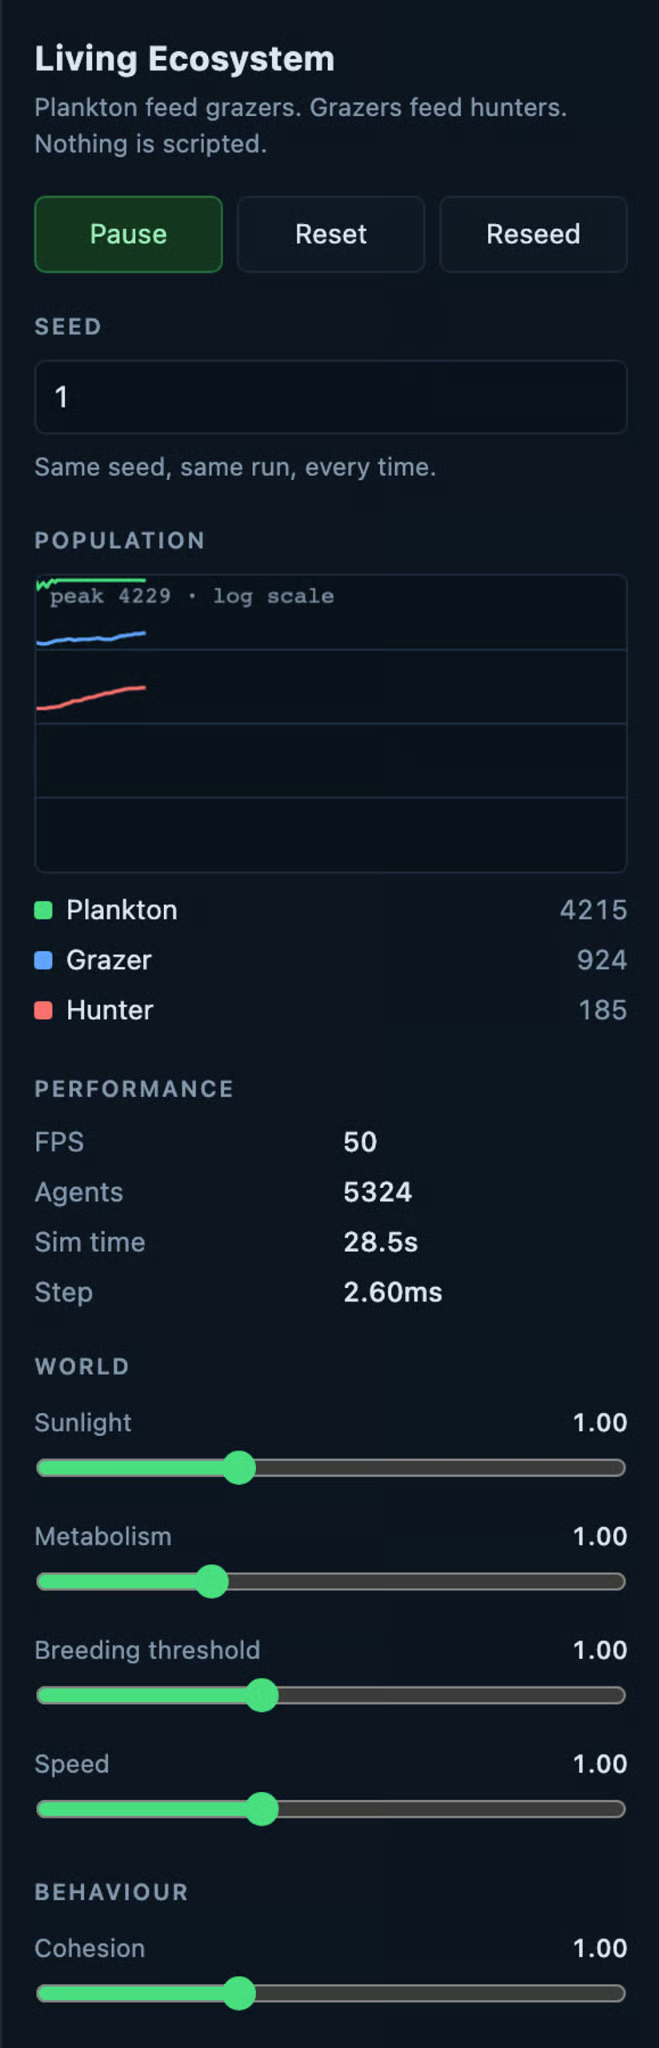
Panel parametrów Opus 5: 9 suwaków — każdy mnożnik startujący od 1,00 — pogrupowane w World i Behaviour.
Fable wystawia 13 parametrów w realnych jednostkach: wzrost roślin 5, promień percepcji 60, separacja 1,5 i metabolizm per gatunek. Opus wystawia 9, wszystkie jako znormalizowane mnożniki startujące od 1,00, podzielone na grupy World i Behaviour.
Jednym zdaniem: Fable daje ci więcej kontroli, a Opus daje panel, którym trudniej łatwo rozbić równowagę ekosystemu.
Jako domyślny wybierz Opus 5. W tym buildzie kosztował o 30% mniej, uruchamiał symulację 2,3x szybciej i napisał lepsze pokrycie testami. Fable wygrał szybkością ukończenia — skończył w około połowie czasu.
Sięgaj po Fable 5, gdy chcesz skończyć build w jednym przelocie przy minimalnym nadzorze albo gdy liczy się ślad zależności. Fable dostarczył program bez zależności, o 42% mniejszy od alternatywy, i zrobił to w 103 turach asystenta wobec 247. Ta zwięzłość ma realną wartość przy zadaniu, które planujesz sam potem przeczytać.
Dwa buildy jednego typu projektu to wciąż nie benchmark. Rzeczywista wydajność potrafi się mocno różnić mimo istniejących benchmarków.
Na przykład, choć nasze porównanie pokazało, że Fable używa więcej tokenów niż Opus, większość deweloperów dzieli się odwrotnym obrazem: Opus 5 spala znacznie więcej tokenów niż Fable czy Sol w podobnych zadaniach. Podejrzenie jest takie, że pretrenowanie RL w Opus 5 zbyt mocno zoptymalizowało go pod nabijanie kosztów tokenów zamiast pomoc przy zachowaniu zwięzłości. Poza porównaniem sam to czuję w pracy. Modele rodziny Opus stają się na powierzchni coraz bardziej rozwlekłe i trudniejsze w czytaniu.
Osobiście będę dalej używać Fable 5 przy prawie wszystkich moich projektach kodowych, także dla klientów, bo w długim biegu wygrywa dokładnością. Jestem na najnowszym planie Max i jeszcze nie dobiłem do limitów, nawet używając Fable w wielu sesjach (choć nie odpalam Claude Code non stop). Po Opus sięgnę, gdy liczy się rachunek za tokeny albo gdy chcę bieżącego komentarza do zadania dla lepszego zrozumienia.
Po więcej o modelach i narzędziach wokół nich polecam przeczytać nasz pełny przewodnik Claude Fable 5 oraz tutoriale o Claude Code i najlepszych praktykach Claude Code.
Naucz się korzystać z Claude Code z DataCamp!
Kurs
Kurs
Kurs