Kurs
Einführung in die Claude-Modelle
3 Std.
14.2K
Fable 5 ist ein coding-fokussiertes Modell in Anthrophics Claude‑5‑Familie, veröffentlicht am 9. Juni 2026. Es kam zusammen mit Mythos 5, einem Schwestermodell ohne Sicherheitsklassifizierer, das Anthropic nur einer kleinen Gruppe geprüfter Organisationen anbot. Eine vollständige Übersicht zum Release und wie sich Fable 5 in Benchmarks schlägt, findest du in unserem dedizierten Fable‑5‑Guide.
Fable 5 liegt preislich über Opus 5 und zielt auf die härteren Coding-Aufgaben. Der Hauptunterschied im Gefühl: Es denkt bei jeder Anfrage „mit“ und lässt sich nicht abschalten. Dadurch wirkt es langsamer und bedächtiger. Opus 5 entscheidet selbst, ob ein Prompt das zusätzliche Nachdenken wert ist.
Beide Modelle teilen sich Fenstergröße und maximale Ausgabe. Sie unterscheiden sich beim Preis und darin, wie das Denken gesteuert wird.
|
|
Fable 5 |
Opus 5 |
|
Input-Preis (pro 1 Mio. Tokens) |
$10 |
$5 |
|
Output-Preis (pro 1 Mio. Tokens) |
$50 |
$25 |
|
Kontextfenster |
1 Mio. Tokens |
1 Mio. Tokens |
|
Max. Ausgabe pro Anfrage |
128K Tokens |
128K Tokens |
|
Denken |
Immer aktiv (nicht deaktivierbar) |
Adaptiv (opt-in) |
|
Verweigerungsverhalten |
|
Standard |
Fable 5 kostet pro Token etwa doppelt so viel wie Opus 5. Weil das Denken immer aktiv ist, fallen pro Lauf auch mehr Tokens an. In der Praxis ist der Preisabstand daher größer als die reinen Token-Sätze vermuten lassen. Im direkten Build später in diesem Guide erzeugte Fable 74% mehr Output-Tokens als Opus – für ein kleineres Programm.
Für einen ausführlichen Vergleich inklusive Benchmark-Unterschieden lies unseren Claude Opus 5 vs Claude Fable 5 Guide.
Ein durchweg nerviger Aspekt von Fable 5 ist der eingebaute Sicherheitsklassifizierer. Weil das Modell als zu leistungsfähig gilt, lässt der Klassifizierer keine Anfragen zu, die auch nur entfernt mit Bereichen wie Biologie oder Cybersicherheit zu tun haben.
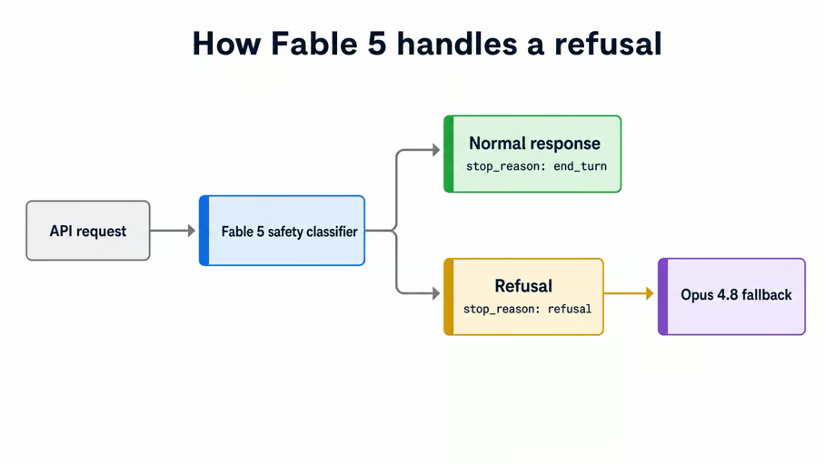
Bei einer Immunologin reichte allein das Wort „cancer“, um einen Biosecurity-Filter auszulösen – Claude Code fiel auf Opus 4.8 zurück.
Ich bin kürzlich selbst hineingelaufen – bei einem Login-Bug in einem privaten Projekt. Der Flow nutzte die Telegram Gateway API für OTP‑Sign‑in, und Fable 5 weigerte sich strikt, das anzufassen. Opus 5 erledigte die Aufgabe – was genau das Problem ist: An dem Bug war nichts sicherheitskritisch.
Automatischer Fallback ohne Konfiguration passiert nur in Claude Code und den Claude-Apps. Wenn du Fable über die API nutzt, bekommst du trotz HTTP‑200‑Erfolg ein stop_reason-Feld in der Antwort.
Die Antwort sieht so aus:
{
  \"stop_reason\": \"refusal\",
  \"stop_details\": {
	\"category\": \"bio\",
	\"explanation\": \"The request was declined by a safety classifier.\"
  }
}
Du musst also stop_reason prüfen, bevor du den Inhalt der Antwort verwendest.
Um Server-seitigen Fallback zu aktivieren, übergib ein fallbacks-Array (z. B. \"fallbacks\": [{\"model\": \"claude-opus-4-8\"}]) und schicke den Header anthropic-beta: server-side-fallback-2026-06-01. Setze ihn bei jeder Anfrage; es gibt keinen Account-weiten Schalter.
Vielleicht fragst du dich, warum manche Quellen sagen, Fable 5 falle auf Opus 4.8 zurück, andere aber auf Opus 5. Beides stimmt, denn das Ziel hängt von Kategorie und Oberfläche ab.
In Claude Code wird eine biologisch markierte Anfrage inzwischen auf Opus 5 neu ausgeführt, während eine Cybersicherheits-Anfrage weiterhin auf Opus 4.8 fällt. In der API unterstützt das Server-seitige fallbacks-Feature derzeit nur Opus 4.8.
Die Aufteilung ist ein Timing-Artefakt: Zum Fable‑Launch im Juni fiel alles auf Opus 4.8 zurück, und der Biologie-Pfad wurde später – nach dem Release von Opus 5 am 24. Juli – auf Opus 5 umgestellt.
Fable 5 hatte einen holprigen Start – selbst ohne den Sicherheitsklassifizierer.
Tage nach dem Launch berichtete Fortune, dass Anthropic Fable 5s Antworten bei etwa 0,03% des Traffics rund um KI- und ML-Infrastruktur stillschweigend abgeschwächt habe, ohne etwas mitzuteilen.
Viele Forschende und Entwickler waren sauer, weil sie für ein $200‑Abo ein Arbeitspferd unter den Frontier‑Modellen erwarteten, das jede Aufgabe anpackt.
Anthropic knickte innerhalb eines Tages unter dem Druck der Community ein und sagte, man habe „den falschen Trade-off gewählt“. Geändert wurde die Sichtbarkeit, nicht die Drossel. Markierte Anfragen werden nun wie Verweigerungen angezeigt, die Absenkung selbst blieb. Anthropic argumentiert, dass die Nutzungsbedingungen den Bau konkurrierender KI-Systeme mit Claude ohnehin untersagen – vertretbar. Es einen Monat lang still zu tun, war es nicht.
Dann kam es dicker. Ein offengelegter Jailbreak löste am 12. Juni eine Anordnung des US-Handelsministeriums aus, und Anthropic nahm Fable 5 und Mythos 5 weltweit für 19 Tage offline.
Anthropic wehrte sich die ganze Zeit vehement gegen den Rückruf. Man argumentierte, der Jailbreak sei eng begrenzt und auch von schwächeren Modellen findbar, sodass der Rückruf-Standard aus ihrer Sicht undurchsichtig wirkte. Beim Maßstab an sich hatten sie einen Punkt. Niemand hat je einen universellen Jailbreak gebaut, und kein Modell heute besteht diesen Standard. Das UK AI Safety Institute meldete Fortschritte in diese Richtung, aber nichts, was tatsächlich funktioniert.
Beim Maßstab selbst hatten sie einen Punkt, wenn auch nicht in der Darstellung. Universelle Jailbreaks existieren: Das UK AI Security Institute berichtet, sie für jedes getestete Frontier-System gefunden zu haben; sein Red‑Team baute einen gegen Fable 5 selbst – einstufig innerhalb von Stunden und binnen Tagen auf mehrstufige agentische Workflows erweitert, wie die Model Card von Fable 5 ausführt.
Strittig ist tatsächlich, ob dieser Maßstab einen Rückruf auslösen sollte – nicht, ob solche Jailbreaks möglich sind.
Anthropic lieferte einen stärkeren Klassifizierer und meldete eine Blockrate über 99%. Daraufhin hob das Handelsministerium die Kontrolle um den 30. Juni herum auf.
Der allgemeine Zugang kehrte am 1. Juli zurück – zu strengeren Bedingungen. Das versprochene zweiwöchige Fenster ohne Einschränkungen schrumpfte auf etwa eine Woche, und ein neues 50%-Wochenlimit bedeutete: Nach Überschreitung wird weitere Fable‑5‑Nutzung als Credits zum vollen Satz von $10 und $50 abgerechnet. Das reichte, um Abonnenten auf Reddit murren zu lassen.
Anthropic verlängerte die Frist zweimal und teilte die Policy dann am 20. Juli nach Plänen auf: Max und Team Premium behalten Fable 5 dauerhaft bei 50% der Wochenlimits, während Pro und Team Standard einen einmaligen $100‑Credit bekommen und danach zum API‑Satz zahlen. Mythos 5 kehrte nur für rund 100 geprüfte US‑Organisationen zurück – zuvor war das Programm breiter und international.
Unterm Strich ist Fable 5 ein starkes Modell in einer Zugangspolitik, die sich von Monat zu Monat verschiebt. Plane gelegentliche Fehlverweigerungen ein und verlass dich nicht darauf, dass die Ratenlimits dieses Monats im nächsten noch gelten.
Um beide Modelle unter identischen Bedingungen zu sehen, gab ich jedem denselben Job in einer frischen Claude‑Code‑Session. Danach las ich die kompletten Transkripte, die internen JSONL‑Dateien und bewertete beide fertigen Apps im Browser.
Mein erster Versuch für diesen Vergleich war ein URL‑Shortener. Das war ein Fehler. Beide Modelle bauten nahezu identische Apps – bis hin zu Theme und Feature‑Set. Ein URL‑Shortener hat eine offensichtliche Standardlösung, die in jedem Trainingsdatensatz steckt. Der Test maß nichts.
Also wählte ich eine Aufgabe ohne kanonische Antwort: eine Simulation eines lebenden Ökosystems. Drei Arten in einem Nahrungsnetz, Agenten, die schwärmen, jagen und verhungern, 5000 gleichzeitig auf dem Bildschirm, alles deterministisch aus einem Seed. Der Prompt verbietet Bibliotheken, die die harten Teile übernehmen würden – jedes Modell muss also eigene räumliche Abfragen, Steuerung und Populationsdynamik schreiben.
Hier ist der Prompt, den beide Modelle wortgleich erhielten:
Build a living ecosystem simulation that runs in the browser, and ship it end-to-end in one shot, without asking me any questions or pausing for confirmation. Make all decisions yourself and only stop when it is fully built, tested, and pushed to GitHub.

Requirements:

- A real-time canvas simulation of an ecosystem with at least three species in a food web (for example producers, herbivores, predators). Species interact: they eat, they are eaten, they reproduce, and they die.
- Agents move with steering behaviour — flocking among their own kind, and avoidance or pursuit across species.
- Each agent has an energy budget. Moving and reproducing cost energy, eating restores it, and running out kills the agent. Population levels must emerge from these rules rather than being scripted.
- The simulation must stay stable and interactive at 5000 agents. Show a live FPS counter and a live population graph per species.
- The whole world is generated from a numeric seed. The same seed must always produce the same run.
- Controls to pause, resume, reset, reseed, and tune the key simulation parameters live while it runs.
- Implement the simulation yourself: the steering, the spatial queries, the integration, and the population dynamics. Do not use a physics engine, a flocking library, a game engine, or a charting library. Plain canvas and your own code.
- Tests covering the core simulation logic.
- A README with setup and run instructions.

The simulation should run in the browser and be usable by someone who has never seen it before.

When it is complete, create a new GitHub repository with the gh CLI (which is already installed and authenticated) and push the project to it.
Die „Keine-Fragen“-Regel ist der Punkt. Sie zeigt, wie weit jedes Modell den Build eigenständig trägt – ohne dass jemand falsche Abzweige korrigiert. Jedes lief in einem eigenen leeren Verzeichnis, ohne Hinweis darauf, dass ein zweites Modell dieselbe Aufgabe hatte.
Die Aufgabe versteckt zudem vier objektive Tests in einem Ergebnis, das optisch wirkt.
Jedes dieser Probleme ist auf dem Bildschirm sichtbar – darum lässt sich eine hübsche Demo benoten.
Beide Builds sind live, du kannst den Vergleich selbst fahren statt mir zu glauben. Öffne sie nebeneinander und reseede jeweils:
Screenshots von beiden findest du weiter unten, falls du lieber liest als klickst. Fairer Hinweis: Die Screenshots sind verkleinert, um die gesamte Oberfläche zu zeigen – Details sind daher nicht glasklar.
Vor den Ergebnissen ein methodischer Hinweis, der fürs Verständnis zählt.
Claude Code kann auf Opus zurückfallen, wenn Fable 5s Sicherheitsklassifizierer ablehnt. Ein „Fable“-Label garantiert also nicht, dass wirklich alles Fable war. Statt anzunehmen, habe ich in beiden Transkripten bei jedem Assistant‑Event das Feld model protokolliert.
Glücklicherweise kam in meinem Vergleich jedes Event im Fable‑Lauf als claude-fable-5 zurück – alle 103. Und jedes Event im Opus‑Lauf als claude-opus-5 – alle 247. Kein Fallback in irgendeine Richtung. Die Zahlen unten beschreiben die Modelle auf dem Label.
Fable arbeitete leise. 56 Tool‑Calls und 429 Wörter Kommentar über den gesamten Build, verteilt auf 2 Textblöcke.
Opus arbeitete sichtbar. 137 Tool‑Calls – mehr als doppelt so viele – und 4.808 Wörter in 110 Blöcken. Bereinigt um Volumen überarbeiten beide Modelle ähnlich häufig: rund 2 Edits pro geschriebenem File.
Auch beim Tooling trennten sie sich. Fable lieferte Plain‑ES‑Module mit einem python3 -m http.server-Startskript und ganz ohne node_modules. Opus installierte Vite und Vitest und baute gegen eine echte Toolchain.
Die Zeiten unten messen nur aktive Arbeit. Ich nahm jeden Lauf vom ersten bis zum letzten Assistant‑Event und zog Leerlauf ab, in dem die Session wartete statt zu bauen.
|
Dimension |
Fable 5 |
Opus 5 |
|
Assistant‑Events |
103 |
247 |
|
Aktive Build‑Zeit |
25 Min |
48 Min |
|
Output‑Tokens |
243.442 |
139.920 |
|
Cache‑Reads |
11,3 Mio. |
26,4 Mio. |
|
Tool‑Calls |
56 (24 Bash, 19 Edit, 10 Write) |
137 (60 Bash, 51 Edit, 20 Write) |
|
Sichtbarer Text |
429 Wörter (2 Blöcke) |
4.808 Wörter (110 Blöcke) |
|
Gesamtkosten |
$28,70 |
$20,07 |
|
Gelieferte Dateien |
9, null Dependencies |
13, Vite + Vitest |
|
Codezeilen |
~1.010 |
~1.746 |
|
Tests |
16, alle grün |
58, alle grün |
|
|
Nein |
Ja |
|
Simulationsgeschwindigkeit |
3,14 ms/Tick bei 3.510 Agenten |
1,35 ms/Tick bei 4.368 Agenten |
|
Auf GitHub gepusht |
Ja |
Ja |
Fable war 43% teurer und erzeugte 74% mehr Output‑Tokens – für ein kleineres Programm. Weil es sein Denken nicht abschalten kann, laufen Kosten weiter, auch wenn es die Arbeit nicht braucht.
Beide Modelle bestanden alle objektiven Checks:
NaN.Opus ist pro Tick 2,3‑mal schneller. Es speichert Agenten in Typed Arrays – ein flaches Array pro Eigenschaft – und hält ein separates räumliches Gitter pro Spezies. Fable gibt jedem Agenten ein eigenes Objekt und nutzt ein gemeinsames, einheitliches Gitter für alle drei. Beides korrekt, aber Opus hat das schnellere Datenlayout.
Fables npm test-Skript läuft nicht. Geliefert wurde node --test test/. Node 26 interpretiert das als Modulpfad statt als Verzeichnis, wodurch der Befehl stirbt, bevor ein einziger Test startet. Die 16 Tests darunter sind okay und laufen, wenn du die Dateien explizit angibst. Der Entry Point in package.json ist fehlerhaft.
Kleiner Bug, großer Effekt – denn der eine Befehl, den Leser wirklich tippen, ist der, der scheitert. Fable bemerkte ihn nie – und das zählt: Der Prompt verlangte Tests und verifizierte sie auf einem Weg, den die eigenen Nutzer nicht gehen.
Opus hat kein entsprechendes Versagen. Seine 58 Tests laufen via npm test und bestehen. Beide Suiten testen das Relevante: Seed‑Determinismus, Energieerhaltung, Torus‑Wrapping und Langzeit‑Artenüberleben. Die Lücke liegt in der Tiefe, nicht der Art. Den einzigen zusätzlichen Check schrieb Opus: den 5000‑Agenten‑Stresstest – genau die Anforderung, die am ehesten bricht.
Die beiden Apps sehen völlig unterschiedlich aus – genau deshalb habe ich die Aufgabe gewechselt.
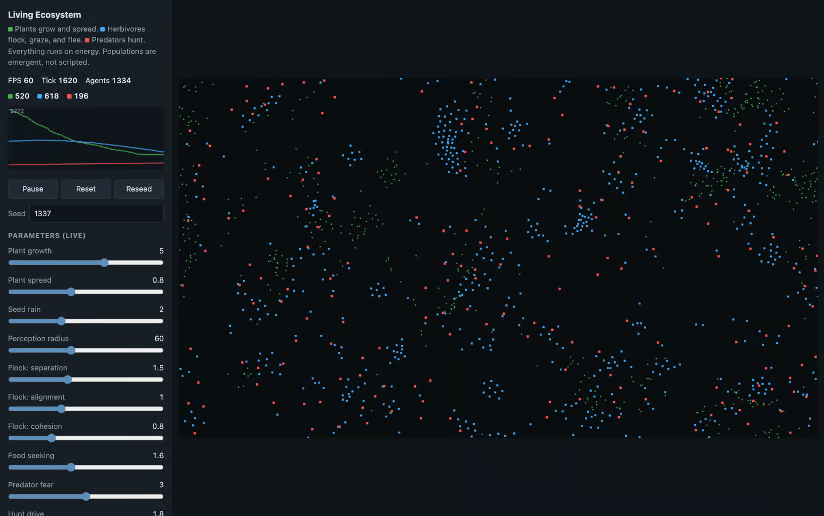
Fable 5: Steuerung links, Agenten als flache Quadrate, Spezies heißen Plants, Herbivores und Predators.
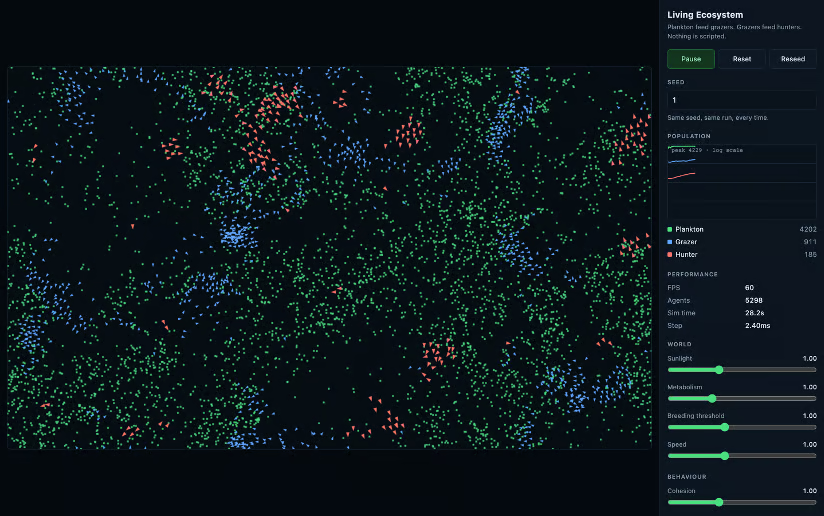
Opus 5: Steuerung rechts, Agenten als gerichtete Dreiecke, Spezies heißen Plankton, Grazers und Hunters.
Auf der UI‑Seite sind das die größten Unterschiede:
Bei den Populationsgrafiken wird der Designunterschied deutlich.
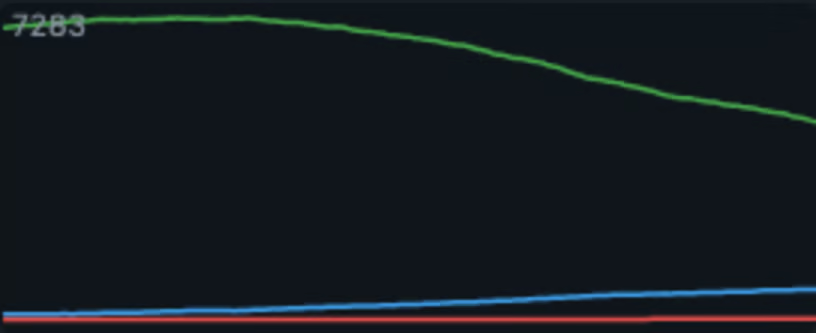
Fable 5s Grafik, lineare Skala. Die Pflanzenlinie belegt die volle Höhe, die Räuberlinie klebt unten.
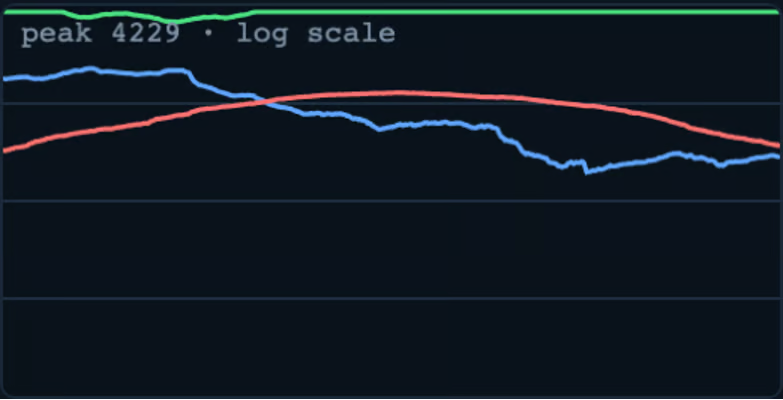
Opus 5s Grafik, logarithmische Skala. Alle drei Spezies bleiben lesbar, die Jägerlinie schneidet die Weidelinie.
Beide Simulationen oszillieren, wie es ein Räuber‑Beute‑System sollte. Fables Pflanzen schwanken in 5 Minuten zwischen 520 und 7.061, während Pflanzenfresser und Räuber hinterherzyklieren – Räuber peaken bei 248 genau dann, wenn Pflanzenfresser bei 119 am Boden sind.
Auf linearer Skala frisst die Pflanzenlinie den gesamten vertikalen Bereich, Pflanzenfresser komprimieren zu einem schmalen Band, Räuber liegen flach auf der Achse.
Darum stellte Opus die Grafik auf Log‑Skala und beschriftete die Peaks. Alle drei Spezies bleiben lesbar, und man sieht die Jägerlinie steigen, die Weidelinie schneiden und wieder fallen, wenn die Weide erholt. Gleiche Datenklasse – nur eine der zwei Charts ist lesbar.
Auch unter der Haube gibt es Unterschiede. Opus deckelt die Produzenten bei 4.229 Plankton, diese Population stößt also an die Decke, und nur die oberen zwei Spezies schwingen. Fable koppelt alle drei – das gibt größere Ausschläge und eine lebendigere Welt. Wir bekamen Stabilität gegen Dynamik, ohne es im Prompt gefordert zu haben.
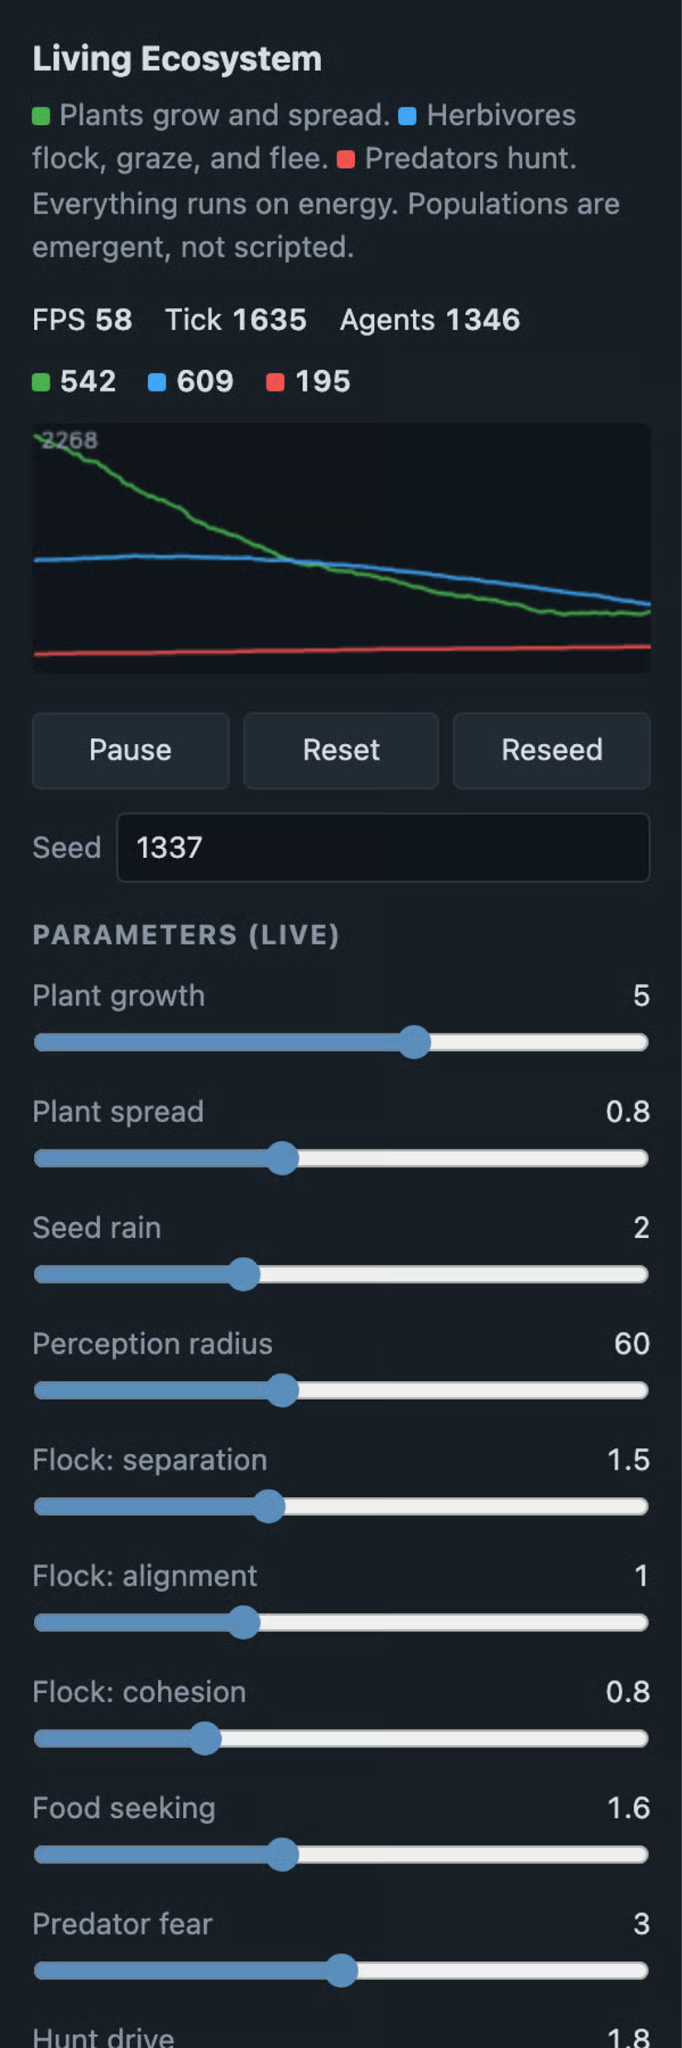
Fable 5s Parameter-Panel: 13 Regler in den Einheiten der Simulation.
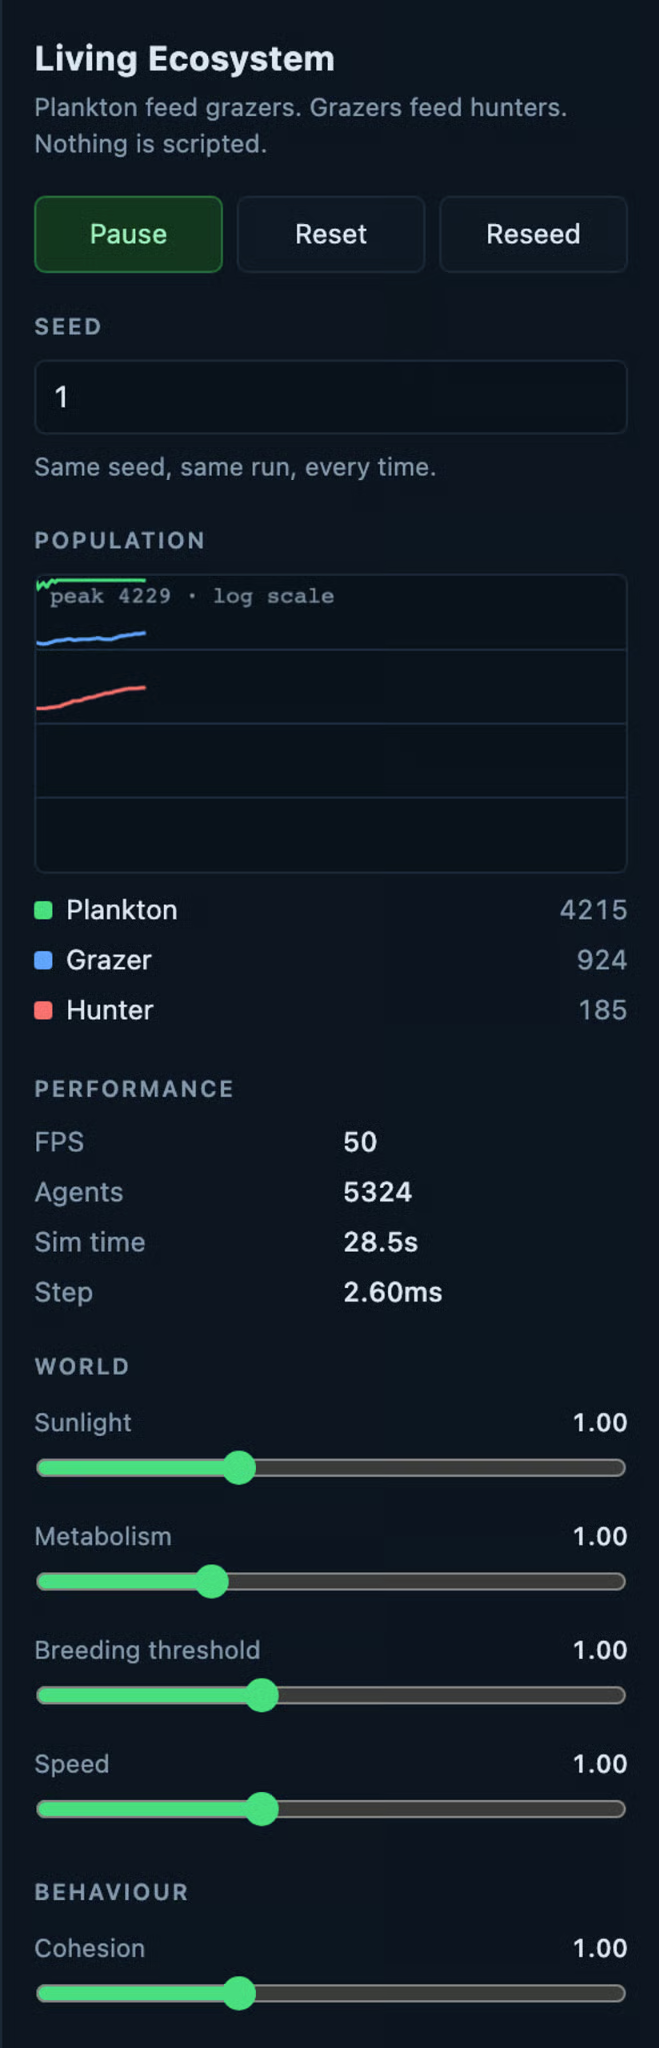
Opus 5s Panel: 9 Regler, jeweils Multiplikatoren ab 1,00, gruppiert in World und Behaviour.
Fable legt 13 Parameter in realen Einheiten offen: Pflanzwachstum 5, Wahrnehmungsradius 60, Separation 1,5 und Spezies‑spezifischer Metabolismus. Opus zeigt 9 Parameter, alles normalisierte Multiplikatoren ab 1,00, aufgeteilt in World und Behaviour.
Kurz: Fable gibt dir mehr Kontrolle, Opus ein Panel, mit dem du das Gleichgewicht nicht so leicht zerschießt.
Nutze Opus 5 als Standard. In diesem Build war es 30% günstiger, lief 2,3‑mal schneller pro Tick und schrieb die bessere Testabdeckung. Fable gewann bei der reinen Durchlaufzeit und war in etwa halb so lange beschäftigt.
Wechsle zu Fable 5, wenn du einen Build in einem Rutsch mit minimaler Aufsicht fertig haben willst – oder wenn der Dependency‑Footprint zählt. Fable lieferte ein Zero‑Dependency‑Programm, 42% kleiner als die Alternative, und kam mit 103 Assistant‑Turns statt 247 ans Ziel. Diese Knappheit hat echten Wert, wenn du die Aufgabe anschließend selbst lesen willst.
Zwei Builds eines Projekttyps sind noch kein Benchmark. Die Performance in der Praxis kann stark variieren – trotz existierender Benchmarks.
Zum Beispiel zeigte unser Vergleich zwar, dass Fable mehr Tokens als Opus nutzte, die meisten Entwickler berichten aber das Gegenteil: Opus 5 verbrennt bei ähnlichen Aufgaben deutlich mehr Tokens als Fable oder Sol. Der Verdacht: Opus 5s RL‑Pretraining hat es zu sehr darauf konditioniert, Tokenkosten zu maximieren statt hilfreich und prägnant zu sein. Abseits des Vergleichs habe ich das in meiner Arbeit durchaus gefühlt. Die Opus‑Familie wird an der Oberfläche immer wortreicher und schwerer zu lesen.
Ich persönlich werde Fable 5 weiterhin für fast alle meine Coding‑Projekte nutzen – auch für Kunden –, weil es auf lange Sicht bei der Genauigkeit gewinnt. Ich bin auf dem neuesten Max‑Plan und habe meine Limits noch nicht erreicht, selbst mit mehreren parallelen Fable‑Sessions (ich lasse Claude Code allerdings nicht non‑stop laufen). Opus nutze ich, wenn die Token‑Rechnung zählt oder wenn ich eine laufende Kommentierung für mein Verständnis möchte.
Für mehr zu den Modellen und dem Ökosystem drumherum empfehle ich, unseren vollständigen Claude‑Fable‑5‑Guide zu lesen – zusammen mit Tutorials zu Claude Code und Best Practices für Claude Code.
Lerne Claude Code mit DataCamp!
Kurs
Kurs
Kurs
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Sejal Jaiswal
9 Min.





