courses
개발자를 위한 AI 보조 코딩
1 시 30 분
10K
대부분의 LLM 앱은 간단한 패턴을 따릅니다. 프롬프트를 보내고, 응답을 받아서 애플리케이션에서 사용합니다.
간단한 작업에는 잘 맞지만, 모델이 코드를 작성하고, 실행하며, 결과를 확인하고, 파일을 다루고, 오류를 수정하고, 실제로 작업이 끝날 때까지 계속 진행해야 할 때는 상황이 훨씬 복잡해집니다.
이럴 때 OpenAI의 Agents API가 정말 유용합니다.
모든 단계를 직접 구현하는 대신, 에이전트에게 작업과 필요한 파일, 작업할 환경만 제공하면 나머지는 알아서 처리합니다.
이 튜토리얼에서는 예제를 간단히 유지하겠습니다. 작은 가상의 카페 매출 데이터셋을 만들어 에이전트에 제공하겠습니다. 에이전트는 분석을 작성하고 실행하며, 결과를 검증하고, 세 개의 출력 파일을 만들어 줍니다.
전체 동작을 백그라운드에서 어떻게 수행하는지 확인하면, 일반적인 코딩 워크플로의 상당 부분이 자동화되고 있음을 실감하실 겁니다.
AI 에이전트를 처음 접하신다면, 저희의 AI Agents 기초 스킬 트랙을 확인해 보시길 권합니다.
OpenAI Agents API는 에이전트에게 작업과 필요한 파일, 그리고 작업할 환경을 제공하고, 나머지는 에이전트가 처리하도록 할 수 있게 해줍니다.
샌드박스를 직접 만들고, 세션을 시작하고, 파일을 업로드하고, 코드를 실행하고, 오류를 확인하고, 모든 단계를 직접 관리하는 대신, 작업과 구성, 환경, 입력 파일을 담은 단 하나의 API 요청을 보낼 수 있습니다.
그다음 대부분의 작업은 Agents API가 처리합니다.
백그라운드에서는 OpenAI가 Codex 하니스를 관리하며, 오케스트레이션, 컨텍스트, 도구 사용, 실행, 장시간 세션 등을 포함합니다. 이는 마치 OpenAI Codex가 클라우드에서 애플리케이션을 위해 실행되는 것과 같습니다.
컴퓨팅 설정, 작업 환경 관리, 세션 추적, 전체 에이전트 루프 구축에 대해 예전만큼 신경 쓸 필요가 없습니다.
특히 에이전트가 단순히 답을 반환하는 것이 아니라 실제로 작업을 수행해야 하는 더 복잡하고 장시간의 작업에 유용합니다.
이 튜토리얼에서는 OpenAI 호스팅 샌드박스를 사용합니다:
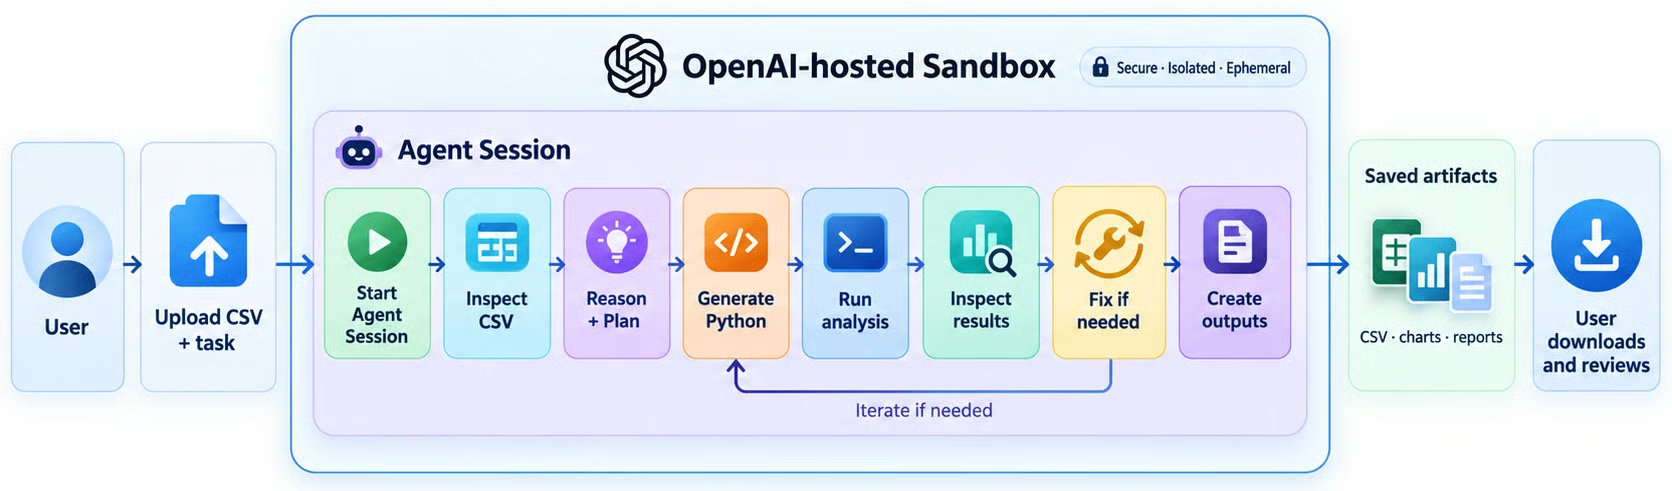
CSV 파일, 작업, 에이전트 구성을 포함한 요청 하나를 보냅니다.
그러면 Agents API가 세션과 샌드박스를 생성하고 관리합니다.
샌드박스 내부에서 에이전트는 파일을 확인하고, 분석 접근법을 고안하고, Python 코드를 생성해 실행하며, 결과를 점검하고 문제가 생기면 수정할 수 있습니다.
모든 작업이 끝나면 출력은 세션 아티팩트로 저장됩니다.
여기에는 차트, 정제된 데이터셋, 보고서, 에이전트가 생성한 기타 파일이 포함될 수 있습니다. 그런 다음 이 파일들을 가져와 사용자가 다운로드하고 검토할 수 있게 할 수 있습니다.
핵심 아이디어는 간단합니다. 작업을 한 번 보내면, 이후 실제 작업은 에이전트가 처리한다는 것입니다.
세 가지의 주요 차이는 워크플로를 얼마나 직접 관리하고 싶은지에 있습니다.
|
Responses API |
Agents SDK |
Agents API |
|
|
정의 |
모델 응답 및 도구 사용을 위한 API |
에이전트 애플리케이션을 구축하는 프레임워크 |
장시간 에이전트 작업 실행을 위한 관리형 API |
|
워크플로 |
애플리케이션이 워크플로를 제어 |
에이전트 루프와 오케스트레이션을 직접 구축 |
OpenAI가 실행의 더 많은 부분을 관리 |
|
핵심 기능 |
프롬프트, 도구, 구조화 출력 |
에이전트, 러너, 도구, 핸드오프, 가드레일 |
세션, 샌드박스, 파일, 코드 실행 |
|
적합한 용도 |
짧고 집중된 작업 |
커스텀 및 멀티 에이전트 애플리케이션 |
파일과 코드를 포함한 장문, 다단계 작업 |
|
예시 |
요약 또는 데이터 추출 |
고객 지원 에이전트 시스템 구축 |
지출 분석, 이상 지출 감지, 월간 보고서 생성 |
다음과 같은 집중 작업이 필요할 때는 Responses API를 사용하세요. 예: 요약, 추출, 분류, 질의응답, 구조화 출력, 소수의 도구 호출 등.
에이전트 애플리케이션을 직접 구축하고 에이전트, 도구, 핸드오프, 가드레일, 멀티 에이전트 워크플로를 더 세밀하게 제어하고 싶다면 Agents SDK를 사용하세요.
작업이 더 복잡하고 자체 작업 환경이 필요하다면 Agents API를 사용하세요. 에이전트가 파일을 다루고, 코드를 실행하며, 결과를 점검하고, 오류를 수정하고, 여러 단계를 거쳐 계속 진행해야 할 때 유용합니다.
이 튜토리얼에서는 에이전트가 파일을 다루고, 분석을 추론하며, 코드를 실행하고, 결과를 점검하고, 최종 아티팩트를 사용자에게 저장해야 하므로 Agents API를 사용합니다.
시작해 보겠습니다
이 튜토리얼에서는 Jupyter Notebook을 사용해 Agents API를 단계별로 테스트하고 각 부분이 어떻게 동작하는지 이해하겠습니다.
먼저 OpenAI 패키지를 설치하고, 튜토리얼 전반에 필요한 라이브러리를 임포트하겠습니다.
우선 OpenAI Python 패키지를 설치 또는 업그레이드하세요:
%pip install -q --upgrade openai그다음 사용할 라이브러리를 임포트합니다:
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
이제 OpenAI 클라이언트를 생성합니다:
client = OpenAI()OPENAI_API_KEY가 환경 변수에 설정되어 있는지 확인하세요. OpenAI 클라이언트가 자동으로 읽어 옵니다.
에이전트에 제공할 간단한 예시로 작은 가짜 매출 데이터셋을 만들겠습니다.
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
이는 다양한 제품, 지점, 날짜, 할인에 걸쳐 50개의 가짜 카페 주문을 생성합니다. 고정된 난수 시드를 사용하므로 노트북을 실행할 때마다 동일한 데이터셋이 생성됩니다.
이제 생성한 데이터를 에이전트에 전달할 수 있는 CSV 파일로 변환하겠습니다.
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
출력:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
또한 CSV를 Base64로 인코딩합니다. 파일을 에이전트 요청에 직접 포함해 보낼 것이기 때문입니다.
이제 CSV 파일을 가지고 에이전트가 수행해야 할 작업을 서술하겠습니다.
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
중요한 점은, 우리가 직접 분석 코드를 작성하는 대신 목표와 기대 산출물을 설명한다는 것입니다.
에이전트는 작업 방식을 스스로 결정하고, 코드를 실행하며, 완료 전에 결과를 검증할 수 있습니다.
이제 모든 것을 한 번의 요청으로 Agents API에 보내고, 실제 작업은 클라우드에서 에이전트가 수행하도록 하겠습니다.
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
대부분의 작업이 여기서 이루어집니다.
에이전트 구성, 호스팅 환경, CSV 파일, 작업을 하나의 요청으로 보냅니다.
OpenAI가 관리형 세션을 생성하고 호스팅 샌드박스 내부에서 에이전트를 실행합니다. 그러면 에이전트는 파일을 확인하고 analyze_sales.py를 작성하여 실행하고, 결과를 점검하고, 문제가 생기면 수정하며, 최종 출력 파일을 생성합니다.
세션 생성 엔드포인트는 동일한 요청에서 환경과 초기 입력을 모두 지원합니다.
요청에는 세 가지 주요 부분이 있습니다:
agent는 OpenAI에 어떤 모델을 사용할지와 에이전트의 동작 방식을 알려줍니다.environment는 에이전트에게 호스팅 작업 공간을 제공하고, 그 안에 우리의 CSV 파일을 배치합니다.input은 이전 섹션에서 정의한 작업을 제공합니다.또한 stream=True를 설정했습니다.
이는 작업 완료 방식 자체를 바꾸지는 않습니다. 다만 전체 턴이 끝날 때까지 기다리지 않고 에이전트가 작업하는 동안 이벤트를 수신할 수 있게 해줍니다.
이 예제에서는 agent.session.turn.output_text.delta 이벤트를 수신하고 최신 텍스트로 노트북을 계속 업데이트합니다.
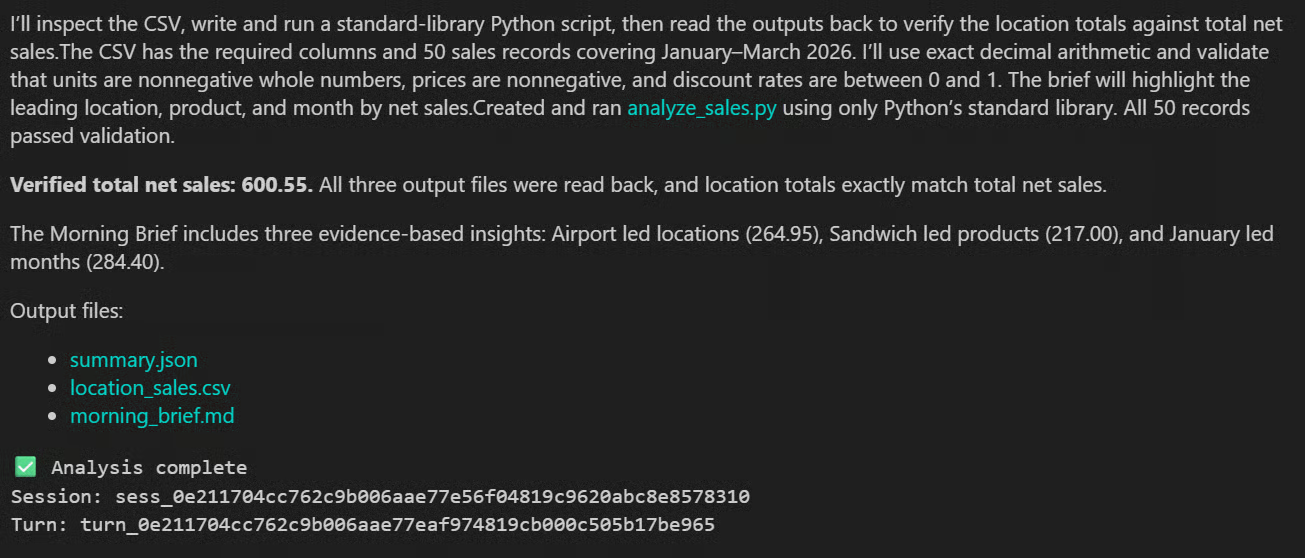
위에 나타나는 텍스트는 에이전트가 진행 상황과 최종 응답을 보고하는 것입니다.
실제 작업은 agent.session.turn.completed 이벤트를 받을 때까지 호스팅 환경에서 계속 실행됩니다.
제 실행에서는 에이전트가 analyze_sales.py를 생성하고 실행했으며, 생성된 파일을 확인하고 순매출 합계를 600.55로 검증했습니다.
중요한 점은, 모델이 어떤 Python 코드를 실행해야 하는지 말만 해준 것이 아니라, 에이전트가 실제로 코드를 작성하고 실행하며 결과를 점검하고, 출력까지 직접 검증했다는 것입니다.
이제 에이전트가 작업을 마쳤으니, 해당 턴 동안 생성된 파일을 다운로드할 수 있습니다.
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
출력:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
여기서는 세션의 아티팩트를 나열하고, 완료된 턴에서 생성된 것들을 남겨 로컬 cloud_bean_results 폴더에 다운로드합니다.
파일 처리가 끝나면, 관리형 환경을 불필요하게 유지하지 않도록 세션을 삭제하는 것이 좋습니다.
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
출력:
Session deleted: True이로써 API에서 관리형 세션이 제거됩니다.
OpenAI에 따르면, 기본 리소스의 물리적 정리는 삭제 요청이 반환된 이후에도 비동기적으로 계속될 수 있습니다.
이 단계는 특히 OpenAI 호스팅 샌드박스를 사용할 때 중요합니다.
샌드박스는 에이전트가 코드를 실행하고 파일을 다루는 컴퓨팅 환경이며, 호스팅 샌드박스는 모델 사용량과 별도로 컨테이너 컴퓨팅 비용이 청구됩니다.
따라서 세션과 환경을 필요 이상으로 실행 상태로 두면 컴퓨팅 비용이 계속 발생할 수 있습니다.
Agents API에서 특히 눈에 띄는 점은 단 하나의 간단한 API 호출로 할 수 있는 일이 정말 많다는 것입니다.
파일, 작업, 모델 구성, 호스팅 환경을 제공했습니다.
그다음은 에이전트가 알아서 처리했습니다. 작업 공간을 만들고, 데이터를 확인하고, Python 코드를 작성해 실행하며, 출력을 점검하고, 필요하면 수정하고, 최종 아티팩트를 생성했습니다.
이는 정말로 Codex가 클라우드에서 애플리케이션을 위해 실행되는 것처럼 느껴집니다.
컴퓨팅 설정, 실행 루프 관리, 중간 파일 처리, 각 단계 추적에 대해 신경 쓸 필요가 없었습니다. 저는 주로 작업을 잘 정의하고 결과를 확인하기만 하면 됐습니다.
실행 자체는 약 2분 정도 걸렸지만, 그 시간 동안 에이전트는 백그라운드에서 꽤 많은 작업을 수행했습니다.
이 점이 일반적인 API 요청과는 다른 부분입니다.
단순히 모델이 텍스트를 생성하기를 기다리는 것이 아니라, 에이전트가 실제 작업을 완료하기를 기다리는 것입니다.
제 테스트에서 이 예제를 세 번 실행하는 데 드는 비용은 모델 및 호스팅 환경 사용료를 포함해 총 $1.52 정도였습니다.
이렇게 작은 작업에는 저렴하다고 하긴 어렵기에, 프로덕션에서는 먼저 더 작거나 저렴한 모델을 테스트해 볼 것입니다.
하지만 코딩, 디버깅, 파일 처리, 추론, 상호 의존적인 여러 단계를 포함하는 더 복잡한 작업에는 추가 비용이 훨씬 더 합리적일 수 있습니다.
추천 DataCamp 강의
courses
tracks
courses