Courses
開発者のための AI 支援コーディング
1時間30分
10K
ほとんどの LLM アプリはシンプルなパターンに従います。プロンプトを送信し、応答を受け取り、その応答をアプリケーションで利用します。
これは簡単なタスクには有効ですが、モデルがコードを書き、実行し、結果を確認し、ファイルを扱い、エラーを修正し、タスクが本当に完了するまで続ける必要がある場合は、話が複雑になります。
そこで役立つのが OpenAI のAgents APIです。
すべての工程を自分で構築する代わりに、エージェントにタスク、必要なファイル、作業環境を与え、残りを任せることができます。
このチュートリアルでは例をシンプルに保ちます。小さな架空のカフェ売上データセットを作成してエージェントに渡します。エージェントは分析を作成して実行し、結果を検証し、3 つの出力ファイルを作成します。
裏側でどのように動作しているかを一通り見ると、通常のコーディングワークフローの大部分が自動化されていることに気づくはずです。
AI エージェントが初めての場合は、AI Agents Fundamentals スキルトラックをご覧ください。
OpenAI Agents APIは、エージェントにタスク、必要なファイル、作業環境を与え、残りを任せることができます。
サンドボックスの作成、セッション開始、ファイルのアップロード、コード実行、エラー確認、各工程の管理を手作業で行う代わりに、タスク、設定、環境、入力ファイルを含む1 回の API リクエストを送るだけで済みます。
その後の処理の大部分は Agents API が担います。
内部では、OpenAI がCodex ハーネスを管理し、オーケストレーション、コンテキスト、ツール利用、実行、長時間のセッションを処理します。これはまるで、アプリケーション向けにOpenAI Codexがクラウド上で稼働しているかのように考えることができます。
コンピュートのセットアップ、作業環境の管理、セッションの追跡、エージェントループの自作について、それほど気にする必要はありません。
特に、エージェントが単に答えを返すのではなく、実際に作業を行う必要がある、より複雑で長時間のタスクに有用です。
このチュートリアルでは、OpenAI ホスト型サンドボックスを使用します。
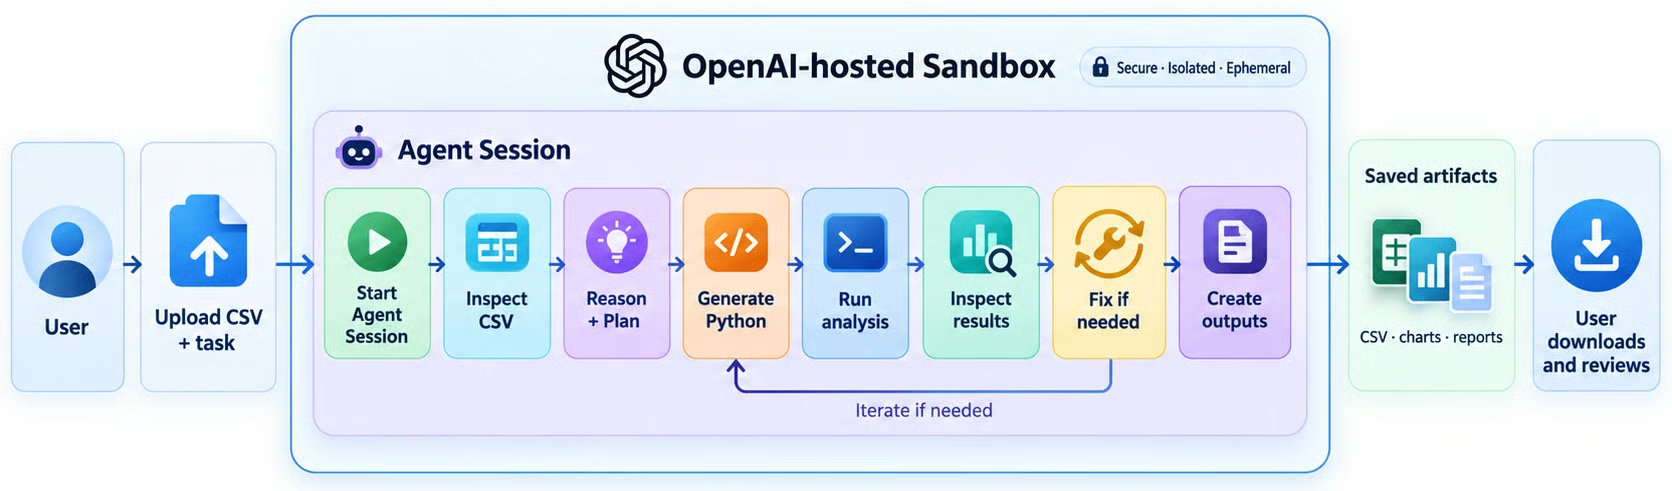
CSV ファイル、タスク、エージェント設定を 1 回のリクエストで送信します。
その後、Agents API がセッションとサンドボックスを作成・管理します。
サンドボックス内で、エージェントはファイルを確認し、分析の進め方を考え、Python コードを生成して実行し、結果をチェックし、問題があれば修正できます。
すべてが完了すると、出力はセッションアーティファクトとして保存されます。
これらはチャート、クリーンなデータセット、レポート、その他エージェントが作成したファイルであり、取得してユーザーがダウンロード・確認できます。
つまり主な考え方はシンプルです。タスクは一度送るだけで、そこから先の実作業はエージェントが担います。
この 3 つの主な違いは、ワークフローをどの程度自分で管理したいかにあります。
|
Responses API |
Agents SDK |
Agents API |
|
|
概要 |
モデル応答とツール利用のための API |
エージェントアプリを構築するためのフレームワーク |
長めのエージェントタスクを実行するマネージド API |
|
ワークフロー |
アプリケーション側でワークフローを制御 |
エージェントループとオーケストレーションを自作 |
OpenAI が実行の多くを管理 |
|
主な機能 |
プロンプト、ツール、構造化出力 |
エージェント、ランナー、ツール、ハンドオフ、ガードレール |
セッション、サンドボックス、ファイル、コード実行 |
|
適している用途 |
短く焦点の定まったタスク |
カスタムやマルチエージェントのアプリ |
ファイルとコードを伴う、長く多段のタスク |
|
例 |
要約やデータ抽出 |
カスタマーサポートのエージェントシステムを構築 |
経費を分析し、異常支出を検知し、月次レポートを作成 |
モデルに要約、抽出、分類、質問応答、構造化出力、少数のツール呼び出しなどの焦点の定まったタスクを完了させたい場合は、Responses APIを使ってください。
エージェント、ツール、ハンドオフ、ガードレール、マルチエージェントのワークフローをより細かく制御したい、エージェントアプリを自分で構築する場合は、Agents SDKを使用します。
タスクがより複雑で、専用の作業環境を必要とする場合は、Agents APIを使用します。エージェントがファイルを扱い、コードを実行し、結果を確認してエラーを修正し、複数ステップにわたって作業を継続する必要がある場合に有効です。
このチュートリアルでは、エージェントがファイルを扱い、分析を考え、コードを実行し、結果を確認し、最終成果物をユーザー向けに保存する必要があるため、Agents APIを使用します。
さっそく始めましょう
このチュートリアルでは、Jupyter Notebook を使って Agents API を一歩ずつ試し、各パートの動作を理解します。
まず OpenAI パッケージをインストールし、以降で必要なライブラリをインポートします。
まず OpenAI の Python パッケージをインストールまたはアップグレードします。
%pip install -q --upgrade openai次に使用するライブラリをインポートします。
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
OpenAI クライアントを作成します。
client = OpenAI()OPENAI_API_KEY が環境変数に設定されていることを確認してください。OpenAI クライアントは自動的に読み込みます。
エージェントに与えるため、簡単なフェイクの売上データセットを作成します。
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
これにより、製品・店舗・日付・割引が異なる 50 件の架空のカフェ注文が作成されます。固定の乱数シードを使っているため、ノートブックを実行するたびに同じデータセットが生成されます。
続いて、生成したデータをエージェントに渡せる CSV ファイルに変換します。
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
出力:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
また、ファイルをエージェントのリクエストに直接同梱するため、CSV を Base64 エンコードしています。
次に、CSV ファイルでエージェントに何をしてほしいかを記述します。
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
重要なのは、分析コード自体を書くのではなく、目標と期待する出力を記述している点です。
エージェントは、作業方法を決め、コードを実行し、完了前に結果を検証できます。
すべてを 1 回のリクエストで Agents API に送信し、実際の作業はクラウド上のエージェントに任せます。
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown("")
,    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
ここが主な処理の山場です。
エージェント設定、ホスト環境、CSV ファイル、タスクを 1 回のリクエストにまとめて送ります。
OpenAI がマネージドセッションを作成し、ホスト型サンドボックス内でエージェントを実行します。エージェントはファイルを確認し、analyze_sales.pyを書いて実行し、結果をチェックし、問題があれば修正し、最終出力ファイルを作成します。
セッション作成エンドポイントは、環境と初期入力を同一リクエストでサポートしています。
リクエストは主に 3 つのパートで構成されます。
agent は、使用するモデルとエージェントの振る舞いを指定します。environment は、エージェントのホスト型ワークスペースを与え、CSV ファイルを配置します。input は、前のセクションで定義したタスクを渡します。また、stream=True を設定しています。
これはタスクの完了方法を変えるものではありません。ターンが完全に終わるまで待つのではなく、エージェントの作業中にイベントを受け取れるようにするものです。
この例では、agent.session.turn.output_text.delta イベントを受け取り、ノートブックを最新のテキストで更新し続けます。
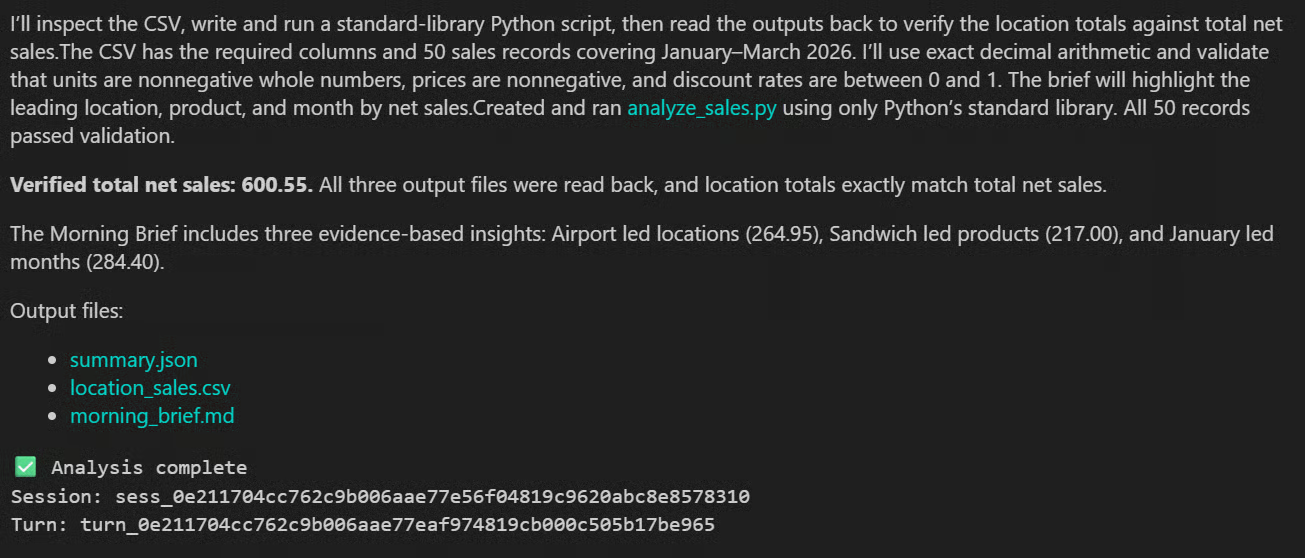
上に現れるテキストは、エージェントの進捗報告と最終応答です。
実際のタスクは、agent.session.turn.completed イベントを受け取るまで、ホスト環境内で実行され続けます。
私の実行では、エージェントは analyze_sales.py を作成して実行し、生成ファイルを確認し、純売上合計 600.55 を検証しました。
重要なのは、モデルが「実行すべき Python コード」を伝えただけではない点です。エージェントが実際にコードを書き、実行し、結果を検査し、自ら出力を検証しました。
エージェントの処理が終わったので、そのターンで作成されたファイルをダウンロードします。
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
出力:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
ここでは、セッションのアーティファクトを列挙し、完了したターンで作成されたものを選び、ローカルの cloud_bean_results フォルダにダウンロードしています。
ファイルの取得が済んだら、必要以上にマネージド環境を残さないよう、セッションを削除しましょう。
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
出力:
Session deleted: Trueこれにより、API からマネージドセッションが削除されます。
物理的なリソースのクリーンアップは、削除リクエストの返却後に非同期で継続する場合があると、OpenAI は述べています。
このステップは、特にOpenAI ホスト型サンドボックスを使用している場合に重要です。
サンドボックスは、エージェントがコードを実行しファイルを扱う計算環境であり、ホスト型サンドボックスはモデル利用とは別に、コンテナコンピュートとして課金されます(稼働時間ベース)。
そのため、必要以上にセッションや環境を稼働させ続けると、コンピュートコストが積み上がる可能性があります。
Agents API で印象的だったのは、たった 1 回のシンプルな API 呼び出しでこなせる範囲の広さです。
ファイル、タスク、モデル設定、ホスト環境を渡しました。
そこから先は、ワークスペースの作成、データの検査、Python コードの作成と実行、出力の確認、必要に応じた修正、最終的な成果物の生成まで、すべてを担ってくれました。
まさに、Codex がアプリケーション向けにクラウドで稼働している感覚です。
コンピュートのセットアップ、実行ループの管理、中間ファイルの取り扱い、各工程の追跡を心配する必要はありませんでした。主に、タスクをうまく定義し、結果を確認するだけでした。
実行自体はおよそ 2 分かかりましたが、その間にエージェントは裏側でかなり多くの処理を行っていました。
これが通常の API リクエストと異なる点です。
テキスト生成を待つだけではなく、エージェントが実際の作業を完了するのを待つのです。
私の検証では、この例を 3 回実行して、モデルとホスト環境の利用を含め、合計で$1.52ほどかかりました。
これほど小さなタスクとしては安くはないため、本番ではより小型または低コストのモデルを先に試すでしょう。
しかし、コーディングやデバッグ、ファイル操作、推論、相互依存する複数ステップを伴う複雑な作業では、追加コストは十分に合理的になり得ます。
おすすめの DataCamp コース
Courses
Tracks
Courses