
Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10K
La plupart des applications basées sur des LLM suivent un schéma simple : vous envoyez une invite, vous recevez une réponse, puis vous l’utilisez dans votre application.
Cela fonctionne bien pour des tâches simples, mais les choses se compliquent lorsque le modèle doit écrire du code, l’exécuter, vérifier le résultat, manipuler des fichiers, corriger les erreurs et poursuivre jusqu’à finaliser réellement la tâche.
C’est là que l’API Agents d’OpenAI devient particulièrement utile.
Au lieu de tout concevoir vous-même, vous donnez à l’agent la tâche, les fichiers nécessaires et un environnement de travail, puis vous le laissez gérer le reste.
Dans ce tutoriel, nous resterons simples. Nous allons créer un petit jeu de données fictif de ventes d’un café et le transmettre à l’agent. L’agent écrira et exécutera l’analyse, vérifiera les résultats et produira trois fichiers de sortie pour nous.
Une fois que vous verrez l’ensemble du processus en coulisses, vous réaliserez à quel point une grande partie du flux de travail de codage habituel est automatisée pour vous.
Si vous découvrez les agents d’IA, nous vous recommandons notre parcours de compétences AI Agents Fundamentals.
L’API OpenAI Agents vous permet de donner à un agent une tâche, les fichiers requis et l’environnement de travail, puis de le laisser gérer la suite.
Au lieu de créer manuellement un bac à sable, démarrer une session, téléverser des fichiers, exécuter du code, contrôler les erreurs et tout orchestrer vous-même, vous pouvez envoyer une seule requête API avec la tâche, la configuration, l’environnement et les fichiers d’entrée.
Ensuite, l’essentiel du travail est pris en charge par l’API Agents.
Sous le capot, OpenAI gère le Codex harness : orchestration, contexte, utilisation d’outils, exécution et sessions longues. Vous pouvez l’imaginer comme si vous aviez OpenAI Codex qui tourne dans le cloud au service de votre application.
Vous n’avez plus à vous soucier autant du provisionnement, de la gestion de l’environnement de travail, du suivi de la session ou de la construction de la boucle agent complète.
C’est particulièrement utile pour des tâches plus complexes et longues, où l’agent doit réellement exécuter le travail, pas seulement renvoyer une réponse.
Pour ce tutoriel, nous utiliserons un bac à sable hébergé par OpenAI :
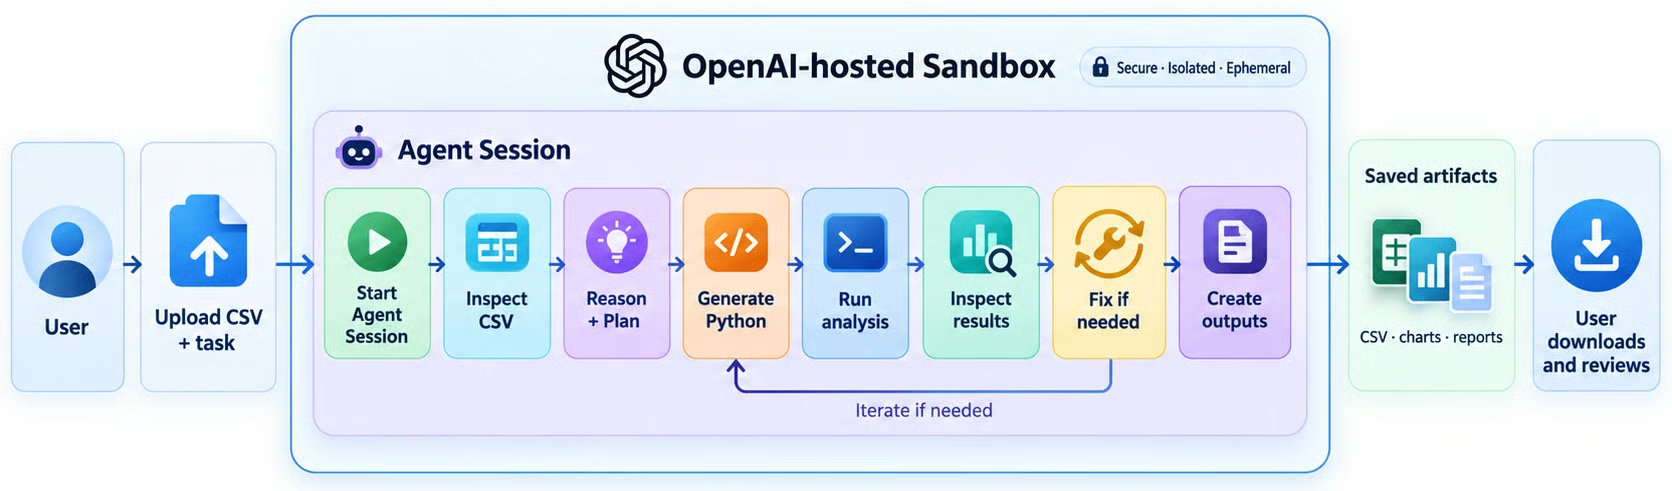
Nous envoyons une requête unique avec le fichier CSV, la tâche et la configuration de l’agent.
L’API Agents crée ensuite la session et le bac à sable, puis les gère pour nous.
À l’intérieur du bac à sable, l’agent peut explorer le fichier, déterminer l’approche d’analyse, générer du code Python, l’exécuter, vérifier les résultats et corriger si quelque chose se passe mal.
Une fois terminé, les sorties sont enregistrées comme artefacts de session.
Il peut s’agir de graphiques, de jeux de données nettoyés, de rapports ou de tout autre fichier créé par l’agent. Nous pouvons ensuite récupérer ces fichiers pour les proposer en téléchargement et en revue à l’utilisateur.
L’idée centrale est donc simple : nous envoyons une seule fois la tâche et l’agent prend en charge l’exécution réelle à partir de là.
La différence majeure entre ces trois options tient à la part du flux de travail que vous souhaitez gérer vous-même.
|
Responses API |
Agents SDK |
Agents API |
|
|
Ce que c’est |
API pour les réponses de modèle et l’usage d’outils |
Framework pour créer des applications d’agents |
API managée pour exécuter des tâches d’agent plus longues |
|
Flux de travail |
Votre application contrôle le flux |
Vous construisez la boucle agent et l’orchestration |
OpenAI prend en charge davantage l’exécution |
|
Fonctionnalités clés |
Prompts, outils, sorties structurées |
Agents, runners, outils, handoffs, garde-fous |
Sessions, bacs à sable, fichiers, exécution de code |
|
Idéal pour |
Tâches courtes et ciblées |
Applications sur mesure et multi-agents |
Tâches plus longues et multi-étapes impliquant fichiers et code |
|
Exemple |
Résumer ou extraire des données |
Construire un système d’agent de support client |
Analyser des dépenses, détecter des anomalies et produire des rapports mensuels |
Utilisez la Responses API quand vous avez besoin que le modèle accomplisse une tâche ciblée : résumé, extraction, classification, questions-réponses, sorties structurées ou quelques appels d’outils.
Utilisez le Agents SDK lorsque vous développez vous-même une application d’agent et souhaitez davantage de contrôle sur les agents, les outils, les handoffs, les garde-fous et les workflows multi-agents.
Utilisez l’Agents API lorsque la tâche est plus complexe et nécessite son propre environnement de travail. C’est utile lorsque l’agent doit manipuler des fichiers, exécuter du code, inspecter les résultats, corriger des erreurs et enchaîner plusieurs étapes.
Pour ce tutoriel, nous utilisons l’Agents API car l’agent doit travailler avec un fichier, raisonner sur l’analyse, exécuter du code, inspecter les résultats et enregistrer les artefacts finaux pour l’utilisateur.
Commençons
Nous allons utiliser un Jupyter Notebook pour tester l’Agents API étape par étape et comprendre le rôle de chaque composant.
Nous commencerons par installer le package OpenAI et importer les bibliothèques nécessaires pour la suite du tutoriel.
D’abord, installez ou mettez à jour le package Python OpenAI :
%pip install -q --upgrade openaiEnsuite, importez les bibliothèques que nous allons utiliser :
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
Créez maintenant le client OpenAI :
client = OpenAI()Assurez-vous que votre OPENAI_API_KEY est déjà défini dans votre environnement. Le client OpenAI le détectera automatiquement.
Nous allons créer un petit jeu de données de ventes factices pour fournir un exemple simple à l’agent.
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
Cela crée 50 commandes fictives du café, couvrant différents produits, lieux, dates et remises. Nous utilisons une graine aléatoire fixe pour générer le même jeu de données à chaque exécution du notebook.
Transformons ensuite les données générées en fichier CSV à transmettre à l’agent.
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
Sortie :
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
Nous encodons aussi le CSV en Base64 car nous enverrons le fichier directement avec la requête à l’agent.
Nous allons maintenant décrire ce que nous attendons de l’agent avec le fichier CSV.
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
L’essentiel est de décrire l’objectif et les sorties attendues, plutôt que d’écrire nous-mêmes le code d’analyse.
L’agent choisit comment réaliser le travail, exécute le code et vérifie les résultats avant de terminer.
Nous allons maintenant tout envoyer à l’API Agents en une seule requête et laisser l’agent travailler dans le cloud.
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
C’est ici que se déroule l’essentiel du travail.
Nous soumettons une requête unique contenant la configuration de l’agent, l’environnement hébergé, le fichier CSV et la tâche.
OpenAI crée la session managée et exécute l’agent dans le bac à sable hébergé. L’agent peut alors inspecter le fichier, écrire analyze_sales.py, l’exécuter, contrôler les résultats, corriger les problèmes et générer les fichiers finaux.
Le point de terminaison de création de session prend en charge à la fois l’environnement et l’entrée initiale dans la même requête.
La requête se compose de trois parties principales :
agent indique à OpenAI quel modèle utiliser et comment l’agent doit se comporter.environment fournit à l’agent son espace de travail hébergé et y place notre fichier CSV.input transmet à l’agent la tâche définie à l’étape précédente.Nous passons aussi stream=True.
Cela ne change pas la manière dont la tâche est exécutée. Cela nous permet simplement de recevoir des événements pendant que l’agent travaille, au lieu d’attendre la fin complète du tour avant de voir quoi que ce soit.
Dans cet exemple, nous écoutons les événements agent.session.turn.output_text.delta et mettons à jour le notebook avec le texte le plus récent.
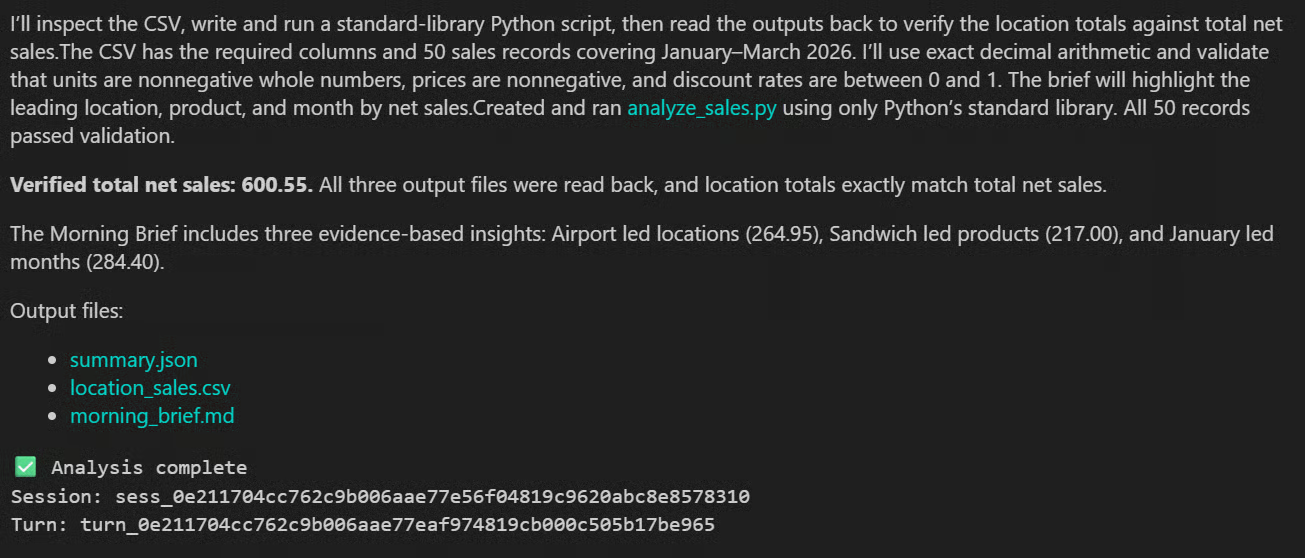
Le texte qui apparaît ci-dessus correspond donc aux mises à jour de progression et à la réponse finale de l’agent.
La tâche continue réellement de s’exécuter dans l’environnement hébergé jusqu’à la réception de l’événement agent.session.turn.completed.
Lors de mon exécution, l’agent a créé et exécuté analyze_sales.py, vérifié les fichiers générés et confirmé un total des ventes nettes de 600,55.
Le point important est que le modèle ne s’est pas contenté de nous dire quel code Python exécuter. L’agent a réellement écrit le code, l’a exécuté, a inspecté le résultat et a vérifié la sortie lui-même.
Maintenant que l’agent a terminé, nous pouvons télécharger les fichiers qu’il a créés pendant ce tour.
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
Sortie :
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
Ici, nous listons les artefacts de la session, conservons ceux créés par le tour complété et les téléchargeons dans le dossier local cloud_bean_results.
Une fois les fichiers récupérés, supprimez la session afin de ne pas conserver l’environnement managé plus longtemps que nécessaire.
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
Sortie :
Session deleted: TrueCela supprime la session managée de l’API.
OpenAI précise que le nettoyage physique des ressources sous-jacentes peut se poursuivre de façon asynchrone après la réponse à la requête de suppression.
Cette étape est particulièrement importante lorsque vous utilisez un bac à sable hébergé par OpenAI.
Le bac à sable est l’environnement de calcul où l’agent exécute du code et manipule des fichiers ; les bacs à sable hébergés utilisent une puissance de calcul conteneurisée facturée séparément de l’usage du modèle.
Donc si vous laissez des sessions et des environnements tourner plus longtemps que nécessaire, vous pouvez engendrer des coûts additionnels de calcul.
Ce qui m’a frappé avec l’Agents API, c’est tout ce qu’elle peut faire à partir d’un simple appel d’API.
Nous lui avons fourni le fichier, la tâche, la configuration du modèle et l’environnement hébergé.
À partir de là, elle a tout géré : création de l’espace de travail, inspection des données, écriture du code Python, exécution, contrôle des sorties, corrections si besoin, et production des artefacts finaux.
On a vraiment l’impression d’avoir Codex qui tourne dans le cloud pour votre application.
Je n’ai pas eu à me soucier du provisionnement, de la gestion de la boucle d’exécution, de la manipulation des fichiers intermédiaires ni du suivi de chaque étape. Il m’a surtout fallu bien définir la tâche, puis analyser le résultat.
L’exécution a pris environ deux minutes, mais pendant ce temps, l’agent a réalisé beaucoup de choses en arrière-plan.
C’est ce qui la différencie d’une requête API classique.
Vous n’attendez pas seulement qu’un modèle génère du texte. Vous attendez qu’un agent accomplisse réellement une tâche.
Dans mes tests, trois exécutions de cet exemple ont coûté environ 1,52 $ au total, incluant l’usage du modèle et de l’environnement hébergé.
Pour une tâche aussi modeste, ce n’est pas donné ; en production, je testerais donc d’abord des modèles plus petits ou moins coûteux.
Mais pour des travaux plus complexes impliquant codage, débogage, fichiers, raisonnement et étapes dépendantes, le surcoût peut être largement justifié.
Les meilleurs cours DataCamp
Cours
Cursus
Cours