
Cursus
AI-ondersteund coderen voor developers
1 Hr 30 Min
10K
De meeste LLM-apps volgen een eenvoudig patroon: stuur een prompt, ontvang een antwoord en gebruik dat antwoord in je applicatie.
Dat werkt goed voor simpele taken, maar het wordt ingewikkelder wanneer het model code moet schrijven, uitvoeren, het resultaat controleren, met bestanden werken, fouten herstellen en doorgaan totdat de taak echt klaar is.
Dit is waar OpenAI's Agents API echt van pas komt.
In plaats van elke stap zelf te bouwen, kun je de agent de taak geven, de benodigde bestanden en een werkomgeving, en de rest laten afhandelen.
In deze tutorial houd ik het voorbeeld simpel. We maken een kleine fictieve dataset met cafeverkopen en geven die aan de agent. De agent schrijft en draait de analyse, verifieert de resultaten en maakt drie uitvoerbestanden voor ons.
Zodra je ziet hoe alles achter de schermen werkt, ga je beseffen hoeveel van de gebruikelijke codeworkflow voor je wordt geautomatiseerd.
Als AI-agents nieuw voor je zijn, raad ik aan om onze Skill track AI Agents Fundamentals te bekijken.
De OpenAI Agents API laat je een agent een taak geven, de benodigde bestanden en de omgeving waarin hij moet werken, en vervolgens de rest laten afhandelen.
In plaats van handmatig een sandbox te maken, een sessie te starten, bestanden te uploaden, code te draaien, fouten te controleren en elke stap zelf te beheren, kun je één API-verzoek sturen met de taak, configuratie, omgeving en invoerbestanden.
Daarna wordt het meeste werk door de Agents API afgehandeld.
Onder de motorkap beheert OpenAI het Codex-harnas, inclusief orkestratie, context, toolgebruik, uitvoering en langlopende sessies. Je kunt het bijna zien als OpenAI Codex dat in de cloud voor jouw applicatie draait.
Je hoeft je minder druk te maken over het opzetten van compute, het beheren van de werkomgeving, het bijhouden van de sessie of het zelf bouwen van de volledige agent-loop.
Dit is vooral handig voor complexere en langlopende taken waarbij de agent het werk echt moet doen, en niet alleen een antwoord hoeft te geven.
Voor deze tutorial gebruiken we een door OpenAI gehoste sandbox:
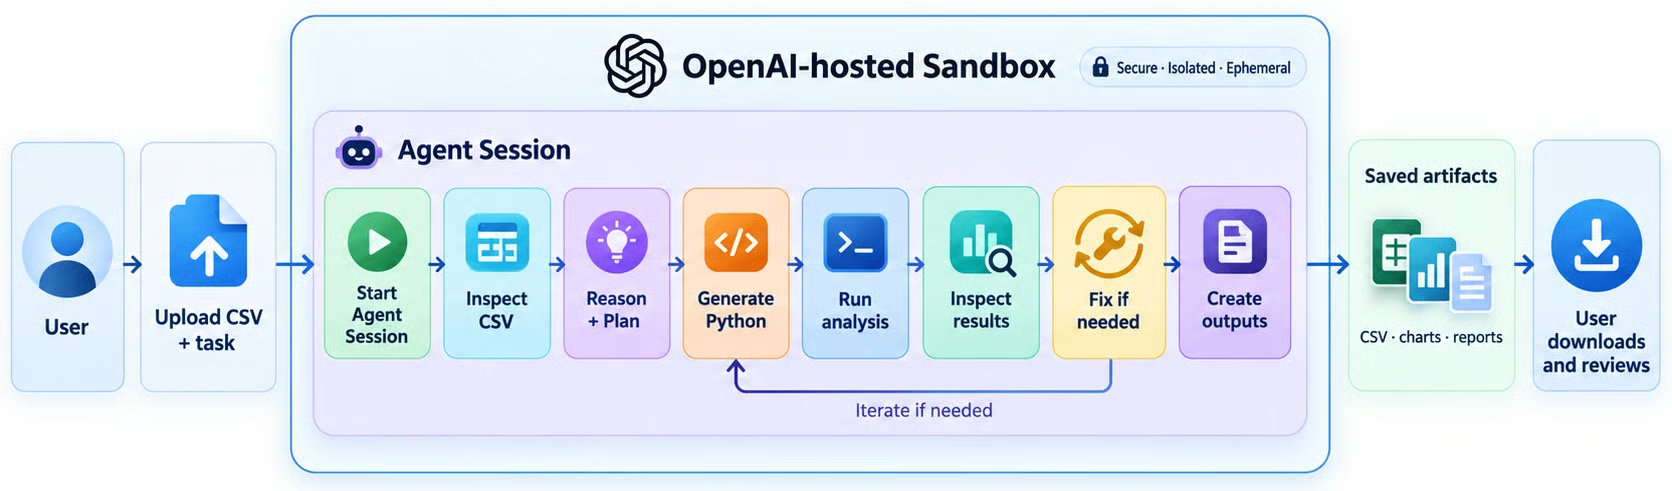
We sturen één verzoek met het CSV-bestand, de taak en de agentconfiguratie.
De Agents API maakt en beheert vervolgens de sessie en sandbox voor ons.
Binnen de sandbox kan de agent naar het bestand kijken, bepalen hoe de analyse aan te pakken, Python-code genereren, die draaien, de resultaten controleren en dingen repareren als er iets misgaat.
Als alles klaar is, worden de outputs opgeslagen als sessie-artifacts.
Dit kunnen grafieken zijn, opgeschoonde datasets, rapporten of andere bestanden die de agent maakt. We kunnen die bestanden vervolgens ophalen en de gebruiker laten downloaden en bekijken.
Het idee is dus simpel: wij sturen de taak één keer, en de agent doet vanaf daar het echte werk.
Het belangrijkste verschil tussen deze drie is hoeveel van de workflow je zelf wilt beheren.
|
Responses API |
Agents SDK |
Agents API |
|
|
Wat het is |
API voor modelantwoorden en toolgebruik |
Framework voor het bouwen van agent-applicaties |
Beheerde API voor het draaien van langere agenttaken |
|
Workflow |
Jouw applicatie stuurt de workflow |
Je bouwt de agent-loop en orkestratie |
OpenAI beheert meer van de uitvoering |
|
Belangrijkste features |
Prompts, tools, gestructureerde outputs |
Agents, runners, tools, handoffs, guardrails |
Sessies, sandboxes, bestanden, code-uitvoering |
|
Beste voor |
Korte, gerichte taken |
Custom en multi-agentapplicaties |
Langere, meerstaps taken met bestanden en code |
|
Voorbeeld |
Samenvatten of data extraheren |
Bouw een klantenservice-agentsysteem |
Uitgaven analyseren, ongebruikelijke uitgaven detecteren en maandrapporten bouwen |
Gebruik de Responses API wanneer je wilt dat het model een gerichte taak afrondt, zoals samenvatten, extractie, classificatie, vraagbeantwoording, gestructureerde outputs of een paar tool-calls.
Gebruik de Agents SDK wanneer je zelf een agentapplicatie bouwt en meer controle wilt over agents, tools, handoffs, guardrails en multi-agentworkflows.
Gebruik de Agents API wanneer de taak complexer is en een eigen werkomgeving nodig heeft. Dit is nuttig wanneer de agent met bestanden moet werken, code moet draaien, resultaten inspecteren, fouten herstellen en doorgaan over meerdere stappen.
Voor deze tutorial gebruiken we de Agents API omdat de agent met een bestand moet werken, moet redeneren over de analyse, code draaien, de resultaten inspecteren en de uiteindelijke artifacts voor de gebruiker moet opslaan.
Laten we beginnen
Voor deze tutorial gebruiken we een Jupyter Notebook om de Agents API stap voor stap te testen en te begrijpen hoe elk onderdeel werkt.
We beginnen met het installeren van het OpenAI-pakket en het importeren van de libraries die we verderop nodig hebben.
Installeer of upgrade eerst het OpenAI Python-pakket:
%pip install -q --upgrade openaiImporteer daarna de libraries die we gebruiken:
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
Maak nu de OpenAI-client aan:
client = OpenAI()Zorg dat je OPENAI_API_KEY al in je omgeving is gezet. De OpenAI-client pikt die automatisch op.
We maken een kleine nepverkopendataset zodat we iets eenvoudigs aan de agent kunnen geven.
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
Dit maakt 50 nepbestellingen voor een café over verschillende producten, locaties, data en kortingen. We gebruiken een vaste random seed zodat elke keer dat we het notebook draaien dezelfde dataset wordt gegenereerd.
Vervolgens zetten we de gegenereerde data om in een CSV-bestand dat aan de agent kan worden doorgegeven.
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
Output:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
We coderen de CSV ook in Base64 omdat we het bestand direct met het agentverzoek meesturen.
Nu beschrijven we wat we willen dat de agent met het CSV-bestand doet.
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
Het belangrijkste is dat we het doel en de verwachte outputs beschrijven, in plaats van zelf de analysecodes te schrijven.
De agent kan zelf beslissen hoe het werk te doen, de code draaien en de resultaten verifiëren voordat hij afrondt.
Nu sturen we alles in één verzoek naar de Agents API en laten we de agent het eigenlijke werk in de cloud doen.
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
Hier gebeurt het meeste werk.
We doen één verzoek met de agentconfiguratie, gehoste omgeving, CSV-bestand en taak.
OpenAI maakt de beheerde sessie en draait de agent in de gehoste sandbox. De agent kan vervolgens het bestand inspecteren, analyze_sales.py schrijven, uitvoeren, de resultaten controleren, alles repareren wat misgaat en de uiteindelijke uitvoerbestanden maken.
De endpoint voor het maken van de sessie ondersteunt zowel de omgeving als de initiële input in hetzelfde verzoek.
Er zijn drie hoofdonderdelen van het verzoek:
agent vertelt OpenAI welk model te gebruiken en hoe de agent zich moet gedragen.environment geeft de agent zijn gehoste werkruimte en plaatst ons CSV-bestand erin.input geeft de agent de taak die we in de vorige sectie hebben gedefinieerd.We zetten ook stream=True.
Dit verandert niet hoe de taak wordt afgerond. Het zorgt er alleen voor dat we events kunnen ontvangen terwijl de agent werkt, in plaats van te wachten tot de hele beurt klaar is voordat we iets zien.
In dit voorbeeld luisteren we naar agent.session.turn.output_text.delta-events en blijven we het notebook bijwerken met de nieuwste tekst.
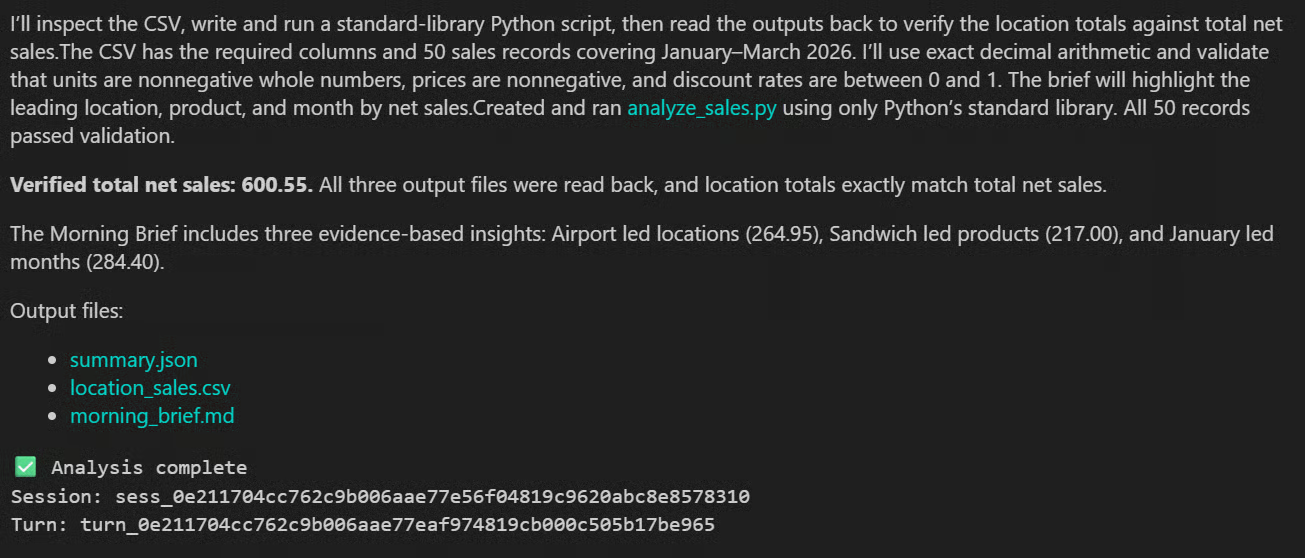
De tekst die we hierboven zien verschijnen is dus de agent die zijn voortgang en eindantwoord rapporteert.
De eigenlijke taak blijft draaien in de gehoste omgeving totdat we het event agent.session.turn.completed ontvangen.
In mijn run maakte en draaide de agent analyze_sales.py, controleerde de gegenereerde bestanden en verifieerde de totale nettoumslag van 600,55.
Belangrijk is dat het model ons niet alleen vertelde welke Python-code we moesten draaien. De agent schreef de code, voerde die uit, bekeek het resultaat en verifieerde de output zelf.
Nu de agent klaar is, kunnen we de bestanden downloaden die hij tijdens die beurt heeft gemaakt.
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
Output:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
Hier lijsten we de artifacts uit de sessie op, houden we die van de voltooide beurt bij, en downloaden we ze naar onze lokale map cloud_bean_results.
Als we klaar zijn met de bestanden, moeten we de sessie verwijderen zodat we de beheerde omgeving niet langer laten draaien dan nodig.
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
Output:
Session deleted: TrueDit verwijdert de beheerde sessie uit de API.
OpenAI merkt op dat de fysieke opschoning van de onderliggende resources asynchroon kan doorgaan nadat het delete-verzoek is teruggekeerd.
Deze stap is vooral belangrijk bij gebruik van een door OpenAI gehoste sandbox.
De sandbox is de compute-omgeving waar de agent code draait en met bestanden werkt, en gehoste sandboxes gebruiken containercompute die apart wordt gefactureerd van het modelgebruik.
Dus als je sessies en omgevingen langer laat draaien dan nodig, kun je blijven computekosten toevoegen.
Wat mij opviel aan de Agents API is hoeveel hij kan doen met één simpele API-call.
We gaven het het bestand, de taak, de modelconfiguratie en de gehoste omgeving.
Vanaf daar regelde het de rest: het maakte de werkruimte, inspecteerde de data, schreef de Python-code, draaide die, controleerde de outputs, herstelde waar nodig en leverde de uiteindelijke artifacts op.
Het voelt echt als Codex dat in de cloud voor je applicatie draait.
Ik hoefde me niet druk te maken over het opzetten van compute, het beheren van de uitvoeringsloop, het afhandelen van tussenbestanden of het bijhouden van elke stap. Ik hoefde vooral de taak goed te definiëren en daarna naar het resultaat te kijken.
De run zelf duurde ongeveer twee minuten, maar in die tijd deed de agent achter de schermen behoorlijk veel.
Dat is wat dit anders maakt dan een normaal API-verzoek.
Je wacht niet gewoon tot een model tekst genereert. Je wacht tot een agent daadwerkelijk een stuk werk afrondt.
In mijn tests kostten drie runs van dit voorbeeld in totaal ongeveer $1,52, inclusief het model- en gehoste omgevinggebruik.
Voor zo'n kleine taak is dat niet goedkoop, dus voor productie zou ik zeker eerst kleinere of goedkopere modellen testen.
Maar voor complexer werk met coderen, debuggen, bestanden, redeneren en meerdere afhankelijke stappen kan de extra kost veel logischer zijn.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus