course
Kodowanie wspomagane przez AI dla programistów
1 godz. 30 min
10K
Większość aplikacji z LLM działa według prostego schematu: wysyłasz prompt, dostajesz odpowiedź i używasz jej w swojej aplikacji.
To sprawdza się przy prostych zadaniach, ale robi się trudniej, gdy model musi napisać kod, uruchomić go, sprawdzić wynik, pracować z plikami, naprawiać błędy i kontynuować aż do faktycznego ukończenia zadania.
Tu właśnie przydaje się Agents API od OpenAI.
Zamiast budować każdy krok samodzielnie, możesz przekazać agentowi zadanie, pliki, których potrzebuje, oraz środowisko pracy i pozwolić mu zająć się resztą.
W tym samouczku przykład będzie prosty. Stworzymy mały fikcyjny zbiór danych sprzedaży kawiarni i przekażemy go agentowi. Agent napisze i uruchomi analizę, zweryfikuje wyniki oraz przygotuje dla nas trzy pliki wyjściowe.
Gdy zobaczysz, jak to wszystko działa pod spodem, zaczniesz dostrzegać, jak wiele z typowego cyklu pracy programisty jest za ciebie automatyzowane.
Jeśli dopiero zaczynasz z agentami AI, polecam nasz ścieżkę umiejętności AI Agents Fundamentals.
OpenAI Agents API pozwala przekazać agentowi zadanie, potrzebne pliki i środowisko pracy, a następnie oddać mu realizację reszty.
Zamiast ręcznie tworzyć piaskownicę, startować sesję, przesyłać pliki, uruchamiać kod, sprawdzać błędy i zarządzać każdym krokiem, możesz wysłać jedno żądanie API zawierające zadanie, konfigurację, środowisko i pliki wejściowe.
Dalej większość pracy wykonuje Agents API.
Pod spodem OpenAI zarządza harnessem Codex, w tym orkiestracją, kontekstem, użyciem narzędzi, wykonaniem i długimi sesjami. Możesz myśleć o tym niemal jak o OpenAI Codex działającym w chmurze dla twojej aplikacji.
Nie musisz już tak bardzo martwić się o konfigurację zasobów obliczeniowych, zarządzanie środowiskiem pracy, śledzenie sesji czy budowanie całej pętli agenta samodzielnie.
To szczególnie przydatne przy bardziej złożonych, długotrwałych zadaniach, w których agent musi faktycznie wykonać pracę, a nie tylko zwrócić odpowiedź.
W tym samouczku użyjemy piaskownicy hostowanej przez OpenAI:
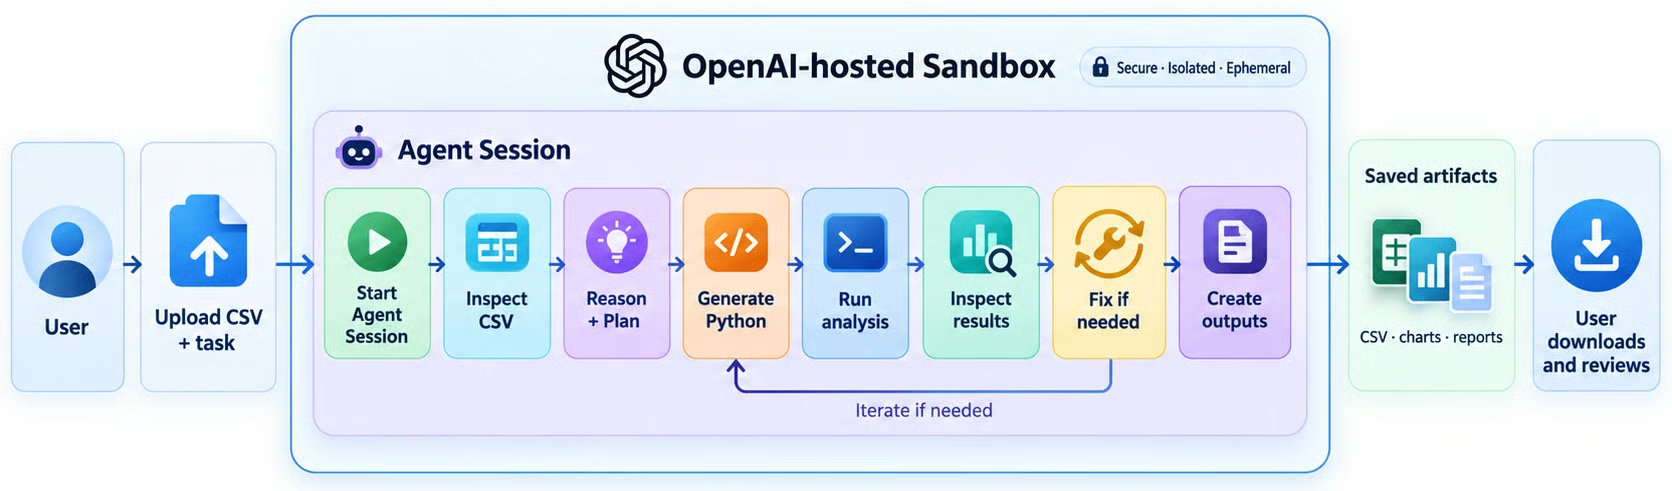
Wysyłamy jedno żądanie z plikiem CSV, zadaniem i konfiguracją agenta.
Agents API tworzy i zarządza za nas sesją i piaskownicą.
Wewnątrz piaskownicy agent może obejrzeć plik, ustalić podejście do analizy, wygenerować kod w Pythonie, uruchomić go, sprawdzić wyniki i poprawić rzeczy, jeśli coś pójdzie nie tak.
Gdy wszystko będzie gotowe, wyjścia zostaną zapisane jako artefakty sesji.
Mogą to być wykresy, oczyszczone zbiory danych, raporty lub inne pliki utworzone przez agenta. Możemy następnie pobrać te pliki i pozwolić użytkownikowi je ściągnąć i przejrzeć.
Główna idea jest więc prosta: wysyłamy zadanie raz, a agent od tego momentu wykonuje właściwą pracę.
Główna różnica między tymi trzema polega na tym, jak dużą częścią przepływu pracy chcesz zarządzać samodzielnie.
|
Responses API |
Agents SDK |
Agents API |
|
|
Czym jest |
API do odpowiedzi modelu i użycia narzędzi |
Framework do budowania aplikacji agentowych |
Zarządzane API do uruchamiania dłuższych zadań agentów |
|
Przepływ pracy |
Twoja aplikacja kontroluje przepływ |
Budujesz pętlę agenta i orkiestrację |
OpenAI zarządza większą częścią wykonania |
|
Kluczowe funkcje |
Prompty, narzędzia, ustrukturyzowane wyjścia |
Agenci, uruchamiacze, narzędzia, przekazania, zabezpieczenia |
Sesje, piaskownice, pliki, wykonywanie kodu |
|
Najlepsze do |
Krótkie, skupione zadania |
Własne i wieloagentowe aplikacje |
Dłuższe, wieloetapowe zadania z plikami i kodem |
|
Przykład |
Streszczanie lub ekstrakcja danych |
Zbuduj system agenta obsługi klienta |
Analiza wydatków, wykrywanie nietypowych kosztów i tworzenie miesięcznych raportów |
Użyj Responses API, gdy potrzebujesz, by model wykonał skupione zadanie, takie jak streszczanie, ekstrakcja, klasyfikacja, Q&A, ustrukturyzowane wyjścia lub kilka wywołań narzędzi.
Użyj Agents SDK, gdy sam budujesz aplikację agentową i chcesz mieć większą kontrolę nad agentami, narzędziami, przekazaniami, zabezpieczeniami i przepływami wieloagentowymi.
Użyj Agents API, gdy zadanie jest bardziej złożone i wymaga własnego środowiska pracy. Przydaje się, gdy agent musi pracować z plikami, uruchamiać kod, sprawdzać wyniki, naprawiać błędy i kontynuować przez wiele kroków.
W tym samouczku użyjemy Agents API, ponieważ agent musi pracować z plikiem, rozumować nad analizą, uruchomić kod, przejrzeć wyniki i zapisać końcowe artefakty dla użytkownika.
Zaczynajmy
W tym samouczku użyjemy Jupyter Notebooka, aby krok po kroku przetestować Agents API i zrozumieć, jak działa każda część.
Zaczniemy od instalacji pakietu OpenAI i zaimportowania bibliotek potrzebnych w dalszej części.
Najpierw zainstaluj lub zaktualizuj pakiet OpenAI dla Pythona:
%pip install -q --upgrade openaiNastępnie zaimportuj biblioteki, których użyjemy:
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
Teraz utwórz klienta OpenAI:
client = OpenAI()Upewnij się, że twój OPENAI_API_KEY jest ustawiony w środowisku. Klient OpenAI wykryje go automatycznie.
Stworzymy mały, fikcyjny zbiór danych sprzedaży, aby mieć coś prostego do przekazania agentowi.
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
To tworzy 50 fikcyjnych zamówień kawiarni dla różnych produktów, lokalizacji, dat i rabatów. Używamy stałego ziarna losowości, więc za każdym uruchomieniem notatnika powstaje ten sam zbiór danych.
Następnie zamienimy wygenerowane dane na plik CSV, który można przekazać agentowi.
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
Wyjście:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
Kodujemy też CSV w Base64, ponieważ wyślemy plik bezpośrednio z żądaniem do agenta.
Teraz opiszemy, co agent ma zrobić z plikiem CSV.
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
Kluczowe jest to, że opisujemy cel i oczekiwane wyjścia, zamiast samemu pisać kod analizy.
Agent może zdecydować, jak wykonać pracę, uruchomić kod i zweryfikować wyniki, zanim zakończy.
Teraz wyślemy wszystko do Agents API w jednym żądaniu i pozwolimy agentowi wykonać właściwą pracę w chmurze.
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
Tu dzieje się większość pracy.
Wysyłamy jedno żądanie zawierające konfigurację agenta, hostowane środowisko, plik CSV i zadanie.
OpenAI tworzy zarządzaną sesję i uruchamia agenta w hostowanej piaskownicy. Agent może następnie przejrzeć plik, napisać analyze_sales.py, uruchomić go, sprawdzić wyniki, naprawić wszystko, co się nie uda, i utworzyć końcowe pliki wyjściowe.
Punkt końcowy tworzenia sesji obsługuje zarówno środowisko, jak i dane wejściowe w tym samym żądaniu.
W żądaniu są trzy główne części:
agent mówi OpenAI, którego modelu użyć i jak ma się zachowywać agent.environment daje agentowi hostowaną przestrzeń roboczą i umieszcza w niej nasz plik CSV.input przekazuje agentowi zadanie zdefiniowane w poprzedniej sekcji.Ustawiamy też stream=True.
To nie zmienia sposobu realizacji zadania. Po prostu pozwala otrzymywać zdarzenia w trakcie pracy agenta zamiast czekać na zakończenie całej tury, zanim cokolwiek zobaczymy.
W tym przykładzie nasłuchujemy zdarzeń agent.session.turn.output_text.delta i na bieżąco aktualizujemy notatnik najnowszym tekstem.
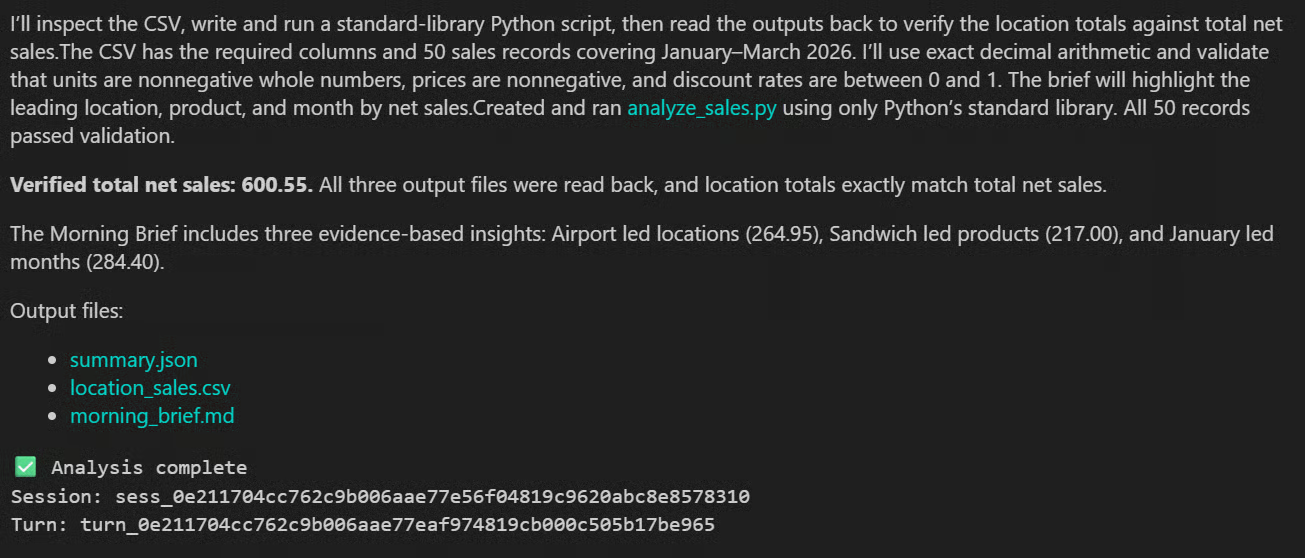
Tekst, który widzimy powyżej, to raportowanie postępu i końcowej odpowiedzi przez agenta.
Samo zadanie działa w hostowanym środowisku aż do momentu otrzymania zdarzenia agent.session.turn.completed.
Podczas mojego uruchomienia agent utworzył i uruchomił analyze_sales.py, sprawdził wygenerowane pliki i zweryfikował łączną sprzedaż netto na poziomie 600,55.
Ważne jest to, że model nie tylko powiedział nam, jaki kod Pythona uruchomić. Agent faktycznie napisał kod, wykonał go, obejrzał wynik i sam zweryfikował output.
Skoro agent skończył, możemy pobrać pliki, które utworzył podczas tej tury.
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
Wyjście:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
Tutaj wypisujemy artefakty z sesji, zachowujemy te utworzone przez zakończoną turę i pobieramy je do lokalnego folderu cloud_bean_results.
Gdy skończymy pracę z plikami, powinniśmy usunąć sesję, aby nie utrzymywać zarządzanego środowiska dłużej niż to konieczne.
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
Wyjście:
Session deleted: TrueTo usuwa zarządzaną sesję z API.
OpenAI zaznacza, że fizyczne czyszczenie zasobów może trwać asynchronicznie po zwróceniu odpowiedzi na żądanie usunięcia.
Ten krok jest szczególnie ważny, gdy używasz piaskownicy hostowanej przez OpenAI.
Piaskownica to środowisko obliczeniowe, w którym agent uruchamia kod i pracuje z plikami, a hostowane piaskownice używają kontenerów obliczeniowych rozliczanych osobno względem użycia modelu.
Jeśli więc utrzymujesz sesje i środowiska dłużej niż potrzeba, możesz generować dodatkowe koszty obliczeń.
To, co najbardziej zwróciło moją uwagę w Agents API, to jak wiele potrafi zrobić po jednym prostym wywołaniu API.
Przekazaliśmy mu plik, zadanie, konfigurację modelu i hostowane środowisko.
Od tego momentu zajął się resztą: utworzył przestrzeń roboczą, obejrzał dane, napisał kod w Pythonie, uruchomił go, sprawdził wyjścia, w razie potrzeby coś poprawił i przygotował finalne artefakty.
To naprawdę przypomina Codex działający w chmurze dla twojej aplikacji.
Nie musiałem martwić się o konfigurację zasobów, zarządzanie pętlą wykonania, obsługę plików pośrednich ani śledzenie każdego kroku. W zasadzie musiałem tylko dobrze zdefiniować zadanie i obejrzeć wynik.
Samo uruchomienie zajęło około dwóch minut, ale w tym czasie agent robił sporo rzeczy w tle.
I to odróżnia to od zwykłego żądania do API.
Nie czekasz tylko, aż model wygeneruje tekst. Czekasz, aż agent faktycznie wykona kawałek pracy.
W moich testach trzy uruchomienia tego przykładu kosztowały w sumie około 1,52 USD, wliczając użycie modelu i hostowanego środowiska.
Przy tak małym zadaniu to nie jest tanio, więc w produkcji na pewno najpierw przetestowałbym mniejsze lub tańsze modele.
Ale przy bardziej złożonej pracy obejmującej kodowanie, debugowanie, pliki, rozumowanie i wiele zależnych kroków, dodatkowy koszt może mieć dużo więcej sensu.
Najlepsze kursy DataCamp
course
Track
course