course
AI-assisterad kodning för utvecklare
1 tim 30 min
10K
De flesta LLM-appar följer ett enkelt mönster: skicka en prompt, få ett svar och använd det svaret i din applikation.
Det fungerar bra för enklare uppgifter, men det blir mer komplicerat när modellen behöver skriva kod, köra den, kontrollera resultatet, arbeta med filer, fixa fel och fortsätta tills uppgiften faktiskt är färdig.
Det är här OpenAI:s Agents API blir riktigt användbart.
I stället för att bygga varje steg själv kan du ge agenten uppgiften, filerna den behöver och en miljö att arbeta i och låta den sköta resten.
I den här handledningen håller jag exemplet enkelt. Vi skapar ett litet fiktivt försäljningsdataset för ett kafé och ger det till agenten. Agenten kommer att skriva och köra analysen, verifiera resultaten och skapa tre utdatafiler åt oss.
När du ser allt fungera bakom kulisserna inser du hur mycket av det vanliga kodarbetsflödet som automatiseras åt dig.
Om du är ny till AI-agenter rekommenderar jag att du kollar in vår kompetensspår i AI Agent Fundamentals.
Med OpenAI Agents API kan du ge en agent en uppgift, filerna den behöver och den miljö den ska arbeta i och sedan låta den sköta resten.
I stället för att manuellt skapa en sandbox, starta en session, ladda upp filer, köra kod, kontrollera fel och själv hantera varje steg kan du skicka en API-begäran med uppgiften, konfigurationen, miljön och indatafilerna.
Efter det hanteras det mesta av arbetet av Agents API.
Under huven hanterar OpenAI Codex-harnessen, inklusive orkestrering, kontext, användning av verktyg, exekvering och långvariga sessioner. Du kan nästan tänka på det som att ha OpenAI Codex körandes i molnet för din applikation.
Du behöver inte oroa dig lika mycket för att sätta upp beräkningsresurser, hantera arbetsmiljön, hålla reda på sessionen eller bygga hela agentloopen själv.
Det här är särskilt användbart för mer komplexa och långvariga uppgifter där agenten faktiskt behöver göra jobbet, inte bara returnera ett svar.
I den här handledningen kommer vi att använda en OpenAI-hostad sandbox:
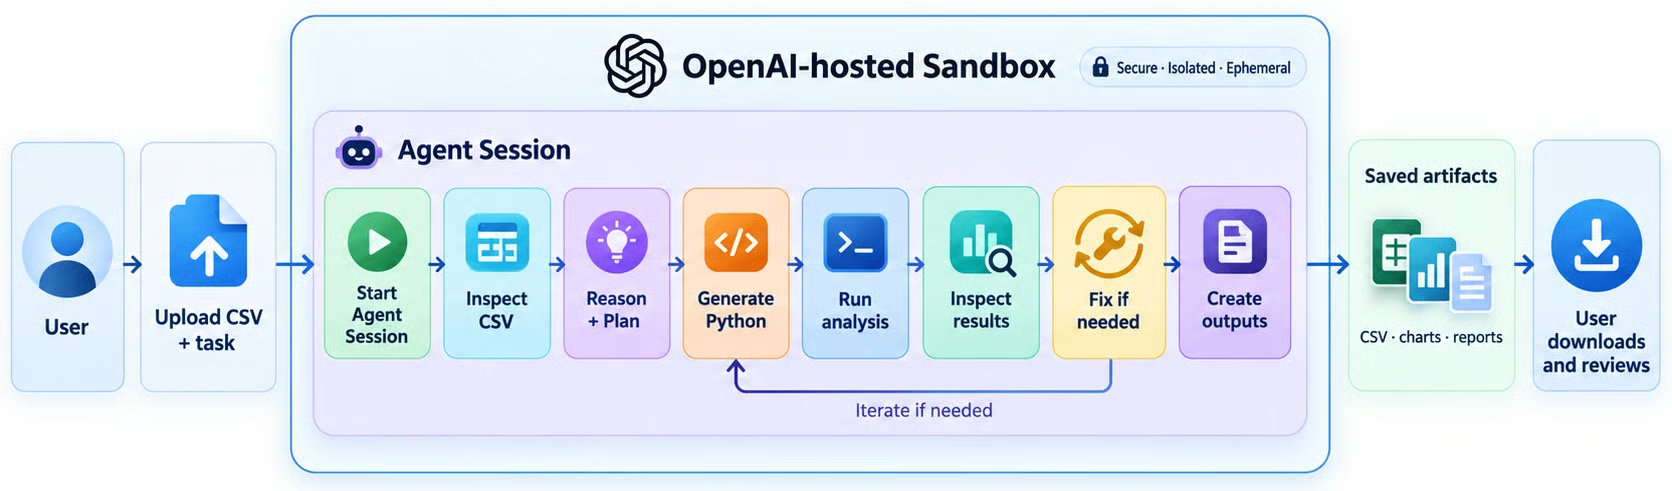
Vi skickar en begäran med CSV-filen, uppgiften och agentkonfigurationen.
Agents API skapar och hanterar sedan sessionen och sandlådan åt oss.
Inuti sandboxen kan agenten titta på filen, lista ut hur analysen ska göras, generera Python-kod, köra den, kontrollera resultaten och fixa saker om något blir fel.
När allt är klart sparas utdata som sessionsartefakter.
Dessa kan vara diagram, städade dataset, rapporter eller andra filer som agenten skapar. Vi kan sedan hämta dessa filer och låta användaren ladda ner och granska dem.
Så huvudidén är enkel: vi skickar uppgiften en gång, och agenten sköter själva arbetet därifrån.
Den stora skillnaden mellan dessa tre är hur mycket av arbetsflödet du själv vill hantera.
|
Responses API |
Agents SDK |
Agents API |
|
|
Vad det är |
API för modellsvar och verktygsanvändning |
Ramverk för att bygga agentapplikationer |
Hanterat API för att köra längre agentuppgifter |
|
Arbetsflöde |
Din applikation styr arbetsflödet |
Du bygger agentloopen och orkestreringen |
OpenAI hanterar mer av exekveringen |
|
Nyckelfunktioner |
Prompter, verktyg, strukturerade utdata |
Agenter, körningar, verktyg, överlämningar, skyddsräcken |
Sessioner, sandlådor, filer, kodexekvering |
|
Bäst för |
Korta, fokuserade uppgifter |
Anpassade och multi-agent-applikationer |
Längre, flerstegsuppgifter som involverar filer och kod |
|
Exempel |
Sammanfatta eller extrahera data |
Bygg ett kundsupportsystem med agenter |
Analysera utgifter, upptäck ovanlig konsumtion och bygg månadsrapporter |
Använd Responses API när du behöver att modellen slutför en fokuserad uppgift, till exempel sammanfattning, extraktion, klassificering, frågesvar, strukturerade utdata eller några få verktygsanrop.
Använd Agents SDK när du bygger en agentapplikation själv och vill ha mer kontroll över agenter, verktyg, överlämningar, skyddsräcken och multi-agent-arbetsflöden.
Använd Agents API när uppgiften är mer komplex och behöver en egen arbetsmiljö. Det är användbart när agenten behöver arbeta med filer, köra kod, inspektera resultat, fixa fel och fortsätta över flera steg.
För den här handledningen använder vi Agents API eftersom agenten behöver arbeta med en fil, resonera om analysen, köra kod, inspektera resultaten och spara de slutliga artefakterna åt användaren.
Nu kör vi igång
I den här handledningen använder vi en Jupyter Notebook för att testa Agents API steg för steg och förstå hur varje del fungerar.
Vi börjar med att installera OpenAI-paketet och importera de bibliotek vi behöver för resten av handledningen.
Installera eller uppgradera först OpenAI:s Python-paket:
%pip install -q --upgrade openaiImportera sedan biblioteken vi ska använda:
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
Skapa nu OpenAI-klienten:
client = OpenAI()Säkerställ att din OPENAI_API_KEY redan är satt i din miljö. OpenAI-klienten läser in den automatiskt.
Vi skapar ett litet fejkat försäljningsdataset så att vi har något enkelt att ge agenten.
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
Detta skapar 50 fejkade kafébeställningar över olika produkter, platser, datum och rabatter. Vi använder ett fast slumpfrö så att samma dataset genereras varje gång vi kör notebooken.
Nästa steg är att omvandla de genererade uppgifterna till en CSV-fil som kan skickas till agenten.
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
Utdata:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
Vi Base64-kodar också CSV-filen eftersom vi kommer att skicka filen direkt med agentbegäran.
Nu beskriver vi vad vi vill att agenten ska göra med CSV-filen.
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
Det viktiga är att vi beskriver målet och förväntade utdata, i stället för att skriva analyskoden själva.
Agenten kan själv bestämma hur arbetet ska utföras, köra koden och verifiera resultaten innan den avslutar.
Nu skickar vi allt till Agents API i en begäran och låter agenten göra det faktiska arbetet i molnet.
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
Det är här det mesta av arbetet sker.
Vi gör en begäran som innehåller agentkonfigurationen, den hostade miljön, CSV-filen och uppgiften.
OpenAI skapar den hanterade sessionen och kör agenten i den hostade sandlådan. Agenten kan sedan inspektera filen, skriva analyze_sales.py, köra den, kontrollera resultaten, fixa eventuella fel och skapa de slutliga utdatafilerna.
Endpointen för att skapa sessionen stödjer både miljön och det initiala indata i samma begäran.
Det finns tre huvuddelar i begäran:
agent talar om för OpenAI vilken modell som ska användas och hur agenten ska bete sig.environment ger agenten dess hostade arbetsyta och placerar vår CSV-fil i den.input ger agenten uppgiften vi definierade i föregående avsnitt.Vi sätter också stream=True.
Detta ändrar inte hur uppgiften slutförs. Det låter oss helt enkelt ta emot händelser medan agenten arbetar i stället för att vänta tills hela vändan är klar innan vi ser något.
I det här exemplet lyssnar vi efter händelser av typen agent.session.turn.output_text.delta och fortsätter att uppdatera notebooken med den senaste texten.
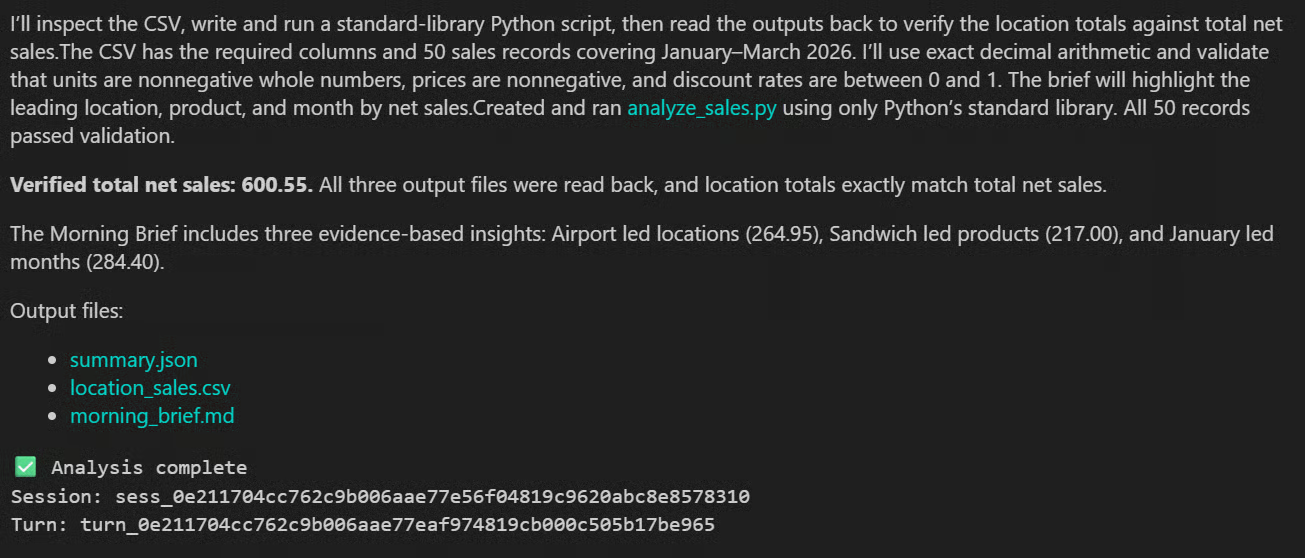
Texten vi ser dyka upp ovan är alltså agenten som rapporterar sin framdrift och sitt slutliga svar.
Själva uppgiften fortsätter att köras i den hostade miljön tills vi tar emot händelsen agent.session.turn.completed.
I min körning skapade och körde agenten analyze_sales.py, kontrollerade de genererade filerna och verifierade totala nettoförsäljningen till 600,55.
Det viktiga är att modellen inte bara berättade vilken Python-kod vi skulle köra. Agenten skrev faktiskt koden, körde den, inspekterade resultatet och verifierade utdata själv.
Nu när agenten är klar kan vi ladda ner filerna som den skapade under den vändan.
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
Utdata:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
Här listar vi artefakterna från sessionen, behåller dem som skapades av den avslutade vändan och laddar ner dem till vår lokala mapp cloud_bean_results.
När vi är klara med filerna bör vi radera sessionen så att vi inte behåller den hanterade miljön längre än nödvändigt.
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
Utdata:
Session deleted: TrueDetta tar bort den hanterade sessionen från API:et.
OpenAI noterar att fysisk städning av de underliggande resurserna kan fortsätta asynkront efter att raderingsbegäran har returnerats.
Detta steg är särskilt viktigt när du använder en OpenAI-hostad sandbox.
Sandboxen är beräkningsmiljön där agenten kör kod och arbetar med filer, och hostade sandlådor använder containeriserad beräkning som debiteras separat från modellanvändningen.
Så om du håller sessioner och miljöer igång längre än nödvändigt kan du fortsätta lägga till beräkningskostnader.
Det som slog mig med Agents API är hur mycket det kan göra från ett enda, enkelt API-anrop.
Vi gav det filen, uppgiften, modellkonfigurationen och den hostade miljön.
Därifrån skötte det resten: det skapade arbetsytan, inspekterade data, skrev Python-koden, körde den, kontrollerade utdata, fixade saker vid behov och producerade de slutliga artefakterna.
Det känns verkligen som att ha Codex körandes i molnet för din applikation.
Jag behövde inte oroa mig för att sätta upp beräkningsresurser, hantera exekveringsloopen, hantera mellanliggande filer eller hålla reda på varje steg. Jag behövde mest definiera uppgiften väl och sedan titta på resultatet.
Körningen tog omkring två minuter, men under den tiden gjorde agenten ganska mycket bakom kulisserna.
Det är det som gör detta annorlunda än ett normalt API-anrop.
Du väntar inte bara på att en modell ska generera text. Du väntar på att en agent faktiskt ska slutföra ett stycke arbete.
I mina tester kostade tre körningar av det här exemplet omkring 1,52 USD totalt, inklusive modell- och miljöanvändning.
För en så liten uppgift är det inte billigt, så i produktion skulle jag definitivt testa mindre eller billigare modeller först.
Men för mer komplext arbete som involverar kodning, felsökning, filer, resonemang och flera beroende steg kan den extra kostnaden vara mycket mer rimlig.
Toppkurser på DataCamp
course
track
course