Courses
面向开发者的 AI 辅助编码
1小时30分钟
10K
大多数 LLM 应用遵循一个简单模式:发送提示词,获取响应,并在您的应用中使用该响应。
这对简单任务很有效,但当模型需要编写代码、运行代码、检查结果、处理文件、修复错误,并持续迭代直到任务真正完成时,就会变得复杂得多。
这正是 OpenAI 的Agents API 大显身手的地方。
您无需亲自搭建每一步,只需给智能体任务、所需文件以及工作环境,其余交给它处理。
在本教程中,我会保持示例简单。我们将创建一个虚构的咖啡馆销售数据集并交给智能体。智能体会编写并运行分析、验证结果,并为我们生成三个输出文件。
当您看到整个过程在幕后如何运转时,您会意识到常规编码流程中有多少部分已被自动化。
如果您是 AI 智能体新手,建议先查看我们的AI Agents Fundamentals 技能路径。
通过OpenAI Agents API,您可以为智能体提供任务、所需文件以及应当工作的环境,然后让它完成剩余工作。
您无需手动创建沙盒、启动会话、上传文件、运行代码、检查错误并逐步管理每个环节,而是可以发送一次 API 请求,其中包含任务、配置、环境和输入文件。
之后,大部分工作将由 Agents API 处理。
在幕后,OpenAI 管理着Codex 托管框架,包括编排、上下文、工具使用、执行以及长时会话。您可以将其理解为OpenAI Codex在云端为您的应用运行。
您无需过多担心计算资源搭建、工作环境管理、会话追踪,或自行构建完整的智能体循环。
这对于更复杂、耗时更长的任务尤其有用——此时智能体需要真正完成工作,而不仅仅返回一个答案。
在本教程中,我们将使用OpenAI 托管的沙盒:
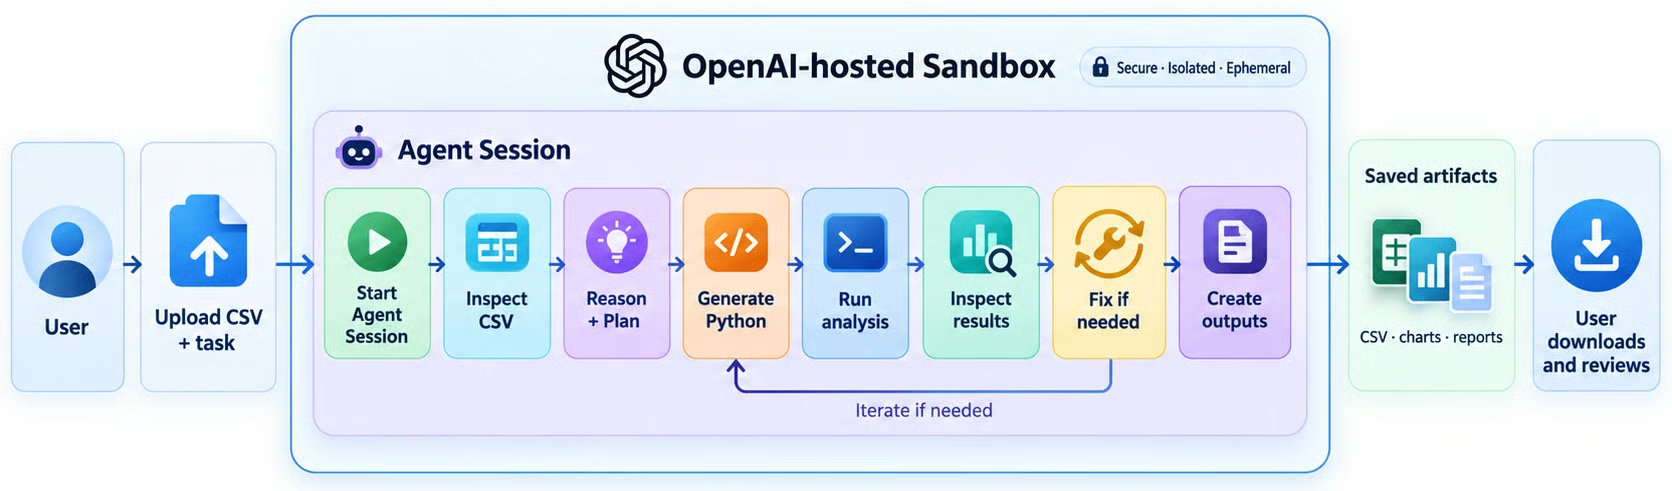
我们发送一个请求,其中包含 CSV 文件、任务以及智能体配置。
随后,Agents API 会为我们创建并管理会话和沙盒。
在沙盒内,智能体可以查看文件、确定分析思路、生成 Python 代码并运行、检查结果,并在出错时修复。
当一切完成后,输出会被保存为会话制品(artifacts)。
这些制品可以是图表、清洗后的数据集、报告,或智能体创建的任何其他文件。我们可以随后检索这些文件,让用户下载并查看。
所以核心思路很简单:我们只需发送一次任务,之后由智能体来完成实际工作。
三者的主要区别在于您希望自己管理多少工作流。
|
Responses API |
Agents SDK |
Agents API |
|
|
是什么 |
用于模型响应与工具调用的 API |
用于构建智能体应用的框架 |
用于运行更长时智能体任务的托管 API |
|
工作流 |
您的应用控制工作流 |
您构建智能体循环与编排 |
OpenAI 负责更多执行环节 |
|
关键特性 |
提示、工具、结构化输出 |
智能体、运行器、工具、移交、护栏 |
会话、沙盒、文件、代码执行 |
|
最佳适用 |
短小、聚焦的任务 |
自定义与多智能体应用 |
涉及文件与代码的更长、多步骤任务 |
|
示例 |
摘要或数据抽取 |
构建客服智能体系统 |
分析支出、检测异常消费并生成月度报告 |
当您需要模型完成聚焦任务(如摘要、抽取、分类、问答、结构化输出或少量工具调用)时,请使用Responses API。
当您希望自行构建智能体应用,并对智能体、工具、移交、护栏以及多智能体工作流有更多掌控时,请使用Agents SDK。
当任务较为复杂并需要独立的工作环境时,请使用Agents API。当智能体需要处理文件、运行代码、检查结果、修复错误,并在多个步骤中持续推进时,这种方式尤为有用。
在本教程中,我们使用Agents API,因为智能体需要使用文件、对分析进行推理、运行代码、检查结果,并将最终制品保存给用户。
让我们开始吧
本教程将使用 Jupyter Notebook 逐步测试 Agents API,并理解各个部分如何工作。
我们先安装 OpenAI 包,并导入接下来会用到的库。
首先,安装或升级 OpenAI Python 包:
%pip install -q --upgrade openai然后导入我们将要使用的库:
import base64
import csv
import io
import os
import random
from datetime import date, timedelta
from pathlib import Path

from IPython.display import Markdown, display
from openai import OpenAI
现在创建 OpenAI 客户端:
client = OpenAI()请确保您的 OPENAI_API_KEY 已在环境中设置。OpenAI 客户端会自动读取它。
我们将创建一个小型的虚构销售数据集,作为交给智能体的简单样例。
random.seed(42)

products = {
    "Latte": 4.50,
    "Tea": 3.00,
    "Cookie": 2.50,
    "Sandwich": 7.00
}

locations = ["Downtown", "Airport", "Campus"]
first_day = date(2026, 1, 1)
orders = []

for order_id in range(1, 51):
    product = random.choice(list(products))

    orders.append(
        {
            "order_id": order_id,
            "date": first_day + timedelta(days=random.randint(0, 89)),
            "location": random.choice(locations),
            "product": product,
            "units": random.randint(1, 5),
            "unit_price": products[product],
            "discount_rate": random.choice([0, 0, 0, 0.10]),
        }
    )
这将创建 50 条虚构的咖啡馆订单,涵盖不同产品、地点、日期和折扣。我们使用固定的随机种子,以便每次运行笔记本都会生成相同的数据集。
接下来,我们将把生成的数据转换为 CSV 文件,以便传给智能体。
csv_buffer = io.StringIO()

writer = csv.DictWriter(
    csv_buffer,
    fieldnames=orders[0].keys()
)

writer.writeheader()
writer.writerows(orders)

csv_text = csv_buffer.getvalue()

csv_base64 = base64.b64encode(
    csv_text.encode()
).decode()

print("Preview:")
print("\n".join(csv_text.splitlines()[:6]))
输出:
Preview:
order_id,date,location,product,units,unit_price,discount_rate
1,2026-01-04,Campus,Latte,3,4.5,0
2,2026-01-18,Campus,Tea,1,3.0,0
3,2026-01-05,Downtown,Sandwich,1,7.0,0
4,2026-03-06,Campus,Tea,1,3.0,0
5,2026-01-29,Airport,Sandwich,5,7.0,0
我们还对 CSV 进行了 Base64 编码,因为我们将随智能体请求直接发送该文件。
现在我们来描述希望智能体对 CSV 文件执行的操作。
task = """
Analyze /workspace/cafe_sales.csv. Write /workspace/analyze_sales.py and run it.

Your job:
1. Check that the required columns exist and numeric values are valid.
2. Calculate gross_sales = units * unit_price.
3. Calculate net_sales = gross_sales * (1 - discount_rate).
4. Summarize net sales by location, product, and month.
5. Find the best-selling location and product by net sales.
6. Write these files:
   - /workspace/outputs/summary.json
   - /workspace/outputs/location_sales.csv
   - /workspace/outputs/morning_brief.md
7. Make the Morning Brief friendly and include three evidence-based insights.
8. Read the files back and verify that location totals equal total net sales.
9. Finish by reporting the verified total and the three output filenames.

Use only Python's standard library. Do not invent or silently change data.
""".strip()
关键是我们描述目标与期望输出,而不是自己编写分析代码。
智能体可以自行决定如何完成工作、运行代码,并在结束前验证结果。
现在我们将把所有内容通过一次请求发送给 Agents API,让智能体在云端完成实际工作。
session_id = None
turn_id = None
response_parts = []

live_output = display(
    Markdown(""),
    display_id=True
)

with client.beta.agents.sessions.create(
    agent={
        "model": "gpt-6-astra",
        "instructions": (
            "You are a careful data analyst. "
            "Write simple code, run it, and verify the results."
        ),
    },
    environment={
        "type": "openai_hosted",
        "network": {"access": "disabled"},
        "files": [
            {
                "type": "inline",
                "path": "/workspace/cafe_sales.csv",
                "data": csv_base64,
            }
        ],
    },
    input=task,
    stream=True,
) as events:

    for event in events:

        if hasattr(event, "session_id"):
            session_id = event.session_id

        if event.type == "agent.session.turn.output_text.delta":
            response_parts.append(event.delta)

            live_output.update(
                Markdown("".join(response_parts))
            )

        elif event.type == "agent.session.turn.completed":
            turn_id = event.turn.id

        elif event.type.endswith(("failed", "cancelled")):
            raise RuntimeError(
                event.model_dump_json(indent=2)
            )

assert session_id and turn_id

live_output.update(
    Markdown("".join(response_parts))
)

print("✅ Analysis complete")
print(f"Session: {session_id}")
print(f"Turn: {turn_id}")
这一步完成了大部分工作。
我们发出一个请求,其中包含智能体配置、托管环境、CSV 文件与任务。
OpenAI 会创建托管会话并在托管沙盒中运行智能体。智能体随后可以检查文件、编写 analyze_sales.py、执行它、检查结果、修复问题,并创建最终输出文件。
会话创建端点在同一请求中同时支持环境与初始输入。
该请求主要包含三部分:
agent 指定 OpenAI 应使用的模型以及智能体的行为方式。environment 为智能体提供托管工作区,并将我们的 CSV 文件放入其中。input 提供我们在上一节定义的任务。我们还设置了 stream=True。
这不会改变任务的完成方式。它只是让我们在智能体工作期间接收事件,而无需等到整个回合结束后才看到任何输出。
在本例中,我们监听 agent.session.turn.output_text.delta 事件,并不断用最新文本更新笔记本。
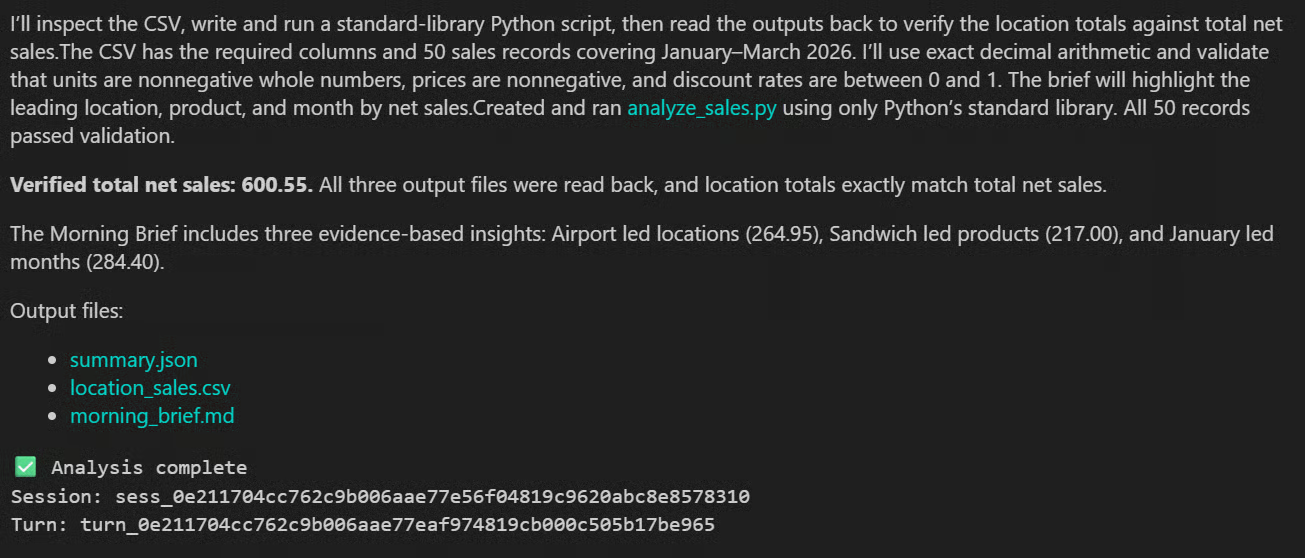
因此,我们上方看到的逐步出现的文字,是智能体在汇报道进度与最终响应。
实际任务会在托管环境中持续运行,直到我们收到 agent.session.turn.completed 事件。
在我的一次运行中,智能体创建并运行了 analyze_sales.py,检查生成的文件,并验证了净销售总额为600.55。
重要的是,模型并非只是告诉我们要运行什么 Python 代码。智能体实际上编写了代码、执行了它、检查了结果,并自行验证了输出。
智能体完成后,我们可以下载它在该回合中创建的文件。
download_dir = Path("cloud_bean_results")
download_dir.mkdir(exist_ok=True)

downloaded = []

for artifact in client.beta.agents.sessions.artifacts.list(
    session_id
):
    if artifact.turn_id == turn_id:

        destination = (
            download_dir / Path(artifact.path).name
        )

        with (
            client.beta.agents.sessions.artifacts
            .with_streaming_response
            .content(
                artifact.id,
                session_id=session_id
            )
        ) as response:
            response.stream_to_file(destination)

        downloaded.append(destination)

assert downloaded

print("Downloaded:")

for path in downloaded:
    print(f"- {path}")
输出:
Downloaded:
- cloud_bean_results/summary.json
- cloud_bean_results/morning_brief.md
- cloud_bean_results/location_sales.csv
此处我们列出会话中的制品,保留由已完成回合创建的那些,并将它们下载到本地的 cloud_bean_results 文件夹中。
处理完文件后,应删除会话,避免托管环境保留超出所需时间。
result = client.beta.agents.sessions.delete(
    session_id
)

print(f"Session deleted: {result.deleted}")
输出:
Session deleted: True这将从 API 中移除托管会话。
OpenAI 指出,底层资源的物理清理可能会在删除请求返回后以异步方式继续进行。
在使用OpenAI 托管沙盒时,此步骤尤为重要。
沙盒是智能体运行代码并处理文件的计算环境,托管沙盒使用基于容器的计算资源,计费与模型用量分开,按运行时间计费。
因此,如果让会话与环境超时运行,会持续产生计算成本。
让我印象最深的是,Agents API 可以通过一次简单的 API 调用完成如此多的工作。
我们提供了文件、任务、模型配置和托管环境。
之后,它处理了剩余一切:创建工作区、检查数据、编写 Python 代码、运行、检查输出、必要时修复,并生成最终制品。
这真的就像是在云端为您的应用运行 Codex。
我无需为计算资源搭建、执行循环管理、中间文件处理或逐步追踪操心。我主要只需要把任务定义清楚,然后查看结果即可。
一次运行大约耗时两分钟,但在这段时间里,智能体在幕后做了很多事情。
这正是它与普通 API 请求的不同之处。
您等待的不是模型生成文本,而是智能体真正完成一项工作。
在我的测试中,三次运行该示例的总成本约为$1.52,包括模型与托管环境的用量。
对于这样的小任务,这并不便宜,因此在生产中我肯定会优先测试更小或更便宜的模型。
但对于涉及编码、调试、文件、推理以及多个相互依赖步骤的复杂工作,这些额外成本就更有意义。
DataCamp 精品课程
Courses
Tracks
Courses