타깃이 월별 전력 수요라고 가정해 보겠습니다. ARIMA와 SARIMA 같은 모델은 시계열의 과거 값과 자체 과거 예측 오차만을 봅니다. 하지만 수요는 온도 같은 외부 요인에도 좌우됩니다. 여름이 덥거나 겨울이 추우면 수요가 늘지요. 모델이 이런 요인을 보지 못하면, 이례적인 달을 모두 노이즈로 취급하고 날씨가 바뀔 때마다 같은 실수를 반복합니다.
SARIMAX는 계절 ARIMA 모델 위에 외부(외생) 변수를 추가해 이 문제를 해결합니다. 시계열의 역사로부터 추세와 계절성은 여전히 학습하지만, 과거 값만으로는 설명되지 않는 부분을 외부 정보로 보완합니다.
만약 Python에서 시계열 데이터를 조작, 해석, 시각화하는 입문이 필요하시다면, 일주일 만에 기초를 다질 수 있는 Time Series in Python 트랙에 등록하세요 .
SARIMAX란?
SARIMAX는 계절 ARIMA 모델에 외부 예측 변수를 함께 사용할 수 있는 모델입니다. 이름은 Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors의 약자입니다.
SARIMAX는 네 가지 정보원을 바탕으로 타깃 시계열을 예측합니다:
- 과거 값: 가장 최근 몇 달의 수요
- 과거 예측 오차: 최근 몇 달 동안 모델이 얼마나 빗나갔는지
- 계절 패턴: 이전 해의 같은 달 수요
- 외생 변수: 평균 월별 기온처럼 모델에 추가하는 외부 데이터
예를 들어 목표가 다음 7월의 전력 수요 예측이라면, SARIMAX는 최근 몇 달의 수요, 과거의 7월 수요, 그리고 7월의 예상 기온을 봅니다. 앞의 두 가지는 시계열 내부 정보이고 온도는 외부 정보입니다.
모형 표기는 SARIMAX(p, d, q)(P, D, Q, S)입니다. 첫 번째 매개변수 집합은 단기 행동을, 두 번째는 계절 성분을 다룹니다. 여기서 S는 한 주기의 시점 수입니다. 연간 패턴이 있는 월별 데이터라면 S는 12입니다.
외생 변수는 이 표기 안에 포함되지 않습니다. 별도의 입력으로 모델에 전달합니다.
SARIMAX의 작동 원리
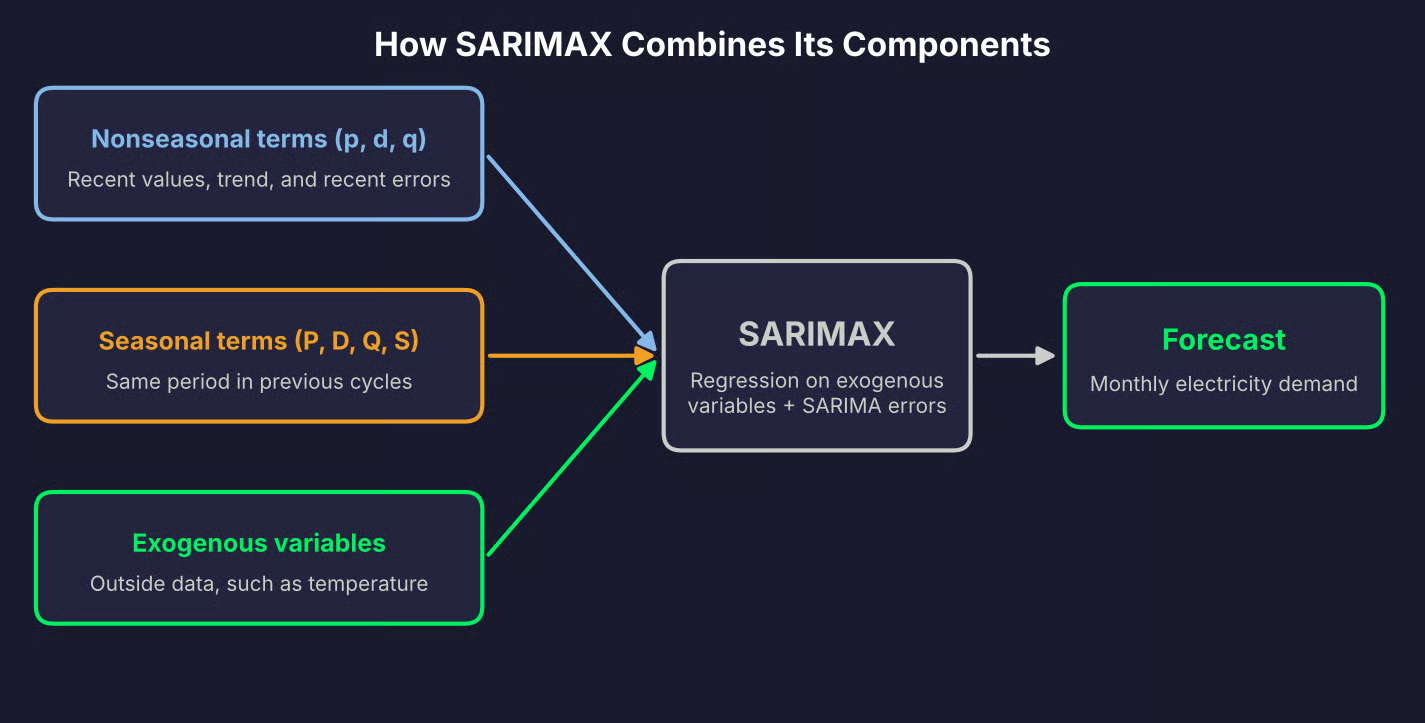
SARIMAX는 두 그룹의 항을 가지고, 그 위에 외생 변수가 더해집니다.
비계절 항 (p, d, q)는 단기 행동을 모델링합니다:
-
자기회귀 차수
p: 모델이 사용하는 과거 값의 수.p = 2이면 이번 달 수요는 직전 두 달의 수요에 의존합니다 -
차분 차수
d: 추세 제거를 위해 시계열을 몇 번 차분할지.d = 1이면 원시 수요 대신 전월 대비 변화량을 사용합니다 -
이동평균 차수
q: 모델이 사용하는 과거 예측 오차의 수. 지난달 수요를 과소추정했으면 그 오차가 이번 달 예측에 반영됩니다
계절 항 (P, D, Q, S)는 같은 일을 계절 지연에서 수행합니다:
-
계절 자기회귀 차수
P: 모델이 참고하는 과거 계절 수. 월별 데이터에서P = 1이면 이번 7월 수요는 작년 7월 수요에 의존합니다 -
계절 차분 차수
D: 계절 지연에서 시계열을 몇 번 차분할지.D = 1이면 이번 7월과 작년 7월을 비교하여 반복되는 연간 패턴을 제거합니다 -
계절 이동평균 차수
Q: 계절 지연에서 사용하는 과거 예측 오차의 수(예: 작년 7월의 오차) -
계절 주기
S: 한 주기의 시점 수. 연간 패턴이 있는 월별 데이터는 12, 주간 패턴이 있는 일별 데이터는 7
외생 변수는 시계열에 없는 정보를 보강합니다.
전력 수요 예시에서는 온도가 그 역할을 합니다. 무더운 여름이나 추운 겨울엔 수요가 늘고, 과거 수요 값만으로는 다음 달 날씨를 알려줄 수 없습니다. 월별 패턴은 이미 계절 항에서 다루므로, 이 예시는 온도만 외부 변수로 필요합니다.
statsmodels에서 SARIMAX는 외생 변수에 대한 선형 회귀이고, 오차가 계절 ARIMA 과정을 따릅니다. 외생 변수가 하나일 때 형태는 다음과 같습니다:
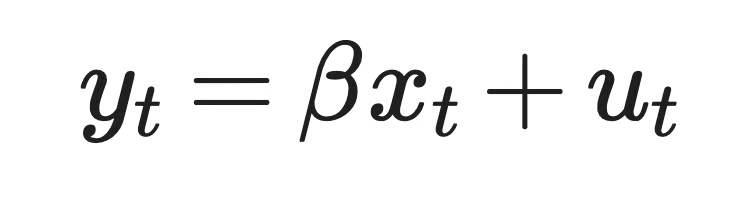
외생 변수가 하나인 SARIMAX
여기서 y_t는 t월의 전력 수요, x_t는 그달의 온도, beta는 온도 계수, u_t는 온도로 설명되지 않는 수요의 부분입니다. 비계절 및 계절 항은 u_t를 모델링합니다.
간단히 말해, 온도가 수요의 일부를 설명하고, 나머지는 SARIMA 항이 모델링합니다.
좀 더 시각적인 개요는 다음과 같습니다:
SARIMAX 구성 요소
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
이 네 모델은 같은 계열에 속합니다. 차이는 미묘하지만, 한 번만 읽어도 이해할 수 있습니다.
ARIMA는 과거 값과 과거 예측 오차로 시계열을 모델링합니다. SARIMA는 여기에 계절 항을 추가하여 S 시점마다 반복되는 패턴을 모델링합니다. ARIMAX는 ARIMA에 외생 변수를 더하지만, 기본적으로 계절 항은 없습니다. SARIMAX는 둘 다 포함합니다.
그래서 SARIMAX는 다른 모델을 특수한 경우로 포함할 수 있습니다. 외생 변수를 전달하지 않으면 SARIMA가 되고, 모든 계절 차수를 0으로 두면 비계절 ARIMAX가 됩니다. 둘 다 없으면 ARIMA입니다.
하지만 아쉽게도, 패키지마다 용어가 일관되지 않습니다.
교과서상의 ARIMAX는 외생 변수를 ARIMA 방정식에 시계열 과거 값과 나란히 직접 넣습니다. 반면 statsmodels의 SARIMAX는 앞 절에서 본 것처럼 SARIMA 오차를 갖는 회귀를 적합합니다. 두 형태는 서로 다른 계수를 추정하므로, 같은 온도 변수라도 패키지에 따라 계수가 달라질 수 있습니다.
클래스와 함수 이름도 일치하지 않습니다. statsmodels의 ARIMA 클래스는 계절 항과 외생 변수도 받을 수 있습니다. R에서는 forecast 패키지가 Arima()와 auto.arima()의 xreg 인수를 통해 외부 회귀를 처리합니다. 따라서 도구 간 결과를 비교하기 전에 각 패키지가 모델을 어떻게 정의하는지 반드시 확인하세요.
간단히 정리하면 다음과 같습니다:
| 계절성? | 외부 변수? | |
|---|---|---|
| ARIMA | 아니오 | 아니오 |
| SARIMA | 예 | 아니오 |
| ARIMAX | 기본은 아님 | 예 |
| SARIMAX | 예 | 예 |
ARIMA 계열 모델 비교
SARIMAX를 사용할 때
타깃에 반복적인 계절 패턴이 있고, 외부 변수가 예측을 개선해 줄 때 SARIMAX가 적절합니다.
예시는 다음과 같습니다:
- 전력 수요: 연간 주기 위에 온도와 공휴일 같은 달력 효과
- 소매 매출: 프로모션, 가격, 연휴 기간
- 호텔 예약: 연간 여행 성수기 위에 지역 행사와 객실 가격
- 대중교통 승차수요: 일별 데이터의 주간 패턴 위에 날씨와 방학
하지만 SARIMAX가 항상 최선은 아닙니다. 다음 두 경우에는 더 단순한 모델로 충분할 수 있습니다:
- 의미 있는 계절성이 없음: 패턴이 반복되지 않는 시계열에 계절 항을 넣으면 추정해야 할 매개변수만 늘립니다. ARIMA 또는 ARIMAX면 충분합니다
- 예측 변수가 정확도를 높이지 않음: 외생 변수가 홀드아웃 테스트 구간의 오차를 줄이지 못한다면 제거하고 SARIMA를 사용하세요. 학습 데이터에 대한 더 나은 적합도는 근거가 되지 않습니다
여기서 기억할 점은, 예측 구간의 모든 외생 변수에 대한 값이 필요하다는 것입니다.
일부 값(공휴일, 계획된 프로모션 등)은 미리 알고 있습니다. 다른 값(예: 온도)은 SARIMAX가 사용하기 전에 별도의 예측이 필요합니다. 예측 변수의 미래 값을 확보할 수 없다면, 해당 변수는 예측에 사용할 수 없습니다.
Python에서 SARIMAX 모델을 만드는 방법
이 절에서는 statsmodels로 SARIMAX 모델을 구축하고, 원시 데이터에서 12개월 예측까지 진행합니다.
예시는 외부 변수로 온도를 사용한 합성 월별 전력 수요입니다. 작고 재현 가능하며, 본문 전반의 흐름과 같습니다.
데이터 준비
데이터셋은 2015년 1월부터 2024년 12월까지 10년의 월별 데이터를 다룹니다.
수요에는 상승 추세, 시간이 지남에 따라 천천히 변하는 연간 달력 패턴, 날씨 효과, 노이즈가 있습니다. 고의적으로 온도 관측 두 개를 비워두었으니, 결측을 처리하는 방법을 볼 수 있습니다:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())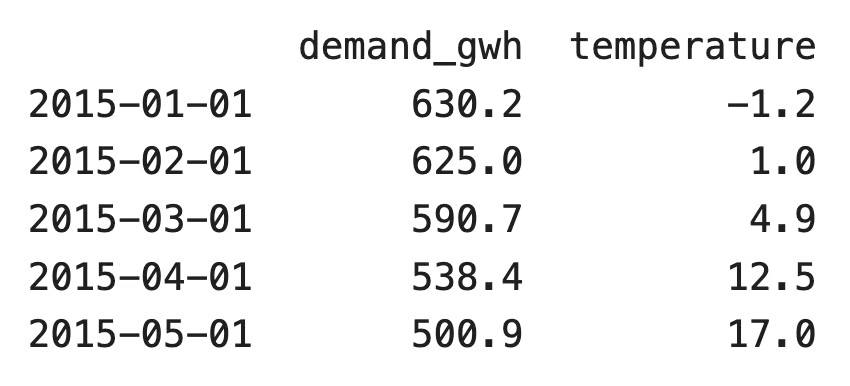
데이터셋의 처음 다섯 행
또는, 시각적 개요를 원하신다면:
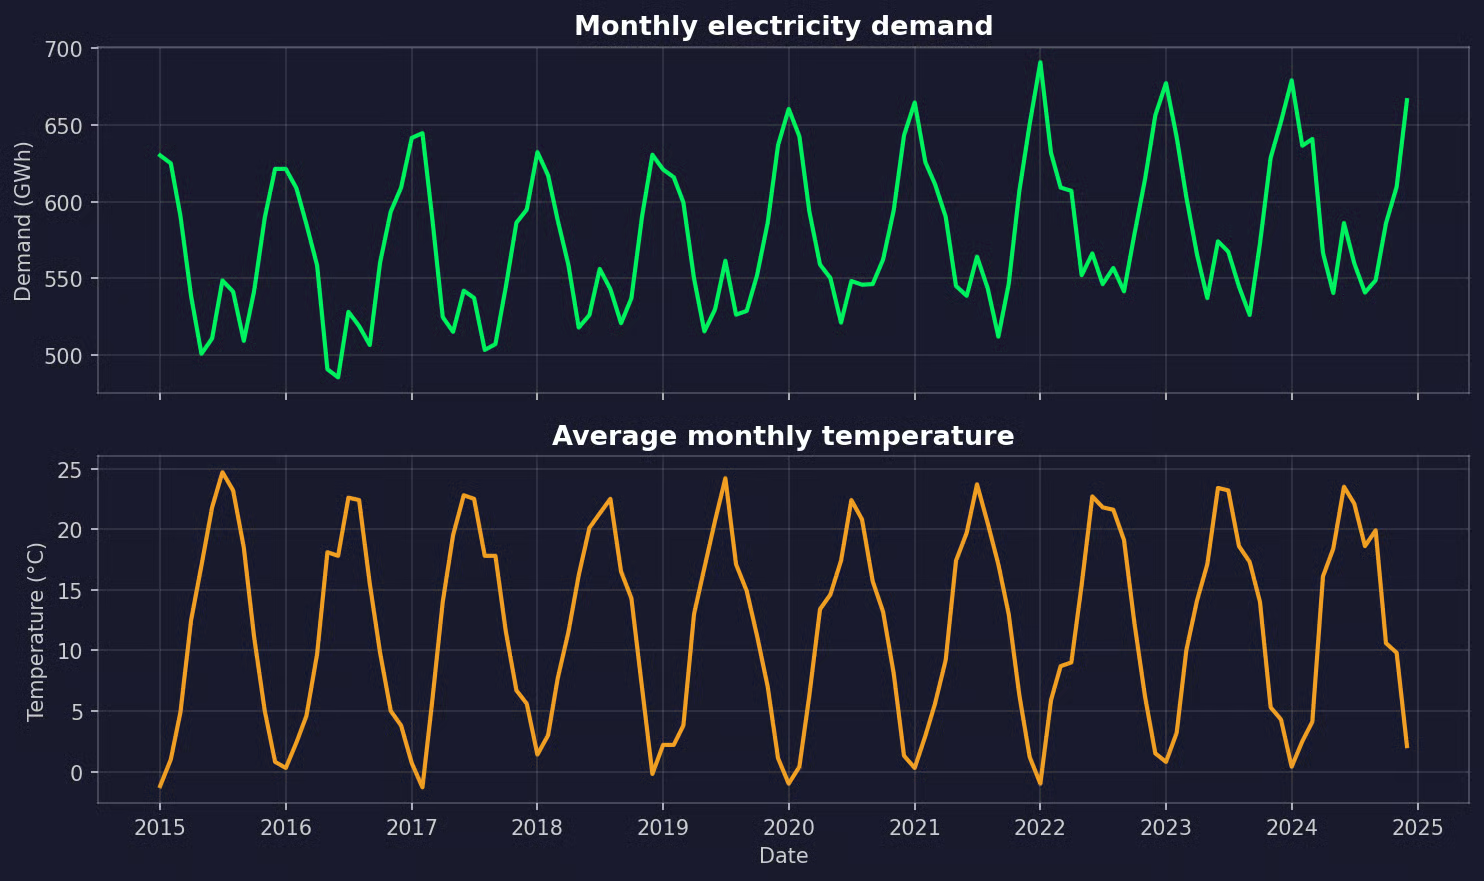
온도 데이터셋
자체 데이터로 작업 중이라면 pd.read_csv()로 불러오고 날짜 열을 인덱스로 설정하세요. 이후 워크플로는 동일합니다.
SARIMAX는 일정한 빈도의 시간 인덱스가 필요합니다. .asfreq() 메서드로 월별 빈도를 설정하고, 누락된 달이 있으면 빈 행을 삽입합니다. 그 다음 결측을 세고 채울 수 있습니다:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()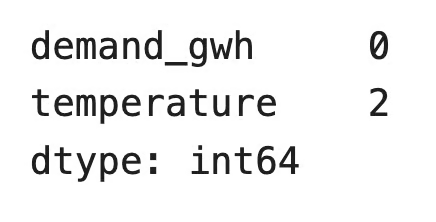
온도 결측 보간
온도는 월별로 완만히 변하므로 선형 보간이 타당합니다. 타깃에서 큰 구간이 비어 있다면 같은 일을 하지 마세요. 만들어낸 값으로 모델을 학습시키는 셈입니다.
다음은 외생 변수입니다. 수요는 춥거나 더울 때 증가하지만, 원시 온도에 대한 직선 회귀만으로 U-자 형태를 잡을 수는 없습니다. 그래서 온도를 두 개의 특성으로 나누겠습니다:
- 난방 정도(heating degrees): 평균 기온이 18도보다 얼마나 낮은지(그 외에는 0)
- 냉방 정도(cooling degrees): 평균 기온이 18도보다 얼마나 높은지(그 외에는 0)
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
이제 데이터를 타깃 y와 외생 변수 X로 분리하세요. 분할은 시간 순서를 따라야 합니다. 모델은 과거로 학습하고 미래로 테스트합니다. 무작위 분할은 미래 정보를 학습에 유출시킵니다:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")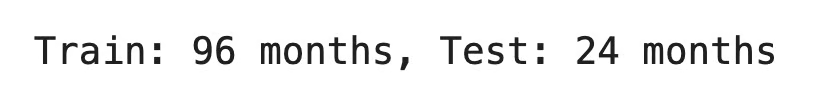
학습/테스트 분할
여기서 기억할 점은 X_test가 실제 관측 온도라는 것입니다. 실제 예측에서는 미리 알 수 없고, 최선의 경우 날씨 예보만 있습니다. 따라서 나중에 보게 될 테스트 점수는 낙관적입니다. 공휴일이나 계획된 가격처럼 예측 시점에도 같은 값이 제공되는 경우에만 관측 예측 변수를 평가에 사용하세요.
계절성과 정상성 탐색
플롯으로 시작하세요. 추세, 계절 주기, 급격한 변화를 찾습니다:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()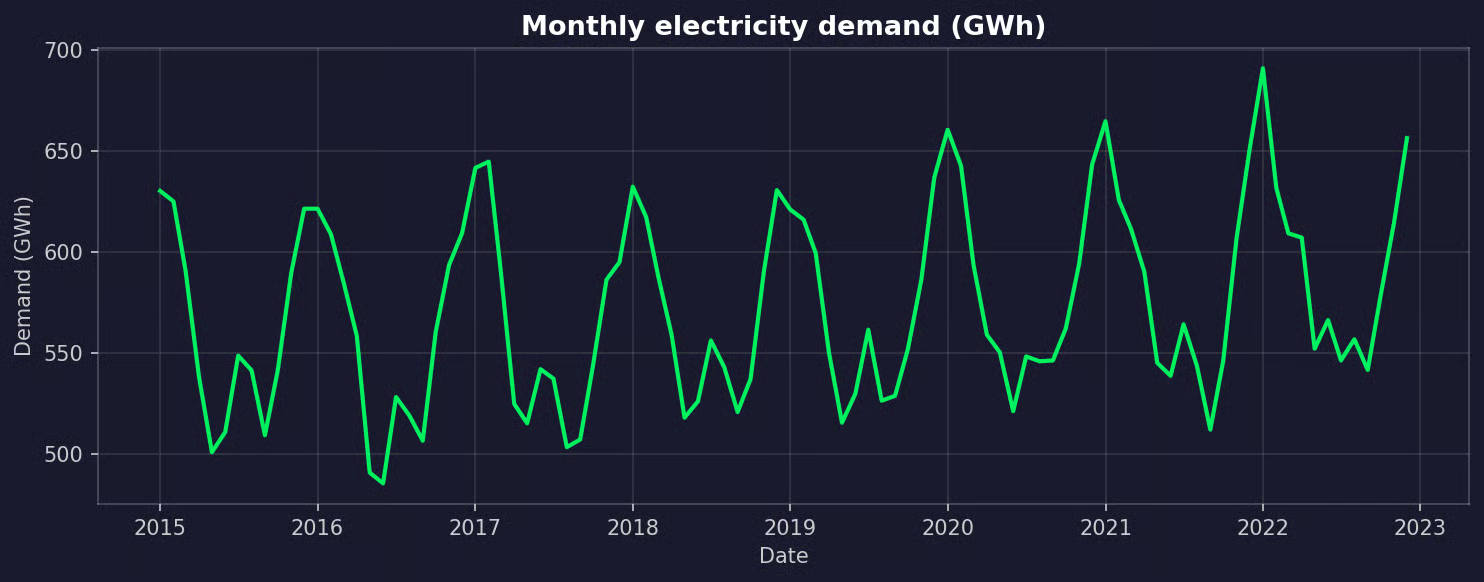
학습 기간의 월별 전력 수요
수요는 시간이 지날수록 증가하고, 겨울에 가장 크며 여름에 더 작은 피크가 있습니다. 패턴은 12개월마다 반복됩니다.
계절 분해는 시리즈를 추세, 계절, 잔차 성분으로 나누어 계절 주기 S를 확인하게 해줍니다:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()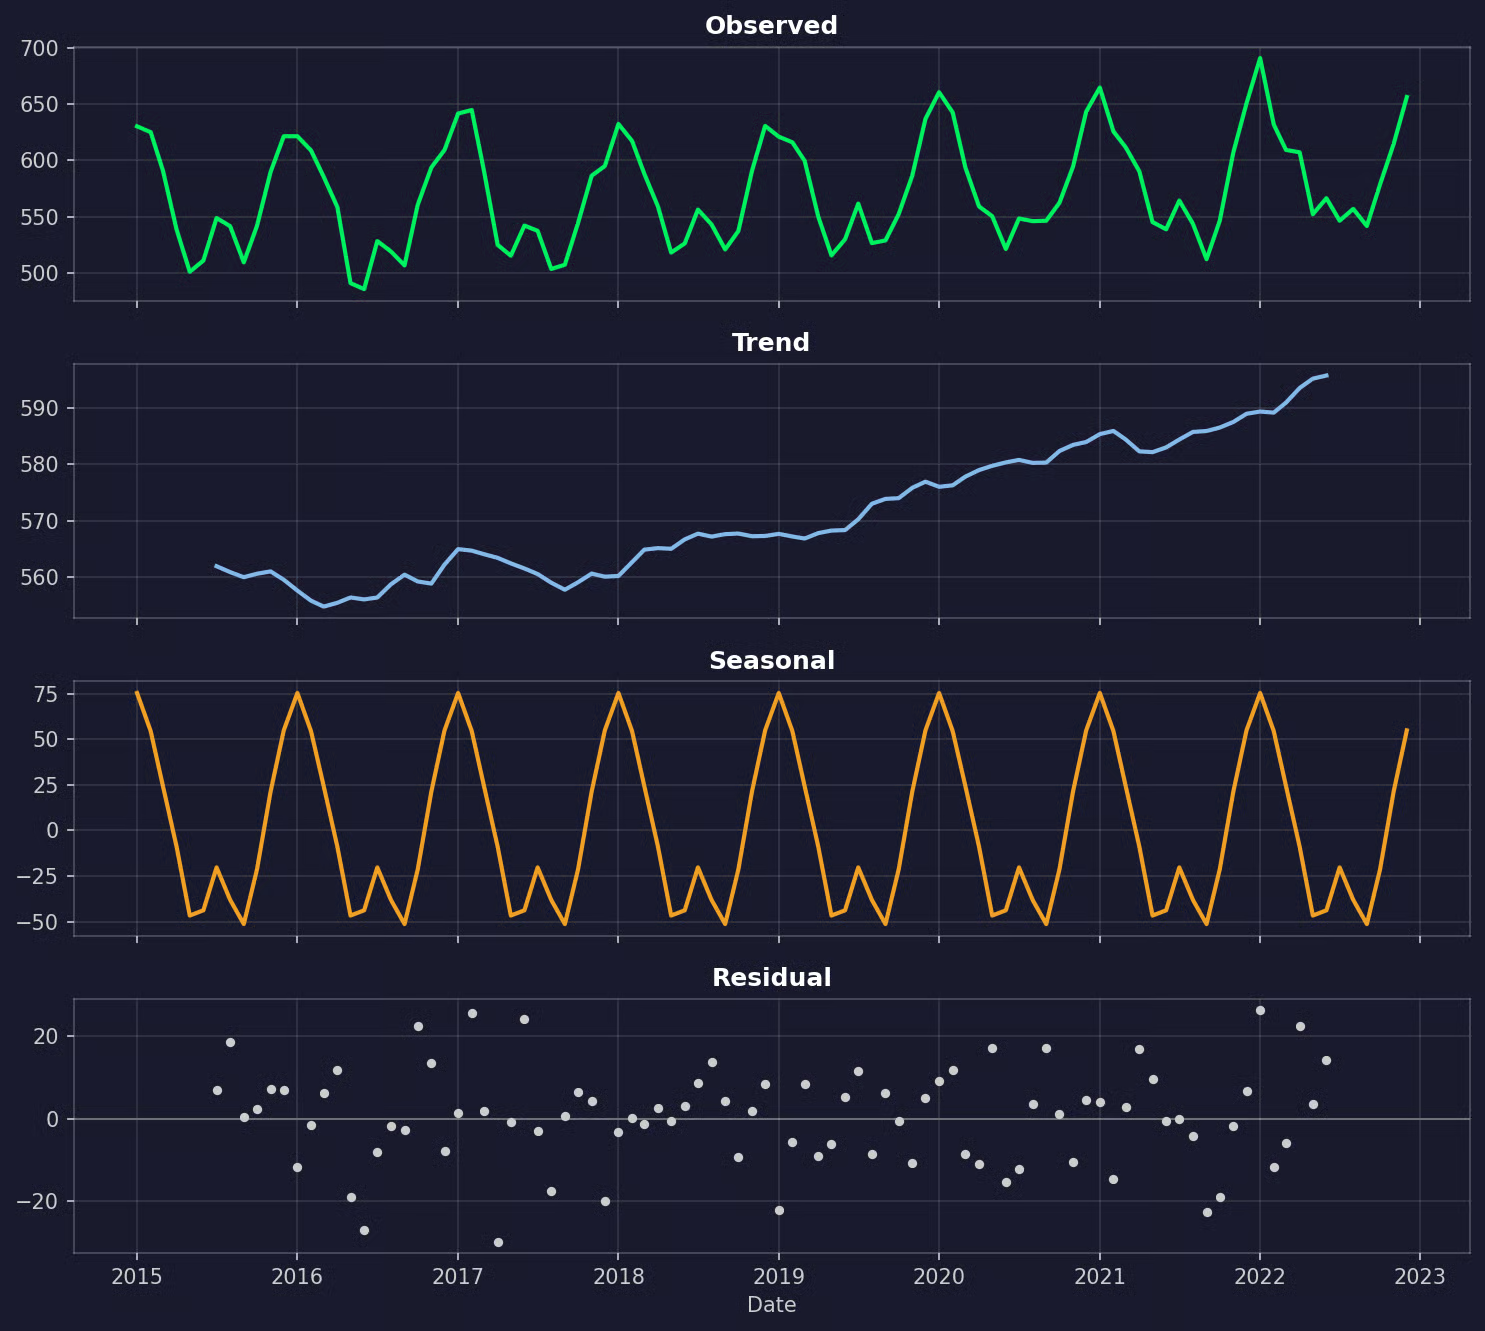
전력 수요의 계절 분해
계절 성분은 매년 반복되므로 S = 12입니다.
ARIMA 계열 모델은 평균과 분산이 시간에 따라 변하지 않는 정상 시계열을 필요로 합니다. 수요는 추세와 계절 주기가 있어 정상성이 아닙니다.
차분은 이를 해결하는 한 방법입니다:
-
일반 차분(
d): 이번 달 값에서 지난달 값을 뺍니다. 추세를 제거합니다 -
계절 차분(
D): 작년 같은 달의 값을 뺍니다. 반복되는 계절 패턴을 제거하고, 선형 추세도 제거합니다
ADF(Augmented Dickey-Fuller) 검정은 정상성을 확인합니다. 귀무가설은 비정상성이고, 작은 p-값(0.05 미만)은 정상성의 근거입니다:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")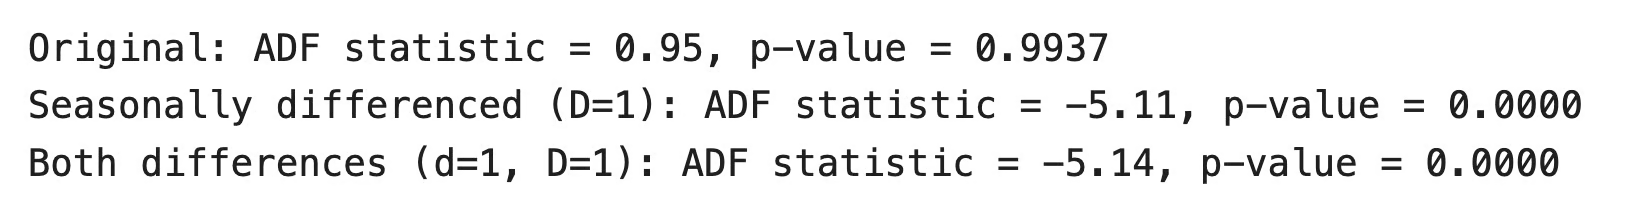
ADF 검정 결과
원시 시계열은 정상이 아닙니다. 계절 차분만으로 해결되므로, 여기에 일반 차분을 추가해도 이득이 없습니다. 필요한 최소한의 차분만 사용하세요. 과도한 차분은 시계열에 노이즈를 더하고 적합을 어렵게 만듭니다.
따라서 d = 0, D = 1를 선택합니다.
다만 ADF 검정은 보조 증거로만 취급하세요. p, q, P, Q에 대해서는 아무 것도 알려주지 않으며, 짧은 시계열에서는 설정에 따라 답이 달라질 수 있습니다.
후보 매개변수 선택
ACF와 PACF 플롯은 나머지 차수의 후보 값을 고르는 데 도움을 줍니다:
-
ACF(자기상관함수): 시계열과 지연된 값 간의 상관을 보여줍니다. ACF의 스파이크는 이동평균 항을 시사하며, 단기 지연에서는
q, 계절 지연에서는Q를 가리킵니다 -
PACF(편자기상관함수): 중간 지연의 영향을 제거한 상관을 보여줍니다. PACF의 스파이크는 자기회귀 항을 시사하며, 단기 지연에서는
p, 계절 지연에서는P를 가리킵니다
모델이 실제로 다루는 시계열이므로, 계절 차분된 시리즈에 대해 둘 다 그려야 합니다:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()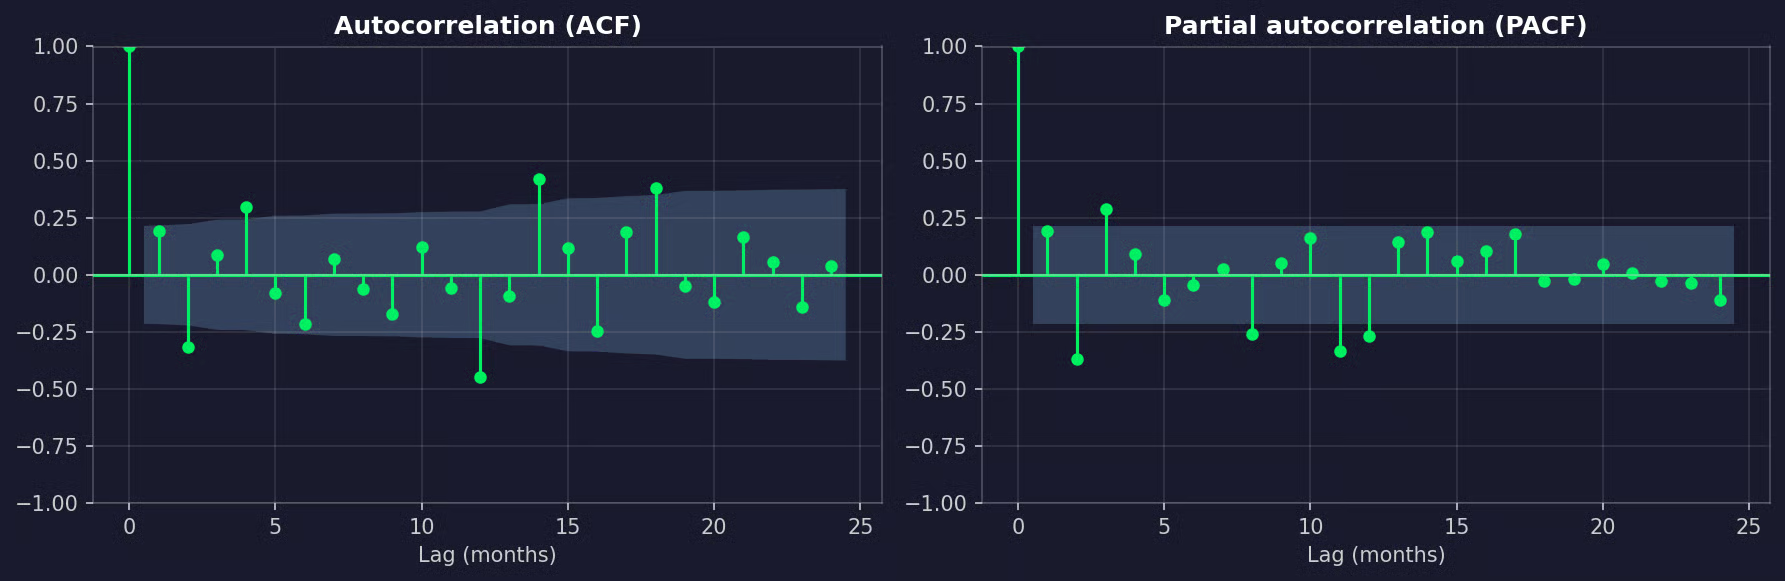
계절 차분된 전력 수요의 ACF와 PACF
ACF는 지연 12에서 뚜렷한 음의 스파이크가 있고 지연 24에서는 없습니다. 이는 전형적인 계절 이동평균 항의 신호이므로 Q = 1이 좋은 후보입니다. 두 플롯 모두 단기 지연에서 몇몇 스파이크를 보이므로 p와 q도 시험해 볼 가치가 있습니다.
다음 단계는 소수의 후보 모델을 적합하고 AIC 또는 BIC로 비교하는 것입니다. 둘 다 학습 데이터에 대한 적합도를 측정하고, 추가 매개변수에는 패널티를 부여합니다. 값이 낮을수록 좋고, BIC가 AIC보다 복잡성에 더 큰 패널티를 줍니다:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))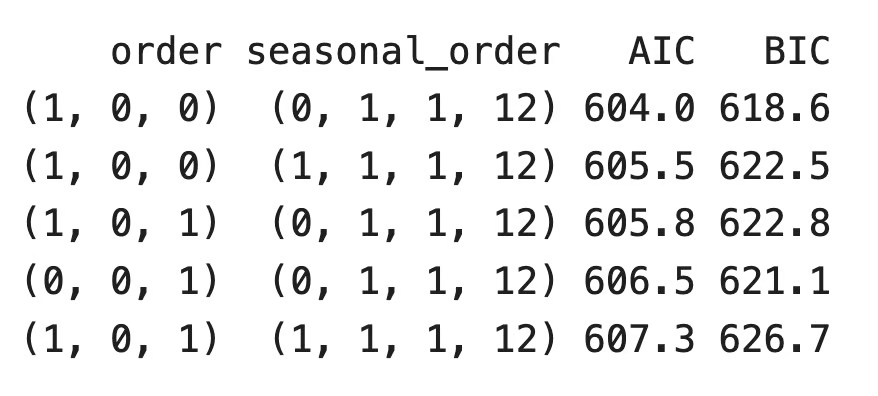
AIC와 BIC 결과
SARIMAX(1, 0, 0)(0, 1, 1, 12)가 AIC와 BIC 모두에서 우승입니다. 목록에서 가장 단순한 모델 중 하나이기도 합니다.
trend="c" 인수는 상수를 추가합니다. 계절 차분을 했을 때 상수는 연간 수요 증가를 모델링합니다.
pmdarima의 auto_arima() 같은 도구는 이 탐색을 자동으로 수행합니다. 초기에 유용하지만, AIC와 BIC는 학습 데이터의 적합만 측정합니다. 모델을 신뢰하기 전에 보지 못한 데이터로 테스트하세요.
모델 적합
타깃은 첫 번째 인수로, 외생 변수는 exog로 전달합니다. order에는 (p, d, q), seasonal_order에는 (P, D, Q, S)를 지정합니다:
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())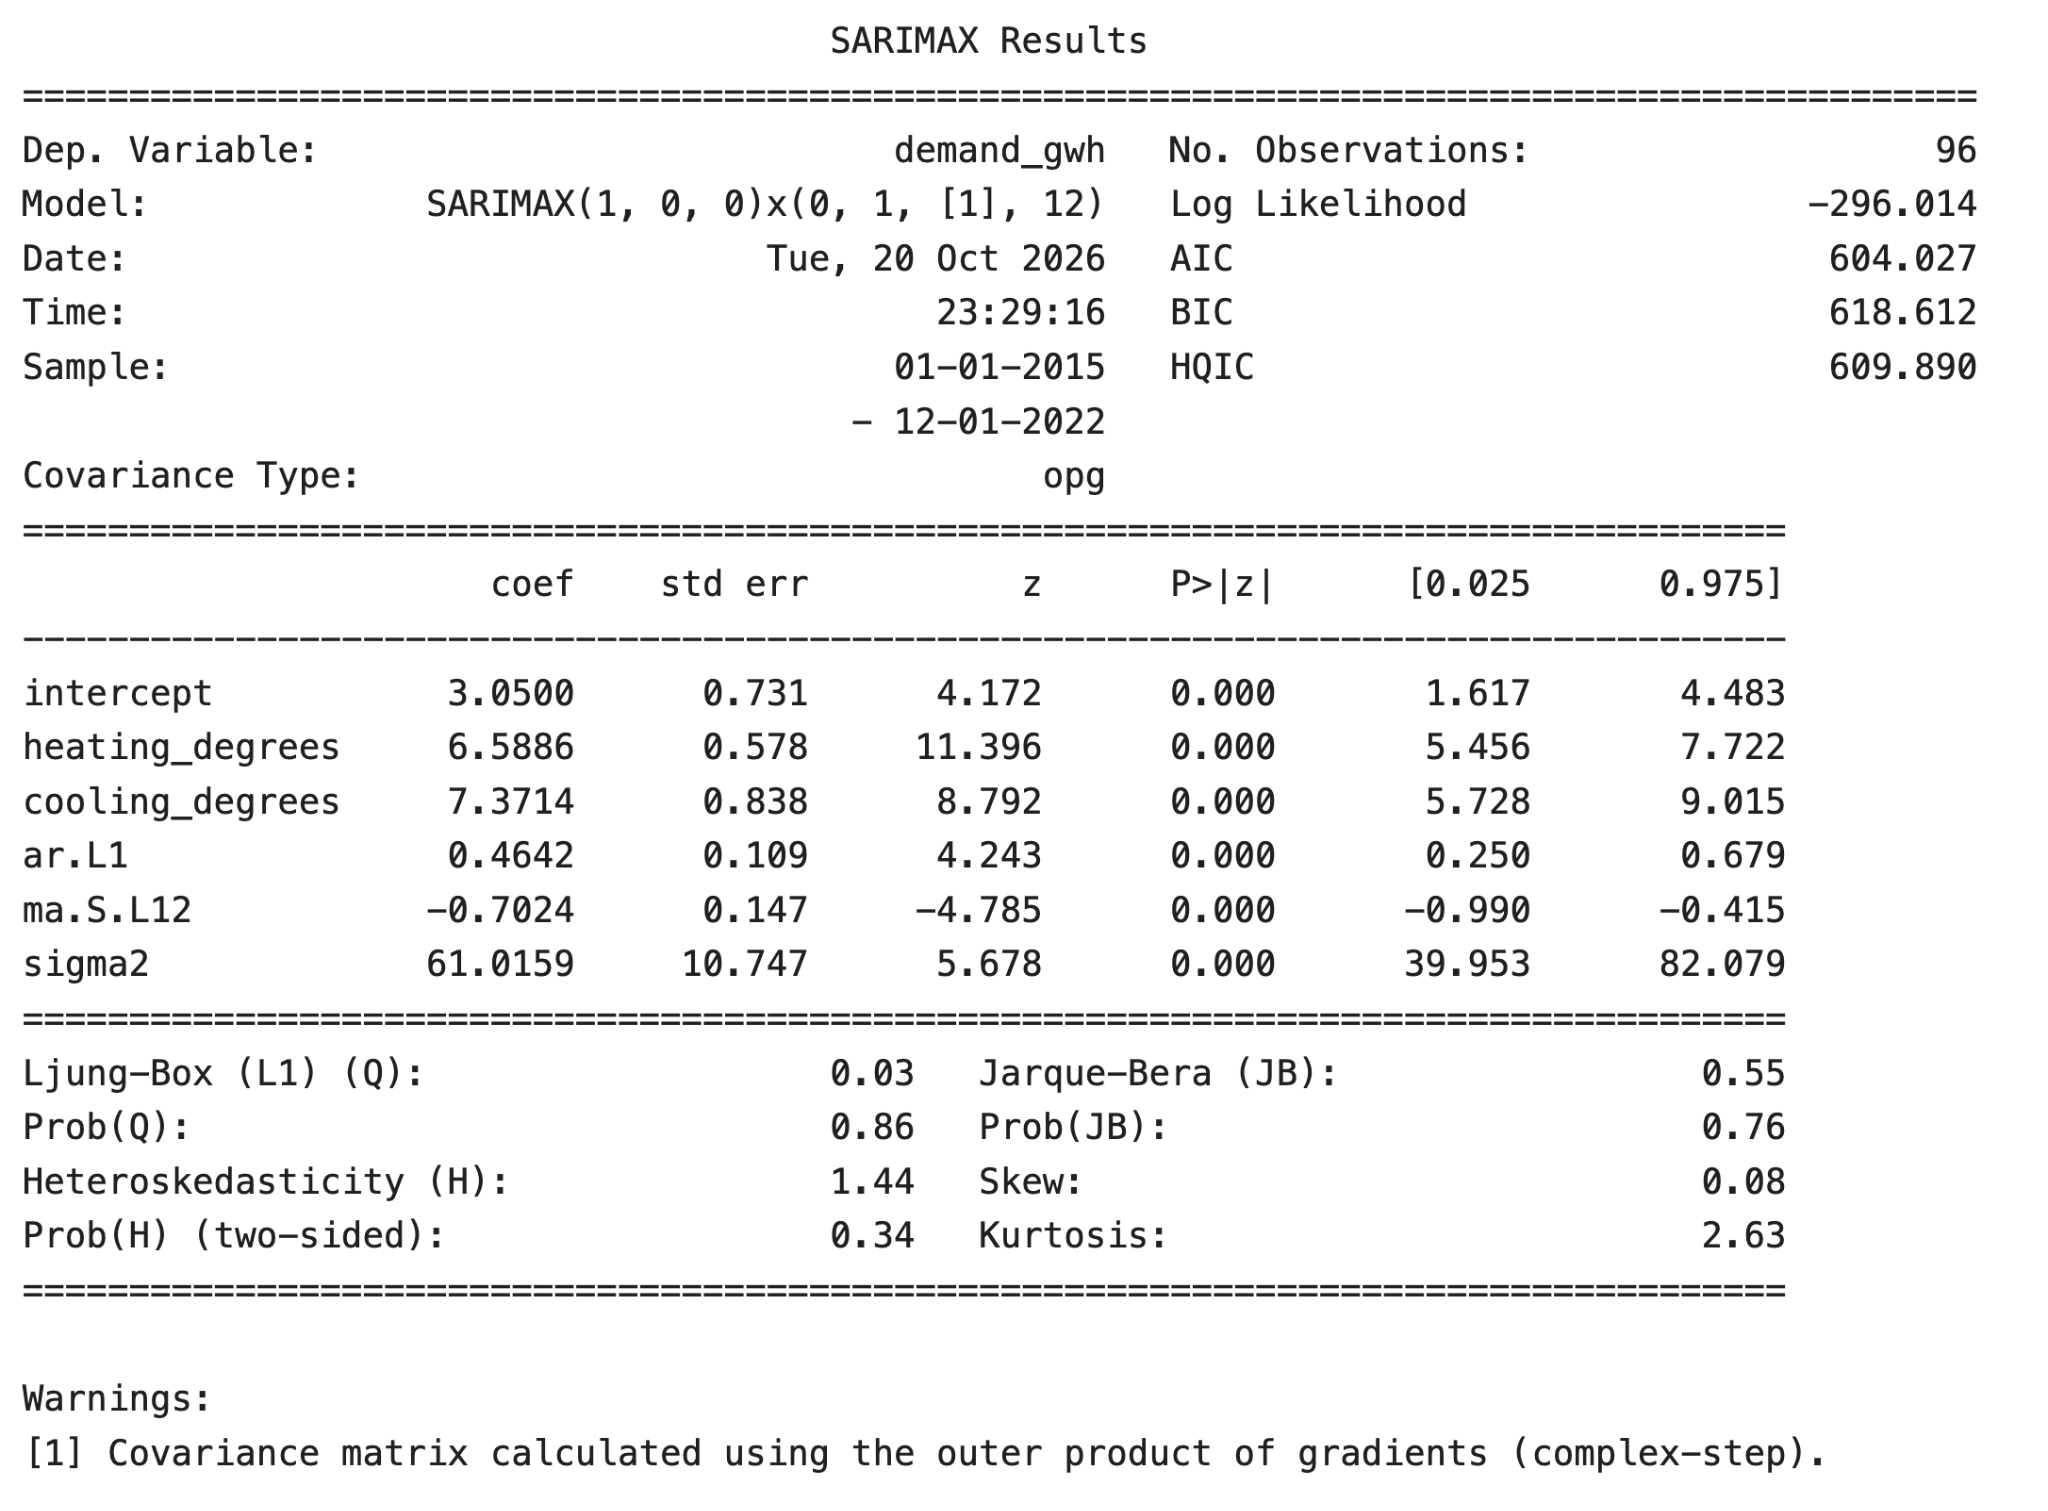
SARIMAX 모델 요약
계수 표를 읽는 방법은 다음과 같습니다:
-
heating_degrees: 난방 정도 1 단위 증가는(모델의 다른 모든 것이 고정될 때) 약 6.6 GWh의 수요 증가와 함께합니다 -
cooling_degrees: 냉방 정도 1 단위 증가는 약 7.4 GWh의 수요 증가와 함께합니다 -
ar.L1: 지난달의 설명되지 않은 차이 중 약 46%가 이번 달로 이어집니다 -
ma.S.L12: 작년 같은 달의 오차를 바탕으로 예측을 보정하는 계절 이동평균 항 -
sigma2: 남은 노이즈의 분산
모든 계수의 p-값이 0에 가깝습니다. 각 항이 모델에 기여한다는 뜻입니다.
하지만 이 계수들은 적합된 모델 내부의 관계를 설명할 뿐, 인과를 뜻하지는 않습니다. 여기서는 온도가 수요의 원인이라는 설정으로 데이터를 생성했으니 안전하게 해석할 수 있지만, 실제 데이터에서는 모델이 보지 못한 것과 동행하기 때문에 중요해 보이는 예측 변수가 있을 수 있습니다.
모델 진단 및 평가
좋은 모델은 무작위 노이즈처럼 보이는 잔차를 남깁니다. 잔차에 여전히 패턴이 있으면, 모델이 무언가를 놓친 것입니다.
.plot_diagnostics() 메서드는 한 번에 네 가지 플롯을 제공합니다:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()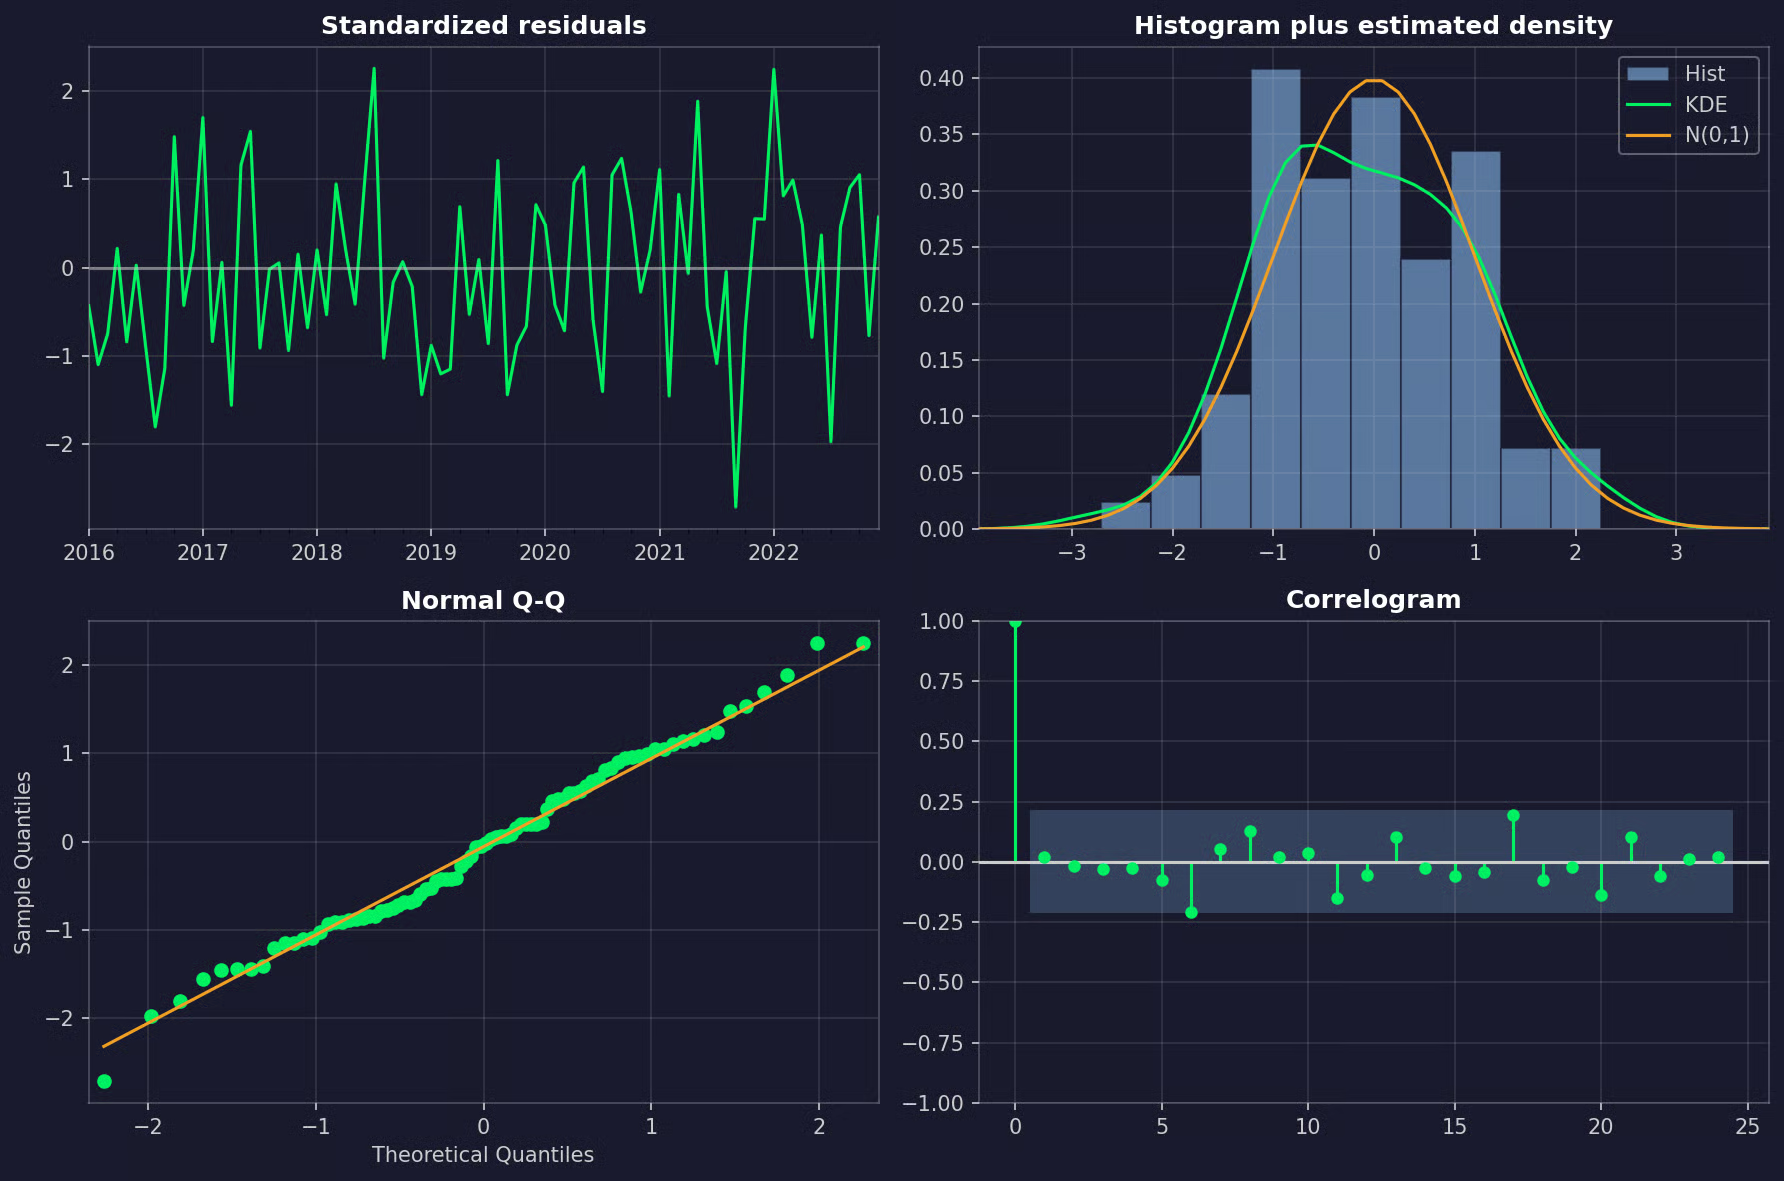
잔차 진단 플롯
확인할 사항은 다음과 같습니다:
- 표준화 잔차: 추세나 반복 패턴이 없어야 하며, 분산이 갑자기 넓어지는 구간이 없어야 합니다
- 히스토그램과 Q-Q 플롯: 정규분포에 가까운 점 분포
- 상관도표: 신뢰구간 밖의 스파이크가 없어야 하며, 특히 지연 12에서 스파이크가 있으면 계절성을 완전히 처리하지 못한 것입니다
Ljung-Box 검정은 같은 확인을 수치로 제공합니다. 귀무가설은 주어진 지연까지 잔차에 자기상관이 없다는 것이므로, p-값이 클수록 좋습니다:
# Skip the first 13 residuals, which come from the differencing start-up period
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))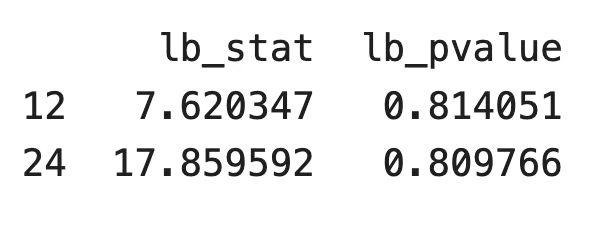
Ljung-Box 검정 결과
두 p-값 모두 0.05를 훨씬 상회하므로, 잔차는 노이즈처럼 보입니다.
이제 가장 중요한 부분, 모델이 보지 못한 데이터에 대한 정확도입니다. .get_forecast()는 24개월 테스트를 예측하며, 그 달들의 외생 값이 필요합니다.
단일 예측 수치만으로는 의미가 적으니, SARIMAX를 두 가지 기준선과 비교하겠습니다:
- 계절 순진 예측: 학습 데이터의 마지막 12개월 값을 반복
- SARIMA: 외생 변수를 제외한 동일 모델
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: repeat the last 12 observed months
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: the same model without exogenous variables
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()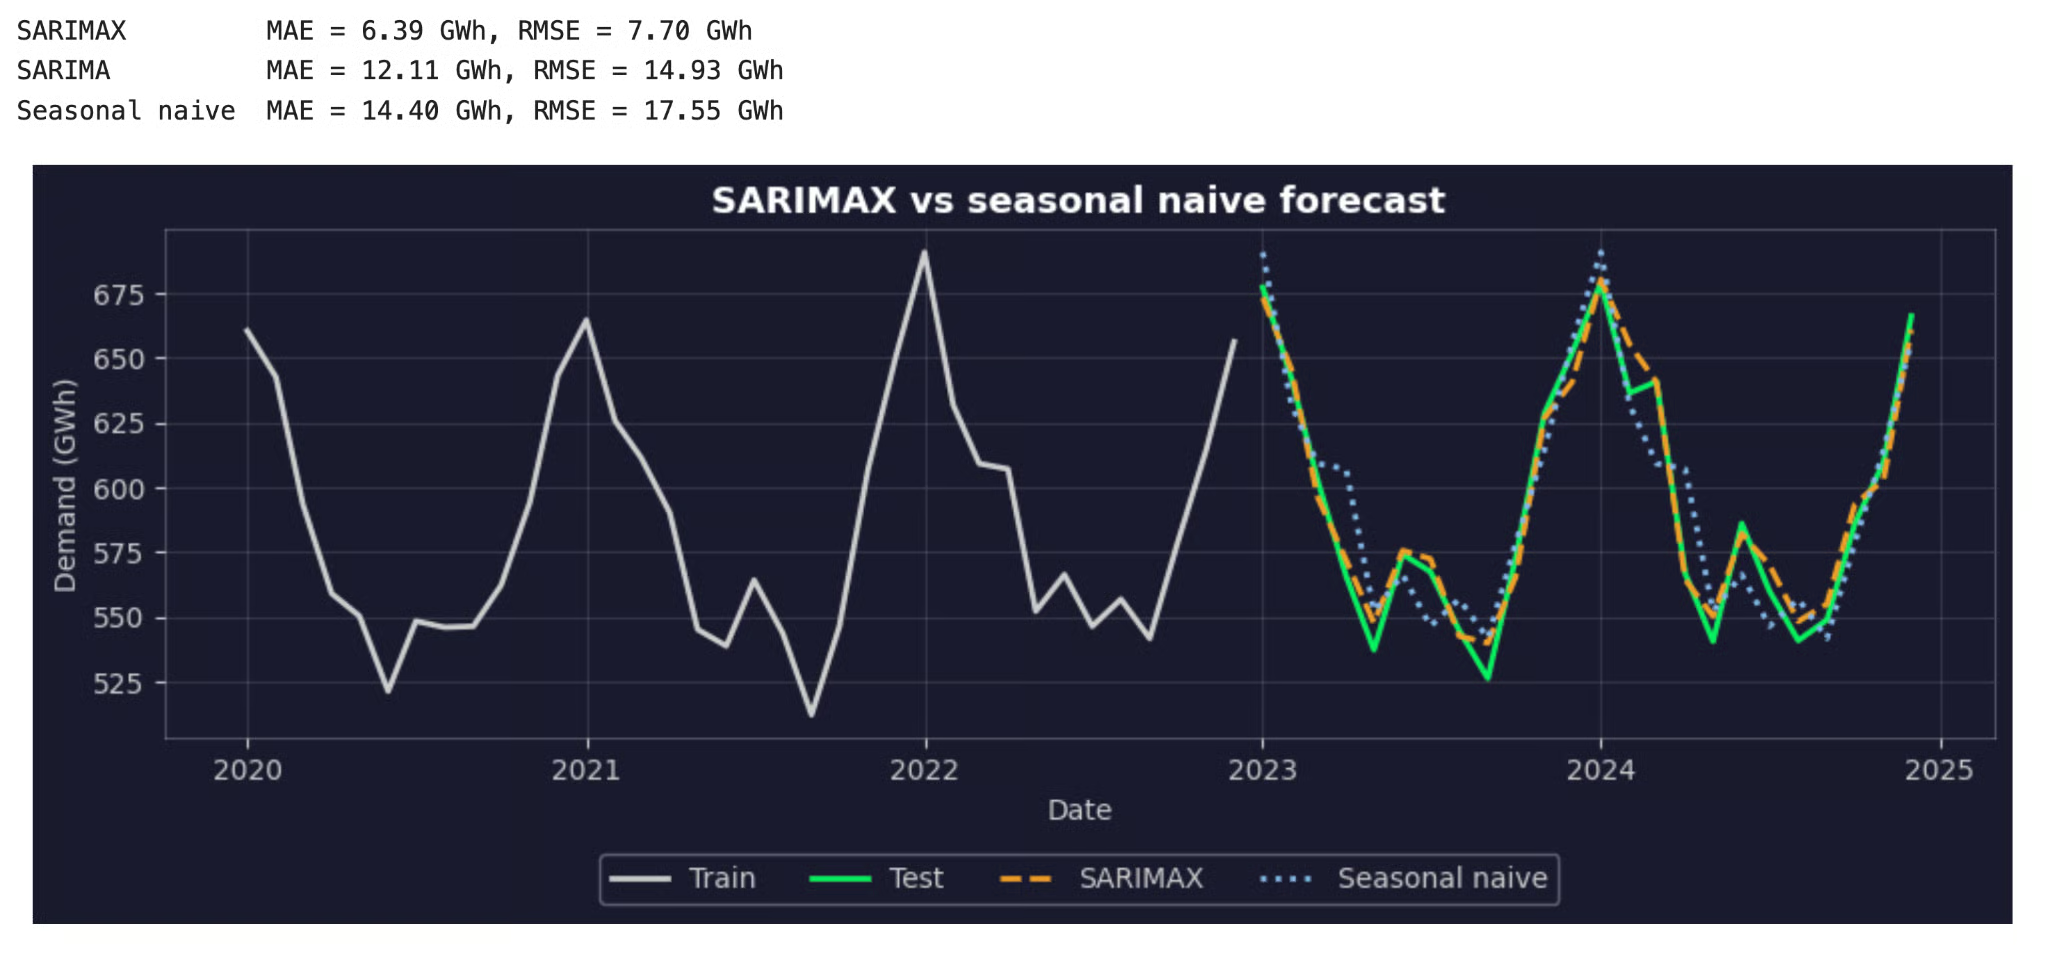
테스트 세트의 실제 수요 대비 SARIMAX와 계절 순진 예측
MAE(평균 절대 오차)는 GWh 단위의 평균 오차 크기입니다. RMSE(평균 제곱근 오차)는 큰 오차에 더 큰 패널티를 줍니다.
SARIMAX는 두 지표 모두에서 SARIMA의 오차를 절반가량으로 줄입니다. 계절 항만으로는 이례적으로 추운 1월이나 더운 7월을 예측할 수 없지만, 온도 특성은 가능합니다.
다만, 이 결과는 테스트 구간의 관측 온도를 사용했습니다. 그 자리에 기상 예보가 들어가면 격차는 더 작아질 것입니다.
미래 값 예측
모델이 만족스러우면 전체 데이터로 다시 적합해, 가장 최근 달에서부터 예측을 시작하세요.
그런 다음 .get_forecast()로 예측합니다. 모든 미래 달의 모든 외생 변수에 대한 값이 필요합니다. 하나라도 누락되면 statsmodels는 오류를 발생시킵니다.
이 값들의 출처는 변수에 따라 다릅니다. 예를 들어:
- 알려진 달력 특성: 공휴일과 근무일 수는 수년 전에 알 수 있습니다
- 계획된 비즈니스 결정: 팀이 이미 일정을 잡았다면 가격과 프로모션을 알 수 있습니다
- 날씨: 온도는 기상 서비스나 다른 모델로 별도 예측이 필요합니다
- 과거 평균: 더 나은 것이 없다면 과거 데이터에서 달력 월별 평균값을 사용하세요
여기서는 기상 예보의 대체물로 마지막 옵션을 사용하겠습니다:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()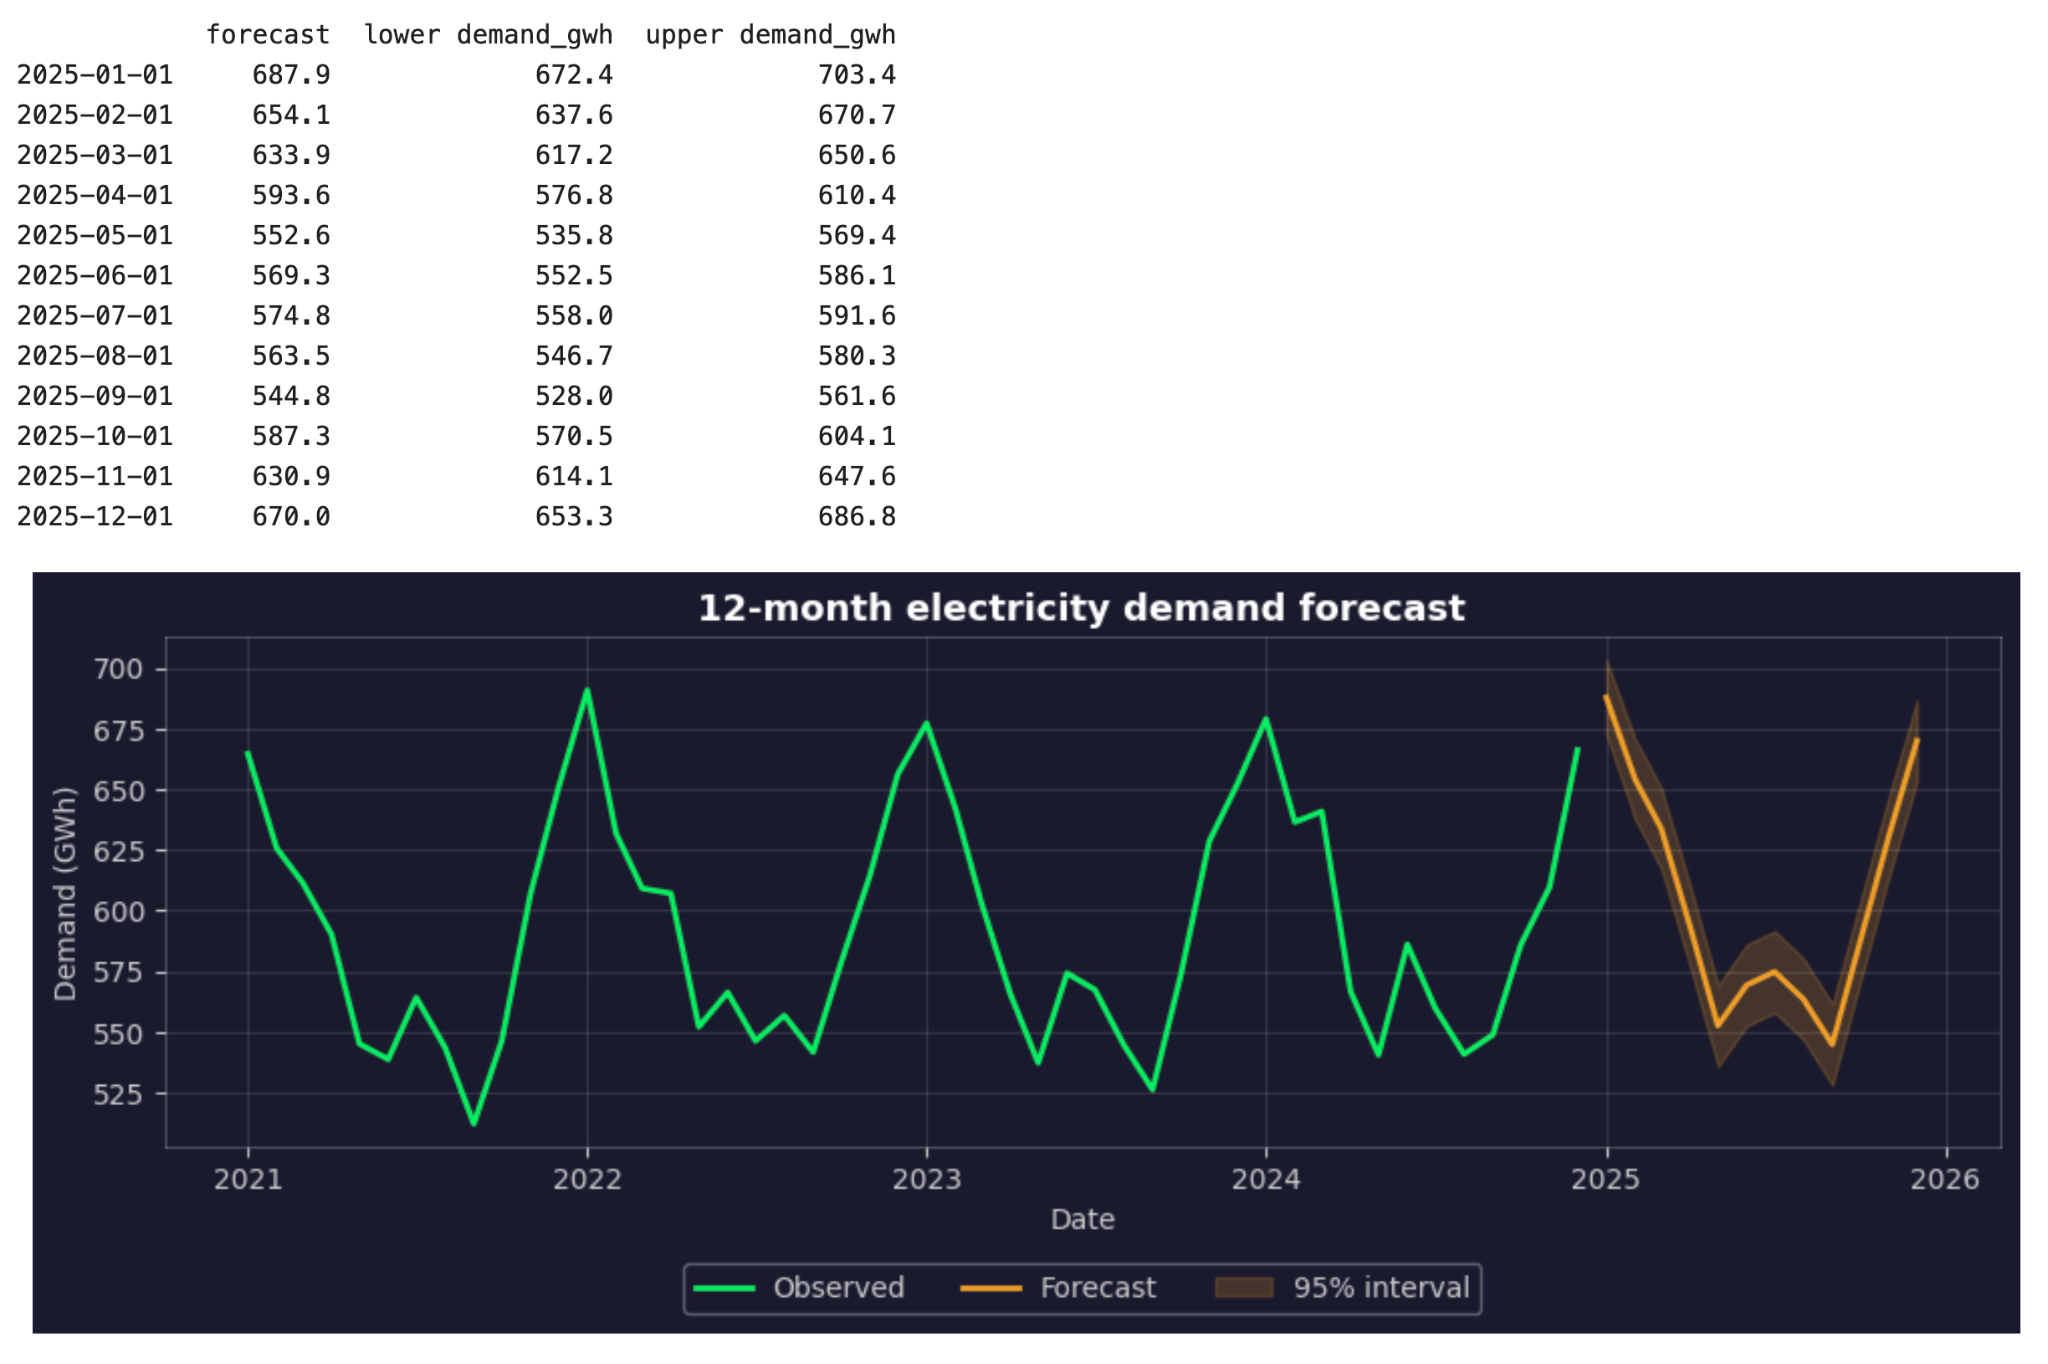
95% 예측 구간을 포함한 12개월 전력 수요 예측
예측은 익숙한 형태를 따릅니다. 겨울에 최고 수요, 여름에 더 작은 봉우리, 봄과 가을에 최저 수요가 나타납니다.
하지만 95% 구간은 제공한 온도 값이 주어졌을 때 적합된 모델의 불확실성만을 반영합니다. 온도 자체의 불확실성은 포함하지 않습니다. 1월이 평균보다 훨씬 추우면, 모델이 올바르더라도 실제 수요가 구간 밖에 있을 수 있습니다.
예측의 민감도를 보고 싶다면, 더 춥고 더 더운 온도 시나리오로 다시 실행해 결과를 비교해 보세요.
SARIMAX의 한계
SARIMAX는 많은 계절성 예측 문제에 좋은 모델이지만, 한계도 있습니다. 알아두어야 할 점은 다음과 같습니다:
-
미래 예측 변수가 필요: 모든 미래 달의 모든 외생 변수 값 없이는 예측할 수 없습니다. 사전에 알 수 없고 예측도 못 하는 변수라면, 과거 데이터의 적합도를 아무리 개선해도 모델에 넣을 수 없습니다
-
예측 변수의 불확실성은 숨겨짐: 미래 예측 변수가 자체적으로 예측치라면, 그 오차가 수요 예측으로 전파됩니다. 표준 예측 구간은 이를 포함하지 않아 실제보다 좁아 보입니다
-
하나의 계절 주기만 처리: 표준 형태는 단일
S만 지원합니다. 시간별 전력 수요는 일간과 주간 주기가 있는데, SARIMAX는 둘을 동시에 모델링할 수 없습니다. 또한S = 168처럼 시간별 데이터의 주간 주기처럼 긴 계절 주기에서는 느려집니다 -
관계는 변할 수 있음: 모델은 학습 데이터의 패턴이 미래에도 유지된다고 가정합니다. 더 많은 가정이 히트펌프로 전환하면, 추위가 수요에 미치는 영향이 바뀌고 기존 계수로는 설명이 안 됩니다. 신선한 데이터로 정기적으로 모델을 재적합하고, 시간이 지남에 따라 정확도를 추적하세요
-
매개변수 선택은 신중해야 함: AIC가 낮은 모델도 나쁜 예측을 할 수 있습니다. AIC와 BIC는 학습 데이터만 보기에, 최종 후보는 홀드아웃 구간에서 테스트하거나, 더 나아가 여러 시간 창에서 시계열 교차검증을 하세요
-
인과 모델이 아님: 유의한 계수는 예측에 도움이 된다는 뜻이지, 타깃을 변화시킨다는 뜻은 아닙니다. 가격을 바꾸면 수요가 어떻게 되는지 알고 싶다면 인과추론 기법이 필요합니다
맺음말
데이터에 계절 패턴이 반복되고 외부 요인에 좌우된다면, SARIMAX를 시도할 가치가 있습니다. 시계열의 역사와 그것을 움직이는 외부 요인을 결합하기 때문입니다. 둘 다 있는 데이터에서는 보통 하나만 보는 모델보다 낫습니다.
여기서 기억할 점은, 모델은 입력만큼만 좋다는 것입니다. 데이터에 근거해 계절 주기를 선택하고, 예측 변수를 주의 깊게 정렬하고, AIC를 맹신하지 말고 미래 데이터로 테스트하세요. 그리고 구축 전에 모든 예측 변수의 미래 값을 확보할 수 있는지 확인하세요. 마지막을 할 수 없다면, SARIMAX는 해당 데이터셋에 맞는 선택이 아닙니다.
계속 학습하고 싶다면, 오후 한나절 만에 기초를 이해할 수 있는 Time Series Analysis in Python 과정에 등록하세요.