Załóżmy, że celem jest miesięczny popyt na energię elektryczną. Modele takie jak ARIMA i SARIMA patrzą wyłącznie na przeszłe wartości szeregu oraz własne błędy prognoz z przeszłości. Ale popyt zależy też od czynników zewnętrznych, jak temperatura: gorące lato go zwiększa, podobnie jak mroźna zima. Jeśli model nie widzi tych czynników, traktuje każdy nietypowy miesiąc jak szum i powtarza ten sam błąd, gdy tylko pogoda znów się zmieni.
SARIMAX rozwiązuje ten problem, dodając do sezonowego modelu ARIMA zmienne zewnętrzne (egzogeniczne). Wciąż uczy się trendu i sezonowości z historii szeregu, ale wykorzystuje też informacje z zewnątrz, które wyjaśniają to, czego nie widać w samych wartościach przeszłych.
Jeśli potrzebujesz wprowadzenia do manipulowania, interpretowania i wizualizacji danych szeregów czasowych w Python, zapisz się na naszą ścieżkę Time Series in Python i ogarnij podstawy w tydzień.
Czym jest SARIMAX?
SARIMAX to sezonowy model ARIMA, który może też używać zewnętrznych predyktorów. Nazwa pochodzi od Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors.
SARIMAX działa, przewidując szereg docelowy na podstawie czterech źródeł informacji:
- Wartości z przeszłości: popyt w ostatnich miesiącach
- Błędy prognoz z przeszłości: jak bardzo mylił się model w ostatnich miesiącach
- Wzorce sezonowe: popyt w tym samym miesiącu w poprzednich latach
- Zmienne egzogeniczne: dane zewnętrzne dodane do modelu, np. średnia miesięczna temperatura
Załóżmy, że chcesz prognozować popyt na energię na lipiec przyszłego roku. SARIMAX patrzy na popyt w ostatnich miesiącach, na popyt w poprzednich lipcach oraz na oczekiwaną temperaturę w lipcu. Dwie pierwsze informacje są w szeregu, a temperatura pochodzi z zewnątrz.
Model zapisuje się jako SARIMAX(p, d, q)(P, D, Q, S). Pierwszy zestaw parametrów opisuje zachowanie krótkookresowe, a drugi składnik sezonowy, gdzie S to liczba kroków czasu w jednym cyklu. Dla danych miesięcznych z rocznym wzorcem S wynosi 12.
Zmienne egzogeniczne nie są uwzględnione w tej notacji. Przekazujesz je do modelu osobno, jako oddzielne wejście.
Jak działa SARIMAX
SARIMAX ma dwie grupy składników, a zmienne zewnętrzne są dodane ponad nimi.
Składniki niesezonowe (p, d, q) modelują zachowanie krótkookresowe:
-
Rząd autoregresji
p: ile przeszłych wartości wykorzystuje model. Przyp = 2popyt w tym miesiącu zależy od popytu w dwóch poprzednich miesiącach -
Rząd różnicowania
d: ile razy model różnicuje szereg, by usunąć trend. Przyd = 1model pracuje na zmianach miesiąc do miesiąca zamiast na surowym popycie -
Rząd średniej ruchomej
q: ile przeszłych błędów prognozy wykorzystuje model. Jeśli model zaniżył popyt w zeszłym miesiącu, ten błąd wpływa na prognozę w tym miesiącu
Składniki sezonowe (P, D, Q, S) robią to samo, ale na opóźnieniach sezonowych:
-
Sezonowy rząd autoregresji
P: ile przeszłych sezonów uwzględnia model. PrzyP = 1i danych miesięcznych popyt w tym lipcu zależy od popytu w zeszłorocznym lipcu -
Sezonowy rząd różnicowania
D: ile razy model różnicuje szereg na opóźnieniu sezonowym. PrzyD = 1model porównuje ten lipiec z zeszłorocznym lipcem, co usuwa powtarzający się roczny wzorzec -
Sezonowy rząd średniej ruchomej
Q: ile przeszłych błędów prognozy na opóźnieniach sezonowych wykorzystuje model, np. błąd z zeszłorocznego lipca -
Okres sezonowy
S: ile kroków ma jeden cykl. To 12 dla danych miesięcznych z rocznym wzorcem i 7 dla danych dziennych z tygodniowym wzorcem
Zmienne egzogeniczne dodają informacje, których nie ma w szeregu.
W przykładzie z popytem na energię chodzi o temperaturę. Gorące lato lub mroźna zima zwiększa popyt, a przeszłe wartości popytu nie powiedzą modelowi, jaka będzie pogoda w przyszłym miesiącu. Wzorzec „miesiąc w roku” i tak pochodzi ze składników sezonowych, więc temperatura to jedyna zewnętrzna zmienna, której ten przykład potrzebuje.
W statsmodels SARIMAX to regresja liniowa na zmiennych egzogenicznych, gdzie błędy podążają za sezonowym procesem ARIMA. Przy jednej zmiennej egzogenicznej wygląda to tak:
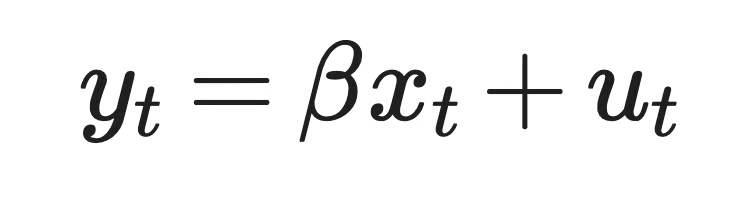
SARIMAX z jedną zmienną egzogeniczną
Tutaj y_t to popyt na energię w miesiącu t, x_t to temperatura w tym miesiącu, beta to współczynnik temperatury, a u_t to część popytu, której temperatura nie wyjaśnia. Składniki niesezonowe i sezonowe modelują u_t.
Mówiąc po prostu: temperatura wyjaśnia część popytu, a składniki SARIMA modelują resztę.
Oto bardziej wizualny przegląd:
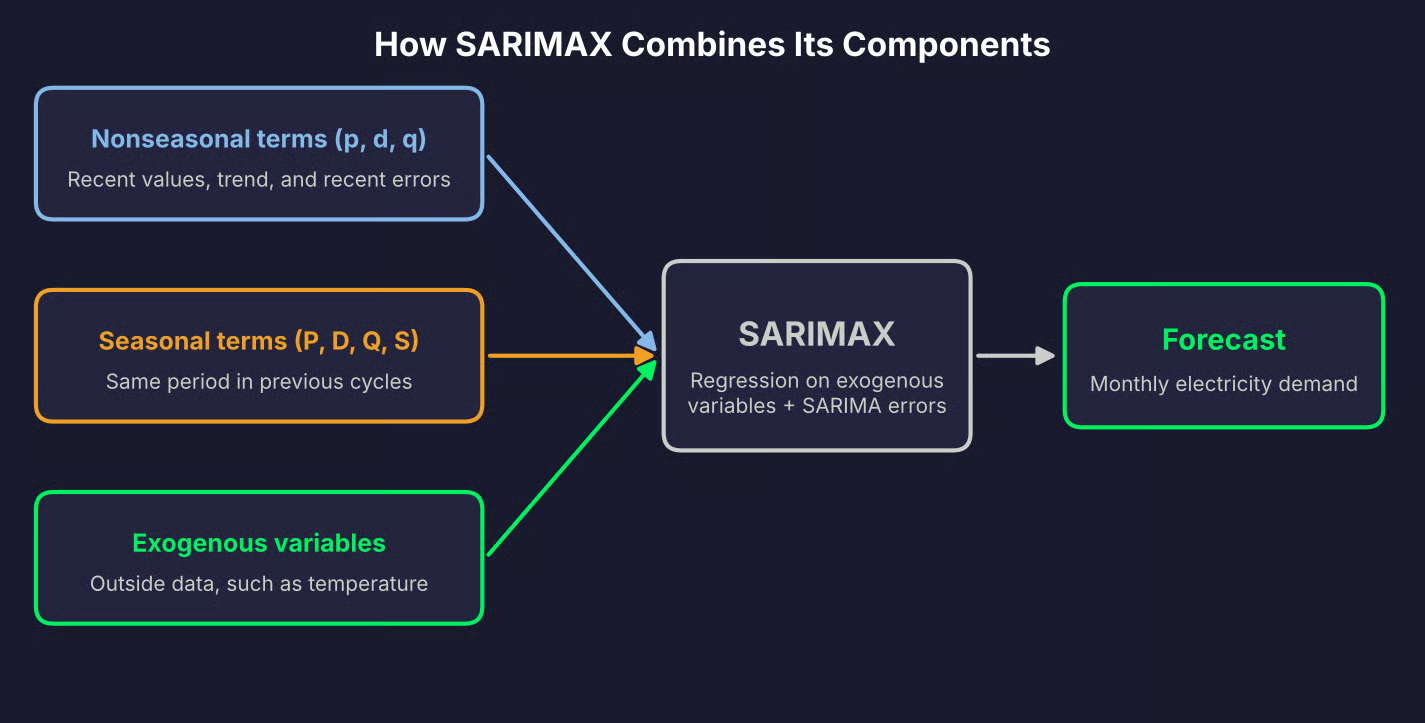
Składniki SARIMAX
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
Te cztery modele należą do tej samej rodziny. Różnice są subtelne, ale zrozumiesz je po jednym przeczytaniu.
ARIMA modeluje szereg na podstawie jego własnych wartości z przeszłości i błędów prognoz z przeszłości. SARIMA dodaje do tego składniki sezonowe, więc potrafi modelować wzorce powtarzające się co S kroków czasowych. ARIMAX dodaje zmienne egzogeniczne do ARIMA, ale domyślnie nie ma składników sezonowych. SARIMAX ma oba.
Dlatego SARIMAX może reprezentować pozostałe modele jako przypadki szczególne. Jeśli nie przekażesz żadnych zmiennych egzogenicznych, dostajesz model SARIMA. Jeśli ustawisz wszystkie rzędy sezonowe na zero, dostajesz niemodulowany sezonowo model ARIMAX. A bez obu to model ARIMA.
Niestety, terminologia nie jest spójna między pakietami.
Podręcznikowy ARIMAX umieszcza zmienne egzogeniczne bezpośrednio w równaniu ARIMA, obok wartości szeregu z przeszłości. SARIMAX w statsmodels dopasowuje zamiast tego regresję z błędami SARIMA, jak pokazano wcześniej. Obie formy szacują różne współczynniki, więc ta sama temperatura może dostać inny współczynnik w zależności od pakietu.
Nazwy klas i funkcji też się nie pokrywają. Klasa ARIMA w statsmodels przyjmuje również składniki sezonowe i zmienne egzogeniczne. W R pakiet forecast obsługuje zewnętrzne regresory poprzez argument xreg w Arima() i auto.arima(). Dlatego przed porównywaniem wyników między narzędziami sprawdź, jak każdy pakiet definiuje model.
Krótka powtórka:
| Sezonowość? | Zmienne zewnętrzne? | |
|---|---|---|
| ARIMA | Nie | Nie |
| SARIMA | Tak | Nie |
| ARIMAX | Nie domyślnie | Tak |
| SARIMAX | Tak | Tak |
Porównanie rodziny modeli ARIMA
Kiedy używać SARIMAX
SARIMAX ma sens, gdy cel ma powtarzający się wzorzec sezonowy, a zmienne zewnętrzne mogą poprawić prognozę.
Na przykład:
- Popyt na energię elektryczną: temperatura i efekty kalendarzowe, np. święta, ponad rocznym cyklem
- Sprzedaż detaliczna: promocje, ceny i okresy świąteczne
- Rezerwacje hotelowe: wydarzenia lokalne i ceny pokoi, ponad rocznym sezonem turystycznym
- Liczba pasażerów komunikacji publicznej: pogoda i ferie szkolne, ponad tygodniowym wzorcem w danych dziennych
Ale SARIMAX nie zawsze jest właściwym wyborem. W dwóch sytuacjach prostszy model zrobi to samo:
- Brak istotnej sezonowości: jeśli szereg nie powtarza wzorca, składniki sezonowe tylko dodają parametry do oszacowania. Wystarczy ARIMA lub ARIMAX
- Predyktory nie poprawiają dokładności: jeśli zmienne egzogeniczne nie zmniejszają błędu na wydzielonym okresie testowym, usuń je i użyj SARIMA. Lepsze dopasowanie do danych treningowych się nie liczy
Pamiętaj, że SARIMAX potrzebuje wartości dla każdej zmiennej egzogenicznej w okresie prognozy.
Niektóre wartości są znane z wyprzedzeniem, np. święta czy planowane promocje. Inne, jak temperatura, trzeba prognozować osobno, zanim SARIMAX będzie mógł ich użyć. Jeśli nie możesz zdobyć przyszłych wartości predyktora, nie możesz użyć go w prognozie.
Jak zbudować model SARIMAX w Pythonie
W tej sekcji zbuduję model SARIMAX w statsmodels, od surowych danych po 12‑miesięczną prognozę.
Przykład używa syntetycznego miesięcznego popytu na energię z temperaturą jako zmienną zewnętrzną. Jest mały, powtarzalny i spójny z resztą artykułu.
Przygotuj dane
Zbiór obejmuje dziesięć lat danych miesięcznych, od stycznia 2015 do grudnia 2024.
Popyt ma rosnący trend, roczny wzorzec kalendarzowy, który powoli się zmienia, efekt pogodowy i szum. Dwie wartości temperatury celowo pominięto, by pokazać, jak radzić sobie z lukami:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())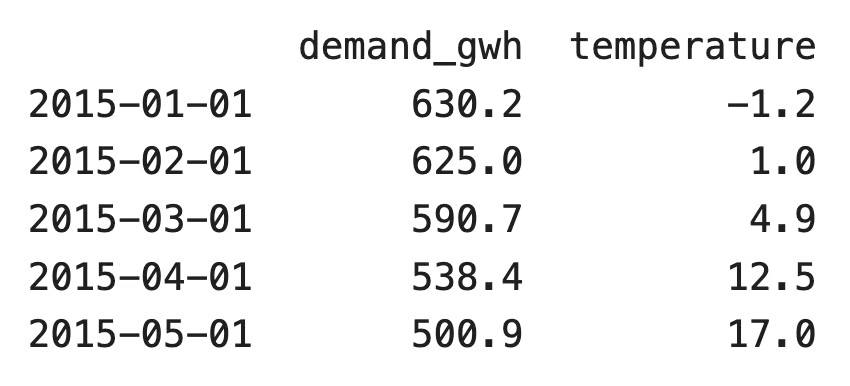
Pierwsze pięć wierszy zbioru danych
Albo, jeśli wolisz przegląd wizualny:
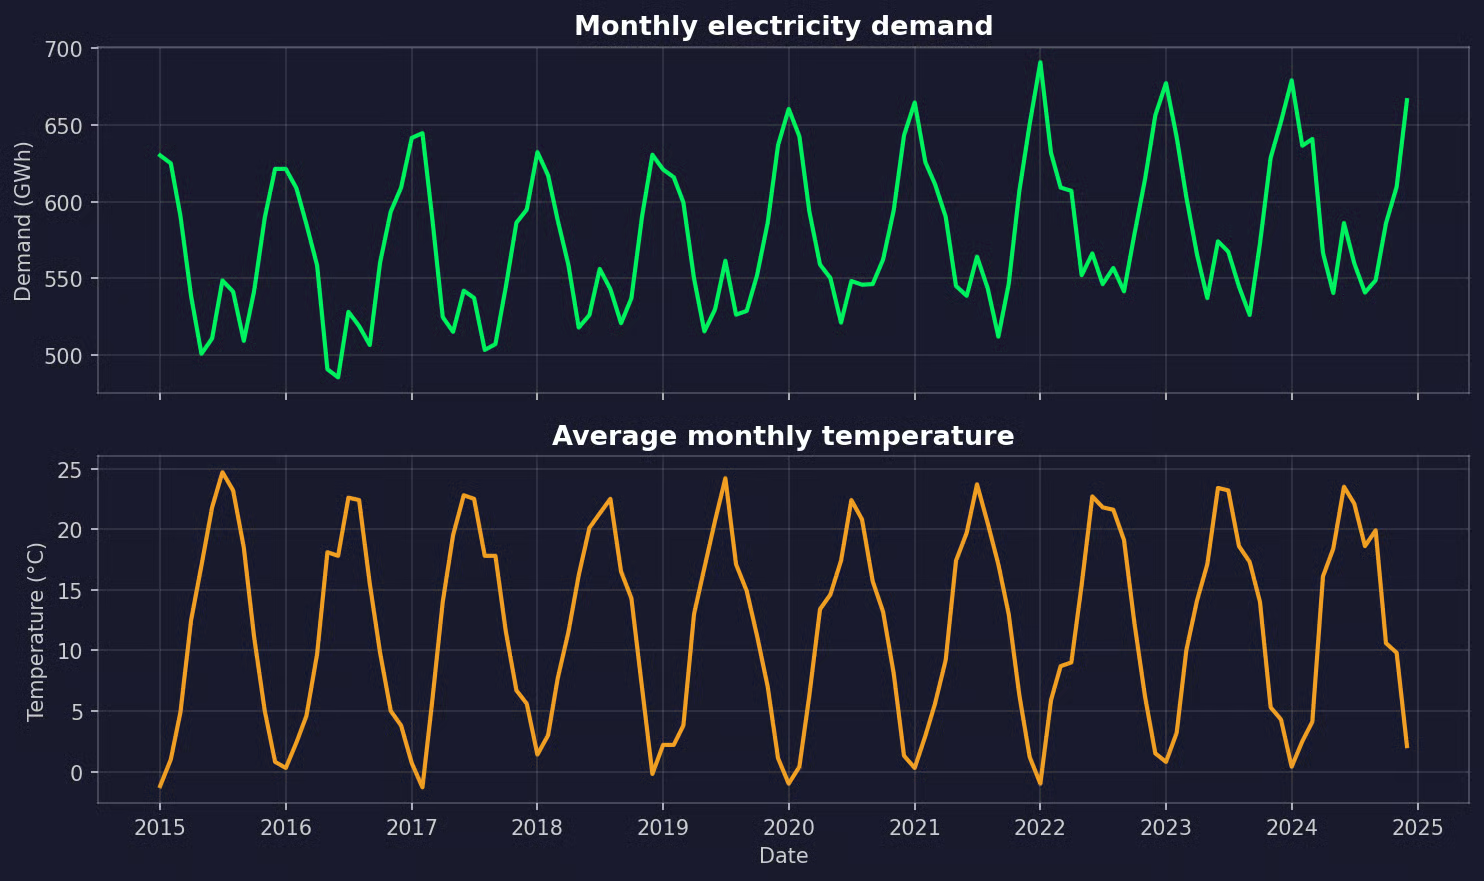
Zbiór temperatur
Jeśli pracujesz na własnych danych, wczytaj je przez pd.read_csv() i ustaw kolumnę daty jako indeks. Reszta przebiegu pracy pozostaje taka sama.
SARIMAX potrzebuje indeksu czasowego ze spójną częstotliwością. Metoda .asfreq() ustawia ją na miesięczną i wstawia pusty wiersz dla brakującego miesiąca. Potem możesz policzyć luki i je uzupełnić:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()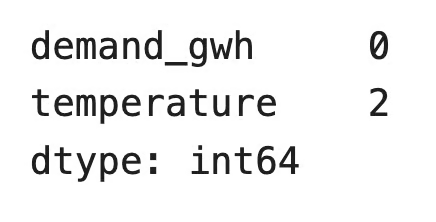
Interpolowanie luk w temperaturze
Interpolacja liniowa działa tutaj, bo temperatura zmienia się płynnie z miesiąca na miesiąc. Nie rób tego samego dla celu, jeśli brakuje dużych fragmentów. Uczyłbyś model na zmyślonych wartościach.
Teraz zmienne egzogeniczne. Popyt rośnie, gdy jest zimno i gdy jest gorąco, ale regresja liniowa na surowej temperaturze nie odwzoruje kształtu litery U. Dlatego podzielę temperaturę na dwie cechy:
- Stopnie grzania: o ile stopni średnia temperatura jest poniżej 18°C, w przeciwnym razie zero
- Stopnie chłodzenia: o ile stopni średnia temperatura jest powyżej 18°C, w przeciwnym razie zero
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
Teraz rozdziel dane na cel y i zmienne egzogeniczne X. Podział musi być chronologiczny: model trenuje na przeszłości i jest testowany na przyszłości. Losowy podział wycieknie informacje o przyszłości do treningu:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")
Podział na zbiory treningowy/testowy
Pamiętaj, że X_test zawiera rzeczywiście zaobserwowane temperatury. W prawdziwej prognozie nie znałbyś ich z góry — co najwyżej miałbyś prognozę pogody. Oznacza to, że wynik testu, który zobaczysz później, jest optymistyczny. Używaj obserwowanych wartości predyktorów do oceny tylko wtedy, gdy te same wartości będą dostępne w chwili prognozy, jak święta czy planowane ceny.
Zbadaj sezonowość i stacjonarność
Zacznij od wykresu. Szukasz trendów, cykli sezonowych i nagłych zmian:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()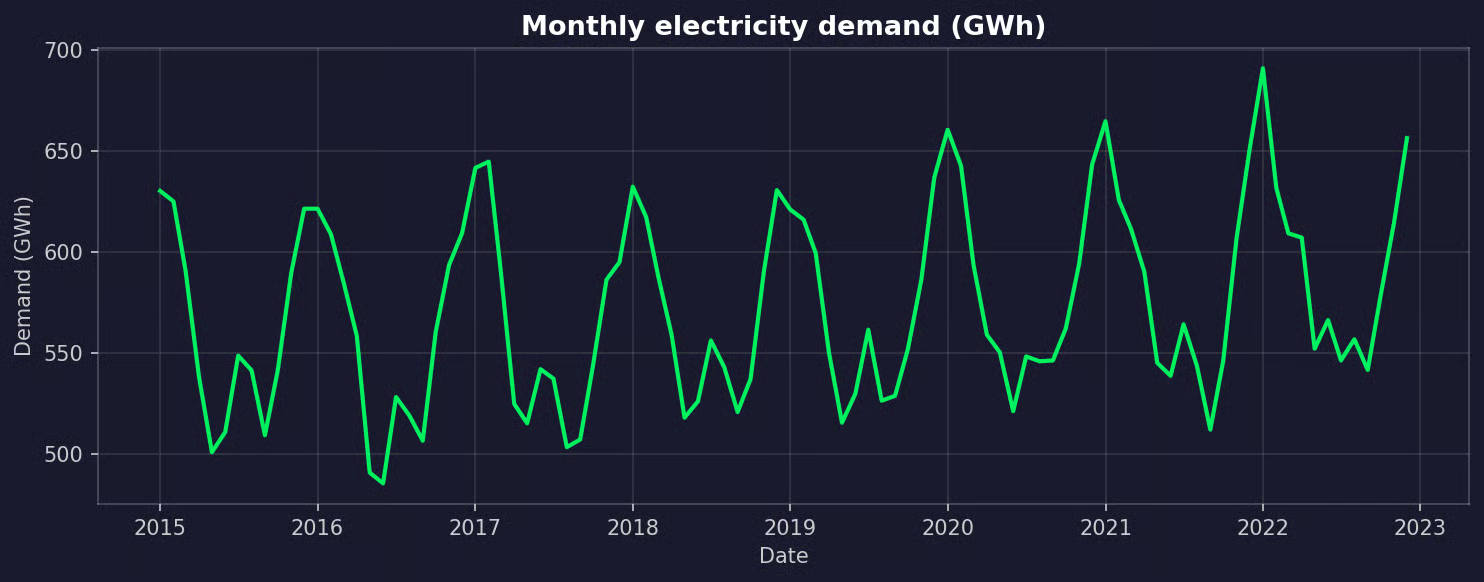
Miesięczny popyt na energię w okresie treningowym
Popyt rośnie w czasie i osiąga szczyt każdej zimy, z mniejszym pikiem latem. Wzorzec powtarza się co 12 miesięcy.
Dekompozycja sezonowa podzieli szereg na trend, składnik sezonowy i resztę, dzięki czemu potwierdzisz okres sezonowy S:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()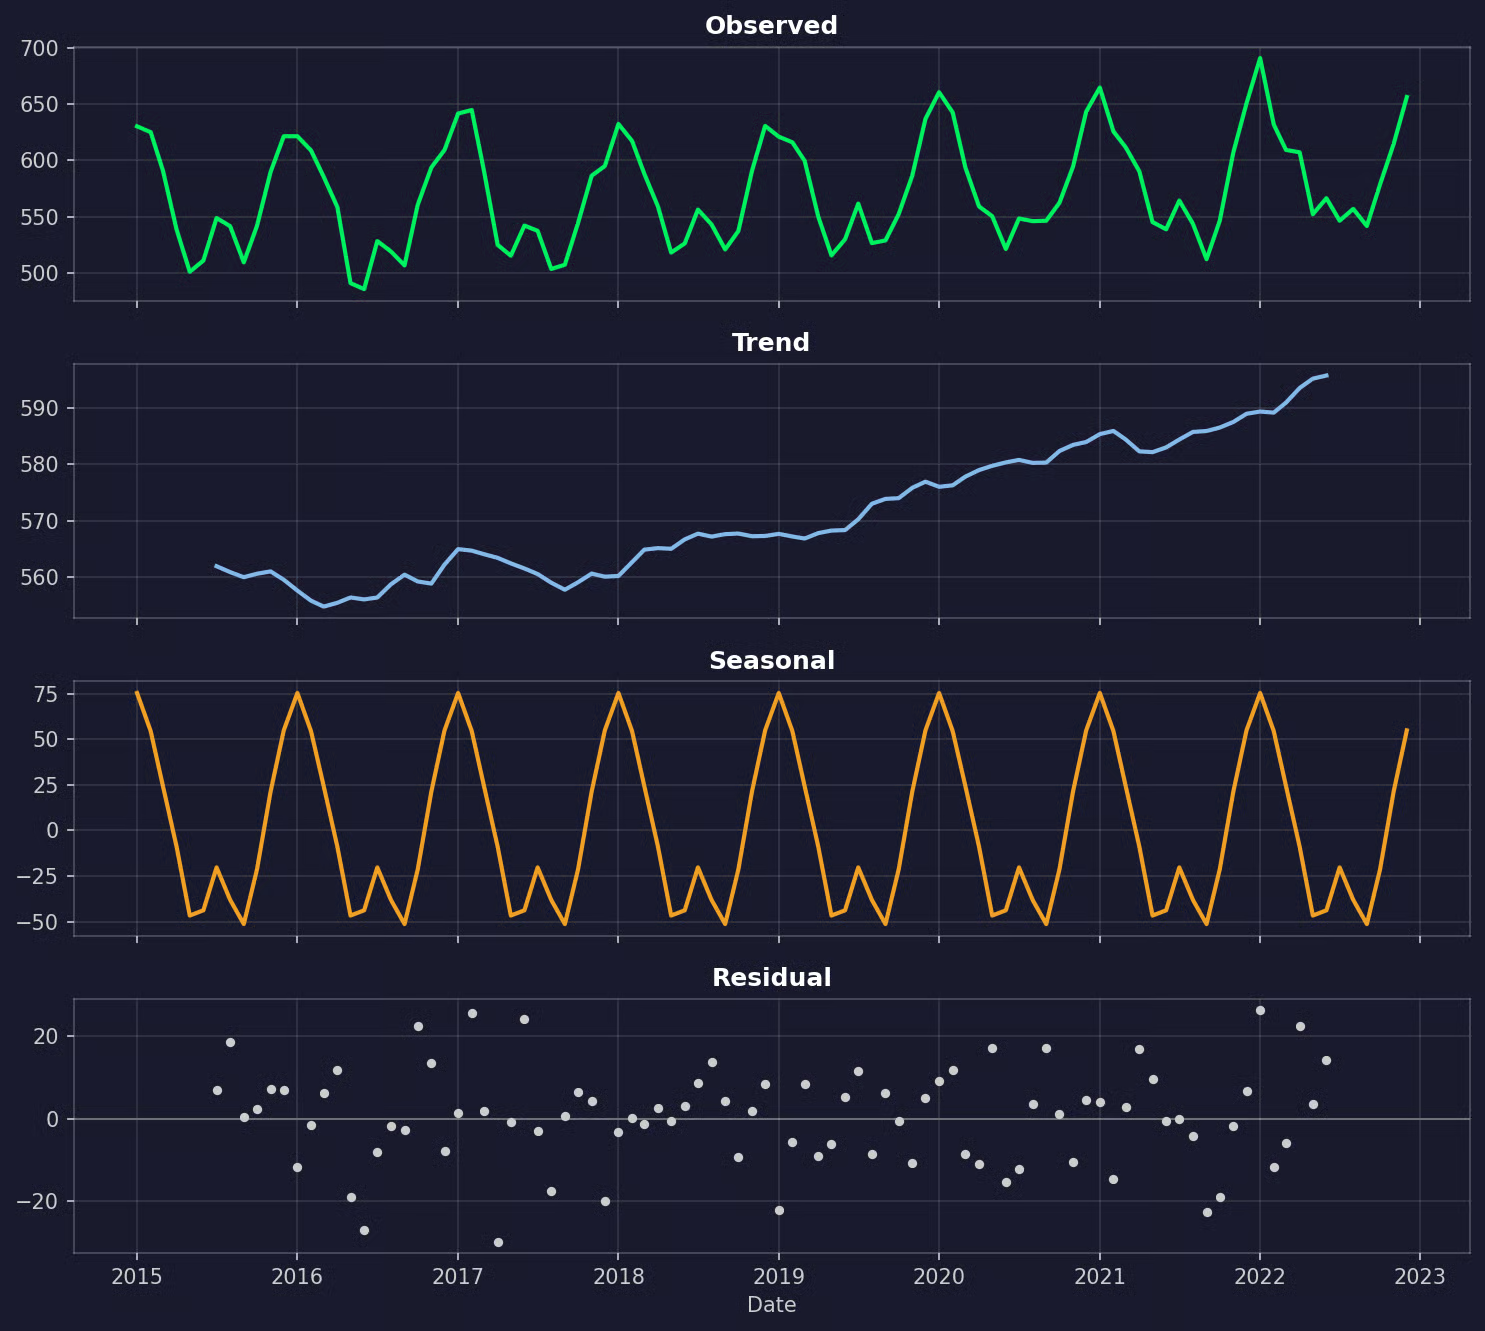
Dekompozycja sezonowa popytu na energię
Składnik sezonowy powtarza się co rok, więc S = 12.
Modele rodziny ARIMA potrzebują szeregu stacjonarnego — takiego, którego średnia i wariancja nie zmieniają się w czasie. Popyt nie jest stacjonarny, bo ma trend i cykl sezonowy.
Różnicowanie to sposób, by to obejść:
-
Różnicowanie zwykłe (
d): odejmuje wartość z zeszłego miesiąca od wartości z tego miesiąca. Usuwa trend -
Różnicowanie sezonowe (
D): odejmuje wartość z tego samego miesiąca w zeszłym roku. Usuwa powtarzający się wzorzec sezonowy, a także liniowy trend
Test rozszerzonego Dickeya-Fullera (ADF) sprawdza stacjonarność. Hipoteza zerowa mówi, że szereg nie jest stacjonarny, więc mała wartość p (poniżej 0,05) świadczy, że jest stacjonarny:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")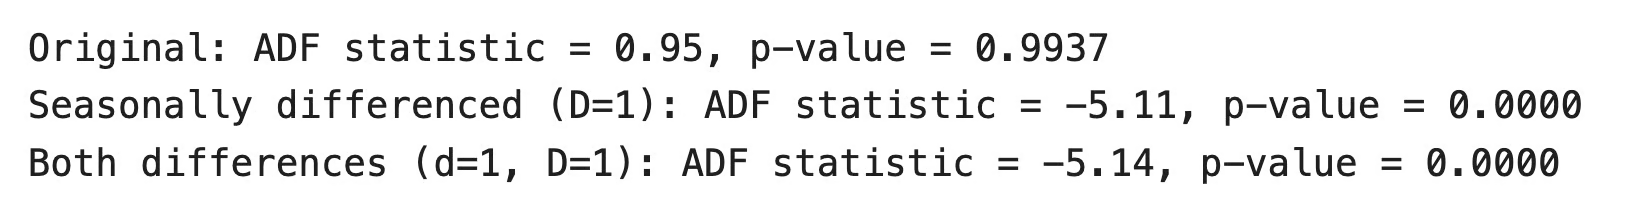
Wynik testu ADF
Oryginalny szereg nie jest stacjonarny. Sama różnica sezonowa to naprawia, więc zwykłe różnicowanie nic nie dodaje. Używaj najmniejszej liczby różnic, która działa — dodatkowe różnice dodają szum i utrudniają dopasowanie modelu.
Wybór to więc d = 0 i D = 1.
Ale traktuj test ADF tylko jako dowód pomocniczy. Nie mówi nic o p, q, P ani Q, a przy krótkich szeregach może dawać różne odpowiedzi zależnie od ustawień.
Wybierz kandydatów na parametry
Wykresy ACF i PACF pomagają wybrać kandydatów na pozostałe rzędy:
-
ACF (funkcja autokorelacji): pokazuje korelację między szeregiem a jego opóźnionymi wartościami. Piki w ACF wskazują na składniki średniej ruchomej:
qdla krótkich opóźnień iQdla sezonowych -
PACF (częściowa funkcja autokorelacji): pokazuje tę samą korelację, ale usuwa wpływ opóźnień pośrednich. Piki w PACF wskazują na składniki autoregresyjne:
pdla krótkich opóźnień iPdla sezonowych
Powinieneś narysować oba dla szeregu z różnicowaniem sezonowym, bo na takim szeregu pracuje model:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()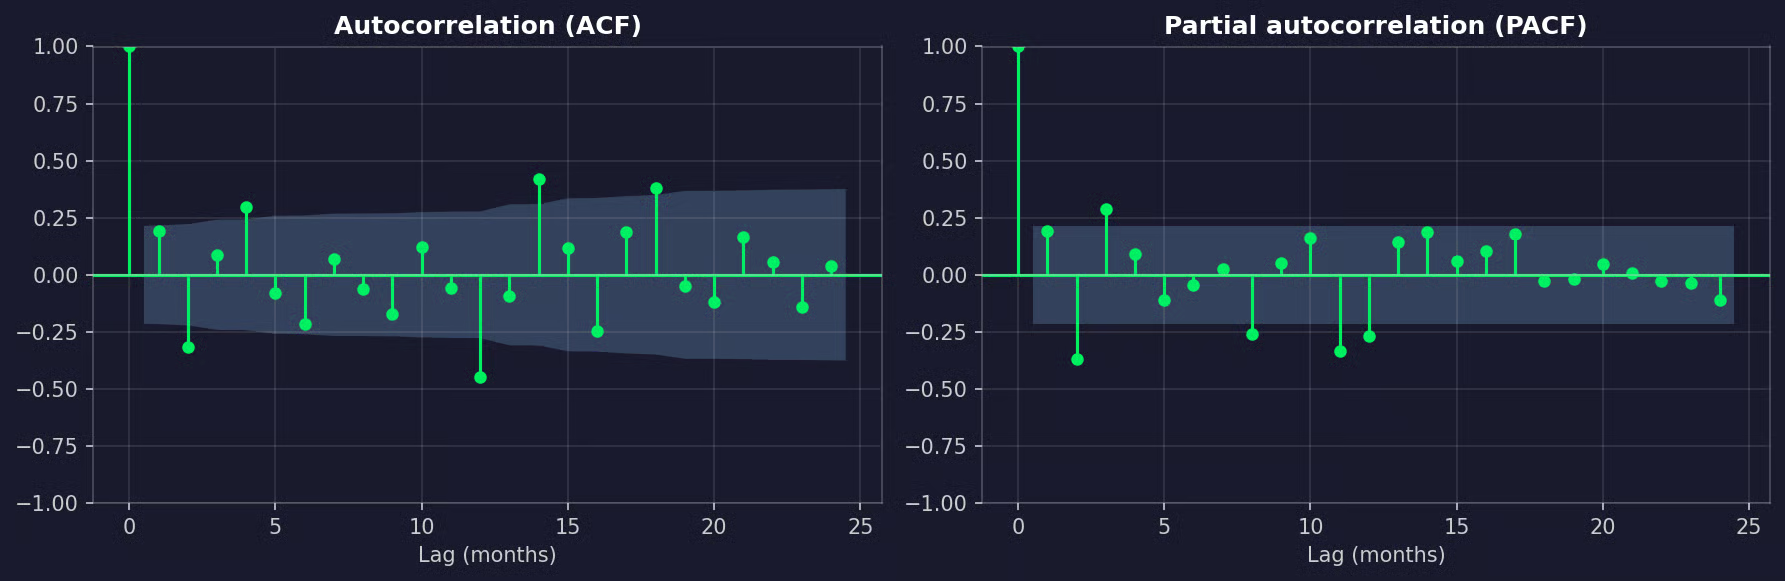
Wykresy ACF i PACF popytu na energię po różnicowaniu sezonowym
ACF ma wyraźny ujemny pik przy opóźnieniu 12 i nic przy 24. To typowy znak sezonowego składnika średniej ruchomej, więc Q = 1 to dobry kandydat. Oba wykresy pokazują też kilka pików przy krótkich opóźnieniach, więc warto przetestować p i q.
Kolejny krok to dopasowanie niewielkiego zestawu modeli-kandydatów i porównanie ich AIC lub BIC. Oba mierzą dopasowanie do danych treningowych i karzą za dodatkowe parametry. Niżej znaczy lepiej, a BIC mocniej karze złożoność niż AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))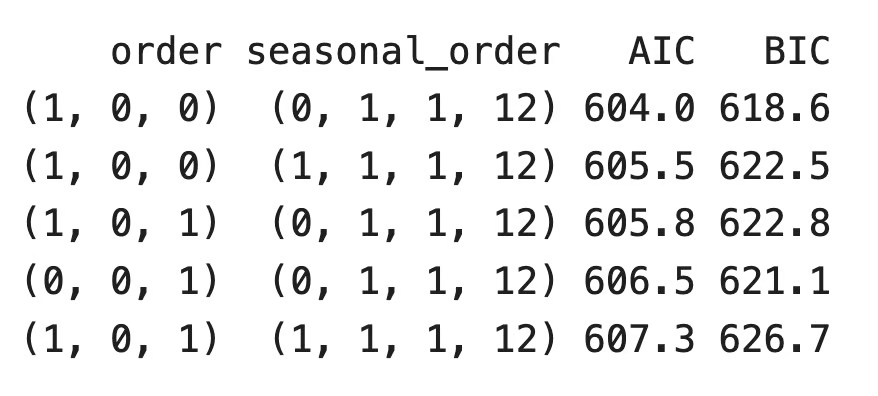
Wyniki AIC i BIC
SARIMAX(1, 0, 0)(0, 1, 1, 12) wygrywa zarówno w AIC, jak i BIC. To też jeden z najprostszych modeli na liście.
Argument trend="c" dodaje stałą. Przy różnicowaniu sezonowym stała modeluje wzrost rok do roku w popycie.
Znajdziesz narzędzia takie jak auto_arima() z biblioteki pmdarima, które zrobią ten przegląd za ciebie. Są wygodne na pierwszy rzut oka, ale AIC i BIC mierzą tylko dopasowanie do danych treningowych. Zanim zaufasz modelowi, przetestuj go na danych, których nie widział.
Dopasuj model
Przekaż cel jako pierwszy argument, a zmienne egzogeniczne przez exog. Argument order przyjmuje (p, d, q), a seasonal_order przyjmuje (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())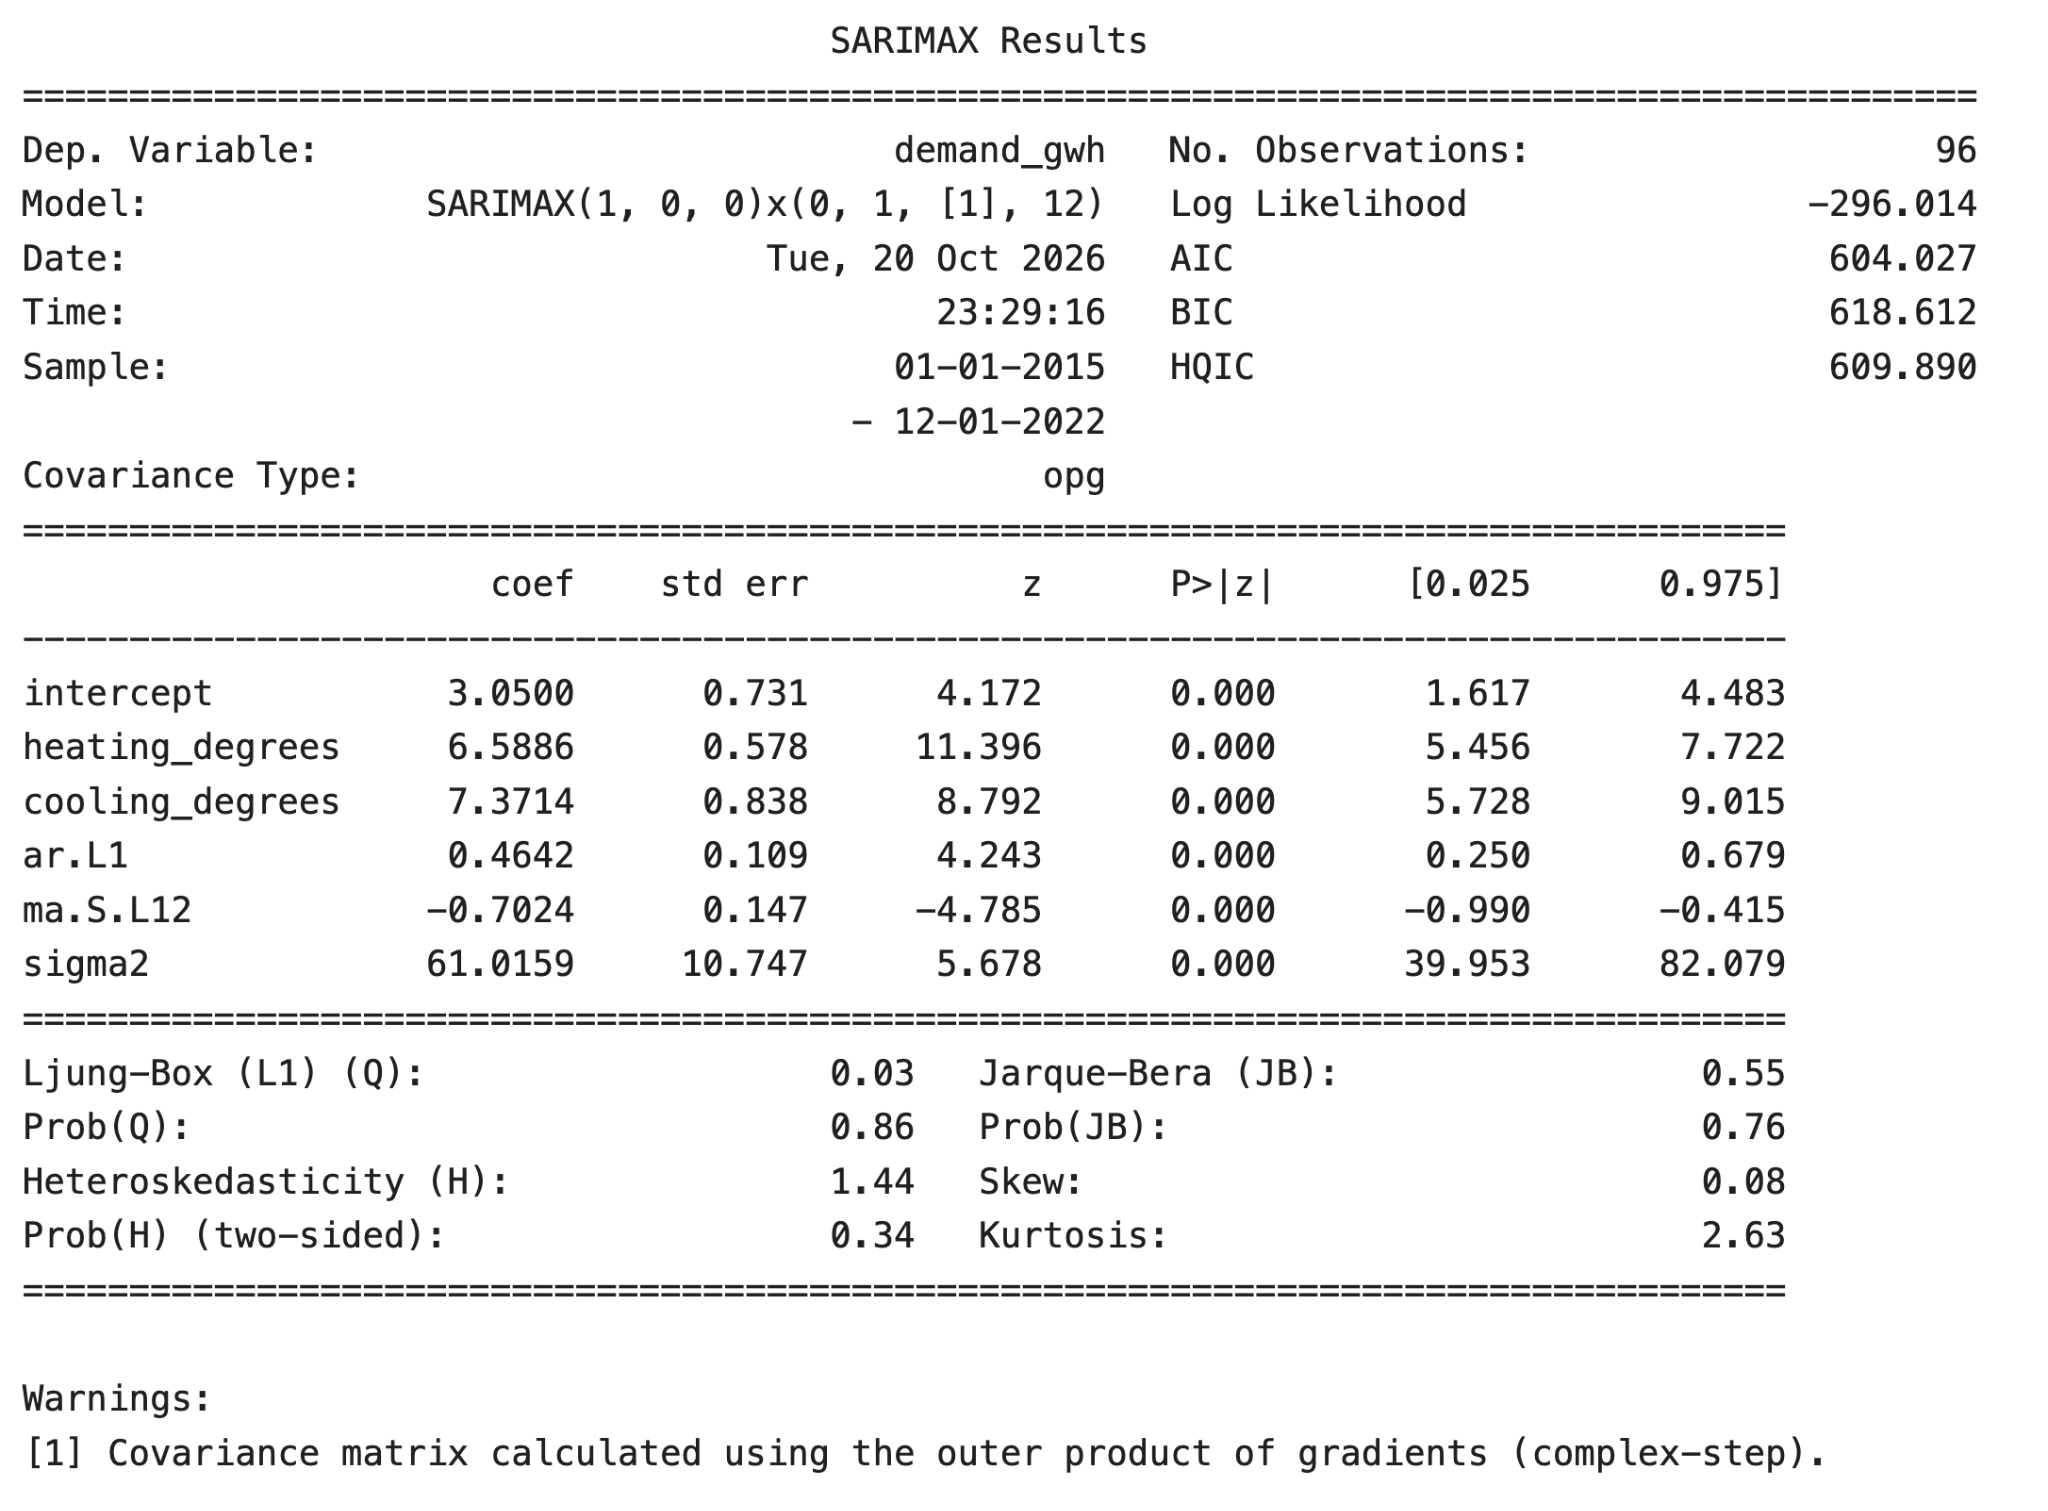
Podsumowanie modelu SARIMAX
Jak czytać tabelę współczynników:
-
heating_degrees: każdy dodatkowy stopień grzania wiąże się z ok. 6,6 GWh dodatkowego popytu, przy pozostałych składnikach modelu stałych -
cooling_degrees: każdy dodatkowy stopień chłodzenia wiąże się z ok. 7,4 GWh dodatkowego popytu -
ar.L1: ok. 46% zeszłomiesięcznej niewyjaśnionej różnicy przenosi się na ten miesiąc -
ma.S.L12: sezonowy składnik średniej ruchomej, który koryguje prognozę na podstawie błędu z tego samego miesiąca rok temu -
sigma2: wariancja pozostałego szumu
Wszystkie współczynniki mają wartości p bliskie zeru, więc każdy składnik coś wnosi do modelu.
Ale te współczynniki opisują zależności w dopasowanym modelu, a nie przyczyny. Tutaj wygenerowałem dane tak, że temperatura jest przyczyną popytu, więc odczyt jest bezpieczny. W prawdziwych danych predyktor może wyglądać na istotny, bo porusza się razem z czymś, czego model nie widzi.
Diagnozuj i oceń model
Dobry model zostawia reszty wyglądające jak losowy szum. Jeśli reszty mają wzorzec, model coś pominął.
Metoda .plot_diagnostics() daje cztery wykresy jednym wywołaniem:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()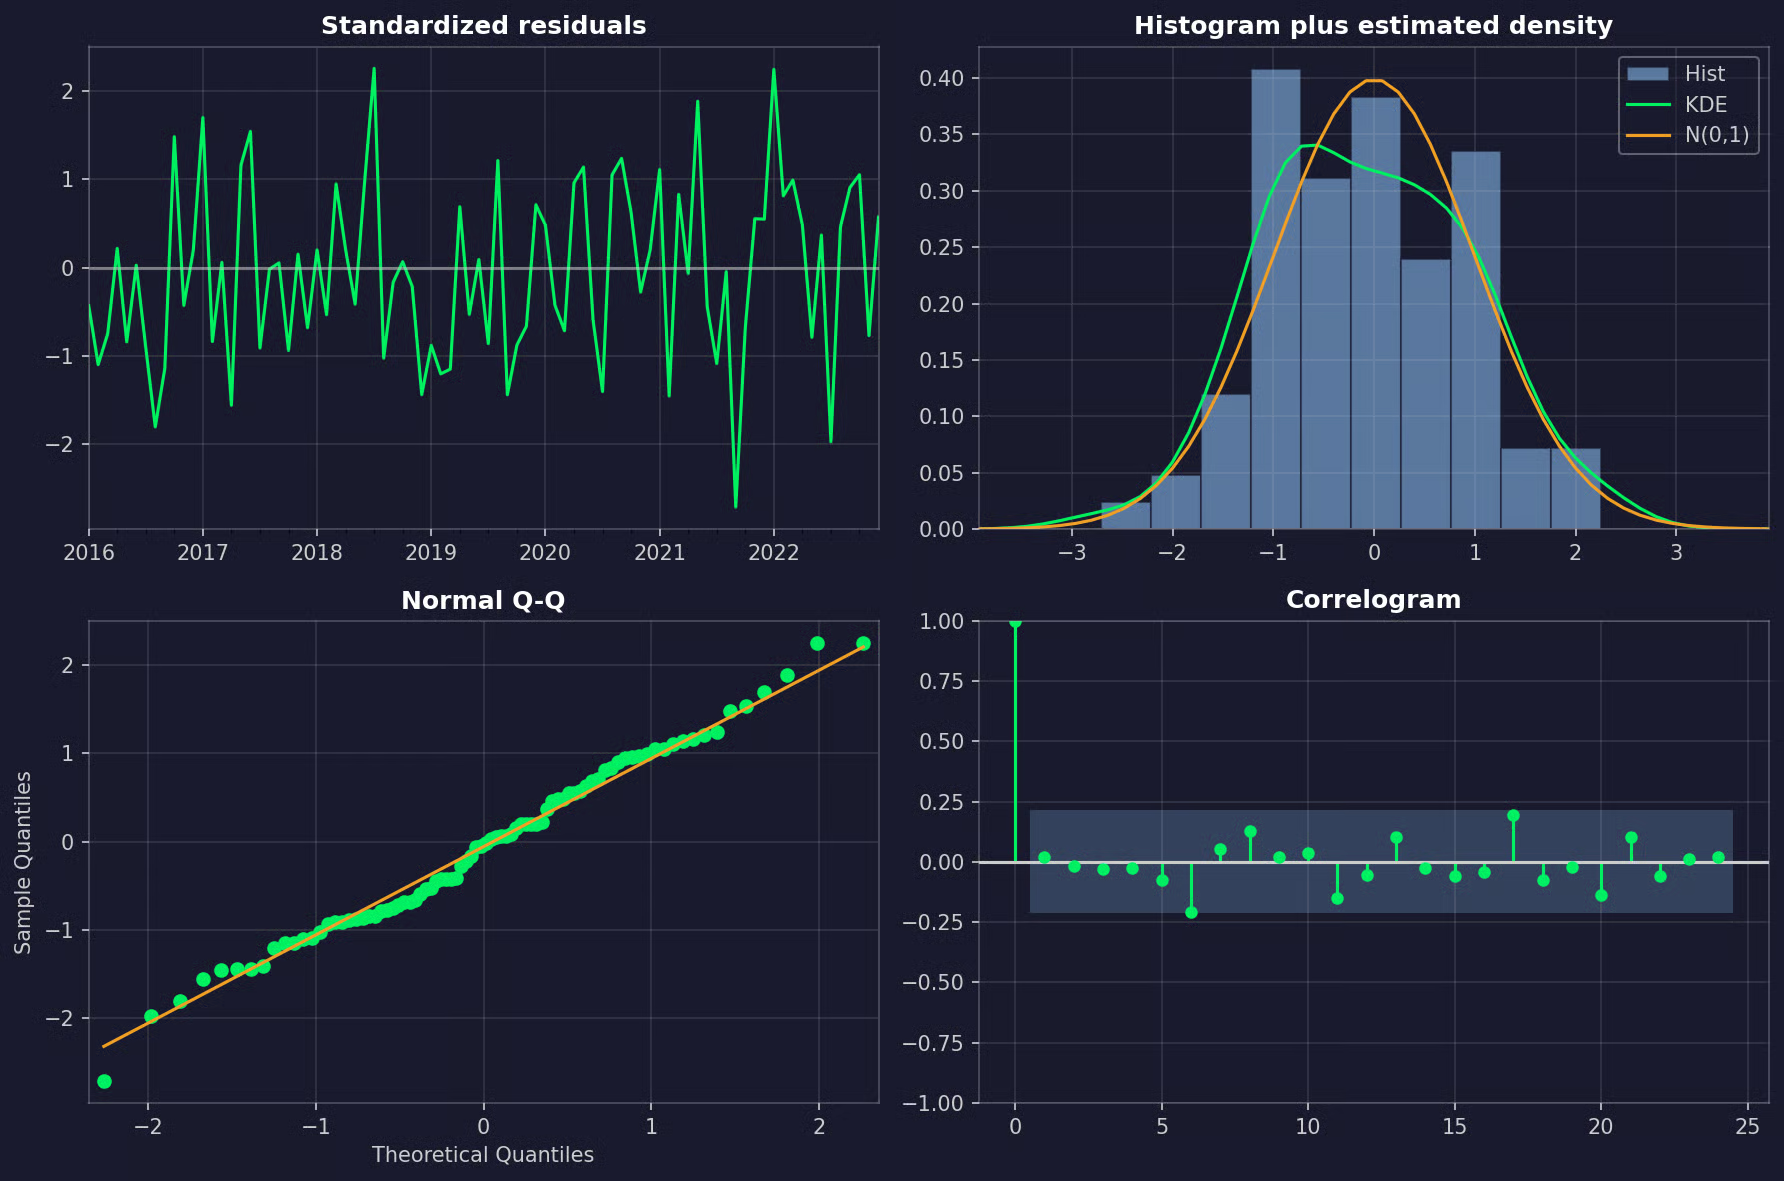
Wykres diagnostyki reszt
Na co zwracać uwagę:
- Zestandaryzowane reszty: bez trendu, bez powtarzającego się wzorca i bez okresów, gdzie rozrzut gwałtownie się zwiększa
- Histogram i wykres Q‑Q: punkty blisko rozkładu normalnego
- Korelogram: brak pików poza pasmem ufności, zwłaszcza przy opóźnieniu 12 — pik tam znaczy, że model nie do końca poradził sobie z sezonowością
Test Ljunga-Boxa daje ten sam sprawdzian w postaci liczby. Hipoteza zerowa mówi, że reszty nie mają autokorelacji do danego opóźnienia, więc chcesz duże wartości p:
# Skip the first 13 residuals, which come from the differencing start-up period
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))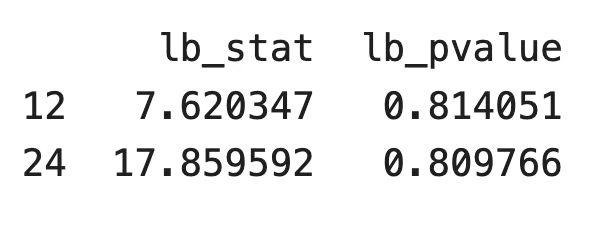
Wyniki testu Ljunga‑Boxa
Obie wartości p dużo powyżej 0,05, więc reszty wyglądają jak szum.
Teraz to, co najważniejsze — dokładność na danych, których model nie widział. Metoda .get_forecast() przewiduje 24 miesiące testowe i potrzebuje wartości egzogenicznych dla tych miesięcy.
Sama liczba prognozy niewiele znaczy, więc porównam SARIMAX z dwoma bazami odniesienia:
- Sezonowa prognoza naiwna: powtarza wartości z ostatnich 12 miesięcy treningu
- SARIMA: ten sam model, ale bez zmiennych egzogenicznych
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: repeat the last 12 observed months
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: the same model without exogenous variables
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()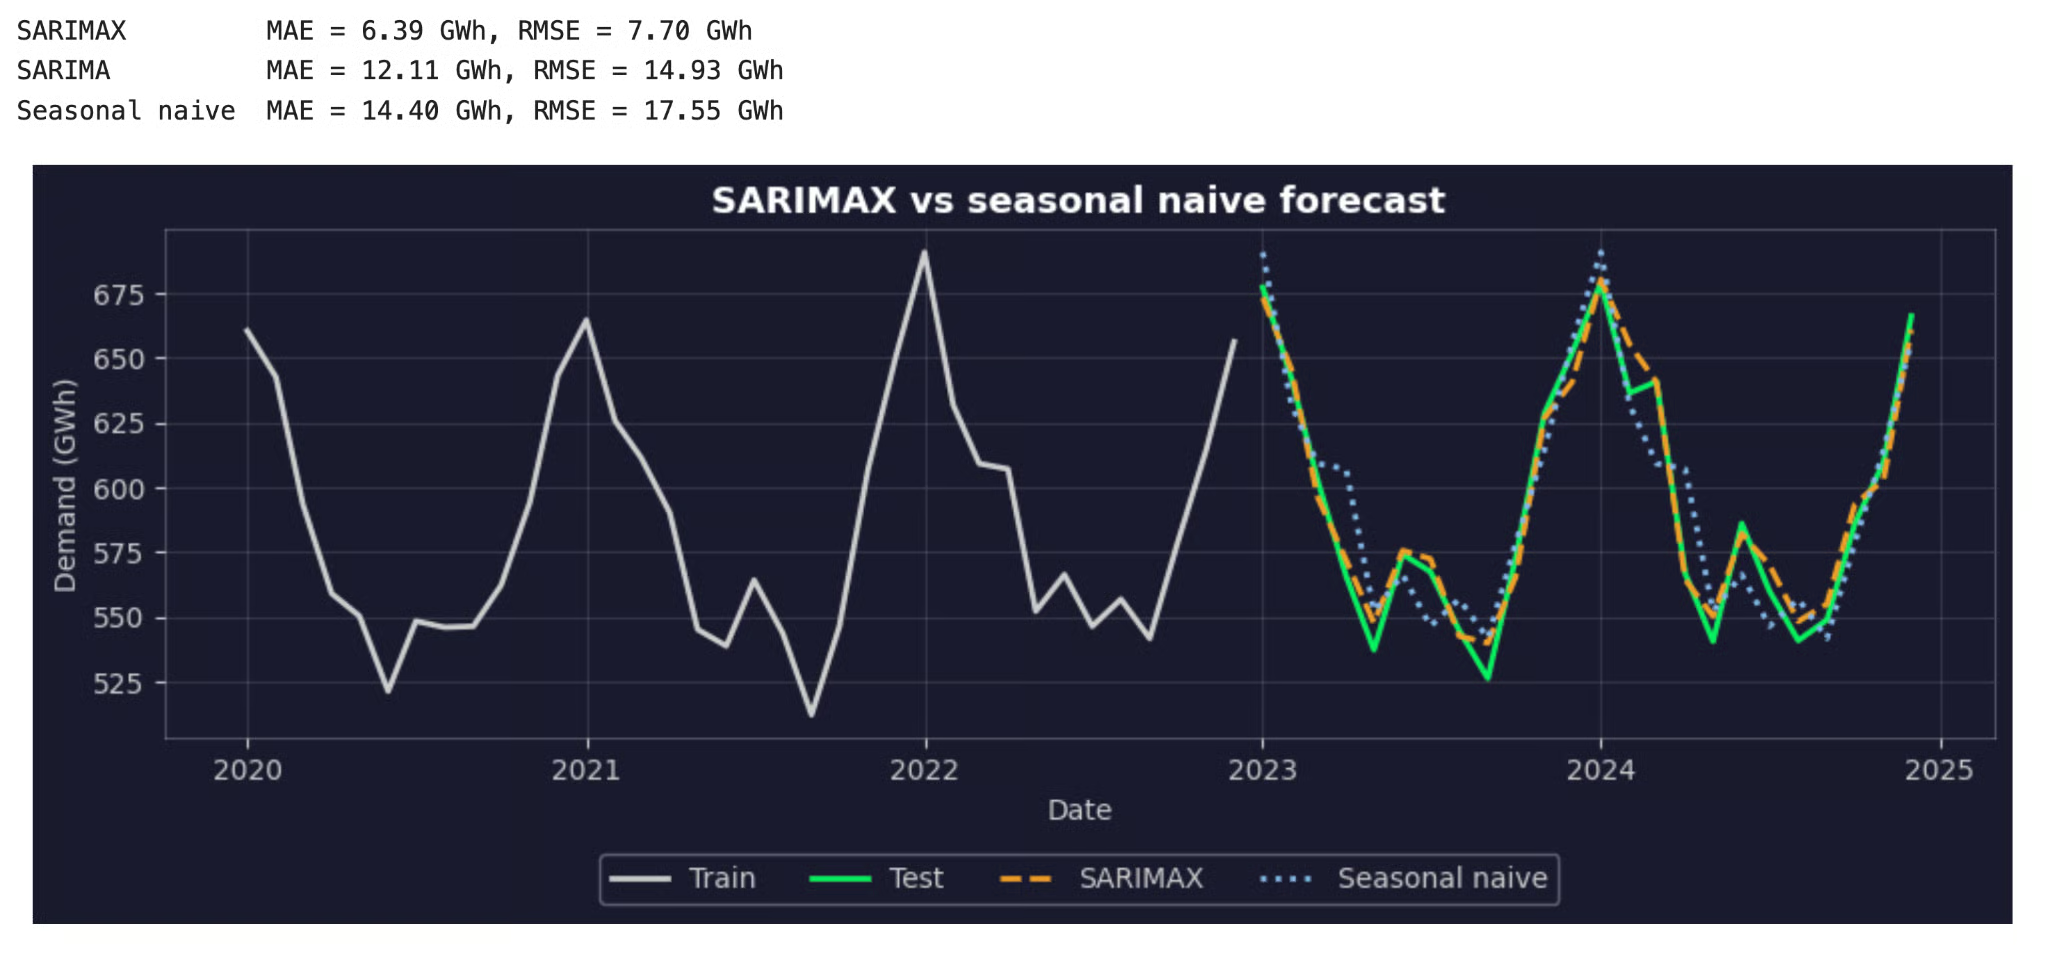
Prognozy SARIMAX i sezonowo naiwne vs rzeczywisty popyt w zbiorze testowym
MAE (średni błąd bezwzględny) to średnia wielkość błędu w GWh. RMSE (pierwiastek z MSE) mocniej karze duże błędy.
SARIMAX ma około połowę błędu SARIMA w obu metrykach. Same składniki sezonowe nie przewidzą wyjątkowo zimnego stycznia ani gorącego lipca, a cechy temperaturowe — tak.
Pamiętaj, że ten wynik używa obserwowanych temperatur z okresu testowego. Z prognozami pogody zamiast nich różnica byłaby mniejsza.
Prognozuj przyszłe wartości
Gdy jesteś zadowolony z modelu, przetrenuj go na wszystkich danych, żeby prognoza zaczynała się od najnowszego miesiąca.
Potem prognozuj metodą .get_forecast(). Potrzebujesz wartości dla każdej zmiennej egzogenicznej w każdym przyszłym miesiącu. Jeśli którejś brakuje, statsmodels zgłosi błąd.
Skąd wziąć te wartości, zależy od zmiennej. Na przykład:
- Znane cechy kalendarza: święta i liczba dni roboczych są znane na lata do przodu
- Planowane decyzje biznesowe: ceny i promocje są znane, jeśli twój zespół już je zaplanował
- Pogoda: temperatura wymaga osobnej prognozy — z serwisu pogodowego lub innego modelu
- Średnie historyczne: jeśli nie masz nic lepszego, użyj średniej wartości dla każdego miesiąca kalendarzowego z danych historycznych
Tutaj użyję tej ostatniej opcji jako substytutu prognozy pogody:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()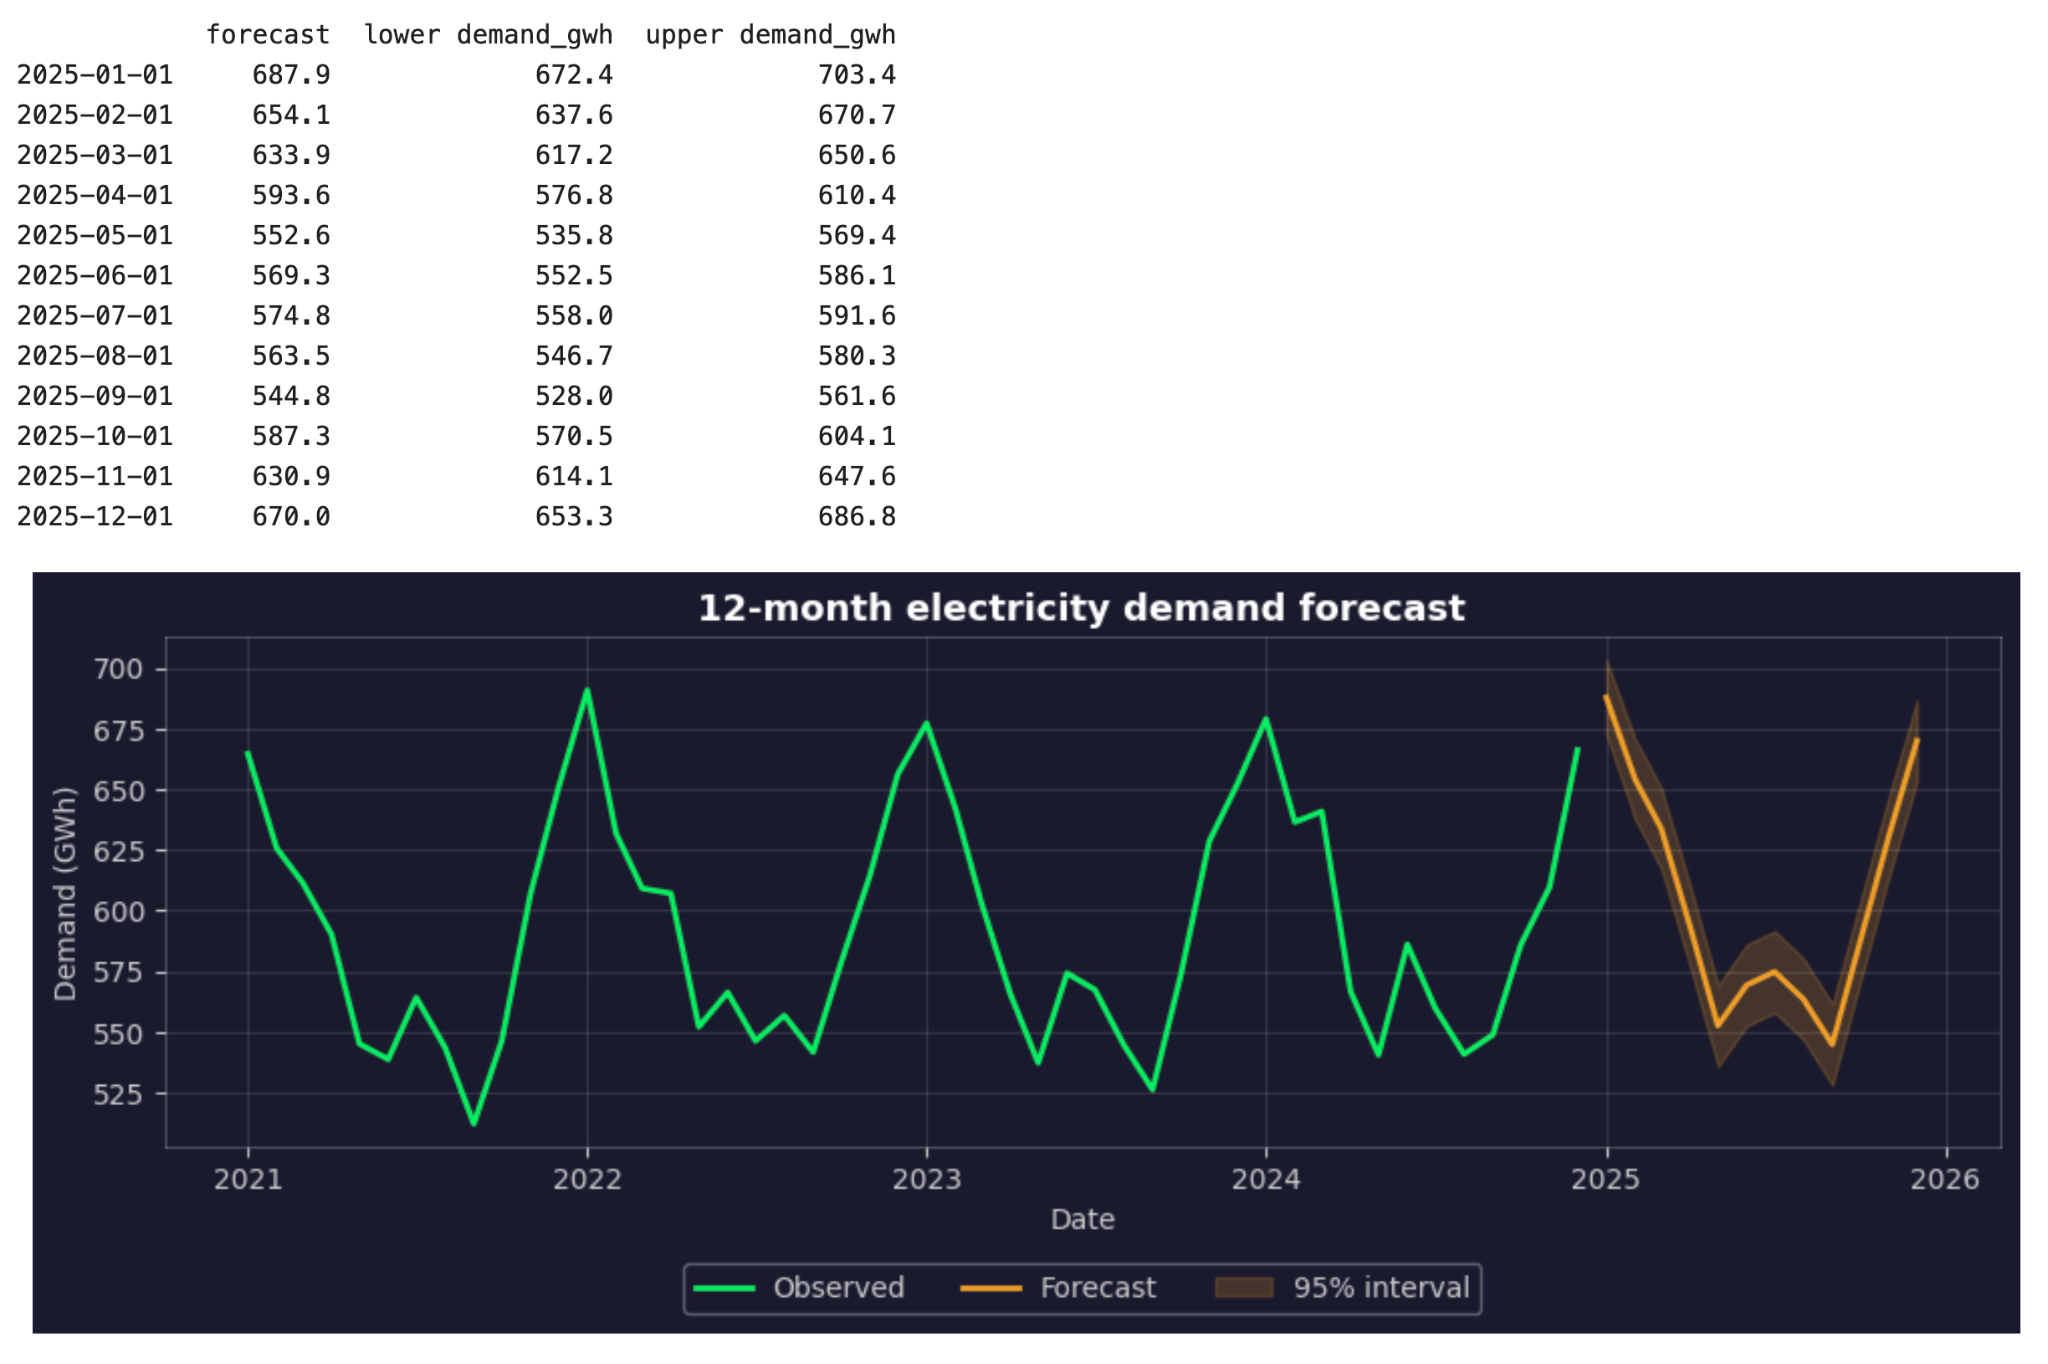
12‑miesięczna prognoza popytu na energię z 95% przedziałem predykcji
Prognoza podąża za znajomym kształtem: najwyższy popyt zimą, mniejsza górka latem i najniższy popyt wiosną oraz jesienią.
Ale 95% przedział obejmuje tylko niepewność dopasowanego modelu, przy założonych przez ciebie temperaturach. Nie obejmuje niepewności tych temperatur. Jeśli styczeń okaże się dużo chłodniejszy niż średnia, rzeczywisty popyt może wypaść poza przedział, nawet jeśli model jest poprawny.
Jeśli chcesz zobaczyć wrażliwość prognozy, uruchom ją ponownie z chłodniejszym i cieplejszym scenariuszem temperatur i porównaj wyniki.
Ograniczenia SARIMAX
SARIMAX to dobry model dla wielu sezonowych problemów prognostycznych, ale ma pewne ograniczenia. Oto, co warto wiedzieć:
-
Wymagane są przyszłe predyktory: model nie potrafi prognozować bez wartości każdej zmiennej egzogenicznej w każdym przyszłym miesiącu. Jeśli predyktor nie jest znany z wyprzedzeniem i nie możesz go prognozować, nie powinien być w modelu, bez względu na to, jak bardzo poprawia dopasowanie do danych historycznych
-
Ukryta niepewność predyktorów: gdy przyszłe predyktory są same prognozami, ich błędy przenoszą się do prognozy popytu. Standardowy przedział predykcji ich nie uwzględnia, więc wygląda na węższy, niż powinien
-
Obsługuje jeden okres sezonowy: standardowa forma wspiera pojedyncze
S. Godzinowy popyt na energię ma cykl dobowy i tygodniowy, a SARIMAX nie potrafi modelować obu naraz. Staje się też wolny przy długich okresach sezonowych, jakS = 168dla cyklu tygodniowego w danych godzinowych -
Zależności mogą się zmieniać: model zakłada, że wzorce z danych treningowych utrzymają się w przyszłości. Jeśli więcej domów przejdzie na pompy ciepła, wpływ zimna na popyt się zmieni i stary współczynnik już tego nie opisze. Regularnie przetrenowuj model na świeżych danych i śledź jego dokładność w czasie
-
Dobór parametrów wymaga ostrożności: model z niskim AIC może wciąż źle prognozować. AIC i BIC patrzą tylko na dane treningowe, więc testuj finalnych kandydatów na wydzielonym okresie albo, lepiej, przez walidację krzyżową w oknach czasowych
-
To nie jest model przyczynowy: istotny współczynnik mówi, że predyktor pomaga w prognozie, a nie że powoduje zmiany w celu. Jeśli chcesz wiedzieć, co stanie się z popytem, gdy zmienisz cenę, potrzebujesz metod wnioskowania przyczynowego
Wnioski
Jeśli twoje dane powtarzają wzorzec sezonowy i zależą od czynników zewnętrznych, warto spróbować SARIMAX. Łączy historię szeregu i czynniki zewnętrzne, które go poruszają. Gdy masz oba, model zwykle wypada lepiej niż taki, który widzi tylko jedno.
Pamiętaj, że model jest tak dobry, jak dane wejściowe, które mu dajesz. Dobierz okres sezonowy na podstawie danych, starannie wyrównaj predyktory, testuj na przyszłych danych zamiast ufać AIC i upewnij się, że będziesz mieć przyszłe wartości dla każdego predyktora, zanim cokolwiek zbudujesz. Jeśli tego ostatniego nie możesz zrobić, SARIMAX nie jest właściwym wyborem dla twojego zbioru danych.
Jeśli chcesz kontynuować naukę, zapisz się na nasz kurs Time Series Analysis in Python i poznaj podstawy w jedno popołudnie.