
假设我们的目标是预测每月的用电量。ARIMA 和 SARIMA 等模型只关注序列过去的数值及其自身过去的预测误差。但需求还取决于温度等外部因素:炎热的夏季会抬高用电量,寒冷的冬季也一样。如果模型看不到这些因素,它会把每个异常的月份都当作噪声处理,等天气再次变化时就会重复犯同样的错误。
SARIMAX 通过在季节性 ARIMA 模型之上加入外部(外生)变量来解决这个问题。它依然从序列历史中学习趋势和季节性,但也利用外部信息来解释仅靠过去值无法解释的部分。
如果您需要快速入门,掌握在 Python 中处理、解释和可视化时间序列数据的基础知识,可报名我们的 Time Series in Python 学习路径,花一周打牢基本功。
什么是 SARIMAX?
SARIMAX 是一种可使用 季节性 ARIMA 模型 并加入外部预测变量的模型。其名称取自“季节性自回归差分移动平均(带外生回归变量)”(Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors)。
SARIMAX 的工作方式是从四类信息预测目标序列:
- 过去的数值: 最近几个月的需求
- 过去的预测误差: 模型在最近几个月偏差了多少
- 季节性模式: 往年同月份的需求
- 外生变量: 您添加到模型的外部数据,如月均气温
例如要预测下一个 7 月的用电量。SARIMAX 会查看前几个月的需求、往年 7 月份的需求,以及 7 月的预期气温。前两项来自序列本身,气温来自外部。
模型通常写作 SARIMAX(p, d, q)(P, D, Q, S)。第一组参数描述短期行为,第二组描述季节性成分,其中 S 是一个周期内的时间步数。若为具有年度模式的月度数据,S 为 12。
外生变量不包含在该记号中。您需要单独将其作为独立输入传给模型。
SARIMAX 的工作原理
SARIMAX 有两组项,外生变量叠加其上。
非季节性项 (p, d, q) 建模短期行为:
-
自回归阶数
p: 模型使用多少个过去的数值。p = 2时,本月需求取决于前两个月的需求 -
差分阶数
d: 模型为去除趋势而进行差分的次数。d = 1时,模型使用环比变化而非原始需求 -
移动平均阶数
q: 模型使用多少个过去的预测误差。若模型上月低估了需求,该误差会影响本月的预测
季节性项 (P, D, Q, S) 做同样的事,但在季节性滞后上:
-
季节性自回归阶数
P: 模型回看多少个过往季节。P = 1且为月度数据时,今年 7 月的需求取决于去年 7 月的需求 -
季节性差分阶数
D: 模型在季节性滞后上进行差分的次数。D = 1时,模型比较今年 7 月与去年 7 月,从而去除重复的年度模式 -
季节性移动平均阶数
Q: 模型使用多少个季节性滞后的预测误差,如去年 7 月的误差 -
季节周期
S: 一个周期包含多少个时间步。对具有年度模式的月度数据为 12,对具有每周模式的日度数据为 7
外生变量能补充序列本身没有的信息。
在用电量的例子里,这就是气温。炎热的夏天或寒冷的冬天会推高需求,而过去的需求值无法告诉模型下个月的天气。月份这一季节性模式已经由季节性项捕获,因此该示例只需要把气温作为唯一的外部变量。
在 statsmodels 中,SARIMAX 相当于对外生变量做一元的线性回归,且回归残差服从季节性 ARIMA 过程。若只有一个外生变量,它看起来像这样:
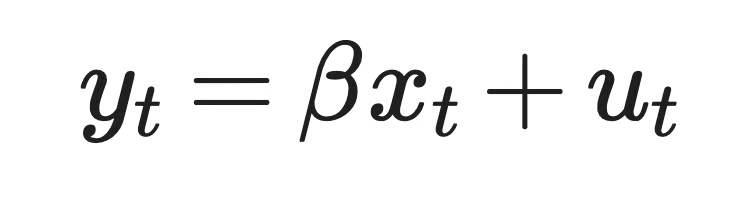
带一个外生变量的 SARIMAX
其中,y_t 是第 t 个月的用电量,x_t 是当月气温,beta 是气温系数,u_t 是气温无法解释的那部分需求。非季节性和季节性项对 u_t 建模。
通俗点说,就是气温解释了需求的一部分,其余部分由 SARIMA 项来建模。
下面是更直观的概览:
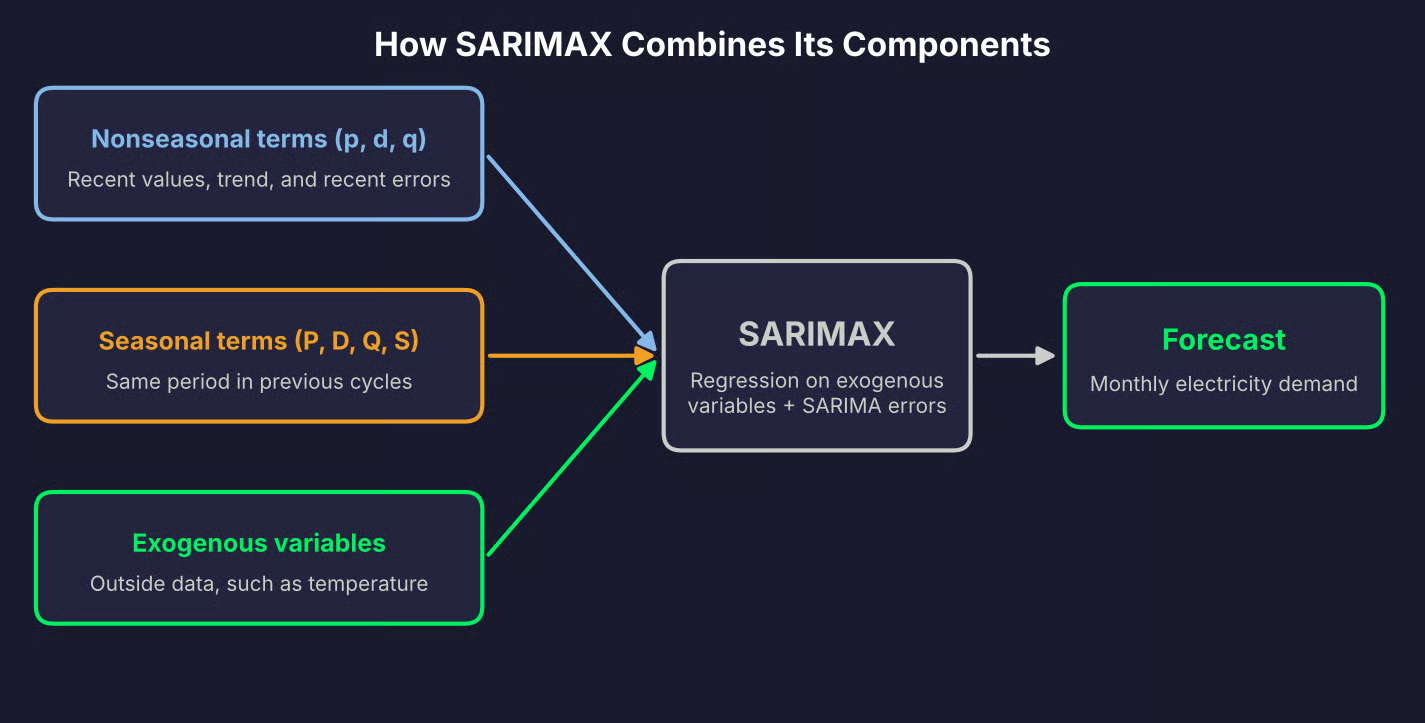
SARIMAX 组成部分
ARIMA 与 SARIMA 与 ARIMAX 与 SARIMAX
这四种模型同属一个家族。差别细微,但一读就能明白。
ARIMA 仅用序列自身的过去值和过去的预测误差来建模。SARIMA 在此基础上加入季节性项,从而能建模每隔 S 个时间步重复的模式。ARIMAX 则在 ARIMA 上加入外生变量,但默认没有季节性项。SARIMAX 二者兼有。
因此 SARIMAX 可以将其他模型作为特例表示。若不传入任何外生变量,得到的是 SARIMA 模型。若把全部季节性阶数设为零,则得到非季节性的 ARIMAX 模型;两者都没有时,就是 ARIMA 模型。
但可惜的是,各库的术语并不一致。
教材中的 ARIMAX 是把外生变量直接放进 ARIMA 方程,与序列的过去值并列。而 statsmodels 的 SARIMAX 则是拟合一个带 SARIMA 误差的回归,如上一节所示。二者估计的系数不同,因此同一个气温变量在不同包中得到的系数可能不一样。
类名和函数名也对不上。statsmodels 中的 ARIMA 类同样接受季节性项和外生变量。在 R 语言中,forecast 包通过 Arima() 和 auto.arima() 的 xreg 参数处理外部回归量。因此,在跨工具比较结果前,请务必核对各包对模型的定义。
简单回顾:
| 有季节性? | 有外部变量? | |
|---|---|---|
| ARIMA | 无 | 无 |
| SARIMA | 有 | 无 |
| ARIMAX | 默认无 | 有 |
| SARIMAX | 有 | 有 |
ARIMA 家族模型对比
何时使用 SARIMAX
当目标具有重复出现的季节性模式,且外部变量能提升预测效果时,SARIMAX 是合理的选择。
例如:
- 用电需求: 在年度周期之上加入气温与节假日等日历效应
- 零售销售: 促销、价格与假期时段
- 酒店预订: 当地活动与房价,叠加年度出行季
- 公共交通客流: 天气与学校假期,叠加日度数据中的每周模式
但 SARIMAX 并非总是最佳选择。以下两种情况用更简单的模型也能做到同样效果:
- 无明显季节性: 若序列没有重复模式,季节性项只会增加待估参数。ARIMA 或 ARIMAX 已足够
- 预测变量不能提升准确率: 若外生变量在留出测试期上不能降低误差,就去掉它们并用 SARIMA。仅在训练数据上更贴合并不算数
这里要记住的是,SARIMAX 需要预测期内每个外生变量的取值。
有些值是提前已知的,例如法定节假日或计划内促销。另一些如气温,则需要先单独预测,SARIMAX 才能使用。若无法获得某个预测变量的未来值,就不能在预测中使用它。
如何在 Python 中构建 SARIMAX 模型
本节将使用 statsmodels 从原始数据开始构建一个 SARIMAX 模型,并给出 12 个月的预测。
示例使用合成的月度用电量数据,并将气温作为外部变量。数据量小且可复现,与本文其余部分的叙述一致。
准备数据
数据集覆盖十年的月度数据,从 2015 年 1 月到 2024 年 12 月。
需求具有上升趋势、随时间缓慢变化的年度日历模式、天气效应和噪声。刻意留出两处气温缺失,以展示如何处理缺口:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())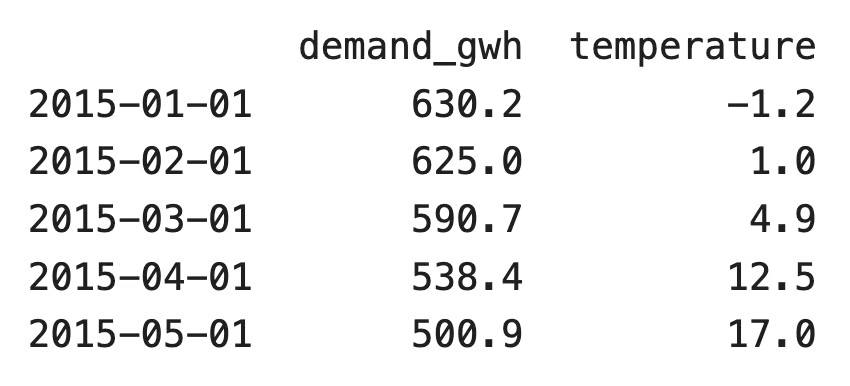
数据集的前五行
或者,看看整体走向:
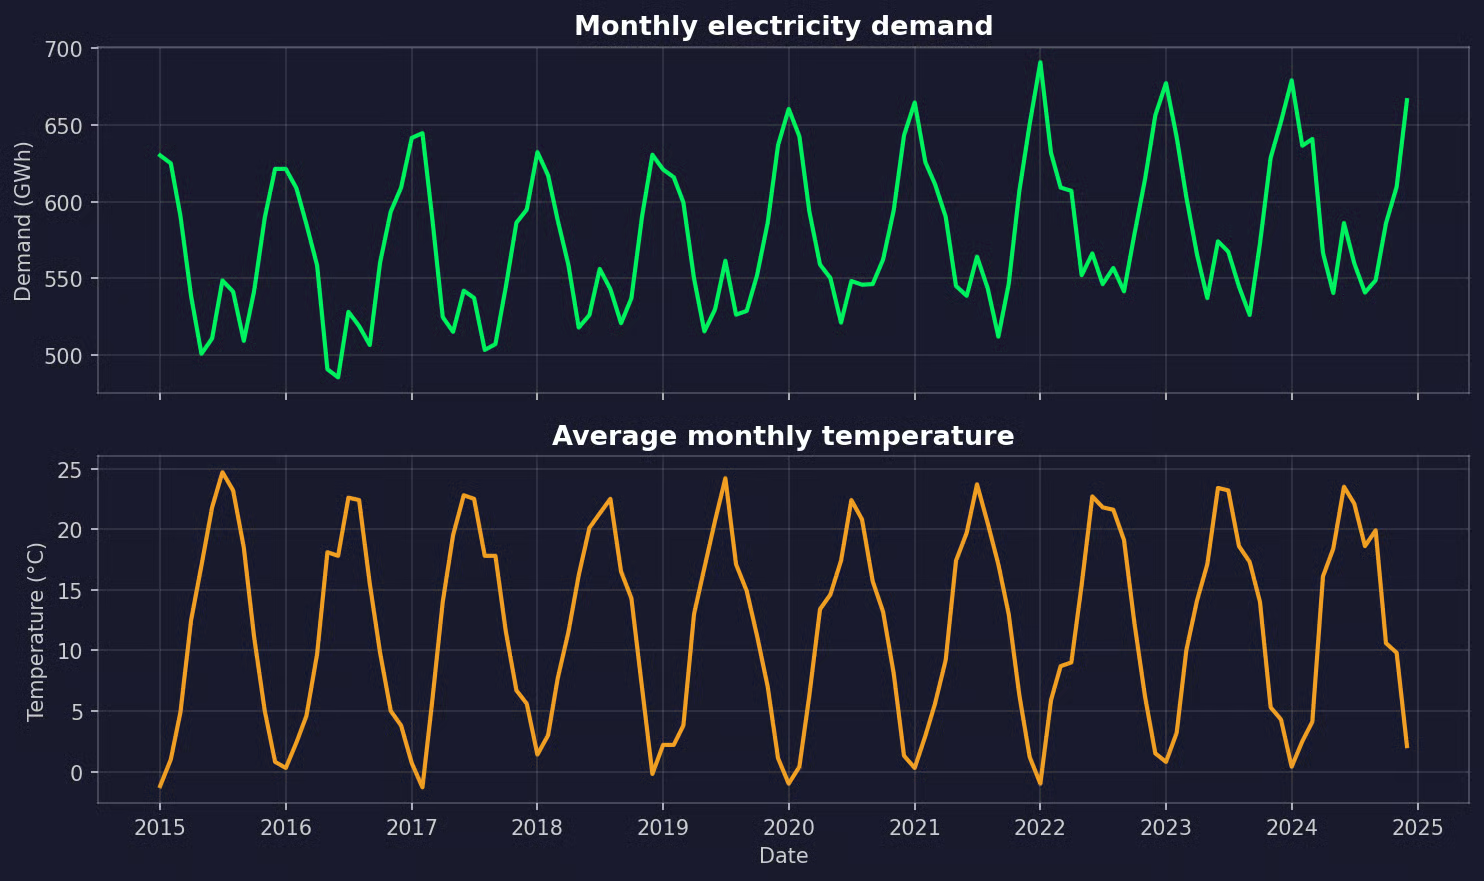
气温数据集
如果您使用自己的数据,用 pd.read_csv() 加载,并将日期列设为索引。其余流程保持一致。
SARIMAX 需要具有一致频率的时间索引。.asfreq() 方法可将频率设为月度,并为任何缺失的月份插入空行。然后您就能统计缺口并填补它们:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()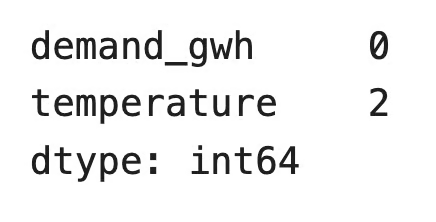
插值填补气温缺口
这里适合用线性插值,因为气温在月与月之间变化平滑。但若目标变量缺失较多,请不要用同样方法,否则您就是在用编造的数据训练模型。
接下来处理外生变量。气温越冷或越热,需求越高,但对原始气温做线性回归无法刻画 U 形关系。因此我们将气温拆为两个特征:
- 采暖度数: 月均气温低于 18 摄氏度的度数,否则为 0
- 制冷度数: 月均气温高于 18 摄氏度的度数,否则为 0
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
现在将数据拆分为目标 y 与外生变量 X。拆分必须按时间顺序进行:模型在过去数据上训练,并在未来数据上测试。随机拆分会把未来信息泄露到训练中:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")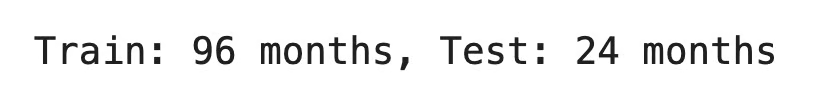
训练/测试拆分
要记住的是,X_test 中是实际观测到的气温。在真实预测中,您并不会提前知道它们——最多只有天气预报。因此稍后看到的测试得分会偏乐观。只有在预测时同样可以获得这些预测变量(如节假日或已计划价格)的情况下,才使用观测值来评估。
探索季节性与平稳性
先画图。关注趋势、季节性周期和突变:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()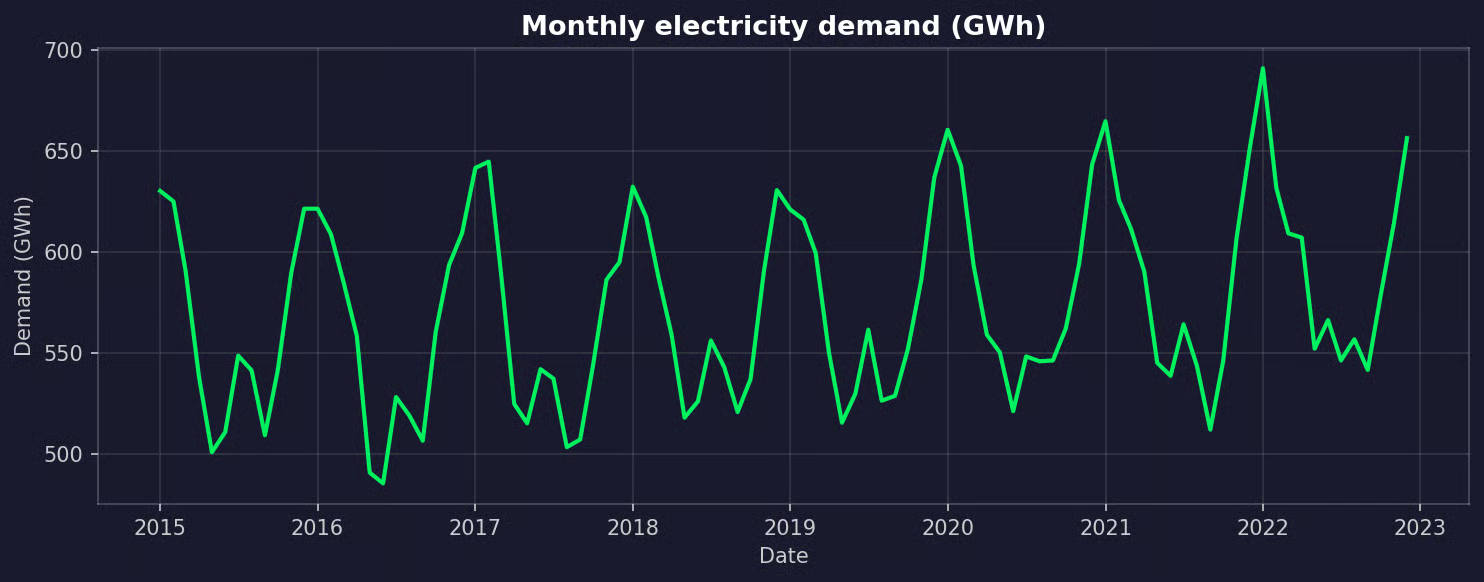
训练期的月度用电量
需求随时间上升,每年冬季出现峰值,夏季有较小的峰值。该模式每 12 个月重复一次。
季节性分解可将序列拆为趋势、季节性与残差,从而确认季节周期 S:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()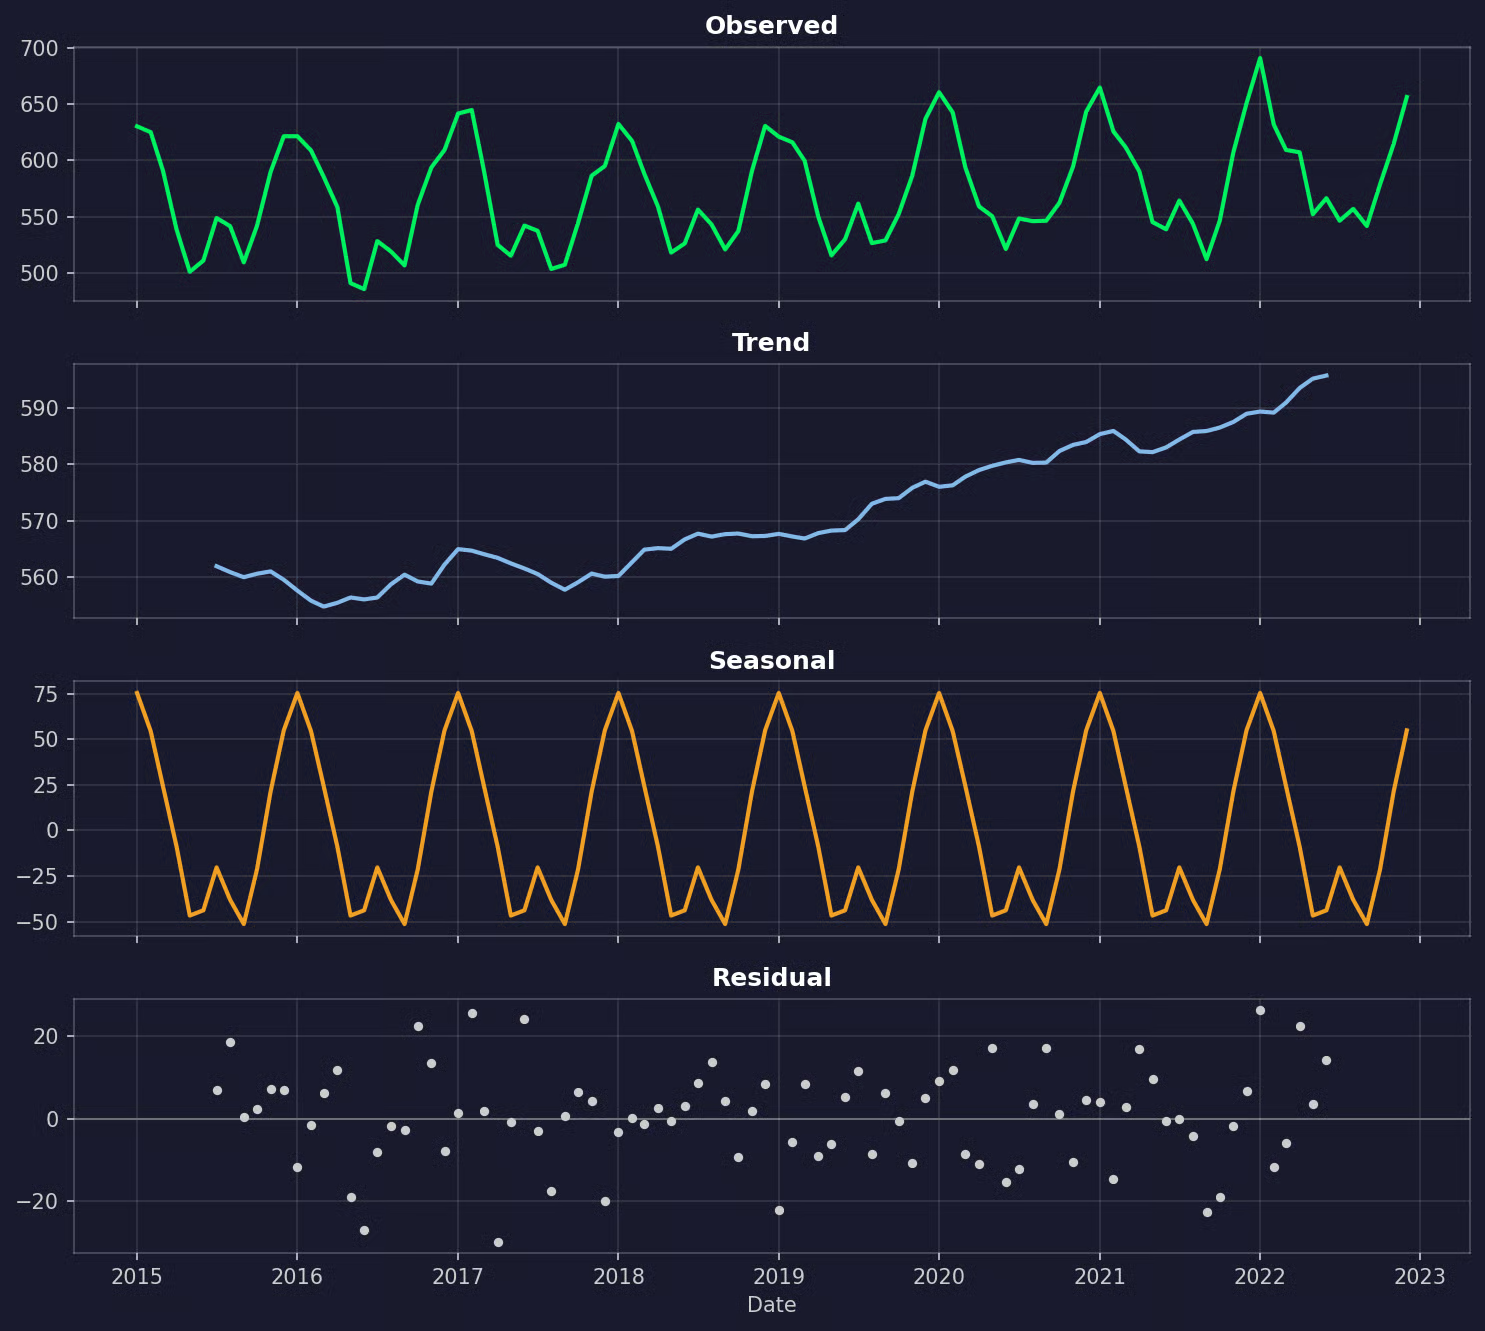
用电量的季节性分解
季节成分每年重复一次,因此 S = 12。
ARIMA 家族模型需要平稳序列——均值与方差不随时间变化。该用电序列因趋势与季节性周期而不平稳。
差分是应对方法之一:
-
常规差分(
d): 用本月值减去上月值,去除趋势 -
季节性差分(
D): 用本月值减去去年同月值,去除重复的季节性模式,同时也能去掉线性趋势
扩展的 Dickey-Fuller(ADF)检验可检查平稳性。其原假设为序列不平稳,因此较小的 p 值(低于 0.05)表明序列平稳:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")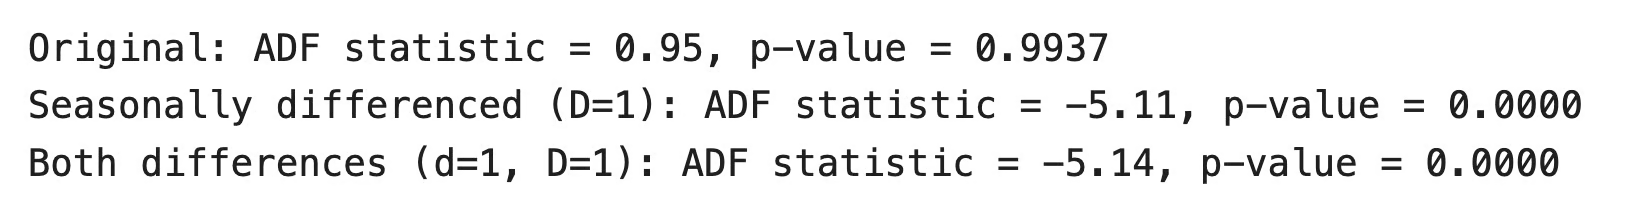
ADF 检验结果
原始序列不平稳。仅季节性差分就能修复,因此再做常规差分没有帮助。使用能奏效的最小差分次数——多做差分会给序列引入噪声,使模型更难拟合。
因此选择 d = 0 且 D = 1。
不过请将 ADF 检验仅作为辅助证据。它无法告诉您 p、q、P 或 Q,且在序列较短时,结论可能随其设置而变。
选择候选参数
ACF 与 PACF 图有助于选择其余阶数的候选值:
-
ACF(自相关函数): 展示序列与自身滞后值之间的相关性。ACF 中的尖峰指向移动平均项:短滞后对应
q,季节性滞后对应Q -
PACF(偏自相关函数): 展示同样的相关性,但移除了中间滞后的影响。PACF 中的尖峰指向自回归项:短滞后对应
p,季节性滞后对应P
应基于季节性差分后的序列绘制两者,因为模型就是在该序列上工作:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()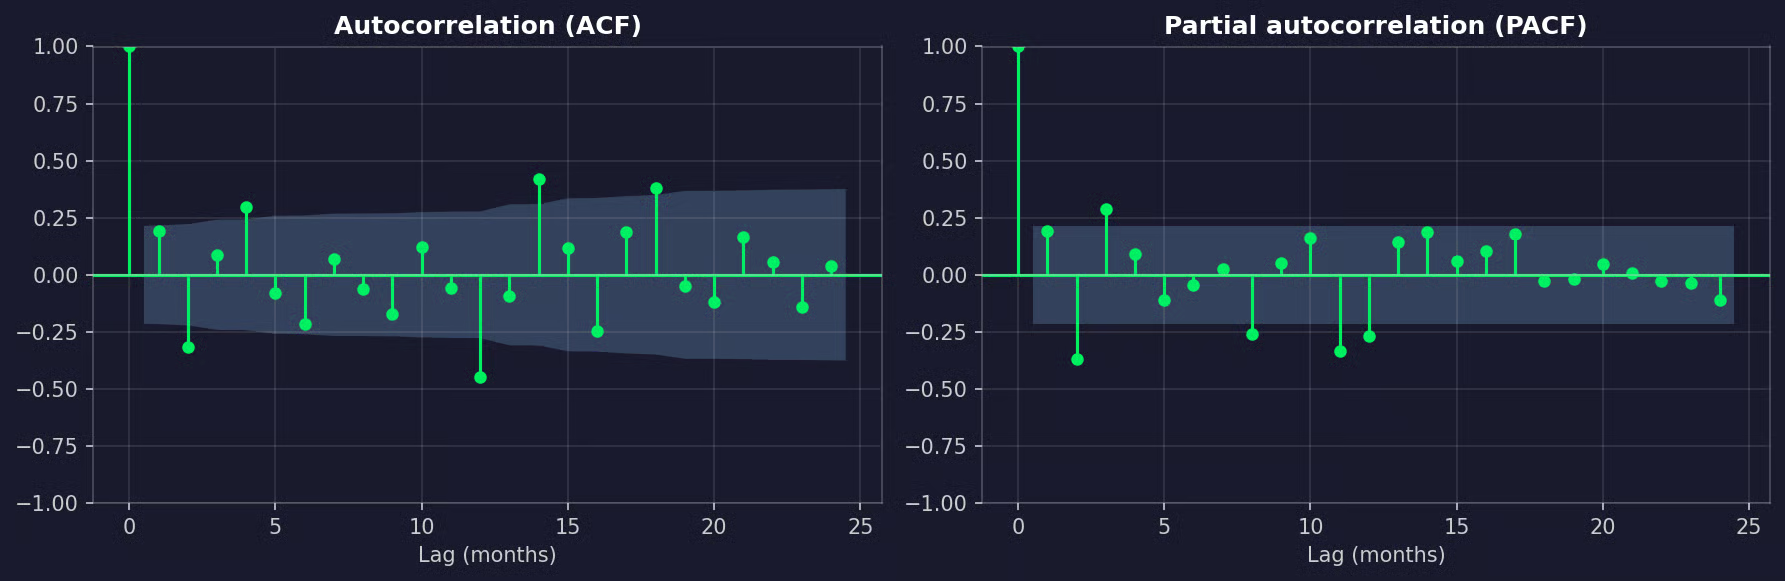
季节性差分后用电量的 ACF 与 PACF 图
ACF 在滞后 12 处有明显的负尖峰,在滞后 24 处没有。这是季节性移动平均项的典型信号,因此 Q = 1 是不错的候选。两张图在短滞后也显示出一些尖峰,因此值得测试 p 与 q。
下一步是拟合一小组候选模型,并用 AIC 或 BIC 比较。两者都衡量模型对训练数据的拟合程度,并对额外参数进行惩罚。值越低越好,且 BIC 对复杂度的惩罚高于 AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))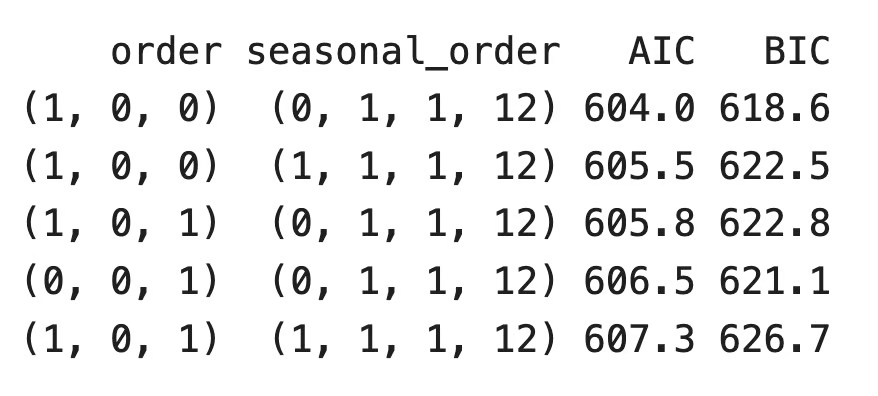
AIC 与 BIC 结果
SARIMAX(1, 0, 0)(0, 1, 1, 12) 在 AIC 与 BIC 上均胜出,同时也是列表中最简单的模型之一。
trend="c" 参数添加常数项。在季节性差分下,常数项用于建模同比增长的需求。
您也可以使用 pmdarima 库的 auto_arima() 等工具来自动搜索。它们适合做第一轮筛选,但 AIC 与 BIC 只衡量训练数据上的拟合程度。在信任一个模型之前,请务必在未见过的数据上测试。
拟合模型
将目标作为第一个参数传入,通过 exog 传入外生变量。order 接受 (p, d, q),seasonal_order 接受 (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())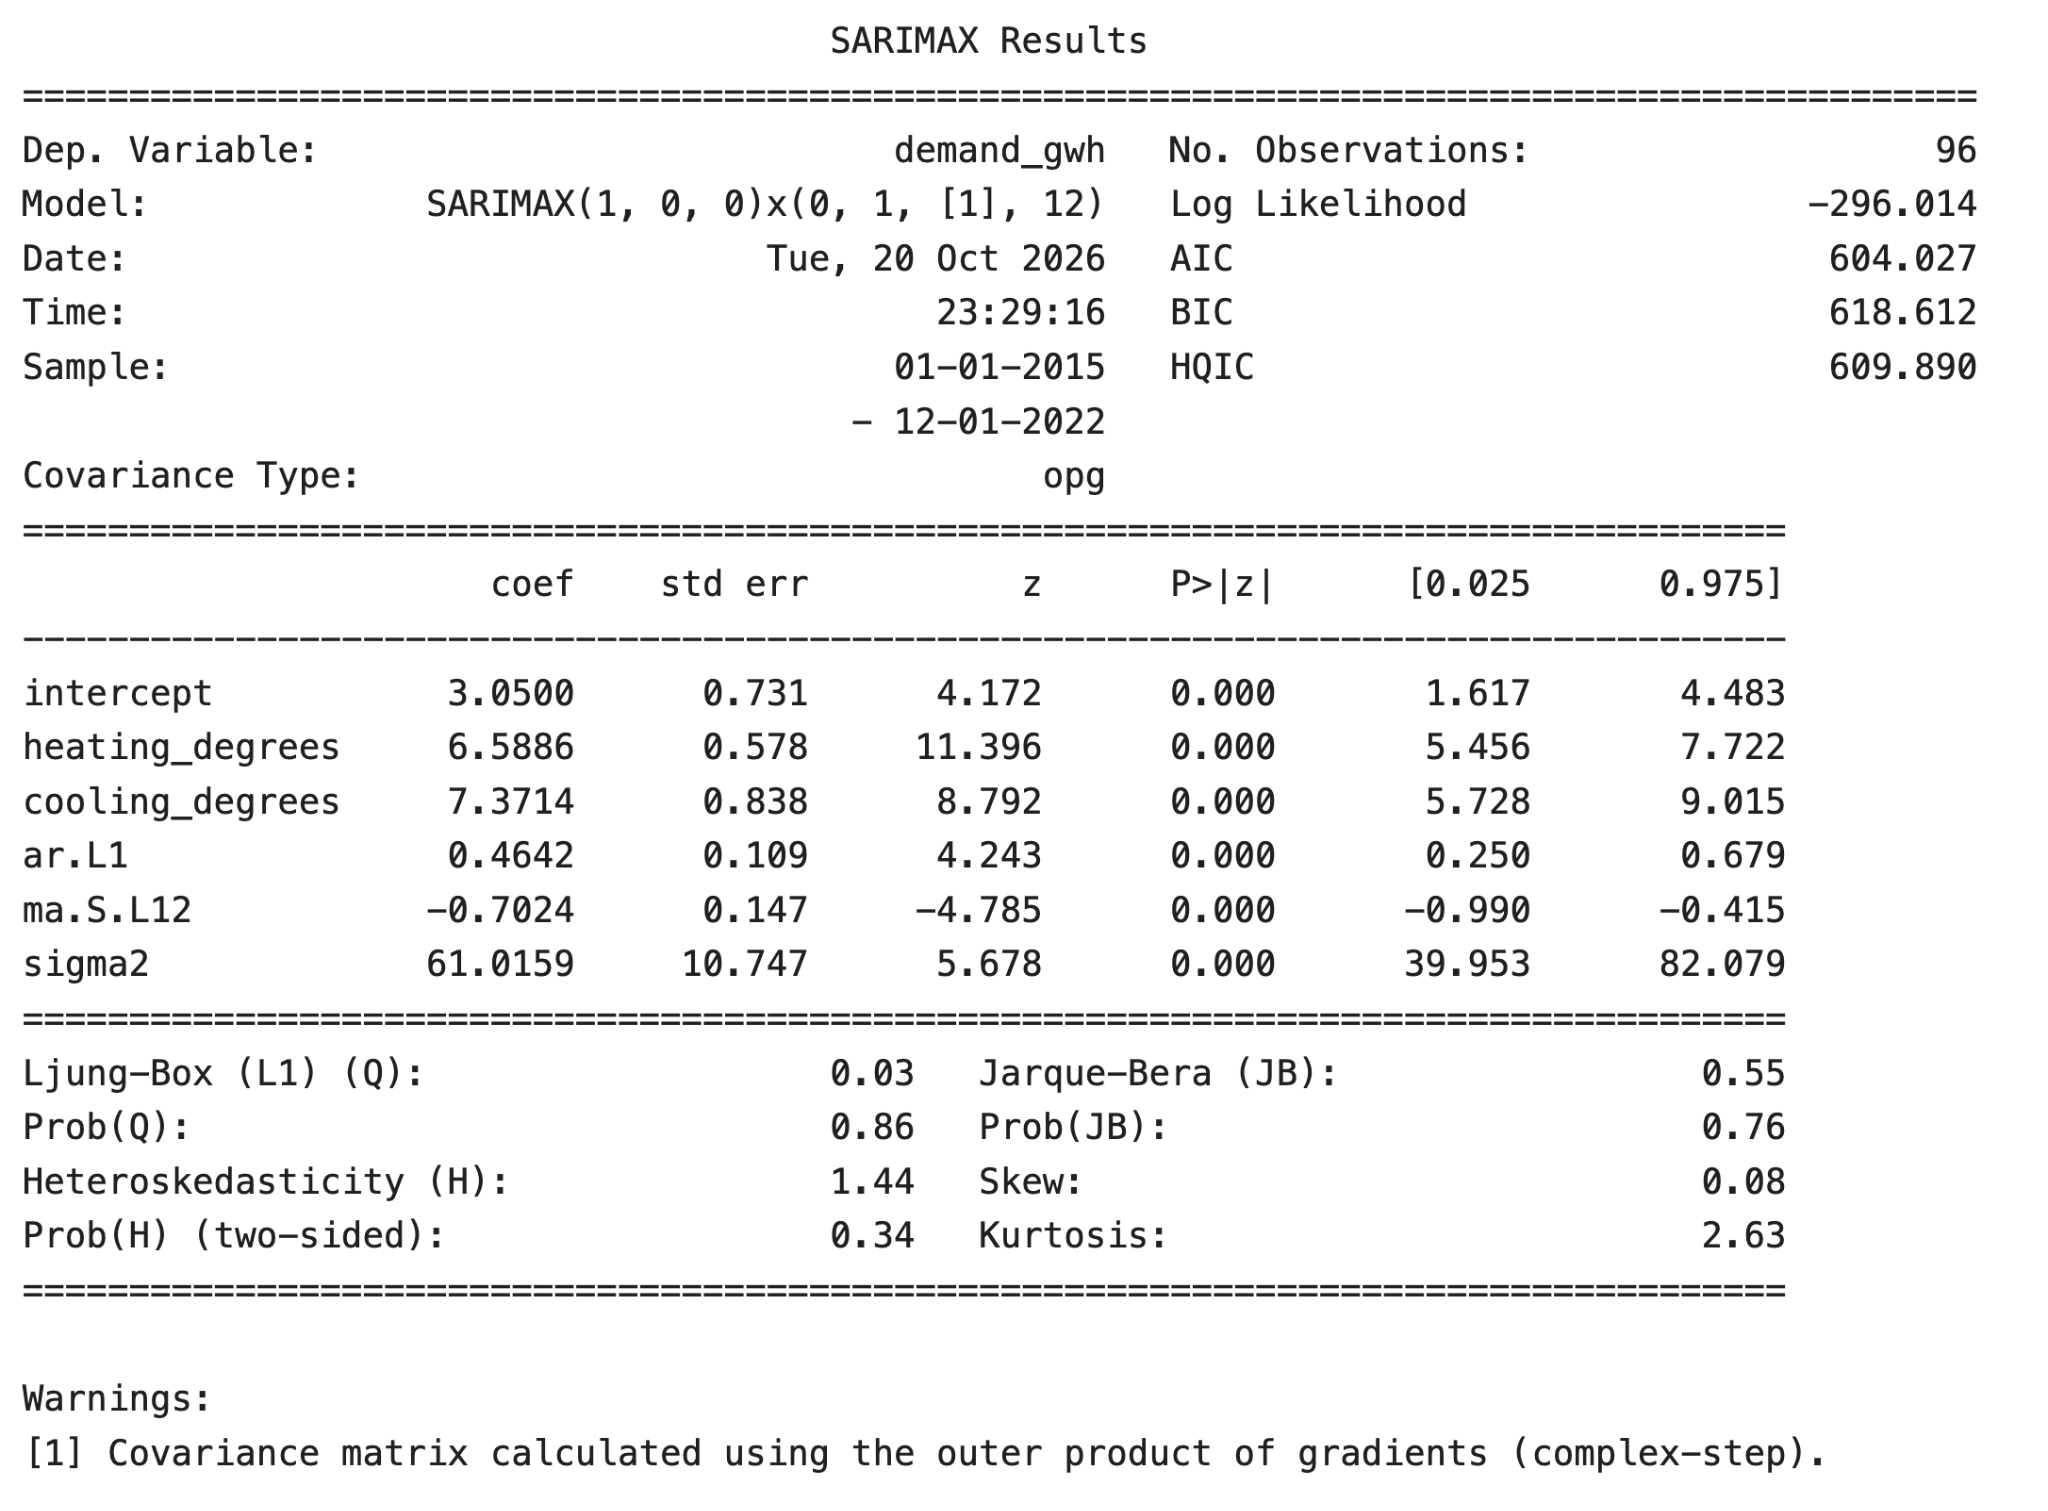
SARIMAX 模型摘要
系数表的阅读方法如下:
-
heating_degrees: 在模型其他条件不变时,每增加 1 个采暖度数,对应约 6.6 GWh 的额外需求 -
cooling_degrees: 每增加 1 个制冷度数,对应约 7.4 GWh 的额外需求 -
ar.L1: 上月未解释的差异约有 46% 会延续到本月 -
ma.S.L12: 季节性移动平均项,基于去年同月的误差来修正预测 -
sigma2: 残余噪声的方差
所有系数的 p 值都接近 0,因此每一项都对模型有贡献。
但这些系数只描述拟合模型内的关系,并不代表因果。本文数据生成时设定了气温是需求的原因,因此这样解读是安全的。实际数据中,某个预测变量之所以看起来重要,可能是因为它与模型未观测到的因素同步变化。
诊断与评估模型
好的模型应留下看似随机噪声的残差。若残差仍有模式,说明模型遗漏了什么。
.plot_diagnostics() 方法可一键生成四张图:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()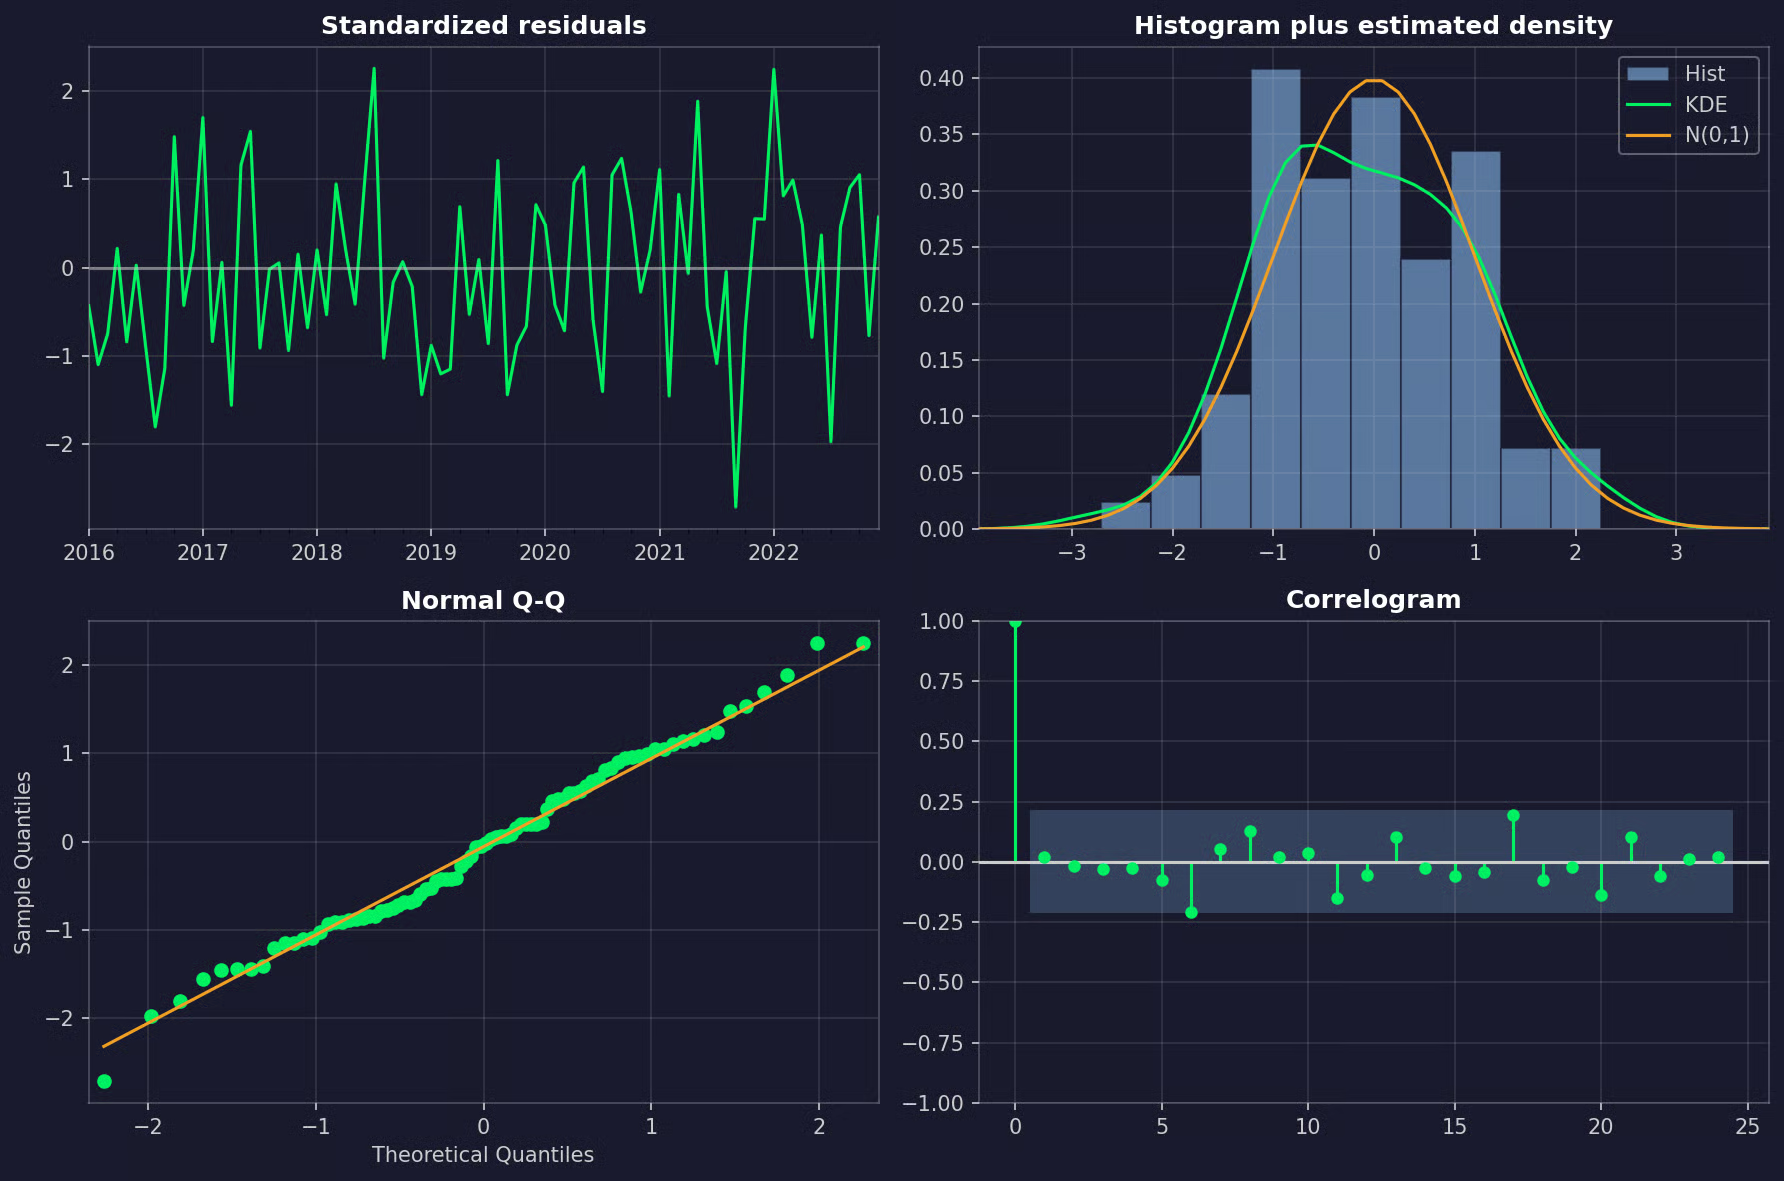
残差诊断图
留意以下几点:
- 标准化残差: 不应有趋势、重复模式,且没有明显变宽的区段
- 直方图和 Q-Q 图: 点位接近正态分布
- 相关图: 置信带外不应有尖峰,尤其是滞后 12——那里出现尖峰意味着模型尚未完全处理季节性
Ljung-Box 检验可将上述检查量化。其原假设是残差在给定滞后内无自相关,因此您希望 p 值较大:
# Skip the first 13 residuals, which come from the differencing start-up period
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))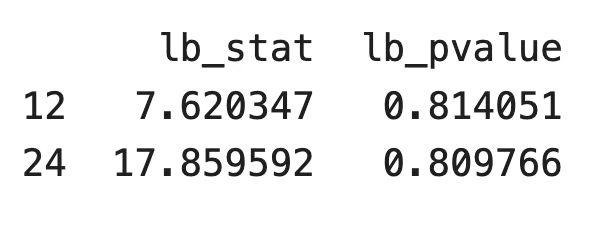
Ljung-Box 检验结果
两个 p 值都远高于 0.05,残差看起来像噪声。
现在来到最关键的部分——在未见过的数据上的准确率。.get_forecast() 方法可预测 24 个测试月,且需要这些月份的外生变量取值。
单个预测数值意义不大,因此这里用两个基线作对比:
- 季节性朴素预测: 直接重复训练期最后 12 个月的数值
- SARIMA: 去掉外生变量后的同款模型
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: repeat the last 12 observed months
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: the same model without exogenous variables
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()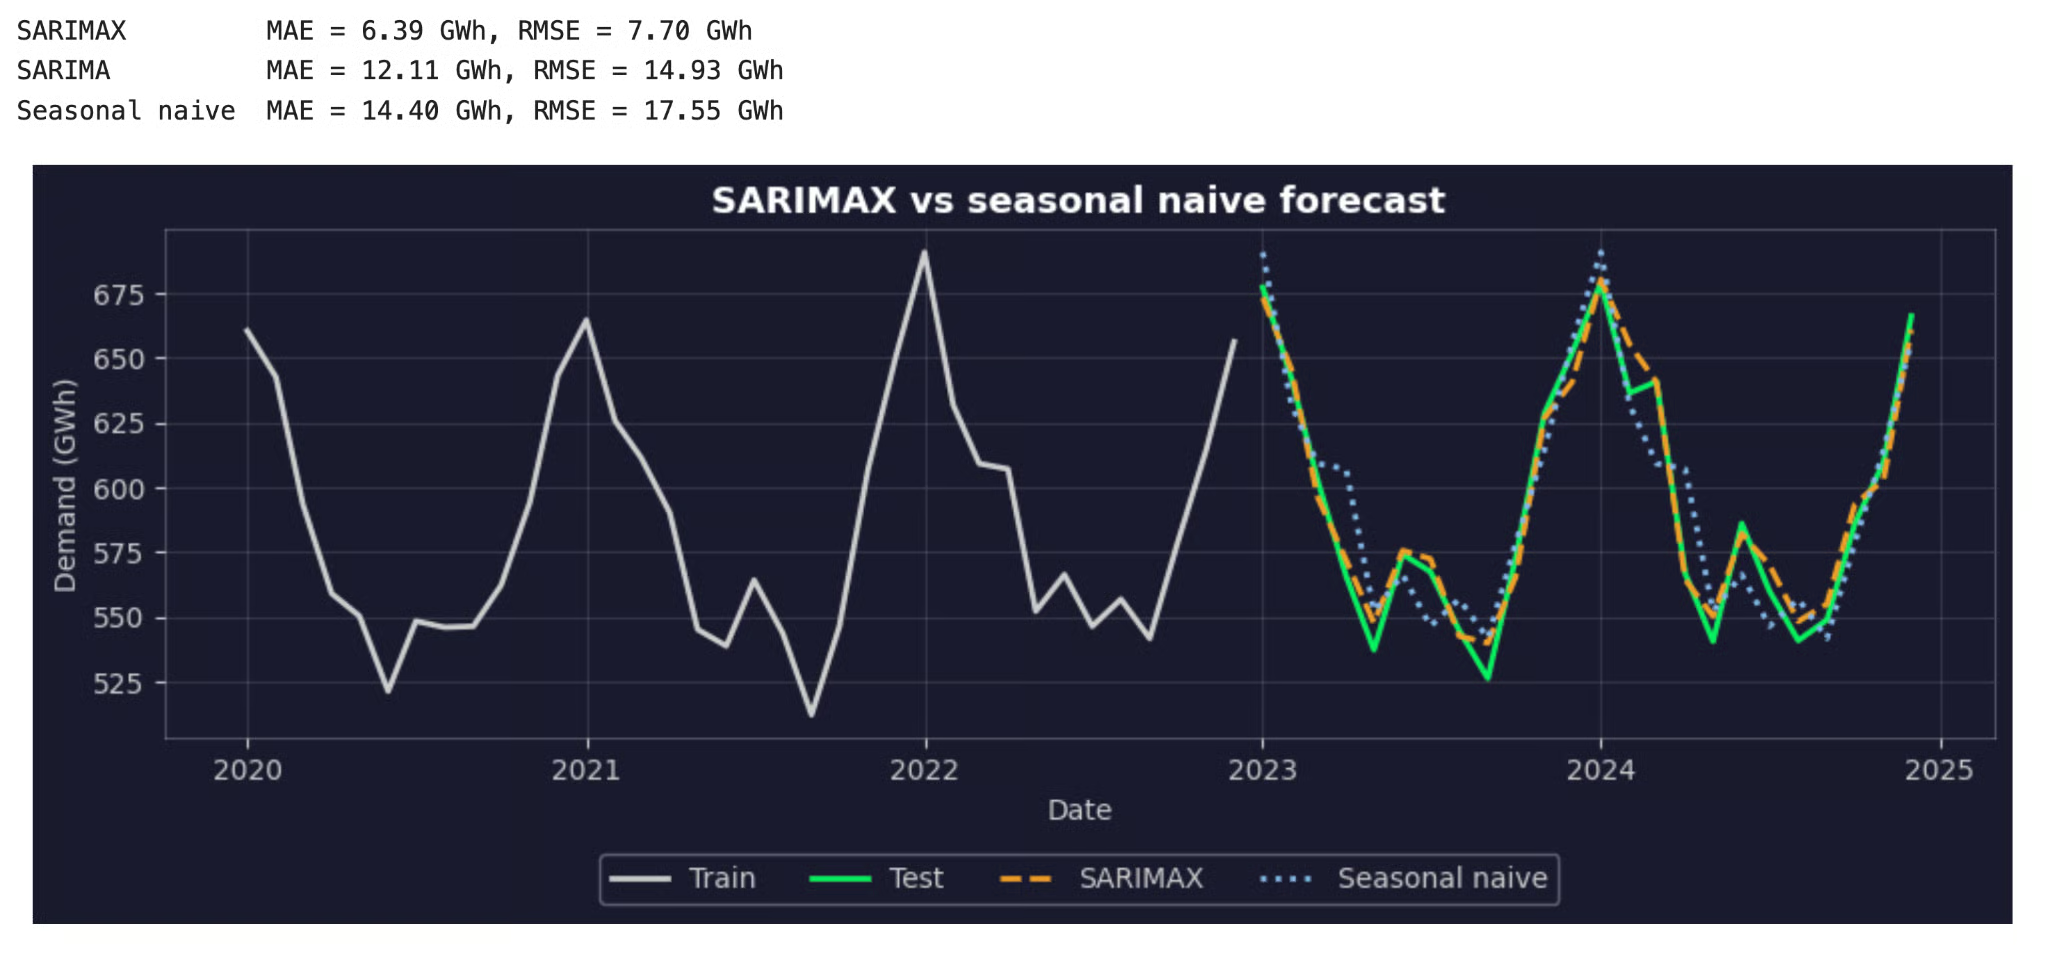
SARIMAX 与季节性朴素预测对比测试集实际需求
MAE(平均绝对误差) 是以 GWh 计的平均误差大小。RMSE(均方根误差) 对较大的错误惩罚更重。
在两项指标上,SARIMAX 的误差约为 SARIMA 的一半。仅靠季节性项无法预测异常寒冷的一月或炎热的七月,而气温特征可以。
请记住,此结果使用了测试期的实际气温。若用天气预报替代,差距会更小。
预测未来值
当您对模型满意后,请用全部数据重新拟合,让预测从最近的月份开始。
然后使用 .get_forecast() 进行预测。您需要为未来每个月的每个外生变量提供取值。若缺少任何一个,statsmodels 会报错。
这些数值的来源取决于变量本身。例如:
- 已知的日历特征: 节假日和工作日数可以提前多年得知
- 已计划的业务决策: 若团队已排期,价格与促销也是已知的
- 天气: 气温需要单独预测,可来自气象服务或另一个模型
- 历史均值: 若没有更好的方法,可使用历史数据中各日历月份的平均值
这里我们用最后一种方式来替代天气预报:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()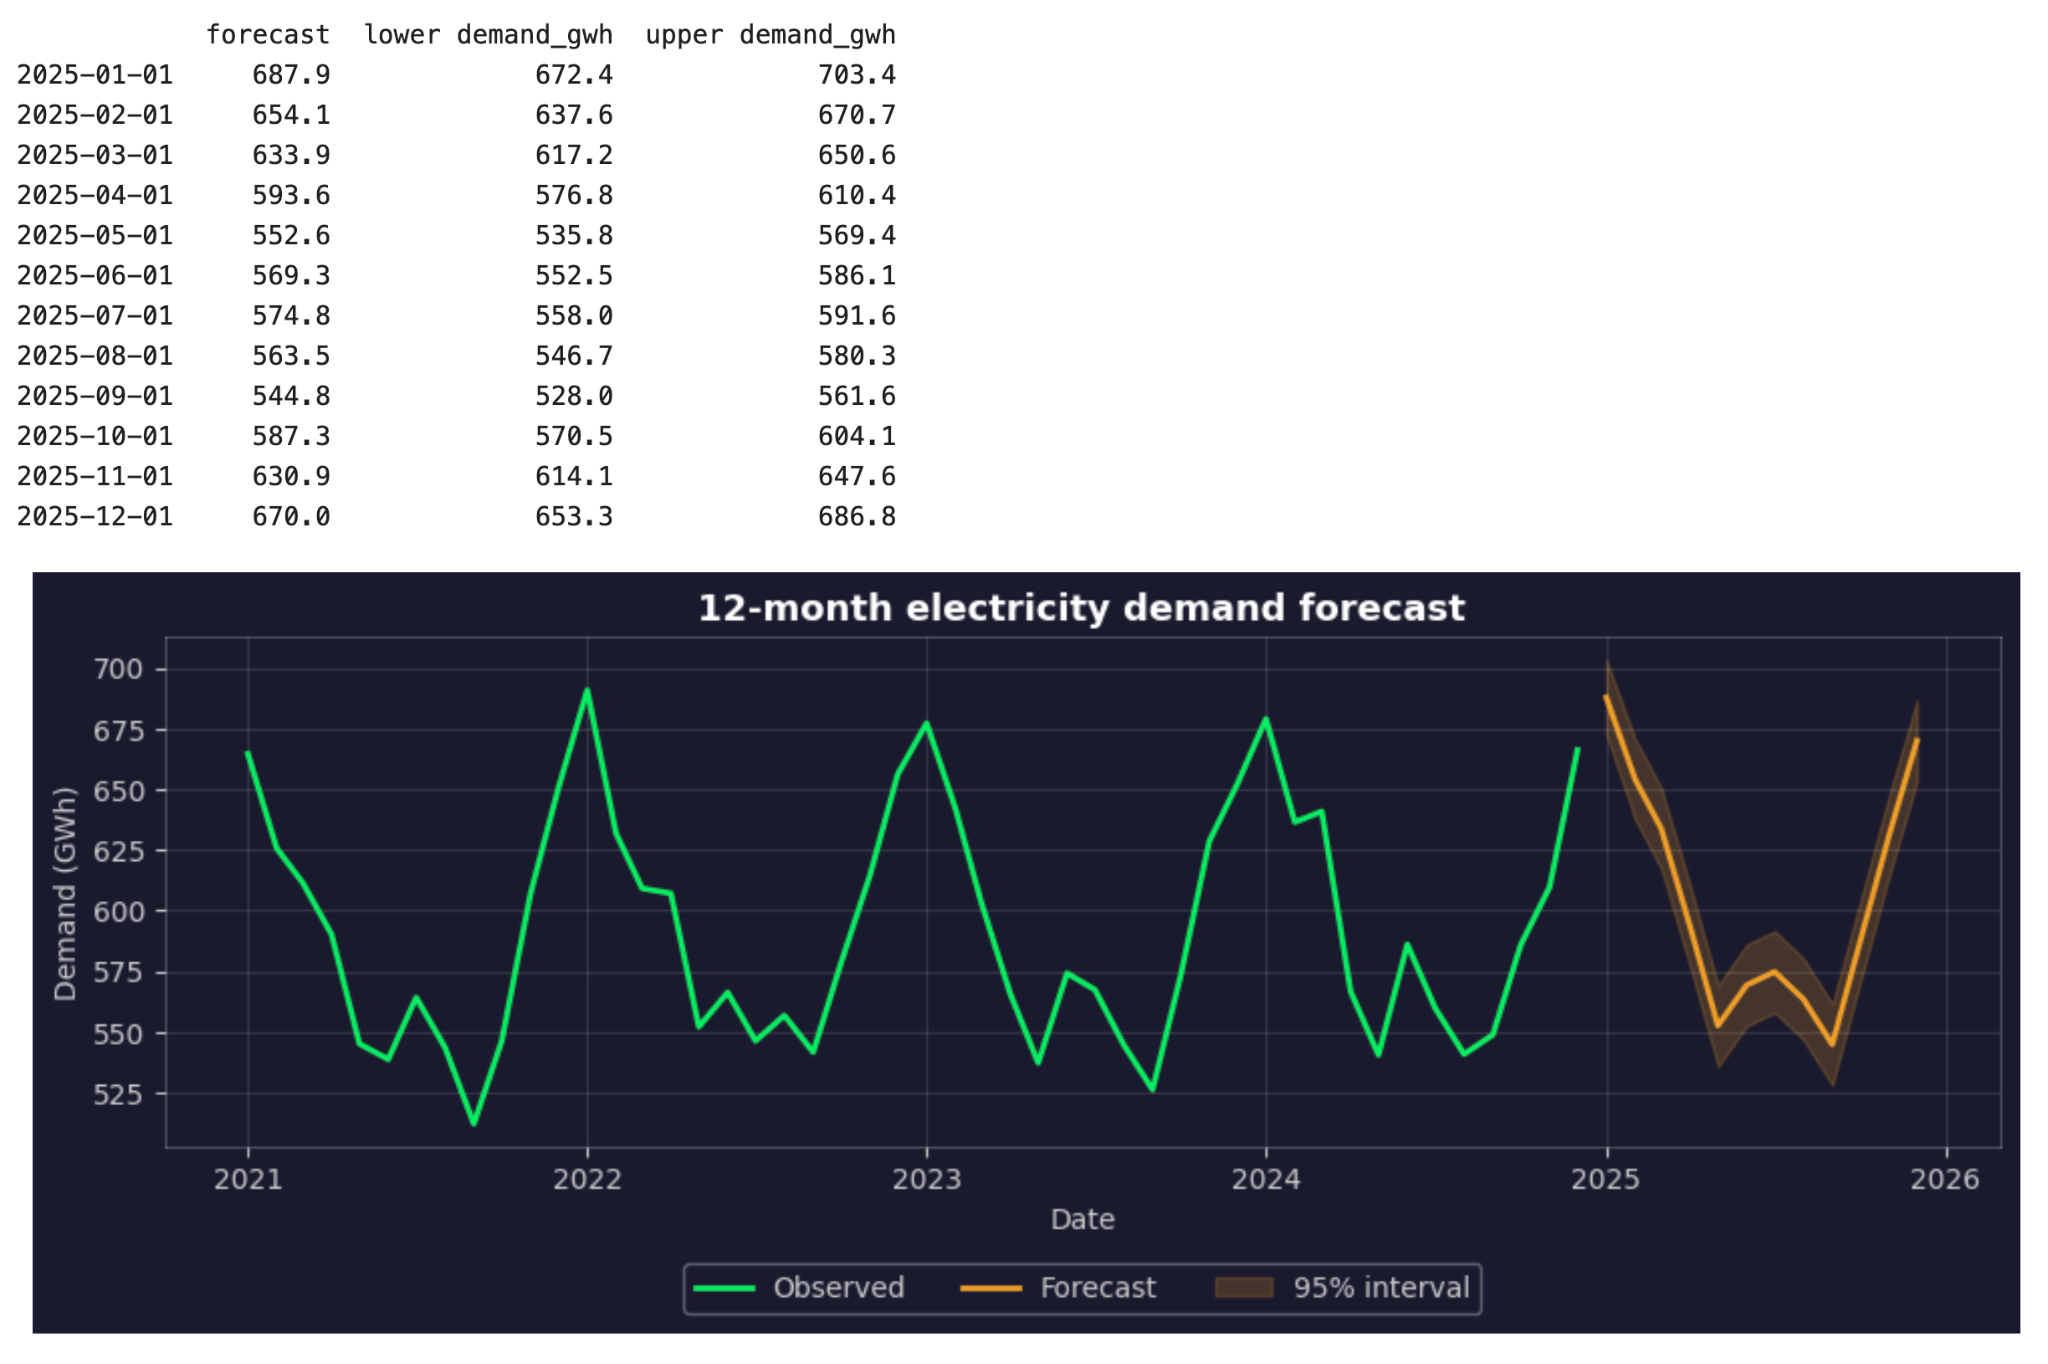
带 95% 预测区间的 12 个月用电量预测
预测走势与既有形状一致:冬季最高,夏季小高峰,春秋最低。
但这个 95% 区间只覆盖在给定气温下拟合模型的不确定性,不包含气温本身的不确定性。若 1 月实际远冷于常年,哪怕模型正确,实际需求也可能落在区间之外。
若想评估预测的敏感性,可分别用更冷和更暖的气温情景再次运行预测并比较结果。
SARIMAX 的局限
SARIMAX 适用于许多季节性预测问题,但也有一些限制。需要了解如下几点:
-
必须提供未来的预测变量: 若未来每个月的每个外生变量没有取值,模型无法进行预测。若某个预测变量并非提前已知,且您无法对其进行预测,就不应将其纳入模型,不论它在过去数据上的拟合提升了多少
-
预测变量的不确定性被隐藏: 当未来预测变量本身来自预测时,它们的误差会传递到需求预测中。标准预测区间不包含这些误差,因此看起来会比应有的更窄
-
只处理一个季节周期: 标准形式只支持单一
S。例如小时级用电既有日周期又有周周期,SARIMAX 无法同时建模二者;且当季节周期很长(如小时数据的周周期S = 168)时,模型也会变慢 -
关系会随时间变化: 模型假设训练期的模式在未来仍保持不变。若更多家庭改用热泵,寒冷天气对需求的影响会改变,旧系数将不再适用。应定期用新数据重新拟合,并持续跟踪模型准确率
-
参数选择需谨慎: AIC 再低的模型也可能预测很差。AIC 与 BIC 只关注训练数据,因此请在留出期上测试最终候选,或者更好地,使用跨多个时间窗口的时间序列交叉验证
-
它不是因果模型: 显著的系数只说明某预测变量有助于预测,并不代表它导致了目标的变化。若您想知道改变价格会对需求造成怎样的影响,需要使用因果推断方法
结语
如果您的数据既有季节性模式,又受外部因素影响,SARIMAX 值得一试。它将序列的历史与推动它变化的外部因素结合起来。当两者并存时,这个模型通常优于只能看到其中一者的模型。
需要记住的是,模型好坏取决于输入。根据数据选择季节周期,谨慎对齐预测变量,不要只信 AIC,要在未来数据上测试;并在构建前确保将来能获得每个预测变量的未来值。若做不到最后一点,SARIMAX 就不适合您的数据集。
若您想继续学习,欢迎报名我们的 Time Series Analysis in Python 课程,半天即可掌握基础。
