Предположим, целевая переменная — месячный спрос на электроэнергию. Модели вроде ARIMA и SARIMA учитывают только прошлые значения ряда и собственные прошлые ошибки прогноза. Но на спрос влияют и внешние факторы, такие как температура: жаркое лето повышает его, как и холодная зима. Если модель не видит эти факторы, она считает каждый необычный месяц шумом и повторяет ту же ошибку при следующем изменении погоды.
SARIMAX решает эту проблему, добавляя внешние (экзогенные) переменные поверх сезонной модели ARIMA. Она по-прежнему извлекает тренд и сезонность из истории ряда, но также использует внешнюю информацию, которая объясняет то, что прошлые значения не могут.
Если вам нужен вводный курс по обработке, интерпретации и визуализации временных рядов в Python, запишитесь на наш трек Time Series in Python и за неделю разберитесь с фундаментом.
Что такое SARIMAX?
SARIMAX является сезонной моделью ARIMA, которая также может использовать внешние предикторы. Расшифровывается как Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors — «сезонная авторегрессия, интегрированное скользящее среднее с экзогенными регрессорами».
SARIMAX работает, прогнозируя целевой ряд на основе четырёх источников информации:
- Прошлые значения: спрос в самых недавних месяцах
- Прошлые ошибки прогноза: насколько модель промахивалась в последних месяцах
- Сезонные шаблоны: спрос в том же месяце прошлых лет
- Экзогенные переменные: внешние данные, которые вы добавляете в модель, например среднюю месячную температуру
Допустим, цель — спрогнозировать спрос на электроэнергию на следующий июль. SARIMAX смотрит на спрос в последние пару месяцев, на спрос в июле предыдущих лет и на ожидаемую температуру в июле. Первые два — из самого ряда, а температура — извне.
Модель записывают как SARIMAX(p, d, q)(P, D, Q, S). Первый набор параметров описывает краткосрочное поведение, второй — сезонную компоненту, где S — число шагов во всём цикле. Для месячных данных с годовым паттерном S равно 12.
Экзогенные переменные в эту нотацию не входят. Их передают модели отдельно как отдельный вход.
Как работает SARIMAX
SARIMAX имеет две группы слагаемых, а экзогенные переменные добавляются поверх них.
Несезонные слагаемые (p, d, q) моделируют краткосрочное поведение:
-
Порядок авторегрессии
p: сколько прошлых значений использует модель. Приp = 2спрос в этом месяце зависит от спроса в двух предыдущих месяцах -
Порядок дифференцирования
d: сколько раз модель дифференцирует ряд, чтобы убрать тренд. Приd = 1модель работает с помесячными изменениями вместо сырых значений спроса -
Порядок скользящего среднего
q: сколько прошлых ошибок прогноза использует модель. Если в прошлом месяце модель занизила спрос, эта ошибка учитывается в прогнозе на текущий месяц
Сезонные слагаемые (P, D, Q, S) делают то же самое, но на сезонных лагах:
-
Сезонный порядок авторегрессии
P: сколько прошлых сезонов учитывает модель. ПриP = 1и месячных данных спрос в этом июле зависит от спроса в прошлом июле -
Сезонный порядок дифференцирования
D: сколько раз модель дифференцирует ряд на сезонном лаге. ПриD = 1модель сравнивает этот июль с прошлым июлем, что убирает повторяющийся годовой паттерн -
Сезонный порядок скользящего среднего
Q: сколько прошлых ошибок прогноза на сезонных лагах использует модель, например ошибку прошлого июля -
Сезонный период
S: сколько шагов во одном цикле. Для месячных данных с годовым паттерном — 12, для дневных с недельным — 7
Экзогенные переменные добавляют информацию, которой нет в самом ряду.
В примере со спросом на электроэнергию — это температура. Жаркое лето или холодная зима увеличивают спрос, а прошлые значения спроса не подскажут модели, какая погода будет в следующем месяце. Сезонный «месяц года» уже учтён в сезонных слагаемых, поэтому в примере достаточно одной внешней переменной — температуры.
В statsmodels SARIMAX — это линейная регрессия по экзогенным переменным с ошибками, следующими сезонному процессу ARIMA. С одной экзогенной переменной это выглядит так:
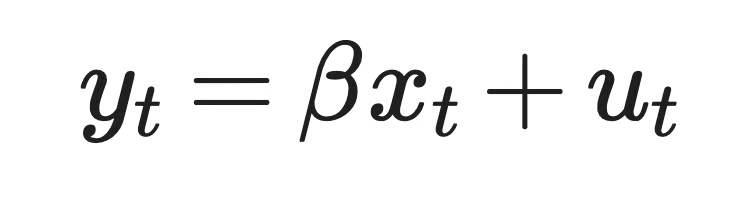
SARIMAX с одной экзогенной переменной
Здесь y_t — спрос на электроэнергию в месяце t, x_t — температура в этом месяце, beta — коэффициент при температуре, а u_t — часть спроса, которую температура не объясняет. Несезонные и сезонные слагаемые моделируют u_t.
Проще говоря: часть спроса объясняет температура, а всё остальное моделируют слагаемые SARIMA.
Вот более наглядный обзор:
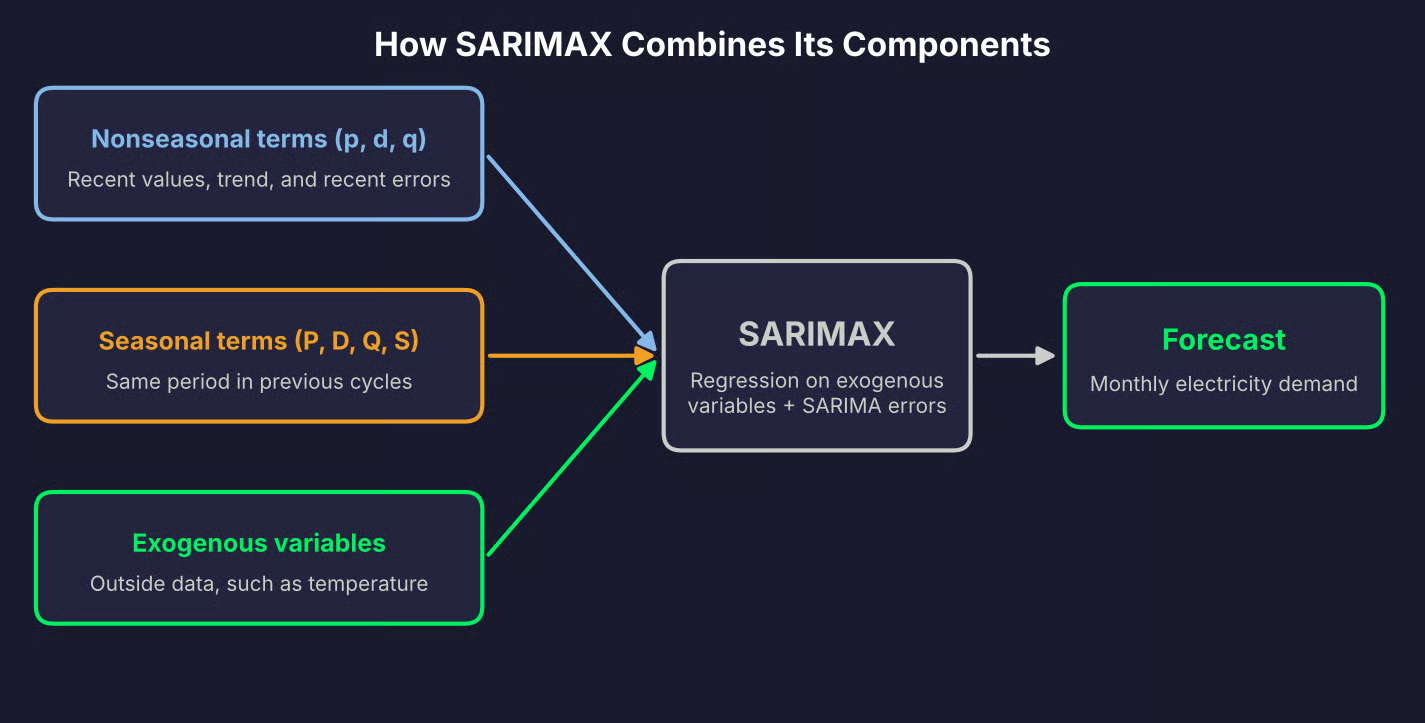
Компоненты SARIMAX
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
Все четыре модели из одного семейства. Различия тонкие, но их легко понять с первого прочтения.
ARIMA моделирует ряд на основе собственных прошлых значений и прошлых ошибок прогноза. SARIMA добавляет к этому сезонные слагаемые, чтобы моделировать шаблоны, повторяющиеся каждые S шагов. ARIMAX добавляет экзогенные переменные к ARIMA, но по умолчанию не имеет сезонных слагаемых. SARIMAX сочетает оба подхода.
Поэтому SARIMAX может представлять остальные модели как частные случаи. Если не передавать экзогенные переменные, получится модель SARIMA. Если обнулить все сезонные порядки, получится несезонная ARIMAX. А без того и другого — ARIMA.
Но, к сожалению, терминология различается между пакетами.
Классический ARIMAX помещает экзогенные переменные непосредственно в уравнение ARIMA рядом с прошлыми значениями ряда. В statsmodels SARIMAX вместо этого обучает регрессию с ошибками SARIMA, как показано выше. Формы разные — коэффициенты тоже, поэтому одна и та же температурная переменная может получить различный коэффициент в зависимости от пакета.
Названия классов и функций тоже не совпадают. Класс ARIMA в statsmodels принимает и сезонные слагаемые, и экзогенные переменные. В R пакет forecast работает с внешними регрессорами через аргумент xreg функций Arima() и auto.arima(). Поэтому всегда проверяйте, как пакет определяет модель, прежде чем сравнивать результаты между инструментами.
Короткое резюме:
| Сезонность? | Внешние переменные? | |
|---|---|---|
| ARIMA | Нет | Нет |
| SARIMA | Да | Нет |
| ARIMAX | Не по умолчанию | Да |
| SARIMAX | Да | Да |
Сравнение семейства моделей ARIMA
Когда использовать SARIMAX
SARIMAX уместен, когда у цели есть повторяющаяся сезонная структура и внешние переменные, способные улучшить прогноз.
Например:
- Спрос на электроэнергию: температура и календарные эффекты (например, праздники) поверх годового цикла
- Розничные продажи: акции, цены и праздничные периоды
- Бронирования отелей: локальные события и цены на номера поверх годового туристического сезона
- Пассажиропоток общественного транспорта: погода и школьные каникулы поверх недельного паттерна в дневных данных
Но SARIMAX подходит не всегда. В двух случаях проще обойтись более простой моделью:
- Нет значимой сезонности: если ряд не повторяет паттерн, сезонные слагаемые лишь добавят оцениваемые параметры. Достаточно ARIMA или ARIMAX
- Предикторы не повышают точность: если экзогенные переменные не уменьшают ошибку на отложенном тестовом периоде, уберите их и используйте SARIMA. Лучшее совпадение на обучении не считается
Важно помнить, что SARIMAX требует значения для каждой экзогенной переменной на период прогноза.
Какие‑то значения известны заранее — например, государственные праздники или запланированные акции. Другие, такие как температура, нужно прогнозировать отдельно, прежде чем SARIMAX сможет их использовать. Если вы не можете получить будущие значения предиктора, вы не можете использовать его в прогнозе.
Как построить модель SARIMAX в Python
В этом разделе мы построим модель SARIMAX в statsmodels — от сырых данных до прогноза на 12 месяцев.
Пример использует синтетический месячный спрос на электроэнергию с температурой как внешней переменной. Он небольшой, воспроизводимый и соответствует общей логике статьи.
Подготовьте данные
Набор данных охватывает десять лет помесячно, с января 2015 по декабрь 2024 года.
Спрос имеет восходящий тренд, годовой календарный паттерн, который медленно меняется со временем, погодный эффект и шум. Две температурные точки намеренно пропущены — чтобы показать, как работать с разрывами:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())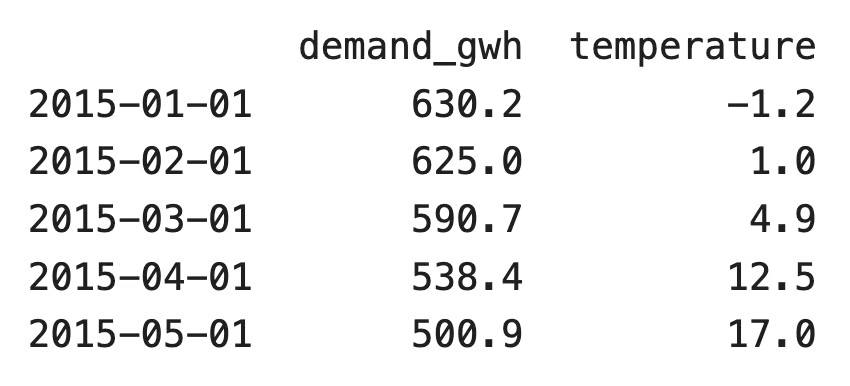
Первые пять строк набора данных
Или, если вам удобнее визуально:
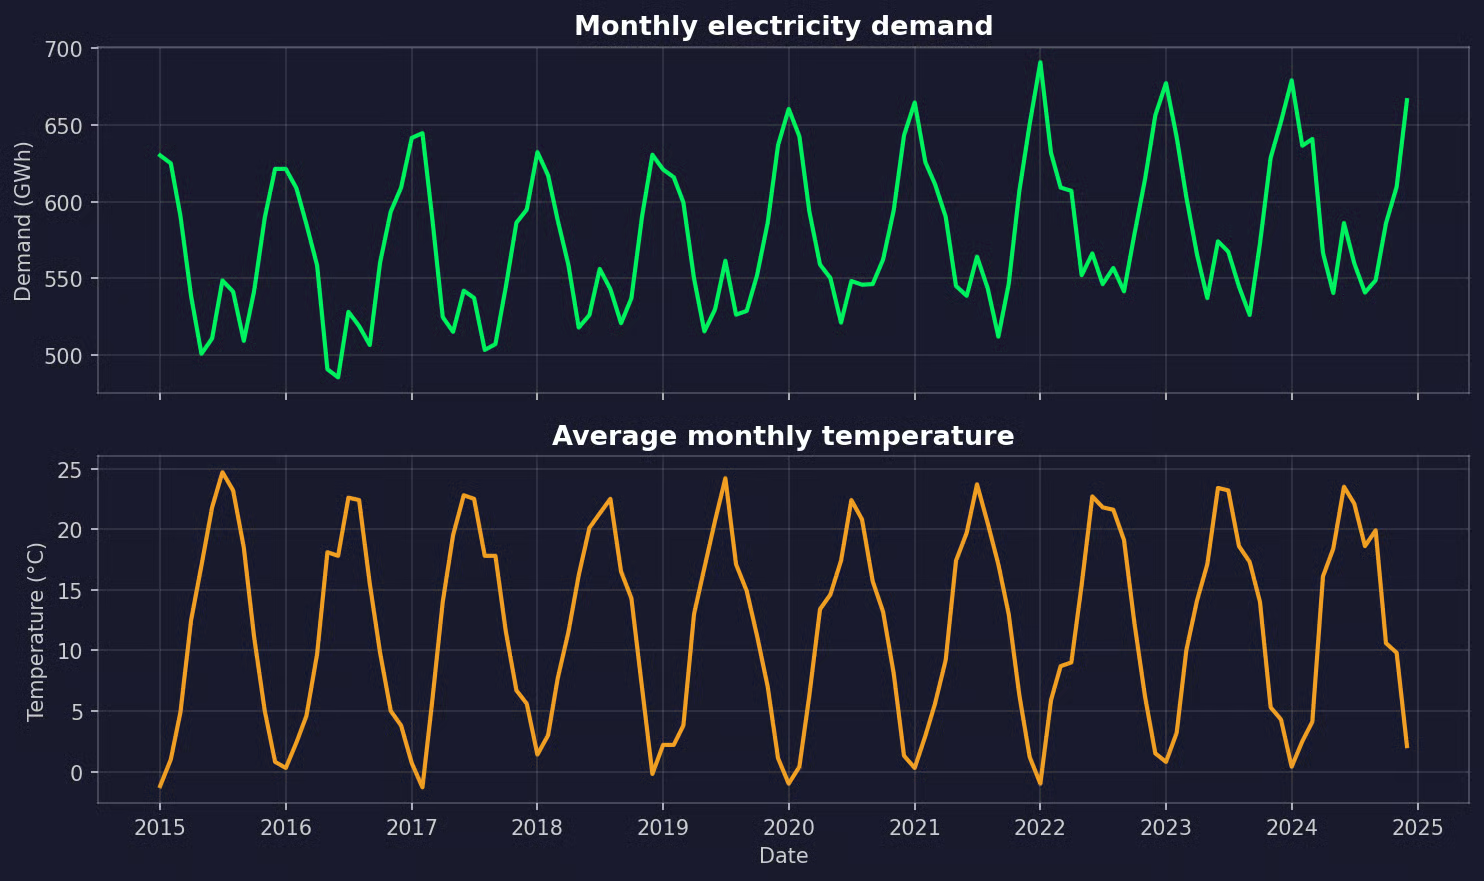
Набор данных температуры
Если вы работаете со своими данными, загрузите их через pd.read_csv() и установите столбец дат индексом. Остальной процесс не меняется.
SARIMAX нужен временной индекс с постоянной частотой. Метод .asfreq() устанавливает месячную частоту и вставляет пустую строку для любого пропущенного месяца. Затем можно посчитать разрывы и заполнить их:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()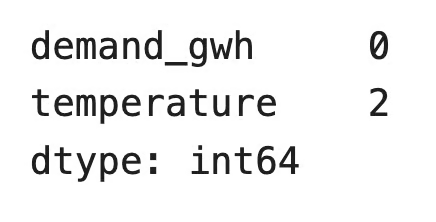
Интерполяция пропусков температуры
Линейная интерполяция подходит здесь, потому что температура плавно меняется месяц к месяцу. Не делайте то же с целью, если в ней большие лакуны: вы будете обучать модель на выдуманных значениях.
Теперь — экзогенные переменные. Спрос растёт и в холод, и в жару, но линейная регрессия по сырой температуре не уловит U‑образную связь. Поэтому мы разделим температуру на два признака:
- Градусы отопления (heating degrees): на сколько градусов средняя температура ниже 18 °C, иначе ноль
- Градусы охлаждения (cooling degrees): на сколько градусов средняя температура выше 18 °C, иначе ноль
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
Теперь разделите данные на цель y и экзогенные переменные X. Разбиение должно быть хронологическим: модель обучается на прошлом и тестируется на будущем. Случайное разбиение утечёт информацией о будущем в обучение:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")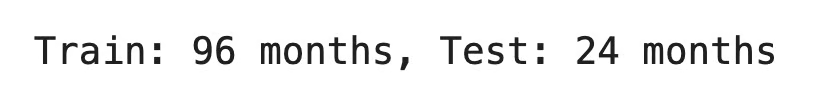
Разбиение на обучение/тест
Важно помнить, что в X_test — фактически наблюдавшиеся температуры. В реальном прогнозе вы их заранее не узнаете — максимум, прогноз погоды. Значит, увиденная далее метрика будет оптимистичной. Используйте наблюдаемые значения предикторов для оценки только если такие же значения будут доступны на момент прогноза (например, праздники или запланированные цены).
Изучите сезонность и стационарность
Начните с графика. Ищите тренды, сезонные циклы и резкие изменения:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()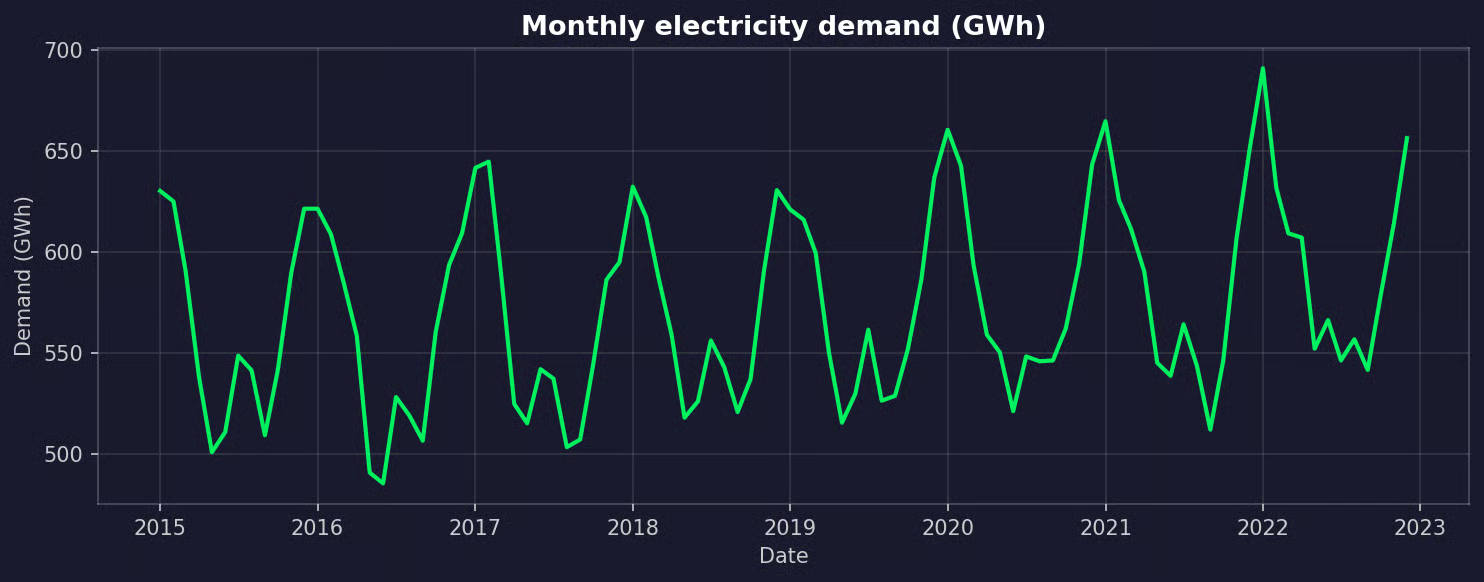
Месячный спрос на электроэнергию в обучающем периоде
Спрос растёт со временем; каждый зимний пик выше, летом — меньший пик. Паттерн повторяется каждые 12 месяцев.
Сезонная декомпозиция разделит ряд на тренд, сезонность и остаток, чтобы подтвердить сезонный период S:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()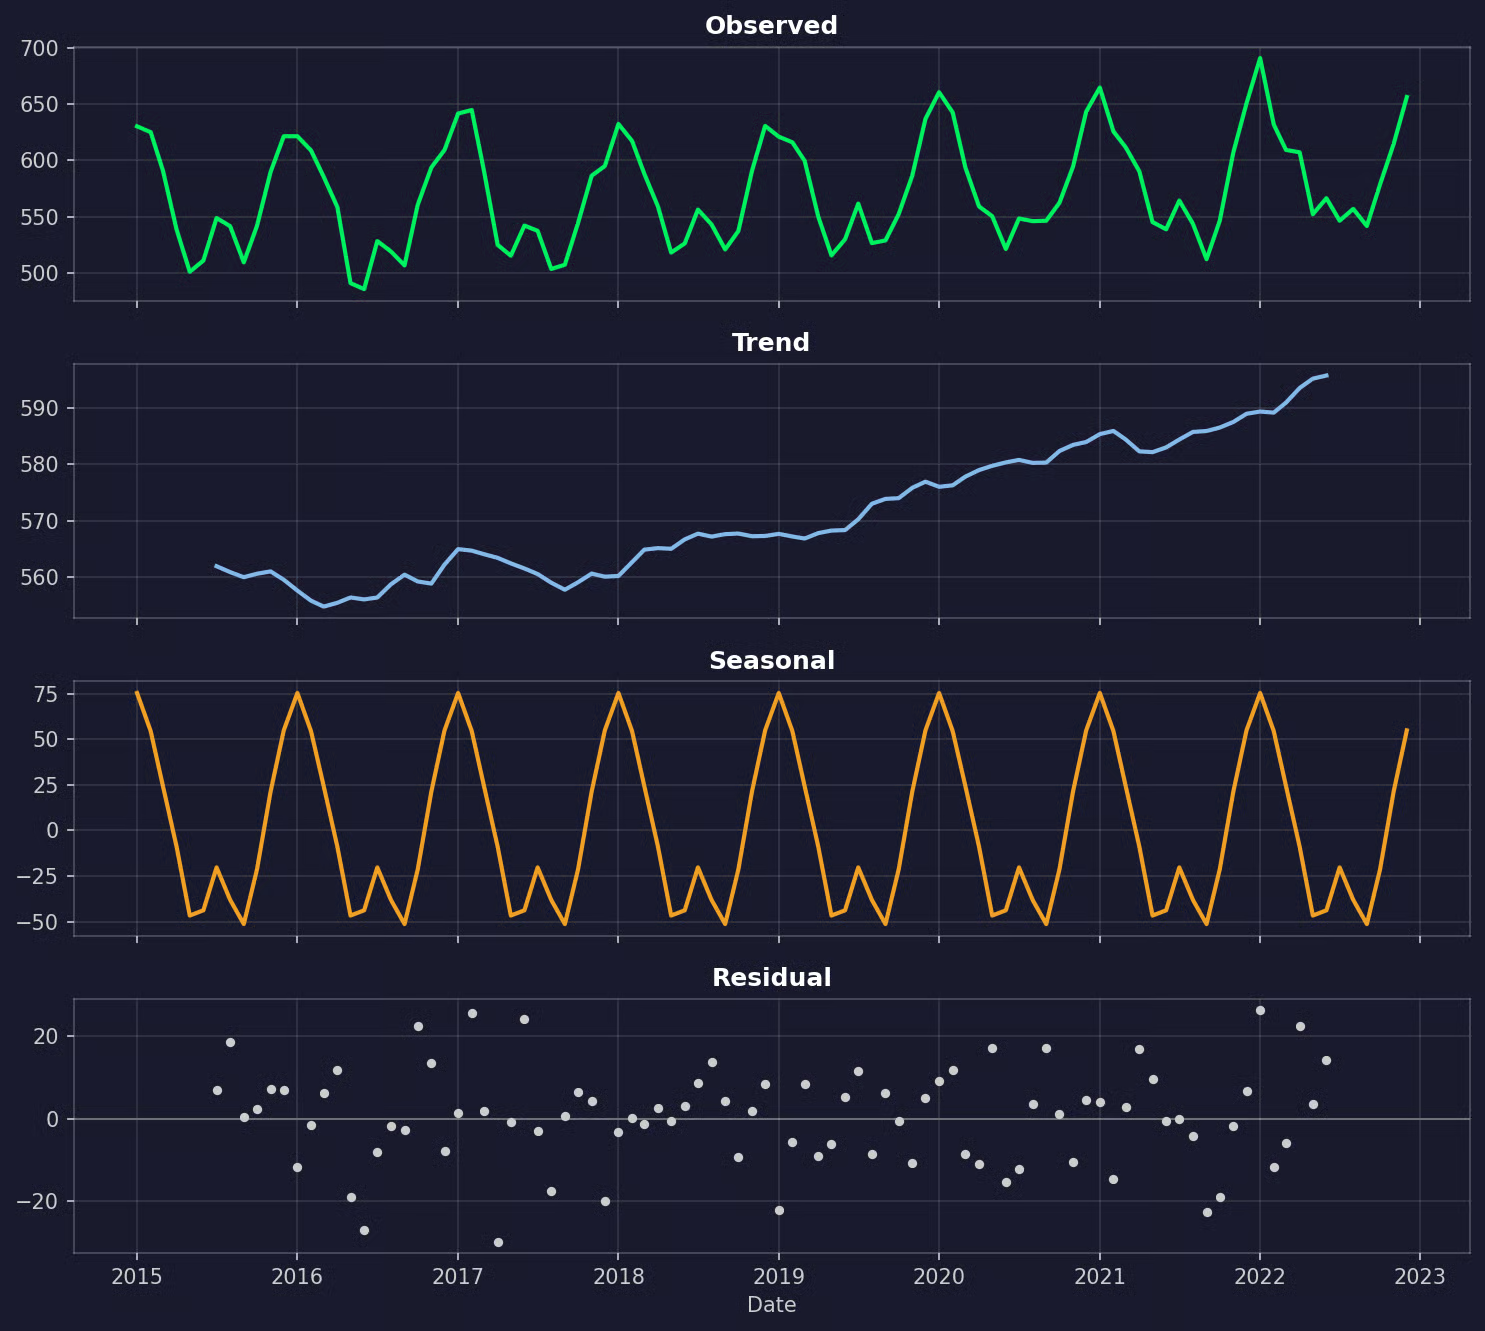
Сезонная декомпозиция спроса на электроэнергию
Сезонная компонента повторяется ежегодно, значит S = 12.
Моделям семейства ARIMA нужен стационарный ряд — со средним и дисперсией, не меняющимися со временем. Наш ряд нестационарен из‑за тренда и сезонного цикла.
Дифференцирование помогает обойти это:
-
Обычное дифференцирование (
d): вычитает значение прошлого месяца из текущего. Убирает тренд -
Сезонное дифференцирование (
D): вычитает значение того же месяца прошлого года. Убирает повторяющуюся сезонность и заодно линейный тренд
Тест расширенного Дики-Фуллера (ADF) проверяет стационарность. Нулевая гипотеза — ряд нестационарен, поэтому маленькое p‑значение (ниже 0,05) — свидетельство стационарности:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")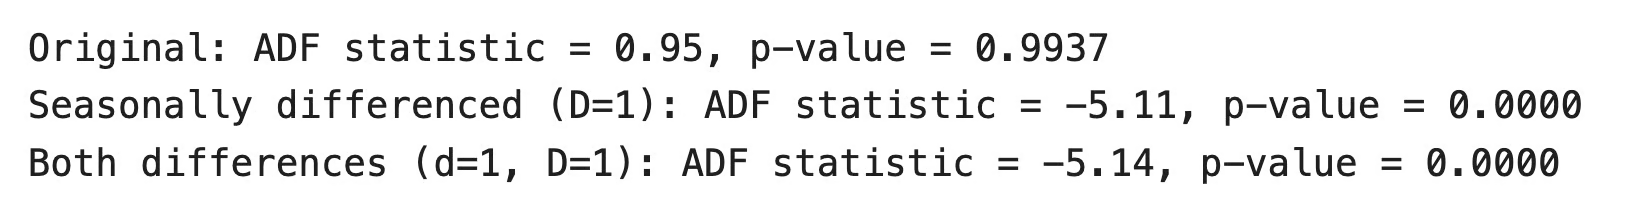
Результат теста ADF
Исходный ряд нестационарен. Одного сезонного дифференцирования достаточно; обычное поверх этого ничего не даёт. Используйте минимально необходимую степень дифференцирования — лишние разности добавляют шум и усложняют оценивание модели.
Итак, выбираем d = 0 и D = 1.
Но относитесь к тесту ADF лишь как к подтверждающему фактору. Он ничего не говорит о p, q, P или Q, а на коротких рядах может давать разные ответы в зависимости от настроек.
Подберите кандидаты параметров
Графики ACF и PACF помогают выбрать кандидатов для оставшихся порядков:
-
ACF (автокорреляционная функция): показывает корреляцию ряда с собственными лагающими значениями. Шипы в ACF указывают на слагаемые скользящего среднего:
qна кратких лагах иQна сезонных -
PACF (частичная автокорреляционная функция): показывает ту же корреляцию, но с устранением влияния промежуточных лагов. Шипы в PACF указывают на авторегрессионные слагаемые:
pна кратких лагах иPна сезонных
Строить их нужно для сезонно продифференцированного ряда — именно с ним работает модель:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()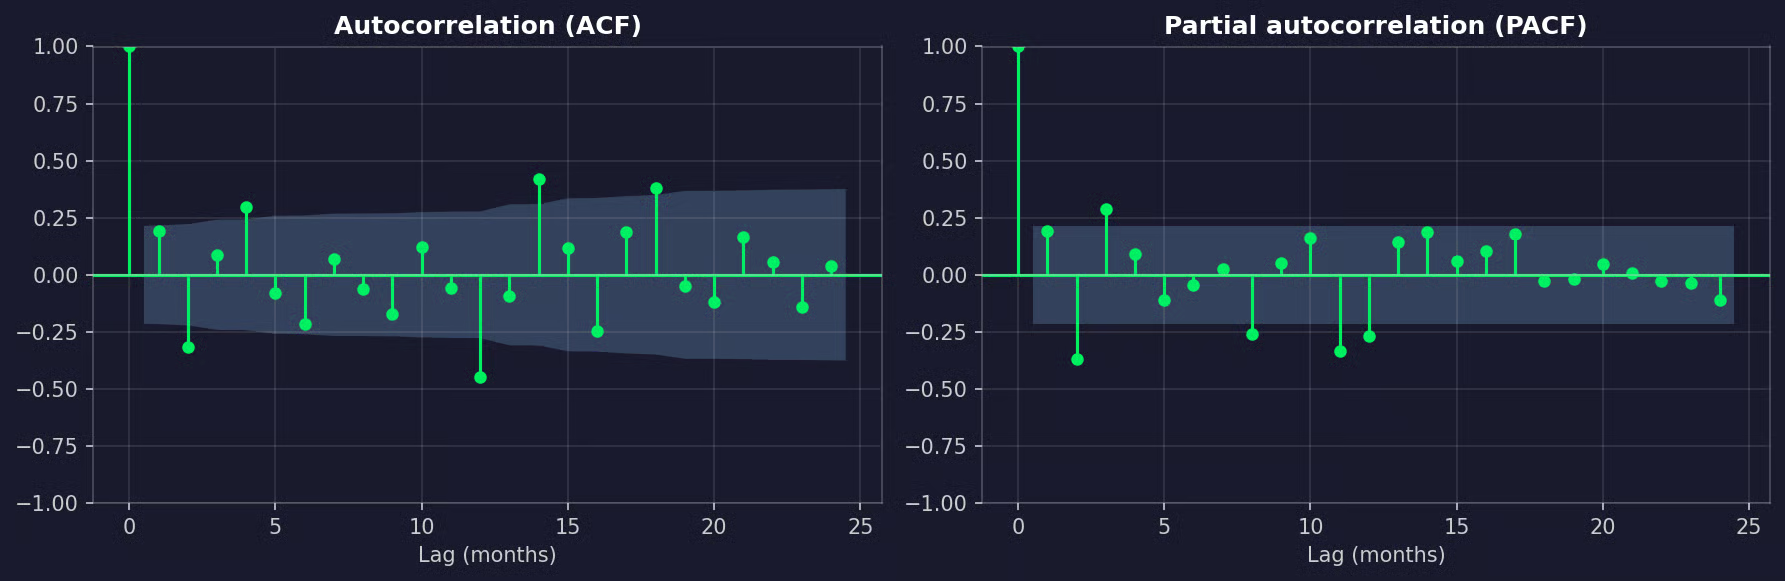
ACF и PACF сезонно продифференцированного спроса на электроэнергию
В ACF заметен явный отрицательный шип на лаге 12 и ничего на лаге 24. Это типичный признак сезонного слагаемого скользящего среднего, так что Q = 1 — хороший кандидат. На обоих графиках есть шипы и на коротких лагах, значит стоит протестировать p и q.
Далее — обучить небольшой набор кандидатных моделей и сравнить их по AIC или BIC. Обе метрики оценивают качество подгонки на обучении и штрафуют за лишние параметры. Ниже — лучше; BIC сильнее штрафует за сложность, чем AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))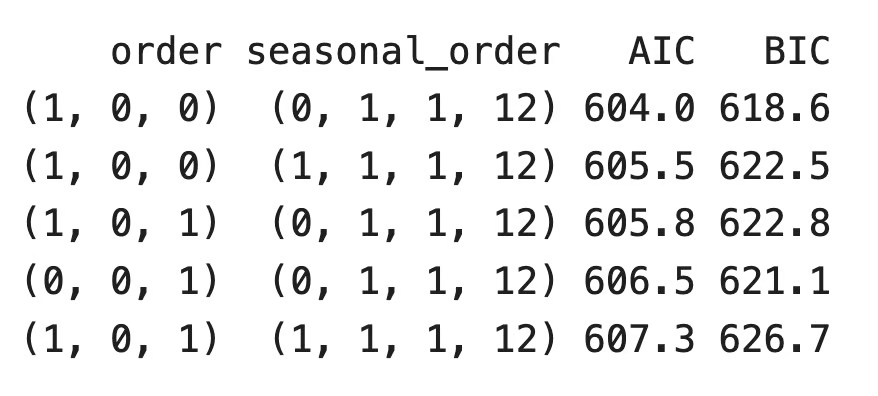
Результаты AIC и BIC
SARIMAX(1, 0, 0)(0, 1, 1, 12) выигрывает по AIC и BIC. Это ещё и одна из самых простых моделей в списке.
Аргумент trend="c" добавляет константу. При сезонном дифференцировании константа моделирует год‑к‑году рост спроса.
Есть инструменты вроде auto_arima() из библиотеки pmdarima, которые выполнят этот поиск за вас. Они удобны для первого прохода, но AIC и BIC оценивают только подгонку на обучении. Прежде чем доверять модели, протестируйте её на невиданных данных.
Обучите модель
Передайте цель первым аргументом, а экзогенные переменные — через exog. Аргумент order принимает (p, d, q), а seasonal_order — (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())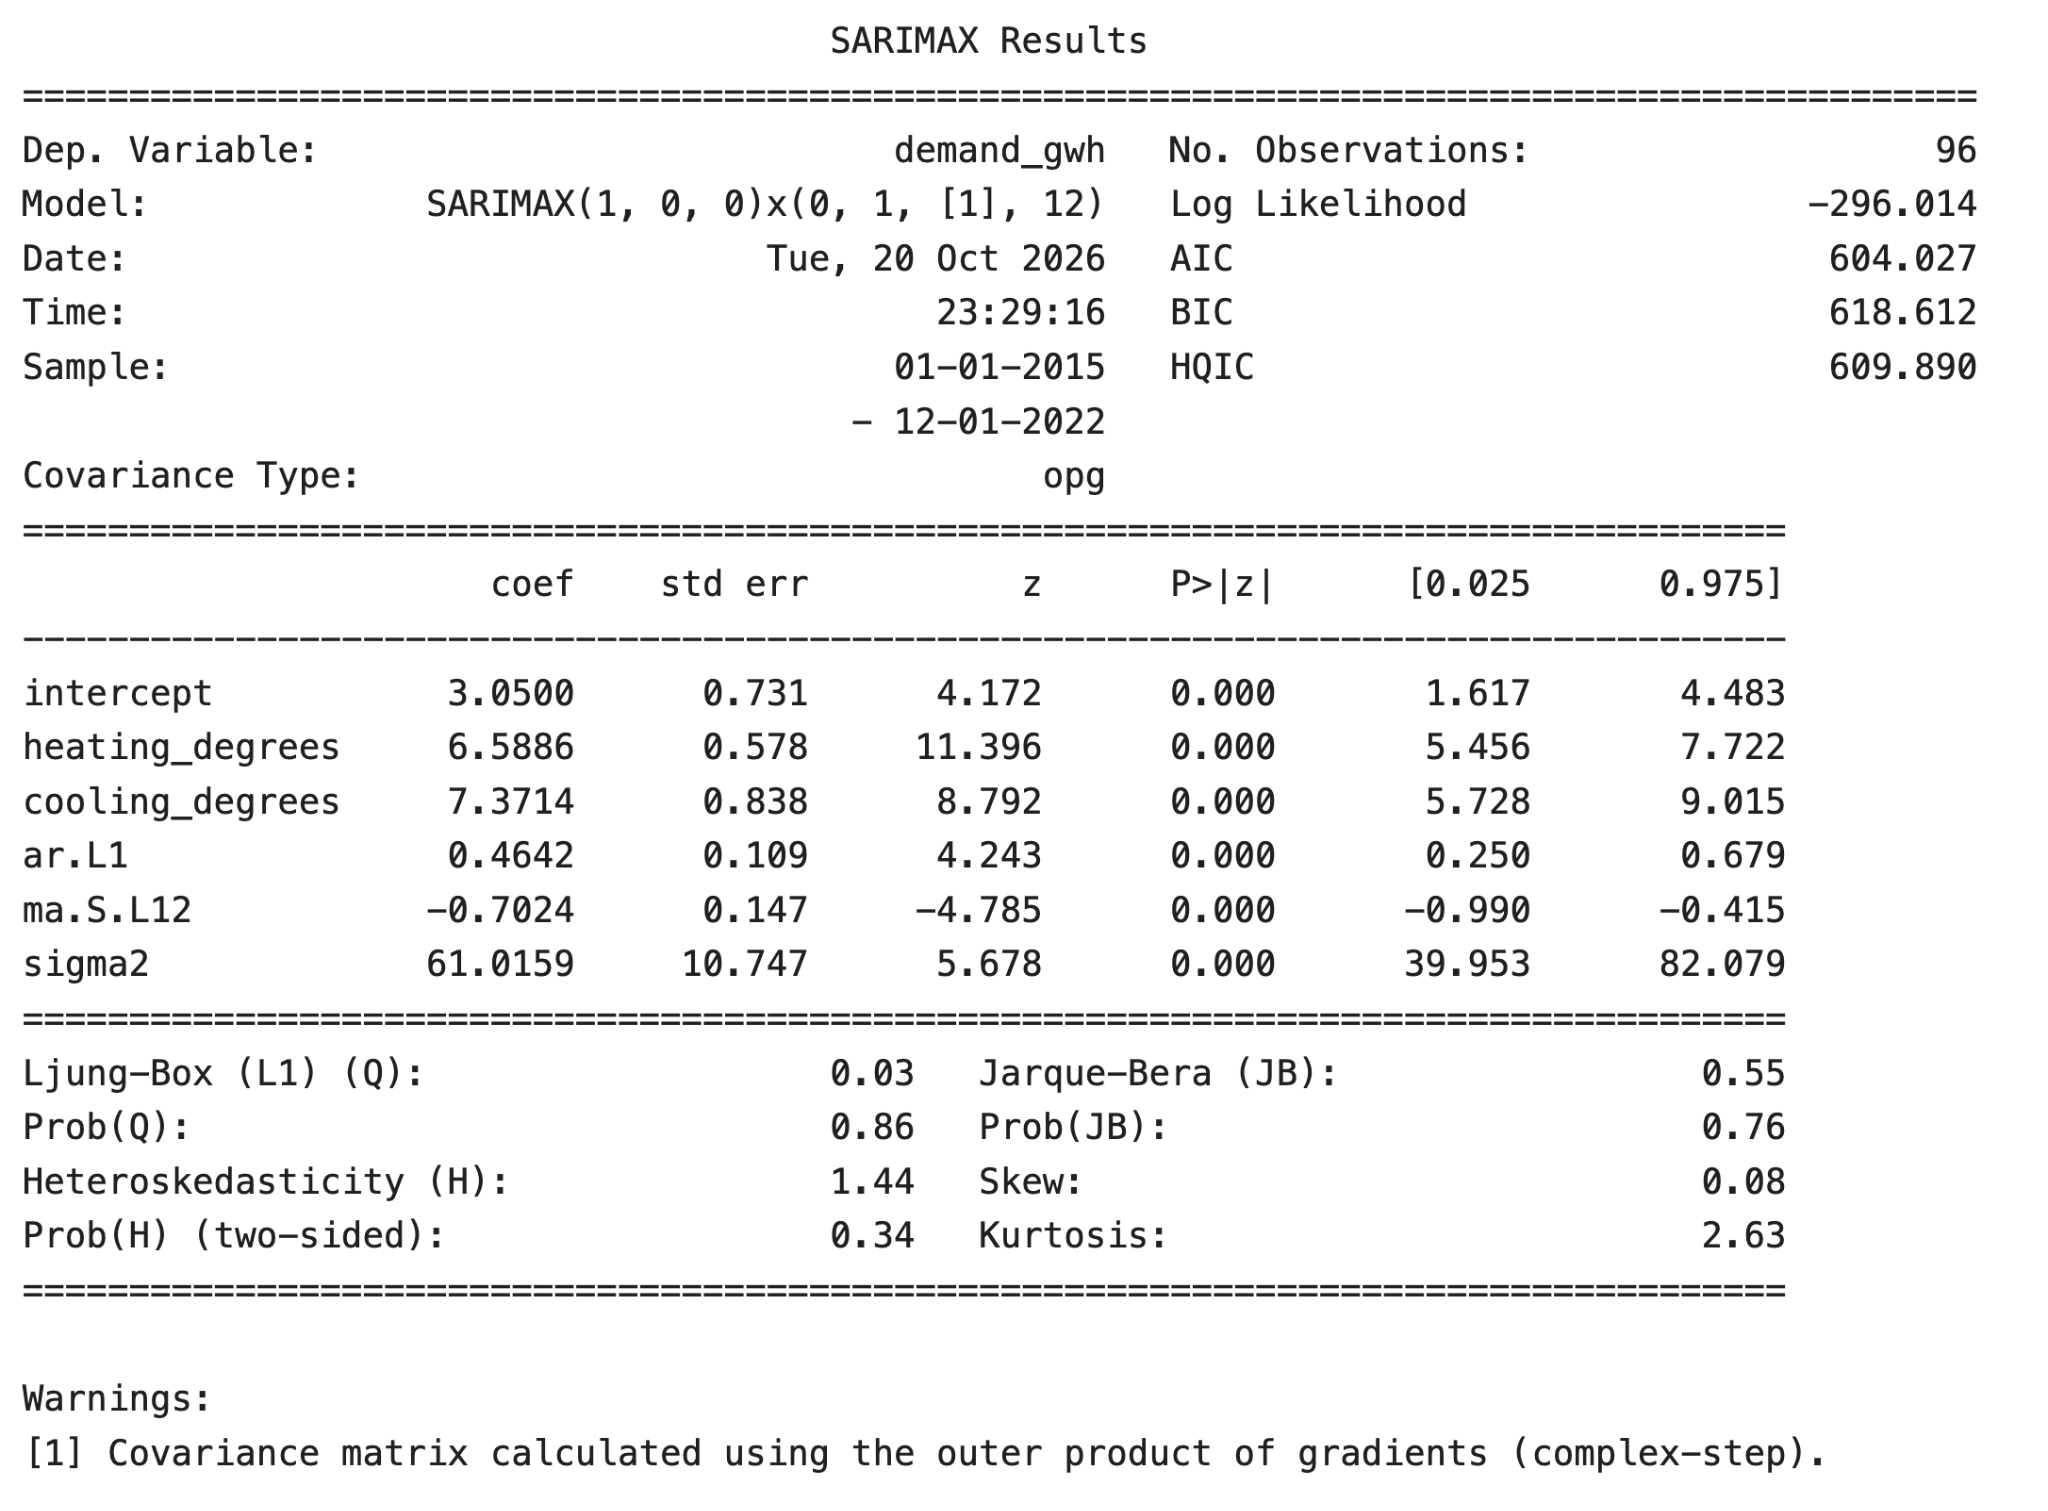
Сводка модели SARIMAX
Как читать таблицу коэффициентов:
-
heating_degrees: каждый дополнительный «градус отопления» связан примерно с +6,6 ГВт·ч спроса при прочих равных в модели -
cooling_degrees: каждый дополнительный «градус охлаждения» — примерно +7,4 ГВт·ч спроса -
ar.L1: около 46% необъяснённой прошлой разницы переходит в текущий месяц -
ma.S.L12: сезонное слагаемое скользящего среднего, корректирующее прогноз по ошибке того же месяца прошлого года -
sigma2: дисперсия оставшегося шума
Все коэффициенты имеют p‑значения, близкие к нулю, значит каждое слагаемое что‑то добавляет модели.
Но эти коэффициенты описывают связи внутри подогнанной модели, а не причинность. Здесь данные сгенерированы так, что температура влияет на спрос, поэтому трактовка безопасна. В реальных данных предиктор может казаться важным, потому что движется вместе с тем, чего модель не видит.
Диагностика и оценка модели
Хорошая модель оставляет после себя остатки, похожие на случайный шум. Если в остатках остаётся структура, модель что‑то упустила.
Метод .plot_diagnostics() строит четыре графика одним вызовом:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()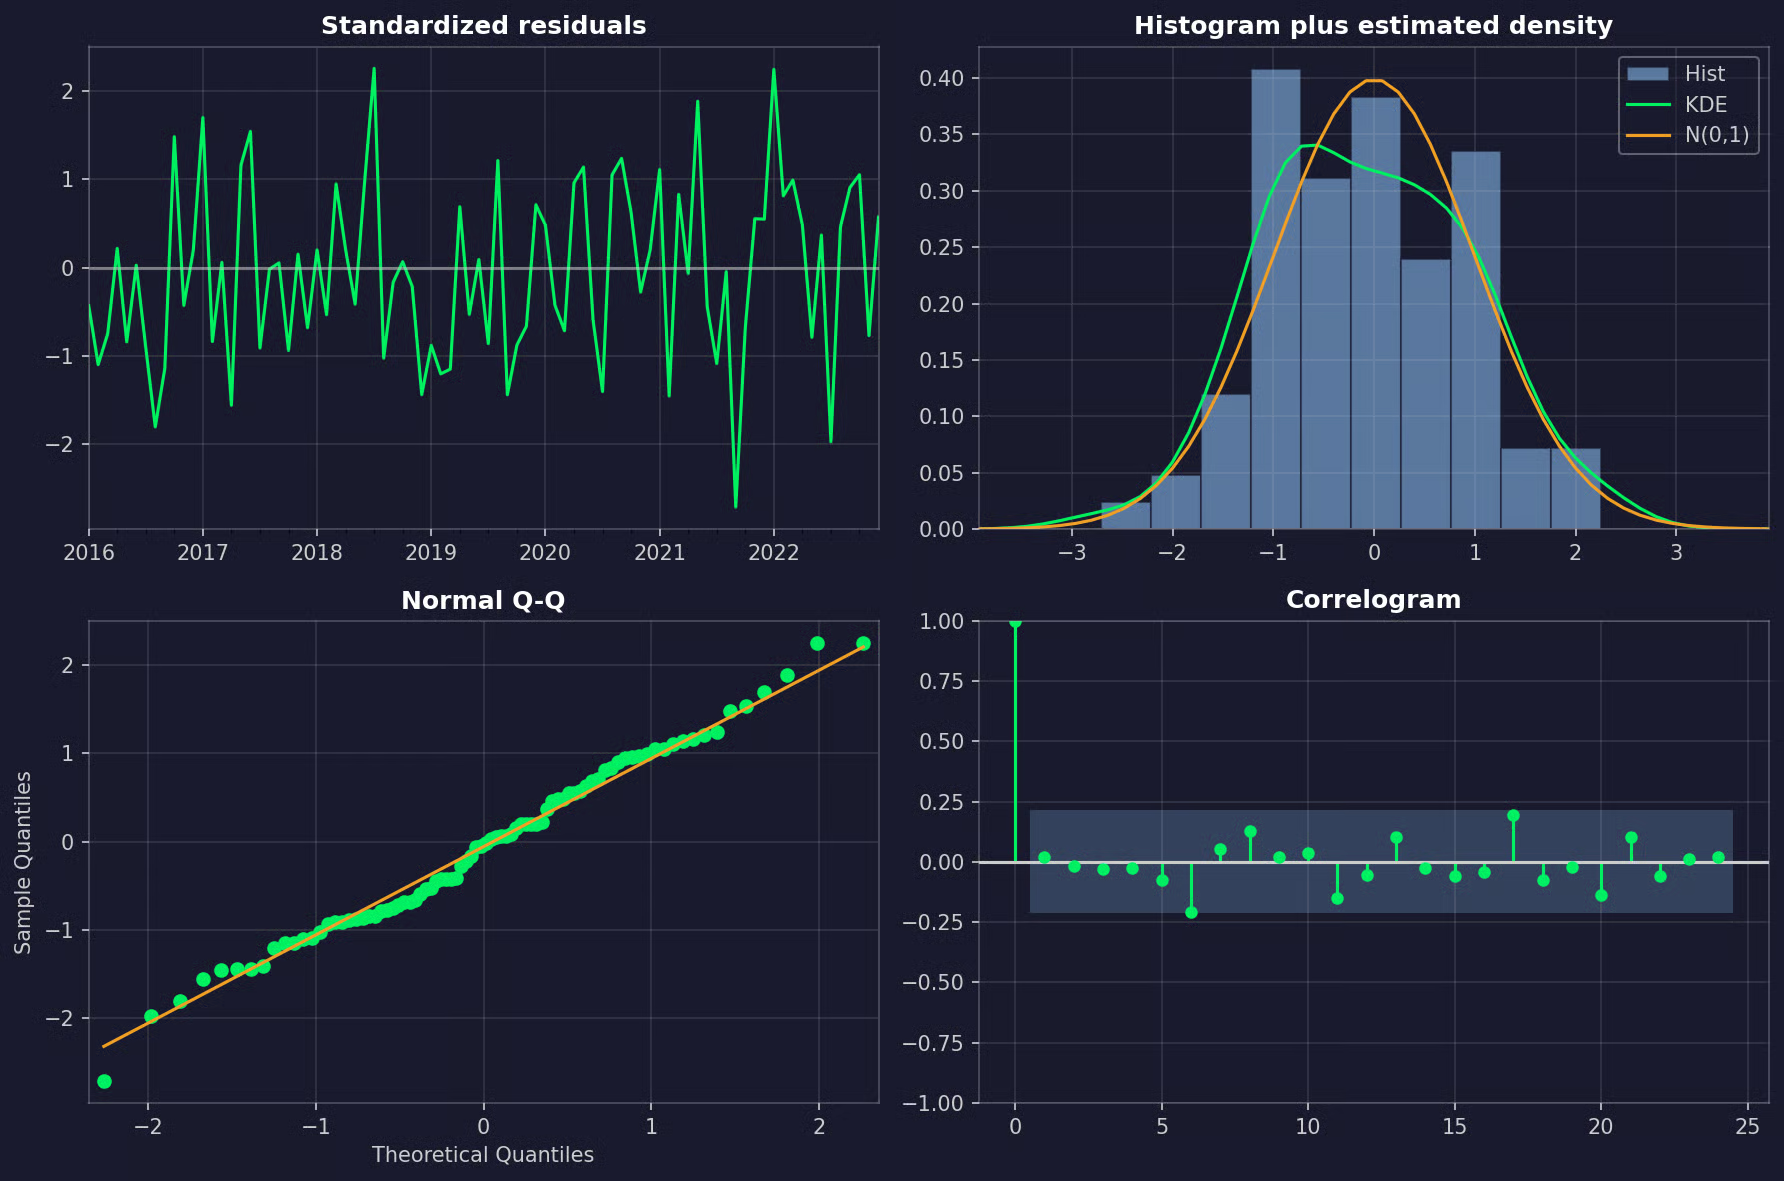
Диагностические графики остатков
На что смотреть:
- Стандартизованные остатки: без тренда, без повторяющихся паттернов и без отрезков с резко растущим размахом
- Гистограмма и Q-Q график: точки близки к нормальному распределению
- Коррелограмма: нет шипов за пределами доверительной полосы, особенно на лаге 12 — шип там означает, что сезонность обработана не до конца
Тест Льюнга—Бокса даёт ту же проверку в числах. Нулевая гипотеза — в остатках нет автокорреляции до заданного лага, значит нам нужны большие p‑значения:
# Пропустим первые 13 остатков из-за разгонного периода дифференцирования
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))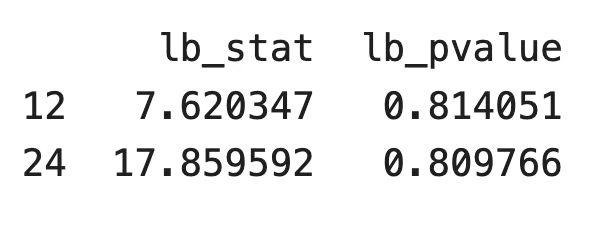
Результаты теста Льюнга—Бокса
Оба p‑значения значительно выше 0,05, значит остатки похожи на шум.
Теперь главное — точность на невиданных данных. Метод .get_forecast() предсказывает 24 тестовых месяца и требует экзогенные значения для этих месяцев.
Сам по себе прогноз мало о чём говорит, поэтому сравним SARIMAX с двумя базовыми подходами:
- Сезонный наивный прогноз: повторяет значения последних 12 месяцев обучения
- SARIMA: та же модель, но без экзогенных переменных
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Бейзлайн 1: повтор последних 12 наблюдавшихся месяцев
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Бейзлайн 2: та же модель без экзогенных переменных
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()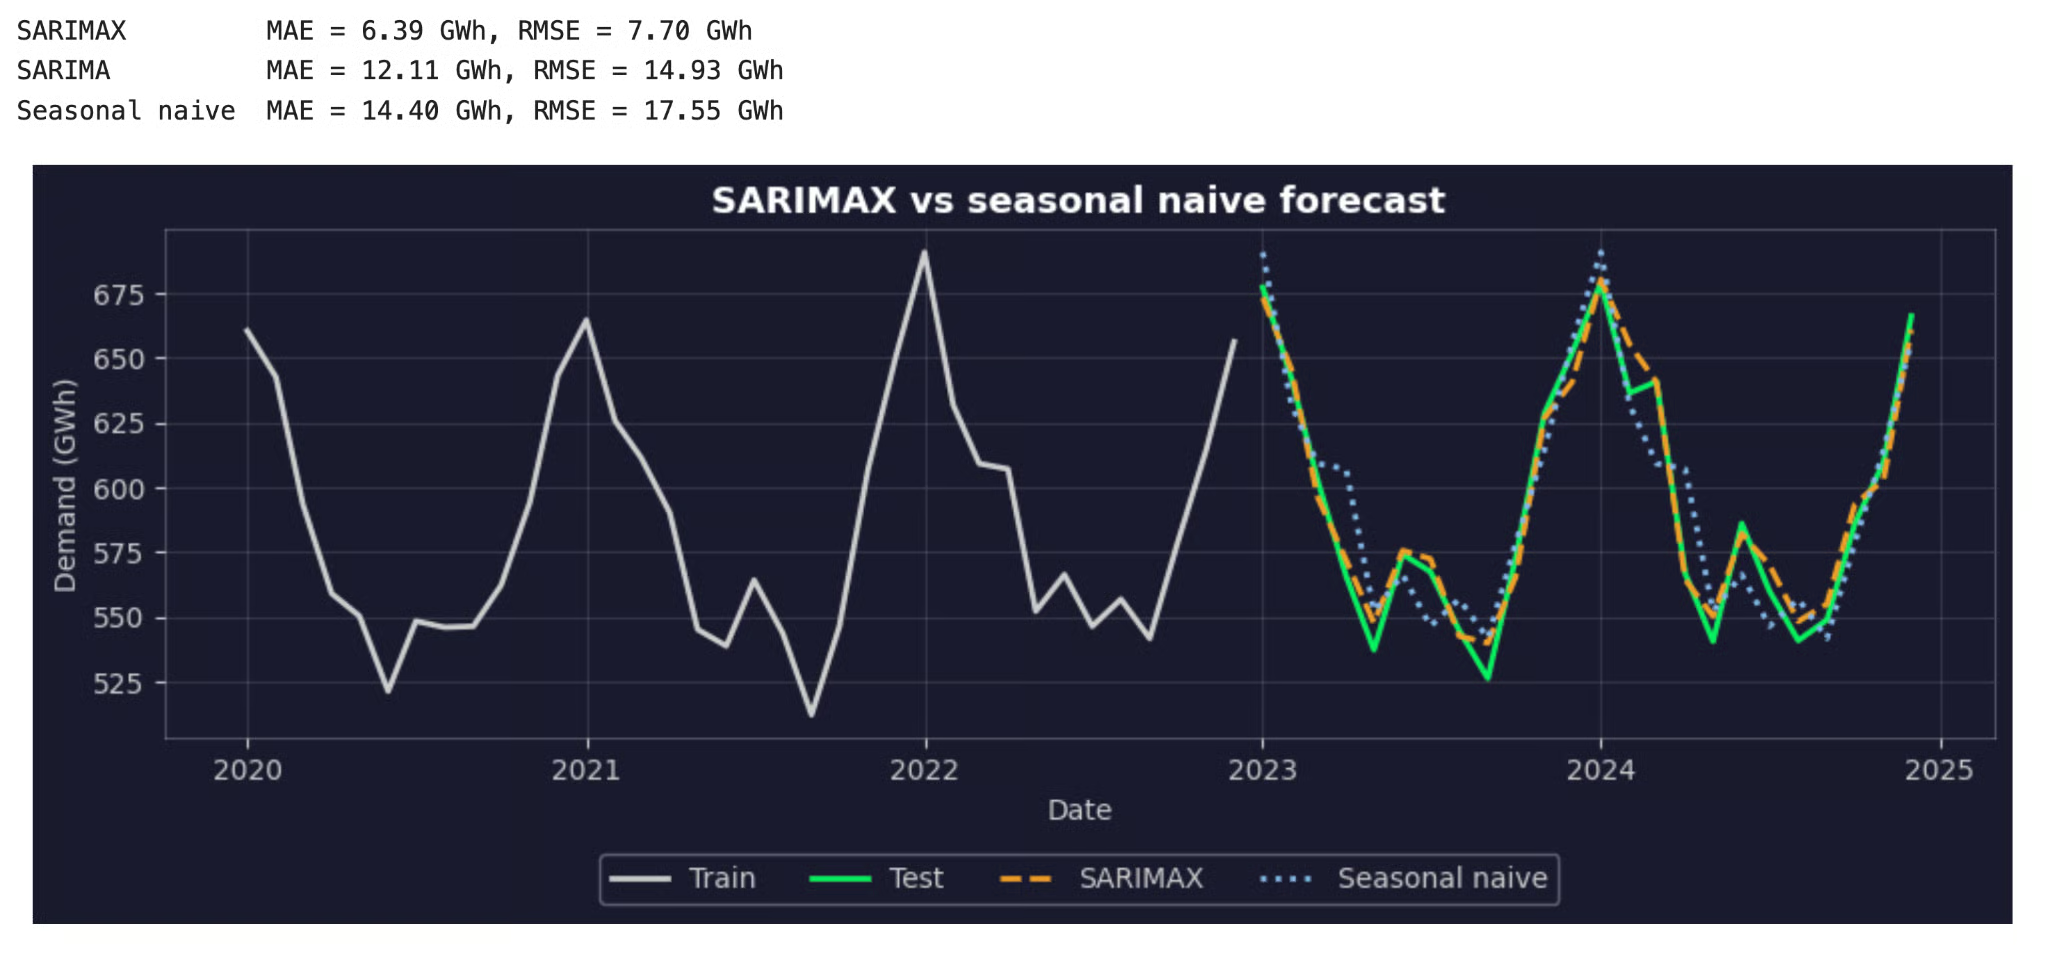
Прогнозы SARIMAX и сезонного наивного метода vs фактический спрос в тестовом наборе
MAE (средняя абсолютная ошибка) — средний размер ошибки в ГВт·ч. RMSE (корень из среднеквадратичной ошибки) сильнее наказывает большие ошибки.
У SARIMAX примерно вдвое меньше ошибка, чем у SARIMA, по обеим метрикам. Одних сезонных слагаемых недостаточно, чтобы предсказать необычно холодный январь или жаркий июль, а температурные признаки — могут.
Помните, что здесь использованы наблюдавшиеся температуры тестового периода. С прогнозом погоды вместо них разница была бы меньше.
Спрогнозируйте будущие значения
Когда вы довольны моделью, переобучите её на всех данных, чтобы прогноз начинался с самого последнего месяца.
Затем прогнозируйте через .get_forecast(). Нужны значения для каждой экзогенной переменной на каждый будущий месяц. Если чего‑то не хватает, statsmodels выдаст ошибку.
Откуда брать эти значения — зависит от переменной. Например:
- Известные календарные признаки: праздники и число рабочих дней известны на годы вперёд
- Запланированные бизнес-решения: цены и акции известны, если они уже внесены в план
- Погода: температура требует отдельного прогноза — от погодного сервиса или другой модели
- Исторические средние: если ничего лучше нет, используйте среднее значение для каждого календарного месяца из прошлых данных
Здесь используем последний вариант как замену прогноза погоды:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()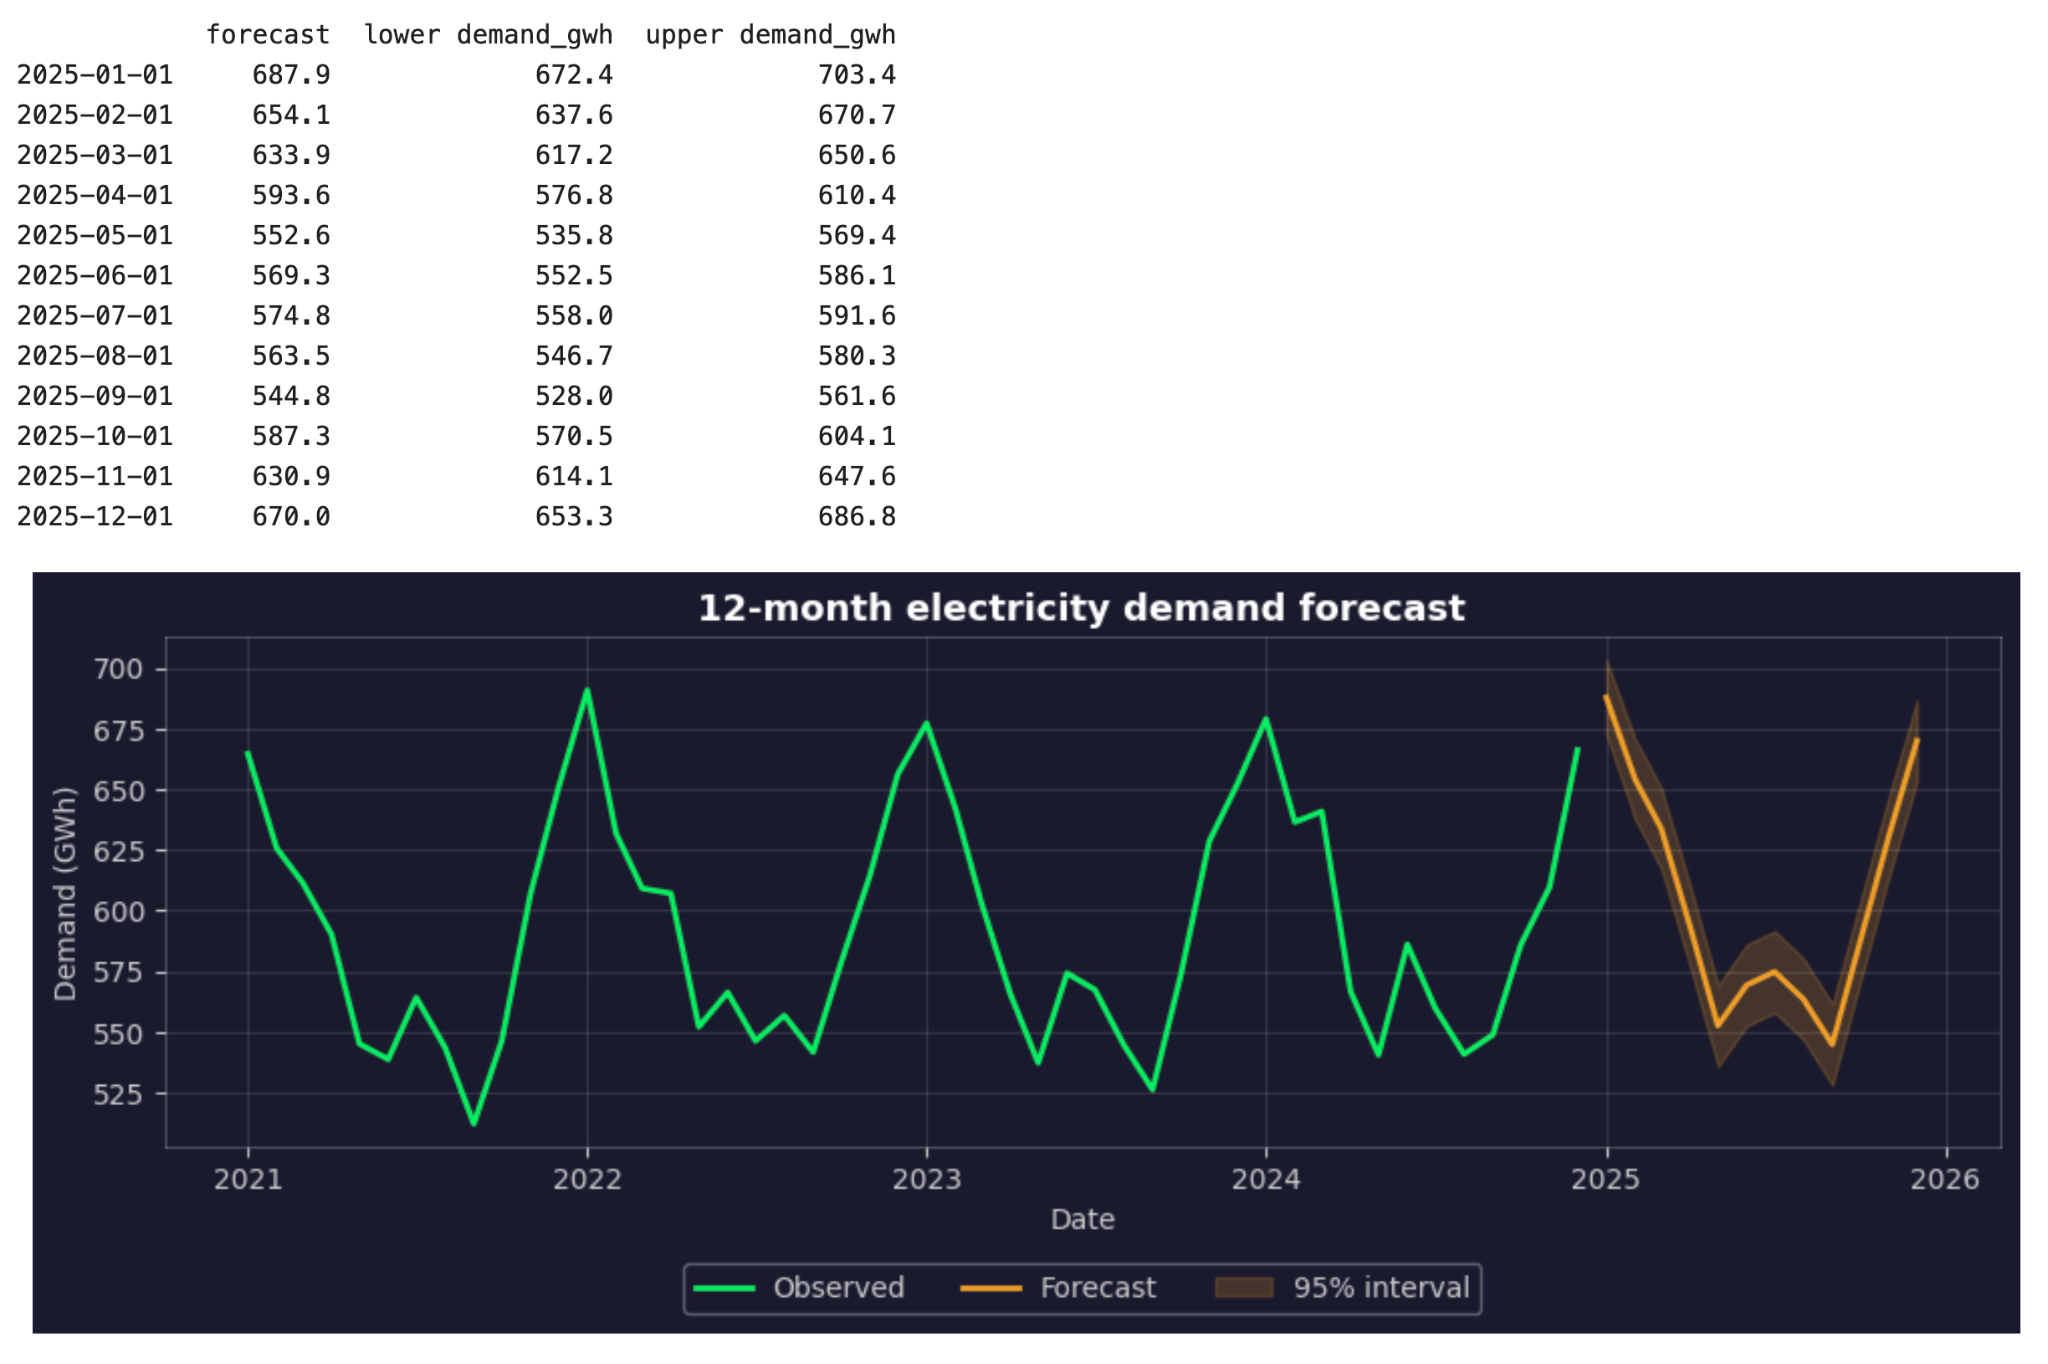
12-месячный прогноз спроса на электроэнергию с 95%-м предиктивным интервалом
Прогноз следует знакомой форме: наибольший спрос зимой, меньший всплеск летом, наименьший — весной и осенью.
Но 95%-й интервал отражает лишь неопределённость подогнанной модели при заданных вами температурах. Он не учитывает неопределённость самих температур. Если январь окажется намного холоднее среднего, фактический спрос может выйти за пределы интервала даже при корректной модели.
Чтобы оценить чувствительность прогноза, запустите его заново со сценарием более холодной и более тёплой погоды и сравните результаты.
Ограничения SARIMAX
SARIMAX хорошо подходит для многих задач сезонного прогнозирования, но у него есть ограничения. Важно знать следующее:
-
Нужны будущие предикторы: модель не сможет прогнозировать без значений каждой экзогенной переменной на каждый будущий месяц. Если предиктор не известен заранее и вы не можете его спрогнозировать, ему не место в модели, как бы ни улучшалась подгонка на прошлых данных
-
Неопределённость предикторов скрыта: когда будущие предикторы тоже являются прогнозами, их ошибки переходят в прогноз спроса. Стандартный предиктивный интервал их не включает, поэтому выглядит уже, чем должен быть
-
Обрабатывает один сезонный период: стандартная форма поддерживает один
S. Почасовой спрос на электроэнергию имеет дневной и недельный цикл, и SARIMAX не может смоделировать оба сразу. К тому же он становится медленным при длинных сезонных периодах, напримерS = 168для недельного цикла в почасовых данных -
Связи могут меняться: модель предполагает, что паттерны из обучающих данных сохранятся в будущем. Если больше домов перейдёт на тепловые насосы, влияние холода на спрос изменится, и старый коэффициент это уже не опишет. Регулярно переобучайте модель на свежих данных и отслеживайте её точность во времени
-
Выбор параметров требует осторожности: модель с низким AIC всё ещё может плохо прогнозировать. AIC и BIC смотрят только на обучение, поэтому тестируйте финальные кандидаты на отложенном периоде или, ещё лучше, через перекрёстную проверку по временным окнам
-
Это не каузальная модель: значимый коэффициент говорит, что предиктор помогает прогнозу, а не что он вызывает изменения цели. Если нужно понять, что произойдёт со спросом при изменении цены, используйте методы причинного вывода
Выводы
Если ваши данные повторяют сезонный паттерн и зависят от внешних факторов, стоит попробовать SARIMAX. Он сочетает историю ряда и внешние факторы, которые на него влияют. Когда в данных есть и то и другое, модель обычно лучше, чем та, что видит только одно.
Важно помнить: модель настолько хороша, насколько хороши входные данные. Подбирайте сезонный период по данным, аккуратно выравнивайте предикторы, проверяйте на будущем вместо доверия AIC и убедитесь, что у вас будут будущие значения для каждого предиктора, прежде чем что‑то строить. Если последнее невозможно, SARIMAX — не лучший выбор для вашего набора.
Если хотите продолжить обучение, запишитесь на наш курс Time Series Analysis in Python и разберитесь с основами за один день.