
Poniamo che il target sia la domanda mensile di elettricità. Modelli come ARIMA e SARIMA guardano solo ai valori passati della serie e ai loro errori di previsione passati. Ma la domanda dipende anche da fattori esterni come la temperatura: un'estate calda la aumenta, e lo stesso fa un inverno rigido. Se il modello non vede questi fattori, tratta ogni mese insolito come rumore e ripete lo stesso errore alla prossima variazione del meteo.
SARIMAX risolve il problema aggiungendo variabili esterne, o esogene, sopra un modello ARIMA stagionale. Continua a imparare trend e stagionalità dalla storia della serie, ma usa anche informazioni esterne che spiegano ciò che i valori passati non possono.
Se ti serve un'introduzione alla manipolazione, interpretazione e visualizzazione dei dati di serie storiche in Python, iscriviti al nostro percorso Time Series in Python per fissare le basi in una settimana.
Cos'è SARIMAX?
SARIMAX è un modello ARIMA stagionale che può anche usare predittori esterni. In particolare, il nome sta per Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors.
SARIMAX funziona prevedendo una serie target da quattro fonti di informazione:
- Valori passati: la domanda negli ultimi mesi
- Errori di previsione passati: quanto il modello ha sbagliato negli ultimi mesi
- Pattern stagionali: la domanda nello stesso mese degli anni precedenti
- Variabili esogene: dati esterni che aggiungi al modello, come la temperatura media mensile
Supponiamo che l'obiettivo sia prevedere la domanda di elettricità per il prossimo luglio. SARIMAX guarda alla domanda negli ultimi paio di mesi, alla domanda nei precedenti mesi di luglio e alla temperatura attesa per luglio. Le prime due sono dentro la serie e la temperatura viene dall'esterno.
Scrivi il modello come SARIMAX(p, d, q)(P, D, Q, S). Il primo gruppo di parametri copre il comportamento di breve periodo, e il secondo la componente stagionale, dove S è il numero di step temporali in un ciclo. Per dati mensili con un pattern annuale, S è 12.
Le variabili esogene non sono incluse in questa notazione. Le passi al modello separatamente, come input a sé stante.
Come funziona SARIMAX
SARIMAX ha due gruppi di termini, e le variabili esogene si aggiungono sopra di essi.
I termini non stagionali (p, d, q) modellano il comportamento di breve periodo:
-
Ordine autoregressivo
p: quante osservazioni passate usa il modello. Conp = 2, la domanda di questo mese dipende dalla domanda dei due mesi precedenti -
Ordine di differenziazione
d: quante volte il modello differenzia la serie per rimuovere un trend. Cond = 1, il modello lavora con variazioni mese su mese invece che con la domanda grezza -
Ordine della media mobile
q: quanti errori di previsione passati usa il modello. Se il mese scorso il modello ha sottostimato la domanda, quell'errore entra nella previsione di questo mese
I termini stagionali (P, D, Q, S) fanno la stessa cosa, ma a ritardi stagionali:
-
Ordine autoregressivo stagionale
P: quante stagioni passate considera il modello. ConP = 1e dati mensili, la domanda di questo luglio dipende dalla domanda dello scorso luglio -
Ordine di differenziazione stagionale
D: quante volte il modello differenzia la serie al ritardo stagionale. ConD = 1, il modello confronta questo luglio con lo scorso luglio, rimuovendo il pattern annuale ripetuto -
Ordine della media mobile stagionale
Q: quanti errori di previsione passati a ritardi stagionali usa il modello, come l'errore dello scorso luglio -
Periodo stagionale
S: quanti step temporali ha un ciclo. È 12 per dati mensili con pattern annuale e 7 per dati giornalieri con pattern settimanale
Le variabili esogene aggiungono informazioni che la serie non ha.
Nell'esempio della domanda di elettricità, è la temperatura. Un'estate calda o un inverno freddo aumentano la domanda, e i valori passati non possono dire al modello come sarà il meteo del mese prossimo. Il pattern del mese dell'anno deriva già dai termini stagionali, quindi la temperatura è l'unica variabile esterna necessaria nell'esempio.
In statsmodels, SARIMAX è una regressione lineare sulle variabili esogene, dove gli errori seguono un processo ARIMA stagionale. Con una variabile esogena, appare così:
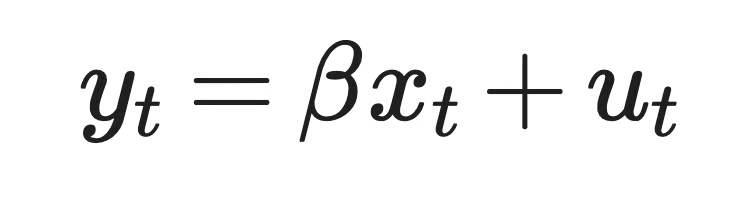
SARIMAX con una variabile esogena
Qui, y_t è la domanda di elettricità nel mese t, x_t è la temperatura in quel mese, beta è il coefficiente della temperatura e u_t è la parte della domanda che la temperatura non spiega. I termini non stagionali e stagionali modellano u_t.
In parole semplici, la temperatura spiega una parte della domanda, e i termini SARIMA modellano tutto il resto.
Ecco una panoramica più visiva:
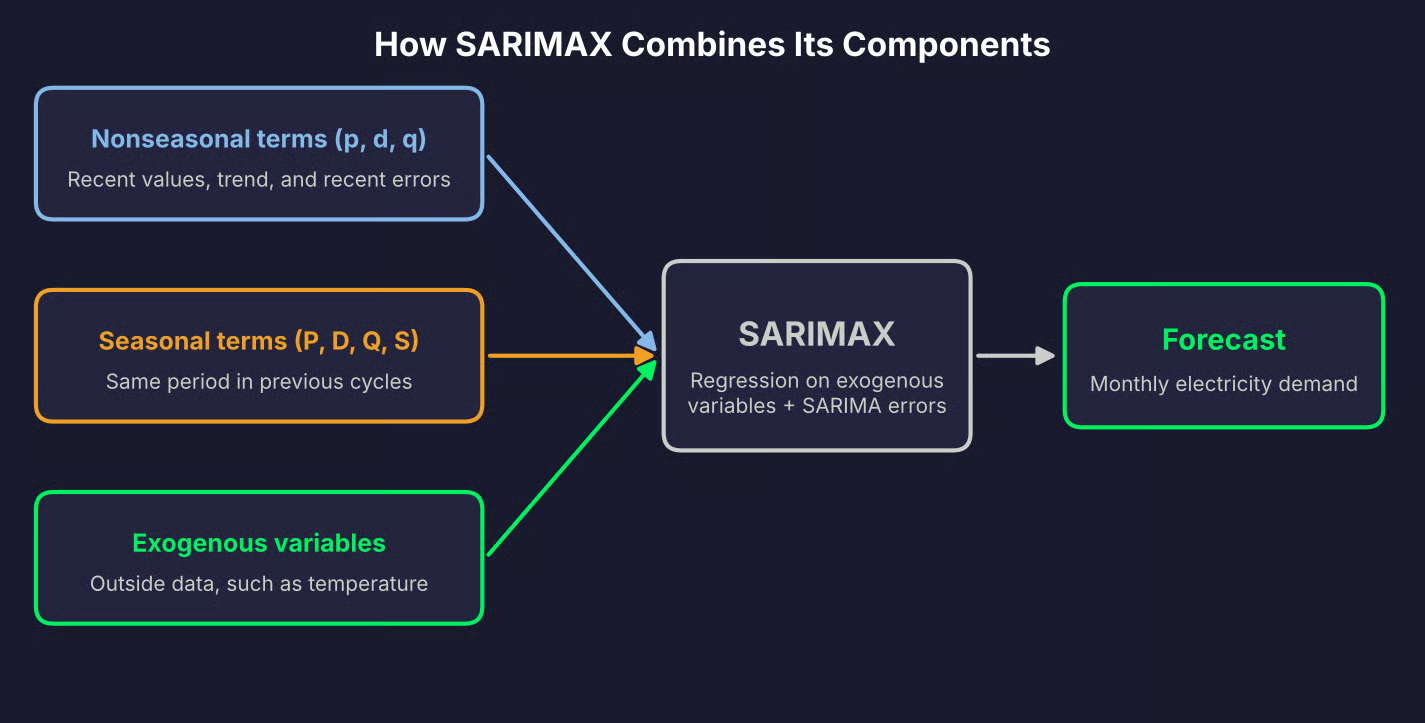
Componenti di SARIMAX
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
Questi quattro modelli appartengono alla stessa famiglia. Le differenze sono sottili, ma le capirai dopo una lettura.
ARIMA modella una serie dai propri valori passati e dagli errori di previsione passati. SARIMA aggiunge termini stagionali sopra a questo, così può modellare pattern che si ripetono ogni S step temporali. ARIMAX aggiunge variabili esogene ad ARIMA, ma di default non ha termini stagionali. SARIMAX ha entrambi.
Ecco perché SARIMAX può rappresentare gli altri modelli come casi particolari. Se non passi variabili esogene, ottieni un modello SARIMA. Se imposti tutti gli ordini stagionali a zero, ottieni un ARIMAX non stagionale. E senza entrambi, è un modello ARIMA.
Purtroppo, la terminologia non è coerente tra i vari pacchetti.
L'ARIMAX da manuale inserisce le variabili esogene direttamente nell'equazione ARIMA, accanto ai valori passati della serie. SARIMAX di statsmodels invece adatta una regressione con errori SARIMA, come mostrato nella sezione precedente. Le due forme stimano coefficienti diversi, quindi la stessa variabile temperatura può ottenere un coefficiente diverso a seconda del pacchetto.
Anche i nomi di classi e funzioni non coincidono. La classe ARIMA in statsmodels accetta anche termini stagionali e variabili esogene. In R, il pacchetto forecast gestisce i regressori esterni tramite l'argomento xreg di Arima() e auto.arima(). Perciò ricordati di controllare come ogni pacchetto definisce il modello prima di confrontare i risultati tra strumenti.
Ecco un rapido riepilogo:
| Stagionalità? | Variabili esterne? | |
|---|---|---|
| ARIMA | No | No |
| SARIMA | Sì | No |
| ARIMAX | Non di default | Sì |
| SARIMAX | Sì | Sì |
Confronto della famiglia di modelli ARIMA
Quando usare SARIMAX
SARIMAX ha senso quando il target ha un pattern stagionale ricorrente e variabili esterne possono migliorare la previsione.
Per esempio:
- Domanda di elettricità: temperatura ed effetti di calendario come le festività, oltre al ciclo annuale
- Vendite retail: promozioni, prezzi e periodi festivi
- Prenotazioni alberghiere: eventi locali e prezzi delle camere, oltre alla stagione turistica annuale
- Passeggeri nel trasporto pubblico: meteo e vacanze scolastiche, oltre a un pattern settimanale nei dati giornalieri
Ma SARIMAX non è sempre la scelta giusta. Un modello più semplice può fare lo stesso lavoro in due casi:
- Nessuna stagionalità significativa: se la serie non ripete un pattern, i termini stagionali aggiungono solo parametri da stimare. ARIMA o ARIMAX bastano
- I predittori non migliorano l'accuratezza: se le variabili esogene non riducono l'errore su un periodo di test separato, rimuovile e usa SARIMA. Un miglior adattamento sui dati di training non conta
La cosa da ricordare è che SARIMAX richiede valori per ogni variabile esogena nel periodo di previsione.
Alcuni valori sono noti in anticipo, ad esempio le festività o le promozioni pianificate. Altri, come la temperatura, devono essere previsti separatamente prima che SARIMAX possa usarli. Se non puoi ottenere valori futuri per un predittore, non puoi usarlo nella previsione.
Come costruire un modello SARIMAX in Python
In questa sezione costruirò un modello SARIMAX con statsmodels, dai dati grezzi a una previsione a 12 mesi.
L'esempio usa una domanda mensile sintetica di elettricità con la temperatura come variabile esterna. È piccolo e riproducibile, e segue lo stesso filo del resto dell'articolo.
Prepara i dati
Il dataset copre dieci anni di dati mensili, da gennaio 2015 a dicembre 2024.
La domanda ha un trend crescente, un pattern di calendario annuale che cambia lentamente nel tempo, un effetto meteo e rumore. Due rilevazioni di temperatura mancano di proposito, così puoi vedere come gestire i buchi:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())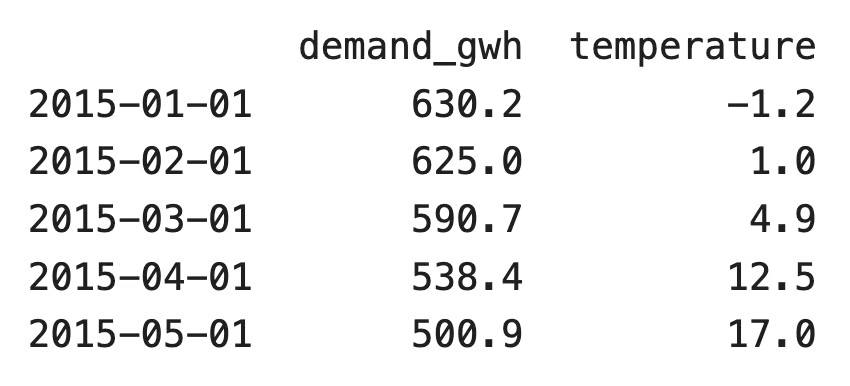
Le prime cinque righe del dataset
Oppure, se preferisci una panoramica visiva:
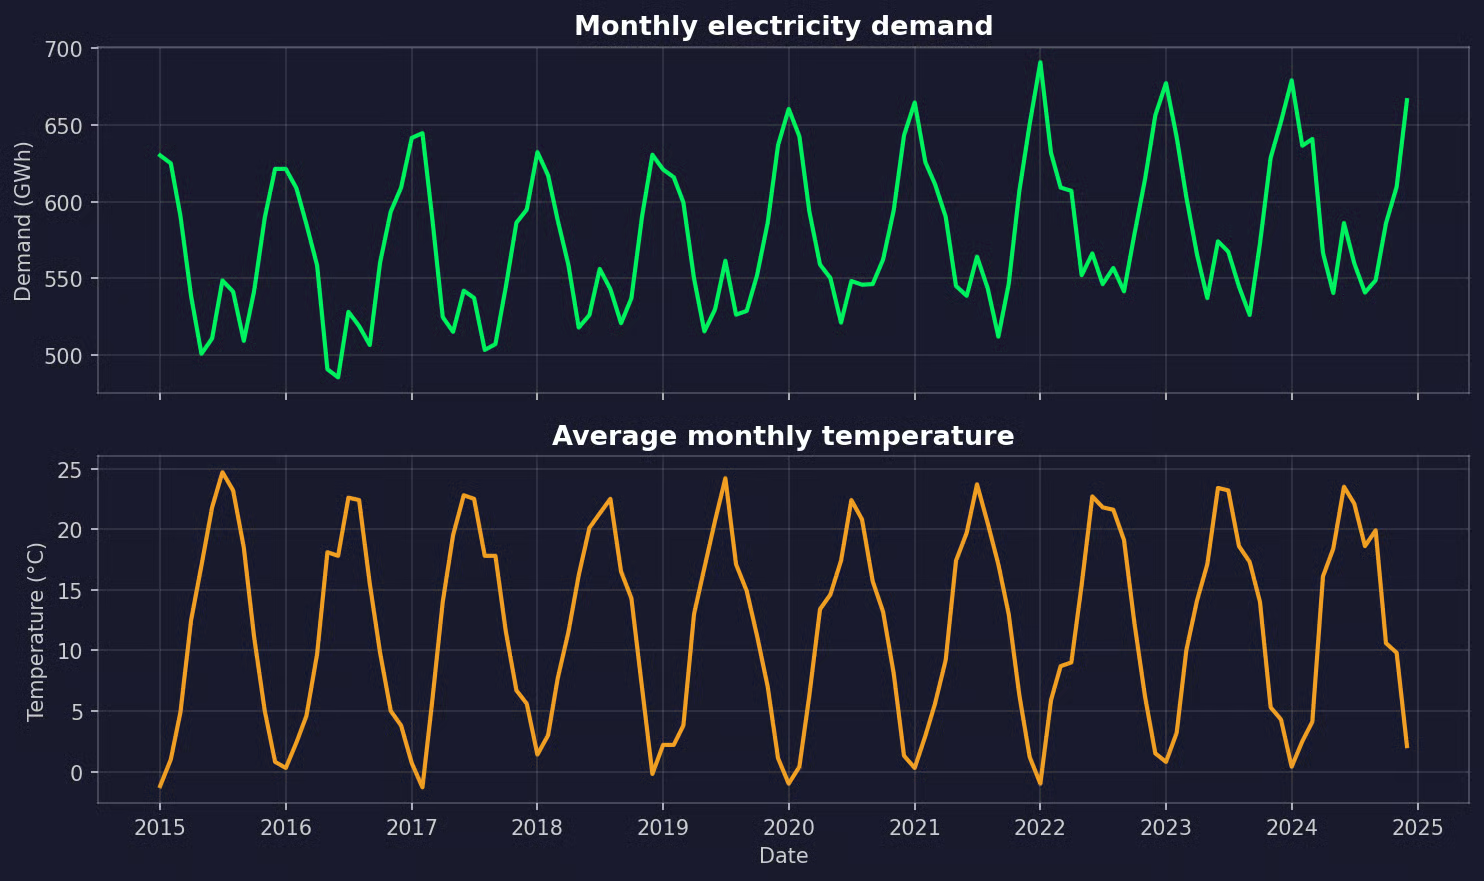
Il dataset della temperatura
Se lavori con i tuoi dati, caricali con pd.read_csv() e imposta la colonna delle date come indice. Il resto del flusso di lavoro resta uguale.
SARIMAX ha bisogno di un indice temporale con frequenza coerente. Il metodo .asfreq() la imposta a mensile e inserisce una riga vuota per ogni mese mancante. Poi puoi contare i buchi e riempirli:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()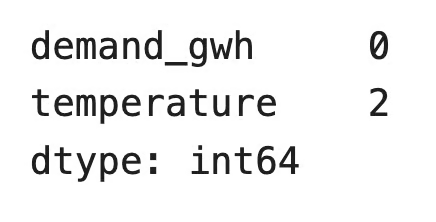
Interpolazione dei buchi nella temperatura
L'interpolazione lineare funziona qui perché la temperatura cambia in modo graduale da un mese all'altro. Non fare lo stesso per il target se ne mancano porzioni ampie. Insegneresti al modello su valori inventati.
Passiamo alle variabili esogene. La domanda sale quando fa freddo e quando fa caldo, ma una regressione lineare su temperatura grezza non può modellare una forma a U. Quindi dividerò la temperatura in due feature:
- Gradi di riscaldamento (heating degrees): di quanti gradi la temperatura media è sotto i 18 °C, e zero altrimenti
- Gradi di raffrescamento (cooling degrees): di quanti gradi la temperatura media è sopra i 18 °C, e zero altrimenti
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
Ora dividi i dati tra target y e variabili esogene X. La suddivisione dev'essere cronologica: il modello si allena sul passato e viene testato sul futuro. Una suddivisione casuale farebbe filtrare informazioni future nel training:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")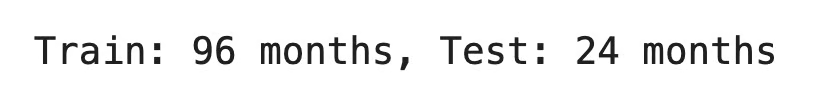
Suddivisione train/test
La cosa da ricordare è che X_test ha temperature effettivamente osservate. In una previsione reale, non le conosceresti in anticipo: al massimo avresti una previsione meteo. Questo significa che lo score di test che vedrai più avanti è ottimistico. Usa valori osservati dei predittori per la valutazione solo se gli stessi valori sarebbero disponibili al momento della previsione, come festività o prezzi pianificati.
Esplora stagionalità e stazionarietà
Inizia con un grafico. Cerca trend, cicli stagionali e cambiamenti improvvisi:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()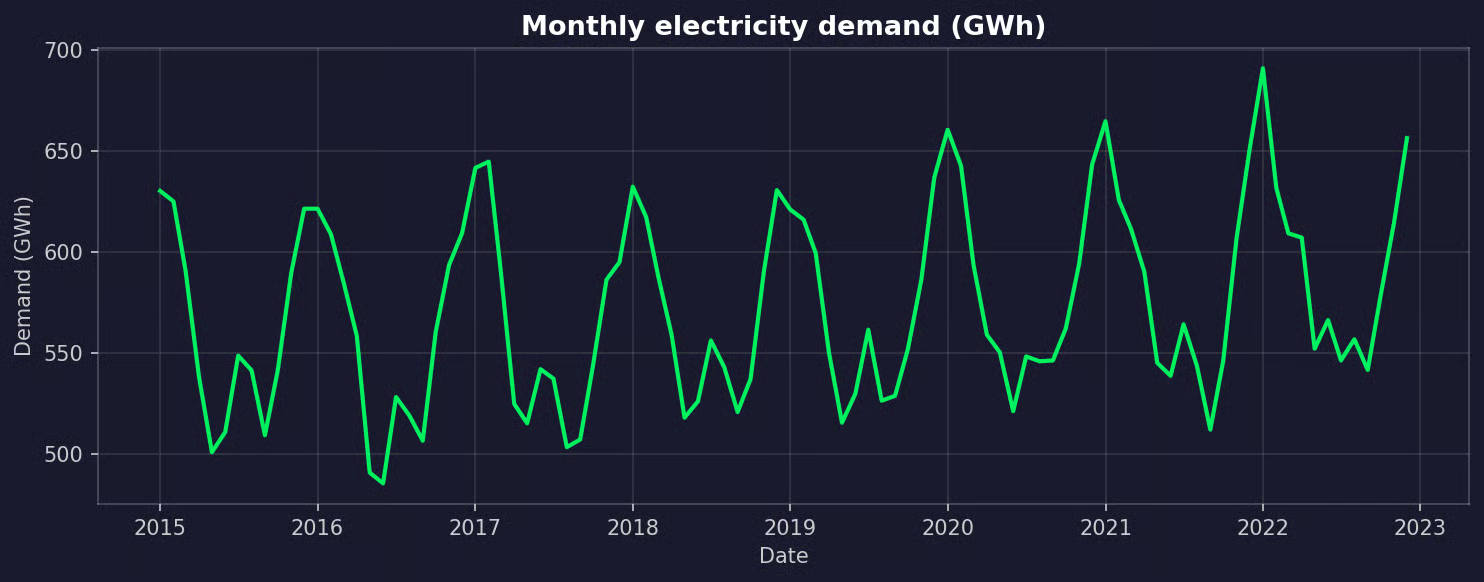
Domanda mensile di elettricità nel periodo di training
La domanda cresce nel tempo e raggiunge il picco ogni inverno, con un picco più piccolo ogni estate. Il pattern si ripete ogni 12 mesi.
Una decomposizione stagionale dividerà la serie in componenti di trend, stagionale e residuo, così puoi confermare il periodo stagionale S:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()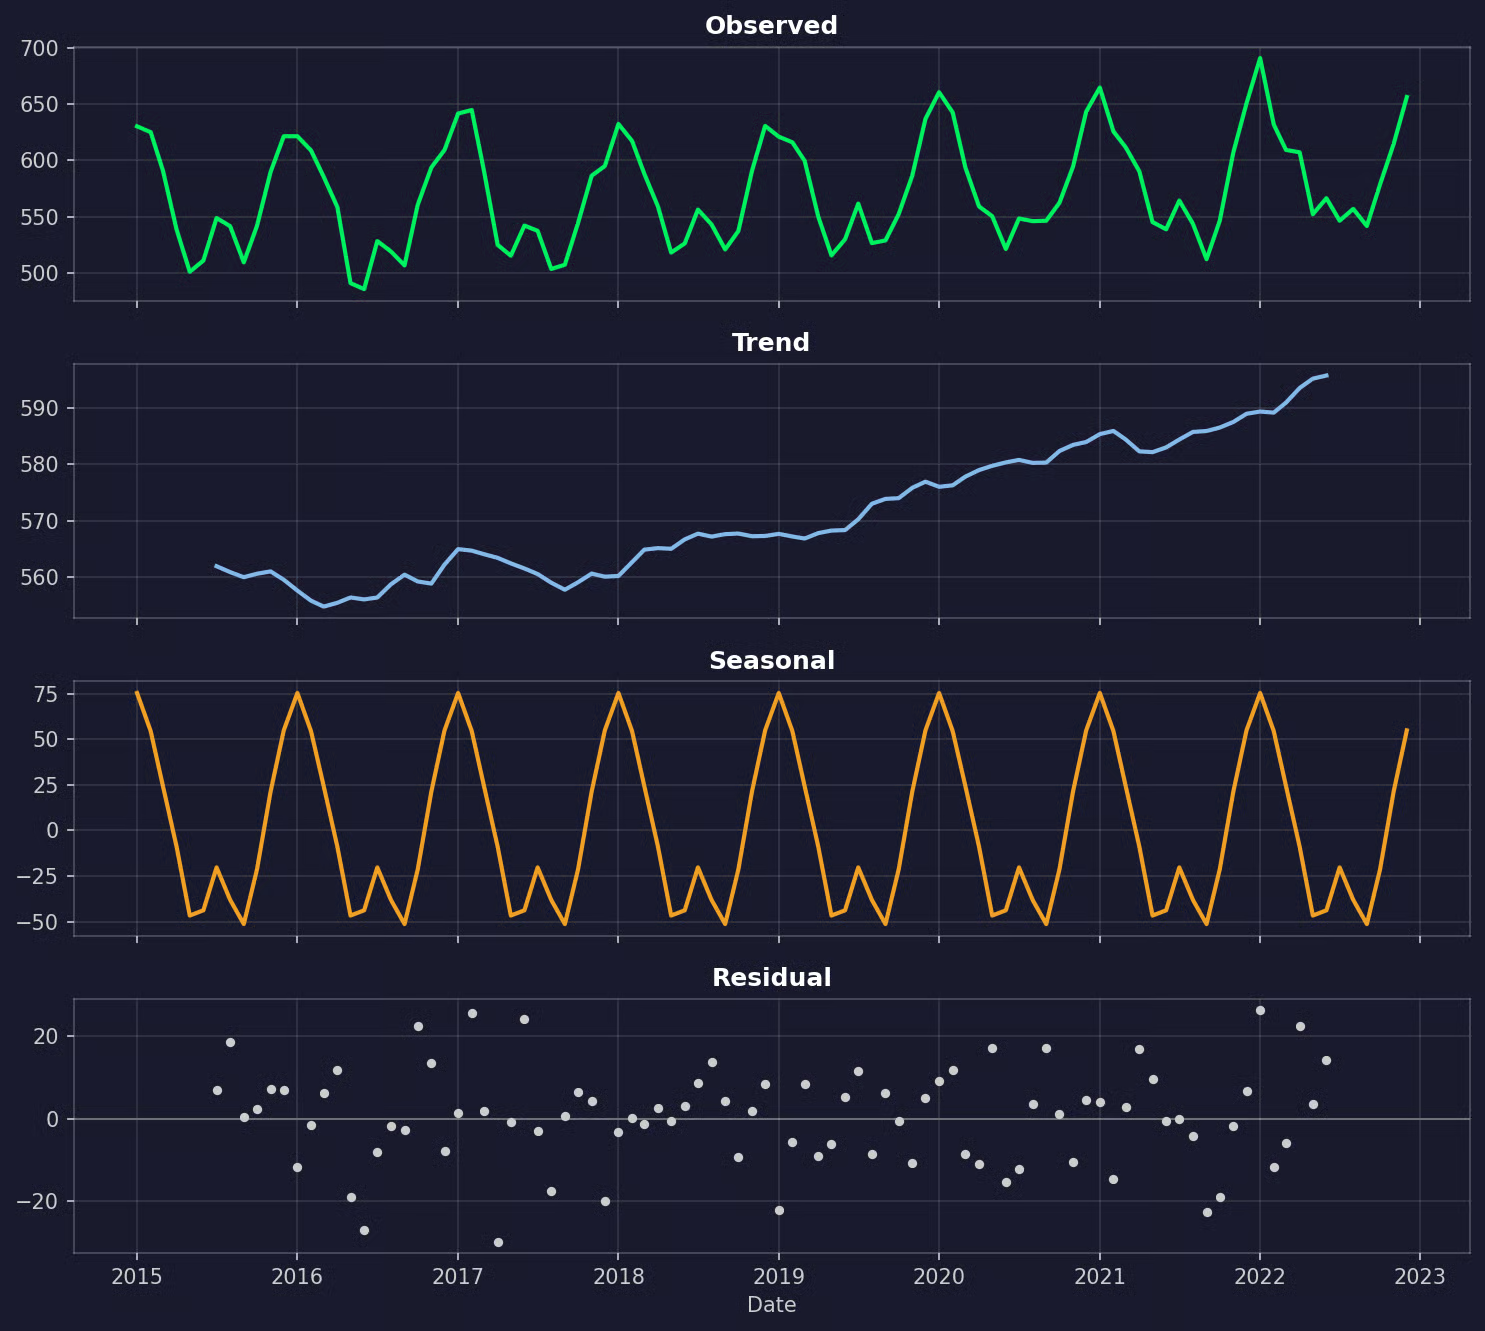
Decomposizione stagionale della domanda di elettricità
La componente stagionale si ripete ogni anno, quindi S = 12.
I modelli della famiglia ARIMA richiedono una serie stazionaria, cioè con media e varianza che non cambiano nel tempo. La domanda non è stazionaria perché ha un trend e un ciclo stagionale.
La differenziazione è un modo per aggirare il problema:
-
Differenziazione regolare (
d): sottrae il valore del mese scorso da quello di questo mese. Rimuove un trend -
Differenziazione stagionale (
D): sottrae il valore dello stesso mese dell'anno scorso. Rimuove un pattern stagionale ripetuto e rimuove anche un trend lineare
Il test di Dickey-Fuller aumentato (ADF) verifica la stazionarietà. La sua ipotesi nulla è che la serie non sia stazionaria, quindi un p-value piccolo (sotto 0,05) è evidenza che lo sia:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")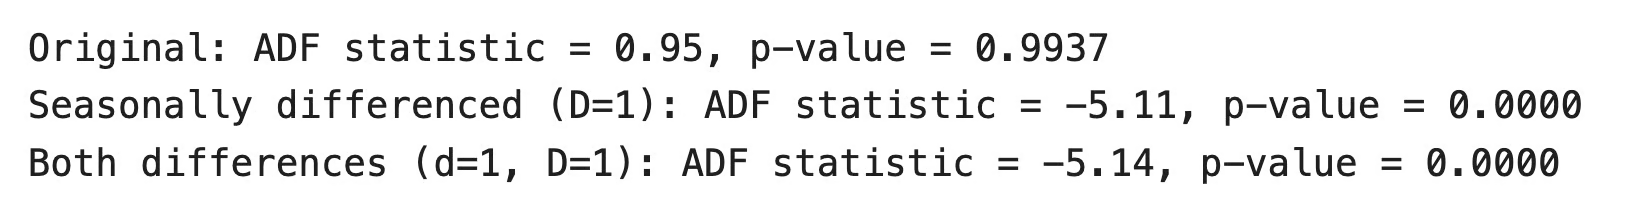
Risultato del test ADF
La serie originale non è stazionaria. La sola differenziazione stagionale la sistema, quindi la differenziazione regolare in più non aggiunge nulla. Usa la quantità minima di differenziazione che funziona: differenze extra aggiungono rumore alla serie e rendono il modello più difficile da adattare.
Quindi la scelta è d = 0 e D = 1.
Ma tratta il test ADF solo come un supporto. Non ti dice nulla su p, q, P o Q, e con serie brevi può dare risposte diverse a seconda delle impostazioni.
Seleziona i parametri candidati
I grafici ACF e PACF aiutano a scegliere i valori candidati per gli ordini rimanenti:
-
ACF (funzione di autocorrelazione): mostra la correlazione tra la serie e i propri valori ritardati. Picchi nell'ACF indicano termini di media mobile,
qa ritardi brevi eQa ritardi stagionali -
PACF (funzione di autocorrelazione parziale): mostra la stessa correlazione, ma rimuove l'effetto dei ritardi intermedi. Picchi nel PACF indicano termini autoregressivi,
pa ritardi brevi ePa ritardi stagionali
Dovresti tracciare entrambi per la serie differenziata stagionalmente, perché è quella con cui lavora il modello:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()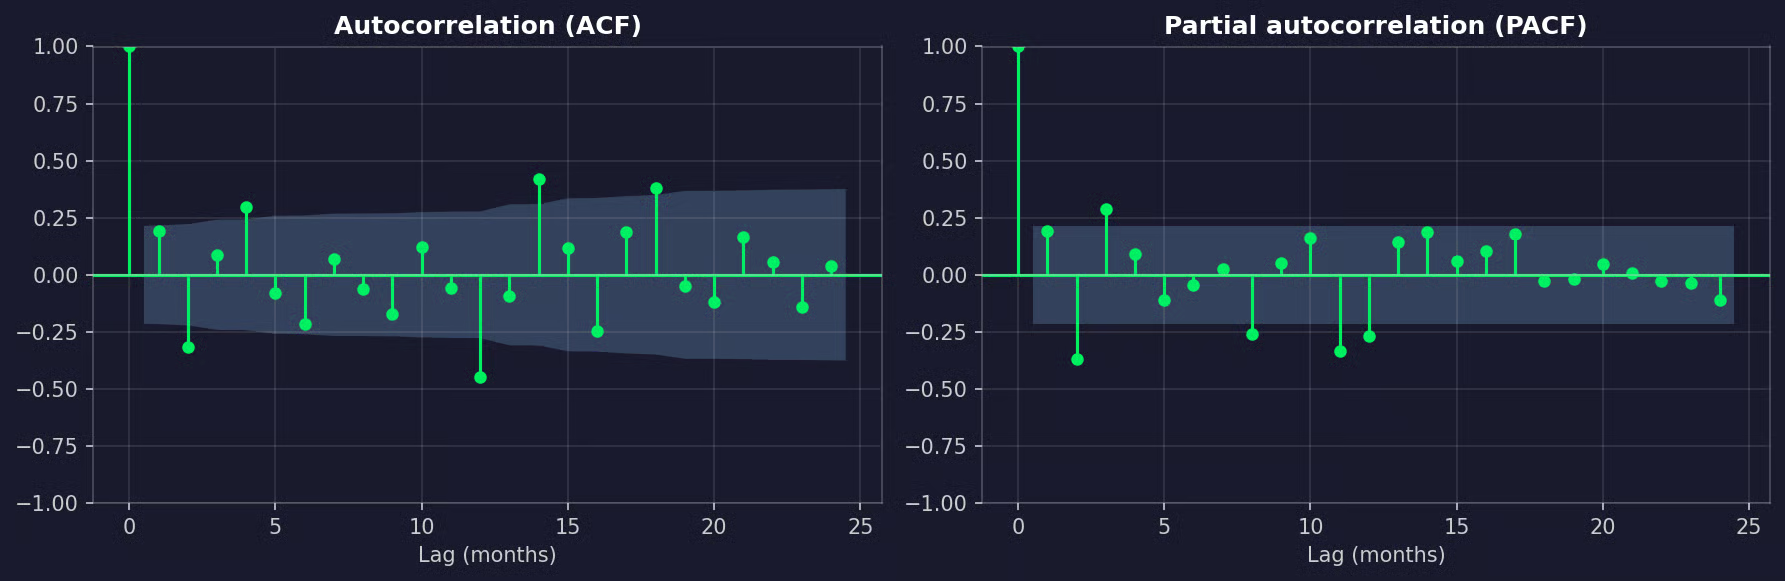
Grafici ACF e PACF della domanda di elettricità differenziata stagionalmente
L'ACF ha un chiaro picco negativo al ritardo 12 e nulla al 24. È il segno tipico di un termine di media mobile stagionale, quindi Q = 1 è un buon candidato. Entrambi i grafici mostrano anche un paio di picchi a ritardi brevi, quindi vale la pena testare p e q.
Il passo successivo è adattare un piccolo set di modelli candidati e confrontarli con AIC o BIC. Entrambi valutano quanto bene un modello si adatta ai dati di training e penalizzano i parametri extra. Più basso è meglio, e il BIC penalizza la complessità più dell'AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))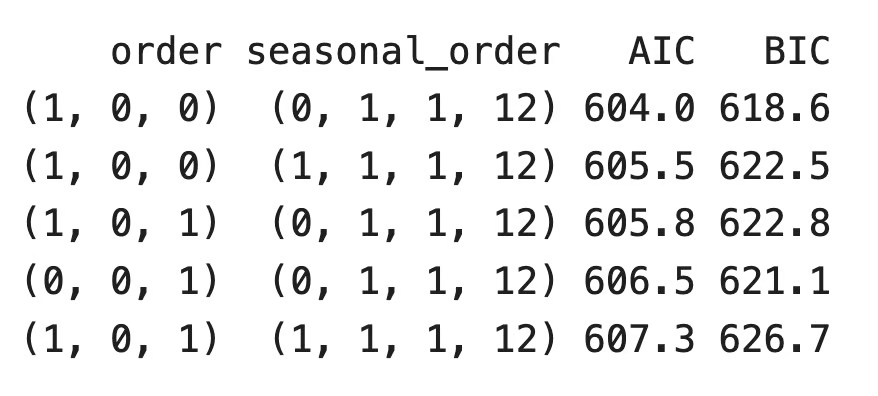
Risultati AIC e BIC
SARIMAX(1, 0, 0)(0, 1, 1, 12) vince sia per AIC che per BIC. È anche uno dei modelli più semplici della lista.
L'argomento trend="c" aggiunge una costante. Con differenziazione stagionale, una costante modella l'aumento anno su anno della domanda.
Troverai strumenti come auto_arima() della libreria pmdarima che eseguono questa ricerca per te. Sono utili per una prima passata, ma AIC e BIC misurano solo l'adattamento ai dati di training. Prima di fidarti di un modello, testalo su dati che non ha visto.
Adatta il modello
Passa il target come primo argomento e le variabili esogene tramite exog. L'argomento order accetta (p, d, q) e seasonal_order accetta (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())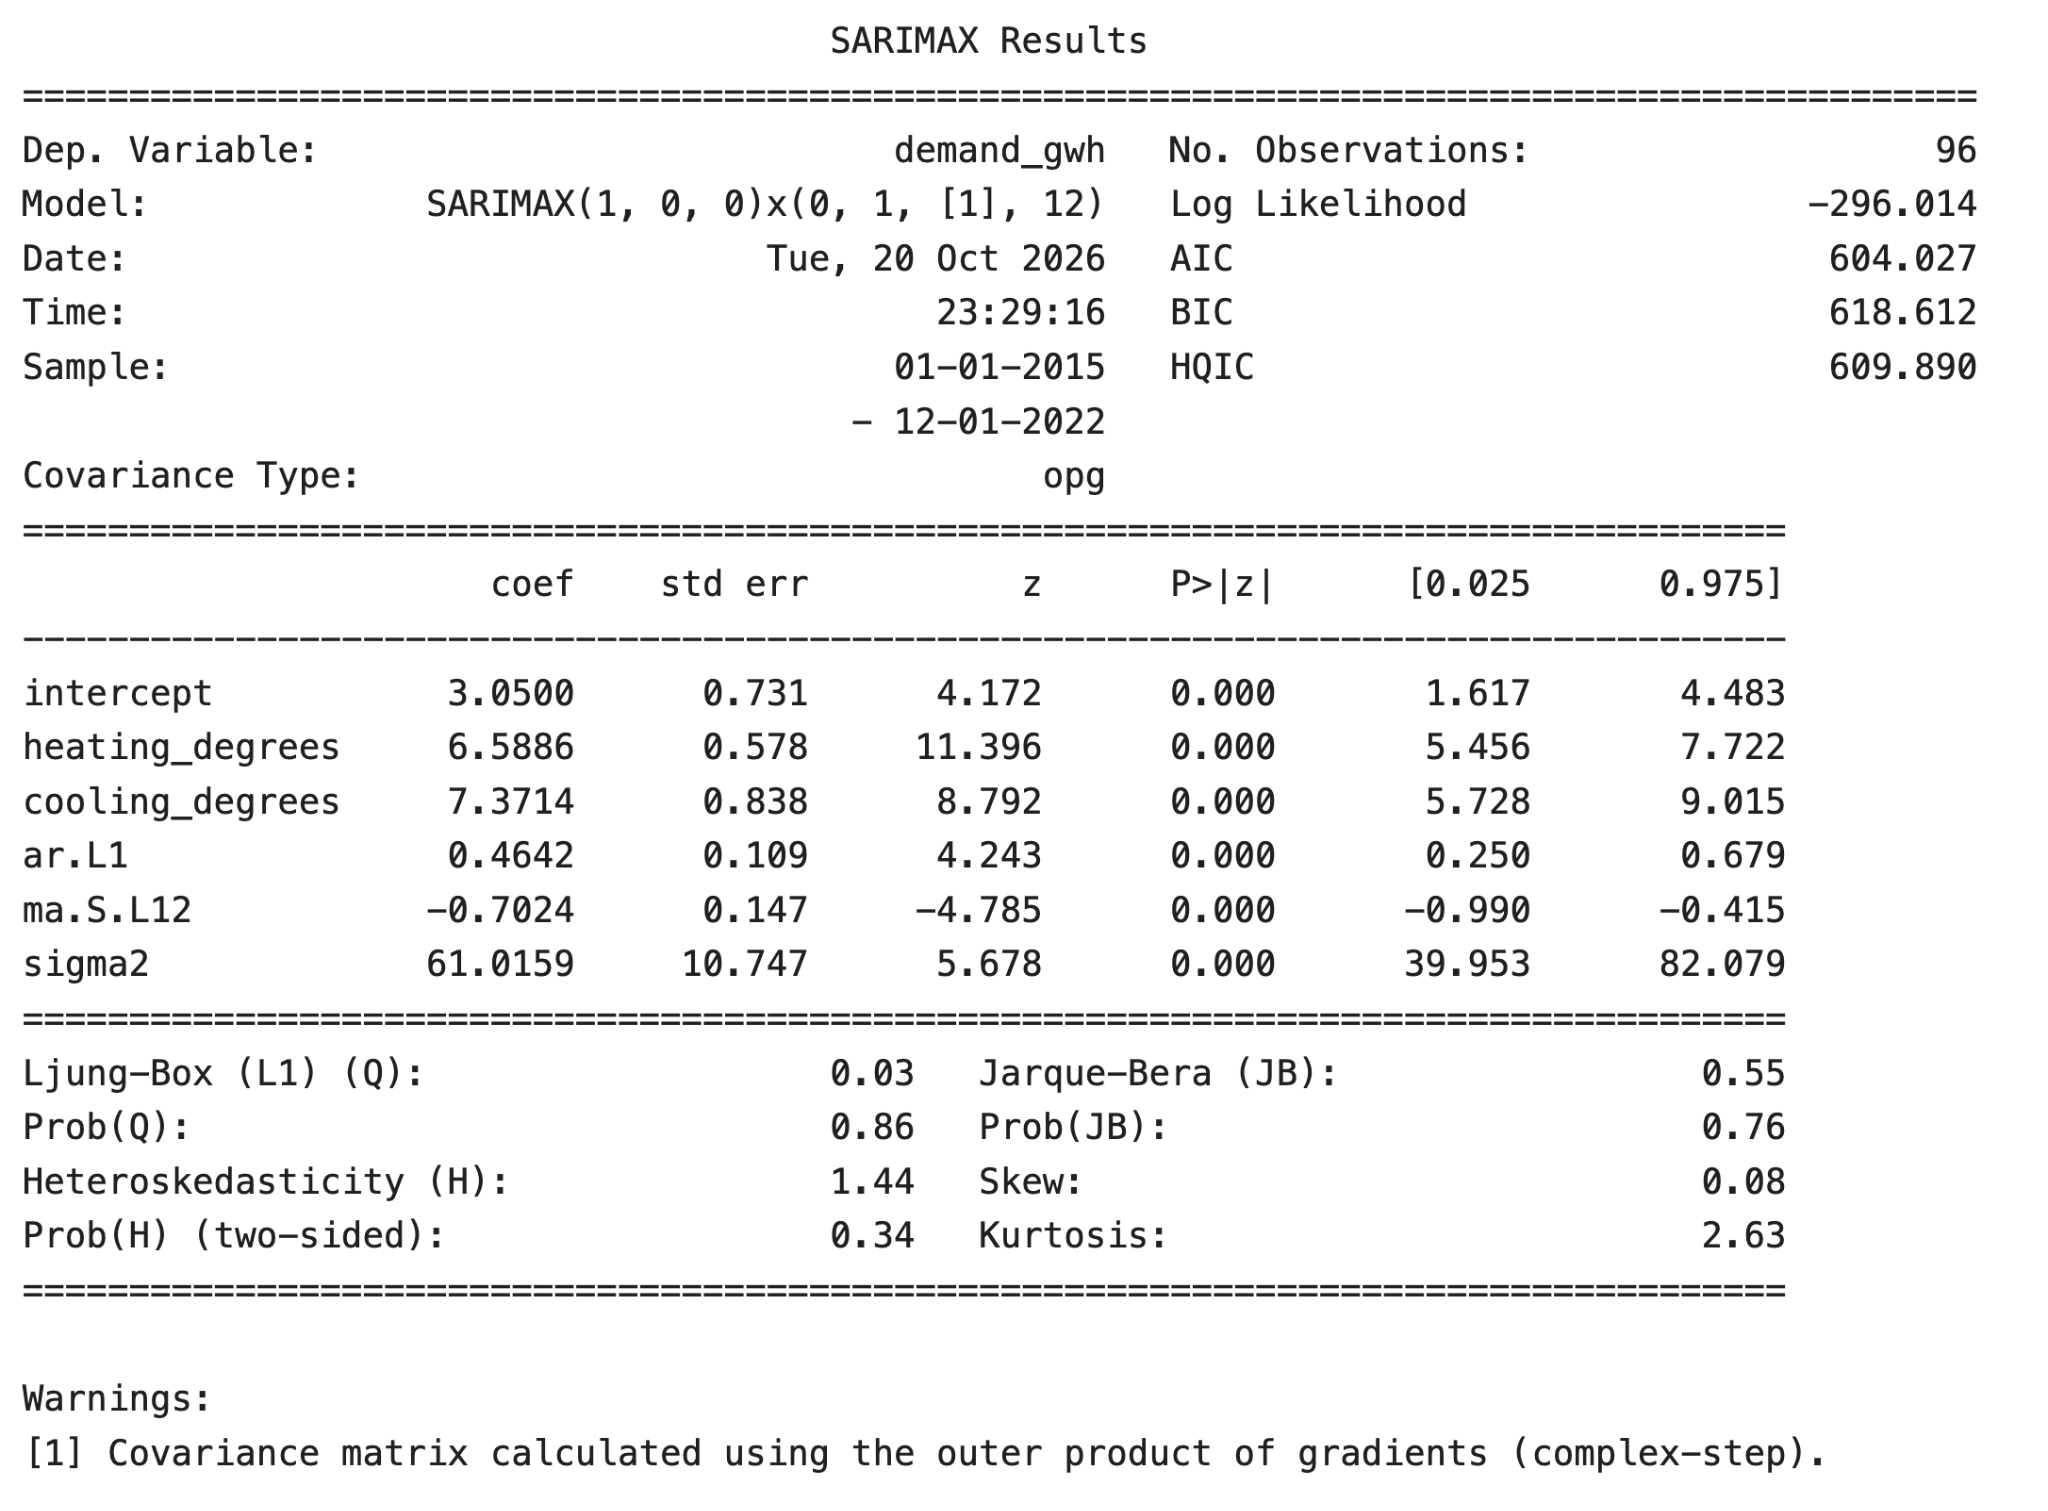
Riepilogo del modello SARIMAX
Ecco come leggere la tabella dei coefficienti:
-
heating_degrees: ogni grado di riscaldamento in più si accompagna a circa 6,6 GWh di domanda extra, a parità del resto del modello -
cooling_degrees: ogni grado di raffrescamento in più si accompagna a circa 7,4 GWh di domanda extra -
ar.L1: circa il 46% della differenza inspiegata del mese scorso si trasferisce in questo mese -
ma.S.L12: il termine di media mobile stagionale, che corregge la previsione in base all'errore dello stesso mese dell'anno scorso -
sigma2: la varianza del rumore rimanente
Tutti i coefficienti hanno p-value vicini a zero, quindi ogni termine aggiunge qualcosa al modello.
Ma questi coefficienti descrivono relazioni all'interno del modello adattato, non cause. Qui ho generato i dati con la temperatura come causa della domanda, quindi la lettura è sicura. Nei dati reali, un predittore può sembrare importante perché si muove insieme a qualcosa che il modello non vede.
Diagnostica e valuta il modello
Un buon modello lascia residui che sembrano rumore casuale. Se i residui hanno ancora un pattern, il modello ha mancato qualcosa.
Il metodo .plot_diagnostics() ti dà quattro grafici con una chiamata:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()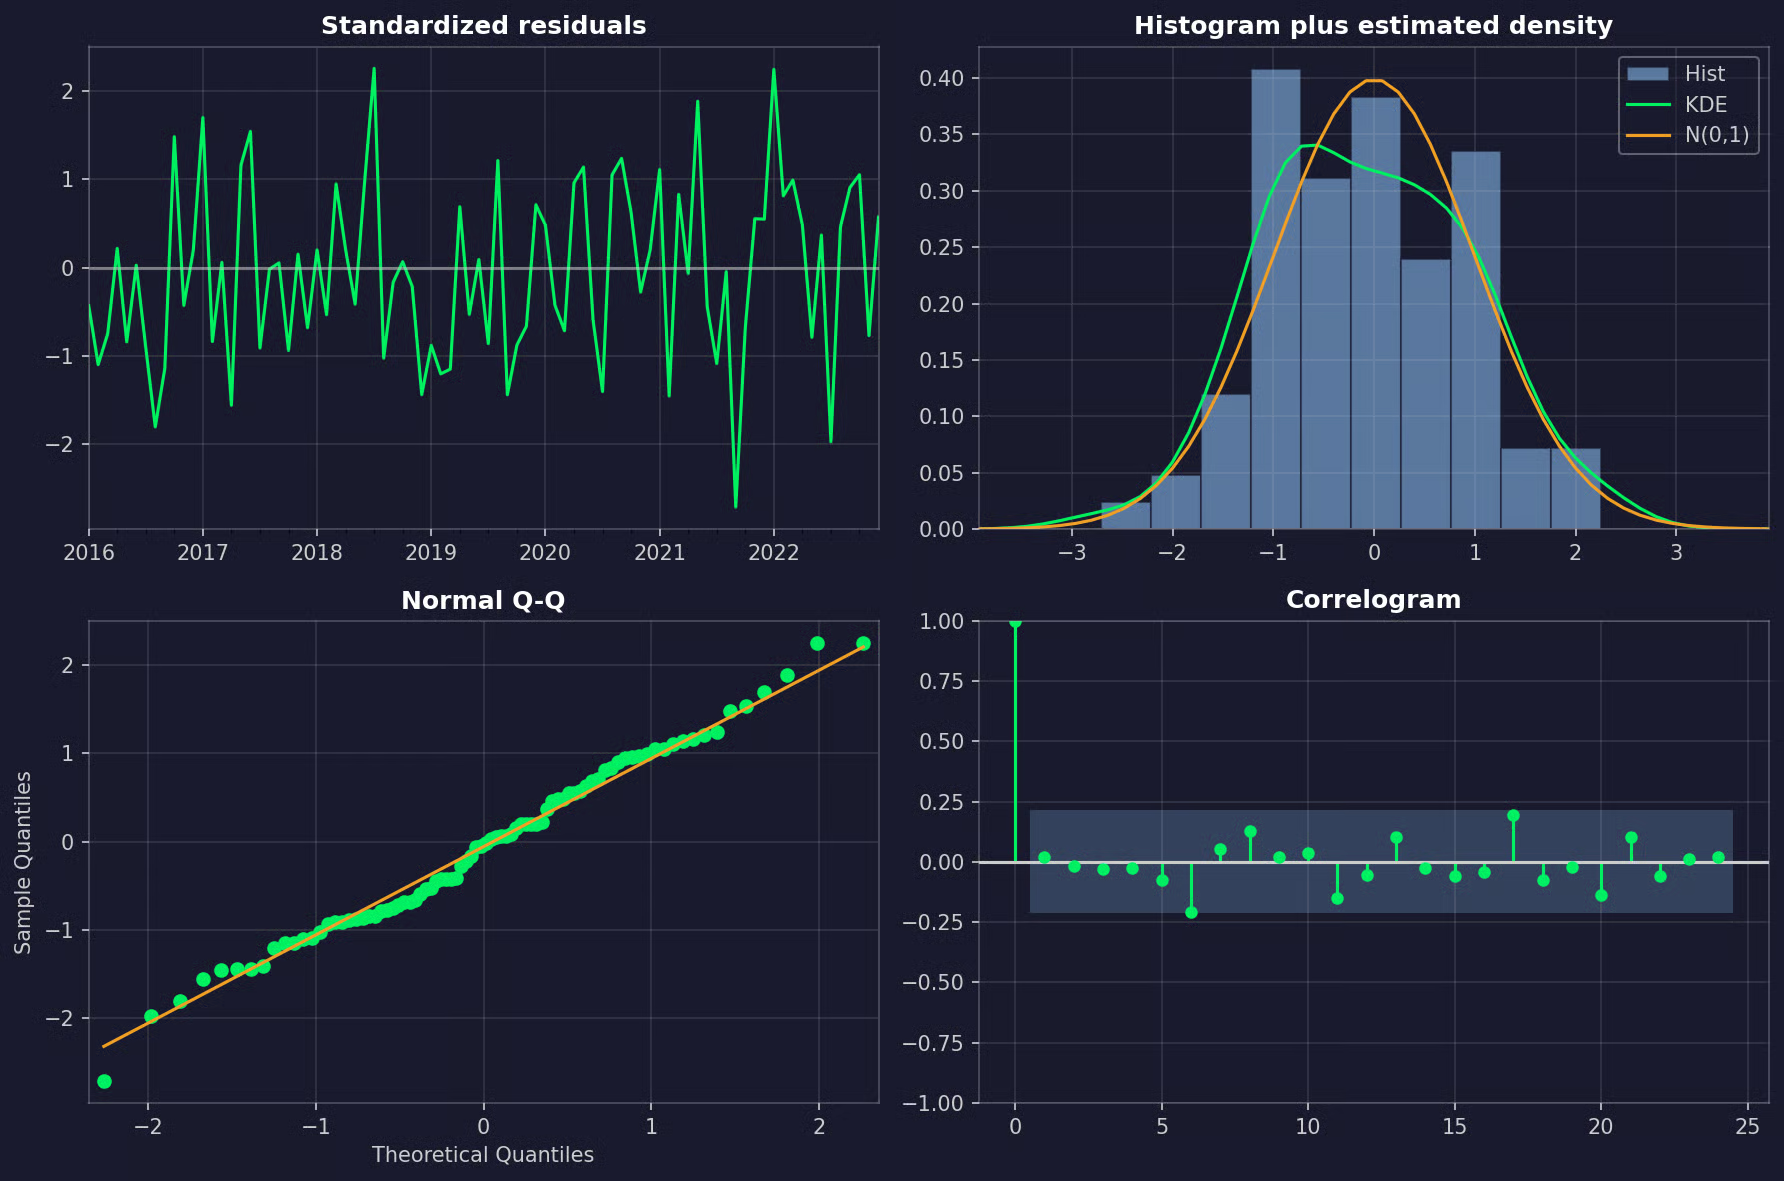
Grafico di diagnostica dei residui
Ecco cosa cercare:
- Residui standardizzati: nessun trend, nessun pattern ripetuto e nessun tratto in cui la dispersione diventa molto più ampia
- Istogramma e grafico Q-Q: punti vicini a una distribuzione normale
- Correlogramma: nessun picco fuori dalla banda di confidenza, soprattutto al ritardo 12: un picco lì significa che il modello non ha gestito completamente la stagionalità
Il test di Ljung-Box ti dà lo stesso controllo come numero. La sua ipotesi nulla è che i residui non abbiano autocorrelazione fino a un certo ritardo, quindi vuoi p-value elevati:
# Skip the first 13 residuals, which come from the differencing start-up period
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))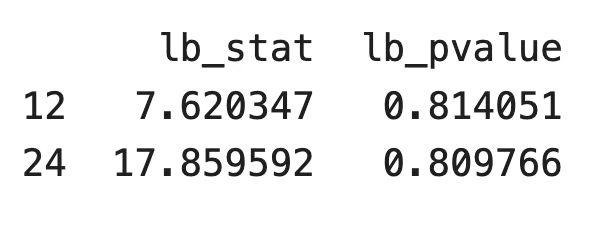
Risultati del test di Ljung-Box
Entrambi i p-value sono ben sopra 0,05, quindi i residui sembrano rumore.
Ora la parte che conta di più: l'accuratezza su dati che il modello non ha visto. Il metodo .get_forecast() predice i 24 mesi di test e ha bisogno dei valori esogeni per quei mesi.
Un numero di previsione conta poco da solo, quindi confronterò SARIMAX con due baseline:
- Previsione stagionale ingenua: ripete i valori degli ultimi 12 mesi di training
- SARIMA: lo stesso modello, ma senza le variabili esogene
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: repeat the last 12 observed months
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: the same model without exogenous variables
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()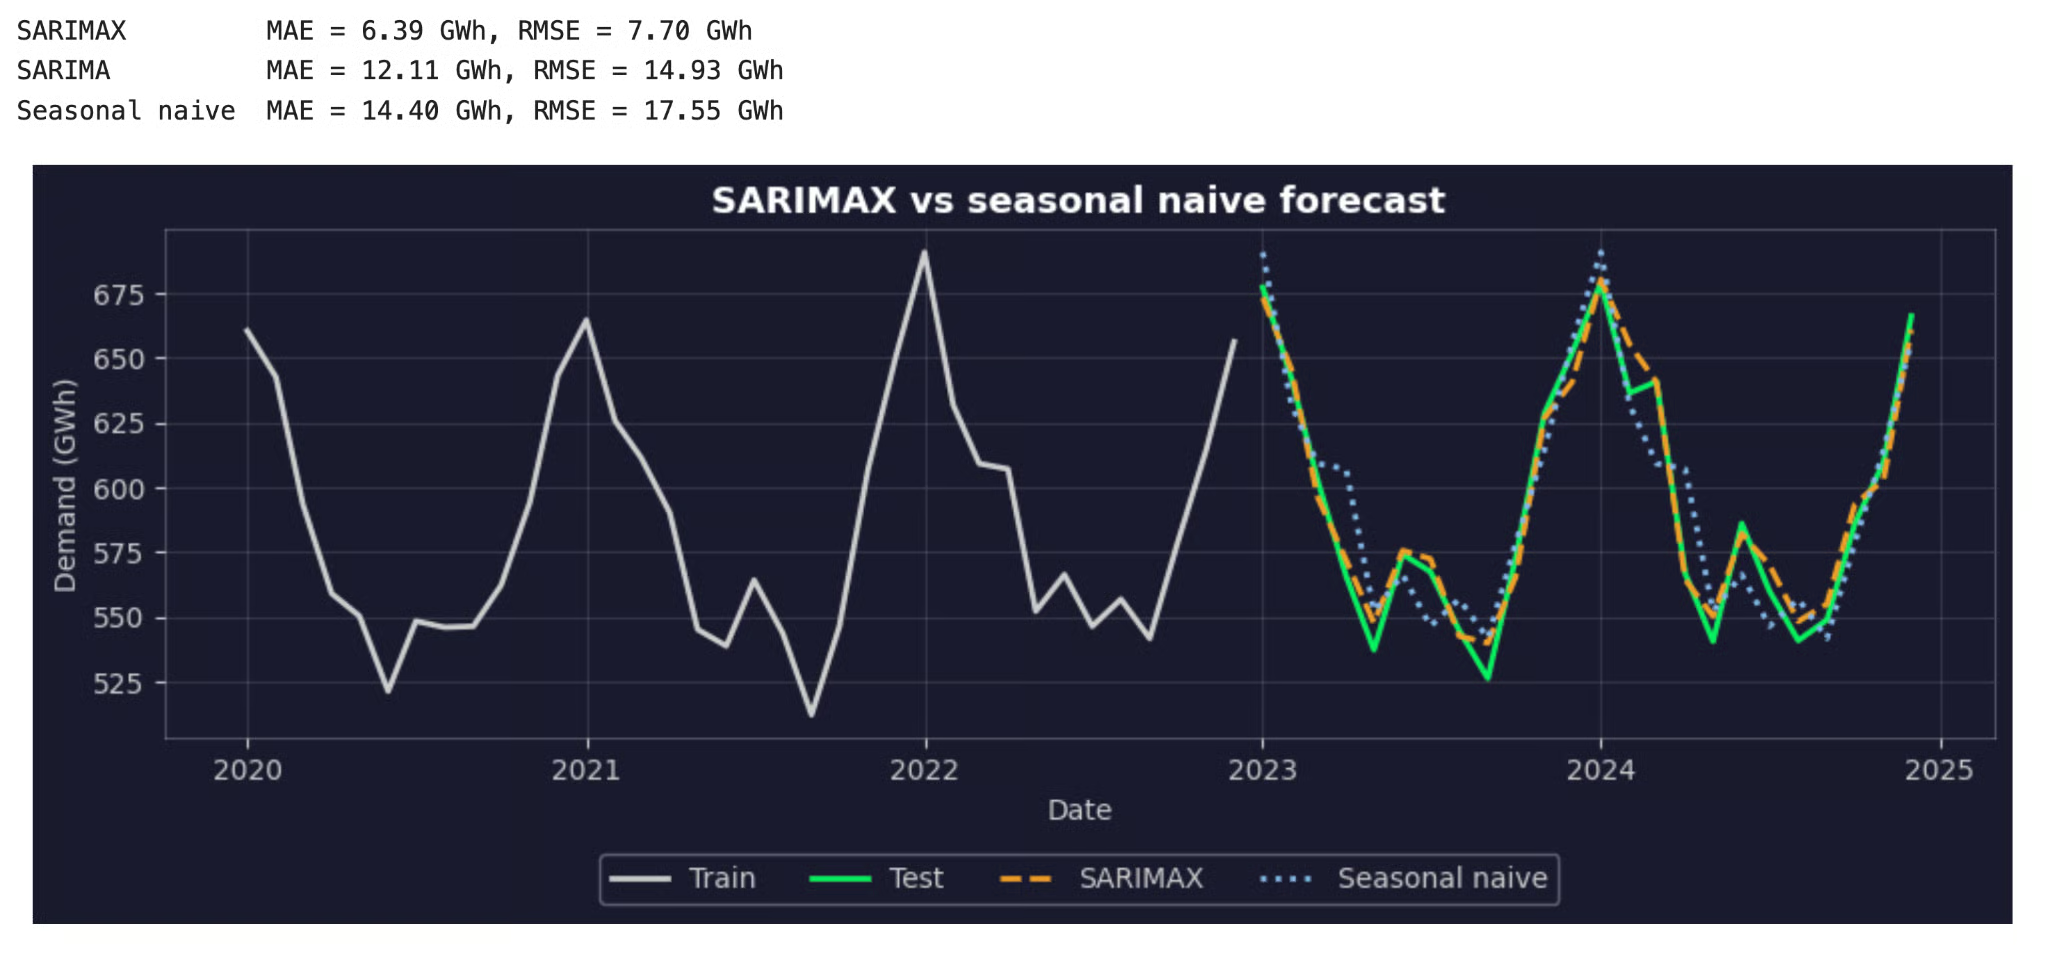
Previsioni SARIMAX e stagionali ingenue rispetto alla domanda reale nel set di test
MAE (mean absolute error) è la dimensione media dell'errore in GWh. RMSE (root mean squared error) penalizza maggiormente gli errori grandi.
SARIMAX ha circa metà dell'errore di SARIMA su entrambe le metriche. I soli termini stagionali non possono prevedere un gennaio insolitamente freddo o un luglio caldo, e le feature di temperatura sì.
Ricorda, questo risultato usa temperature del periodo di test osservate. Con previsioni meteo al loro posto, il divario sarebbe più piccolo.
Prevedi valori futuri
Quando sei soddisfatto del modello, riadattalo su tutti i dati, così la previsione parte dal mese più recente.
Poi prevedi con .get_forecast(). Ti serve un valore per ogni variabile esogena in ogni mese futuro. Se ne manca una, statsmodels solleva un errore.
La provenienza di quei valori dipende dalla variabile. Per esempio:
- Feature di calendario note: festività e numero di giorni lavorativi si conoscono con anni di anticipo
- Decisioni di business pianificate: prezzi e promozioni sono noti se il tuo team li ha già programmati
- Meteo: la temperatura richiede una previsione separata, da un servizio meteo o da un altro modello
- Medie storiche: se non hai di meglio, usa il valore medio per ciascun mese di calendario dai dati passati
Userò qui l'ultima opzione come sostituto di una previsione meteo:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()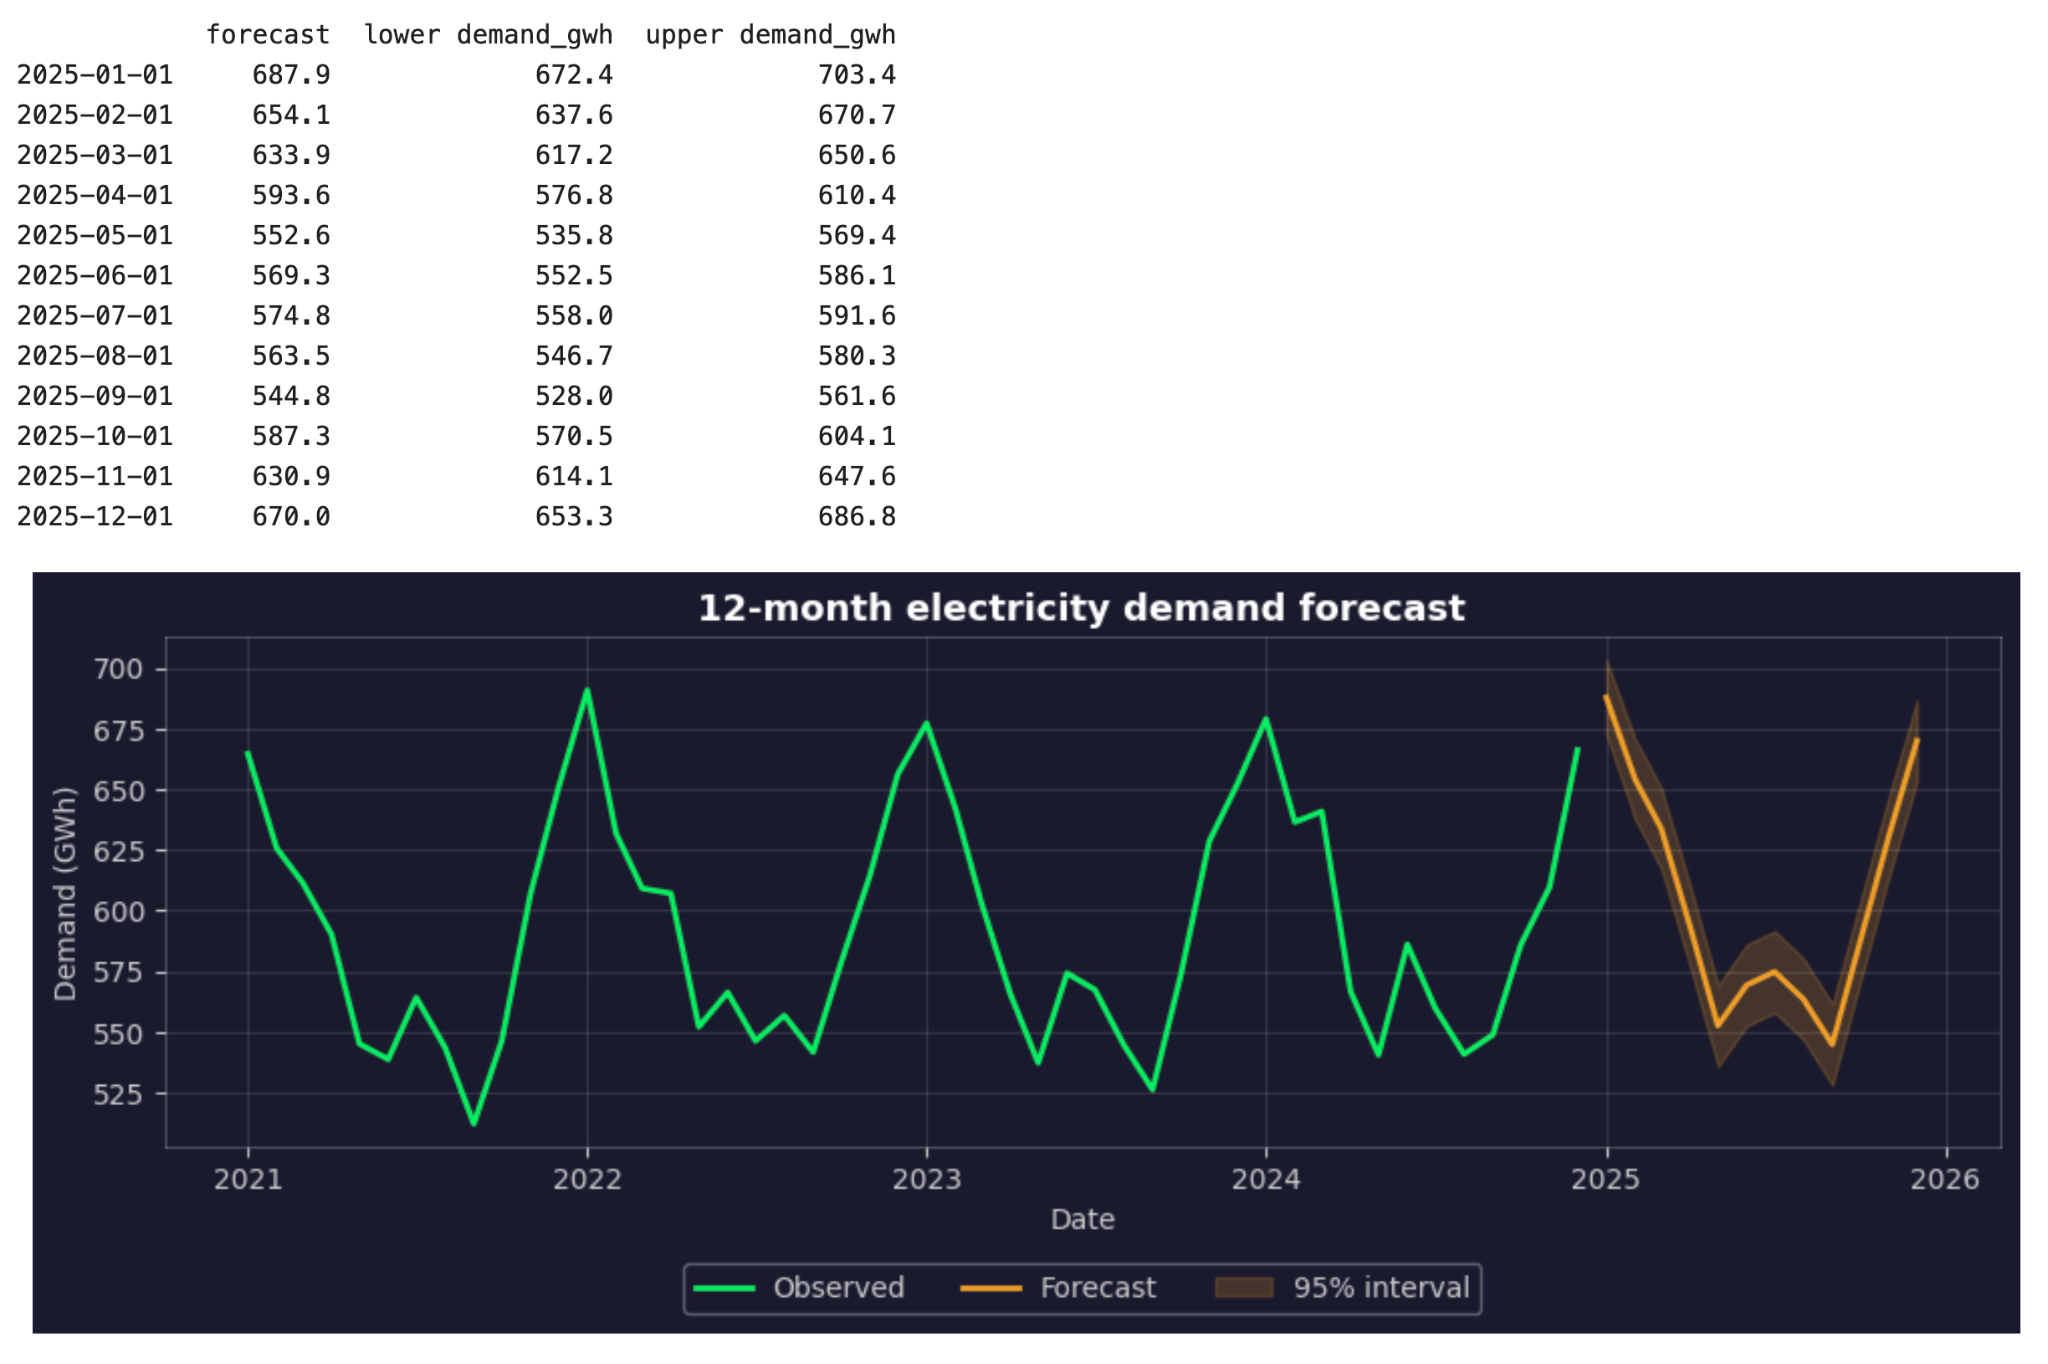
Previsione a 12 mesi della domanda di elettricità con intervallo di previsione al 95%
La previsione segue l'andamento noto, con la domanda più alta in inverno, un rigonfiamento più piccolo in estate e la più bassa in primavera e autunno.
Ma l'intervallo al 95% copre solo l'incertezza del modello adattato, dati i valori di temperatura che hai fornito. Non include l'incertezza su quelle temperature. Se gennaio fosse molto più freddo della media, la domanda reale potrebbe cadere fuori dall'intervallo anche quando il modello è corretto.
Se vuoi vedere quanto è sensibile la previsione, rieseguila con uno scenario di temperatura più freddo e uno più caldo e confronta i risultati.
Limitazioni di SARIMAX
SARIMAX è un buon modello per molti problemi di previsione stagionale, ma ha dei limiti. Ecco cosa dovresti sapere:
-
Servono predittori futuri: il modello non può prevedere senza valori per ogni variabile esogena in ogni mese futuro. Se un predittore non è noto in anticipo e non puoi prevederlo, non appartiene al modello, a prescindere da quanto migliori l'adattamento sui dati passati
-
L'incertezza dei predittori è nascosta: quando i predittori futuri sono a loro volta previsioni, i loro errori si trasferiscono nella previsione della domanda. L'intervallo di previsione standard non li include, quindi sembra più stretto di quanto dovrebbe
-
Gestisce un solo periodo stagionale: la forma standard supporta un singolo
S. La domanda oraria di elettricità ha un ciclo giornaliero e uno settimanale, e SARIMAX non può modellare entrambi insieme. Diventa anche lento con periodi stagionali lunghi, comeS = 168per un ciclo settimanale in dati orari -
Le relazioni possono cambiare: il modello assume che i pattern nei dati di training rimarranno gli stessi in futuro. Se più case passano alle pompe di calore, l'effetto del freddo sulla domanda cambierà, e il vecchio coefficiente non lo descriverà più. Dovresti riadattare regolarmente il modello su dati freschi e monitorarne l'accuratezza nel tempo
-
La selezione dei parametri richiede attenzione: un modello con AIC basso può comunque fare cattive previsioni. AIC e BIC guardano solo ai dati di training, quindi testa i candidati finali su un periodo tenuto da parte o, meglio, con cross-validation a serie temporali su un paio di finestre temporali
-
Non è un modello causale: un coefficiente significativo ti dice che un predittore aiuta la previsione, non che causa cambiamenti nel target. Se vuoi sapere cosa succede alla domanda quando cambi un prezzo, servono metodi di inferenza causale
Conclusione
Se i tuoi dati ripetono un pattern stagionale e dipendono da fattori esterni, vale la pena provare SARIMAX. Combina la storia della serie e i fattori esterni che la muovono. Quando i tuoi dati hanno entrambi, il modello di solito è migliore di uno che vede solo uno dei due.
La cosa da ricordare è che il modello è tanto buono quanto gli input che gli fornisci. Scegli il periodo stagionale in base ai dati, allinea con cura i predittori, testa su dati futuri invece di fidarti dell'AIC e assicurati di avere valori futuri per ogni predittore prima di costruire qualsiasi cosa. Se non puoi fare quest'ultima cosa, SARIMAX non è la scelta giusta per il tuo dataset.
Se vuoi continuare a imparare, iscriviti al nostro corso Time Series Analysis in Python e comprendi le basi in un pomeriggio.




