Säg att målet är månadsvis elanvändning. Modeller som ARIMA och SARIMA tittar bara på seriens historiska värden och sina egna tidigare prognosfel. Men efterfrågan beror också på yttre faktorer som temperatur: en het sommar ökar den, likaså en kall vinter. Om modellen inte ser dessa faktorer behandlar den varje ovanlig månad som brus och upprepar samma misstag nästa gång vädret ändras.
SARIMAX löser detta genom att lägga till externa, eller exogena, variabler ovanpå en säsongs-ARIMA-modell. Den lär sig fortfarande trend och säsongsmönster från seriens historik, men använder också extern information som förklarar det de historiska värdena inte kan.
Om du behöver en start i att manipulera, tolka och visualisera tidsseriedata i Python, gå vår Time Series in Python-track för att få grepp om grunderna på en vecka.
Vad är SARIMAX?
SARIMAX är en säsongs-ARIMA-modell som också kan använda externa prediktorer. Namnet står specifikt för Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors.
SARIMAX fungerar genom att förutsäga en målserie från fyra informationskällor:
- Tidigare värden: Efterfrågan under de senaste månaderna
- Tidigare prognosfel: Hur mycket modellen missade med under de senaste månaderna
- Säsongsmönster: Efterfrågan under samma månad tidigare år
- Exogena variabler: Externa data du lägger till i modellen, såsom genomsnittlig månadstemperatur
Anta att målet är att prognostisera elanvändningen för nästa juli. SARIMAX tittar på efterfrågan under de senaste månaderna, på efterfrågan under tidigare julimånader, och på förväntad temperatur i juli. De två första ligger i serien och temperaturen kommer utifrån.
Du skriver modellen som SARIMAX(p, d, q)(P, D, Q, S). Den första uppsättningen parametrar täcker kortsiktigt beteende och den andra uppsättningen täcker den säsongsbetonade komponenten, där S är antalet tidssteg i en cykel. För månadsdata med ett årligt mönster är S 12.
De exogena variablerna ingår inte i denna notation. Du skickar in dem separat till modellen, som en egen indata.
Hur SARIMAX fungerar
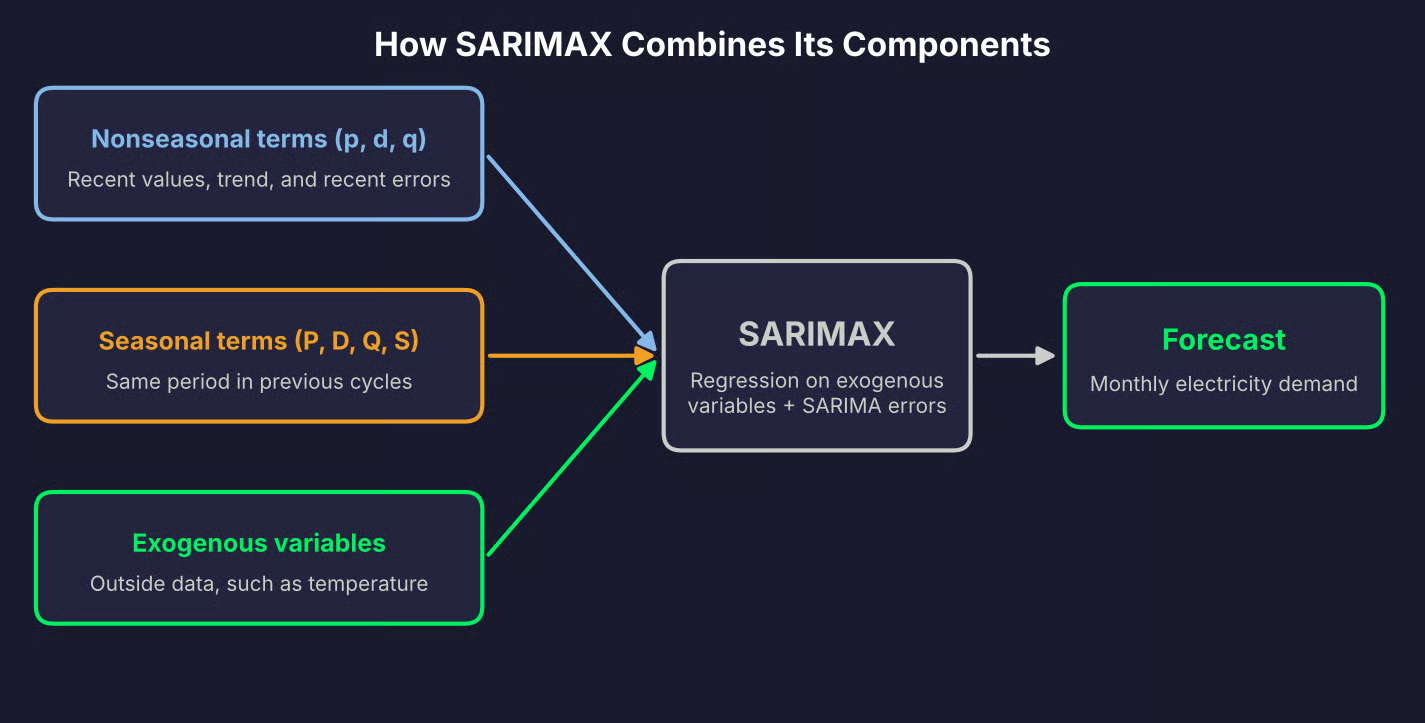
SARIMAX har två grupper av termer, och de exogena variablerna läggs ovanpå dem.
De icke-säsongsbetonade termerna (p, d, q) modellerar kortsiktigt beteende:
-
Autoregressiv ordning
p: Hur många tidigare värden modellen använder. Medp = 2beror efterfrågan denna månad på efterfrågan de två senaste månaderna -
Differensordning
d: Hur många gånger modellen differensierar serien för att ta bort en trend. Medd = 1arbetar modellen med månadsförändringar istället för rå efterfrågan -
Glidande medelvärdes ordning
q: Hur många tidigare prognosfel modellen använder. Om modellen underskattade efterfrågan förra månaden går det felet in i denna månads prognos
De säsongsbetonade termerna (P, D, Q, S) gör samma sak, men på säsongslagg:
-
Säsongs-AR-ordning
P: Hur många tidigare säsonger modellen tittar på. MedP = 1och månadsdata beror efterfrågan denna juli på efterfrågan förra juli -
Säsongsdifferensordning
D: Hur många gånger modellen differensierar serien på säsongslagg. MedD = 1jämför modellen denna juli med förra juli, vilket tar bort det återkommande årliga mönstret -
Säsongs-MA-ordning
Q: Hur många tidigare prognosfel på säsongslagg modellen använder, till exempel felet från förra juli -
Säsongsperiod
S: Hur många tidssteg en cykel har. Den är 12 för månadsdata med ett årligt mönster och 7 för dagsdata med ett veckomönster
Exogena variabler tillför information som serien inte har.
I exemplet med elanvändning är det temperatur. En het sommar eller en kall vinter ökar efterfrågan, och tidigare efterfrågevärden kan inte tala om för modellen hur vädret blir nästa månad. Mönstret för månad på året kommer redan från säsongstermerna, så temperatur är den enda externa variabeln som behövs i exemplet.
I statsmodels är SARIMAX en linjär regression på de exogena variablerna, där felen följer en säsongs-ARIMA-process. Med en exogen variabel ser det ut så här:
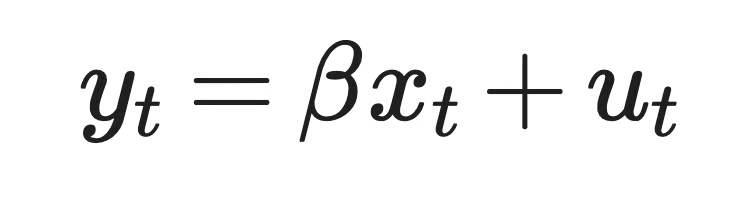
SARIMAX med en exogen variabel
Här är y_t elanvändningen i månad t, x_t är temperaturen den månaden, beta är temperaturkoefficienten, och u_t är den del av efterfrågan som temperaturen inte förklarar. De icke-säsongsbetonade och säsongsbetonade termerna modellerar u_t.
Med enklare ord: temperaturen förklarar en del av efterfrågan och SARIMA-termerna modellerar resten.
Här är en mer visuell översikt:
SARIMAX-komponenter
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
Dessa fyra modeller tillhör samma familj. Skillnaderna är subtila, men du förstår dem efter en genomläsning.
ARIMA modellerar en serie utifrån dess egna tidigare värden och tidigare prognosfel. SARIMA lägger till säsongstermer ovanpå detta, så att den kan modellera mönster som upprepas var S:e tidssteg. ARIMAX lägger till exogena variabler till ARIMA, men har inte säsongstermer som standard. SARIMAX har båda.
Därför kan SARIMAX representera de andra modellerna som specialfall. Om du inte skickar in några exogena variabler får du en SARIMA-modell. Om du sätter alla säsongsordningar till noll får du en icke-säsongsbetonad ARIMAX-modell. Och utan båda är det en ARIMA-modell.
Men tyvärr är terminologin inte konsekvent mellan olika paket.
Läroboks-ARIMAX lägger in exogena variabler direkt i ARIMA-ekvationen, bredvid seriens tidigare värden. statsmodels’ SARIMAX passar istället en regression med SARIMA-fel, som visats i föregående avsnitt. De två formerna skattar olika koefficienter, så samma temperaturvariabel kan få olika koefficient beroende på paket.
Klass- och funktionsnamn matchar inte heller. Klassen ARIMA i statsmodels accepterar också säsongstermer och exogena variabler. I R hanterar paketet forecast externa regressorer via argumentet xreg i Arima() och auto.arima(). Så kom ihåg att kontrollera hur varje paket definierar modellen innan du jämför resultat mellan verktyg.
Här är en snabb sammanfattning:
| Säsongsmönster? | Externa variabler? | |
|---|---|---|
| ARIMA | Nej | Nej |
| SARIMA | Ja | Nej |
| ARIMAX | Inte som standard | Ja |
| SARIMAX | Ja | Ja |
Jämförelse inom ARIMA-familjen
När ska du använda SARIMAX
SARIMAX är vettigt när målet har ett återkommande säsongsmönster och externa variabler kan förbättra prognosen.
Till exempel:
- Elanvändning: Temperatur och kalendereffekter såsom helgdagar, ovanpå den årliga cykeln
- Detaljhandelns försäljning: Kampanjer, priser och helgperioder
- Hotellbokningar: Lokala evenemang och rumspriser, ovanpå den årliga resesäsongen
- Kollektivtrafikresande: Väder och skollov, ovanpå ett veckomönster i dagsdata
Men SARIMAX är inte alltid rätt val. En enklare modell kan göra samma jobb i dessa två fall:
- Ingen meningsfull säsong: Om serien inte upprepar ett mönster lägger säsongstermer bara till parametrar att skatta. ARIMA eller ARIMAX räcker
- Prediktorer förbättrar inte noggrannheten: Om exogena variabler inte minskar felet på en utvärderad testperiod, ta bort dem och använd SARIMA. En bättre passform på träningsdata räknas inte
Det viktiga här är att SARIMAX behöver värden för varje exogen variabel under prognosperioden.
Vissa värden är kända i förväg, till exempel helgdagar eller planerade kampanjer. Andra, som temperatur, måste prognostiseras separat innan SARIMAX kan använda dem. Om du inte kan få framtida värden för en prediktor kan du inte använda den i prognosen.
Hur du bygger en SARIMAX-modell i Python
I det här avsnittet bygger jag en SARIMAX-modell med statsmodels, från rådata till en 12-månadersprognos.
Exemplet använder syntetisk månadsvis elanvändning med temperatur som extern variabel. Det är litet och reproducerbart och följer samma berättelse som resten av artikeln.
Förbered data
Datasettet täcker tio år av månadsdata, från januari 2015 till december 2024.
Efterfrågan har en uppåtgående trend, ett årligt kalendermönster som förändras långsamt över tid, en vädereffekt och brus. Två temperaturmätningar saknas med avsikt, så att du kan se hur man hanterar luckor:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())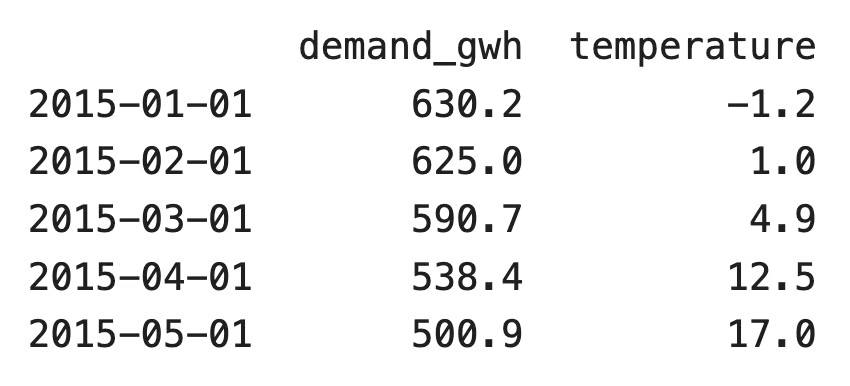
De fem första raderna i datasettet
Eller om du föredrar en visuell översikt:
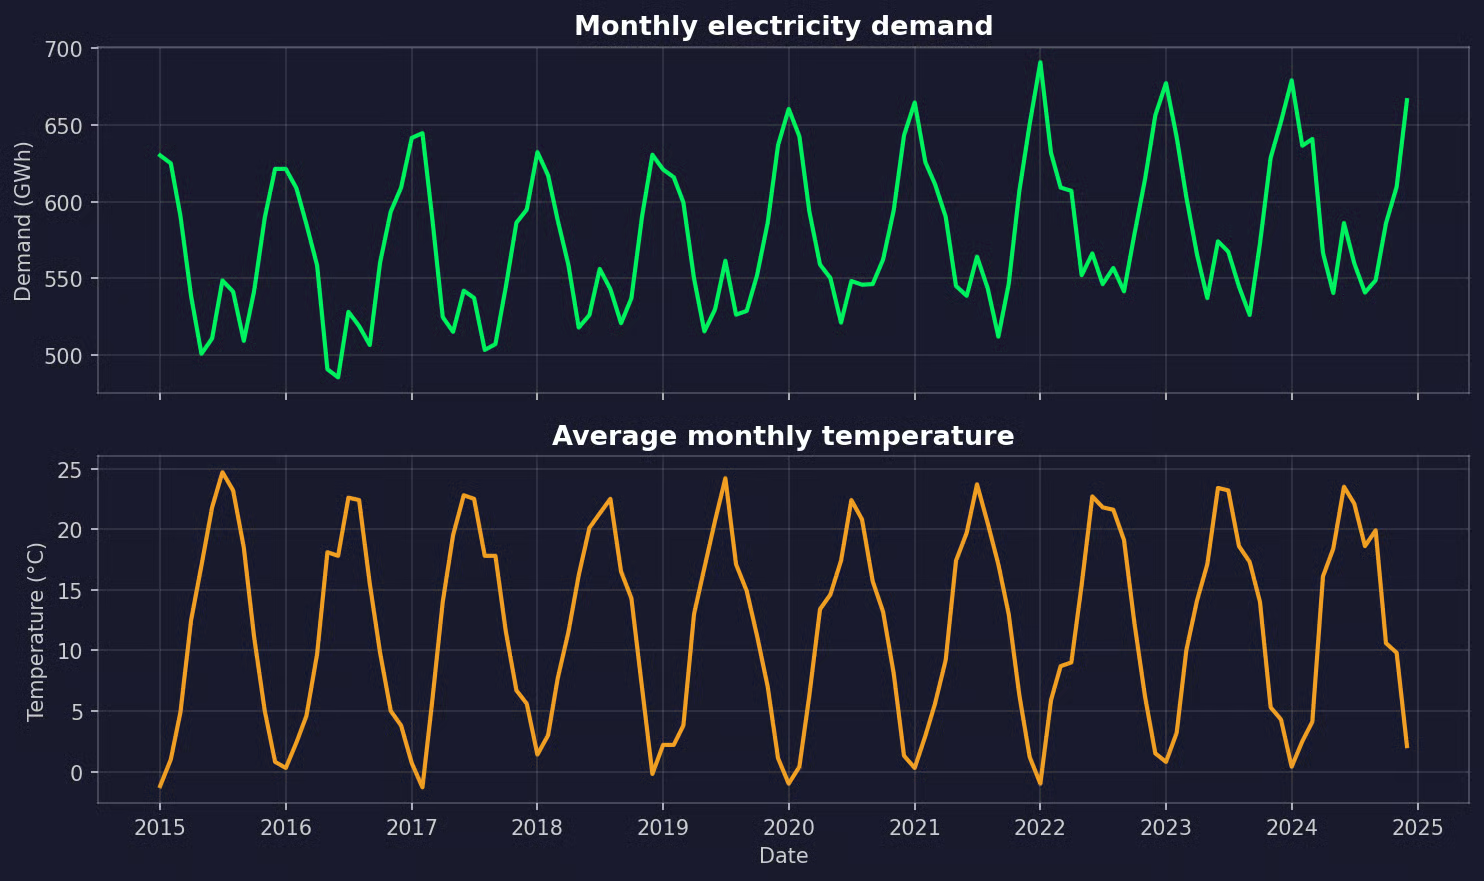
Temperaturdatasetet
Om du arbetar med egna data, ladda dem med pd.read_csv() och sätt datumkolumnen som index. Resten av arbetsflödet är detsamma.
SARIMAX behöver ett tidsindex med en konsekvent frekvens. Metoden .asfreq() sätter den till månadsvis och infogar en tom rad för varje saknad månad. Sedan kan du räkna luckorna och fylla dem:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()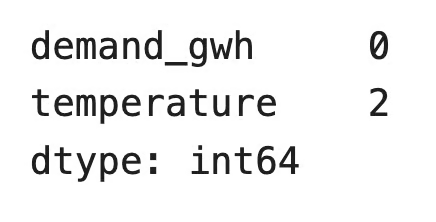
Interpolering av temperaturluckor
Linjär interpolering fungerar här eftersom temperaturen förändras mjukt från månad till månad. Gör inte samma sak för målet om stora delar saknas. Du skulle lära modellen på påhittade värden.
Nästa steg är de exogena variablerna. Efterfrågan går upp när det är kallt och när det är varmt, men en rak linjär regression på rå temperatur kan inte modellera en U-form. Så jag delar upp temperaturen i två funktioner:
- Uppvärmningsgrader: Hur många grader medeltemperaturen ligger under 18 grader Celsius, och noll annars
- Kylgrader: Hur många grader medeltemperaturen ligger över 18 grader Celsius, och noll annars
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
Dela nu upp data i målet y och de exogena variablerna X. Uppdelningen måste vara kronologisk: modellen tränar på det förflutna och testas på framtiden. En slumpmässig uppdelning skulle läcka framtidsinformation in i träningen:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")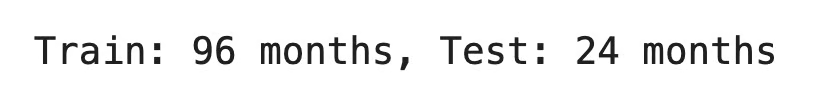
Tränings-/testuppdelning
Det viktiga här är att X_test har faktiskt observerade temperaturer. I en riktig prognos skulle du inte känna till dem i förväg – du skulle som bäst ha en väderprognos. Det innebär att testpoängen du ser senare är optimistisk. Använd observerade prediktorvärden för utvärdering bara om samma värden kommer att finnas tillgängliga vid prognostillfället, som helgdagar eller planerade priser.
Utforska säsong och stationaritet
Börja med en graf. Du letar efter trender, säsongscykler och plötsliga förändringar:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()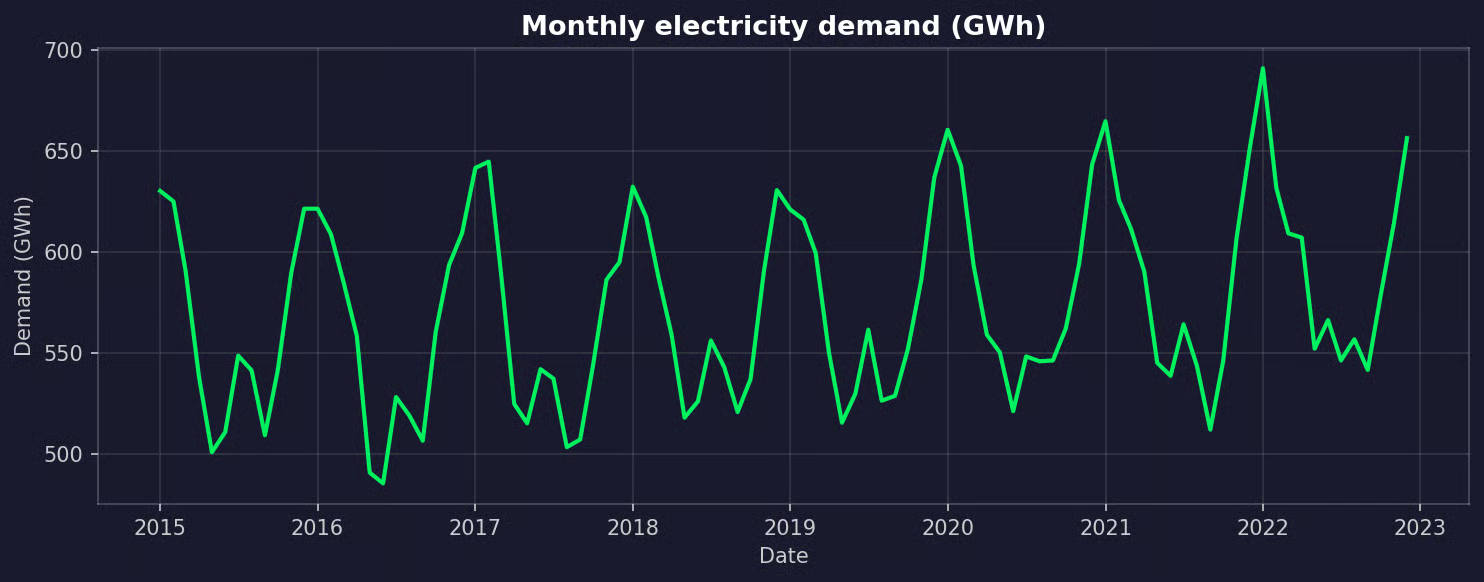
Månadsvis elanvändning under träningsperioden
Efterfrågan ökar över tid och toppar varje vinter med en mindre topp varje sommar. Mönstret upprepas var 12:e månad.
En säsongsdekomposition delar upp serien i trend-, säsongs- och residualkomponenter, så att du kan bekräfta säsongsperioden S:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()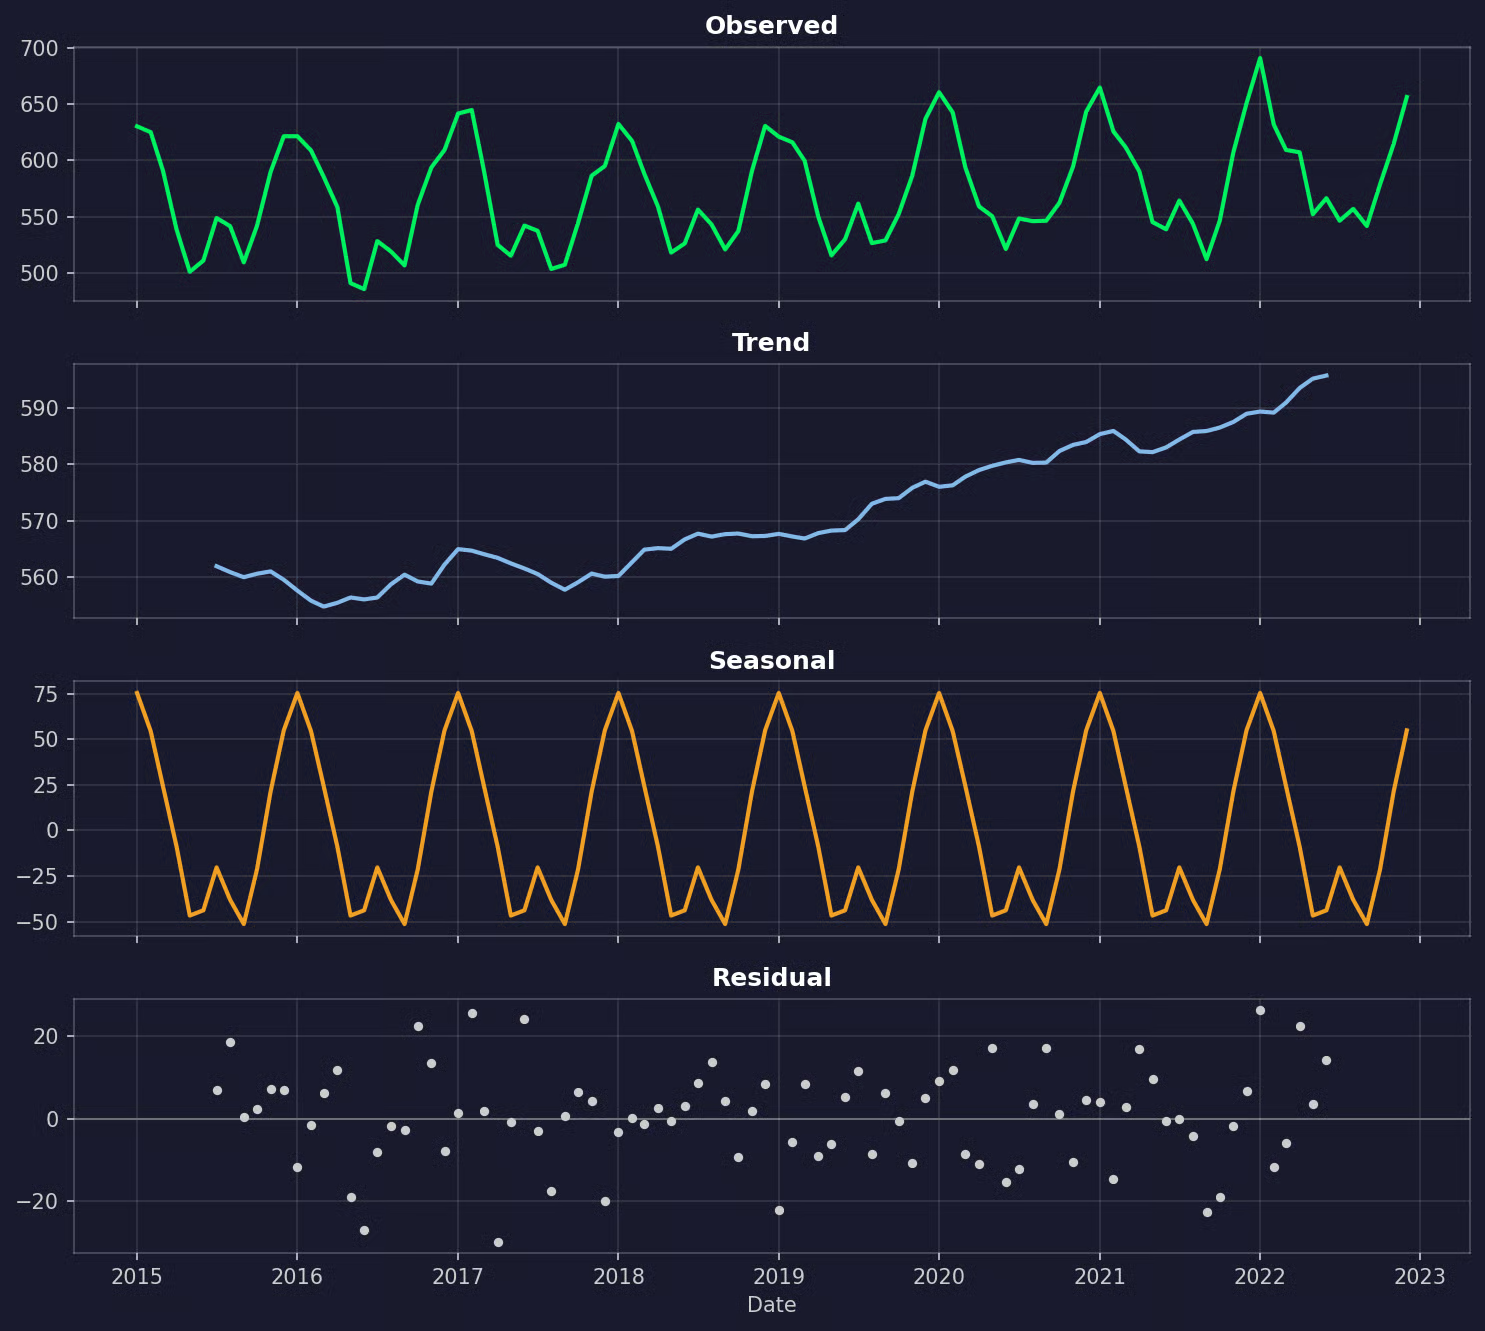
Säsongsdekomposition av elanvändning
Den säsongsbetonade komponenten upprepas varje år, så S = 12.
Modeller i ARIMA-familjen behöver en stationär serie – en vars medelvärde och varians inte förändras över tid. Efterfrågan är inte stationär eftersom den har en trend och en säsongscykel.
Differensiering är ett sätt att hantera det:
-
Vanlig differens (
d): Subtraherar förra månadens värde från denna månads värde. Tar bort en trend -
Säsongsdifferens (
D): Subtraherar värdet från samma månad förra året. Tar bort ett återkommande säsongsmönster och tar också bort en linjär trend
Augmented Dickey-Fuller-testet (ADF) kontrollerar stationaritet. Nollhypotesen är att serien inte är stationär, så ett litet p-värde (under 0,05) är bevis på att den är det:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")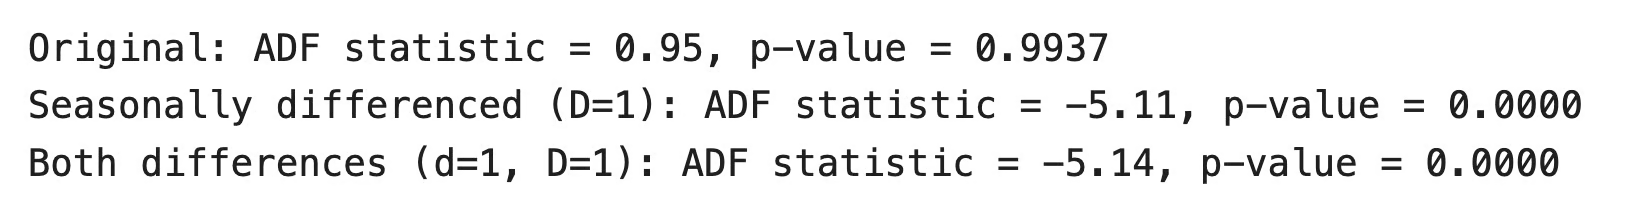
Resultat från ADF-testet
Den ursprungliga serien är inte stationär. Säsongsdifferens ensam fixar det, så vanlig differens ovanpå tillför inget. Använd minsta möjliga differens som fungerar – extra differenser tillför brus till serien och gör modellen svårare att anpassa.
Valet blir alltså d = 0 och D = 1.
Men behandla ADF-testet endast som stödjande bevis. Det säger inget om p, q, P eller Q, och med korta serier kan det ge olika svar beroende på inställningar.
Välj kandidatparametrar
ACF- och PACF-diagram hjälper dig att välja kandidatvärden för återstående ordningar:
-
ACF (autokorrelationsfunktion): Visar korrelationen mellan serien och dess egna förskjutna värden. Spikar i ACF pekar på glidande medelvärdestermer,
qvid korta lagg ochQvid säsongslagg -
PACF (partiell autokorrelationsfunktion): Visar samma korrelation men tar bort effekten av mellanliggande lagg. Spikar i PACF pekar på autoregressiva termer,
pvid korta lagg ochPvid säsongslagg
Du bör plotta båda för den säsongsdifferensierade serien, eftersom det är den serien modellen arbetar med:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()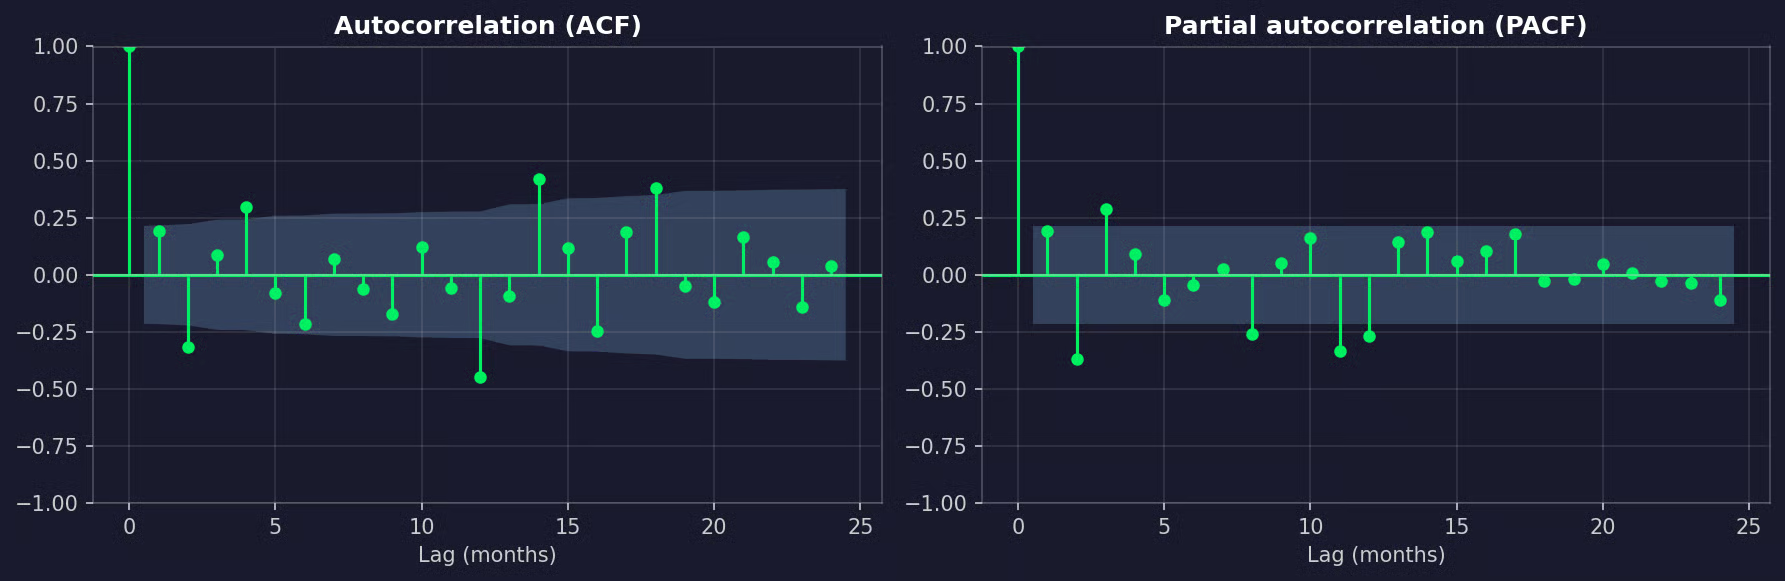
ACF- och PACF-diagram för säsongsdifferensierad elanvändning
ACF har en tydlig negativ spik vid lagg 12 och inget vid lagg 24. Det är ett typiskt tecken på en säsongs-MA-term, så Q = 1 är en bra kandidat. Båda diagrammen visar också ett par spikar vid korta lagg, så p och q är värda att testa.
Nästa steg är att anpassa en liten uppsättning kandidatmodeller och jämföra dem med AIC eller BIC. Båda poängsätter hur väl en modell passar träningsdata och straffar extra parametrar. Lägre är bättre, och BIC straffar komplexitet mer än AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))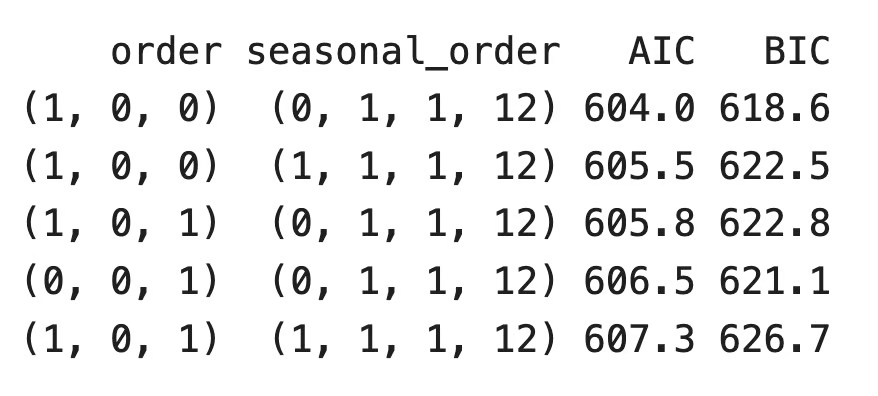
AIC- och BIC-resultat
SARIMAX(1, 0, 0)(0, 1, 1, 12) vinner på både AIC och BIC. Det är också en av de enklaste modellerna i listan.
Argumentet trend="c" lägger till en konstant. Med säsongsdifferens modellerar en konstant den år-för-år-ökning i efterfrågan.
Det finns verktyg som auto_arima() från biblioteket pmdarima som kör denna sökning åt dig. De är praktiska för ett första försök, men AIC och BIC mäter bara passform på träningsdata. Innan du litar på en modell, testa den på data den inte har sett.
Anpassa modellen
Skicka målet som första argument och de exogena variablerna via exog. Argumentet order tar (p, d, q) och seasonal_order tar (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())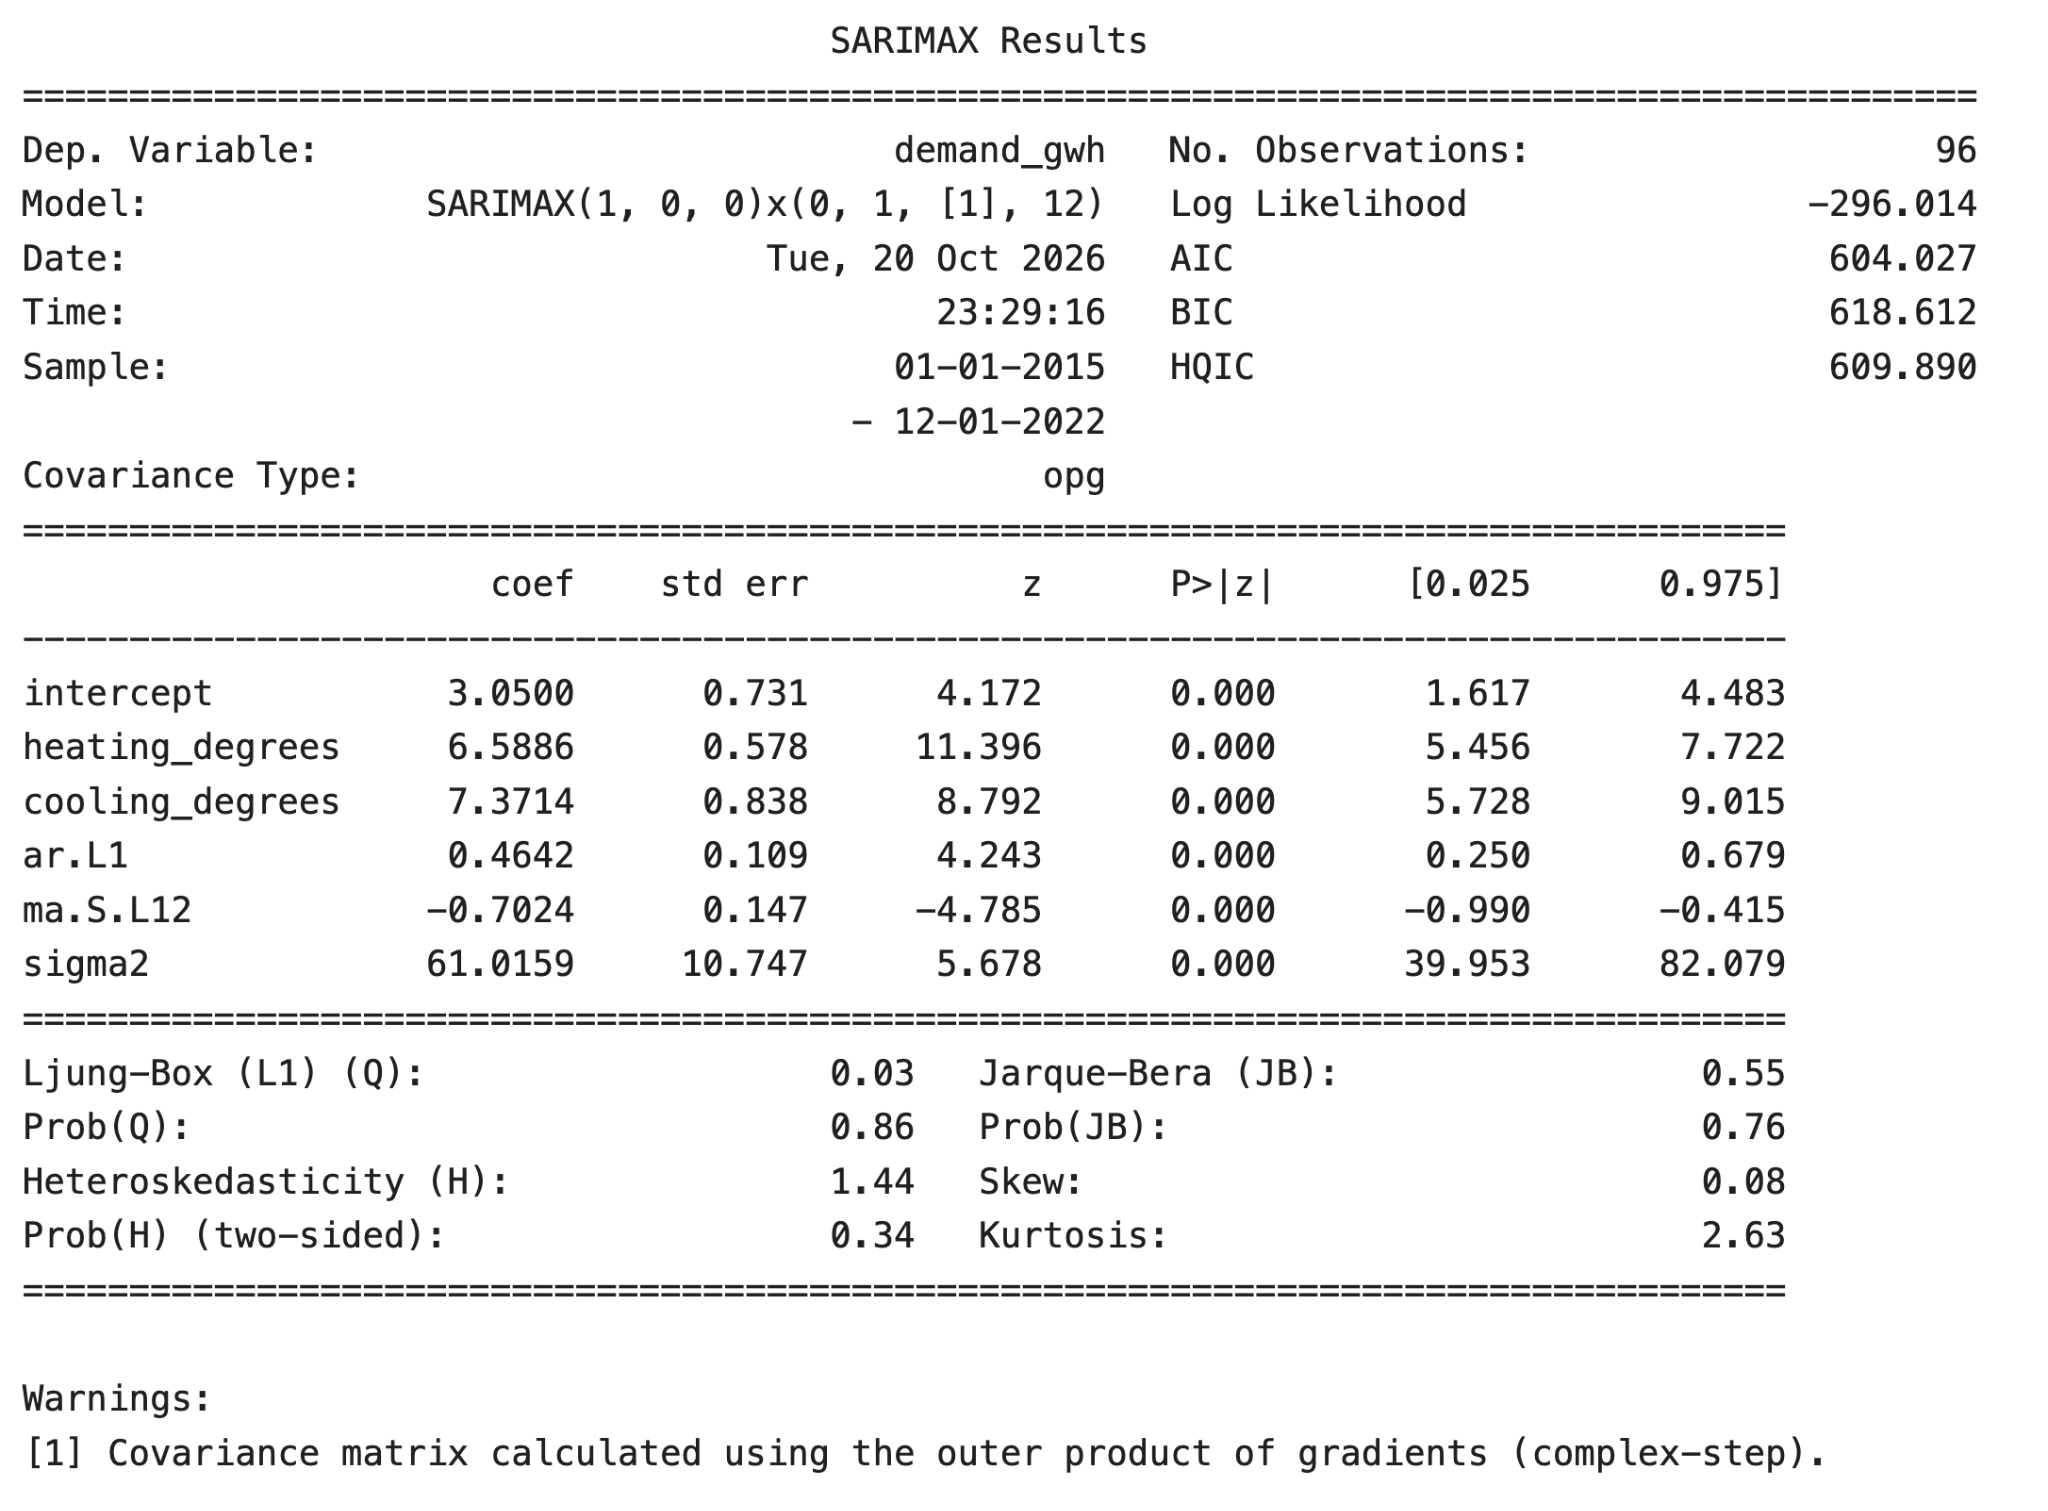
Sammanfattning av SARIMAX-modellen
Så här läser du koefficienttabellen:
-
heating_degrees: Varje extra uppvärmningsgrad hänger ihop med cirka 6,6 GWh extra efterfrågan, med allt annat i modellen fixerat -
cooling_degrees: Varje extra kylgrad hänger ihop med cirka 7,4 GWh extra efterfrågan -
ar.L1: Cirka 46 % av förra månadens oförklarade avvikelse bärs över till denna månad -
ma.S.L12: Den säsongsbetonade MA-termen, som korrigerar prognosen baserat på felet från samma månad förra året -
sigma2: Variansen i det återstående bruset
Alla koefficienter har p-värden nära noll, så varje term tillför något till modellen.
Men dessa koefficienter beskriver relationer inne i den anpassade modellen, inte orsaker. Här genererade jag data med temperatur som orsak till efterfrågan, så tolkningen är säker. I verkliga data kan en prediktor verka viktig för att den samvarierar med något modellen inte ser.
Diagnostisera och utvärdera modellen
En bra modell lämnar residualer som ser ut som slumpmässigt brus. Om residualerna fortfarande har ett mönster har modellen missat något.
Metoden .plot_diagnostics() ger dig fyra diagram i ett anrop:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()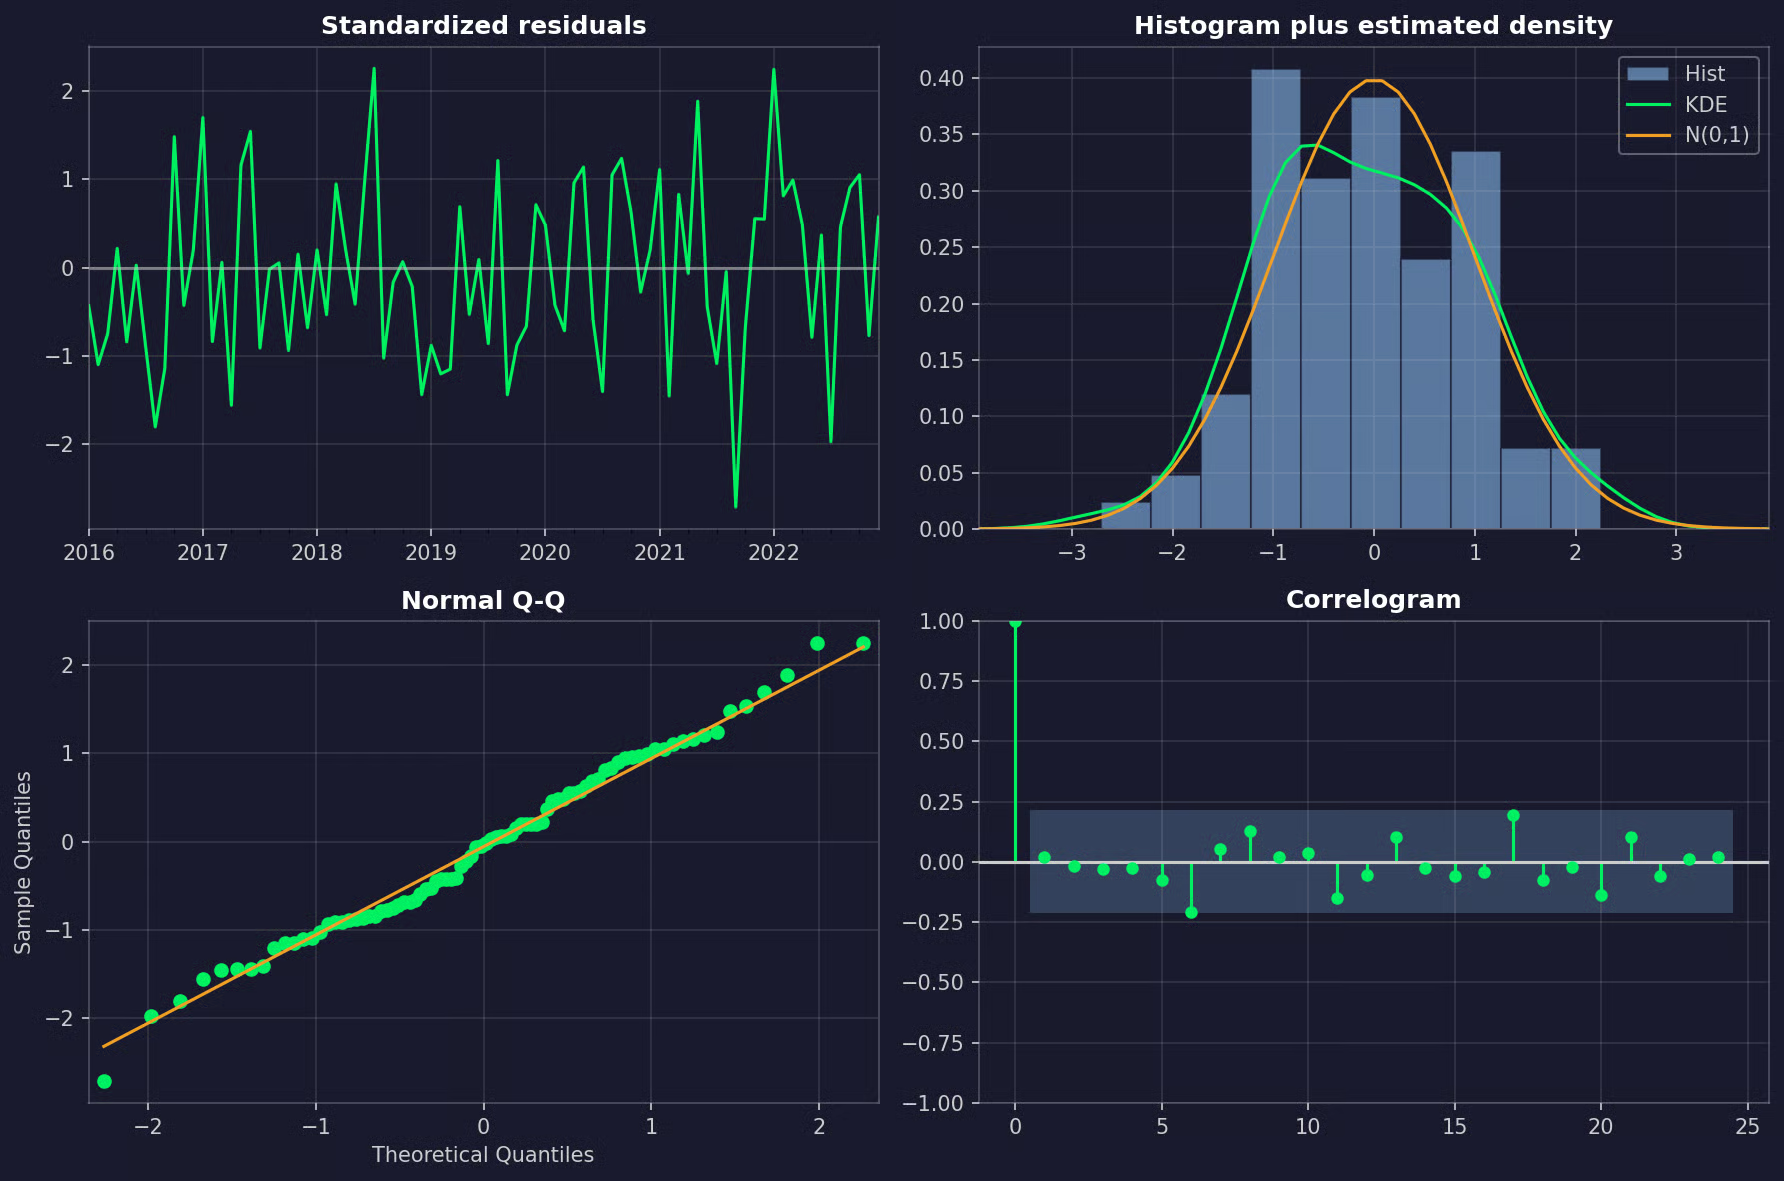
Diagram för residualdiagnostik
Det här ska du titta efter:
- Standardiserade residualer: Ingen trend, inget upprepat mönster och inga perioder där spridningen blir mycket större
- Histogram och Q-Q-diagram: Punkter nära en normalfördelning
- Korrelogram: Inga spikar utanför konfidensbandet, särskilt vid lagg 12 – en spik där betyder att modellen inte helt hanterat säsongsmönstret
Ljung–Box-testet ger dig samma kontroll i sifferform. Nollhypotesen är att residualerna saknar autokorrelation upp till en given lagg, så du vill ha stora p-värden:
# Skip the first 13 residuals, which come from the differencing start-up period
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))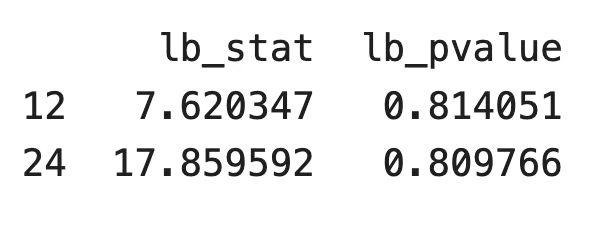
Resultat från Ljung–Box-testet
Båda p-värdena ligger väl över 0,05, så residualerna ser ut som brus.
Nu till det som är viktigast – noggrannhet på data modellen inte sett. Metoden .get_forecast() förutspår de 24 testmånaderna och behöver de exogena värdena för dessa månader.
Ett prognostal säger lite i sig, så jag jämför SARIMAX mot två baslinjer:
- Säsongsnaiv prognos: Upprepar värdena från de sista 12 månaderna av träningsdata
- SARIMA: Samma modell, men utan exogena variabler
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: repeat the last 12 observed months
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: the same model without exogenous variables
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()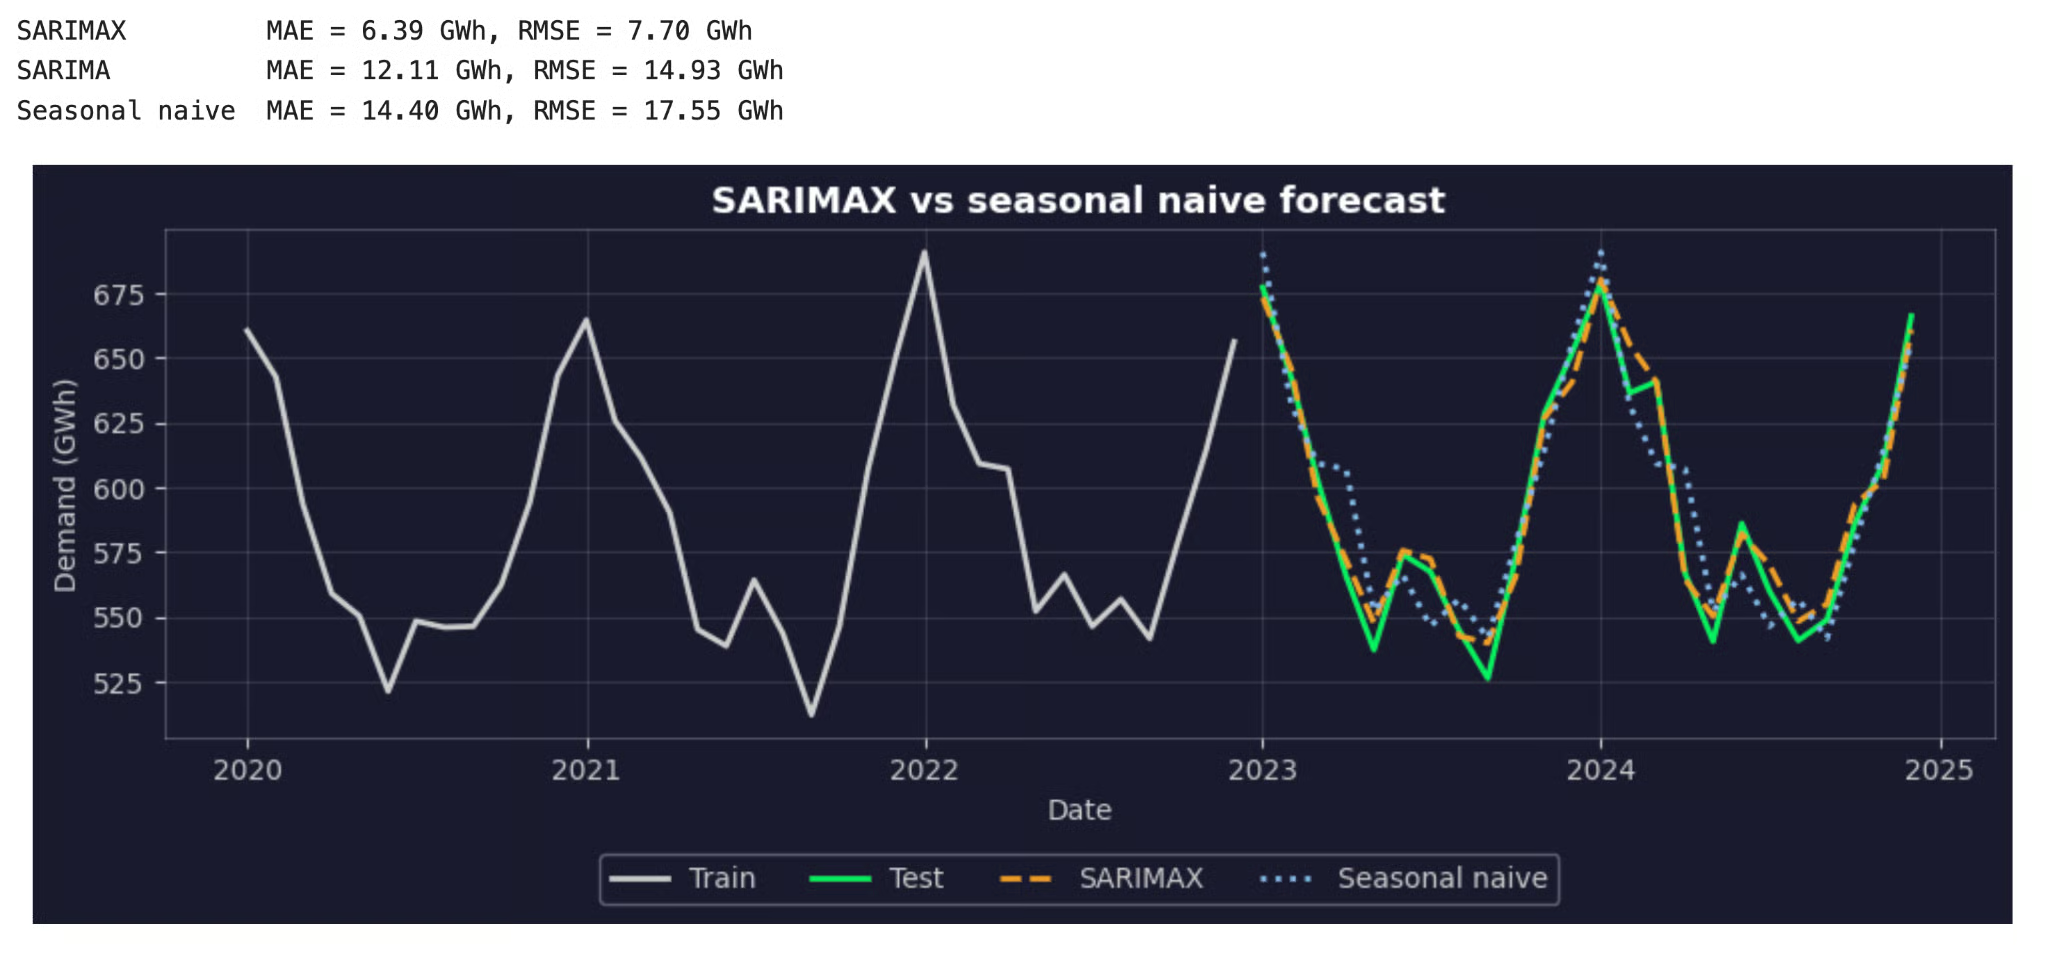
SARIMAX- och säsongsnaiva prognoser jämfört med faktisk efterfrågan i testmängden
MAE (mean absolute error) är den genomsnittliga felstorleken i GWh. RMSE (root mean squared error) bestraffar stora fel mer.
SARIMAX har ungefär halva felet jämfört med SARIMA på båda måtten. Säsongstermerna ensamma kan inte förutsäga en ovanligt kall januari eller en het juli, och temperaturvariablerna kan det.
Kom ihåg att detta resultat använder observerade temperaturer under testperioden. Med väderprognoser i deras ställe skulle gapet vara mindre.
Prognostisera framtida värden
När du är nöjd med modellen, anpassa den på all data, så att prognosen startar från den senaste månaden.
Prognostisera sedan med .get_forecast(). Du behöver ett värde för varje exogen variabel varje framtida månad. Om något saknas kastar statsmodels ett fel.
Var dessa värden kommer ifrån beror på variabeln. Till exempel:
- Kända kalendervariabler: Helgdagar och antal arbetsdagar är kända flera år i förväg
- Planerade affärsbeslut: Priser och kampanjer är kända om ditt team redan lagt schema
- Väder: Temperatur behöver en separat prognos, från en vädertjänst eller en annan modell
- Historiska medelvärden: Om du inte har något bättre, använd medelvärdet för varje kalendermånad från tidigare data
Jag använder det sista alternativet här som en stand-in för en väderprognos:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()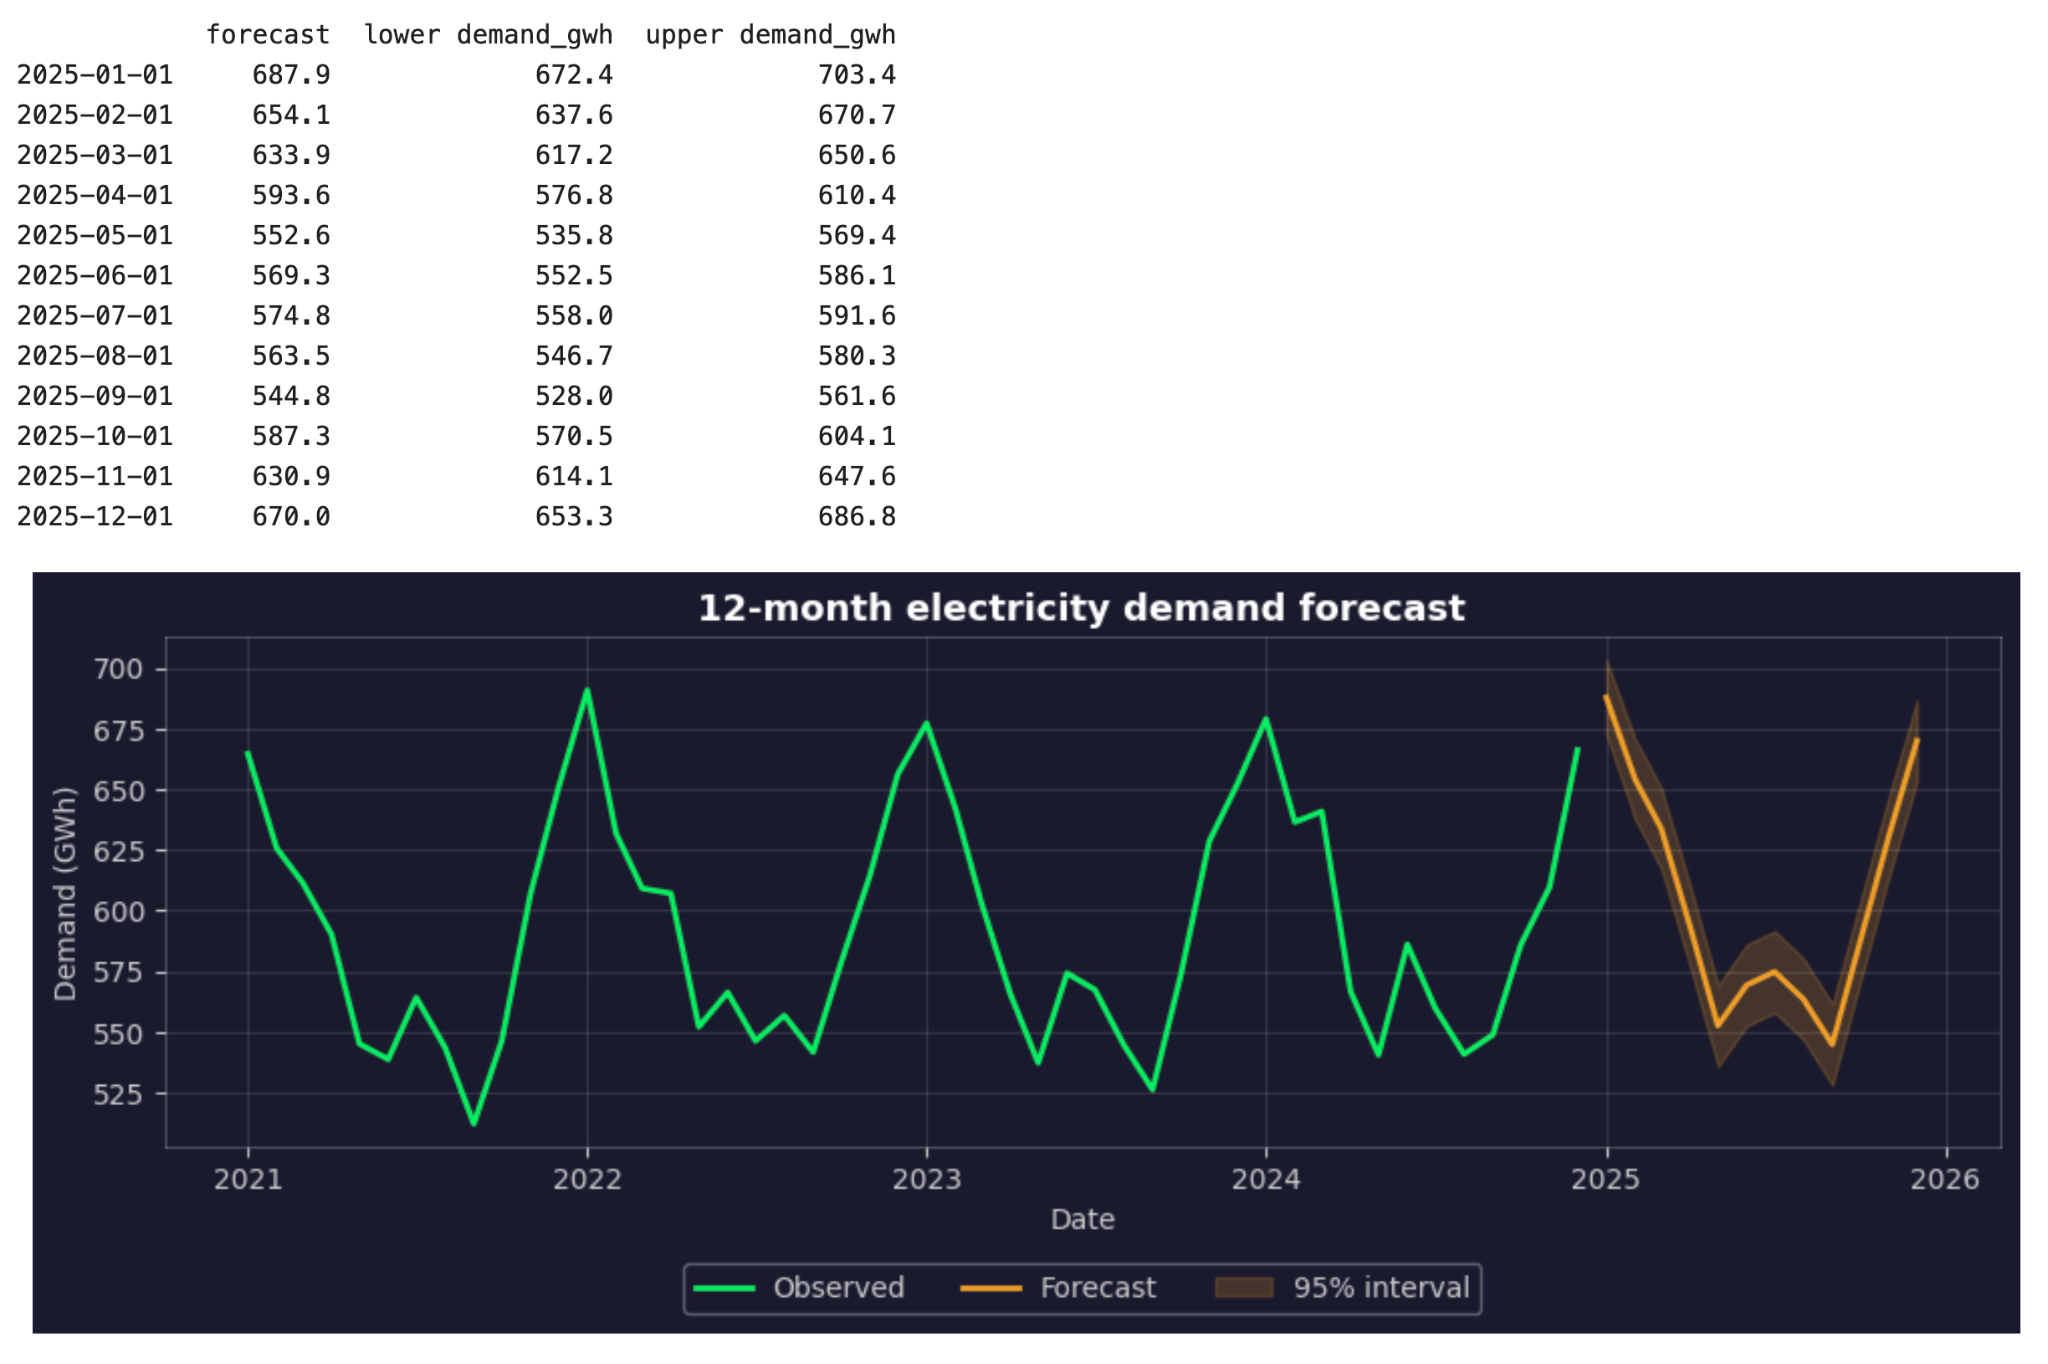
12-månadersprognos för elanvändning med ett 95 % prediktionsintervall
Prognosen följer den välbekanta formen, med högst efterfrågan på vintern, en mindre puckel på sommaren och lägst efterfrågan på våren och hösten.
Men 95 %-intervallet täcker bara osäkerheten i den anpassade modellen givet temperaturvärdena du angav. Det inkluderar inte osäkerheten i dessa temperaturer. Om januari blir mycket kallare än genomsnittet kan faktisk efterfrågan hamna utanför intervallet även när modellen är korrekt.
Om du vill se hur känslig prognosen är, kör den igen med ett kallare och ett varmare temperaturscenario och jämför resultaten.
Begränsningar med SARIMAX
SARIMAX är en bra modell för många säsongsprognosproblem, men den har vissa begränsningar. Här är vad du bör veta:
-
Framtida prediktorer krävs: Modellen kan inte prognostisera utan värden för varje exogen variabel varje framtida månad. Om en prediktor inte är känd i förväg och du inte kan prognostisera den, hör den inte hemma i modellen, oavsett hur mycket den förbättrar passformen på historiska data
-
Prediktorosäkerhet är dold: När framtida prediktorer själva är prognoser överförs deras fel in i efterfrågeprognosen. Standardintervall för prognos inkluderar dem inte, så det ser smalare ut än det borde
-
Den hanterar en säsongsperiod: Standardformen stödjer en enda
S. Timvis elanvändning har en daglig och en veckovis cykel, och SARIMAX kan inte modellera båda samtidigt. Den blir också långsam med långa säsongsperioder, såsomS = 168för en veckocykel i timdata -
Relationer kan förändras: Modellen antar att mönstren i träningsdata består i framtiden. Om fler hem byter till värmepumpar förändras effekten av kallt väder på efterfrågan, och den gamla koefficienten beskriver inte det längre. Du bör återanpassa modellen på färsk data regelbundet och följa dess noggrannhet över tid
-
Parameterval kräver omsorg: En modell med låg AIC kan ändå göra dåliga prognoser. AIC och BIC tittar bara på träningsdata, så testa slutkandidaterna på en hållen utperiod, eller ännu hellre med tidsserie-korsvalidering över ett par tidsfönster
-
Det är inte en kausal modell: En signifikant koefficient säger att en prediktor hjälper prognosen, inte att den orsakar förändringar i målet. Om du vill veta vad som händer med efterfrågan när du ändrar ett pris behöver du kausala inferensmetoder
Slutsats
Om dina data upprepar ett säsongsmönster och beror på yttre faktorer är SARIMAX värt att prova. Det kombinerar seriens historik och de yttre faktorer som påverkar den. När dina data har båda är modellen oftast bättre än en modell som bara ser det ena.
Det viktiga att komma ihåg är att modellen bara är så bra som indata du ger den. Välj säsongsperiod baserat på data, aligna prediktorer noggrant, testa på framtida data istället för att lita på AIC, och se till att du kommer ha framtida värden för varje prediktor innan du bygger något. Om du inte kan göra det sista är SARIMAX inte rätt val för ditt dataset.
Om du vill fortsätta lära dig, gå vår kurs Time Series Analysis in Python och förstå grunderna på en eftermiddag.