
Stel, je doelvariabele is de maandelijkse vraag naar elektriciteit. Modellen zoals ARIMA en SARIMA kijken alleen naar de vorige waarden van de reeks en hun eigen vorige voorspellingsfouten. Maar de vraag hangt ook af van externe factoren, zoals temperatuur: een hete zomer verhoogt de vraag, en een koude winter ook. Als het model deze factoren niet ziet, behandelt het elke uitzonderlijke maand als ruis en maakt het dezelfde fout zodra het weer omslaat.
SARIMAX lost dit probleem op door externe, of exogene, variabelen toe te voegen bovenop een seizoensgebonden ARIMA-model. Het leert nog steeds trend en seizoenspatroon uit de geschiedenis van de reeks, maar gebruikt daarnaast externe informatie die verklaart wat de verleden waarden niet kunnen.
Als je een opstarter nodig hebt om tijdreeksdata in Python te manipuleren, interpreteren en visualiseren, schrijf je dan in voor ons Time Series in Python-traject en leg in een week de basis.
Wat is SARIMAX?
SARIMAX is een seizoensgebonden ARIMA-model dat ook externe voorspellers kan gebruiken. Concreet staat de naam voor Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors.
SARIMAX werkt door een doelreeks te voorspellen op basis van vier informatiebronnen:
- Vorige waarden: De vraag in de meest recente maanden
- Vorige voorspellingsfouten: Hoeveel het model er in de meest recente maanden naast zat
- Seizoenspatronen: De vraag in dezelfde maand van voorgaande jaren
- Exogene variabelen: Externe data die je aan het model toevoegt, zoals de gemiddelde maandtemperatuur
Stel dat je de vraag naar elektriciteit voor komende juli wilt voorspellen. SARIMAX kijkt naar de vraag in de afgelopen paar maanden, naar de vraag in eerdere julimaanden, en naar de verwachte temperatuur voor juli. De eerste twee zitten in de reeks zelf en de temperatuur komt van buitenaf.
Je schrijft het model als SARIMAX(p, d, q)(P, D, Q, S). De eerste set parameters dekt kortetermijngedrag, en de tweede set de seizoenscomponent, waarbij S het aantal tijdstappen in één cyclus is. Voor maanddata met een jaarlijks patroon is S 12.
De exogene variabelen staan niet in deze notatie. Je geeft ze apart door aan het model, als eigen input.
Hoe SARIMAX werkt
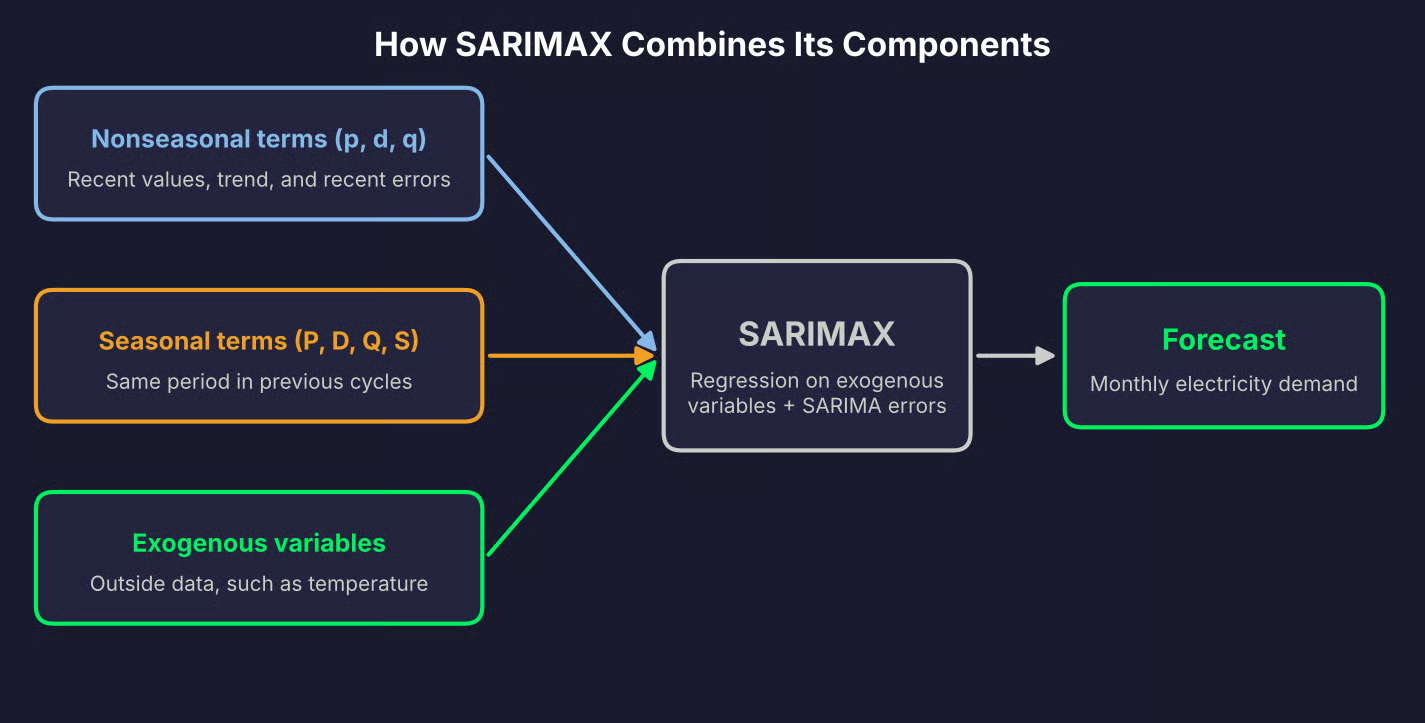
SARIMAX heeft twee groepen termen, en de exogene variabelen komen daar bovenop.
De niet-seizoensgebonden termen (p, d, q) modelleren het kortetermijngedrag:
-
Autoregressieve orde
p: Hoeveel vorige waarden het model gebruikt. Metp = 2hangt de vraag van deze maand af van de vraag in de twee voorgaande maanden -
Verschilorde
d: Hoe vaak het model de reeks differentieert om een trend te verwijderen. Metd = 1werkt het model met maand-op-maand veranderingen in plaats van ruwe vraag -
Moving average-orde
q: Hoeveel eerdere voorspellingsfouten het model gebruikt. Als het model vorige maand de vraag onderschatte, gaat die fout mee in de voorspelling van deze maand
De seizoensgebonden termen (P, D, Q, S) doen hetzelfde, maar op seizoensvertragingen:
-
Seizoensautoregressieve orde
P: Hoeveel voorgaande seizoenen het model bekijkt. MetP = 1en maanddata hangt de vraag in juli af van de vraag in juli vorig jaar -
Seizoensverschilorde
D: Hoe vaak het model de reeks differentieert op de seizoensvertraging. MetD = 1vergelijkt het model deze juli met vorige juli, wat het terugkerende jaarlijkse patroon verwijdert -
Seizoens moving average-orde
Q: Hoeveel eerdere voorspellingsfouten op seizoensvertragingen het model gebruikt, zoals de fout van vorige juli -
Seizoensperiode
S: Hoeveel tijdstappen één cyclus heeft. Het is 12 voor maanddata met een jaarlijks patroon en 7 voor dagdata met een wekelijks patroon
Exogene variabelen voegen informatie toe die de reeks zelf niet bevat.
In het elektriciteitsvraagvoorbeeld is dat temperatuur. Een hete zomer of een koude winter verhoogt de vraag, en verleden waarden van de vraag kunnen het model niet vertellen wat het weer volgende maand wordt. Het maand-van-het-jaarpatroon komt al uit de seizoentermen, dus temperatuur is de enige externe variabele die het voorbeeld nodig heeft.
In statsmodels is SARIMAX een lineaire regressie op de exogene variabelen, waarbij de fouten een seizoensgebonden ARIMA-proces volgen. Met één exogene variabele ziet het er zo uit:
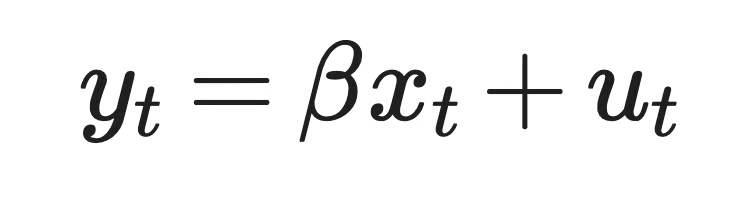
SARIMAX met één exogene variabele
Hier is y_t de elektriciteitsvraag in maand t, x_t de temperatuur in die maand, beta de temperatuurcoëfficiënt, en u_t het deel van de vraag dat temperatuur niet verklaart. De niet-seizoensgebonden en seizoensgebonden termen modelleren u_t.
In gewone taal: temperatuur verklaart een deel van de vraag, en de SARIMA-termen modelleren de rest.
Hier is een meer visueel overzicht:
SARIMAX-componenten
ARIMA vs. SARIMA vs. ARIMAX vs. SARIMAX
Deze vier modellen horen bij dezelfde familie. De verschillen zijn subtiel, maar je begrijpt ze na één keer lezen.
ARIMA modelleert een reeks op basis van eigen vorige waarden en eerdere voorspellingsfouten. SARIMA voegt daar seizoensgebonden termen aan toe, zodat het patronen kan modelleren die elke S tijdstappen terugkeren. ARIMAX voegt exogene variabelen toe aan ARIMA, maar heeft standaard geen seizoensgebonden termen. SARIMAX heeft beide.
Daarom kan SARIMAX de andere modellen voorstellen als speciale gevallen. Als je geen exogene variabelen doorgeeft, krijg je een SARIMA-model. Zet je alle seizoensordes op nul, dan krijg je een niet-seizoensgebonden ARIMAX-model. En zonder beide is het een ARIMA-model.
Helaas is de terminologie niet consistent tussen pakketten.
De leerboek-ARIMAX zet exogene variabelen rechtstreeks in de ARIMA-vergelijking, naast de vorige waarden van de reeks. statsmodels’ SARIMAX fit een regressie met SARIMA-fouten in plaats daarvan, zoals in de vorige sectie getoond. De twee vormen schatten verschillende coëfficiënten, dus dezelfde temperatuurvariabele kan een andere coëfficiënt krijgen afhankelijk van het pakket.
Class- en functienamen komen ook niet overeen. De ARIMA-klasse in statsmodels accepteert ook seizoensgebonden termen en exogene variabelen. In R behandelt het forecast-pakket externe regressoren via het xreg-argument van Arima() en auto.arima(). Onthoud daarom dat je moet controleren hoe elk pakket het model definieert voordat je resultaten tussen tools vergelijkt.
Hier is een korte recap:
| Seizoenspatroon? | Externe variabelen? | |
|---|---|---|
| ARIMA | Nee | Nee |
| SARIMA | Ja | Nee |
| ARIMAX | Niet standaard | Ja |
| SARIMAX | Ja | Ja |
Vergelijking van de ARIMA-modellengroep
Wanneer je SARIMAX gebruikt
SARIMAX is logisch als de doelvariabele een terugkerend seizoenspatroon heeft en externe variabelen de voorspelling kunnen verbeteren.
Bijvoorbeeld:
- Elektriciteitsvraag: Temperatuur en kalendereffecten zoals feestdagen, bovenop de jaarlijkse cyclus
- Retailverkopen: Promoties, prijzen en feestdagperiodes
- Hotelboekingen: Lokale evenementen en kamerprijzen, bovenop het jaarlijkse reisseizoen
- Openbaar vervoer-gebruik: Weer en schoolvakanties, bovenop een wekelijks patroon in dagdata
Maar SARIMAX is niet altijd de juiste keuze. In deze twee gevallen kan een eenvoudiger model hetzelfde doen:
- Geen betekenisvolle seizoensinvloed: Als de reeks geen patroon herhaalt, voegen seizoentermen alleen te schatten parameters toe. ARIMA of ARIMAX is dan genoeg
- Voorspellers verbeteren nauwkeurigheid niet: Als exogene variabelen de fout op een apart gehouden testperiode niet verlagen, haal ze weg en gebruik SARIMA. Een betere fit op de trainingsdata telt niet
Wat je hier moet onthouden, is dat SARIMAX waarden nodig heeft voor elke exogene variabele in de voorspelperiode.
Sommige waarden zijn van tevoren bekend, bijvoorbeeld feestdagen of geplande promoties. Andere, zoals temperatuur, moet je apart voorspellen voordat SARIMAX ze kan gebruiken. Als je voor een voorspeller geen toekomstige waarden kunt krijgen, kun je die niet in de voorspelling gebruiken.
Hoe bouw je een SARIMAX-model in Python
In deze sectie bouw ik een SARIMAX-model met statsmodels, van ruwe data tot een 12-maandsvoorspelling.
Het voorbeeld gebruikt synthetische maandelijkse elektriciteitsvraag met temperatuur als externe variabele. Het is klein en reproduceerbaar, en volgt hetzelfde verhaal als de rest van het artikel.
Data voorbereiden
De dataset beslaat tien jaar aan maanddata, van januari 2015 tot en met december 2024.
De vraag heeft een opwaartse trend, een jaarlijks kalenderpatroon dat langzaam in de tijd verandert, een weereffect en ruis. Twee temperatuurmetingen ontbreken expres, zodat je ziet hoe je met gaten omgaat:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import warnings

warnings.filterwarnings("ignore")

rng = np.random.default_rng(10)

# Monthly timestamps from January 2015 to December 2024
dates = pd.date_range(start="2015-01-01", periods=120, freq="MS")
month = dates.month.to_numpy()

# Average monthly temperature in degrees Celsius
temperature = 12 + 11 * np.sin(2 * np.pi * (month - 4) / 12) + rng.normal(0, 2, 120)

# Calendar pattern that repeats every year and changes slowly over time
calendar_effect = 15 * np.cos(2 * np.pi * (month - 1) / 12)
for t in range(12, 120):
    calendar_effect[t] = calendar_effect[t - 12] + rng.normal(0, 2.5)

# Short-term noise where each month carries over part of the previous one
noise = np.zeros(120)
for t in range(1, 120):
    noise[t] = 0.5 * noise[t - 1] + rng.normal(0, 6)

# Demand in GWh: upward trend, calendar pattern, weather effect, and noise
trend = np.linspace(500, 560, 120)
heating_demand = 6 * np.clip(18 - temperature, 0, None)
cooling_demand = 9 * np.clip(temperature - 18, 0, None)
demand = trend + calendar_effect + heating_demand + cooling_demand + noise

df = pd.DataFrame(
    {"demand_gwh": demand.round(1), "temperature": temperature.round(1)},
    index=dates,
)

# Two missing temperature readings
df.loc[["2018-07-01", "2021-02-01"], "temperature"] = np.nan

print(df.head())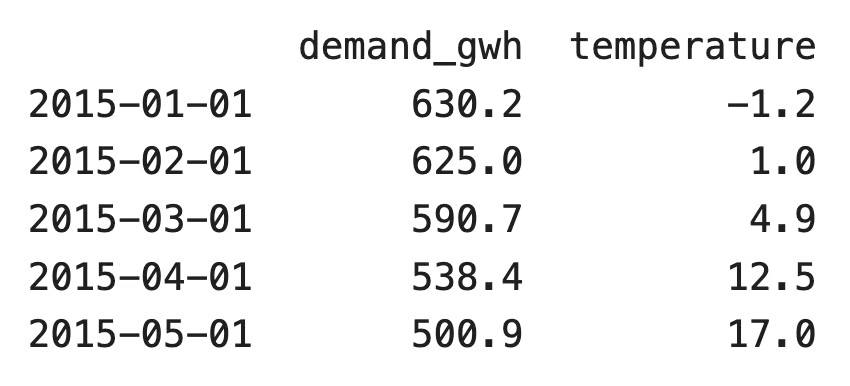
De eerste vijf rijen van de dataset
Of, als je liever een visueel overzicht hebt:
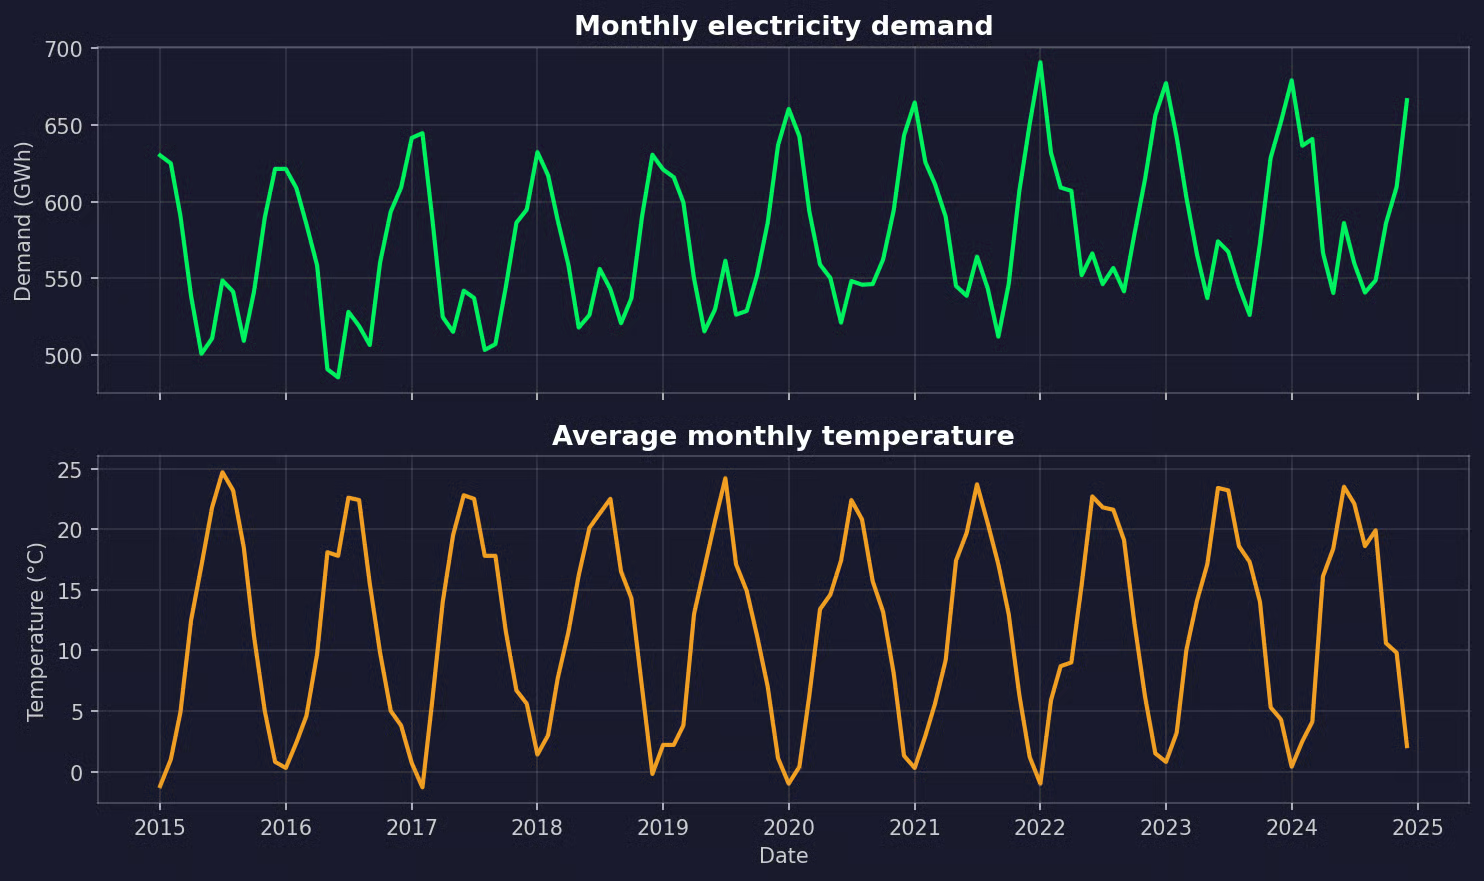
De temperatuurdataset
Werk je met je eigen data, laad die dan met pd.read_csv() en zet de datumkolom als index. De rest van de workflow blijft hetzelfde.
SARIMAX heeft een tijdsindex met een consistente frequentie nodig. De methode .asfreq() zet die op maandelijks en voegt een lege rij in voor elke ontbrekende maand. Daarna kun je de gaten tellen en opvullen:
df = df.asfreq("MS")
print(df.isna().sum())

df["temperature"] = df["temperature"].interpolate()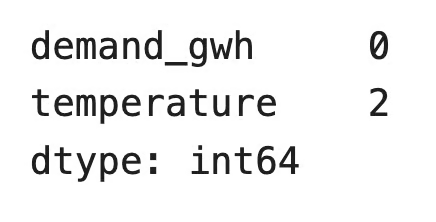
Temperatuurgaten interpoleren
Lineaire interpolatie werkt hier omdat temperatuur vloeiend van maand tot maand verandert. Doe hetzelfde niet voor de doelvariabele als daar grote stukken van ontbreken. Je zou het model dan trainen op verzonnen waarden.
Dan de exogene variabelen. De vraag stijgt wanneer het koud is en wanneer het warm is, maar een rechte-lijn-regressie op ruwe temperatuur kan geen U-vorm modelleren. Daarom splits ik temperatuur op in twee features:
- Verwarmingsgraden: Hoeveel graden de gemiddelde temperatuur onder 18 graden Celsius ligt, en anders nul
- Koelingsgraden: Hoeveel graden de gemiddelde temperatuur boven 18 graden Celsius ligt, en anders nul
df["heating_degrees"] = (18 - df["temperature"]).clip(lower=0)
df["cooling_degrees"] = (df["temperature"] - 18).clip(lower=0)
Splits de data nu in het doel y en de exogene variabelen X. De splitsing moet chronologisch zijn: het model traint op het verleden en wordt getest op de toekomst. Een willekeurige splitsing zou toekomstige informatie laten lekken in de training:
y = df["demand_gwh"]
X = df[["heating_degrees", "cooling_degrees"]]

y_train, y_test = y[:"2022-12"], y["2023-01":]
X_train, X_test = X[:"2022-12"], X["2023-01":]

print(f"Train: {len(y_train)} months, Test: {len(y_test)} months")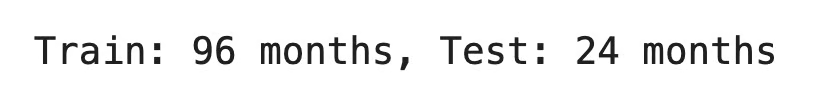
Train/test-splitsing
Wat je hier moet onthouden, is dat X_test daadwerkelijk geobserveerde temperaturen bevat. In een echte voorspelling zou je die niet van tevoren weten - hooguit heb je een weersverwachting. Dat betekent dat de testscore die je later ziet optimistisch is. Gebruik geobserveerde waarden van voorspellers alleen voor evaluatie als diezelfde waarden ook op voorspeltijd beschikbaar zijn, zoals feestdagen of geplande prijzen.
Seizoensinvloed en stationariteit verkennen
Begin met een plot. Je zoekt trends, seizoenscycli en plotselinge veranderingen:
from statsmodels.tsa.seasonal import seasonal_decompose

fig, ax = plt.subplots(figsize=(10, 4))
y_train.plot(ax=ax, title="Monthly electricity demand (GWh)")
plt.show()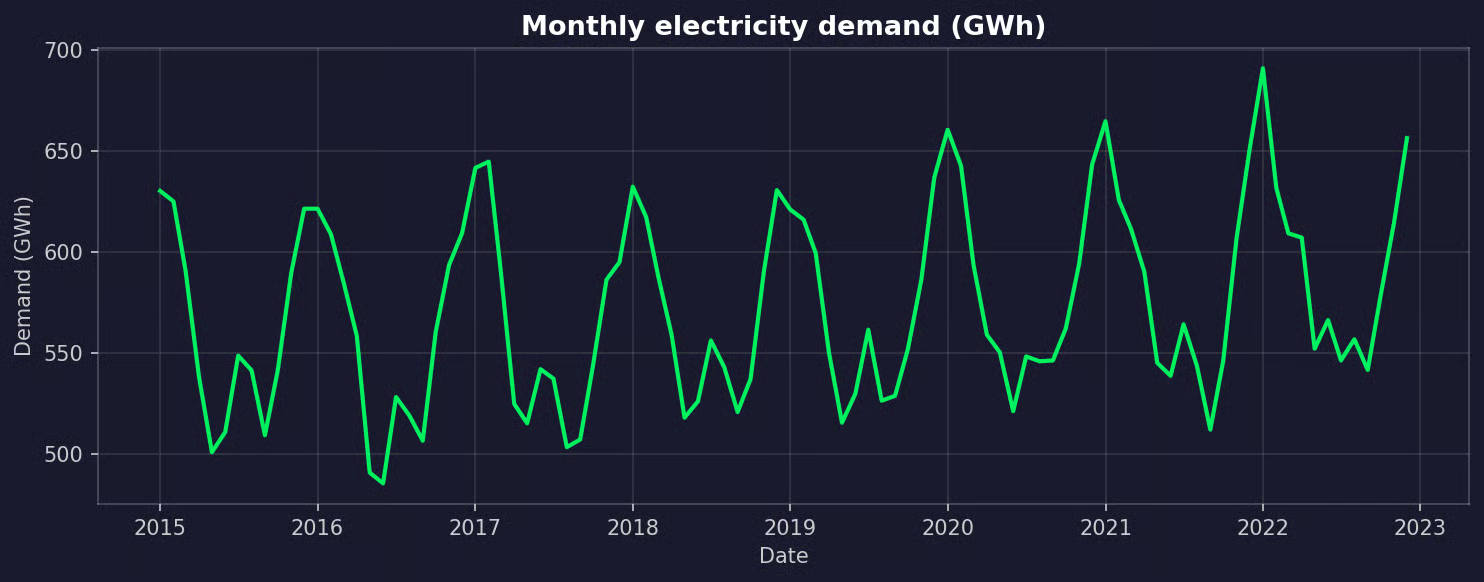
Maandelijkse elektriciteitsvraag in de trainingsperiode
De vraag stijgt in de tijd en piekt elke winter met een kleinere piek in de zomer. Het patroon herhaalt zich elke 12 maanden.
Een seizoensdecompositie splitst de reeks in trend-, seizoens- en residucomponenten, zodat je de seizoensperiode S kunt bevestigen:
decomposition = seasonal_decompose(y_train, model="additive", period=12)
decomposition.plot()
plt.show()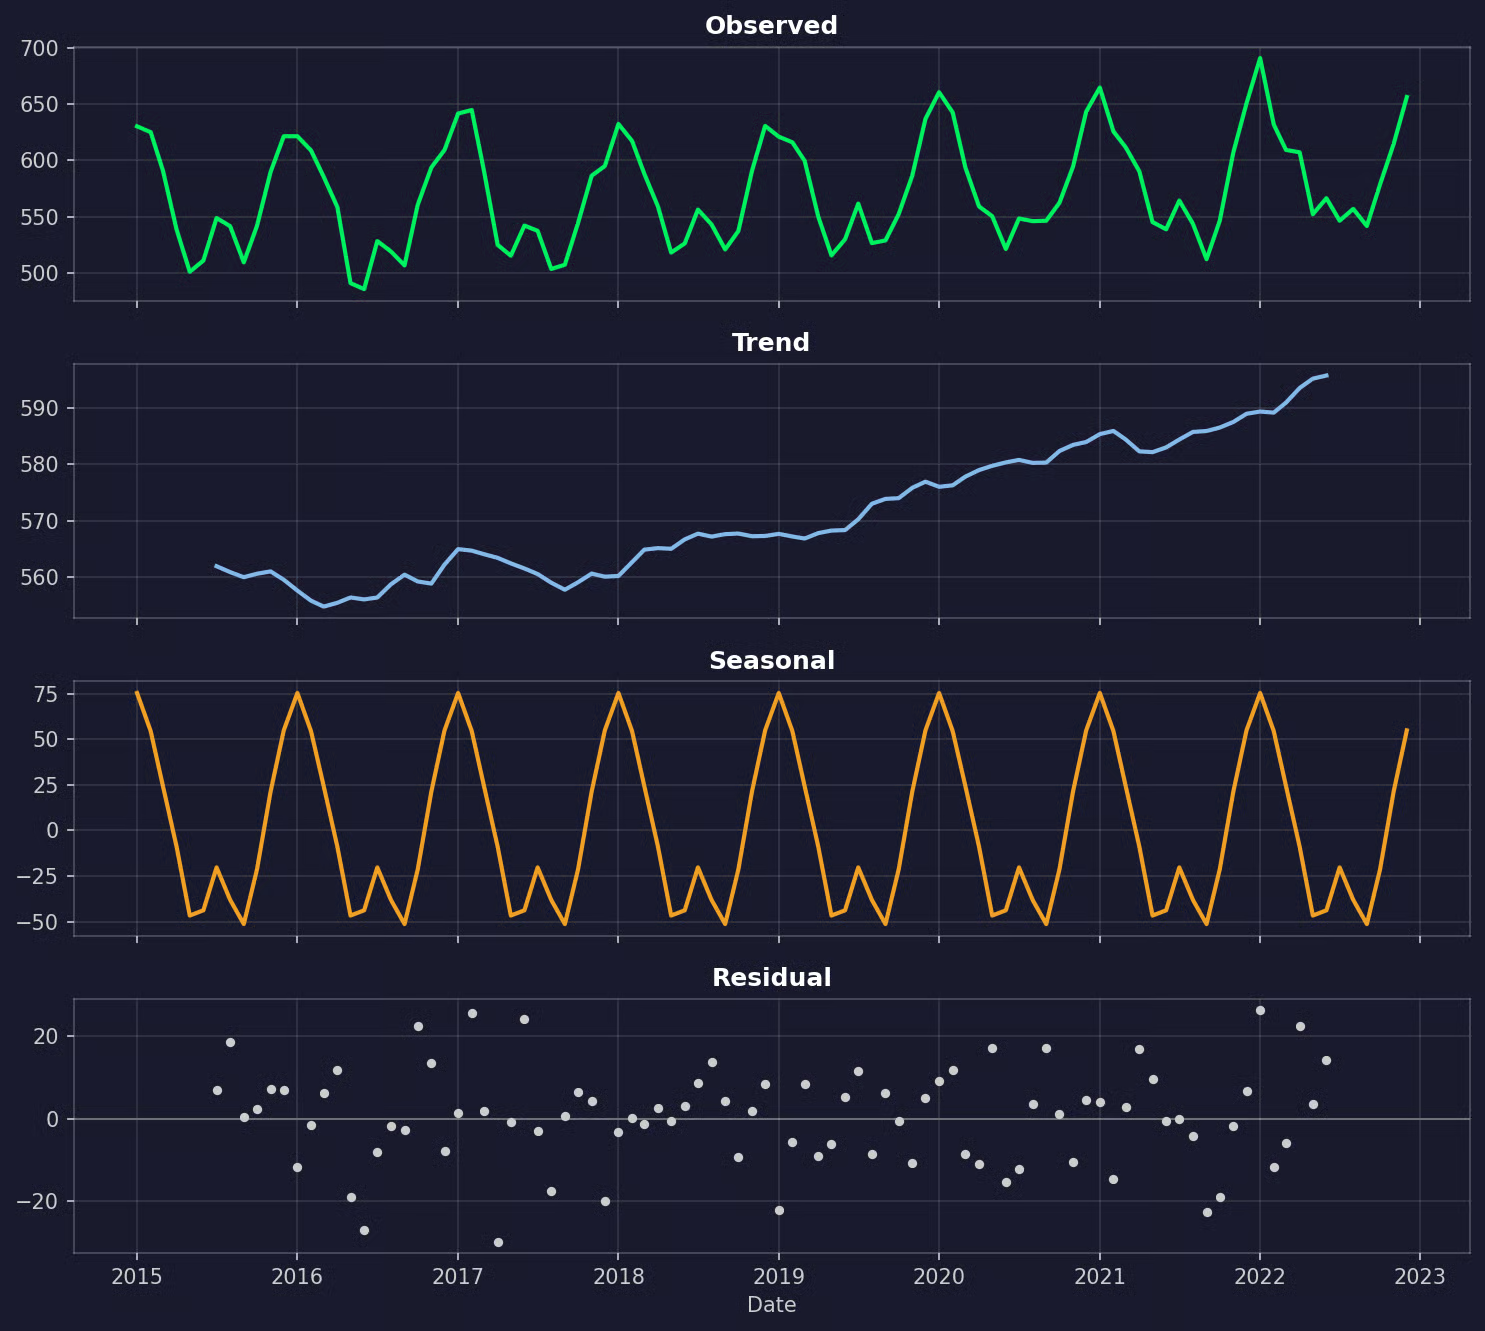
Seizoensdecompositie van de elektriciteitsvraag
De seizoenscomponent herhaalt zich jaarlijks, dus S = 12.
Modellen uit de ARIMA-familie hebben een stationaire reeks nodig - eentje waarvan het gemiddelde en de variantie niet in de tijd veranderen. De vraag is niet stationair omdat er een trend en een seizoenscyclus in zitten.
Differentiëren is een manier om daarmee om te gaan:
-
Regulier differentiëren (
d): Trekt de waarde van vorige maand af van die van deze maand. Het verwijdert een trend -
Seizoensdifferentie (
D): Trekt de waarde van dezelfde maand vorig jaar af. Het verwijdert een terugkerend seizoenspatroon en verwijdert ook een lineaire trend
De Augmented Dickey-Fuller (ADF)-test controleert op stationariteit. De nulhypothese is dat de reeks niet stationair is, dus een kleine p-waarde (onder 0,05) is bewijs dat ze wel stationair is:
from statsmodels.tsa.stattools import adfuller

series_versions = {
    "Original": y_train,
    "Seasonally differenced (D=1)": y_train.diff(12).dropna(),
    "Both differences (d=1, D=1)": y_train.diff().diff(12).dropna(),
}

for name, series in series_versions.items():
    adf_stat, p_value = adfuller(series)[:2]
    print(f"{name}: ADF statistic = {adf_stat:.2f}, p-value = {p_value:.4f}")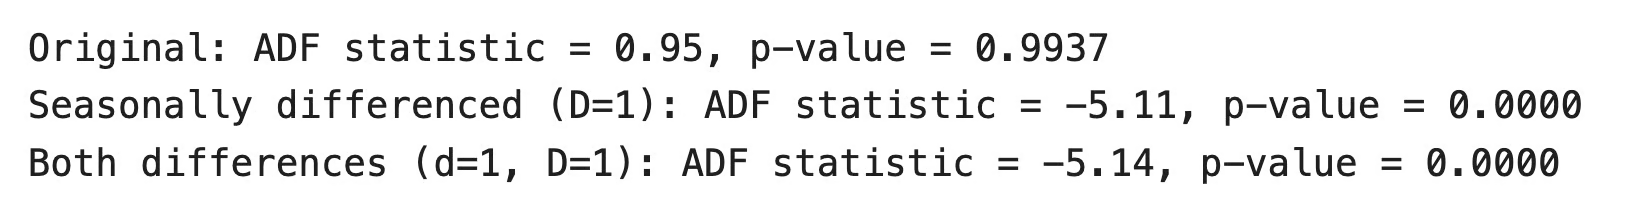
ADF-testresultaat
De originele reeks is niet stationair. Seizoensdifferentie alleen lost het op, dus regulier differentiëren voegt daar niets aan toe. Gebruik de kleinste hoeveelheid differentiëren die werkt - extra verschillen voegen ruis toe aan de reeks en maken het model lastiger te fitten.
De keuze is dus d = 0 en D = 1.
Maar behandel de ADF-test alleen als ondersteunend bewijs. Die vertelt je niets over p, q, P of Q, en met korte reeksen kan de uitkomst verschillen afhankelijk van de instellingen.
Kandidaatparameters selecteren
ACF- en PACF-plots helpen je kandidaatwaarden voor de overige ordes te kiezen:
-
ACF (autocorrelatiefunctie): Toont de correlatie tussen de reeks en haar eigen vertraagde waarden. Spikes in de ACF wijzen op moving average-termen,
qop korte vertragingen enQop seizoensvertragingen -
PACF (partiële autocorrelatiefunctie): Toont dezelfde correlatie, maar verwijdert het effect van de tussenliggende vertragingen. Spikes in de PACF wijzen op autoregressieve termen,
pop korte vertragingen enPop seizoensvertragingen
Je zou beide moeten plotten voor de seizoensgedifferentieerde reeks, want daarmee werkt het model:
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

y_seasonal_diff = y_train.diff(12).dropna()

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
plot_acf(y_seasonal_diff, lags=24, ax=axes[0])
plot_pacf(y_seasonal_diff, lags=24, ax=axes[1])
plt.show()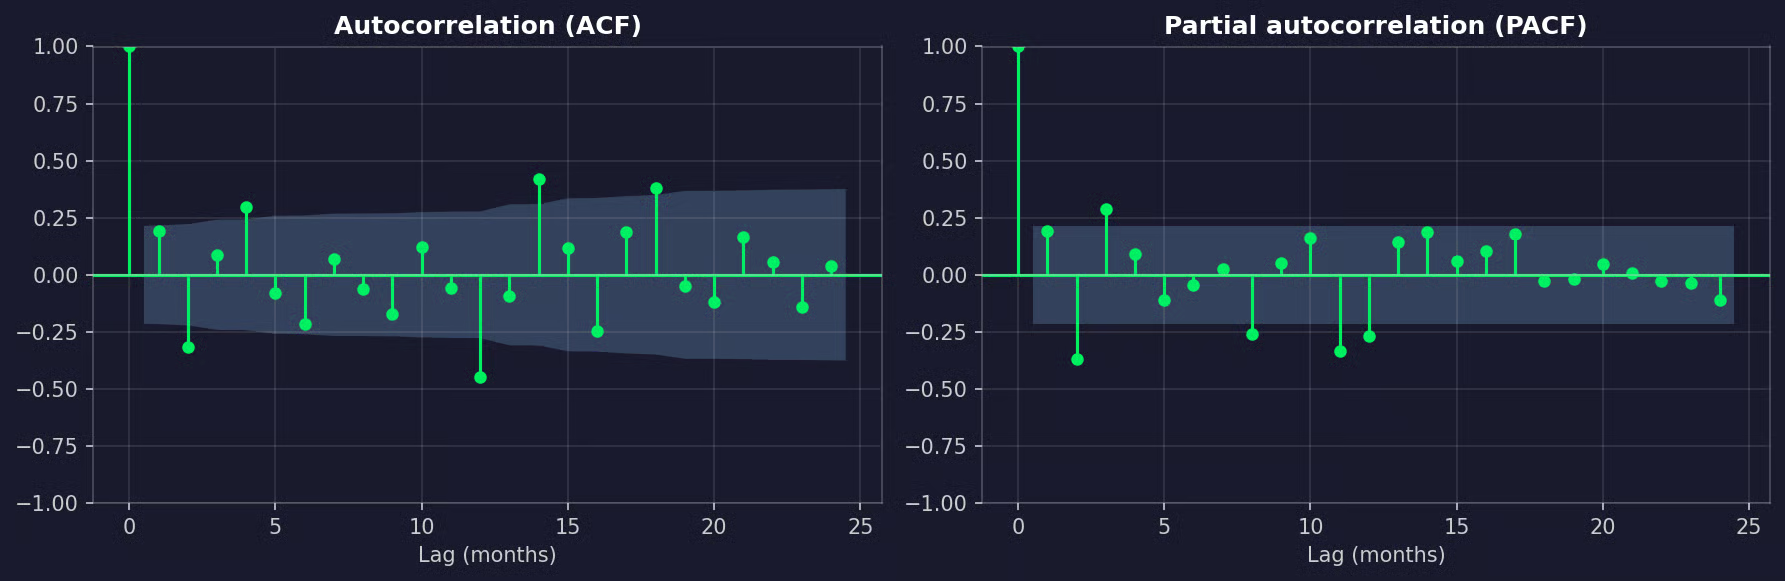
ACF- en PACF-plots van seizoensgedifferentieerde elektriciteitsvraag
De ACF heeft een duidelijke negatieve spike op vertraging 12 en niets op 24. Dat is het typische teken van een seizoens moving average-term, dus Q = 1 is een goede kandidaat. Beide plots laten ook een paar spikes op korte vertragingen zien, dus p en q zijn het testen waard.
De volgende stap is een kleine set kandidaatmodellen fitten en ze vergelijken met AIC of BIC. Beide scoren hoe goed een model de trainingsdata past en straffen extra parameters. Lager is beter, en BIC straft complexiteit meer dan AIC:
import itertools
from statsmodels.tsa.statespace.sarimax import SARIMAX

candidates = []
for p, q, P, Q in itertools.product([0, 1], [0, 1], [0, 1], [0, 1]):
    candidate = SARIMAX(
        y_train,
        exog=X_train,
        order=(p, 0, q),
        seasonal_order=(P, 1, Q, 12),
        trend="c",
    ).fit(disp=False)
    candidates.append({
        "order": (p, 0, q),
        "seasonal_order": (P, 1, Q, 12),
        "AIC": round(candidate.aic, 1),
        "BIC": round(candidate.bic, 1),
    })

print(pd.DataFrame(candidates).sort_values("AIC").head(5).to_string(index=False))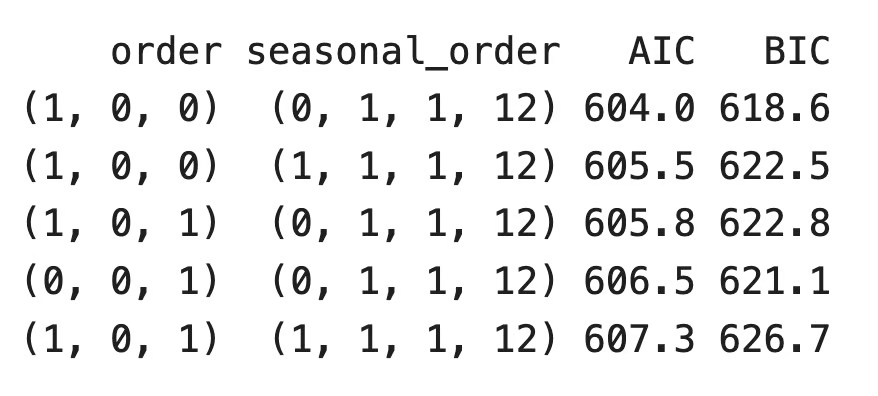
AIC- en BIC-resultaten
SARIMAX(1, 0, 0)(0, 1, 1, 12) wint op zowel AIC als BIC. Het is ook een van de eenvoudigste modellen in de lijst.
Het argument trend="c" voegt een constante toe. Met seizoensdifferentie modelleert een constante de jaar-op-jaar toename in vraag.
Er zijn tools zoals auto_arima() uit de pmdarima-bibliotheek die deze zoekslag voor je doen. Handig voor een eerste ronde, maar AIC en BIC meten alleen de fit op de trainingsdata. Voor je een model vertrouwt, test het op data die het nog niet heeft gezien.
Het model fitten
Geef de doelvariabele als eerste argument en de exogene variabelen via exog. Het argument order neemt (p, d, q), en seasonal_order neemt (P, D, Q, S):
model = SARIMAX(
    y_train,
    exog=X_train,
    order=(1, 0, 0),
    seasonal_order=(0, 1, 1, 12),
    trend="c",
)
results = model.fit(disp=False)
print(results.summary())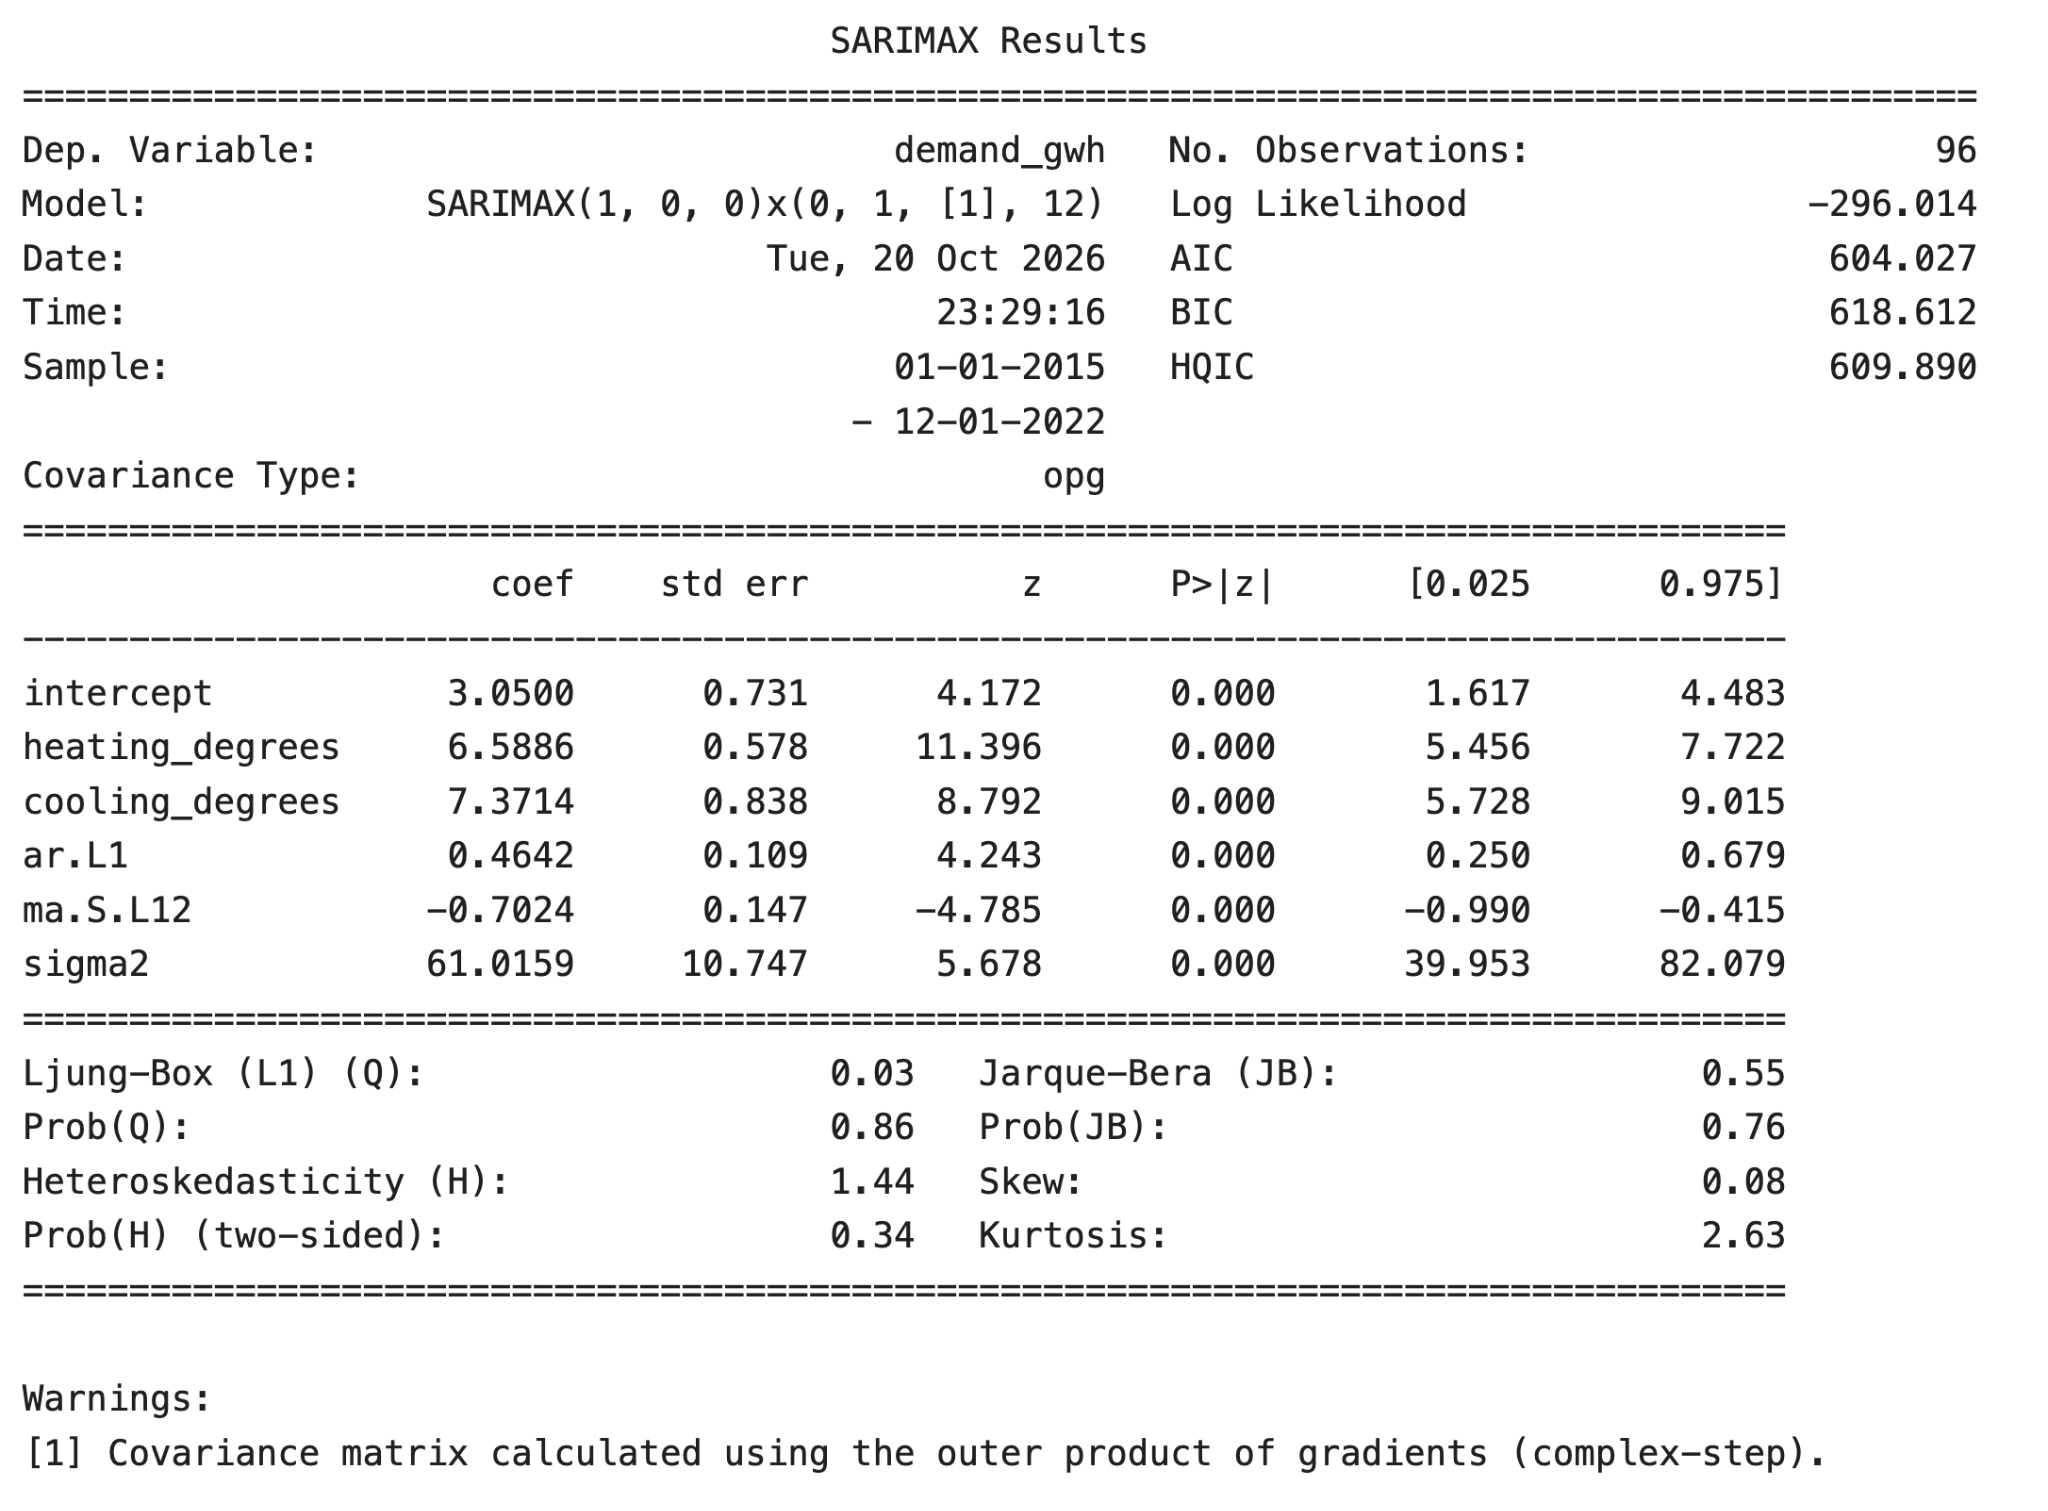
SARIMAX-modeloverzicht
Zo lees je de coëfficiëntentabel:
-
heating_degrees: Elke extra verwarmingsgraad gaat samen met ongeveer 6,6 GWh extra vraag, met de rest van het model vastgezet -
cooling_degrees: Elke extra koelingsgraad gaat samen met ongeveer 7,4 GWh extra vraag -
ar.L1: Ongeveer 46% van het onverklaarde verschil van vorige maand werkt door in deze maand -
ma.S.L12: De seizoens moving average-term, die de voorspelling corrigeert op basis van de fout van dezelfde maand vorig jaar -
sigma2: De variantie van de overblijvende ruis
Alle coëfficiënten hebben p-waarden dicht bij nul, dus elke term voegt iets toe aan het model.
Maar deze coëfficiënten beschrijven relaties binnen het gefitte model, geen oorzaken. Hier heb ik de data gegenereerd met temperatuur als oorzaak van vraag, dus de lezing is veilig. In echte data kan een voorspeller belangrijk lijken omdat die samen beweegt met iets dat het model niet ziet.
Het model diagnosticeren en evalueren
Een goed model laat residuen achter die op willekeurige ruis lijken. Als er nog een patroon in de residuen zit, heeft het model iets gemist.
De methode .plot_diagnostics() geeft je vier plots in één keer:
from statsmodels.stats.diagnostic import acorr_ljungbox

results.plot_diagnostics(figsize=(12, 8))
plt.show()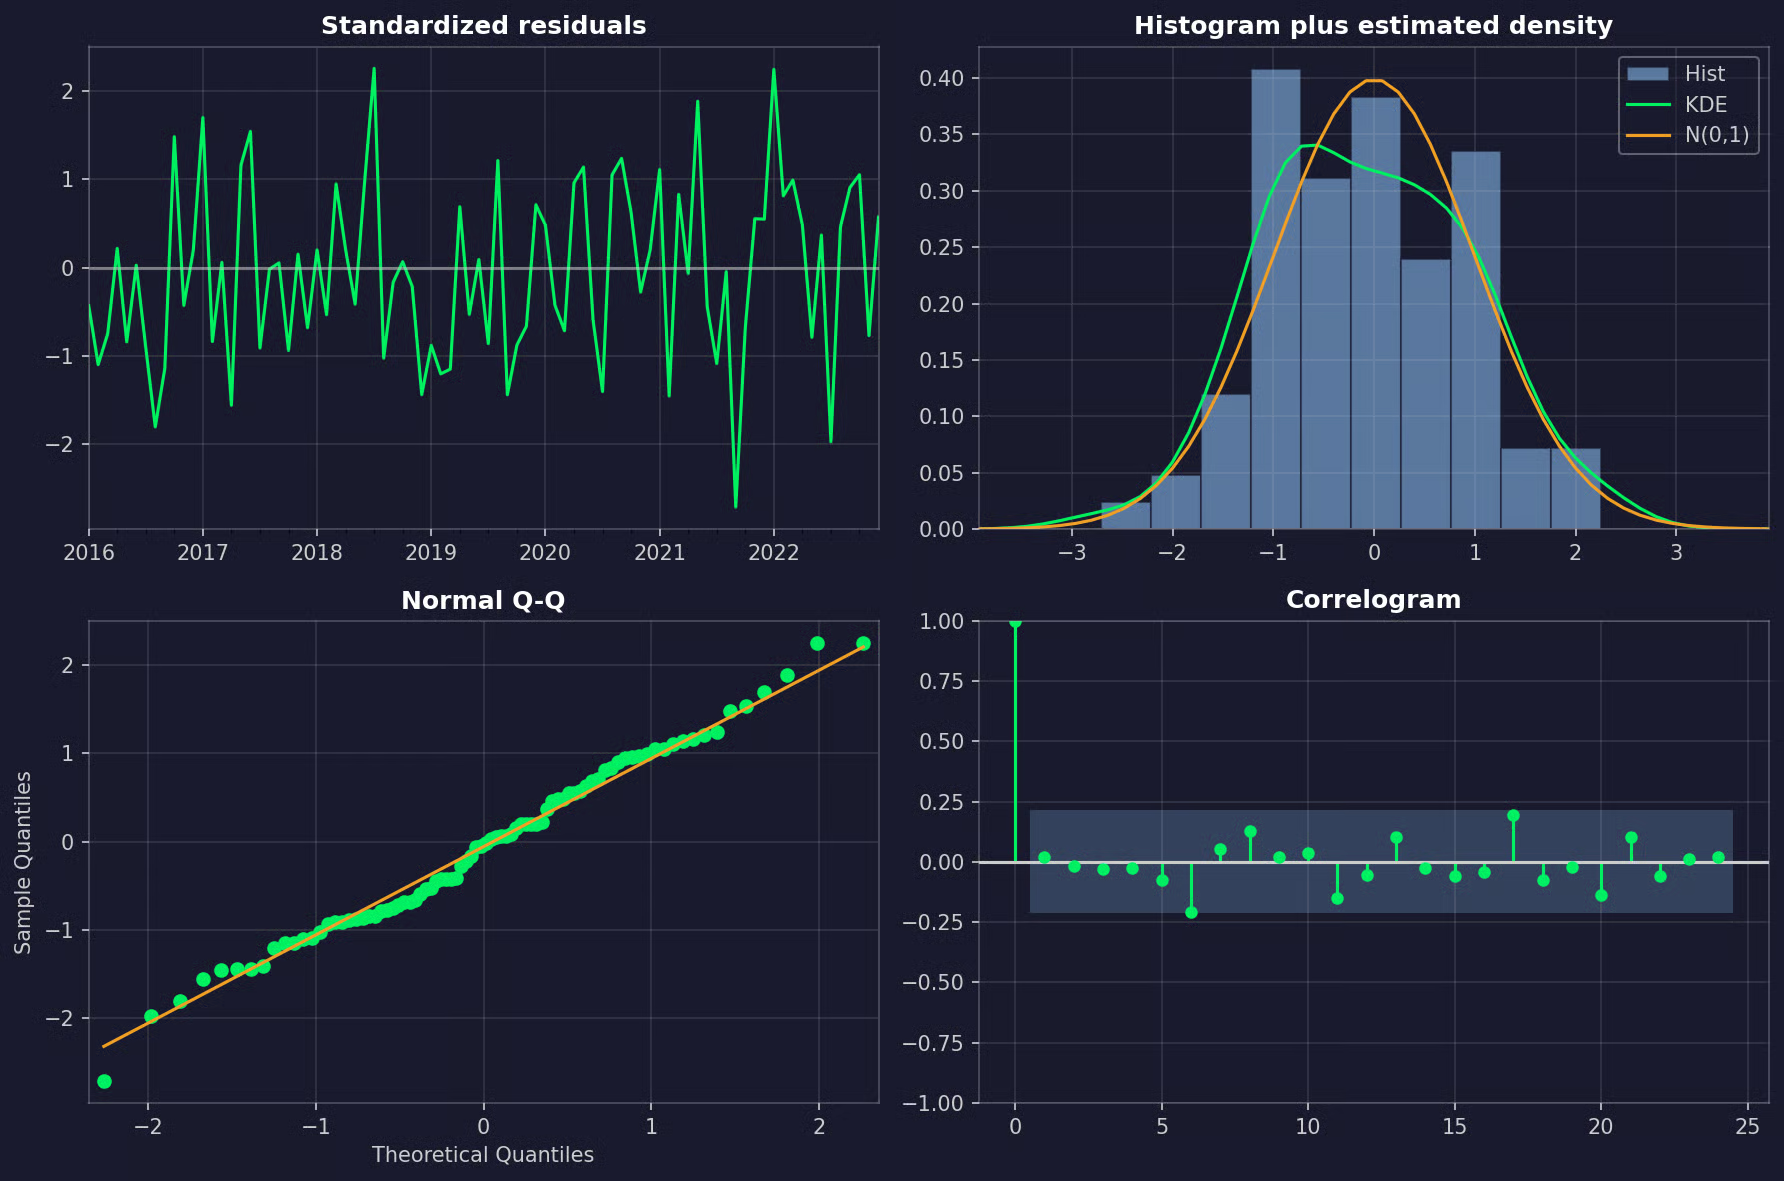
Diagnostische plot van residuen
Hier let je op:
- Gestandaardiseerde residuen: Geen trend, geen terugkerend patroon en geen periodes waarin de spreiding veel groter wordt
- Histogram en Q-Q-plot: Punten dicht bij een normale verdeling
- Correlogram: Geen spikes buiten de betrouwbaarheidsband, vooral niet op vertraging 12 - een spike daar betekent dat het model de seizoensinvloed niet volledig heeft afgehandeld
De Ljung-Box-test geeft je dezelfde controle als getal. De nulhypothese is dat de residuen geen autocorrelatie hebben tot een gegeven vertraging, dus je wilt grote p-waarden:
# Sla de eerste 13 residuen over, die uit de opstartperiode van differentiëren komen
print(acorr_ljungbox(results.resid[13:], lags=[12, 24]))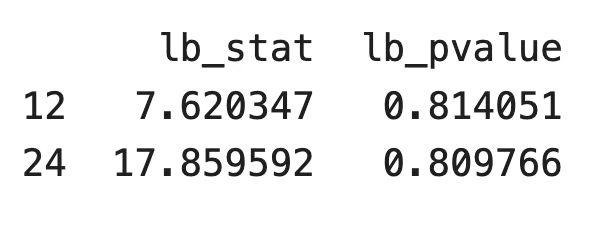
De Ljung-Box-testresultaten
Beide p-waarden liggen ruim boven 0,05, dus de residuen lijken op ruis.
Nu het belangrijkste deel - nauwkeurigheid op data die het model niet heeft gezien. De methode .get_forecast() voorspelt de 24 testmaanden, en heeft daarvoor de exogene waarden van die maanden nodig.
Een voorspelling op zich zegt weinig, dus ik vergelijk SARIMAX met twee baselines:
- Seizoens-naïeve voorspelling: Herhaalt de waarden van de laatste 12 maanden van de trainingsdata
- SARIMA: Ditzelfde model, maar zonder de exogene variabelen
from sklearn.metrics import mean_absolute_error, root_mean_squared_error

sarimax_pred = results.get_forecast(steps=len(y_test), exog=X_test).predicted_mean

# Baseline 1: herhaal de laatste 12 geobserveerde maanden
naive_pred = pd.Series(np.tile(y_train[-12:].to_numpy(), 2), index=y_test.index)

# Baseline 2: hetzelfde model zonder exogene variabelen
sarima_results = SARIMAX(
    y_train, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)
sarima_pred = sarima_results.get_forecast(steps=len(y_test)).predicted_mean

for name, pred in [("SARIMAX", sarimax_pred), ("SARIMA", sarima_pred), ("Seasonal naive", naive_pred)]:
    mae = mean_absolute_error(y_test, pred)
    rmse = root_mean_squared_error(y_test, pred)
    print(f"{name:<15} MAE = {mae:.2f} GWh, RMSE = {rmse:.2f} GWh")

fig, ax = plt.subplots(figsize=(10, 4))
y_train["2020":].plot(ax=ax, label="Train")
y_test.plot(ax=ax, label="Test")
sarimax_pred.plot(ax=ax, label="SARIMAX", linestyle="--")
naive_pred.plot(ax=ax, label="Seasonal naive", linestyle=":")
ax.legend()
plt.show()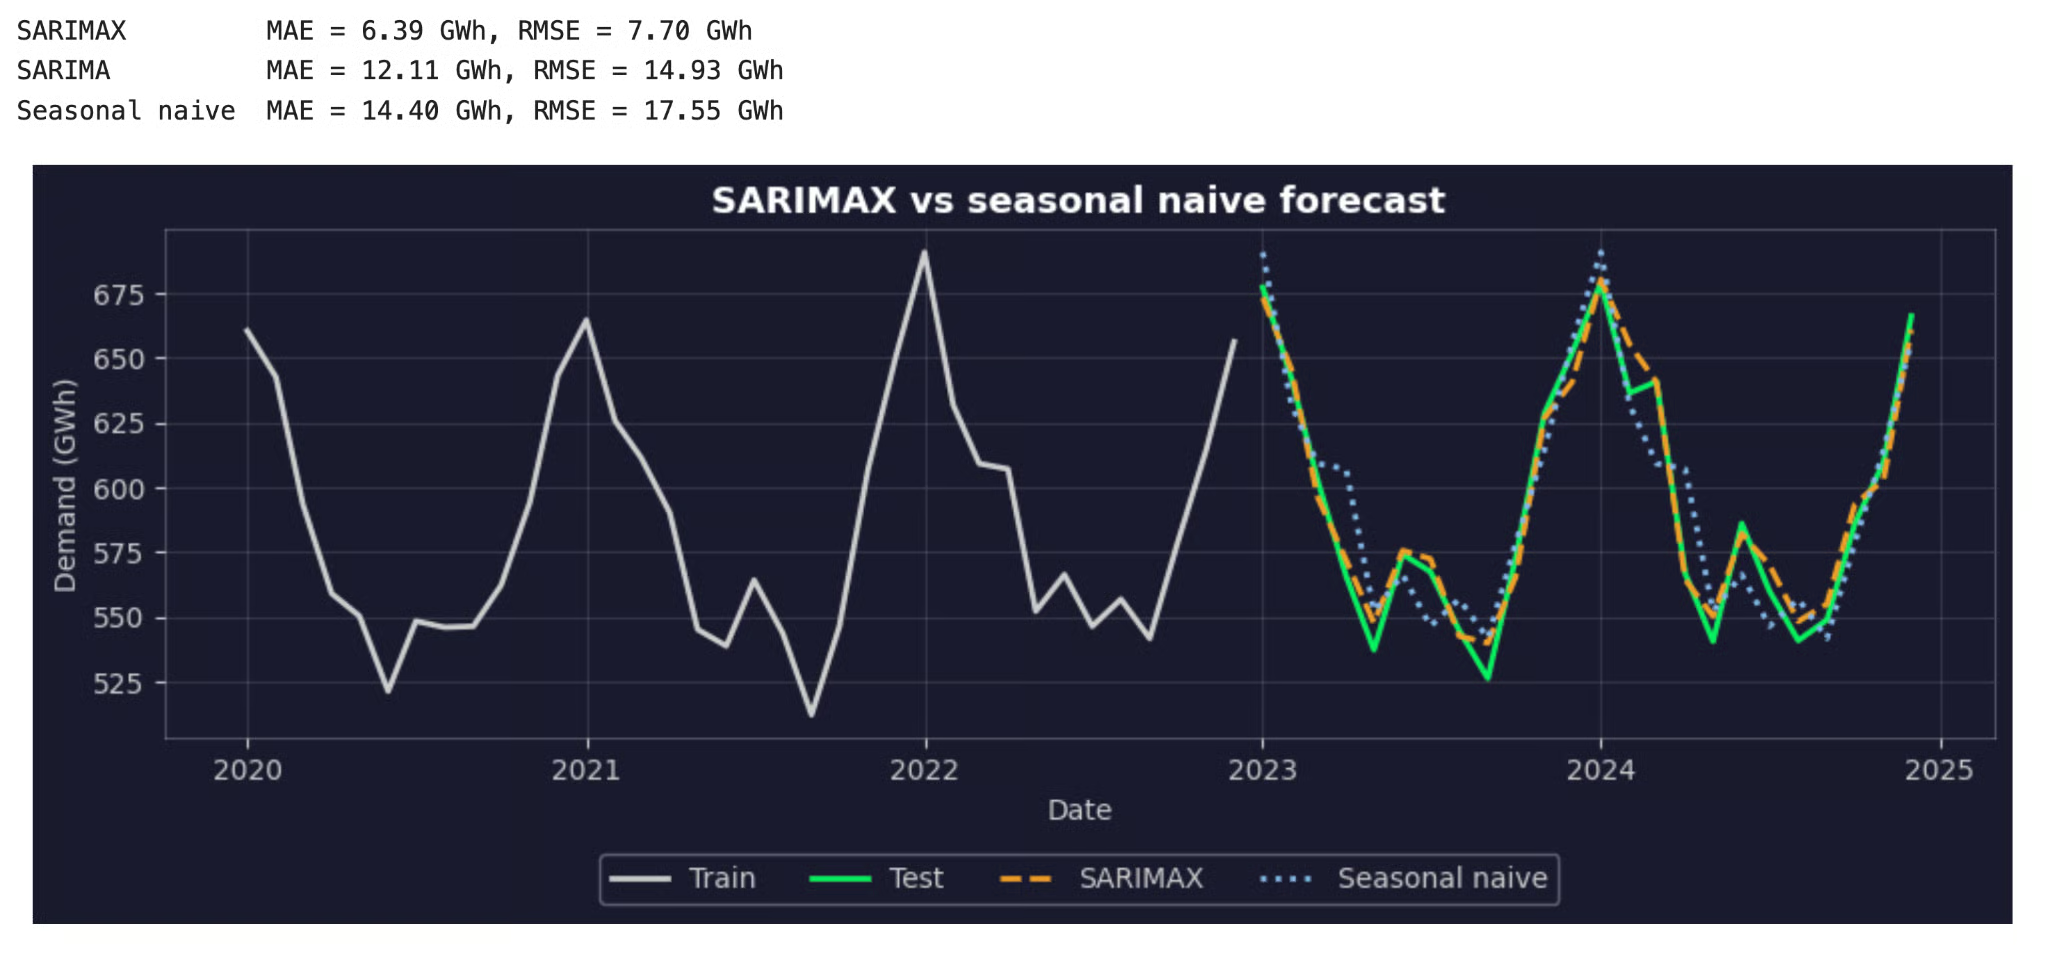
SARIMAX- en seizoens-naïeve voorspellingen versus daadwerkelijke vraag in de testset
MAE (mean absolute error) is de gemiddelde grootte van de fout in GWh. RMSE (root mean squared error) bestraft grote fouten zwaarder.
SARIMAX heeft ongeveer de helft van de fout van SARIMA op beide metrics. Alleen seizoentermen kunnen een uitzonderlijk koude januari of hete juli niet voorspellen, en de temperatuurfeatures wel.
Onthoud: dit resultaat gebruikt geobserveerde testperiode-temperaturen. Met weersverwachtingen in hun plaats zou het verschil kleiner zijn.
Toekomstige waarden voorspellen
Als je tevreden bent met het model, fit het dan opnieuw op alle data, zodat de voorspelling start vanaf de meest recente maand.
Voorspel vervolgens met .get_forecast(). Je hebt een waarde nodig voor elke exogene variabele in elke toekomstige maand. Als er eentje ontbreekt, geeft statsmodels een foutmelding.
Waar die waarden vandaan komen, hangt af van de variabele. Bijvoorbeeld:
- Bekende kalenderfeatures: Feestdagen en het aantal werkdagen zijn jaren vooruit bekend
- Geplande zakelijke beslissingen: Prijzen en promoties zijn bekend als je team ze al heeft ingepland
- Weer: Temperatuur heeft een aparte voorspelling nodig, van een weerdienst of van een ander model
- Historische gemiddelden: Als je niets beters hebt, gebruik dan de gemiddelde waarde per kalendermaand uit verleden data
Ik gebruik hier de laatste optie als stand-in voor een weersverwachting:
final_results = SARIMAX(
    y, exog=X, order=(1, 0, 0), seasonal_order=(0, 1, 1, 12), trend="c"
).fit(disp=False)

future_dates = pd.date_range(start="2025-01-01", periods=12, freq="MS")

# Stand-in for a weather forecast: the average temperature of each calendar month
monthly_normals = df.groupby(df.index.month)["temperature"].mean()
future_temperature = monthly_normals.loc[future_dates.month].to_numpy()

X_future = pd.DataFrame({
    "heating_degrees": np.clip(18 - future_temperature, 0, None),
    "cooling_degrees": np.clip(future_temperature - 18, 0, None),
}, index=future_dates)

forecast = final_results.get_forecast(steps=12, exog=X_future)
forecast_df = pd.concat([forecast.predicted_mean.rename("forecast"), forecast.conf_int(alpha=0.05)], axis=1)
print(forecast_df.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
y["2021":].plot(ax=ax, label="Observed")
forecast.predicted_mean.plot(ax=ax, label="Forecast")
ci = forecast.conf_int(alpha=0.05)
ax.fill_between(ci.index, ci.iloc[:, 0], ci.iloc[:, 1], alpha=0.3, label="95% interval")
ax.legend()
plt.show()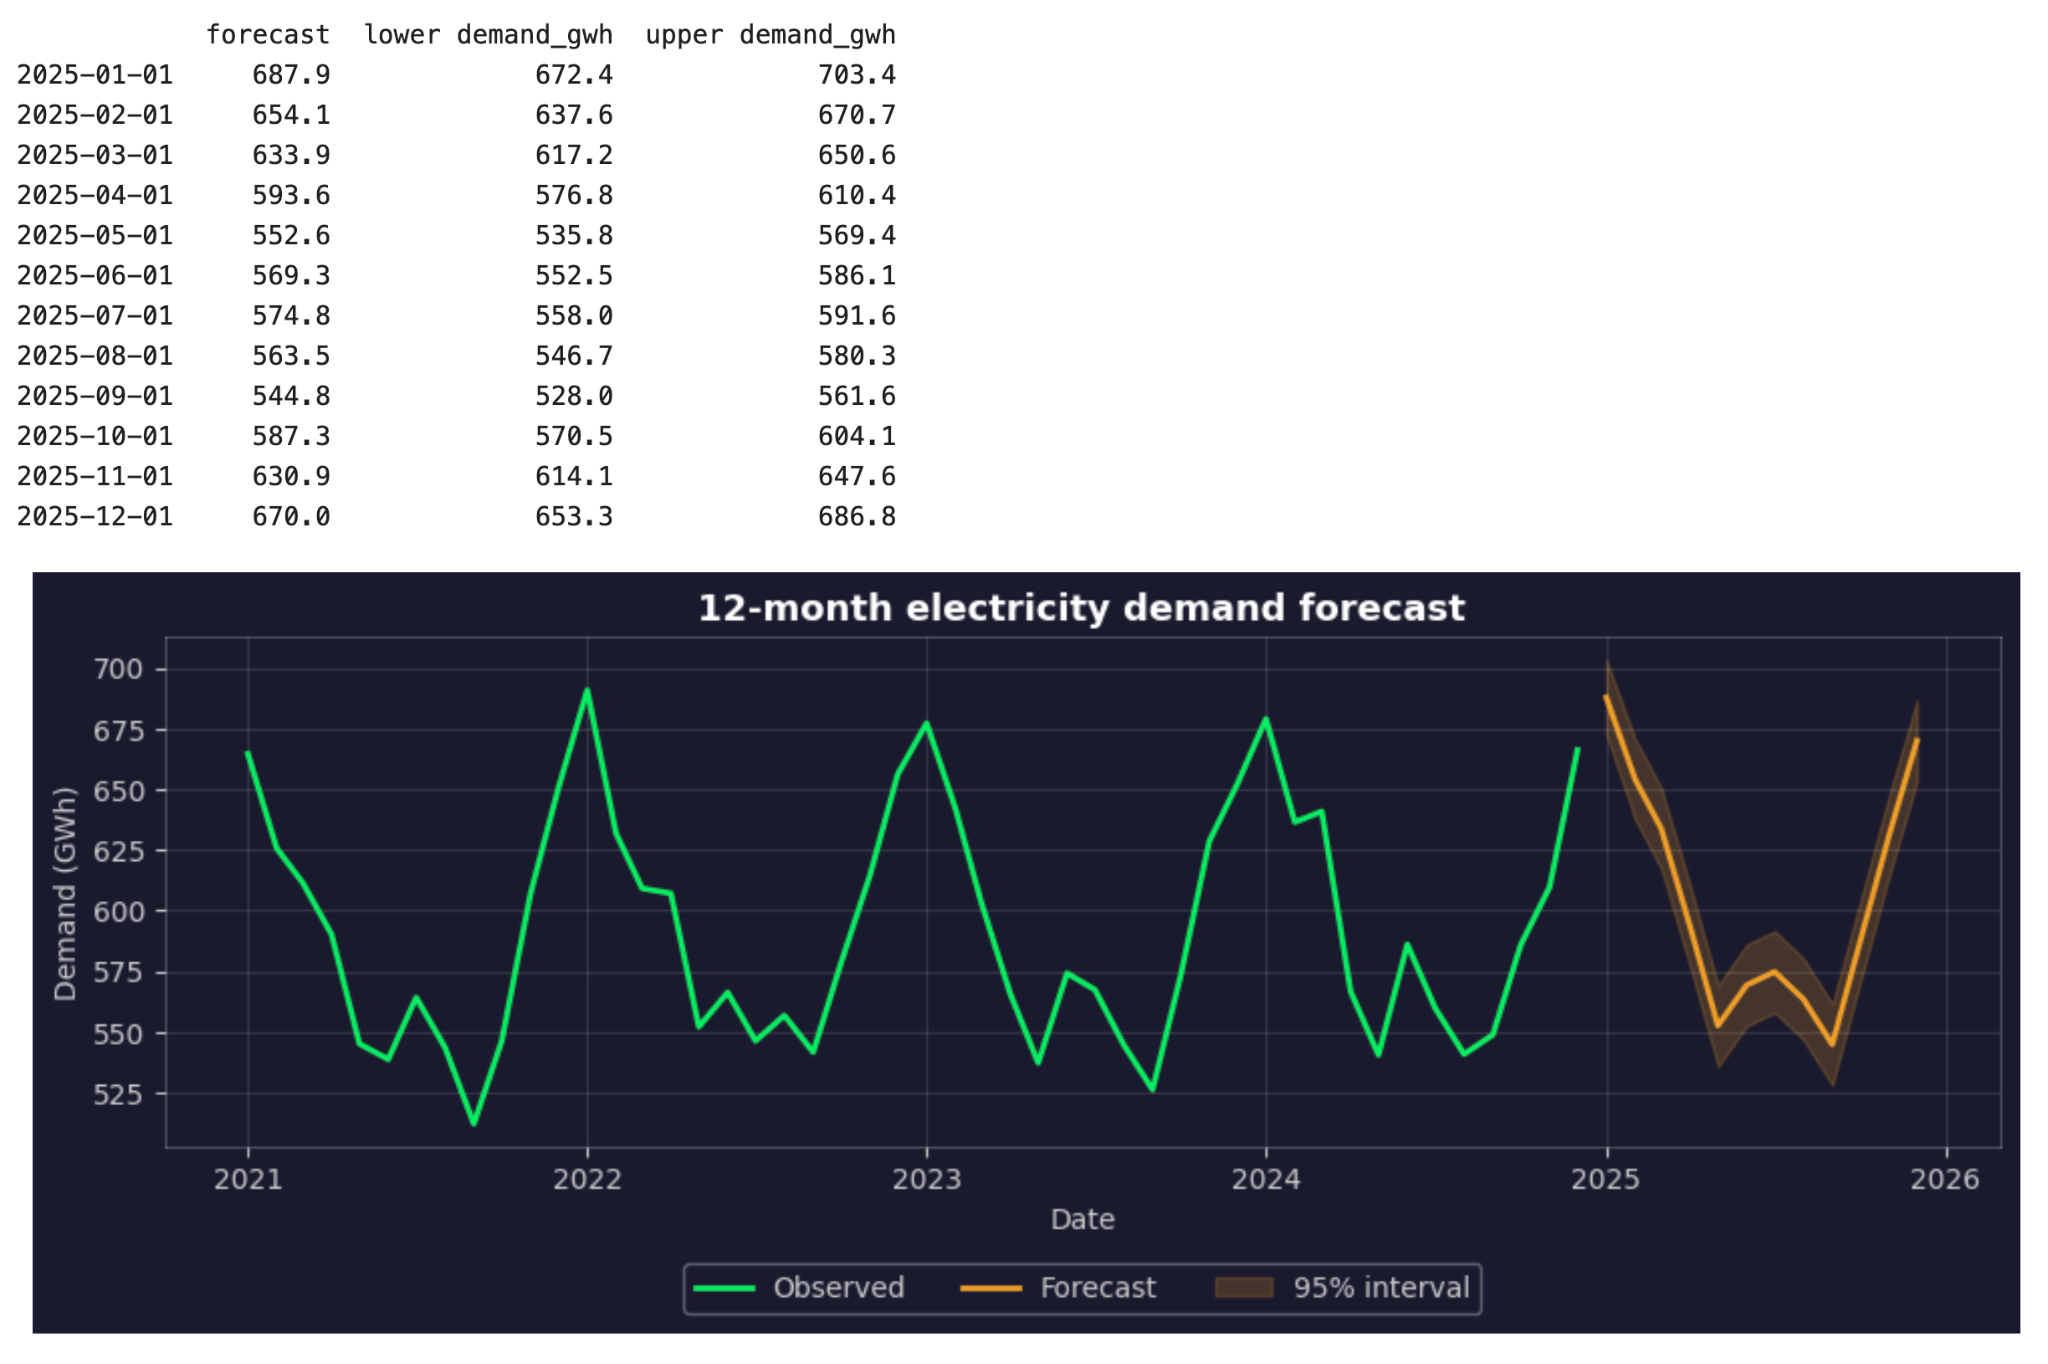
12-maandsvoorspelling van elektriciteitsvraag met een 95%-voorspellingsinterval
De voorspelling volgt de bekende vorm, met de hoogste vraag in de winter, een kleinere bult in de zomer en de laagste vraag in de lente en herfst.
Maar het 95%-interval dekt alleen de onzekerheid van het gefitte model, gegeven de temperatuurwaarden die je hebt aangeleverd. Het omvat niet de onzekerheid in die temperaturen. Als januari veel kouder wordt dan gemiddeld, kan de werkelijke vraag buiten het interval vallen, zelfs als het model correct is.
Wil je zien hoe gevoelig de voorspelling is, draai hem dan nog eens met een kouder en een warmer temperatuurscenario en vergelijk de resultaten.
Beperkingen van SARIMAX
SARIMAX is een goed model voor veel seizoensgebonden voorspellingsproblemen, maar het heeft grenzen. Dit moet je weten:
-
Toekomstige voorspellers zijn vereist: Het model kan niet voorspellen zonder waarden voor elke exogene variabele in elke toekomstige maand. Als een voorspeller niet van tevoren bekend is en je die niet kunt voorspellen, hoort die niet in het model, ongeacht hoeveel die de fit op verleden data verbetert
-
Onzekerheid in voorspellers is verborgen: Als toekomstige voorspellers zelf voorspellingen zijn, werken hun fouten door in de vraagvoorspelling. Het standaard voorspellingsinterval bevat die niet, en lijkt dus smaller dan het zou moeten zijn
-
Het behandelt één seizoensperiode: De standaardvorm ondersteunt één enkele
S. Uurlijkse elektriciteitsvraag heeft een dagelijkse en een wekelijkse cyclus, en SARIMAX kan die niet tegelijk modelleren. Het wordt ook traag bij lange seizoensperiodes, zoalsS = 168voor een wekelijkse cyclus in uurlijkse data -
Relaties kunnen veranderen: Het model gaat ervan uit dat de patronen in de trainingsdata in de toekomst hetzelfde blijven. Als meer woningen overstappen op warmtepompen, verandert het effect van koud weer op de vraag, en beschrijft de oude coëfficiënt dat niet meer. Je zou het model regelmatig op verse data moeten refitten en de nauwkeurigheid door de tijd volgen
-
Parameterkeuze vergt zorg: Een model met een lage AIC kan alsnog slecht voorspellen. AIC en BIC kijken alleen naar de trainingsdata, dus test de eindkandidaten op een apart gehouden periode, of beter: met tijdreeks-crossvalidatie over een paar tijdvensters
-
Het is geen causaal model: Een significante coëfficiënt vertelt je dat een voorspeller de voorspelling helpt, niet dat die veranderingen in de doelvariabele veroorzaakt. Wil je weten wat er met de vraag gebeurt als je een prijs verandert, dan heb je causale-inferentiemethoden nodig
Conclusie
Als je data een seizoenspatroon herhaalt en afhangt van externe factoren, is SARIMAX het proberen waard. Het combineert de geschiedenis van de reeks met de externe factoren die haar beïnvloeden. Als je data beide heeft, is het model meestal beter dan een model dat er maar één ziet.
Wat je hier moet onthouden, is dat het model maar zo goed is als de inputs die je geeft. Kies de seizoensperiode op basis van de data, lijn voorspellers zorgvuldig uit, test op toekomstige data in plaats van AIC te vertrouwen, en zorg dat je toekomstige waarden voor elke voorspeller hebt voordat je iets bouwt. Als dat laatste niet kan, is SARIMAX niet de juiste keuze voor je dataset.
Wil je blijven leren, schrijf je dan in voor onze cursus Time Series Analysis in Python en begrijp de basis in één middag.


