Gegevensverwerking, -analyse en -visualisaties zijn uitgevoerd met R en de bijbehorende packages. Het notebook en de relevante bestanden vind je hier.
Volgens het Merriam-Webster woordenboek zijn data feitelijke informatie die dienen als basis voor redenering, discussie of berekening. Volgens die definitie is data in feite elk stuk verzamelde informatie dat kan worden gebruikt en verder verwerkt en geanalyseerd om inzichten te verkrijgen. Het wordt vaak geassocieerd met computers omdat data doorgaans in een computer worden geproduceerd en opgeslagen, maar data bestaan al veel langer dan we misschien denken.
Geschiedenis van data
Het vroegste voorbeeld van mensen die data opslaan en analyseren dateert uit 18.000 v.Chr., toen werd ontdekt dat prehistorische mensen telstokjes gebruikten om elementaire berekeningen uit te voeren. Deze paleolithische stamleden maakten inkepingen in stokken en botten om hun activiteiten bij te houden, zoals handel drijven en voorraden monitoren. Rond 2400 v.Chr. werd in Babylon het telraam uitgevonden, een apparaat om berekeningen mee te maken.
Door de geschiedenis heen is de voortdurende ontwikkeling van dataverzameling, -verwerking en -analyse te zien in talloze geschriften op stenen tabletten, klei, papyrus, hout en papieren rollen. Uiteindelijk, naarmate er meer vormen van data werden ontdekt, evolueerde ook de behoefte aan het verwerken, verzamelen, opslaan en analyseren ervan.
Naarmate de menselijke samenleving geavanceerder werd, nam ook de behoefte aan dataverwerking toe. In de 19e eeuw begon men in de Verenigde Staten met het houden van een census. Het aantal datapunten in de volkstelling groeide exponentieel, tot het punt dat het U.S. Census Bureau schatte dat het jaren of zelfs decennia zou duren om alle gegevens te verzamelen en te analyseren. Dat was een groot probleem, omdat het samenstellen en analyseren van de huidige censusgegevens pas afgerond zou zijn wanneer de volgende volkstelling op het punt stond te beginnen of al begonnen was. Gelukkig ontwikkelde een jonge ingenieur en uitvinder, Herman Hollerith, de Hollerith Tabulating Machine—een elektromechanische tabuleermachine die de tijd die nodig was om censusgegevens te verzamelen en te analyseren terugbracht van jaren naar slechts enkele maanden. Hierdoor wordt Hollerith beschouwd als de vader van de moderne automatische dataverwerking en zou hij later bekend worden als de oprichter van IBM.
Fast forward naar de 20e eeuw en de uitvinding van de computer. Met de komst van een krachtiger rekenmachine kwam er een geavanceerdere behoefte aan gegevensopslag. Fritz Pfleumer, een Duits-Oostenrijkse ingenieur, vond een methode uit om informatie magnetisch op tape op te slaan. Sommige principes van zijn uitvinding worden vandaag de dag nog steeds gebruikt voor digitale gegevensopslag. In deze periode won de term “business intelligence” aan populariteit, omdat de behoefte aan opkomende software en systemen voor het analyseren van commerciële en operationele prestaties snel toenam.
De ware datarevolutie vond plaats toen Tim Berners-Lee in 1989 het World Wide Web, ook wel het internet, creëerde. Dit leidde tot geautomatiseerde informatie-uitwisseling tussen mensen over de hele wereld. Dat betekent dat er tegenwoordig meer data worden gedeeld, gecreëerd en opgeslagen, wat leidt tot nieuwe manieren om data te verzamelen, te gebruiken en te analyseren.
Transitie naar “Big Data”
Door de enorme groei van het internet in de jaren 90 en de gestage ontwikkeling van pc’s en andere apparaten nam het aantal online apparaten (en daarmee de hoeveelheid gecreëerde data) snel toe.
Hoewel het idee van Big Data al bestond vóór de jaren 90, kreeg het pas in 2005 officieel een label van Roger Mougalas. Hij beschreef het als “een grote set data die vrijwel onmogelijk te beheren en te verwerken is met traditionele business intelligence-tools.”
Big Data is een term die wordt gebruikt om het grote volume aan data—zowel gestructureerd als ongestructureerd—te beschrijven dat organisaties dagelijks overspoelt. Het omvat het volume aan informatie, de snelheid waarmee deze wordt gecreëerd en verzameld, en de variëteit of reikwijdte van de gedekte datapunten.
Gezien de omvang en complexiteit van Big Data is het proces van het verzamelen, organiseren en analyseren ervan om patronen en andere nuttige informatie te ontdekken een essentieel onderdeel geworden van de besluitvorming bij veel organisaties. Dit heeft op zijn beurt geleid tot data science—een interdisciplinaire discipline die wetenschappelijke methoden, processen, algoritmen en systemen gebruikt om uit een groot volume aan data patronen te onthullen en zakelijke leiders in staat te stellen weloverwogen inzichten te verkrijgen.
Welke rollen zijn er in data science?
Volgens IBM is data science een multidisciplinaire aanpak om bruikbare inzichten te halen uit de grote en steeds groeiende hoeveelheden data die door moderne organisaties worden verzameld en gecreëerd. Het vakgebied vereist doorgaans vaardigheden in informatica en zuivere wetenschap, omdat data scientists wetenschappelijke methoden toepassen en voorspellende analyses en kunstmatige intelligentie gebruiken om inzichten uit data te halen. Zie onze uitgebreide gids ‘wat is data science’ voor een meer diepgaande definitie.
Tegenwoordig gebruiken bedrijven en organisaties “data science” vaak als verzamelterm voor het verwerken van grote hoeveelheden data, of het nu gaat om het voorbereiden, opschonen, analyseren of visualiseren van data om patronen te onthullen. Dit zijn enkele van de data science-carrières die je kunt nastreven:
-
Data scientist
Data scientists moeten wiskunde, statistiek en de wetenschappelijke methode kunnen toepassen; meerdere tools en technieken gebruiken voor het opschonen en voorbereiden van data; voorspellende analyses en kunstmatige intelligentie uitvoeren; en uitleggen hoe deze resultaten kunnen worden ingezet om datagedreven oplossingen te bieden voor zakelijke problemen. Ze hebben veel meer technische vaardigheden nodig dan data-analisten. Om te beginnen kun je data science-gerichte cursussen volgen zoals deze op DataCamp: Introduction to Python for Data Science en Introduction to R.
-
Data-analist
Data-analisten verzamelen, verwerken en voeren statistische data-analyses uit om tot betekenisvolle conclusies voor organisaties te komen. Ze transformeren en manipuleren grote datasets tot bruikbare vormen, zoals rapporten of presentaties. Ze ondersteunen ook het besluitvormingsproces door belangrijke patronen te zoeken en inzichten uit de data te halen, die ze vervolgens effectief communiceren aan organisatieleiders om zakelijke beslissingen te ondersteunen. Deze cursussen op DataCamp kunnen je helpen je carrière als data-analist te starten: Introduction to SQL en Exploratory Data Analysis in SQL.
-
Data engineer
Data engineers zijn verantwoordelijk voor het voorbereiden, verwerken en beheren van verzamelde en opgeslagen data voor analytische of operationele doeleinden. Net als traditionele ingenieurs bouwen en onderhouden data engineers “pipelines” die data van het ene systeem naar het andere verbinden, waardoor informatie toegankelijk wordt voor data scientists. Daarom moeten data engineers verschillende programmeertalen begrijpen die in data science worden gebruikt, zoals Python, R en SQL. Onderwerpen gerelateerd aan data engineering zoals deze zijn beschikbaar op DataCamp: Introduction to Data Engineering en Understanding Data Engineering.
-
Data-architect
Data-architecten ontwerpen en maken vooral blauwdrukken voor databeheersystemen die data engineers vervolgens bouwen. Vergelijkbaar met traditionele architecten zijn data-architecten de “visionairs”, omdat zij verantwoordelijk zijn voor het visualiseren en ontwerpen van het databeheerraamwerk van een organisatie. Daarnaast verbeteren data-architecten de prestaties van bestaande systemen en zorgen ze ervoor dat deze toegankelijk zijn voor databasebeheerders en analisten. Je kunt cursussen volgen die verband houden met data-architectuur, zoals deze op DataCamp: AWS Cloud Concepts en Database Design
-
Business intelligence (BI)-developer
BI-developers zijn gespecialiseerde engineers die softwaretools gebruiken om data om te zetten in bruikbare inzichten die zakelijke beslissingen ondersteunen. Ze zijn verantwoordelijk voor het vereenvoudigen van technische informatie zodat iedereen in het bedrijf deze gemakkelijk kan begrijpen. Kort gezegd: ze maken en draaien rapporten met data die ze vinden via business intelligence-tools, en vertalen de informatie naar meer begrijpelijke taal. Cursussen in tools voor business intelligence, zoals Microsoft Power BI en Tableau, zijn beschikbaar op DataCamp, waaronder: Introduction to Power BI en Analyzing Data in Tableau
-
Statisticus
Aangezien statistiek een van de belangrijkste fundamenten van data science is, kunnen veel statistici eenvoudig overstappen naar het data science-veld. Statistici zijn voornamelijk verantwoordelijk voor het verzamelen en verwerken van data. Zij bepalen welke data ze nodig hebben en hoe ze die verzamelen. Daarnaast ontwerpen ze experimenten, analyseren en interpreteren ze de data en rapporteren ze conclusies. Bekijk deze inleidende cursussen statistiek op DataCamp: Introduction to Statistical Modeling in R en Introduction to Statistics in Spreadsheets.
-
Machine learning engineer
Machine learning engineers zijn een andere groep gespecialiseerde engineers die zich richten op het onderzoeken, bouwen en ontwerpen van systemen voor kunstmatige intelligentie (AI) en machine learning (ML) om voorspellende modellen te automatiseren. In wezen ontwikkelen ze algoritmen die invoergegevens gebruiken en statistische modellen benutten om een output te voorspellen, terwijl ze de outputs continu bijwerken zodra er nieuwe data beschikbaar komen. DataCamp heeft talloze cursussen over machine learning die je mogelijk nuttig vindt, zoals: Understanding Machine Learning en Machine Learning with caret in R.
Een snelle online zoektocht naar vacatures geeft je een idee welke van de bovenstaande data science-carrières het meest in trek is. De onderstaande grafiek toont de vacatures per carrièrepad volgens Indeed USA op 8 december 2021.
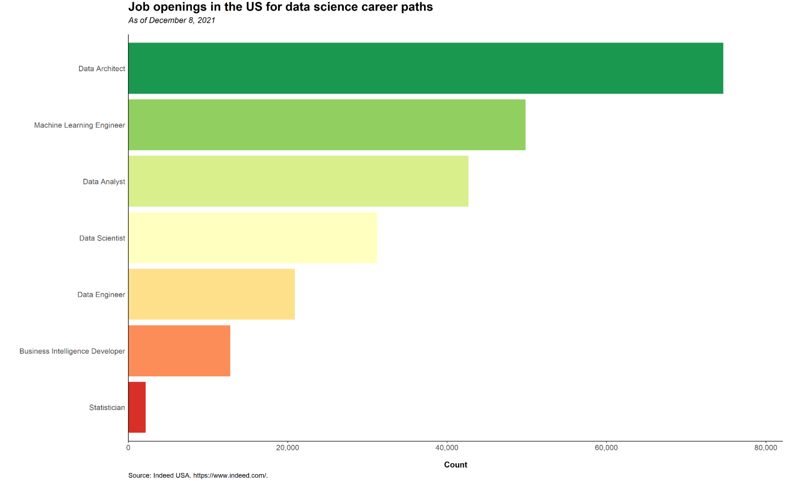
Data-architect lijkt het meest gevraagde carrièrepad in data science, vanwege hun belang bij het creëren van databeheersystemen die vervolgens door andere data science-professionals worden gebruikt. Daarna volgt machine learning engineer, gezien het belang van het inzetten van kunstmatige intelligentie om uitkomsten te voorspellen bij veel techbedrijven.
Het minst in trek zijn statistici, vooral omdat veel traditionele statistici nu data scientists worden. Verwacht wordt dat deze trend zich voortzet, gezien hoe eenvoudig het voor statistici is om van zuivere statistiek naar data science over te stappen, aangezien zij al over de fundamentele kennis beschikken om volwaardig data scientist te worden.
Data science vertraagt niet
Het vakgebied data science werd in de jaren 2010 enorm populair, zeker toen “Data Scientist” door Harvard Business Review werd bestempeld als de “meest sexy baan van de 21e eeuw”. Het werd zo populair dat de titel “Data Scientist” alomtegenwoordig en trendy werd. Hoewel de term “meest sexy baan” in eerste instantie misschien belachelijk klinkt, verwijst het vooral naar het feit dat data scientists niet alleen gewild zijn, maar ook duur om in te huren en lastig te behouden.
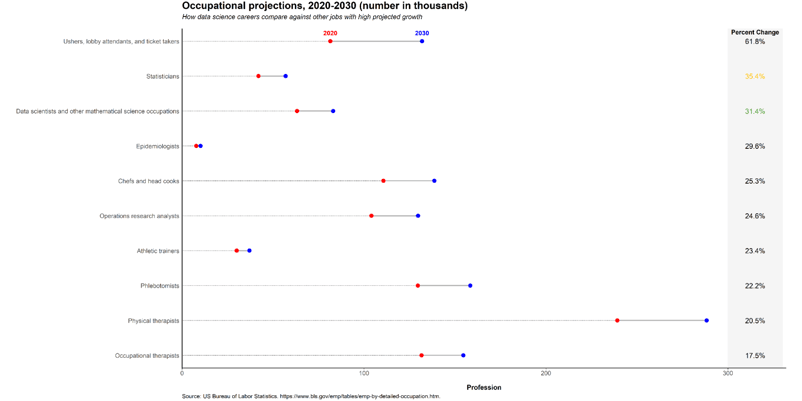
Dat data science tegenwoordig ontzettend populair is, staat buiten kijf; de betere vraag is: blijft het in de toekomst net zo populair? Op basis van werkgelegenheidsprognoses lijkt dat inderdaad het geval. Gegevens uit de werkgelegenheidsprognoses 2020-2030 van het U.S. Bureau of Labor Statistics laten zien dat carrières in data science—waaronder statistiek, data science en andere wiskundige en natuurwetenschappelijke beroepen zoals data engineering—een zeer hoge groeivoet zullen vertonen in termen van procentuele verandering van 2020 tot 2030. Statistici stonden in totaal op plek 14, terwijl data scientists en andere wiskundige wetenschapsberoepen in totaal op plek 31 stonden van de 790 banen in de data.
Hoewel het aandeel van statistici en data scientists in de totale beroepsbevolking klein is vergeleken met andere beroepen, zullen die aantallen in de komende jaren naar verwachting toenemen, naarmate de carrièreweg in data science steeds populairder wordt. De onderstaande figuur laat zien hoe statistici, data scientists en andere wiskundige wetenschapsberoepen zich verhouden tot andere banen met een hoge verwachte groei.
Een echt goedbetaald vakgebied
Een belangrijke reden waarom data science populair is, is dat het een van de bestbetaalde beroepen ter wereld is. De onderstaande figuur toont het salarisspectrum voor 10 verschillende beroepen—waaronder data scientists en data-analisten—in New York City. De gegevens zijn afkomstig van Teleport, een website die gegevens over leefomstandigheden (zoals salarissen) in verschillende steden verzamelt.
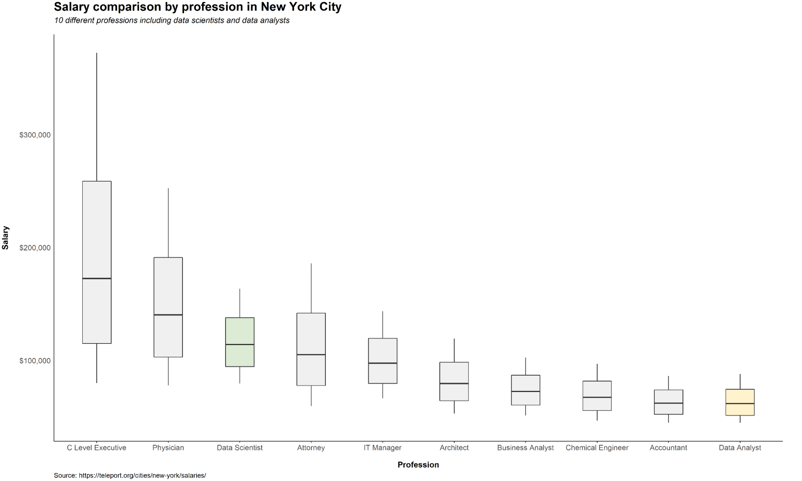
Volgens Teleport hadden data scientists het 4e hoogste jaarlijkse mediaansalaris in New York City van \$114.105, net achter C-level executives en zorgmedewerkers. In sommige andere steden, zoals Manilla, staan data scientists zelfs op plek 2, direct achter C-level executives. Dat zegt veel over hoe lucratief deze baan is. Functies als data-analist zijn, hoewel niet zo lucratief als data science-posities, zeker niet te onderschatten. Met een jaarlijks mediaansalaris van $61.818 verdienen data-analisten nog steeds ongeveer het gemiddelde huishoudinkomen in New York City.
Blijvende groei op de arbeidsmarkt
Nog een belangrijke reden voor de populariteit van data science is hoe organisaties tegenwoordig de principes van data science integreren in hun dagelijkse werkzaamheden. De onderstaande grafiek toont de top 10 sectoren die data science in hun werk betrekken. De steekproefdata van 8.000 op data science gerichte bedrijven zijn afkomstig van Diffbot, ’s werelds grootste knowledge graph.
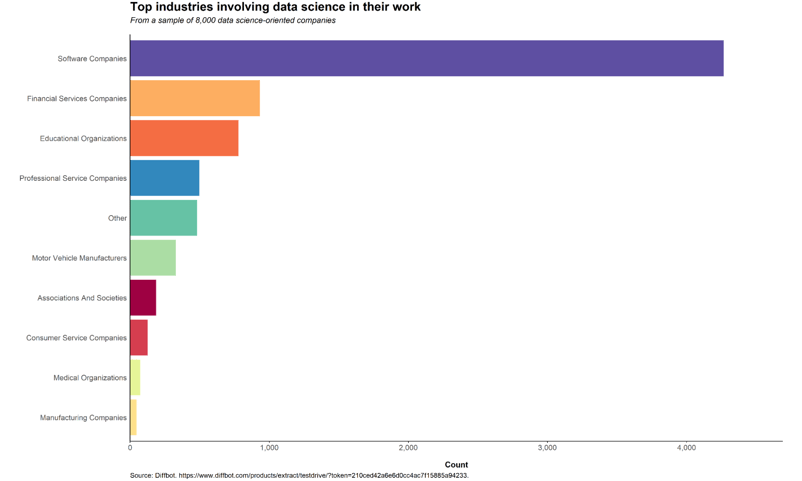
Het is geen verrassing dat softwarebedrijven—waaronder techbedrijven als Google, Apple en Uber—bovenaan staan. De enorme groei van big data is immers veroorzaakt door de creatie van het internet, dat nauw verweven is met software en technologie. Data science draait echt om het verwerken van veel informatie met behulp van diverse tools en technologie.
Daarna volgen financiële dienstverleners, gestuwd door de opkomst van fintechbedrijven. Een samentrekking van “finance” en “technology”, fintechbedrijven integreren technologie en innovatie in hun diensten en aanbod om hun levering aan klanten te verbeteren en traditionele financiële diensten te verstoren. Omdat het gaat om het verwerken van enorme hoeveelheden data, zoals klantinformatie, zagen financiële dienstverleners het potentieel van data science-tools om hun processen te stroomlijnen en te optimaliseren en hun diensten te verbeteren.
Kortom, is het de moeite waard om een carrière in data science na te streven?
Met alles wat hierboven is uitgelegd, is het antwoord een volmondig ja! Welke specifieke carrière in data science je moet nastreven, hangt vooral af van je individuele sterke punten en algemene interesses. Belangrijk is dat elk van de hierboven genoemde carrières zeker de moeite waard is.
Als een carrièrepad dat zeer lucratief is en geen tekenen van afnemende populariteit vertoont, zal data science nog vele jaren blijven bepalen en beïnvloeden hoe bedrijven en organisaties opereren.


 Adel Nehme · 15 min
Gegevensverwerking, -analyse en -visualisaties zijn uitgevoerd met R en de bijbehorende packages. Het notebook en de relevante bestanden vind je hier.
Volgens het Merriam-Webster woordenboek zijn data feitelijke informatie die dienen als basis voor redenering, discussie of berekening. Volgens die definitie is data in feite elk stuk verzamelde informatie dat kan worden gebruikt en verder verwerkt en geanalyseerd om inzichten te verkrijgen. Het wordt vaak geassocieerd met computers omdat data doorgaans in een computer worden geproduceerd en opgeslagen, maar data bestaan al veel langer dan we misschien denken.
Geschiedenis van data
Het vroegste voorbeeld van mensen die data opslaan en analyseren dateert uit 18.000 v.Chr., toen werd ontdekt dat prehistorische mensen telstokjes gebruikten om elementaire berekeningen uit te voeren. Deze paleolithische stamleden maakten inkepingen in stokken en botten om hun activiteiten bij te houden, zoals handel drijven en voorraden monitoren. Rond 2400 v.Chr. werd in Babylon het telraam uitgevonden, een apparaat om berekeningen mee te maken.
Door de geschiedenis heen is de voortdurende ontwikkeling van dataverzameling, -verwerking en -analyse te zien in talloze geschriften op stenen tabletten, klei, papyrus, hout en papieren rollen. Uiteindelijk, naarmate er meer vormen van data werden ontdekt, evolueerde ook de behoefte aan het verwerken, verzamelen, opslaan en analyseren ervan.
Naarmate de menselijke samenleving geavanceerder werd, nam ook de behoefte aan dataverwerking toe. In de 19e eeuw begon men in de Verenigde Staten met het houden van een census. Het aantal datapunten in de volkstelling groeide exponentieel, tot het punt dat het U.S. Census Bureau schatte dat het jaren of zelfs decennia zou duren om alle gegevens te verzamelen en te analyseren. Dat was een groot probleem, omdat het samenstellen en analyseren van de huidige censusgegevens pas afgerond zou zijn wanneer de volgende volkstelling op het punt stond te beginnen of al begonnen was. Gelukkig ontwikkelde een jonge ingenieur en uitvinder, Herman Hollerith, de Hollerith Tabulating Machine—een elektromechanische tabuleermachine die de tijd die nodig was om censusgegevens te verzamelen en te analyseren terugbracht van jaren naar slechts enkele maanden. Hierdoor wordt Hollerith beschouwd als de vader van de moderne automatische dataverwerking en zou hij later bekend worden als de oprichter van IBM.
Fast forward naar de 20e eeuw en de uitvinding van de computer. Met de komst van een krachtiger rekenmachine kwam er een geavanceerdere behoefte aan gegevensopslag. Fritz Pfleumer, een Duits-Oostenrijkse ingenieur, vond een methode uit om informatie magnetisch op tape op te slaan. Sommige principes van zijn uitvinding worden vandaag de dag nog steeds gebruikt voor digitale gegevensopslag. In deze periode won de term “business intelligence” aan populariteit, omdat de behoefte aan opkomende software en systemen voor het analyseren van commerciële en operationele prestaties snel toenam.
De ware datarevolutie vond plaats toen Tim Berners-Lee in 1989 het World Wide Web, ook wel het internet, creëerde. Dit leidde tot geautomatiseerde informatie-uitwisseling tussen mensen over de hele wereld. Dat betekent dat er tegenwoordig meer data worden gedeeld, gecreëerd en opgeslagen, wat leidt tot nieuwe manieren om data te verzamelen, te gebruiken en te analyseren.
Transitie naar “Big Data”
Door de enorme groei van het internet in de jaren 90 en de gestage ontwikkeling van pc’s en andere apparaten nam het aantal online apparaten (en daarmee de hoeveelheid gecreëerde data) snel toe.
Hoewel het idee van Big Data al bestond vóór de jaren 90, kreeg het pas in 2005 officieel een label van Roger Mougalas. Hij beschreef het als “een grote set data die vrijwel onmogelijk te beheren en te verwerken is met traditionele business intelligence-tools.”
Big Data is een term die wordt gebruikt om het grote volume aan data—zowel gestructureerd als ongestructureerd—te beschrijven dat organisaties dagelijks overspoelt. Het omvat het volume aan informatie, de snelheid waarmee deze wordt gecreëerd en verzameld, en de variëteit of reikwijdte van de gedekte datapunten.
Gezien de omvang en complexiteit van Big Data is het proces van het verzamelen, organiseren en analyseren ervan om patronen en andere nuttige informatie te ontdekken een essentieel onderdeel geworden van de besluitvorming bij veel organisaties. Dit heeft op zijn beurt geleid tot data science—een interdisciplinaire discipline die wetenschappelijke methoden, processen, algoritmen en systemen gebruikt om uit een groot volume aan data patronen te onthullen en zakelijke leiders in staat te stellen weloverwogen inzichten te verkrijgen.
Welke rollen zijn er in data science?
Volgens IBM is data science een multidisciplinaire aanpak om bruikbare inzichten te halen uit de grote en steeds groeiende hoeveelheden data die door moderne organisaties worden verzameld en gecreëerd. Het vakgebied vereist doorgaans vaardigheden in informatica en zuivere wetenschap, omdat data scientists wetenschappelijke methoden toepassen en voorspellende analyses en kunstmatige intelligentie gebruiken om inzichten uit data te halen. Zie onze uitgebreide gids ‘wat is data science’ voor een meer diepgaande definitie.
Tegenwoordig gebruiken bedrijven en organisaties “data science” vaak als verzamelterm voor het verwerken van grote hoeveelheden data, of het nu gaat om het voorbereiden, opschonen, analyseren of visualiseren van data om patronen te onthullen. Dit zijn enkele van de data science-carrières die je kunt nastreven:
Data scientist
Data scientists moeten wiskunde, statistiek en de wetenschappelijke methode kunnen toepassen; meerdere tools en technieken gebruiken voor het opschonen en voorbereiden van data; voorspellende analyses en kunstmatige intelligentie uitvoeren; en uitleggen hoe deze resultaten kunnen worden ingezet om datagedreven oplossingen te bieden voor zakelijke problemen. Ze hebben veel meer technische vaardigheden nodig dan data-analisten. Om te beginnen kun je data science-gerichte cursussen volgen zoals deze op DataCamp: Introduction to Python for Data Science en Introduction to R.
Data-analist
Data-analisten verzamelen, verwerken en voeren statistische data-analyses uit om tot betekenisvolle conclusies voor organisaties te komen. Ze transformeren en manipuleren grote datasets tot bruikbare vormen, zoals rapporten of presentaties. Ze ondersteunen ook het besluitvormingsproces door belangrijke patronen te zoeken en inzichten uit de data te halen, die ze vervolgens effectief communiceren aan organisatieleiders om zakelijke beslissingen te ondersteunen. Deze cursussen op DataCamp kunnen je helpen je carrière als data-analist te starten: Introduction to SQL en Exploratory Data Analysis in SQL.
Data engineer
Data engineers zijn verantwoordelijk voor het voorbereiden, verwerken en beheren van verzamelde en opgeslagen data voor analytische of operationele doeleinden. Net als traditionele ingenieurs bouwen en onderhouden data engineers “pipelines” die data van het ene systeem naar het andere verbinden, waardoor informatie toegankelijk wordt voor data scientists. Daarom moeten data engineers verschillende programmeertalen begrijpen die in data science worden gebruikt, zoals Python, R en SQL. Onderwerpen gerelateerd aan data engineering zoals deze zijn beschikbaar op DataCamp: Introduction to Data Engineering en Understanding Data Engineering.
Data-architect
Data-architecten ontwerpen en maken vooral blauwdrukken voor databeheersystemen die data engineers vervolgens bouwen. Vergelijkbaar met traditionele architecten zijn data-architecten de “visionairs”, omdat zij verantwoordelijk zijn voor het visualiseren en ontwerpen van het databeheerraamwerk van een organisatie. Daarnaast verbeteren data-architecten de prestaties van bestaande systemen en zorgen ze ervoor dat deze toegankelijk zijn voor databasebeheerders en analisten. Je kunt cursussen volgen die verband houden met data-architectuur, zoals deze op DataCamp: AWS Cloud Concepts en Database Design
Business intelligence (BI)-developer
BI-developers zijn gespecialiseerde engineers die softwaretools gebruiken om data om te zetten in bruikbare inzichten die zakelijke beslissingen ondersteunen. Ze zijn verantwoordelijk voor het vereenvoudigen van technische informatie zodat iedereen in het bedrijf deze gemakkelijk kan begrijpen. Kort gezegd: ze maken en draaien rapporten met data die ze vinden via business intelligence-tools, en vertalen de informatie naar meer begrijpelijke taal. Cursussen in tools voor business intelligence, zoals Microsoft Power BI en Tableau, zijn beschikbaar op DataCamp, waaronder: Introduction to Power BI en Analyzing Data in Tableau
Statisticus
Aangezien statistiek een van de belangrijkste fundamenten van data science is, kunnen veel statistici eenvoudig overstappen naar het data science-veld. Statistici zijn voornamelijk verantwoordelijk voor het verzamelen en verwerken van data. Zij bepalen welke data ze nodig hebben en hoe ze die verzamelen. Daarnaast ontwerpen ze experimenten, analyseren en interpreteren ze de data en rapporteren ze conclusies. Bekijk deze inleidende cursussen statistiek op DataCamp: Introduction to Statistical Modeling in R en Introduction to Statistics in Spreadsheets.
Machine learning engineer
Machine learning engineers zijn een andere groep gespecialiseerde engineers die zich richten op het onderzoeken, bouwen en ontwerpen van systemen voor kunstmatige intelligentie (AI) en machine learning (ML) om voorspellende modellen te automatiseren. In wezen ontwikkelen ze algoritmen die invoergegevens gebruiken en statistische modellen benutten om een output te voorspellen, terwijl ze de outputs continu bijwerken zodra er nieuwe data beschikbaar komen. DataCamp heeft talloze cursussen over machine learning die je mogelijk nuttig vindt, zoals: Understanding Machine Learning en Machine Learning with caret in R.
Een snelle online zoektocht naar vacatures geeft je een idee welke van de bovenstaande data science-carrières het meest in trek is. De onderstaande grafiek toont de vacatures per carrièrepad volgens Indeed USA op 8 december 2021.
Data-architect lijkt het meest gevraagde carrièrepad in data science, vanwege hun belang bij het creëren van databeheersystemen die vervolgens door andere data science-professionals worden gebruikt. Daarna volgt machine learning engineer, gezien het belang van het inzetten van kunstmatige intelligentie om uitkomsten te voorspellen bij veel techbedrijven.
Het minst in trek zijn statistici, vooral omdat veel traditionele statistici nu data scientists worden. Verwacht wordt dat deze trend zich voortzet, gezien hoe eenvoudig het voor statistici is om van zuivere statistiek naar data science over te stappen, aangezien zij al over de fundamentele kennis beschikken om volwaardig data scientist te worden.
Data science vertraagt niet
Het vakgebied data science werd in de jaren 2010 enorm populair, zeker toen “Data Scientist” door Harvard Business Review werd bestempeld als de “meest sexy baan van de 21e eeuw”. Het werd zo populair dat de titel “Data Scientist” alomtegenwoordig en trendy werd. Hoewel de term “meest sexy baan” in eerste instantie misschien belachelijk klinkt, verwijst het vooral naar het feit dat data scientists niet alleen gewild zijn, maar ook duur om in te huren en lastig te behouden.
Dat data science tegenwoordig ontzettend populair is, staat buiten kijf; de betere vraag is: blijft het in de toekomst net zo populair? Op basis van werkgelegenheidsprognoses lijkt dat inderdaad het geval. Gegevens uit de werkgelegenheidsprognoses 2020-2030 van het U.S. Bureau of Labor Statistics laten zien dat carrières in data science—waaronder statistiek, data science en andere wiskundige en natuurwetenschappelijke beroepen zoals data engineering—een zeer hoge groeivoet zullen vertonen in termen van procentuele verandering van 2020 tot 2030. Statistici stonden in totaal op plek 14, terwijl data scientists en andere wiskundige wetenschapsberoepen in totaal op plek 31 stonden van de 790 banen in de data.
Hoewel het aandeel van statistici en data scientists in de totale beroepsbevolking klein is vergeleken met andere beroepen, zullen die aantallen in de komende jaren naar verwachting toenemen, naarmate de carrièreweg in data science steeds populairder wordt. De onderstaande figuur laat zien hoe statistici, data scientists en andere wiskundige wetenschapsberoepen zich verhouden tot andere banen met een hoge verwachte groei.
Een echt goedbetaald vakgebied
Een belangrijke reden waarom data science populair is, is dat het een van de bestbetaalde beroepen ter wereld is. De onderstaande figuur toont het salarisspectrum voor 10 verschillende beroepen—waaronder data scientists en data-analisten—in New York City. De gegevens zijn afkomstig van Teleport, een website die gegevens over leefomstandigheden (zoals salarissen) in verschillende steden verzamelt.
Volgens Teleport hadden data scientists het 4e hoogste jaarlijkse mediaansalaris in New York City van \$114.105, net achter C-level executives en zorgmedewerkers. In sommige andere steden, zoals Manilla, staan data scientists zelfs op plek 2, direct achter C-level executives. Dat zegt veel over hoe lucratief deze baan is. Functies als data-analist zijn, hoewel niet zo lucratief als data science-posities, zeker niet te onderschatten. Met een jaarlijks mediaansalaris van $61.818 verdienen data-analisten nog steeds ongeveer het gemiddelde huishoudinkomen in New York City.
Blijvende groei op de arbeidsmarkt
Nog een belangrijke reden voor de populariteit van data science is hoe organisaties tegenwoordig de principes van data science integreren in hun dagelijkse werkzaamheden. De onderstaande grafiek toont de top 10 sectoren die data science in hun werk betrekken. De steekproefdata van 8.000 op data science gerichte bedrijven zijn afkomstig van Diffbot, ’s werelds grootste knowledge graph.
Het is geen verrassing dat softwarebedrijven—waaronder techbedrijven als Google, Apple en Uber—bovenaan staan. De enorme groei van big data is immers veroorzaakt door de creatie van het internet, dat nauw verweven is met software en technologie. Data science draait echt om het verwerken van veel informatie met behulp van diverse tools en technologie.
Daarna volgen financiële dienstverleners, gestuwd door de opkomst van fintechbedrijven. Een samentrekking van “finance” en “technology”, fintechbedrijven integreren technologie en innovatie in hun diensten en aanbod om hun levering aan klanten te verbeteren en traditionele financiële diensten te verstoren. Omdat het gaat om het verwerken van enorme hoeveelheden data, zoals klantinformatie, zagen financiële dienstverleners het potentieel van data science-tools om hun processen te stroomlijnen en te optimaliseren en hun diensten te verbeteren.
Kortom, is het de moeite waard om een carrière in data science na te streven?
Met alles wat hierboven is uitgelegd, is het antwoord een volmondig ja! Welke specifieke carrière in data science je moet nastreven, hangt vooral af van je individuele sterke punten en algemene interesses. Belangrijk is dat elk van de hierboven genoemde carrières zeker de moeite waard is.
Als een carrièrepad dat zeer lucratief is en geen tekenen van afnemende populariteit vertoont, zal data science nog vele jaren blijven bepalen en beïnvloeden hoe bedrijven en organisaties opereren.