Cursus
Concepten van Large Language Models (LLMs)
2 uur
112K
Let op: Bonsai 2 27B is nu beschikbaar, gebaseerd op Qwen3.8 27B
Taalmodellen lokaal draaien wordt steeds makkelijker, zelfs op oudere hardware. Bonsai is een 1-bit model dat is ontworpen om klein, snel en efficiënt te zijn, waardoor het een goede optie is voor lokaal gebruik op een Windows-laptop.
In deze tutorial laat ik je zien wat Bonsai is en hoe 1-bit modellen op een eenvoudige manier werken. Ik neem je stap voor stap mee door het volledige installatieproces.
Dit omvat het downloaden van het Bonsai 8B GGUF-model, het opzetten van de PrismML-fork van llama.cpp, het testen van het model in de command line, het draaien als een lokale server en controleren of alles werkt met zowel curl als de ingebouwde WebUI.
Ik raad je aan ook onze gidsen te bekijken over het lokaal draaien van GLM-5.1 en Qwen3.5-27B.
Bonsai is een familie van compacte 1-bit taalmodellen van PrismML, met varianten van 1,7B, 4B en 8B, zodat je een formaat kunt kiezen dat past bij je apparaat en prestatiewensen.
De Bonsai-lijn is ontworpen voor efficiënte lokale inferentie, met ondersteuning in llama.cpp en aanverwante runtimes, en het vlaggenschip Bonsai 8B GGUF-model is veel kleiner dan een typisch FP16 8B-model, terwijl het toch concurrerend blijft qua capaciteiten.
Een 1-bit model werkt door elk gewicht op te slaan als één enkele bit in plaats van standaard waarden met volledige precisie. In Bonsai’s Q1_0-formaat wordt een waarde 0 toegewezen aan een negatieve schaal en een waarde 1 aan een positieve schaal, met één FP16-schaal gedeeld over elke 128 gewichten.
Deze aanpak verlaagt het geheugengebruik aanzienlijk, terwijl het model functioneel en efficiënt blijft voor inferentie. Bonsai past dit 1-bit ontwerp toe op embeddings, attention projections, MLP projections en de LM-head, waardoor het een end-to-end 1-bit model is.
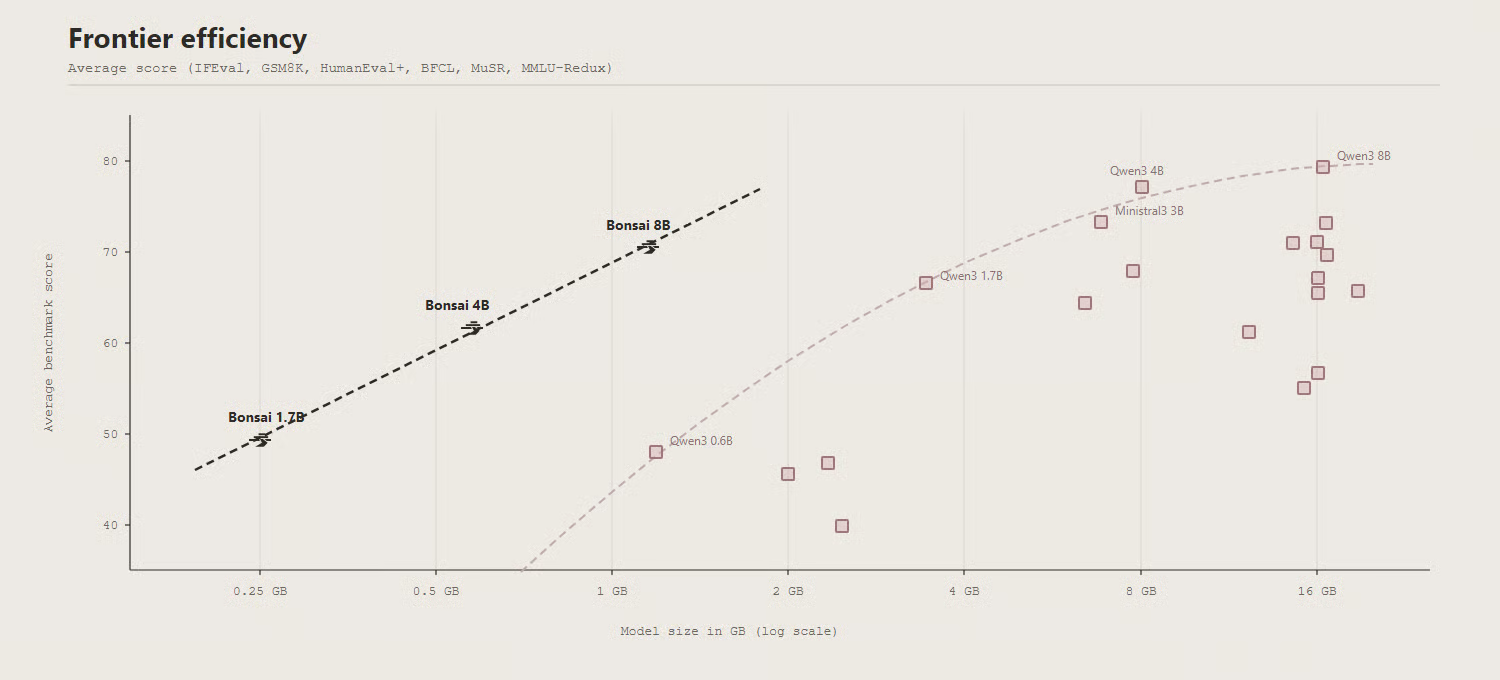
Bron: prism-ml/Bonsai-8B-gguf · Hugging Face
In benchmarktests laat Bonsai 8B zien dat een veel kleiner 1-bit model toch kan concurreren met full-precision modellen in de 6B- tot 9B-klasse. De modelkaart rapporteert een gemiddelde score van 70,5 over zes evaluatiecategorieën, wat het in de buurt brengt van verschillende standaard 8B-modellen. Daardoor is Bonsai opvallend niet alleen qua formaat en snelheid, maar ook omdat het solide prestaties weet te behouden.
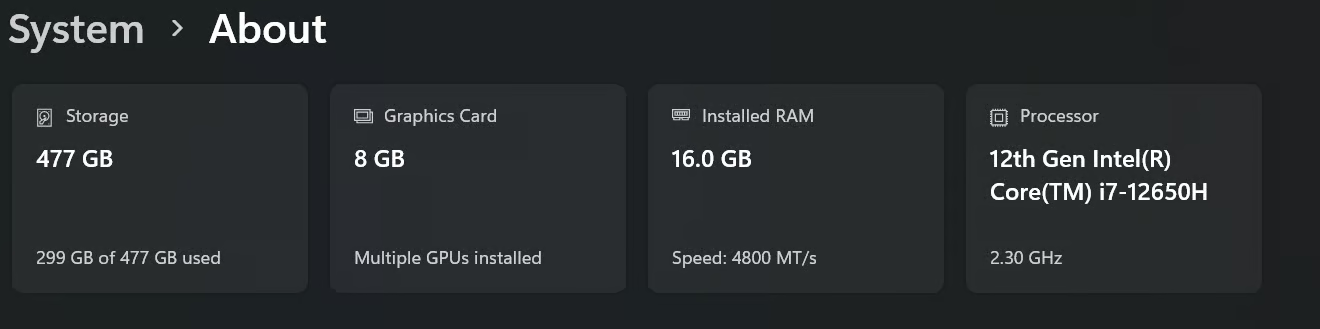
Voor deze tutorial draai ik Bonsai op een oudere Windows-laptop met een 12th Gen Intel-processor en een NVIDIA RTX 3070 GPU. Een van de grootste voordelen van Bonsai 8B is dat het kan draaien met ongeveer 2 GB VRAM of systeemgeheugen, wat het een praktische optie maakt voor oudere laptops en systemen met minder geheugen.
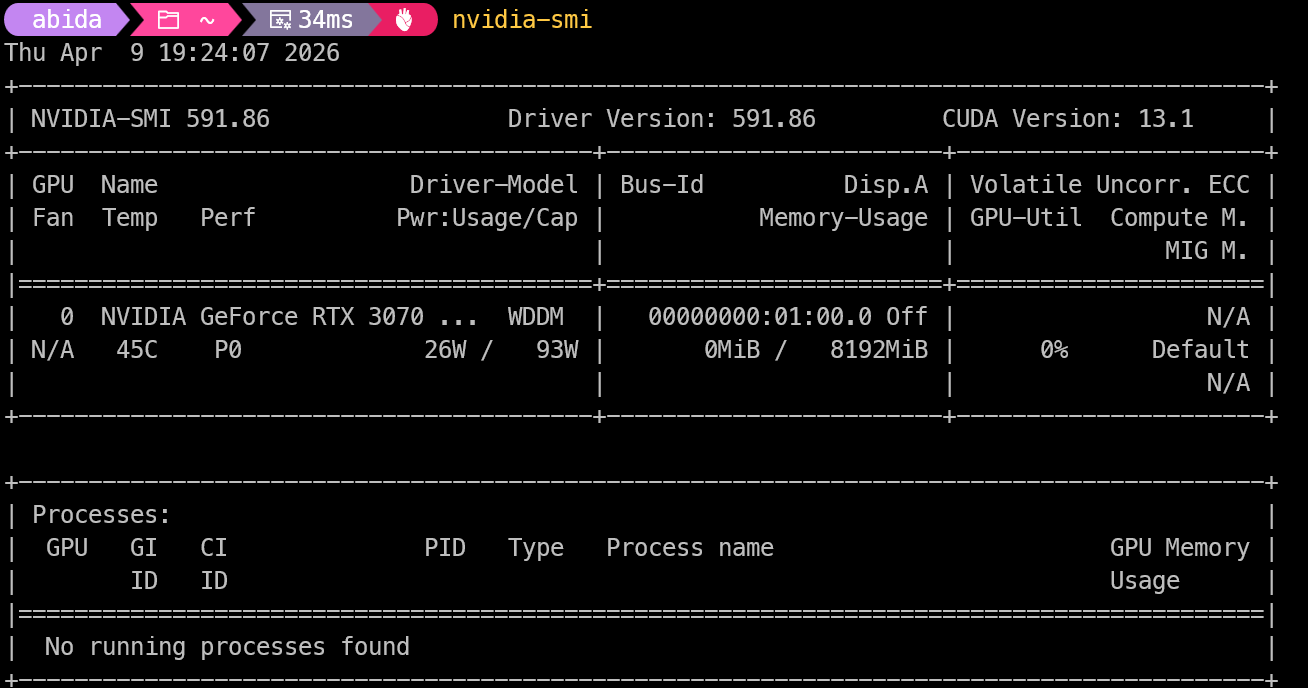
Voor betere snelheid raad ik aan de nieuwste NVIDIA GPU-driver en de CUDA Toolkit te installeren via NVIDIA’s officiële downloadpagina. De CUDA Toolkit is NVIDIA’s officiële ontwikkelomgeving voor GPU-versnelde applicaties.
Als alles is geïnstalleerd, open je de Opdrachtprompt of Terminal en voer je uit:
nvidia-smiDeze opdracht toont je NVIDIA GPU, stuurprogrammaversie en CUDA-ondersteuning. Als je GPU correct wordt weergegeven, is je systeem klaar om GPU-acceleratie te gebruiken om Bonsai lokaal te draaien.
Ga eerst naar de Bonsai 8B GGUF-repository op Hugging Face en download het GGUF-modellbestand rechtstreeks via de downloadknop.
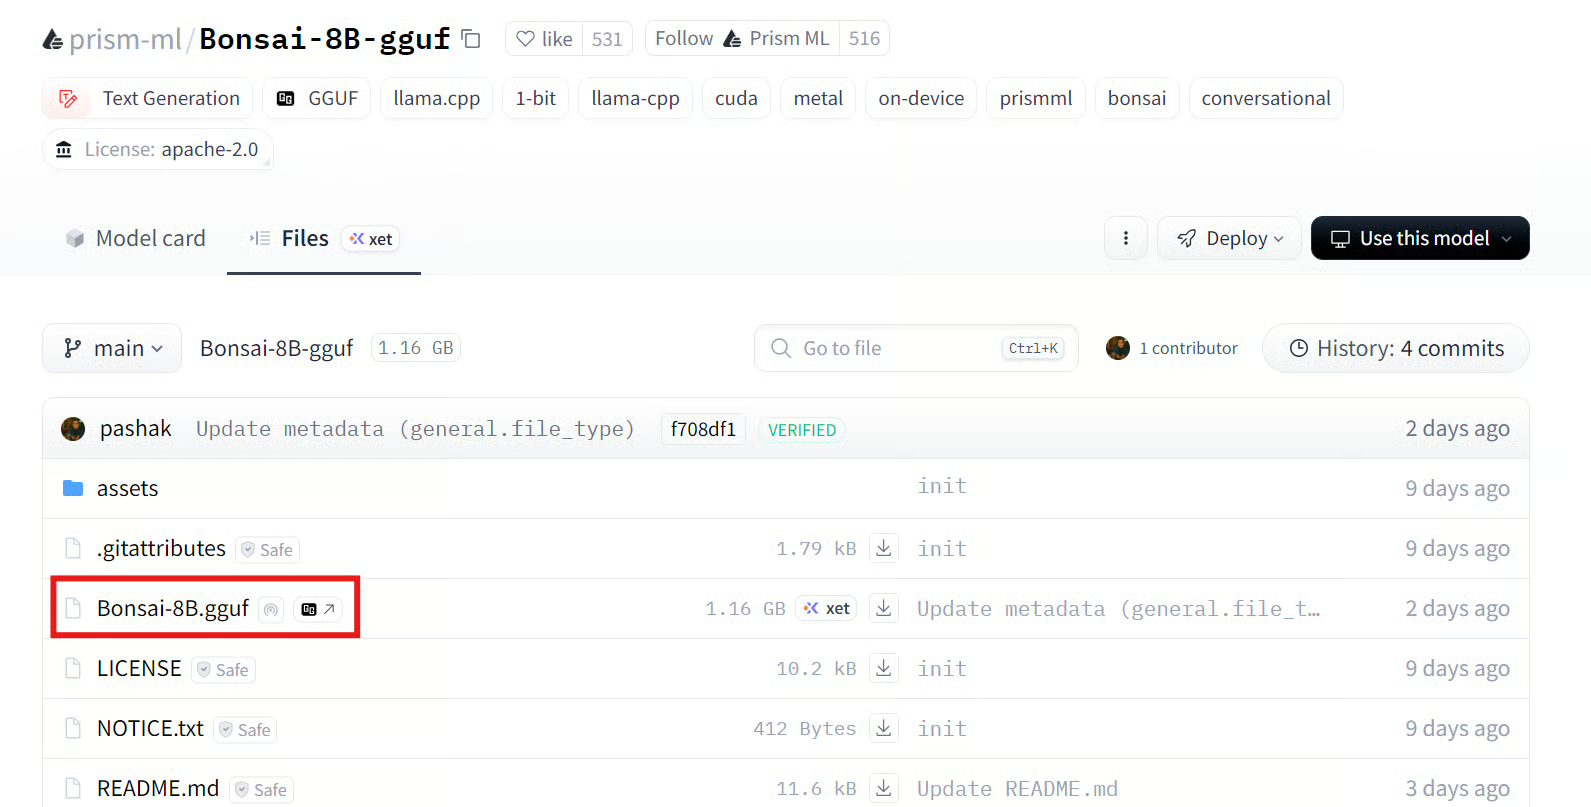
Maak daarna een map met de naam "Bonsai" op je systeem. Maak daarin een tweede map genaamd "model" en plaats het gedownloade GGUF-bestand in die map.
Open vervolgens de PrismML llama.cpp-releas pagina en download de vooraf gebouwde Windows x64-build die overeenkomt met jouw CUDA-versie. Voor deze tutorial download je het Windows x64 (CUDA 13.1)-bestand en de CUDA 13.1 DLL's van dezelfde releasepagina.
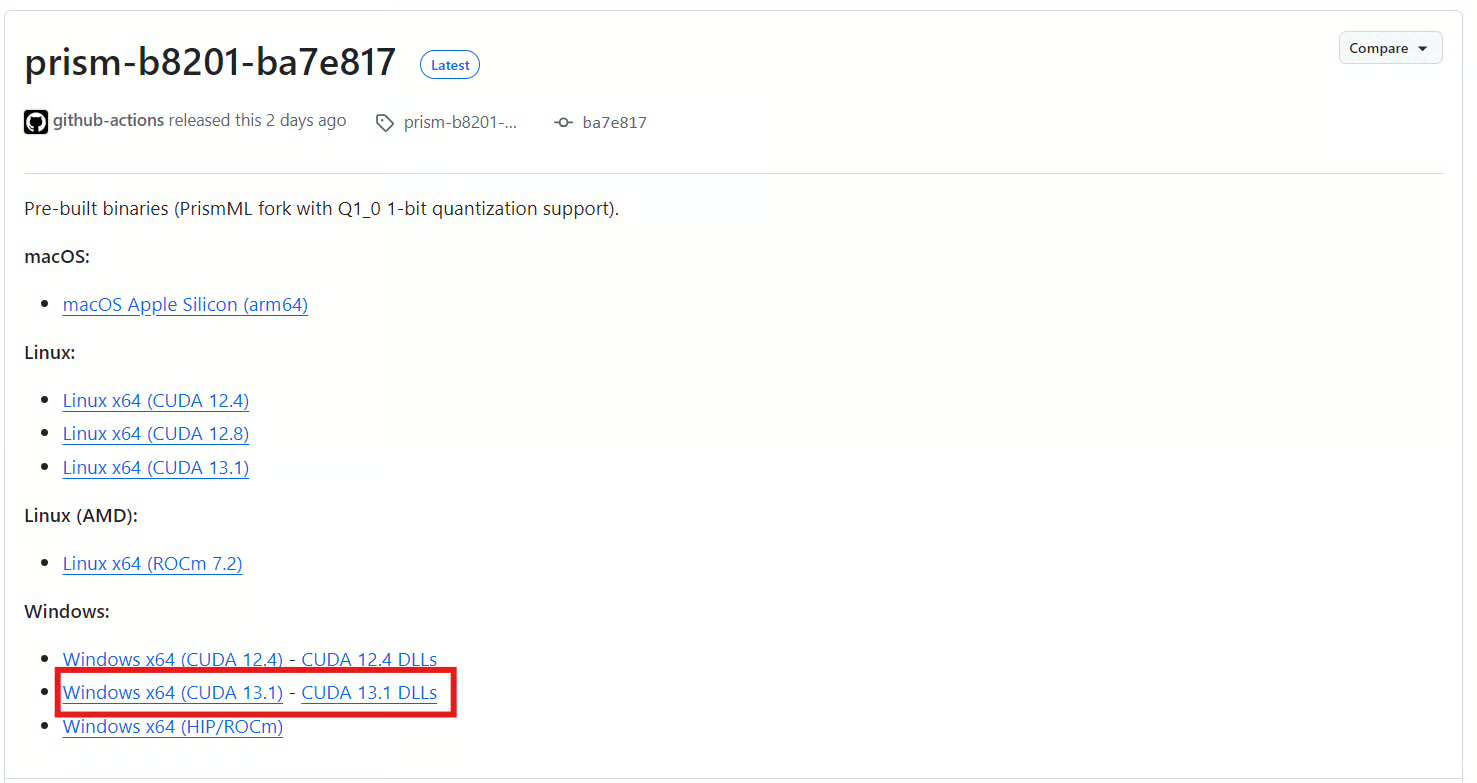
Na het downloaden van beide ZIP-bestanden pak je ze uit in de eerder aangemaakte map "Bonsai".
Als dit klaar is, bevat de map je modeldirectory met het Bonsai GGUF-bestand, plus de llama.cpp-bestanden die nodig zijn om het model in de command line en als lokale server te draaien.
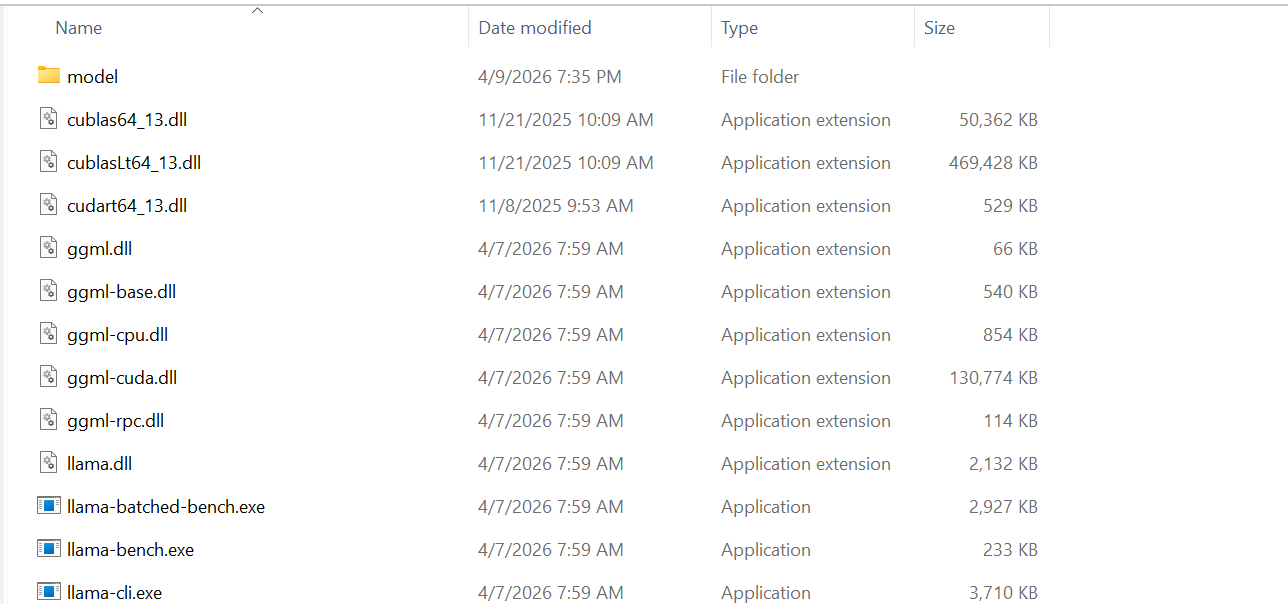
Open nu je "Bonsai"-map, klik met de rechtermuisknop in een leeg gebied en kies Openen in Terminal. Zo kun je het model rechtstreeks draaien vanuit de map met de llama.cpp-bestanden en je "model"-directory.
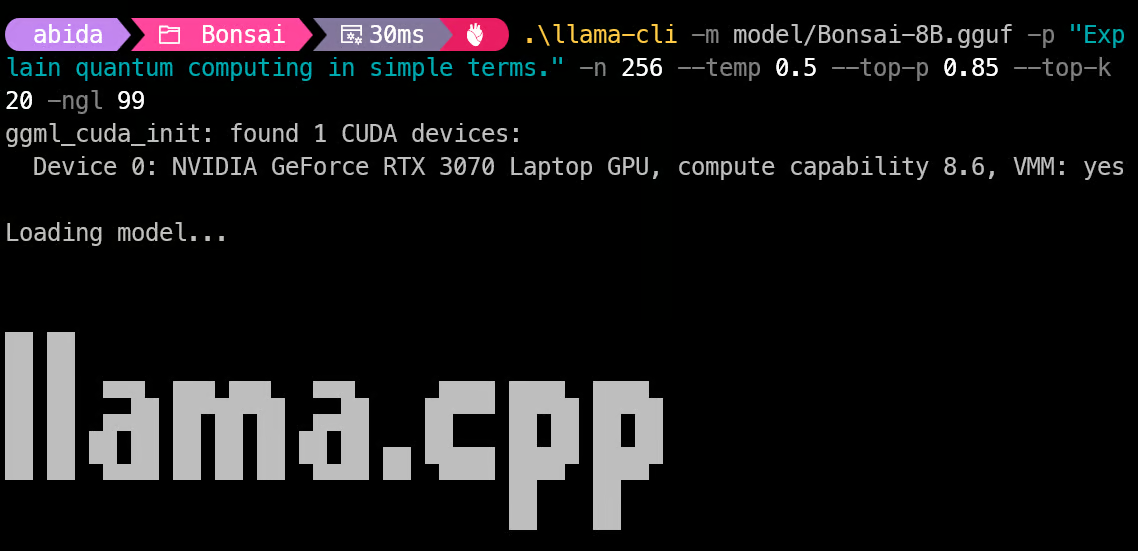
Voer vervolgens de volgende opdracht uit om Bonsai te testen met llama-cli:
.\llama-cli -m model/Bonsai-8B.gguf -p "Explain quantum computing in simple terms." -n 256 --temp 0.5 --top-p 0.85 --top-k 20 -ngl 99Deze opdracht volgt dezelfde aanbevolen prompt- en generatie-instellingen als in de officiële Bonsai-quickstart, waaronder temperature 0.5, top-p 0.85, top-k 20 en -ngl 99 voor het offloaden van lagen naar de GPU.
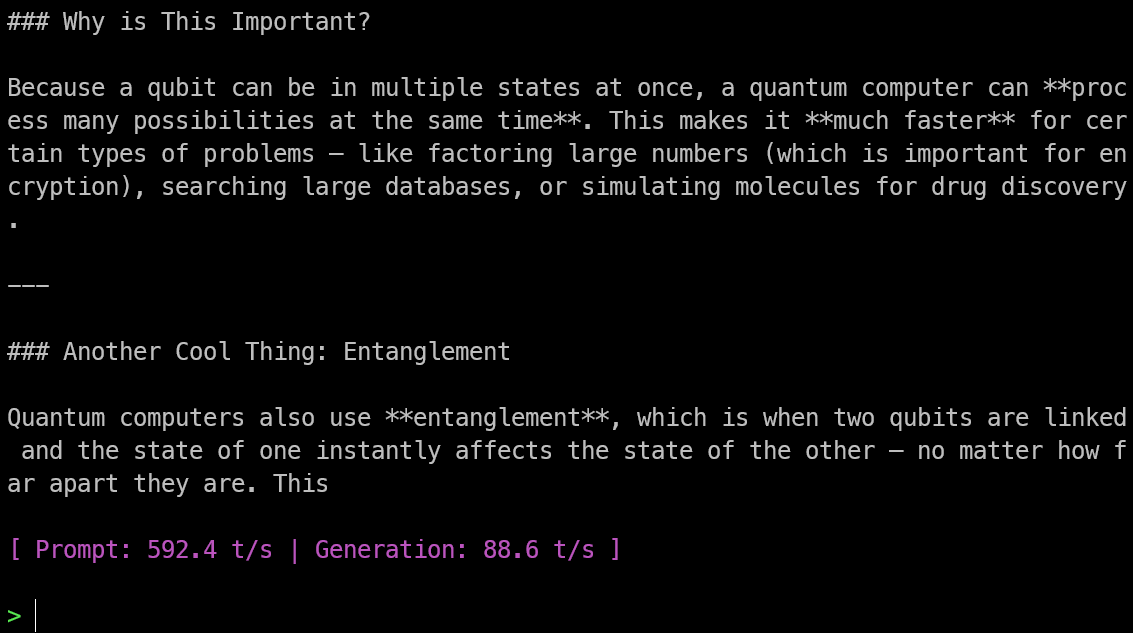
In mijn test werd het model in minder dan een seconde in het GPU-geheugen geladen en was de respons zowel snel als accuraat.
Ik haalde ook ongeveer 88,6 tokens per seconde, wat erg indrukwekkend is voor een lokaal model op een oudere laptop.
Na het testen van het model in de CLI kun je het draaien als een lokale inferentieserver met llama-server:
.\llama-server -m model/Bonsai-8B.gguf -ngl 99 --host 127.0.0.1 --port 8033Dit volgt dezelfde lokale server-setup als op de officiële Bonsai-modelpagina, waar PrismML llama-server gebruikt om het model via een lokale HTTP-endpoint te serveren.
In mijn test werd het model in minder dan 5 seconden in het geheugen geladen.
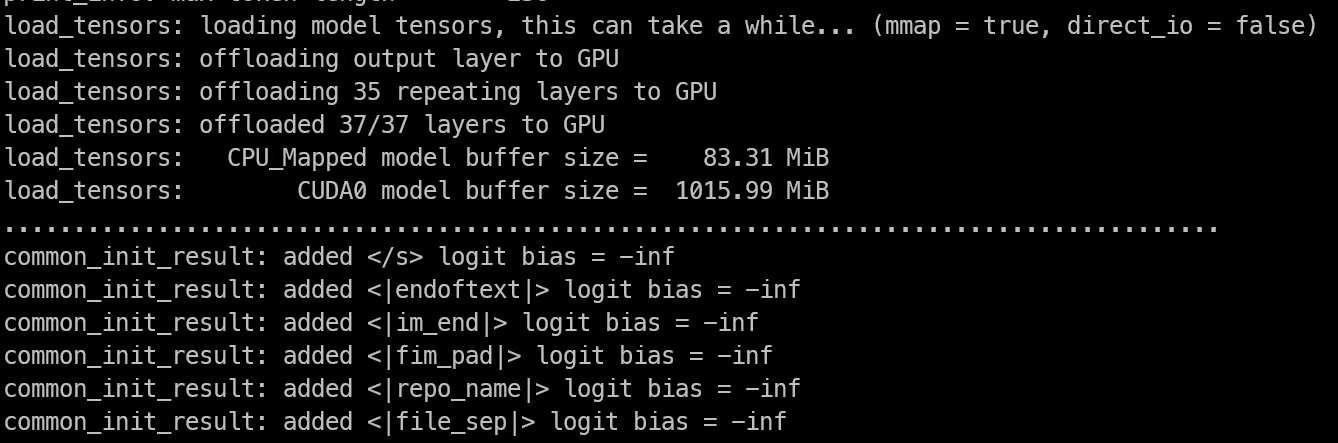
Zodra het laden klaar is, zie je in de terminal dat de server draait op 127.0.0.1:8033. Dat betekent dat Bonsai nu beschikbaar is via een lokale API-endpoint op je machine.
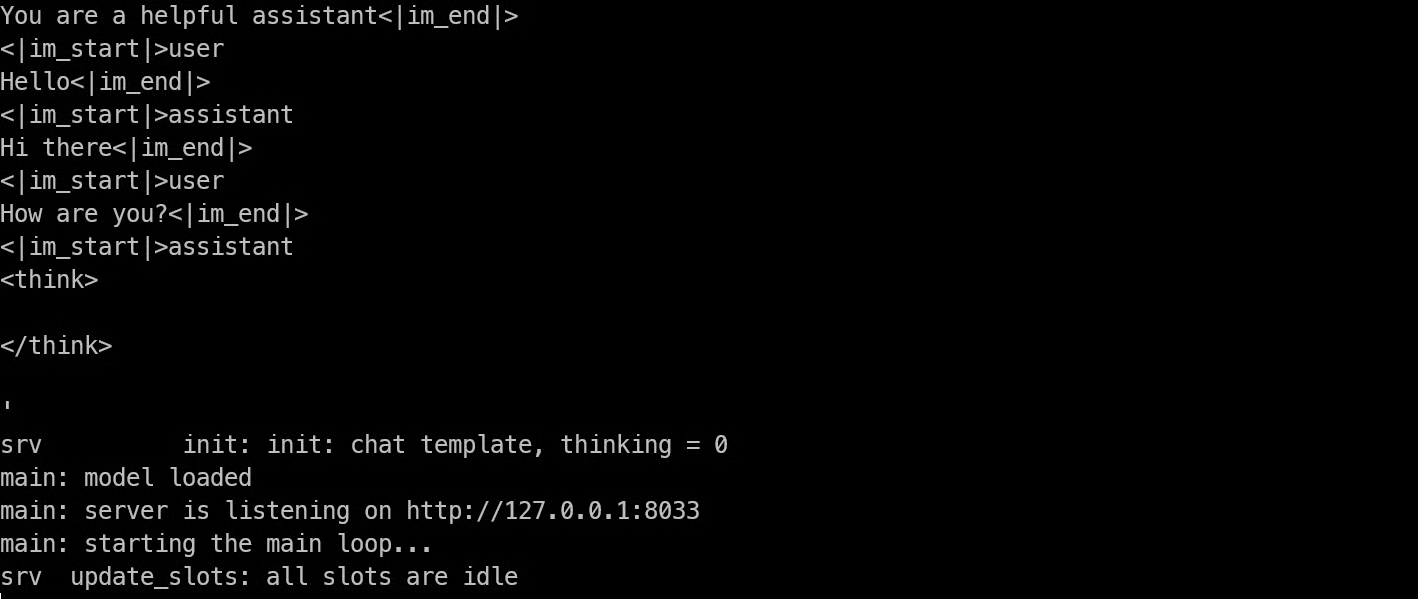
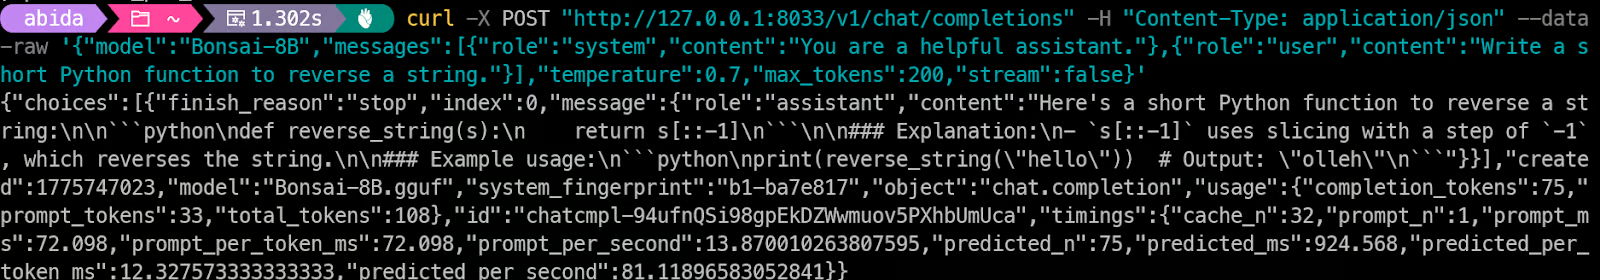
Nu de Bonsai-server draait, is de volgende stap de lokale API testen met curl. De llama-server-endpoint is OpenAI-compatibel, dus je kunt een verzoek sturen naar /v1/chat/completions en een normale chatcompletion-respons terugkrijgen.
Voer de volgende opdracht uit in je terminal:
curl -X POST "http://127.0.0.1:8033/v1/chat/completions" -H "Content-Type: application/json" --data-raw '{"model":"Bonsai-8B","messages":[{"role":"system","content":"You are a helpful assistant."},{"role":"user","content":"Write a short Python function to reverse a string."}],"temperature":0.7,"max_tokens":200,"stream":false}'Als alles werkt, retourneert de server een JSON-respons met de gegenereerde output.
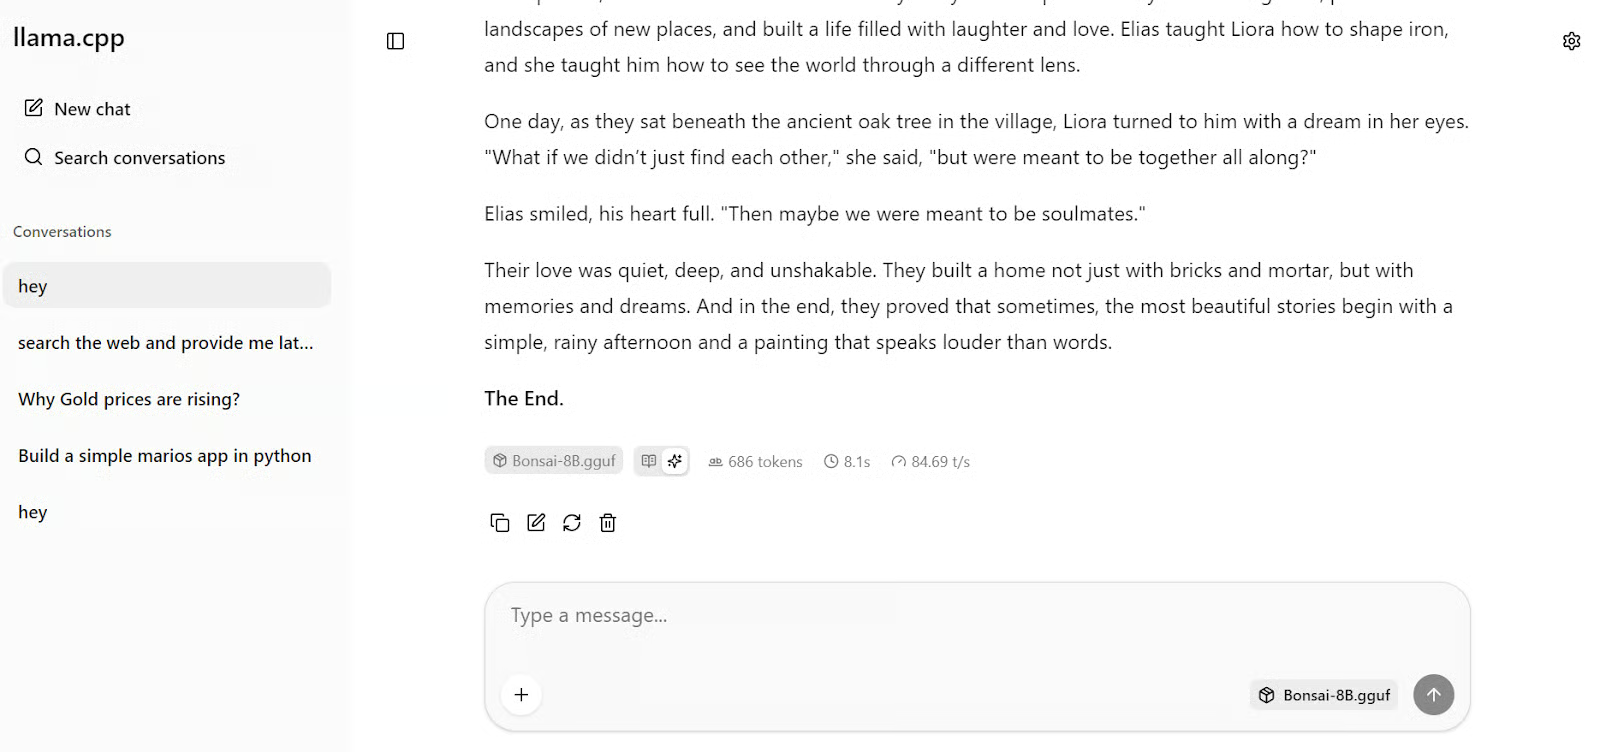
Zodra de server draait, open je http://127.0.0.1:8033/ in je browser. De llama.cpp-server heeft een ingebouwde web-UI.
Dit geeft je een eenvoudige ChatGPT-achtige interface om je lokaal draaiende model te testen. In mijn geval opende de UI direct en kon ik meteen met Bonsai chatten vanuit de browser.
Ik vroeg eerst om een verhaal te schrijven en binnen enkele seconden kwam er een respons met ongeveer 85 tokens per seconde.
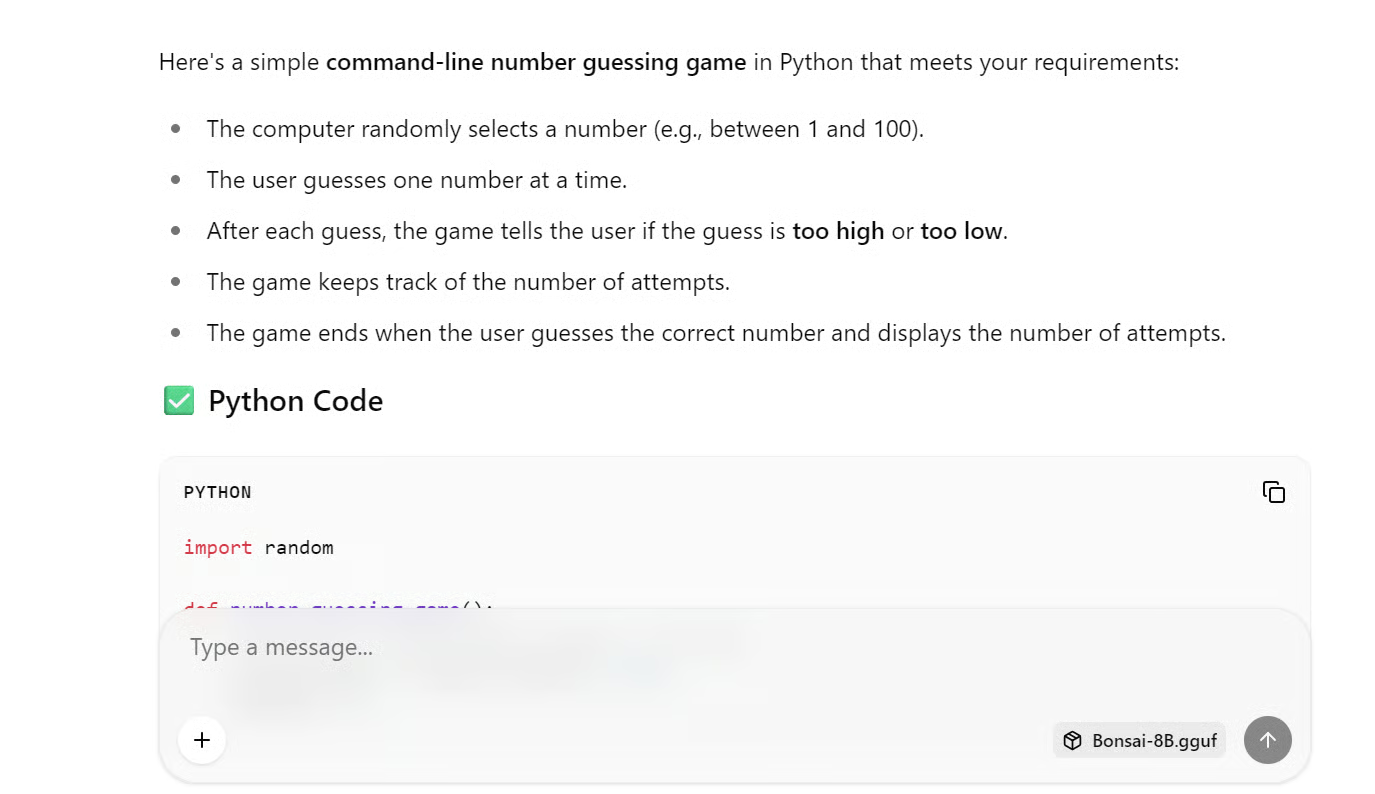
Om te zien hoe het een echte codingtaak aanpakt, gaf ik deze prompt:
Write Python code to build a command-line number guessing game where the user guesses a randomly selected number, receives "too high" or "too low" hints after each guess, and sees the total number of attempts once they guess correctly.Opnieuw was de respons snel. Het model genereerde de code plus eenvoudige instructies over hoe je het bestand opslaat en met Python uitvoert.
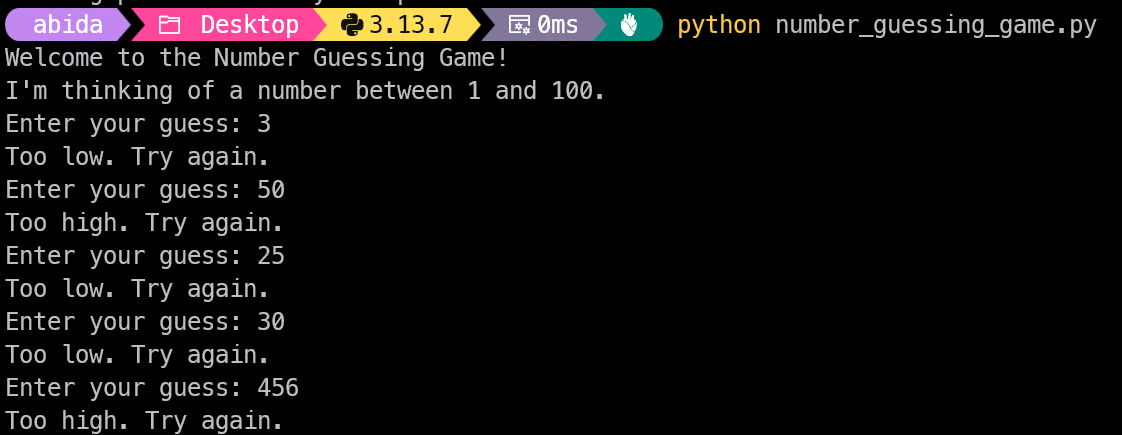
Ik kopieerde de code naar een Python-bestand, draaide het in de terminal en het werkte meteen probleemloos.
Ik testte ook een tweede prompt om te zien hoe het front-endgeneratie afhandelde:
Create a simple, clean HTML personal profile website for Abid Ali Awan, a Data Scientist, with sections for a hero intro, about, skills, projects, and contact, using modern styling and placeholder content that can be customized later.Opnieuw was de respons snel. Ik kopieerde de gegenereerde code naar een HTML-bestand en opende het in de browser, en de pagina werd correct weergegeven.
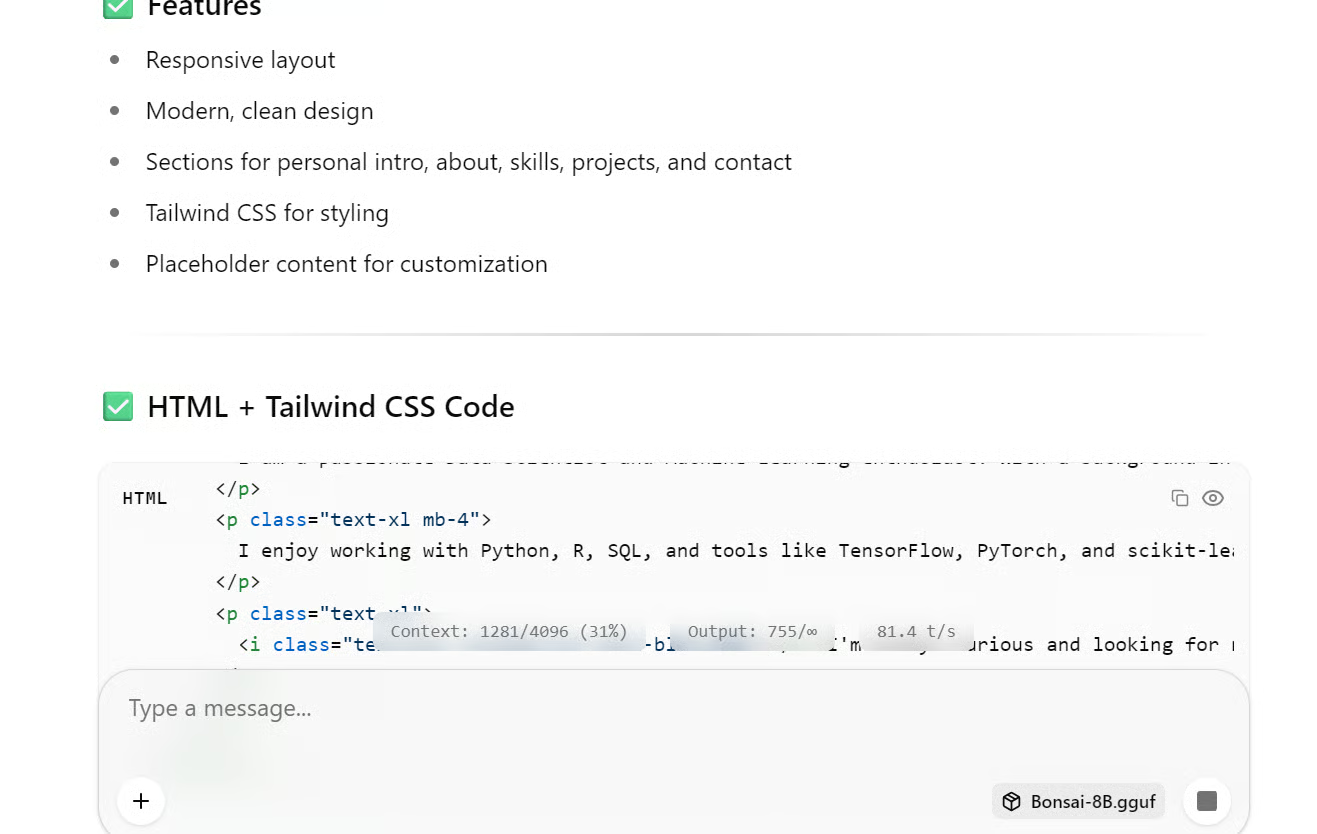
Voor een model dat zo klein is, was het resultaat oprecht indrukwekkend.
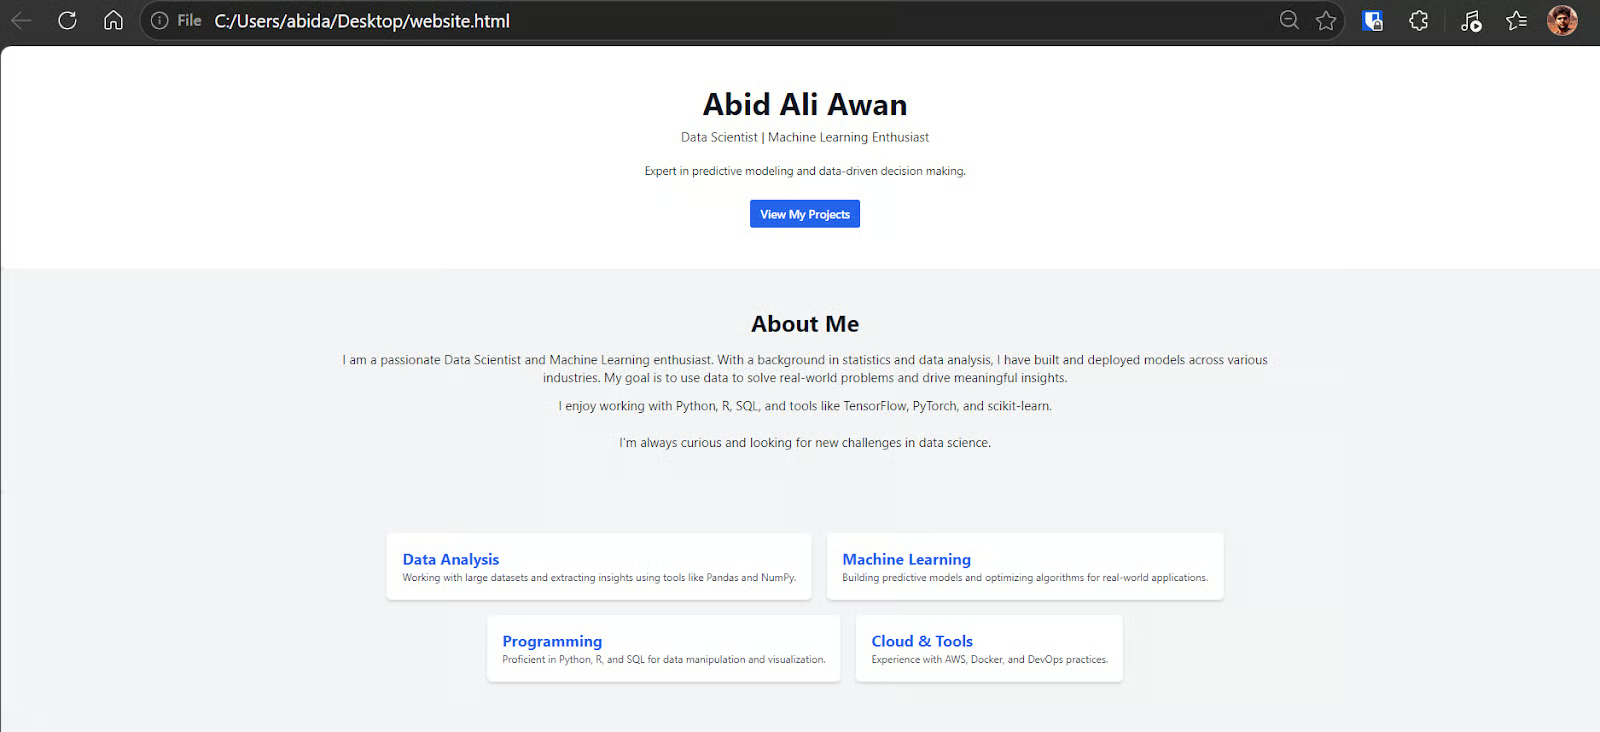
Wat me het meest verraste aan Bonsai was de combinatie van snelheid, formaat en intelligentie. Ik had niet verwacht dat een model dat zo klein is, zo snel en bruikbaar zou voelen op een oudere Windows-laptop.
De volledige setup was ook veel eenvoudiger dan ik verwachtte. Ik hoefde alleen het GGUF-bestand van Hugging Face en de PrismML llama.cpp-buildbestanden te downloaden, alles in één map te plaatsen en de commando's in de terminal uit te voeren om het model lokaal te testen en te serveren. Van begin tot eind deed ik er minder dan twee minuten over om van nul setup naar daadwerkelijk gebruik van het model te gaan.
De llama.cpp WebUI maakte de hele ervaring nog toegankelijker, vooral voor iemand met beperkte kennis van lokale AI-setup of compute. Zodra de server draaide, kon ik prompts testen, code genereren en creatieve schrijftaken proberen via een eenvoudige browserinterface zonder extra tools.
Ik vond de kwaliteit van de outputs ook goed. Voor een model van dit formaat ging Bonsai verrassend goed om met zowel code als creatief schrijven. Het was snel in de CLI, snel via de lokale server en snel in de WebUI. Dat gezegd hebbende, denk ik niet dat een model dat zo klein is de juiste keuze is voor agentische coding of complexere taken die diepere redenering en langere contextverwerking nodig hebben.
Toch denk ik dat 1-bit modellen een veelbelovende richting zijn als je lokaal wilt draaien. Ze bieden een sterke balans tussen efficiëntie en intelligentie en maken lokale AI veel praktischer op alledaagse hardware. Ik zou graag een groter 1-bit model proberen, iets dichter bij het Qwen3.5-27B-bereik, omdat dat mogelijk een nog betere balans biedt tussen snelheid, geheugenverbruik en capaciteit.
LLM-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min