{count, plural, one {Leerpad} other {Leerpaden}}
AI-basisprincipes
{hours} uur
OpenAI heeft zojuist Deep Research uitgebracht, een AI-agent die wordt aangestuurd door een versie van het aankomende o3-model. Het is ontworpen om het web te doorzoeken, meerdere bronnen te analyseren en grote hoeveelheden informatie te synthetiseren.
Je vraagt je misschien af: doet ChatGPT dit niet al?
In tegenstelling tot een gewone ChatGPT-sessie die snelle antwoorden genereert, kan Deep Research meerstaps onderzoeken uitvoeren, meerdere bronnen aanhalen en gestructureerde rapporten produceren.
Als je bijvoorbeeld ooit hebt uitgezocht welke auto je het beste kunt kopen—reviews vergelijken, kosten afwegen, enzovoort—dan weet je dat betrouwbare informatie vinden tijd kost en veel internetzoekwerk. Deep Research is precies voor dit soort werk gebouwd.
Ik heb Deep Research getest en was zowel onder de indruk als teleurgesteld. Het toont veel potentie, maar produceert ook onjuiste feiten en gevolgtrekkingen. In deze blog ben ik je menselijke agent en vat ik alles samen wat je moet weten over Deep Research. Ik neem je mee langs praktische voorbeelden, deel prompting-tips en laat zien waar Deep Research uitblinkt—en waar je extra voorzichtig moet zijn.
OpenAI’s Deep Research is een AI-gestuurde agent die is ontworpen voor diepgaand, meerstaps onderzoek op internet. In tegenstelling tot de standaard browse-mogelijkheden van ChatGPT, die snelle antwoorden geven, zoekt, analyseert en synthetiseert Deep Research autonoom informatie uit honderden online bronnen.
Deep Research is bedoeld voor iedereen die behoefte heeft aan uitgebreid en betrouwbaar onderzoek, waaronder:
Kortom, als een taak inhoudt dat je meerdere bronnen doorneemt, gegevens kruisverwijst en informatie samenvat tot een bruikbaar formaat, is Deep Research de juiste tool.
Aangedreven door een versie van het aankomende o3-model bouwt Deep Research voort op OpenAI’s vooruitgang in redeneermodellen, maar is specifiek geoptimaliseerd voor webbrowse en analyse van data uit de echte wereld.
Om dit te bereiken trainde OpenAI Deep Research met reinforcement learning op browse- en redeneertaken uit de praktijk. Daardoor kan het model een iteratief, stapsgewijs onderzoeksproces volgen en verbetert het zijn vermogen om complexe onderwerpen te synthetiseren tot gestructureerde rapporten.
Humanity’s Last Exam is een nieuw gelanceerde benchmark die AI test met meerkeuze- en kortantwoordvragen op expertniveau in meer dan 100 vakken, van taalkunde en raketwetenschap tot ecologie en wiskunde. Deze evaluatie meet het vermogen van een AI om over disciplines heen te redeneren en gespecialiseerde kennis op te zoeken wanneer dat nodig is—een cruciale vaardigheid voor onderzoeksgerichte modellen.
Deep Research behaalde een recordnauwkeurigheid van 26,6%, veel hoger dan eerdere modellen, waaronder OpenAI’s eigen o1 (9,1%), DeepSeek-R1 (9,4%) en Claude 3.5 Sonnet (4,3%). Opvallend waren de grootste verbeteringen ten opzichte van OpenAI’s o1 te zien in scheikunde, geestes- en sociale wetenschappen, en wiskunde, waar Deep Research liet zien complexe vragen te kunnen ontleden en gezaghebbende informatie op te halen.
|
Model |
Nauwkeurigheid (%) |
|
GPT-4o |
3,3 |
|
Claude 3.5 Sonnet |
4,3 |
|
Gemini Thinking |
6,2 |
|
OpenAI o1 |
9,1 |
|
DeepSeek-R1* |
9,4 |
|
OpenAI o3-mini (high)* |
13,0 |
|
OpenAI Deep Research (met browsing + Python-tools) |
26,6 |
* Modellen getest op de tekst-only subset van het examen omdat ze niet multimodaal zijn. Bron: OpenAI
GAIA (General AI Agent benchmark) evalueert hoe goed AI-systemen omgaan met vragen uit de echte wereld, waarbij een combinatie van redeneren, webbrowsen, multimodale vaardigheid en toolgebruik nodig is.
Deep Research zette een nieuw state-of-the-art (SOTA) record neer en voert de externe GAIA-ranglijst aan met sterke prestaties op alle moeilijkheidsniveaus. Het model behaalde vooral hoge nauwkeurigheid bij Level 3-taken, die complex, meerstaps onderzoek en synthetisering vereisen.
|
GAIA-evaluatie |
Niveau 1 |
Niveau 2 |
Niveau 3 |
Gemiddeld |
|
Vorige SOTA |
67,92% |
67,44% |
42,31% |
63,64% |
|
Deep Research (pass@1) |
74,29% |
69,06% |
47,6% |
67,36% |
|
Deep Research (cons@64) |
78,66% |
73,21% |
58,03% |
72,57% |
Bron: OpenAI
De hoge pass@1-score van Deep Research laat zien dat zelfs de eerste poging om een GAIA-vraag te beantwoorden nauwkeuriger is dan eerdere modellen. De cons@64-score (die prestaties bij meerdere antwoordpogingen meet) benadrukt bovendien het vermogen om zichzelf te corrigeren en antwoorden te verfijnen op basis van nieuwe informatie.
OpenAI voerde ook interne evaluaties uit, waarbij Deep Research door domeinexperts werd beoordeeld op taken op expertniveau. Ik vond de interne evaluaties behoorlijk interessant!
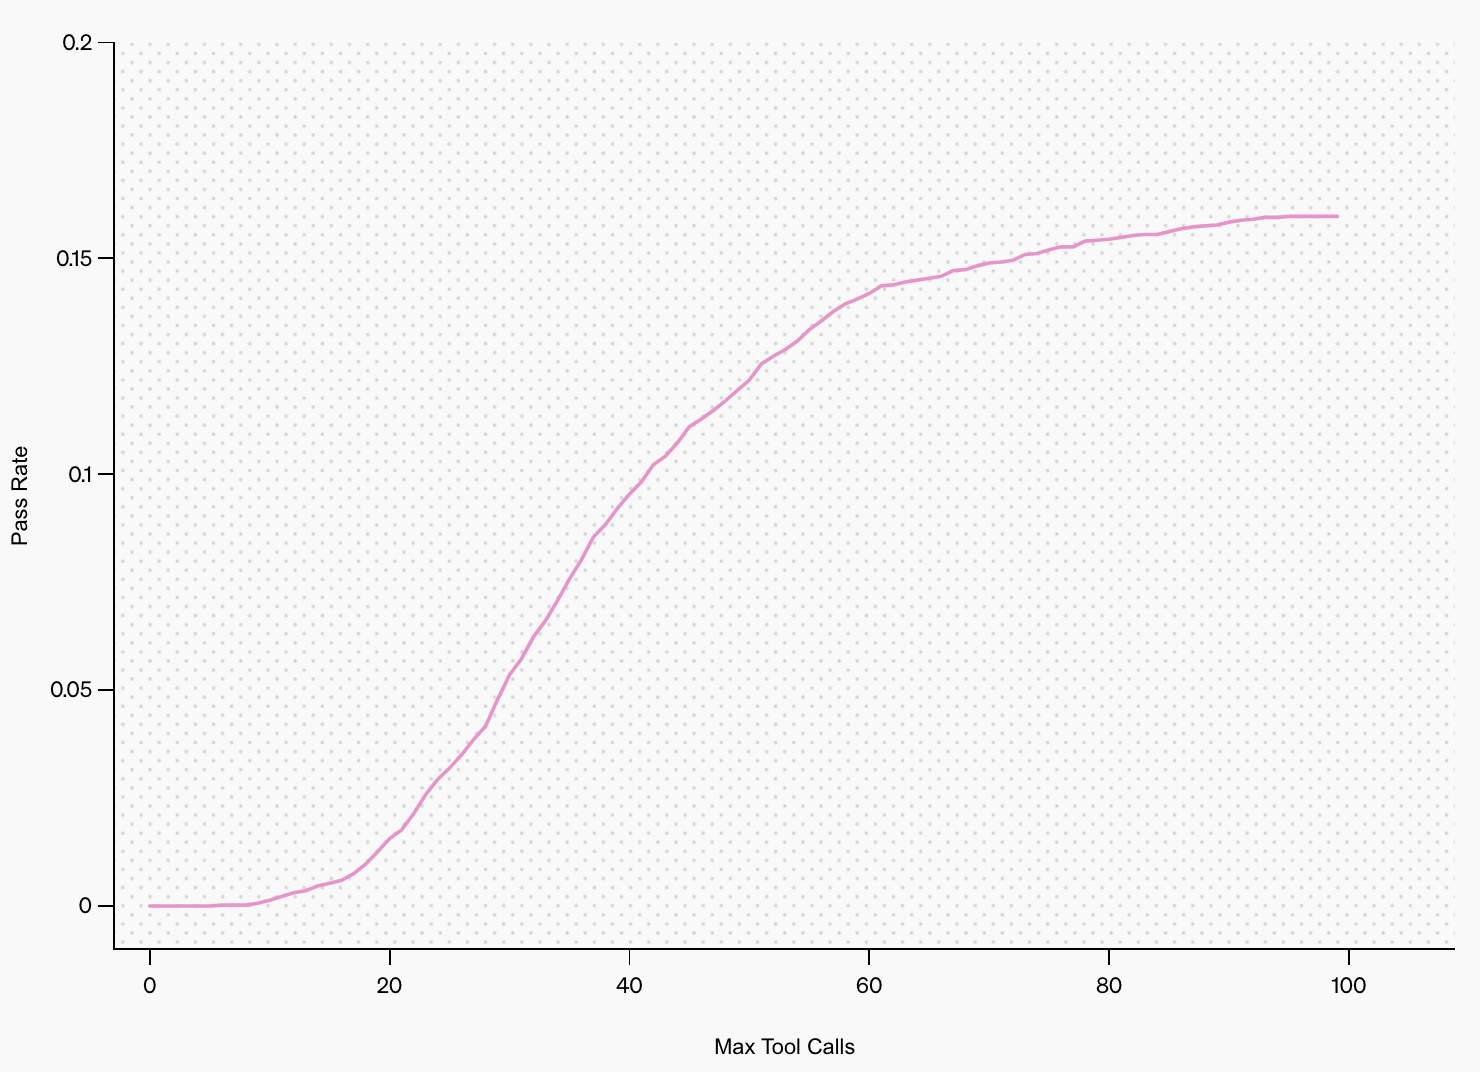
De onderstaande grafiek laat zien dat het slagingspercentage stijgt naarmate er meer toolcalls worden gedaan. Dit benadrukt hoe belangrijk het is om het iteratief te laten browsen en analyseren—meer tijd om na te denken leidt tot betere resultaten.
Bron: OpenAI
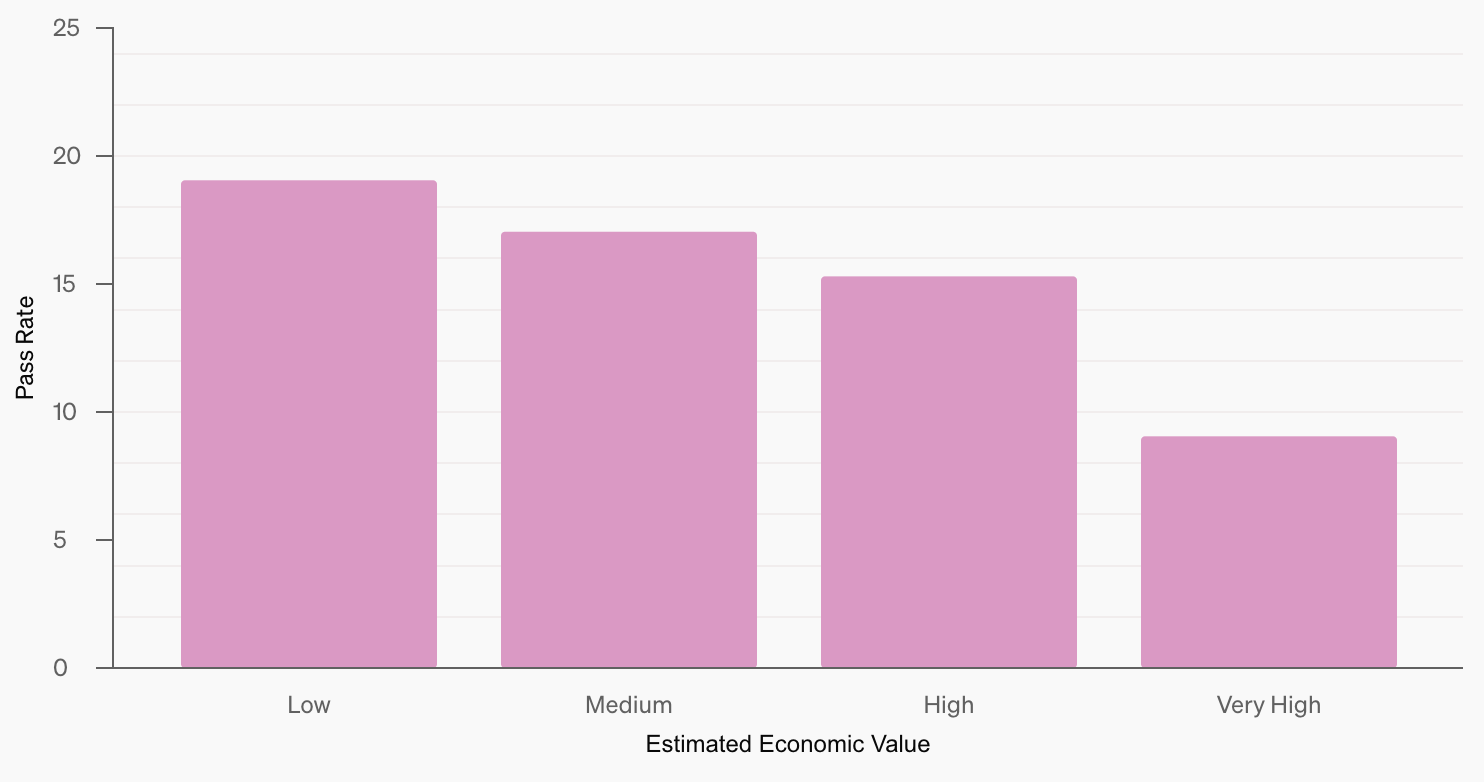
Laten we naar nog een grafiek kijken—zie hieronder. Deep Research presteert het best bij taken met een lagere geschatte economische waarde, waarbij de nauwkeurigheid afneemt naarmate de potentiële financiële impact van de taak toeneemt. Dit suggereert dat economisch belangrijkere taken vaak complexer zijn of afhankelijk van propriëtaire kennis die online niet breed toegankelijk is.
Bron: OpenAI
De onderstaande grafiek zet slagingspercentages af tegen het aantal uren dat een mens nodig zou hebben om elke taak te voltooien. Het model presteert het best bij taken waar een persoon 1-3 uur over zou doen, maar de prestatie neemt niet consistent af met de tijd—wat aangeeft dat wat AI lastig vindt niet altijd overeenkomt met wat voor mensen tijdrovend is.
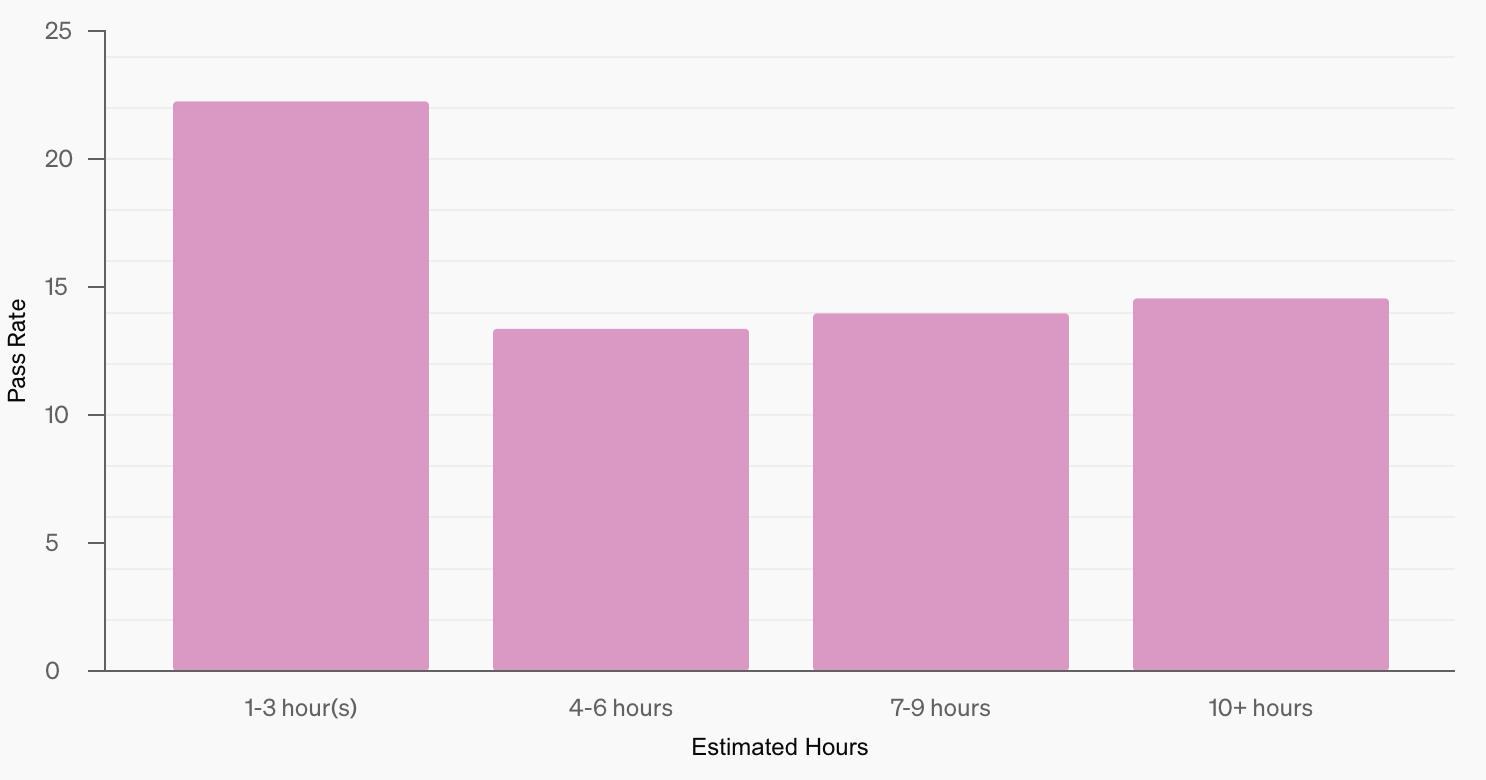
Bron: OpenAI
Op het moment van publicatie is Deep Research alleen beschikbaar voor Pro-gebruikers, met een limiet van 100 zoekopdrachten per maand, maar OpenAI is van plan de toegang binnenkort uit te breiden naar Plus-, Team- en Enterprise-gebruikers.
Naar mijn mening zit Deep Research nog in een vroege fase. Hoewel het veel belooft, laat het eerste voorbeeld hieronder veel problemen zien. Het tweede voorbeeld toont echter het enorme potentieel.
Ik worstel er voortdurend mee om een volledig overzicht te krijgen van de AI-ecosystemen van verschillende bedrijven. Neem Google, bijvoorbeeld—ze hebben Gemini 2.0 Flash, Imagen 3, Veo 2, Project Mariner, Project Astra… wat mis ik nog? Om eindelijk een helder overzicht te krijgen, gaf ik OpenAI’s Deep Research deze opdracht.
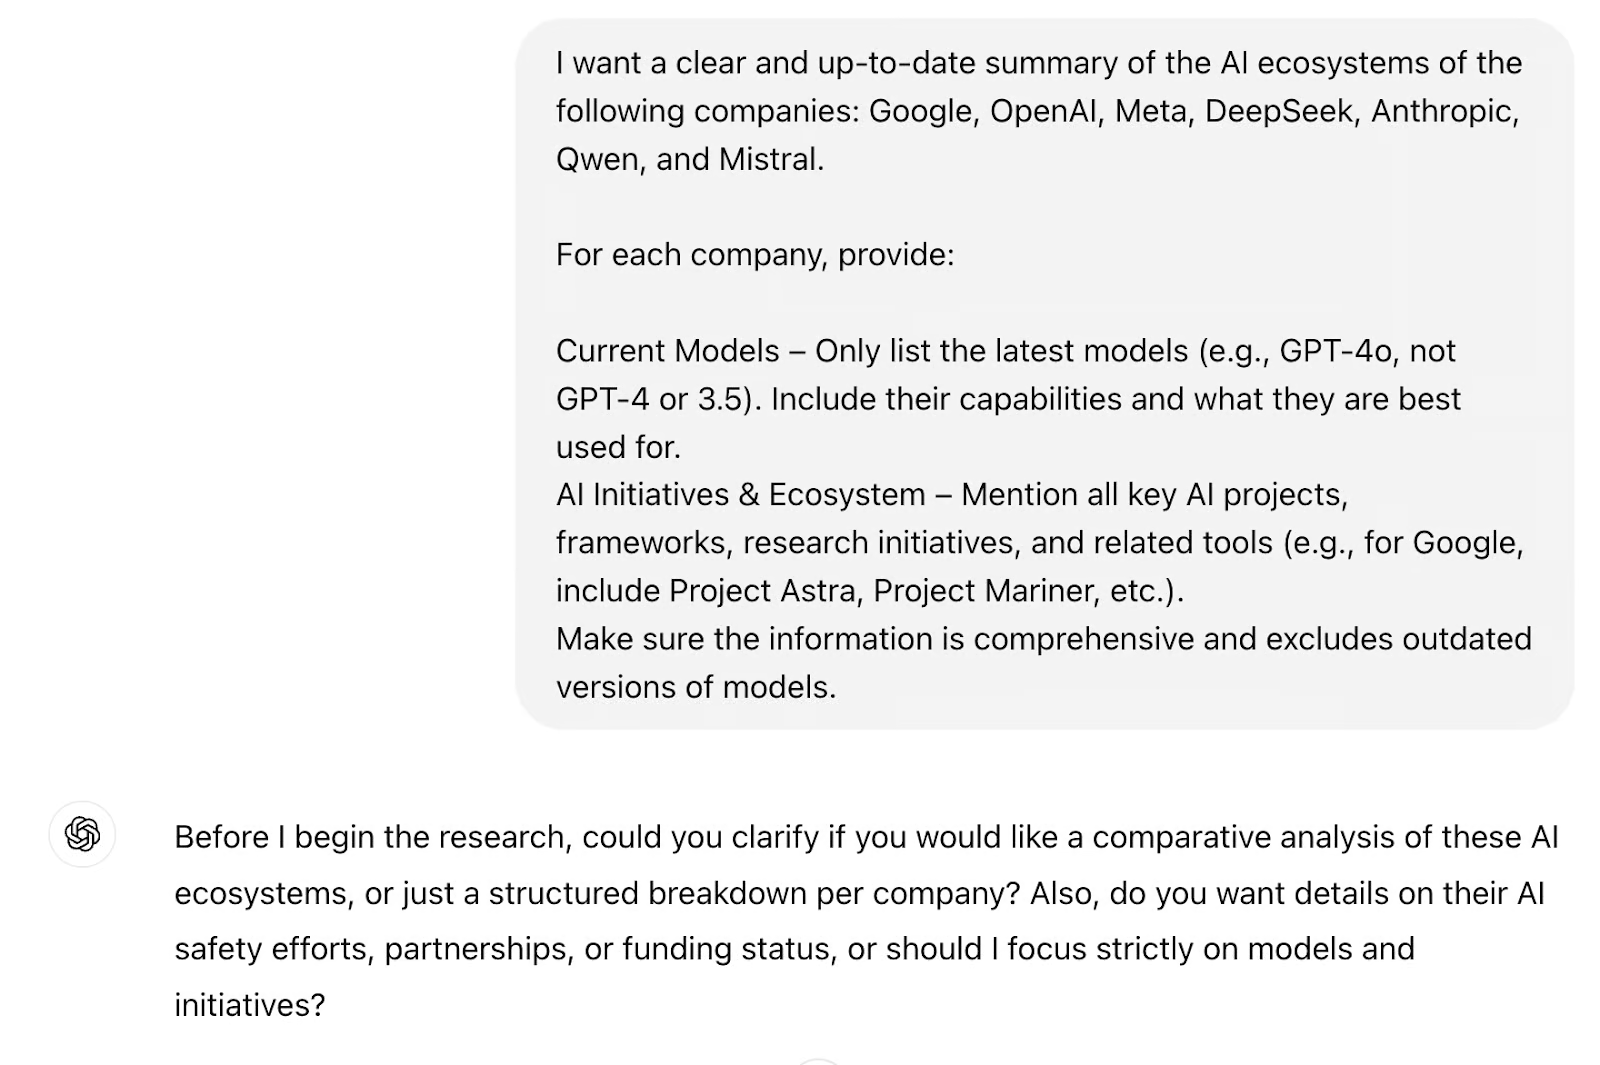
Let op dat het model niet direct met het onderzoek begon, maar eerst om verduidelijking vroeg. In al mijn tests probeerde het model, hoe specifiek mijn eerste prompt ook was, het onderzoek altijd verder af te bakenen. Dat is nuttig, vind ik, omdat ik vaak denk dat mijn prompt duidelijk en specifiek is, maar hij meestal baat heeft bij wat aanscherping.
Ik beantwoordde de vragen van het model en toen begon het onderzoek. Er opende een paneel aan de rechterkant van de browser waarop je de activiteit en bronnen van de agent in realtime zag:
Het duurde 11 minuten en het model raadpleegde 25 bronnen. Let op: een bron is een hoofdwebsite en het model kan meerdere pagina’s van die website doorlopen—bij 25 bronnen en gemiddeld vier pagina’s per bron kun je verwachten dat het model zo’n 100 webpagina’s heeft bezocht.
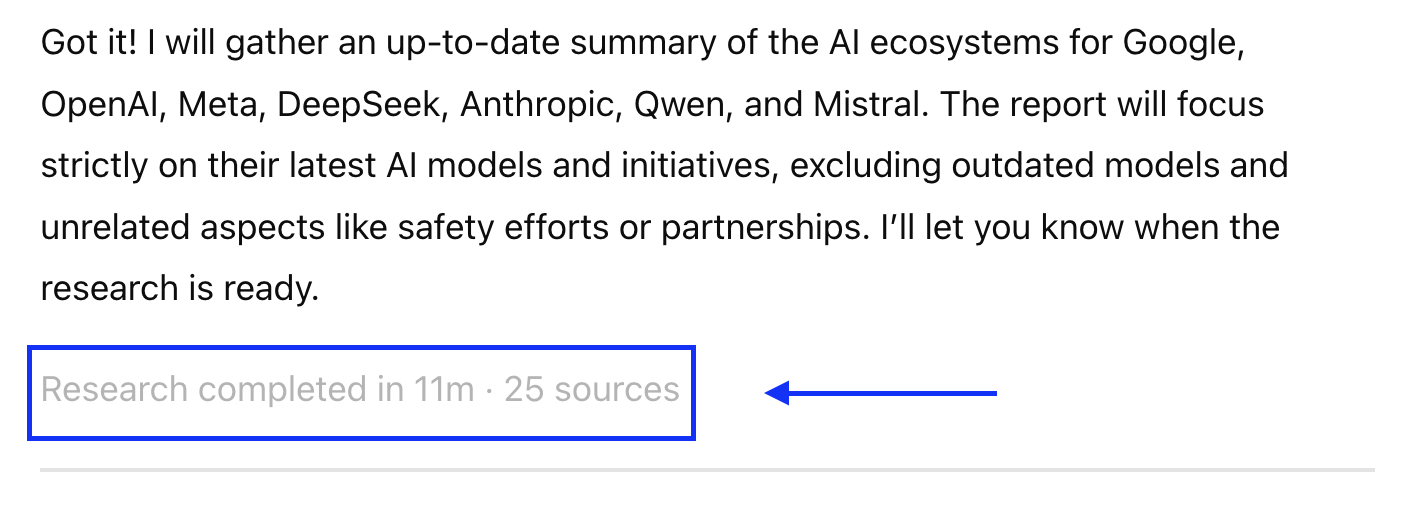
Al met al was ik teleurgesteld over het resultaat—je kunt het antwoord van Deep Research hier lezen. Maar laat ik beginnen met wat ik er wél goed aan vond:
Toch had het antwoord verschillende problemen, en ik richt me op de belangrijkste:
Deze problemen maken het lastig om OpenAI’s Deep Research te vertrouwen. Ik testte het expres op een onderwerp waar ik veel van weet, zodat ik het antwoord kon factchecken—maar wat als ik op Deep Research moest vertrouwen voor een onderwerp waar ik niets van afweet?
Misschien is het probleem met Deep Research dat het nog niet zo goed is in het identificeren van de meest actuele informatie. Daarom heb ik het getest op een meer tijdloos onderwerp—een onderwerp dat minder afhankelijk is van recente ontwikkelingen.
Ik rijd in een auto uit 2013 en denk er af en toe aan om hem te vervangen. Maar ik loop steeds tegen dezelfde vraag aan: moet ik nieuw of tweedehands kopen? Een nieuwe auto schrijft snel af, maar een oude kan hogere reparatiekosten betekenen. Ik wil weten wat experts hiervan vinden, dus dit was een uitstekende gelegenheid om Deep Research verschillende studies en meningen te laten doorzoeken en een rapport te laten samenstellen.
Voor we doorgaan, een tip: optimaliseer je prompt met je favoriete LLM vóór je Deep Research aan het werk zet. Begin met: “Je bent een prompt engineer. Help me deze prompt te optimaliseren: (jouw prompt hier)”. Dit is de geoptimaliseerde prompt die ik voor Deep Research gebruikte:
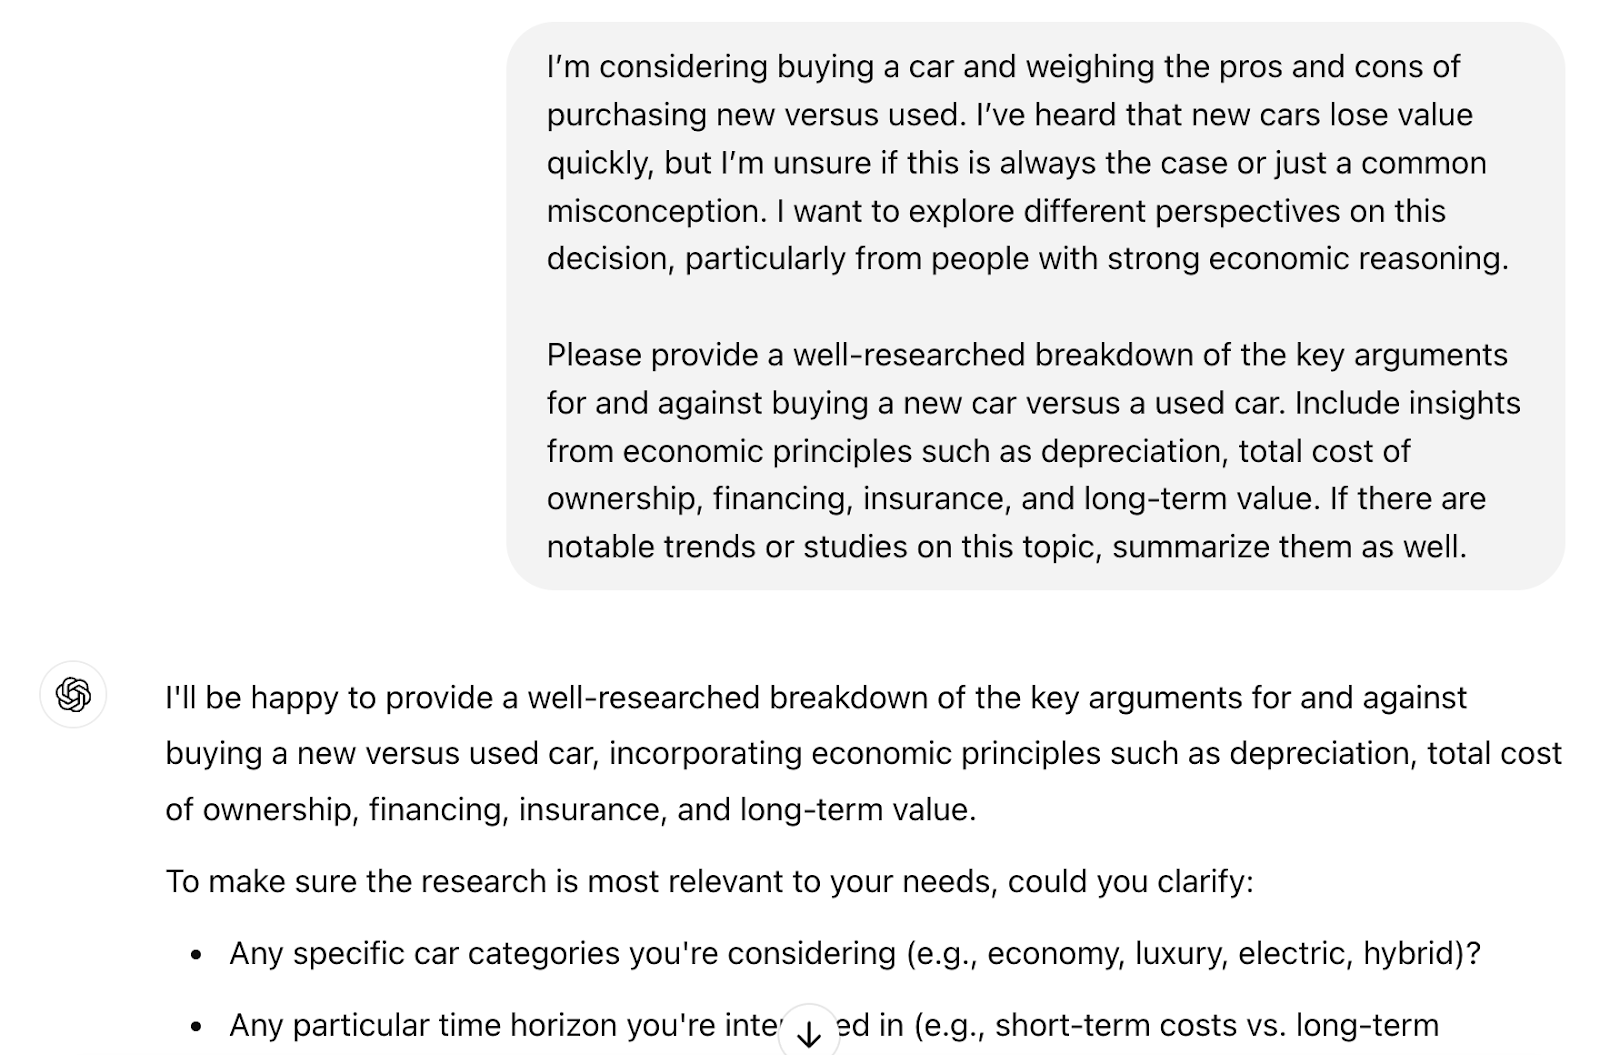
Net als eerder vroeg Deep Research om verduidelijkingen voordat het begon en rondde het het onderzoek in zes minuten af, waarbij het meerdere webpagina’s over 12 bronnen raadpleegde. Je kunt het volledige rapport hier lezen.
Dit keer was het rapport goed—héél goed!
Ik had nooit gedacht dat je dit probleem vanuit zoveel invalshoeken kunt benaderen. De breedte aan informatie was indrukwekkend en naar mijn schatting heeft Deep Research me ruim 10 uur browsen en research bespaard. Het haalde academische studies, branche-rapporten, analyses van markttrends, vergelijkingen van verzekeringskosten, enzovoort binnen.
Ik ben geen expert op dit gebied, dus ik kan de nauwkeurigheid van het rapport niet volledig beoordelen. Maar vanuit consumentenperspectief was veel informatie logisch en echt nuttig. Ik heb ook een paar details geverifieerd met de aangehaalde bronnen en geen problemen gevonden.
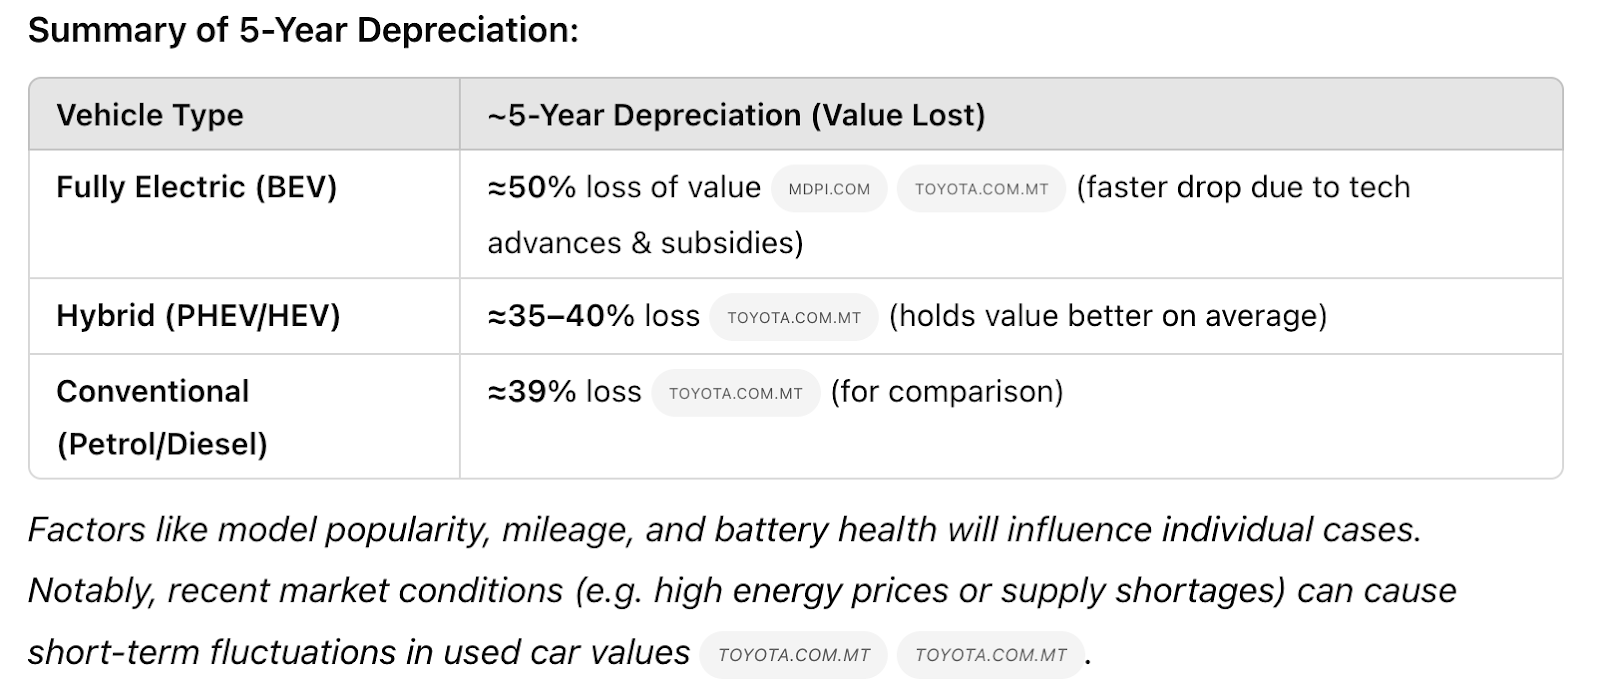
Net als in het eerste voorbeeld was de diepgang goed in balans en de outputstructuur uitstekend. Vooral de onderstaande tabel vond ik sterk—kijk maar naar die afschrijvingswaarden en je snapt waarom ik mijn 12 jaar oude hybride nog even houd.
OpenAI’s Deep Research toont veelbelovend en kan ons veel onderzoekstijd besparen. Het is echter nog onbetrouwbaar als het gaat om actuele informatie en levert soms onjuiste feiten of gebrekkige gevolgtrekkingen op.
Ik vind nog steeds dat Deep Research in een vroege fase zit, en het OpenAI-team erkent dit ook openlijk in hun aankondigingsartikel.
Eerlijk gezegd blijf ik terugkomen bij Deep Research, en ik hoop dat het steeds beter wordt.
Leer AI met deze cursussen!
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

