

Cursus
Werken met DeepSeek in Python
3 uur
1.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleIn januari 2025 bracht DeepSeek DeepSeek-R1 uit, de volgende stap in hun werk aan redeneermodellen. Het is een upgrade van hun eerdere DeepSeek-R1-Lite-Preview en laat zien dat ze serieus willen concurreren met OpenAI’s o1.
Sindsdien blijft DeepSeek het model verbeteren. In mei 2025 brachten ze DeepSeek-R1-0528 uit, een geüpgradede versie met betere benchmarkprestaties, minder hallucinaties en nieuwe mogelijkheden zoals function calling en ondersteuning voor JSON-uitvoer.
Hoewel DeepSeek op sommige punten misschien iets achterloopt op concurrenten, maken het open-sourcekarakter en de aanzienlijk lagere prijs het tot een aantrekkelijke optie voor de AI-community.
In deze blog neem ik de belangrijkste functies van DeepSeek-R1 door, het ontwikkelingsproces, de gedistilleerde modellen, hoe je er toegang toe krijgt, de prijs, en hoe het zich verhoudt tot de modellen van OpenAI.
Ik schreef dit artikel oorspronkelijk op de dag dat DeepSeek-R1 werd uitgebracht, maar ik heb het nu bijgewerkt met een nieuw onderdeel over de nasleep—hoe het de aandelenmarkt beïnvloedde, de economie van AI (inclusief de paradox van Jevons en de commoditisering van AI-modellen) en OpenAI’s beschuldiging dat DeepSeek hun modellen heeft gedistilleerd. Ik heb ook een bijgewerkt onderdeel toegevoegd over de nieuwe DeepSeek-R1-0528.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week kort uitlegt. Abonneer je en blijf scherp in een paar minuten per week:
DeepSeek-R1 is een open-source redeneermodel, ontwikkeld door DeepSeek, een Chinees AI-bedrijf, voor taken die logische gevolgtrekkingen, wiskundige probleemoplossing en besluitvorming in realtime vereisen.
Wat redeneermodellen zoals DeepSeek-R1 en OpenAI’s o1 onderscheidt van traditionele taalmodellen, is hun vermogen om te laten zien hoe ze tot een conclusie zijn gekomen.
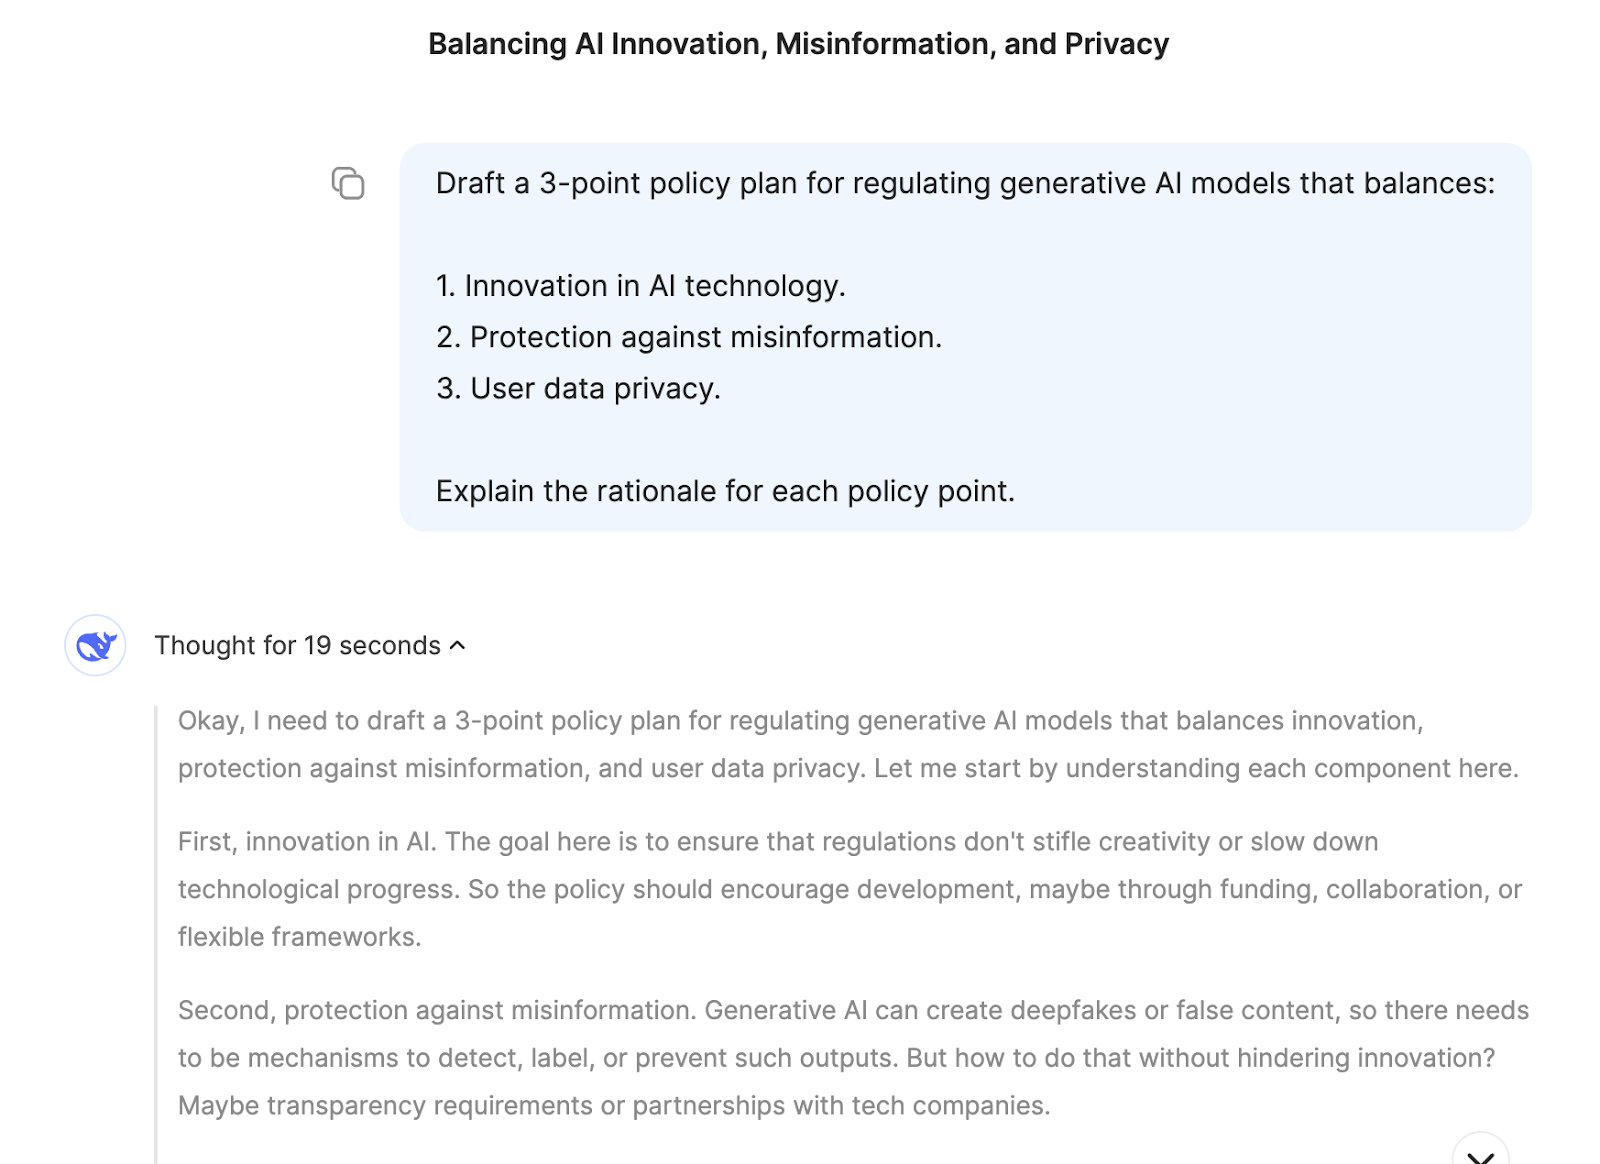
Met DeepSeek-R1 kun je de logica volgen, waardoor je de output makkelijker begrijpt en, indien nodig, kunt bekritiseren. Deze mogelijkheid geeft redeneermodellen een voorsprong in domeinen waar resultaten uitlegbaar moeten zijn, zoals onderzoek of complexe besluitvorming.
Wat DeepSeek-R1 bijzonder competitief en aantrekkelijk maakt, is het open-sourcekarakter. Anders dan bij propriëtaire modellen kunnen ontwikkelaars en onderzoekers dankzij open source binnen bepaalde technische grenzen, zoals resourcevereisten, het model verkennen, aanpassen en implementeren.
In dit onderdeel laat ik zien hoe DeepSeek-R1 is ontwikkeld, beginnend bij de voorganger, DeepSeek-R1-Zero.
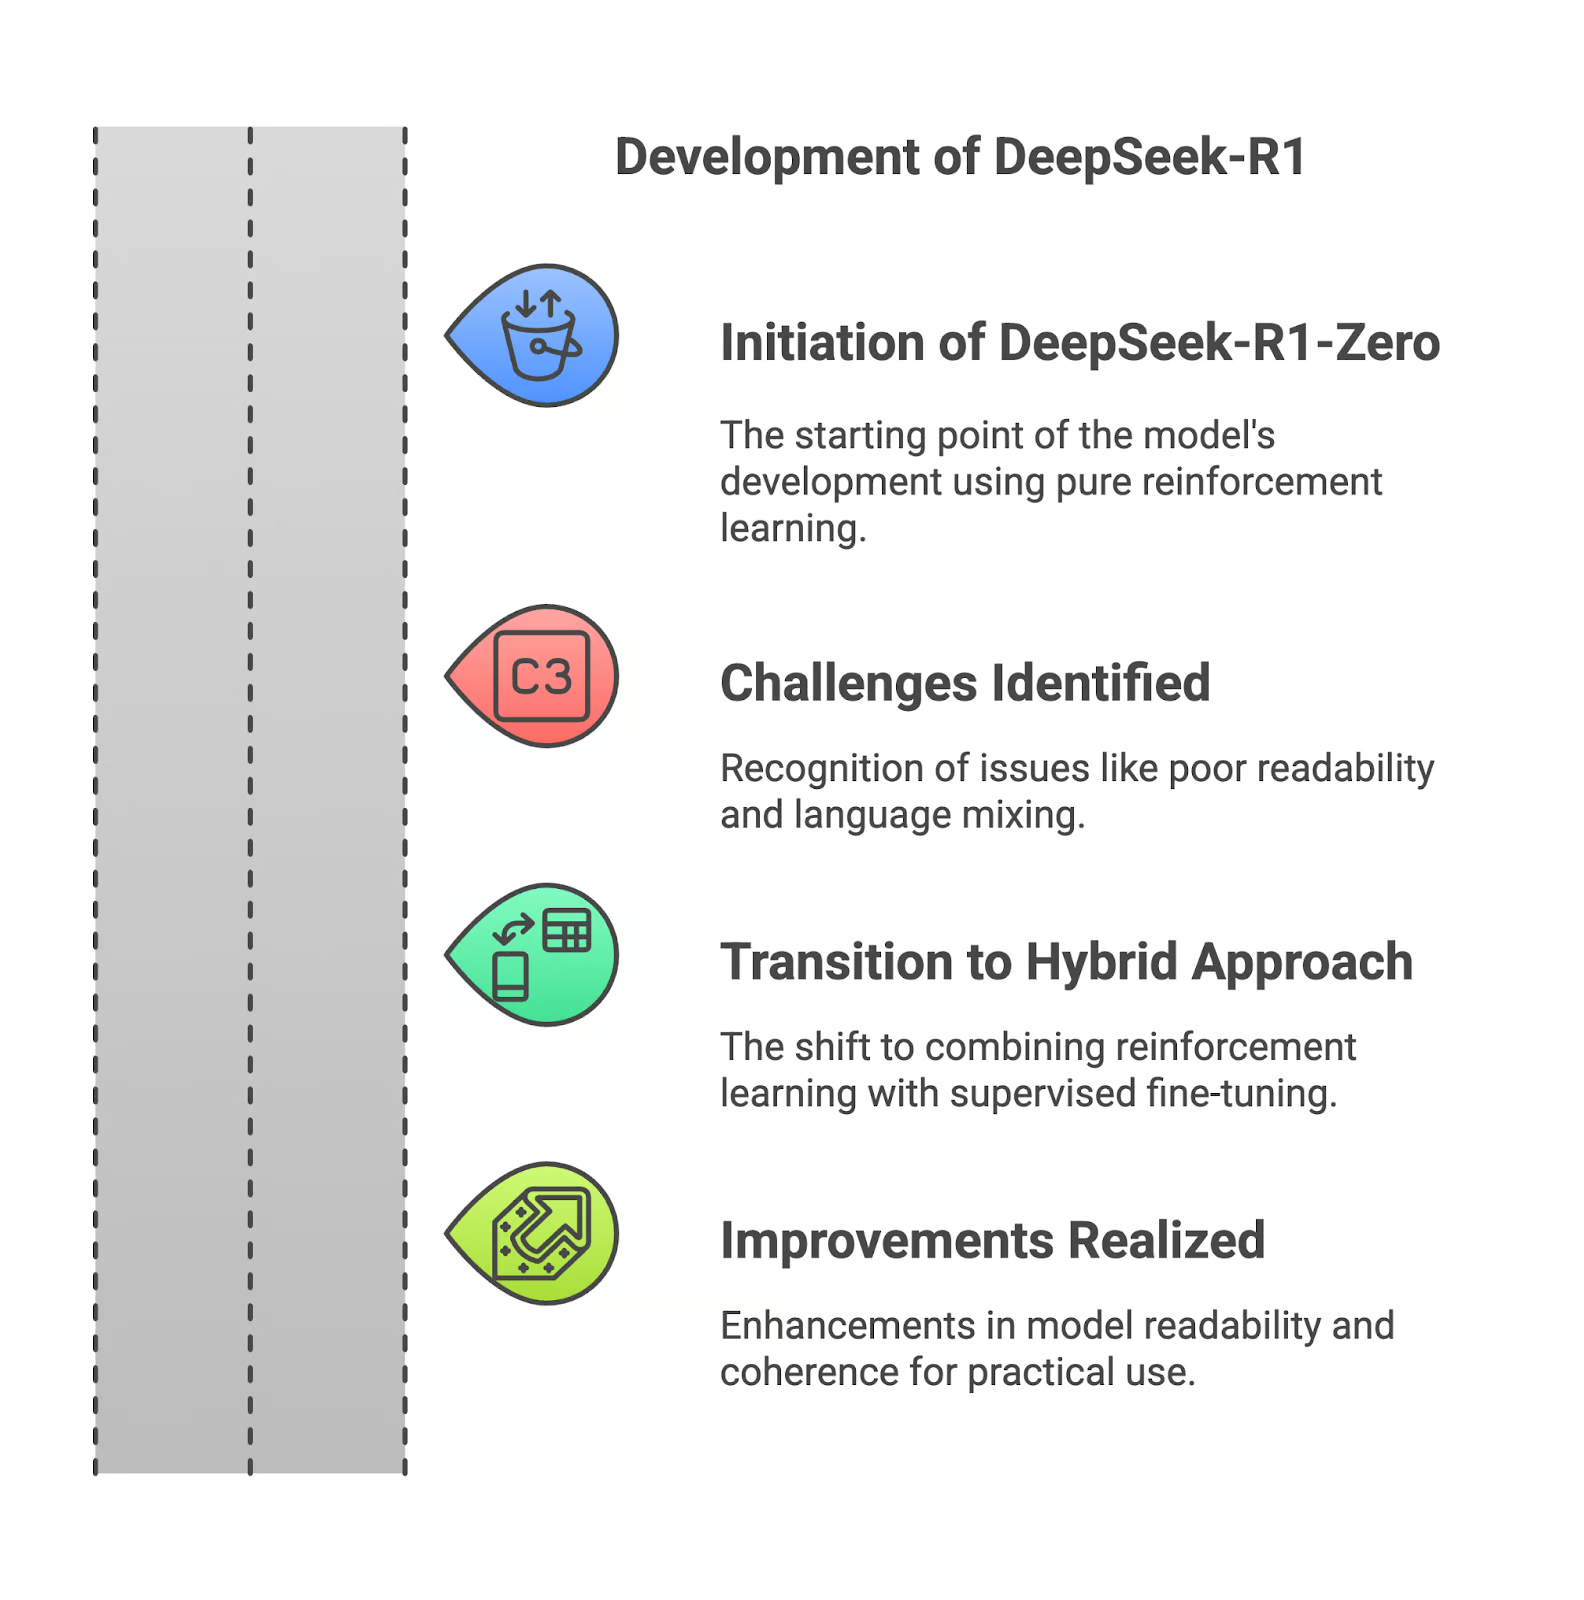
DeepSeek-R1 begon met R1-Zero, een model dat volledig is getraind via reinforcement learning. Hoewel deze aanpak zorgde voor sterke redeneercapaciteiten, had ze grote nadelen. De outputs waren vaak lastig te lezen en het model mengde soms talen binnen zijn antwoorden. Deze beperkingen maakten R1-Zero minder geschikt voor toepassingen in de praktijk.
De afhankelijkheid van puur reinforcement learning leverde outputs op die logisch klopten, maar slecht gestructureerd waren. Zonder de sturing van gesuperviseerde data had het model moeite om zijn redenering effectief te communiceren. Dit was een drempel voor gebruikers die helderheid en precisie nodig hadden in de resultaten.
Om deze problemen aan te pakken, wijzigde DeepSeek de ontwikkeling van R1 door reinforcement learning te combineren met supervised fine-tuning. Deze hybride aanpak gebruikte gecureerde datasets en verbeterde de leesbaarheid en samenhang van het model. Problemen zoals taalvermenging en gefragmenteerde redenering werden aanzienlijk verminderd, waardoor het model geschikter werd voor praktisch gebruik.
Als je meer wilt leren over de ontwikkeling van DeepSeek-R1, raad ik aan de releasepaper te lezen.
Distillatie in AI is het proces waarbij kleinere, efficiëntere modellen worden gemaakt uit grotere modellen, waarbij veel van hun redeneervermogen behouden blijft terwijl de rekeneisen dalen. DeepSeek paste deze techniek toe om een reeks gedistilleerde modellen van R1 te maken, op basis van Qwen- en Llama-architecturen.
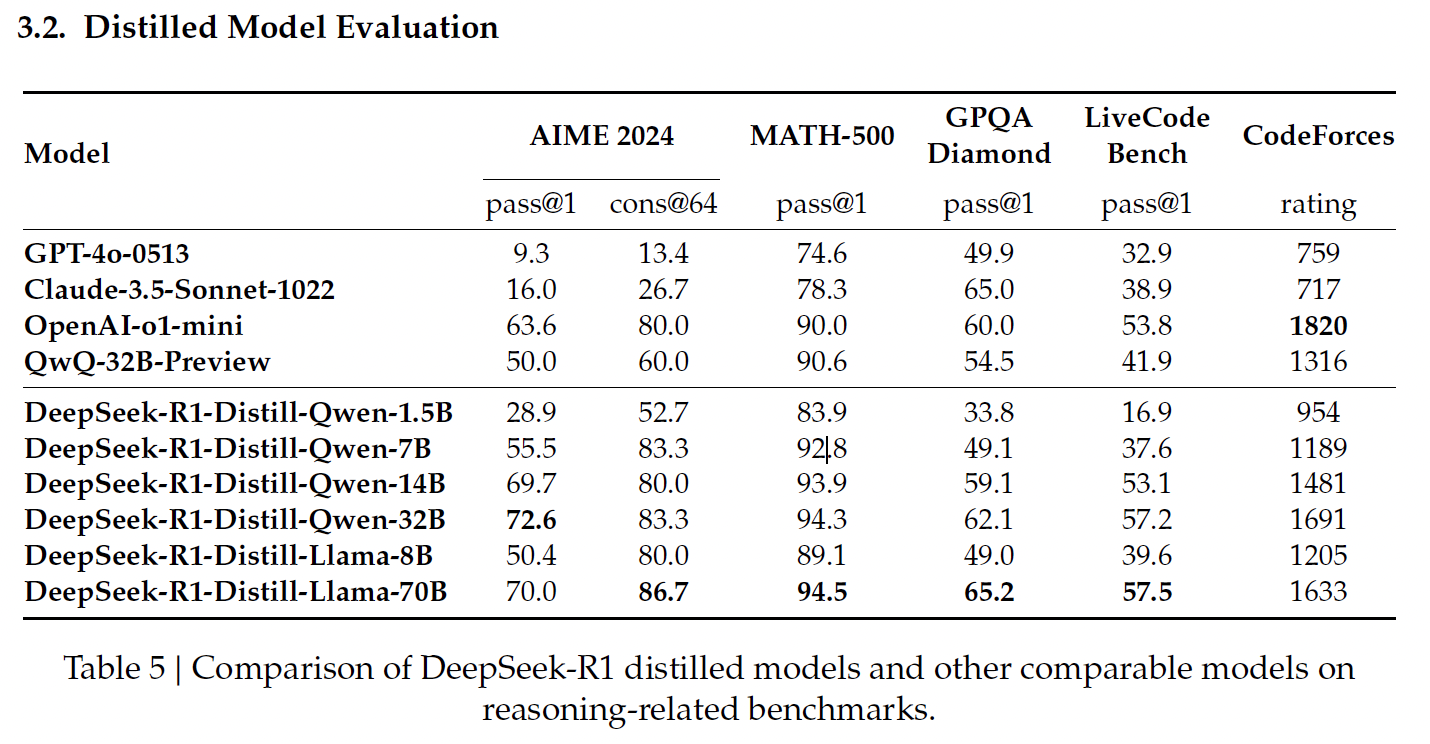
Bron: DeepSeek’s releasepaper
De Qwen-gebaseerde gedistilleerde modellen van DeepSeek richten zich op efficiëntie en schaalbaarheid en bieden een balans tussen prestaties en rekenvereisten.
Dit is het kleinste gedistilleerde model en behaalt 83,9% op MATH-500. MATH-500 test het vermogen om wiskundige problemen op middelbareschoolniveau op te lossen met logische redenering en meerstapsoplossingen. Dit resultaat laat zien dat het model basiswiskundige taken goed aankan ondanks zijn compacte omvang.
De prestaties dalen echter aanzienlijk op LiveCodeBench (16,9%), een benchmark die is ontworpen om codeerkwaliteiten te beoordelen, wat de beperkte geschiktheid voor programmeertaken benadrukt.
Qwen-7B blinkt uit op MATH-500 met 92,8%, wat wijst op sterke wiskundige redeneercapaciteiten. Het presteert ook redelijk op GPQA Diamond (49,1%), dat feitelijke vraagbeantwoording evalueert, wat duidt op een goede balans tussen wiskundige en feitelijke redenering.
De scores op LiveCodeBench (37,6%) en CodeForces (rating 1189) suggereren echter dat het minder geschikt is voor complexe programmeertaken.
Dit model presteert goed op MATH-500 (93,9%), wat aangeeft dat het complexe wiskundige problemen aankan. De score van 59,1% op GPQA Diamond duidt ook op competentie in feitelijke redenering.
De prestaties op LiveCodeBench (53,1%) en CodeForces (rating 1481) laten zien dat er nog groeiruimte is bij codeer- en programmeerspecifieke redeneringstaken.
Het grootste Qwen-gebaseerde model behaalt de hoogste score binnen zijn reeks op AIME 2024 (72,6%), dat geavanceerde meerstaps wiskundige redenering evalueert. Het blinkt ook uit op MATH-500 (94,3%) en GPQA Diamond (62,1%), wat de kracht toont in zowel wiskundige als feitelijke redenering.
De resultaten op LiveCodeBench (57,2%) en CodeForces (rating 1691) suggereren dat het veelzijdig is, maar nog niet geoptimaliseerd voor programmeertaken vergeleken met modellen die in coderen gespecialiseerd zijn.
De Llama-gebaseerde gedistilleerde modellen van DeepSeek geven prioriteit aan hoge prestaties en geavanceerde redeneercapaciteiten, vooral bij taken die wiskundige en feitelijke precisie vereisen.
Llama-8B presteert goed op MATH-500 (89,1%) en redelijk op GPQA Diamond (49,0%), wat aangeeft dat het wiskundige en feitelijke redenering aankan. Het scoort echter lager op codeerbenchmarks zoals LiveCodeBench (39,6%) en CodeForces (rating 1205), wat de beperkingen bij programmeertaken benadrukt in vergelijking met Qwen-gebaseerde modellen.
Het grootste gedistilleerde model, Llama-70B, levert topprestaties op MATH-500 (94,5%), de beste onder alle gedistilleerde modellen, en behaalt een sterke score van 86,7% op AIME 2024, waardoor het een uitstekende keuze is voor geavanceerde wiskundige redenering.
Het presteert ook goed op LiveCodeBench (57,5%) en CodeForces (rating 1633), wat suggereert dat het competenter is in programmeertaken dan de meeste andere modellen. Op dit gebied is het vergelijkbaar met OpenAI’s o1-mini of GPT-4o.
Je kunt DeepSeek-R1 op twee manieren gebruiken: via het webplatform DeepSeek Chat en via de DeepSeek API, zodat je de optie kunt kiezen die het beste bij je past.
Het DeepSeek Chat-platform biedt een eenvoudige manier om met DeepSeek-R1 te werken. Je kunt er direct heen via de chatpagina of klikken op Start Now op de homepage.
Na registratie kun je de modus “Deep Think” selecteren om de stapsgewijze redeneercapaciteiten van Deepseek-R1 te ervaren.
Voor integratie van DeepSeek-R1 in je toepassingen biedt de DeepSeek API programmatische toegang.
Om te beginnen heb je een API-sleutel nodig door je te registreren op het DeepSeek Platform.
De API is compatibel met het formaat van OpenAI, waardoor de integratie eenvoudig is als je bekend bent met de tools van OpenAI. Meer instructies vind je in DeepSeek’s API-documentatie.
Sinds mei 2025 is het chatplatform gratis te gebruiken met het R1-model.
De API biedt twee modellen—deepseek-chat (DeepSeek-V3) en deepseek-reasoner (DeepSeek-R1)—met de volgende prijsstructuur (per 1M tokens):
|
MODEL |
CONTEXTLENGTE |
MAX COT-TOKENS |
MAX OUTPUT-TOKENS |
1M TOKENS INPUTPRIJS (CACHE HIT) |
1M TOKENS INPUTPRIJS (CACHE MISS) |
1M TOKENS OUTPUTPRIJS |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
Bron: DeepSeek’s prijspagina
Bezoek DeepSeek’s prijspagina voor de meest actuele prijsinformatie en om te begrijpen hoe je de kosten van CoT (Chain-of-Thought) redenering berekent.
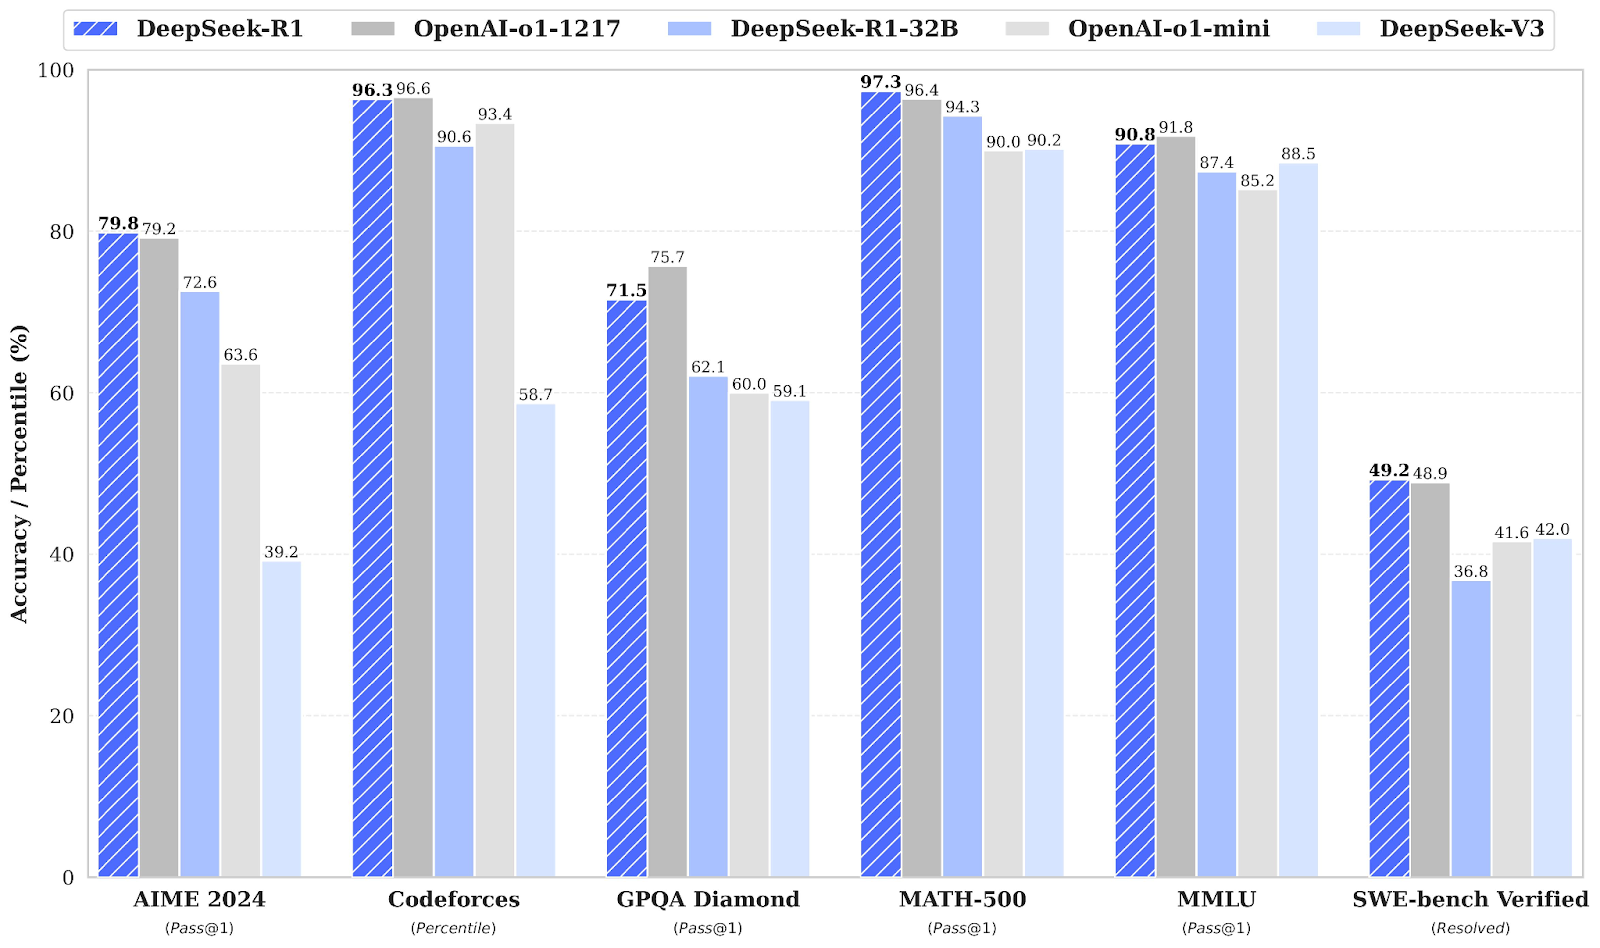
DeepSeek-R1 concurreert rechtstreeks met OpenAI o1 op verschillende benchmarks en evenaart of overtreft vaak OpenAI’s o1.
Bron: DeepSeek’s releasepaper
Op wiskundebenchmarks laat DeepSeek-R1 sterke prestaties zien. Op AIME 2024, dat geavanceerde meerstaps wiskundige redenering evalueert, scoort DeepSeek-R1 79,8%, net voor OpenAI o1-1217 met 79,2%.
Op MATH-500 pakt DeepSeek-R1 de leiding met een indrukwekkende 97,3%, iets hoger dan OpenAI o1-1217 met 96,4%. Deze benchmark test modellen op diverse wiskundige problemen op middelbareschoolniveau die gedetailleerde redenering vereisen.
De Codeforces-benchmark evalueert de codeer- en algoritmische redeneringscapaciteiten van een model, weergegeven als percentielrangorde ten opzichte van menselijke deelnemers. OpenAI o1-1217 leidt met 96,6%, terwijl DeepSeek-R1 een zeer competitieve 96,3% behaalt, met slechts een klein verschil.
De SWE-bench Verified-benchmark beoordeelt redenering bij software-engineeringtaken. DeepSeek-R1 presteert sterk met 49,2%, net voor OpenAI o1-1217 met 48,9%. Dit positioneert DeepSeek-R1 als een sterke uitdager bij gespecialiseerde redeneerstaken zoals softwareverificatie.
Voor feitelijke redenering meet GPQA Diamond het vermogen om algemene kennisvragen te beantwoorden. DeepSeek-R1 scoort 71,5% en blijft daarmee achter bij OpenAI o1-1217, dat 75,7% behaalt. Dit benadrukt het lichte voordeel van OpenAI o1-1217 bij feitelijke redeneringstaken.
Op MMLU, een benchmark die meerdere disciplines omvat en multitask-taalbegrip evalueert, ligt OpenAI o1-1217 nipt voor op DeepSeek-R1, met 91,8% tegenover 90,8% voor DeepSeek-R1.
De release van DeepSeek-R1 had verstrekkende gevolgen: invloed op aandelenmarkten, hertekening van de AI-economie en controverse rond modelontwikkelingspraktijken.
DeepSeek’s introductie van het R1-model, dat geavanceerde AI-mogelijkheden biedt voor een fractie van de kosten van concurrenten, leidde tot een forse daling van de aandelenkoersen van grote Amerikaanse techbedrijven.
Nvidia bijvoorbeeld zag de aandelenkoers met bijna 18% dalen, goed voor een verlies van ongeveer $600 miljard aan marktkapitalisatie. Deze daling werd gevoed door zorgen van investeerders dat de efficiënte AI-modellen van DeepSeek de vraag naar high-performance hardware zou kunnen verminderen, die traditioneel door bedrijven als Nvidia wordt geleverd.
Open-weight modellen zoals DeepSeek-R1 verlagen de kosten en dwingen AI-bedrijven hun prijsstrategieën te herzien. Dat blijkt uit het scherpe prijscontrast:
Sommige kopstukken verwijzen naar de paradox van Jevons—het idee dat naarmate de efficiëntie toeneemt, het totale verbruik kan stijgen in plaats van dalen. Microsoft-CEO Satya Nadella hintte hierop en stelt dat naarmate AI goedkoper wordt, de vraag zal exploderen.
Ik vond echter deze evenwichtige blik van The Economist prettig, waarin wordt betoogd dat een volledig Jevons-effect zeldzaam is en afhangt van de vraag of prijs de belangrijkste belemmering voor adoptie is. Met slechts “5% van de Amerikaanse bedrijven die momenteel AI gebruiken en 7% die van plan is het te adopteren” zal het Jevons-effect waarschijnlijk laag zijn. Veel bedrijven vinden AI-integratie nog steeds lastig of niet nodig.
Naast de ontwrichtende impact kwam DeepSeek ook in het middelpunt van controverse te staan. OpenAI beschuldigde DeepSeek ervan hun modellen te distilleren—kort gezegd kennis onttrekken aan OpenAI’s propriëtaire systemen en die prestaties repliceren in een compacter, efficiënter model.
Tot nu toe heeft OpenAI geen direct bewijs voor deze claim geleverd, en voor velen oogt de beschuldiging meer als een strategische zet om investeerders gerust te stellen in het veranderende AI-landschap.
Op 28 mei 2025 bracht DeepSeek een geüpgradede versie van zijn redeneermodel uit: DeepSeek-R1-0528. Deze update introduceert verschillende belangrijke verbeteringen:
Ondanks deze toevoegingen veranderen de API-eindpunten niet—DeepSeek-R1-0528 is volledig achterwaarts compatibel. Ontwikkelaars kunnen dezelfde interface blijven gebruiken, met de extra voordelen van het nieuwe model.
Je kunt het uitproberen op het DeepSeek Chat-platform of de open-sourcegewichten op Hugging Face bekijken.
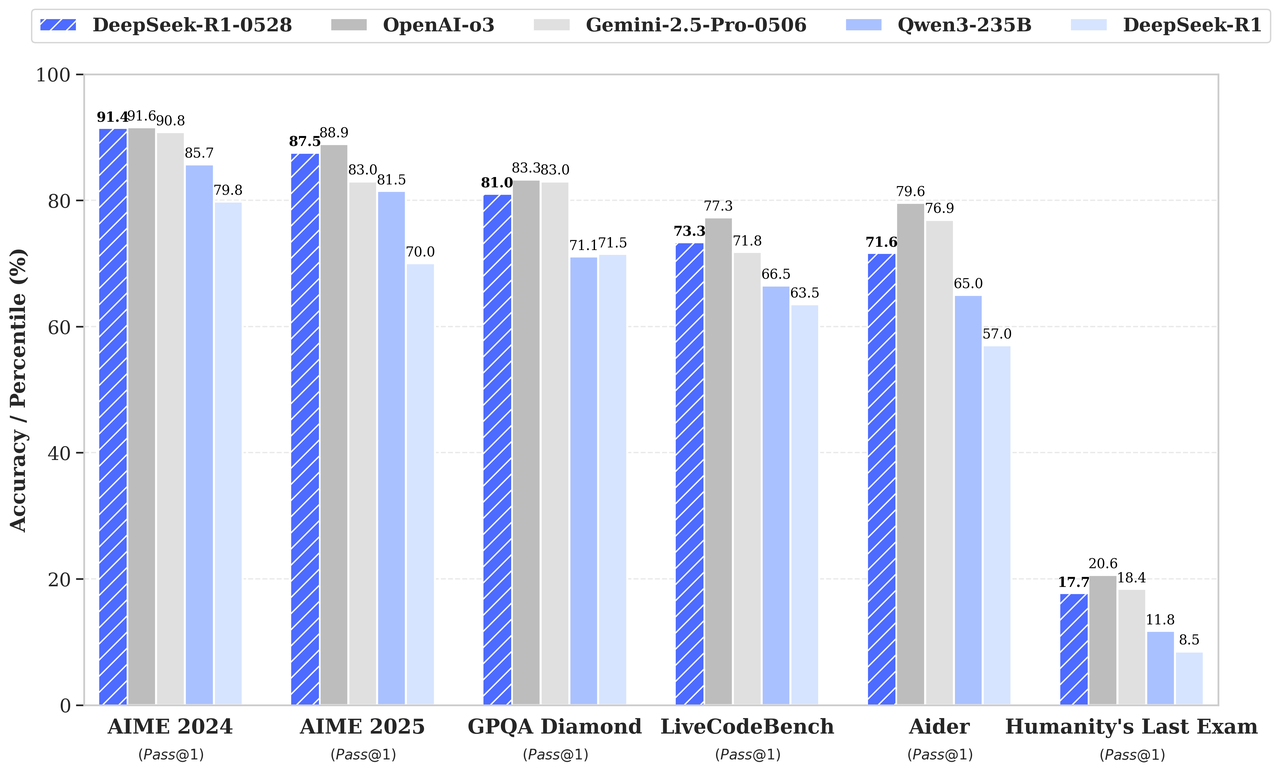
Volgens de benchmarkgrafiek in de releaseaankondiging presteert DeepSeek-R1-0528 beter dan zijn voorganger en concurreert het sterk met OpenAI’s o3 en Gemini 2.5 Pro:
Bron: DeepSeek
DeepSeek-R1 is een sterke concurrent in AI die draait om redeneren, met prestaties die vergelijkbaar zijn met OpenAI’s o1. Hoewel OpenAI’s o1 mogelijk een kleine voorsprong heeft in coderen en feitelijke redenering, maken het open-sourcekarakter en de kostenefficiënte toegang van DeepSeek-R1 het in mijn ogen tot een aantrekkelijke optie.
Leer AI met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

