



Leerpad
ChatGPT-basisprincipes
3 uur
Oefen en volg je voortgang.
Ga Verder Met Googleo3 is OpenAI’s nieuwste frontiermodel, ontworpen om redeneercapaciteiten te verbeteren voor complexe taken zoals programmeren, wiskunde, wetenschap en visuele perceptie.
Het o3-redeneermodel is het eerste redeneermodel met toegang tot autonome toolgebruik. Dit betekent dat o3 zoekopdrachten, Python, afbeeldingsgeneratie en -interpretatie kan gebruiken om zijn taken te voltooien.
Dit vertaalt zich in sterke prestaties op geavanceerde benchmarks die probleemoplossing in de echte wereld testen, waar eerdere modellen moeite mee hadden. OpenAI benadrukt o3’s verbetering ten opzichte van o1 en positioneert het als hun meest capabele en veelzijdige model tot nu toe.
o3 bouwt direct voort op de basis die door o1 is gelegd, maar de verbeteringen zijn aanzienlijk op cruciale vlakken. OpenAI heeft o3 gepositioneerd als een model dat is ontworpen om complexere redeneertaken aan te kunnen, wat ook terug te zien is in de benchmarks.
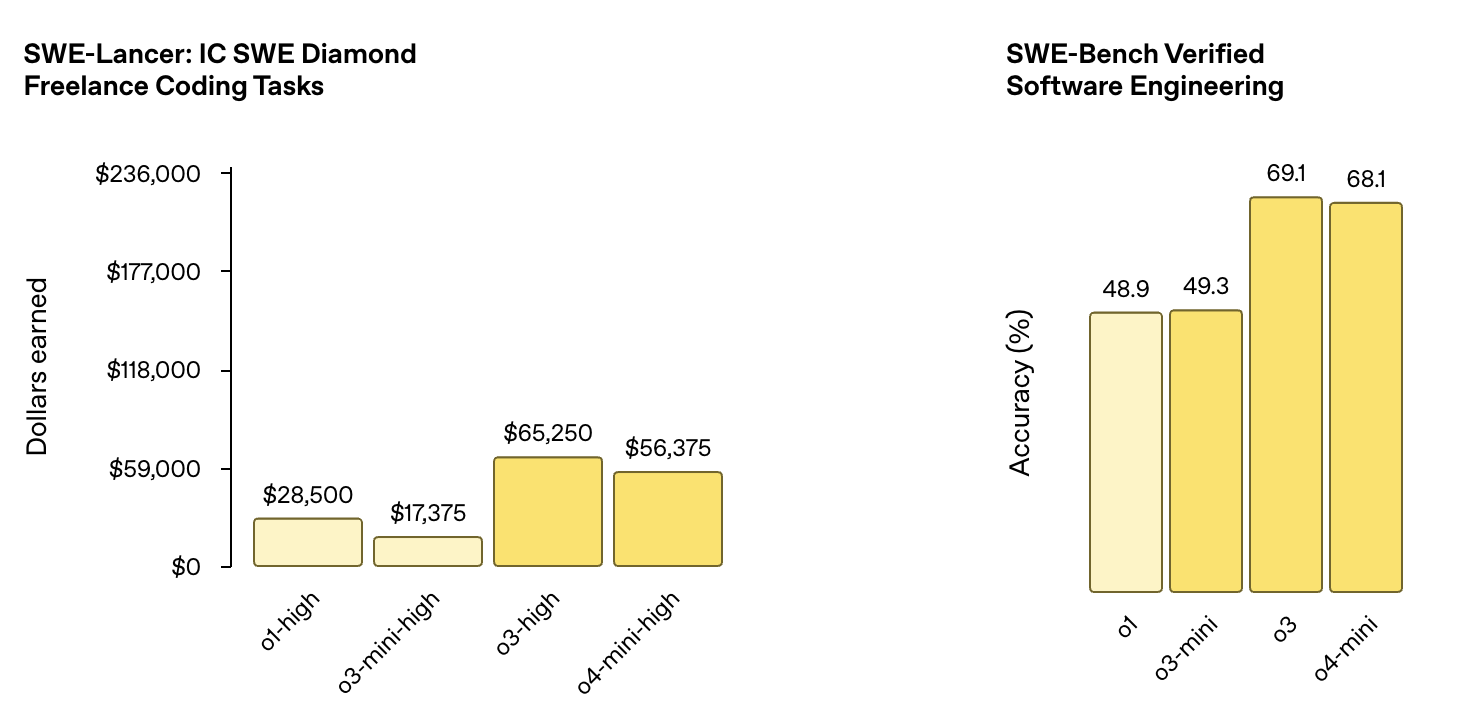
Bij tests op software-engineeringtaken behaalde o3 69,1% nauwkeurigheid op de SWE-Bench Verified Software Engineering-benchmark, een substantiële verbetering ten opzichte van o1’s score van 48,9%.
Bron: OpenAI
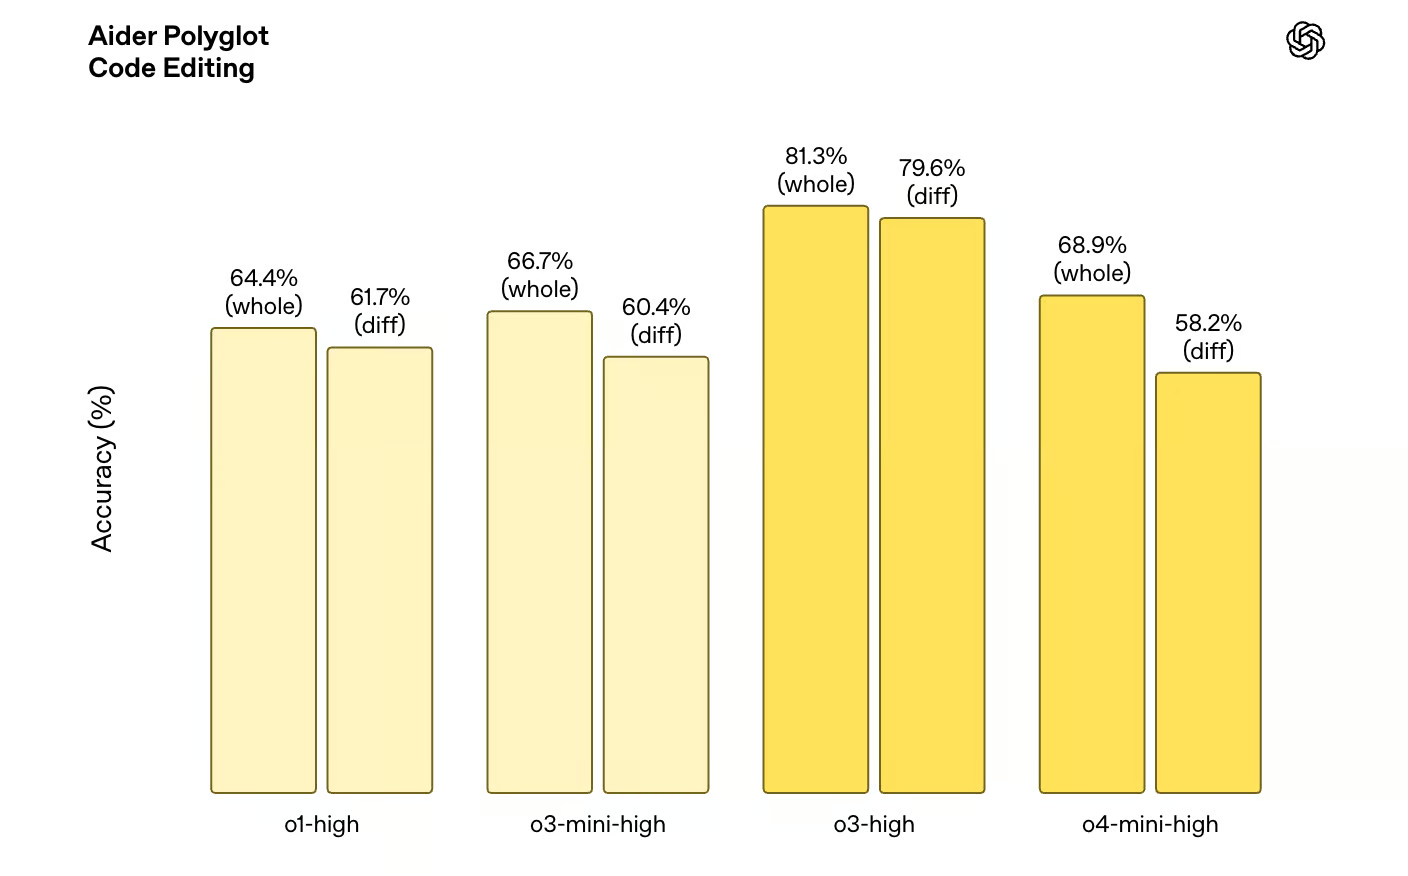
Ook op competitief programmeren scoorde o3 hoog, met een ELO-score van 2706, ver boven o1’s eerdere hoogste score van 1891. Bovendien presteert o3 significant beter op codebewerkingsbenchmarks: o3-varianten overtreffen o1 overal op de Aider Polyglot Code Editing-benchmark.
Bron: OpenAI
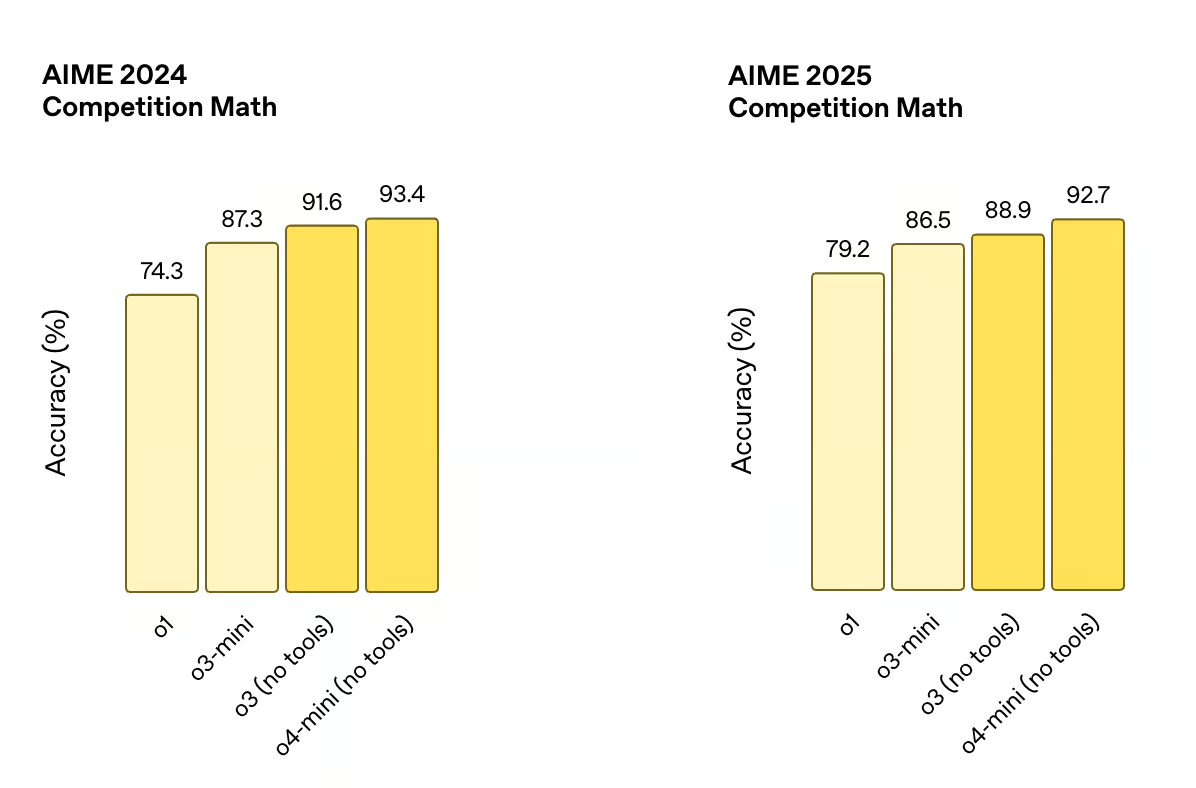
De verbeteringen beperken zich niet tot programmeren. o3 blinkt ook uit in wiskundig redeneren, met 91,6% nauwkeurigheid op de AIME 2024, vergeleken met 74,3% voor o1. Het scoorde ook 88,9% op de AIME 2025. Deze vooruitgang wijst op een model dat meer genuanceerde en moeilijke problemen aankan, en dichter in de buurt komt van benchmarks die traditioneel door menselijke experts worden gedomineerd.
Bron: OpenAI
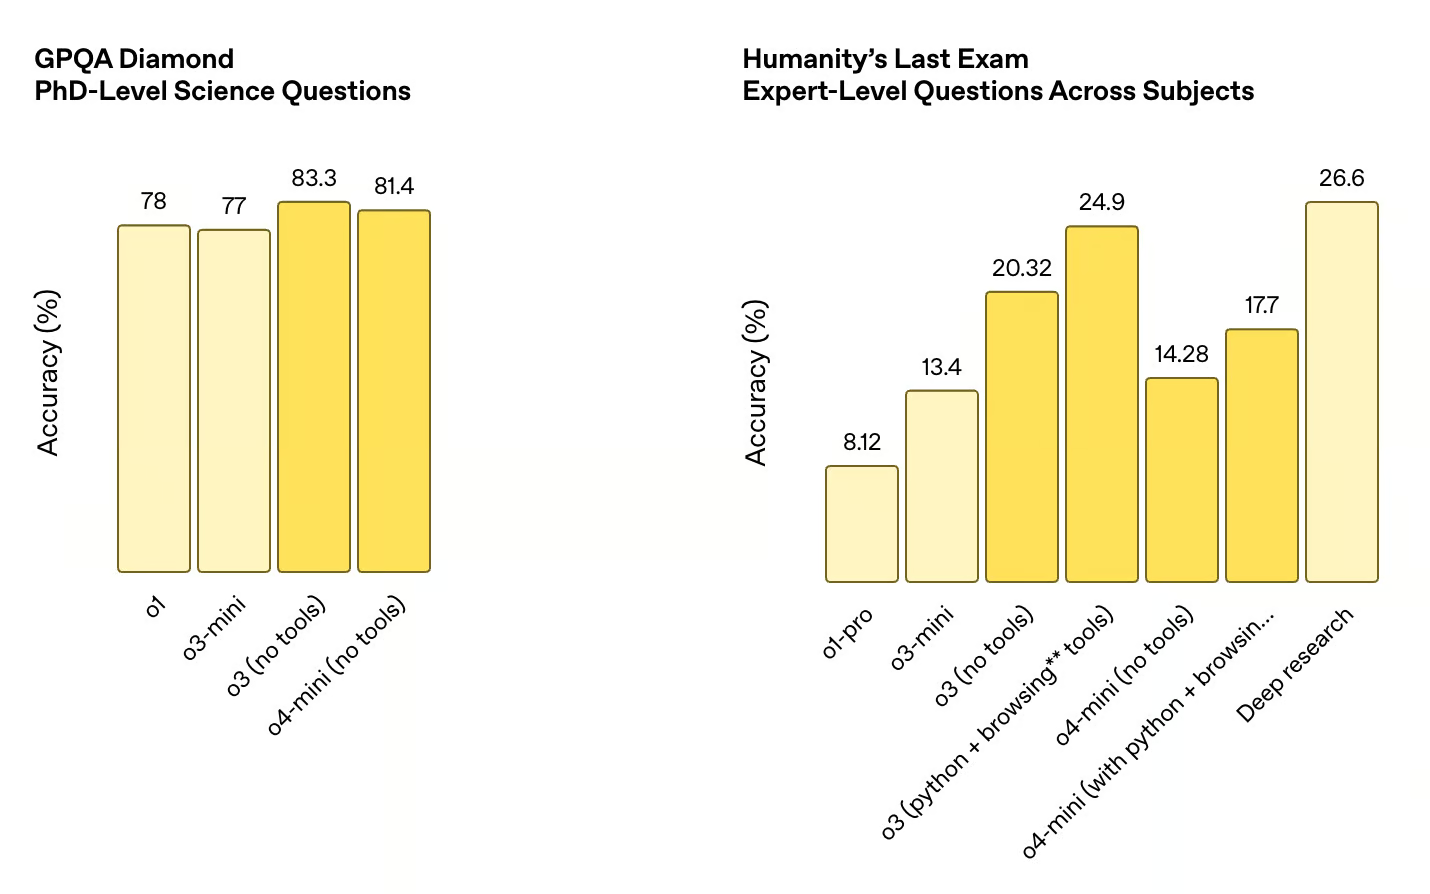
De sprong is vergelijkbaar zichtbaar in wetenschapsgerelateerde benchmarks. Op GPQA Diamond, dat prestaties meet op wetenschappelijke vragen op PhD-niveau, behaalde o3 een nauwkeurigheid van 83,3%, tegenover 78% voor o1. Deze winst laat een brede verbetering zien in het vermogen van het model om technisch veeleisende problemen over disciplines heen op te lossen.
Bron: OpenAI
Een van de opvallendste aspecten van het nieuwe o3-model is het vermogen om direct met afbeeldingen te redeneren in zijn chain of thought. Dit betekent dat o3 visueel en tekstueel redeneren kan combineren tijdens het oplossen van problemen, wat ook terug te zien is in de prestaties op meerdere visuele redeneerbenchmarks.
Bron: OpenAI
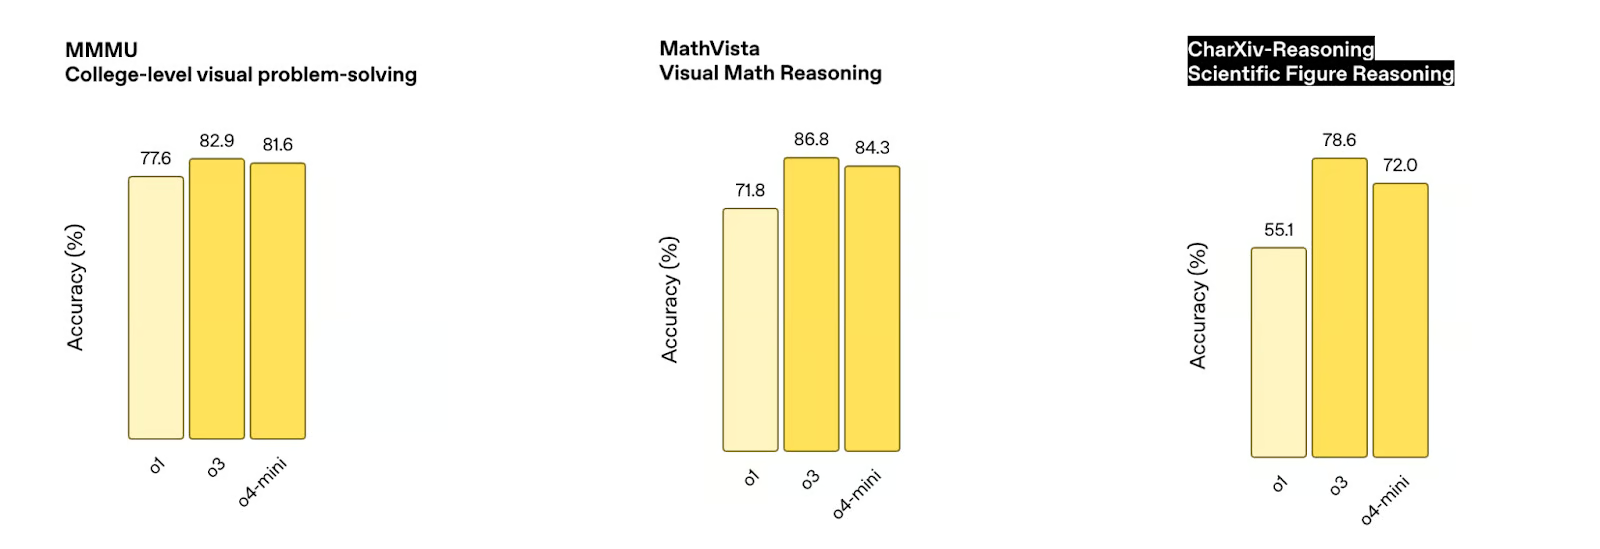
Zo presteert o3 beter dan o1 op diverse visuele redeneerbenchmarks, waaronder de MMMU College-level visuele probleemoplossingsbenchmark (82,9% vs 77,6% voor o1), de MathVista Visual Math Reasoning-benchmark (86,8% vs 71,8% voor o1) en de CharXiv-Reasoning Scientific Figure Reasoning-benchmark (78,6% vs 55,1% voor o1).
Bron: OpenAI
Een gebied waar o3’s vooruitgang bijzonder opmerkelijk is, is de EpochAI Frontier Math-benchmark.
Dit wordt beschouwd als een van de meest uitdagende benchmarks in AI omdat het bestaat uit nieuwe, ongepubliceerde problemen die opzettelijk veel moeilijker zijn dan standaarddatasets. Veel van deze problemen bevinden zich op het niveau van wiskundig onderzoek en vereisen vaak uren of zelfs dagen werk van professionele wiskundigen om één probleem op te lossen. Huidige AI-systemen scoren doorgaans onder de 2% op deze benchmark, wat de moeilijkheidsgraad onderstreept.
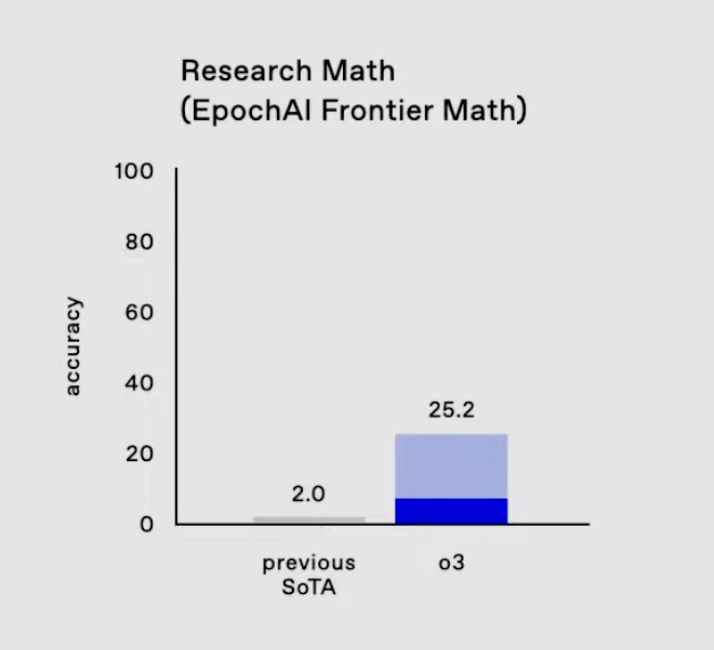
O3 op EpochAI Frontier Math. Bron: OpenAI
De Frontier Math van Epic AI is belangrijk omdat deze modellen verder duwt dan uit-het-hoofd leren of het optimaliseren van bekende patronen. In plaats daarvan test hij het vermogen om te generaliseren, abstract te redeneren en problemen aan te pakken die ze niet eerder zijn tegengekomen—eigenschappen die essentieel zijn voor het vooruitbrengen van AI-redeneervermogen. o3’s score van 25,2% op deze benchmark is een sprong vooruit ten opzichte van de eerdere state-of-the-art-prestaties.
Een van de meest opvallende prestaties van o3 is de score op de ARC AGI-benchmark, een test die algemeen wordt beschouwd als de gouden standaard voor het evalueren van algemene intelligentie in AI.
ARC (Abstraction and Reasoning Corpus), ontwikkeld in 2019 door François Chollet, richt zich op het beoordelen van het vermogen van AI om nieuwe vaardigheden te leren en te generaliseren op basis van minimale voorbeelden. In tegenstelling tot traditionele benchmarks die vaak getrainde kennis of patroonherkenning testen, zijn ARC-taken ontworpen om modellen uit te dagen om regels en transformaties ter plekke af te leiden—taken die mensen intuïtief kunnen oplossen, maar waar AI historisch gezien moeite mee heeft gehad.
Wat ARC AGI bijzonder moeilijk maakt, is dat elke taak een andere redeneervaardigheid vereist. Modellen kunnen niet vertrouwen op gememoriseerde oplossingen of sjablonen; ze moeten zich in elke test aanpassen aan volledig nieuwe uitdagingen. De ene taak kan bijvoorbeeld gaan over het herkennen van patronen in geometrische transformaties, terwijl een andere vereist dat je redeneert over numerieke reeksen. Deze diversiteit maakt ARC AGI een krachtig meetinstrument voor hoe goed een AI echt kan denken en leren zoals een mens.
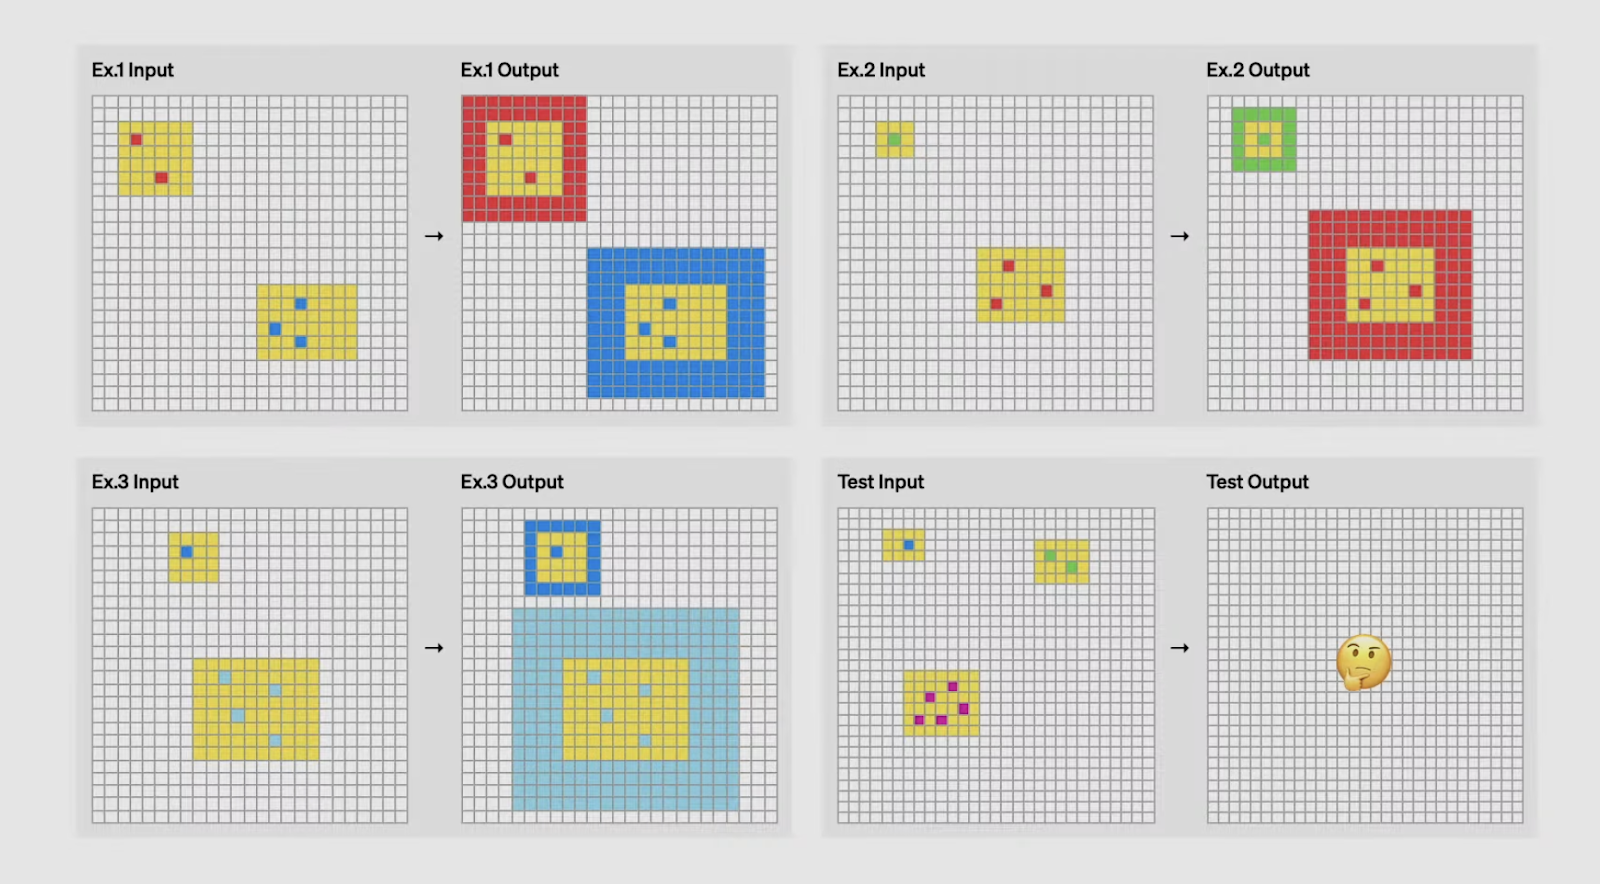
Kun jij de logica raden waarmee de input wordt omgezet in output? Bron: OpenAI
o3’s prestaties op ARC AGI markeren een belangrijke mijlpaal. In low-compute-instellingen scoorde o3 76% op de semi-private holdoutset—een cijfer dat ver boven elk eerder model ligt.
Met high-compute-instellingen was de score zelfs nog indrukwekkender: 88%, waarmee de drempel van 85% wordt overschreden die vaak als menselijk prestatieniveau wordt aangehaald. Dit is de eerste keer dat een AI beter presteert dan mensen op deze benchmark, waarmee een nieuwe standaard wordt gezet voor redeneergerichte taken.
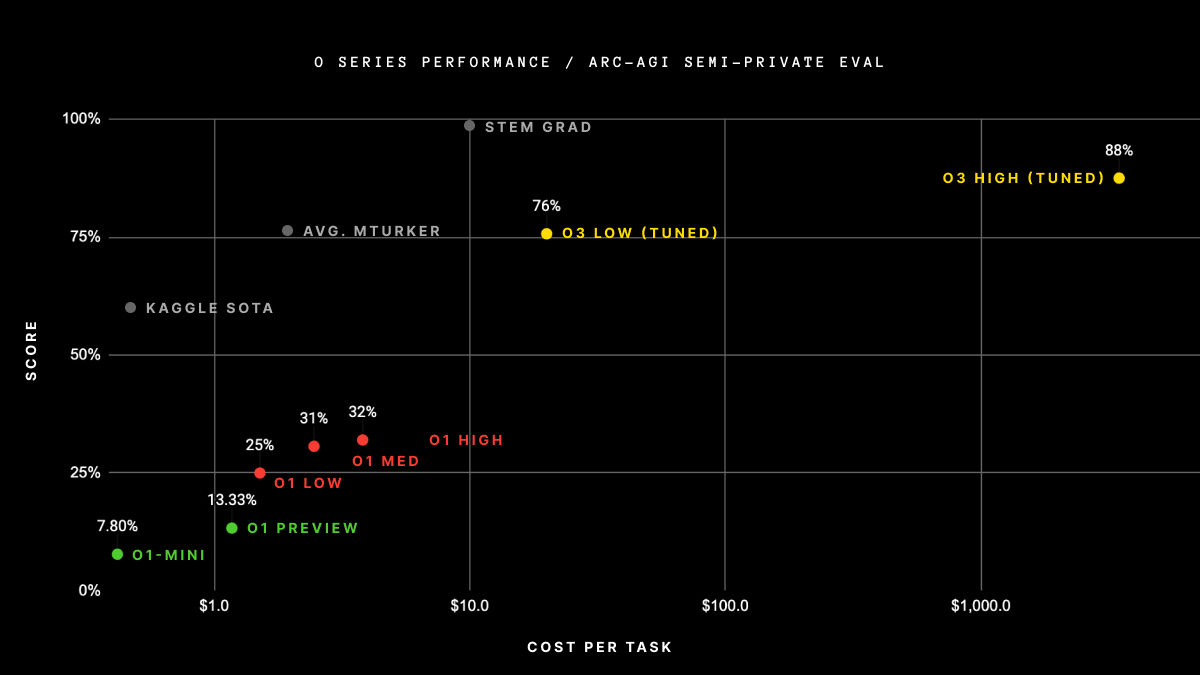
Bron: ArcPrize
Wij vinden deze resultaten bijzonder noemenswaardig omdat ze laten zien dat o3 taken aankan die aanpassingsvermogen en generalisatie vereisen in plaats van uit-het-hoofdkennis of brute rekenkracht. Het is een duidelijke indicatie dat o3 dichter bij echte algemene intelligentie komt, voorbij domeinspecifieke capaciteiten en richting gebieden die eerder als exclusief menselijk werden beschouwd.
Dat gezegd hebbende, bovenstaande resultaten zijn gebaseerd op de versie van o3 die werd gedeeld tijdens OpenAI’s 12 Days of Christmas-evenement in december, en OpenAI heeft bevestigd dat de nieuw uitgebrachte versie van o3 verschilt van de versie die in de bovenstaande tests is getoond. ARC AGI zal binnenkort de bijgewerkte prestatieresultaten van o3 publiceren.
Verbeteringen van deze omvang komen niet zomaar uit de lucht vallen. Het team van OpenAI heeft enkele doorbraken gerealiseerd om dit soort cijfers te halen:
OpenAI ontdekte dat het verhogen van het compute-budget tijdens reinforcement learning-training de modelprestaties verbetert—een weerspiegeling van het schaalgedrag dat we zagen bij gesuperviseerde pretraining in GPT-modellen. Maar deze keer leert o3, in plaats van te optimaliseren voor volgende-woordvoorspelling, door beloningen in reinforcement learning te maximaliseren, vaak in omgevingen met toolondersteuning.
Met andere woorden, OpenAI behandelt reinforcement learning meer als pretraining—opschalen in zowel duur als compute—en dat lijkt te werken. Dit ontgrendelt vermogens die baat hebben bij langetermijnplanning en sequentieel redeneren, zoals competitief programmeren en wiskundebewijzen in meerdere stappen. In combinatie met toolgebruik worden de prestatiewinsten nog duidelijker.
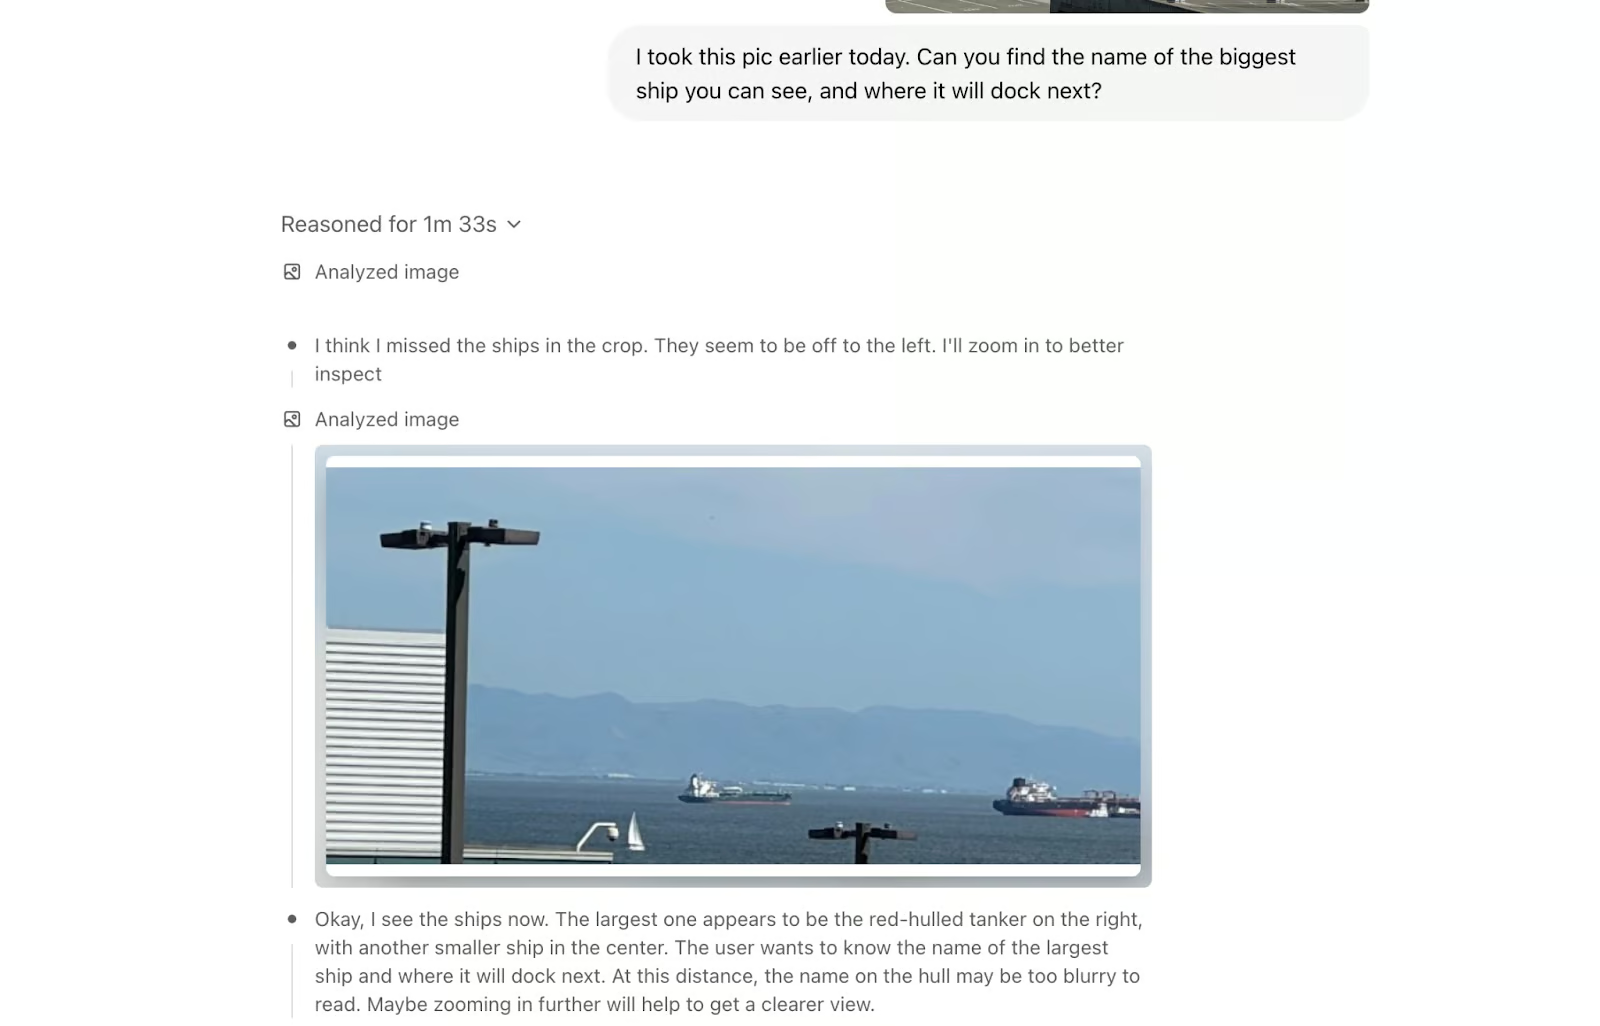
o3 laat ook significante verbeteringen zien in visueel redeneren. Het begrijpt afbeeldingen niet alleen—het integreert ze direct in zijn redeneerloop. Dat omvat interpreteren, manipuleren en opnieuw inspecteren van afbeeldingen tijdens het oplossen van problemen. Dit is een van de redenen waarom o3 goed presteert op taken met wetenschappelijke figuren, wiskundediagrammen en zelfs plannen op basis van foto’s.
Een belangrijke innovatie is hoe o3 de ruwe afbeelding in het geheugen behoudt gedurende het volledige redeneerproces. In plaats van een statisch bijschrift te verwerken en de afbeelding te negeren, kan het inzoomen, roteren of op verzoek verschillende delen van de afbeelding opnieuw bekijken met behulp van tools. Dit maakt het redeneren dynamischer en stelt het in staat rommeliger visuele input aan te pakken, zoals een wazig whiteboard, een handgetekend diagram of een foto van een conferentieschema.
In één voorbeeld gebruikte OpenAI o3 om een afbeelding van lage kwaliteit van een showschema te lezen en een planning te maken waarin elk evenement paste met tien minuten pauze ertussen—iets wat zowel het parsen van de visuele lay-out als het toepassen van realtime beperkingen vereist.
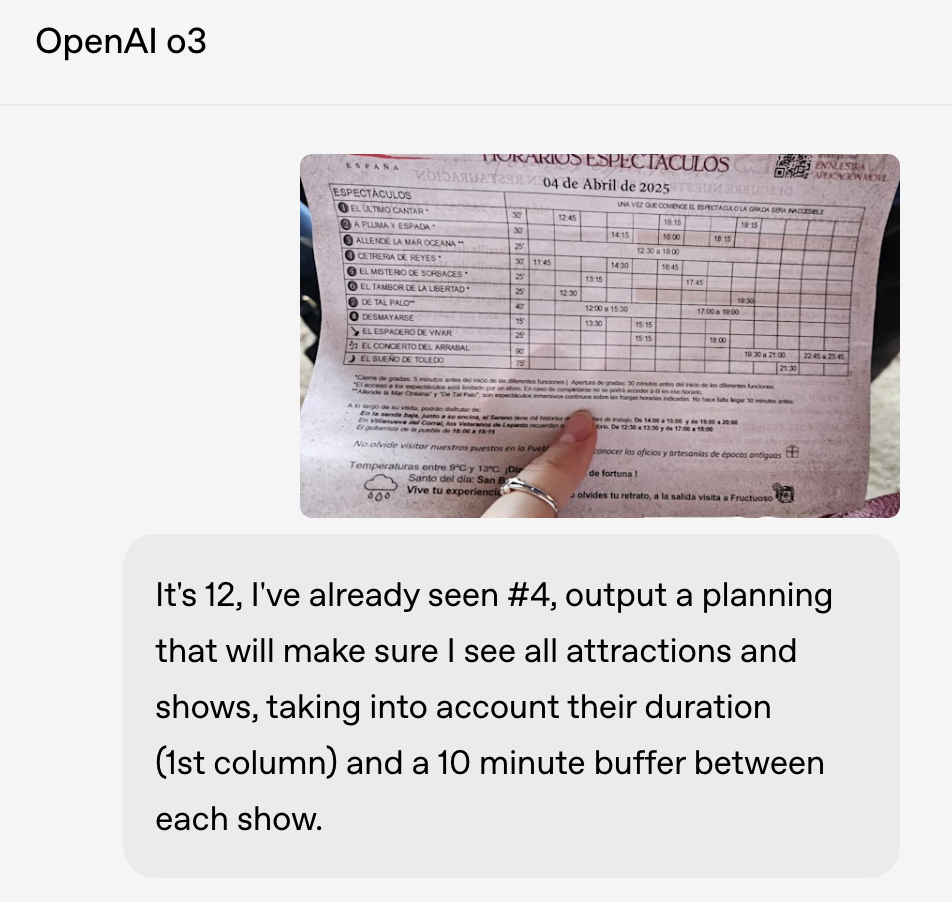
We wilden de visuele vaardigheden snel zelf testen. We gaven eerst o1 een rudimentaire tekening en vroegen: “Met welke fractal beginnen we te tekenen?”
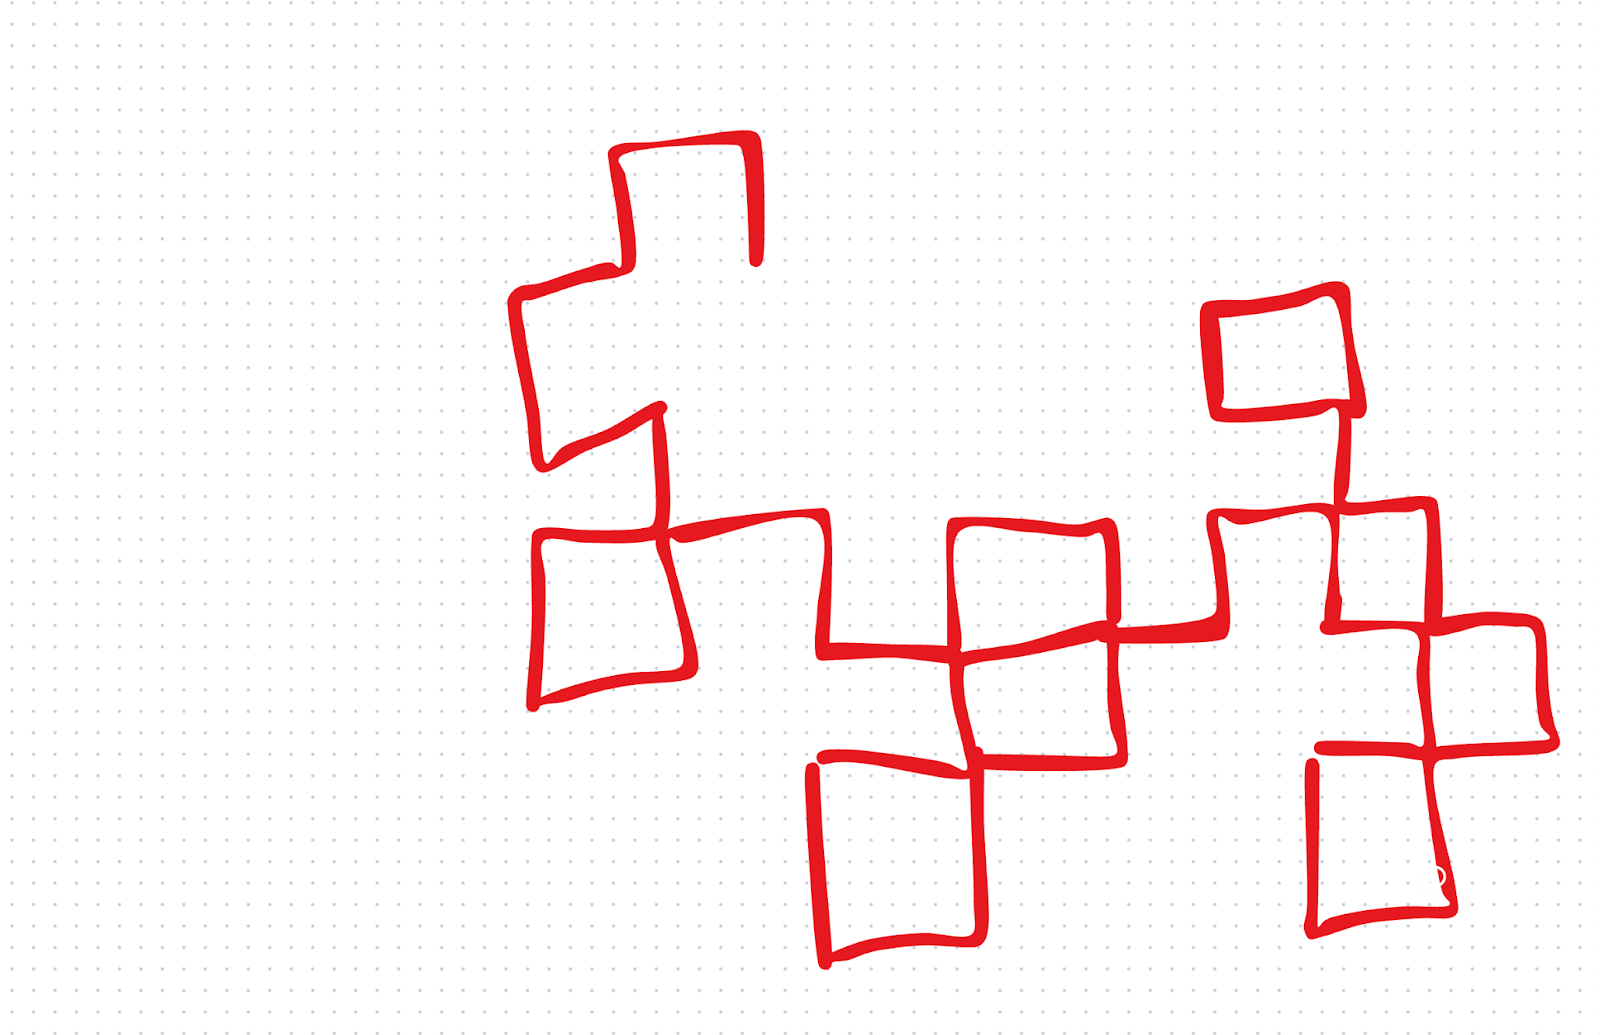
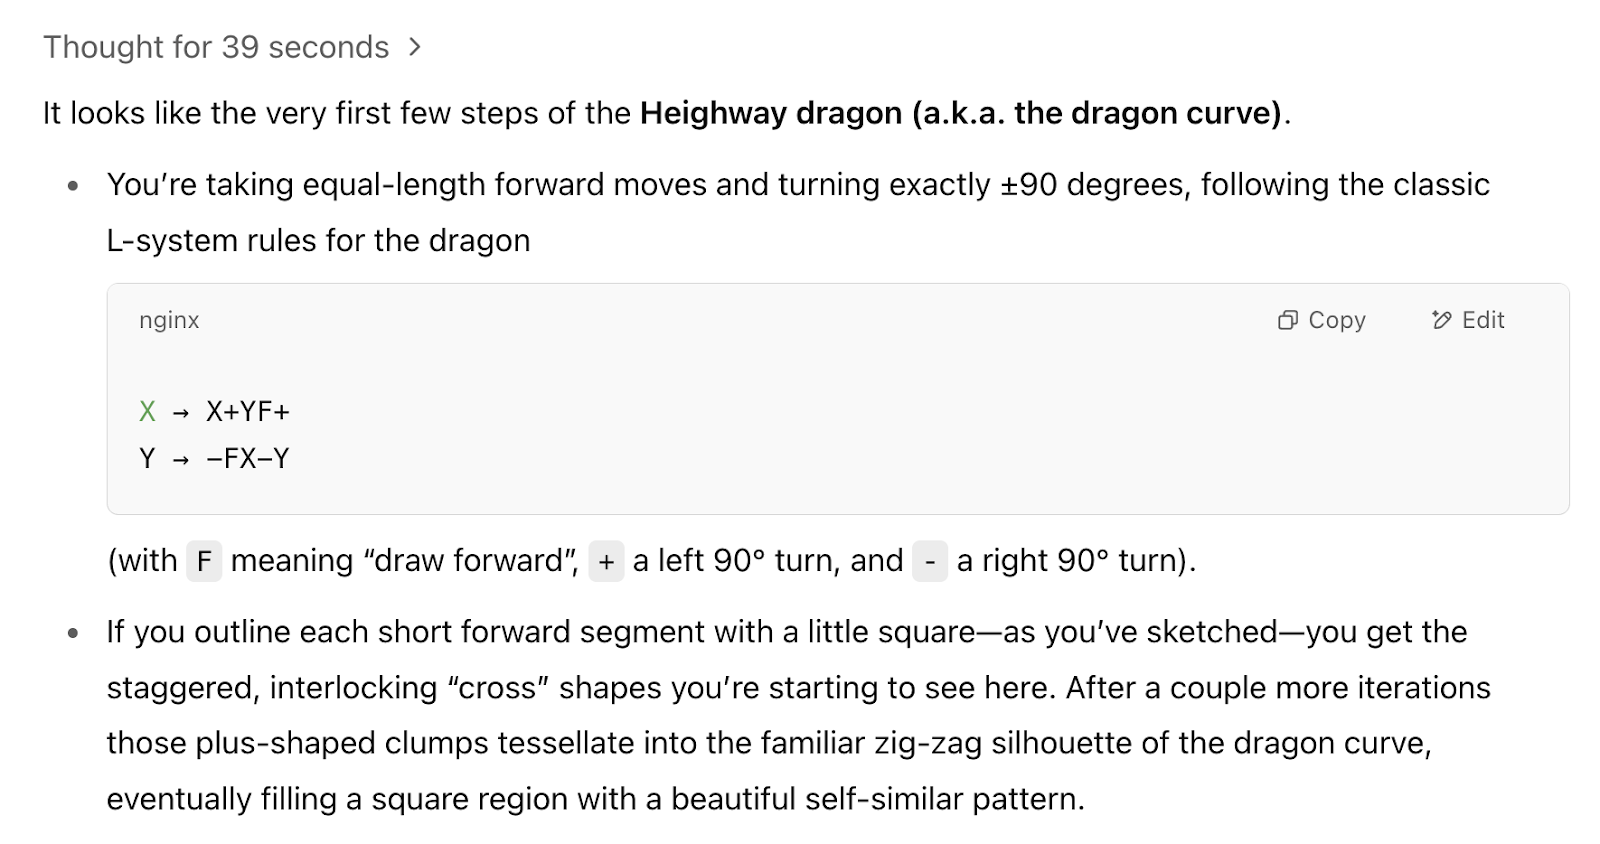
o1 antwoordde onjuist. o3 had het daarentegen goed: het zei dat we begonnen waren met het tekenen van de dragon curve. Dit was een kleine test, maar we waren onder de indruk van het resultaat omdat we o3 weinig aanknopingspunten gaven.
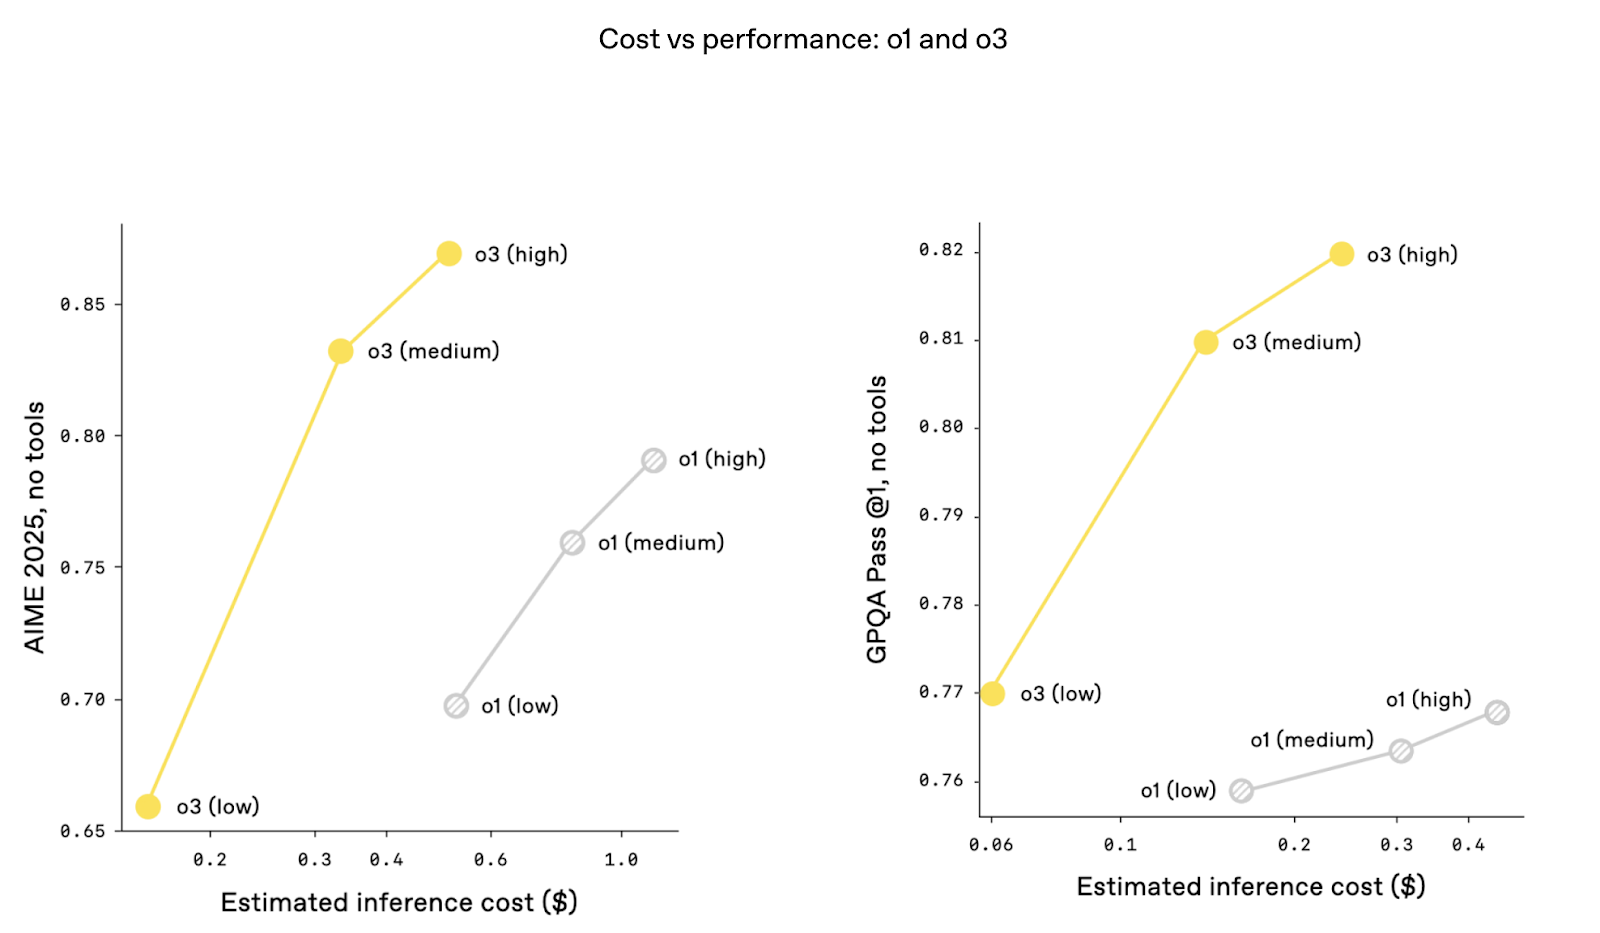
Interessant genoeg zijn de kosten-versus-prestatiemetrics beter met o3. Met andere woorden: de prestaties zijn hoger bij dezelfde niveaus van inferencekosten. Dit kan te danken zijn aan architecturale optimalisaties die de token-throughput verbeteren en de latentie verminderen. Kosten zijn een groot discussiepunt sinds Deepseek-R1 superhoge prestaties aankondigde tegen een fractie van de kosten van ChatGPT.
Sinds april 2025 is o3-mini volledig vervangen door o4-mini in ChatGPT en de API. o4-mini biedt betere prestaties op de meeste benchmarks, voegt native multimodale input toe en behoudt toolcompatibiliteit—terwijl het sneller en betaalbaarder blijft dan o3. In feite neemt o4-mini nu de rol over die voor o3-mini bedoeld was. De onderstaande inhoud blijft echter geldig voor o3-mini.
o3-mini werd samen met o3 geïntroduceerd als een kostenefficiënt alternatief dat geavanceerde redeneercapaciteiten voor meer gebruikers toegankelijk maakt, met behoud van prestaties. OpenAI omschreef o3-mini als het herdefiniëren van de “kosten-prestatiegrens” in redeneermodellen, waardoor het geschikt is voor taken die hoge nauwkeurigheid vereisen maar middelen moeten balanceren.
Een van de opvallende functies van o3-mini is de adaptieve denktijd, waarmee gebruikers de redeneerinspanning van het model kunnen aanpassen aan de complexiteit van de taak. Voor eenvoudigere problemen kunnen gebruikers laag-intensief redeneren selecteren om snelheid en efficiëntie te maximaliseren.
Voor uitdagendere taken maken opties voor hogere redeneerinspanning het model in staat te presteren op niveaus die vergelijkbaar zijn met o3 zelf, maar tegen een fractie van de kosten. Deze flexibiliteit is vooral aantrekkelijk voor ontwikkelaars en onderzoekers die aan diverse use-cases werken.
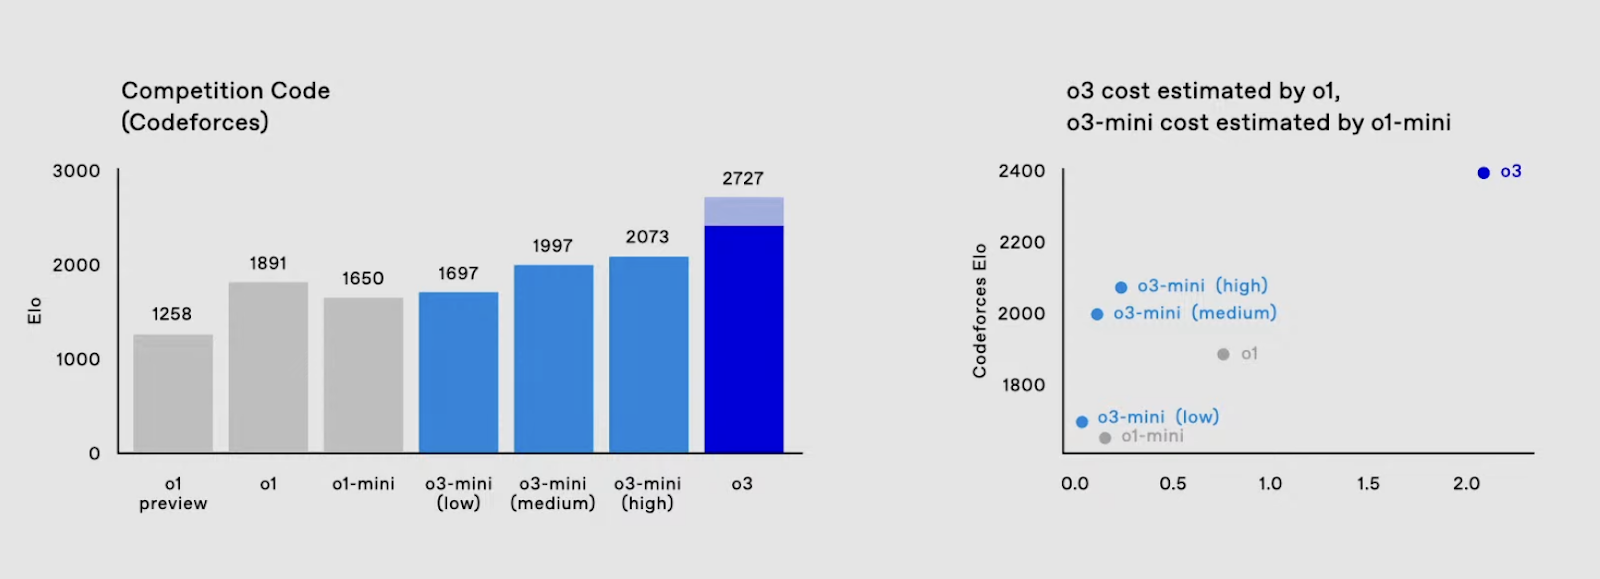
Bron: OpenAI
De live-demo liet zien dat o3-mini zijn belofte waarmaakt. Zo kreeg o3-mini bij een programmeertaak de opdracht om een Python-script te genereren voor het maken van een lokale server met een interactieve UI voor testen. Ondanks de complexiteit van de taak presteerde het model goed, wat zijn vermogen aantoont om programmeeruitdagingen aan te kunnen.
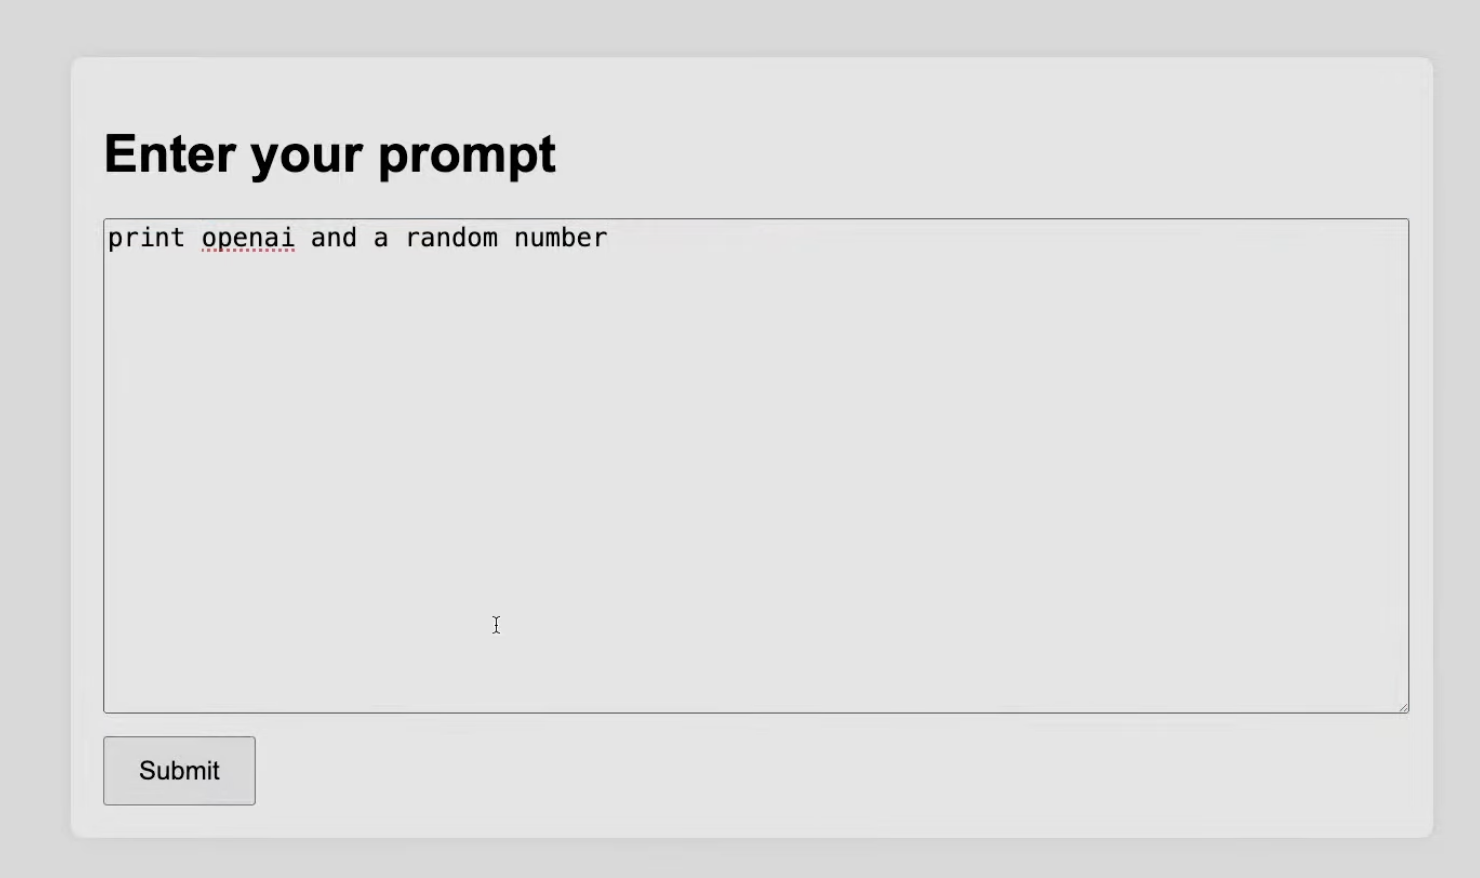
Bron: OpenAI
Wij zien o3-mini als een praktische oplossing voor scenario’s waarin kosteneffectiviteit en prestaties op één lijn moeten liggen.
Het heeft even geduurd voordat O3 beschikbaar kwam, en sommige redenen hebben mogelijk te maken met innovaties op het gebied van veiligheid.
OpenAI zei dat het zijn trainingsdatasets voor veiligheid opnieuw heeft opgebouwd en duizenden gerichte weigeraanvragen heeft geïntroduceerd. Ze noemden specifieke categorieën: biologische dreigingen, het genereren van malware en jailbreaktechnieken. Deze vernieuwde trainingsdata hebben o3 in staat gesteld om sterke weigeringsnauwkeurigheid te tonen op interne benchmarks, zoals het afhandelen van instructiehiërarchie en jailbreakbestendigheid. Naar verluidt hebben OpenAI-teamleden hiervoor duizend uur besteed aan het markeren van onveilige content.
OpenAI heeft ook een op redeneren gebaseerd LLM-monitor geïmplementeerd (wat ze een “safety-focused reasoning monitor” noemen). Dus naast het trainen van het model om “nee” te zeggen tegen onveilige prompts, heeft OpenAI een extra veiligheidslaag geïntroduceerd, namelijk een redenerende LLM. Zie het als een waakhondmodel dat parallel draait, specifiek getraind om na te denken over de intentie en potentiële risico’s van gebruikersinvoer, aan de hand van door mensen geschreven veiligheidsregels.
OpenAI heeft een proactieve aanpak gehanteerd voor veiligheidstests voor o3 en o3 mini door onderzoekers vroegtijdig toegang te geven voor publieke veiligheidsevaluaties voorafgaand aan de volledige release van de modellen.
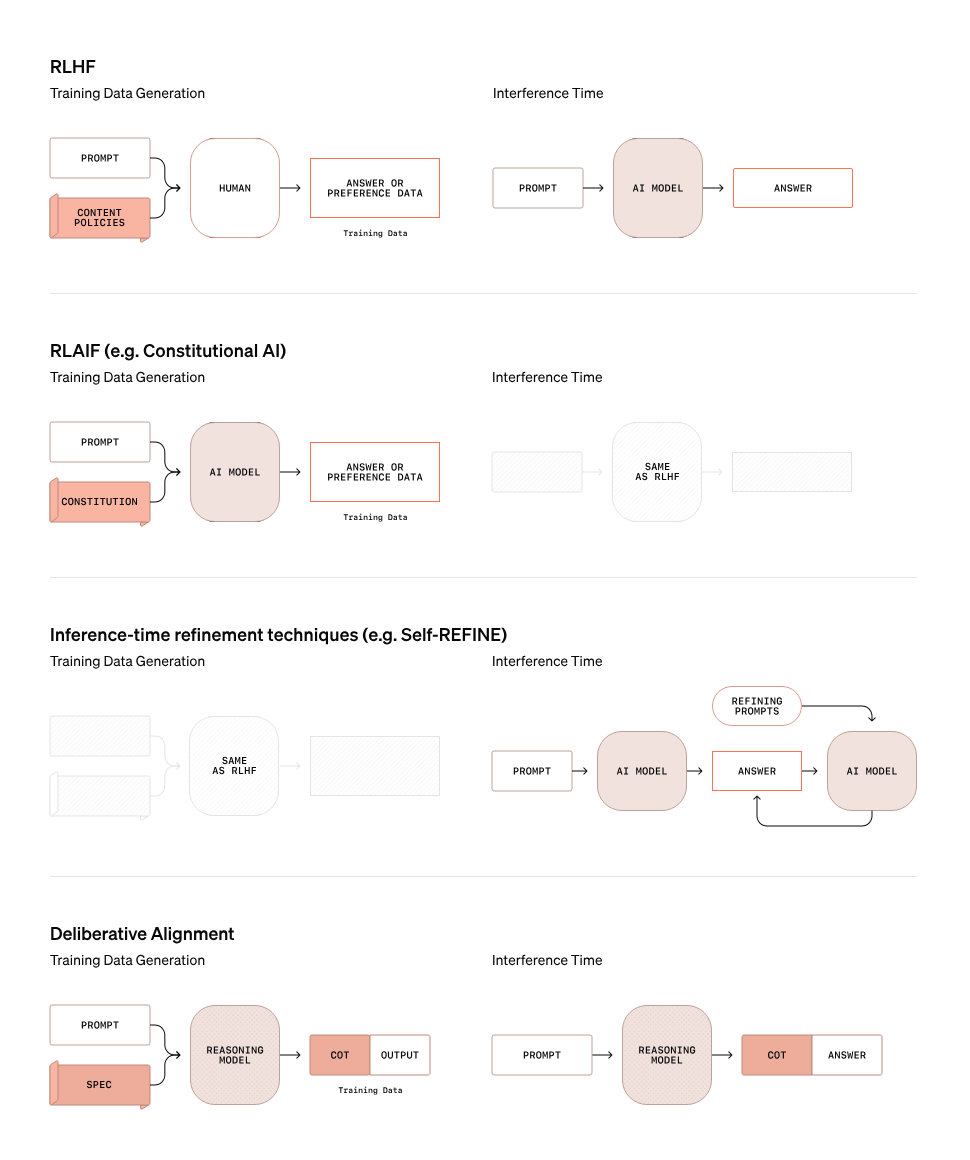
Een centraal onderdeel van OpenAI’s veiligheidsstrategie voor o3 is deliberative alignment, een methode die verder gaat dan traditionele veiligheidsbenaderingen. De onderstaande grafiek laat zien hoe deliberative alignment verschilt van andere methoden zoals RLHF (Reinforcement Learning with Human Feedback), RLAIF (Reinforcement Learning with AI Feedback) en verfijningstechnieken tijdens inferentie zoals Self-REFINE.
Bron: OpenAI
Bij deliberative alignment vertrouwt het model niet simpelweg op statische regels of voorkeursdatasets om te bepalen of een prompt veilig of onveilig is. In plaats daarvan gebruikt het zijn redeneercapaciteiten om prompts in realtime te evalueren. De bovenstaande grafiek illustreert dit proces:
OpenAI verwacht dat we meer willen lezen over veiligheid. In anticipatie hierop publiceerden ze hun Preparedness Framework met hun ideeën over het meten en beschermen tegen ernstige schade.
In de ChatGPT-modelkiezer zie je nu o3 en o4-mini beschikbaar. Volgens de aankondiging van OpenAI wordt o3-pro in de komende weken verwacht. Het zal dezelfde toolfuncties bevatten—zoals Python, browsen en afbeeldingsanalyse—als de andere modellen in de o-serie.
Wil je updates over wanneer o3-pro beschikbaar komt, meld je dan aan voor DataCamp’s nieuwsbrief, The Median, en we laten het je weten zodra hij er is.
O3 en o3 mini benadrukken de toenemende complexiteit van AI-systemen en de uitdagingen om ze verantwoord uit te brengen. Hoewel de benchmarks indrukwekkend zijn, zijn we vooral geïnteresseerd in de vragen die deze modellen oproepen: Hoe goed blijven ze presteren in praktijksituaties? Zijn de veiligheidsmaatregelen robuust genoeg om randgevallen op schaal aan te pakken?
Voor ons zijn o3 en o3 mini vroege signalen dat AI-systemen richting meer autonomie bewegen. Hun indrukwekkende redeneer- en aanpassingsvermogen suggereren een verschuiving van tools die wij bedienen naar agenten die namens ons handelen. Wat gebeurt er wanneer deze systemen open-eindetaken uitvoeren zonder menselijke aansturing? Hoe beoordelen we modellen die hun eigen doelen genereren, en niet alleen hun output?
Als je meer AI-onderwerpen wilt verkennen, raden we aan:
Leer AI met deze cursussen!
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

