
Visualisaties helpen ons de wereld te begrijpen en stellen ons in staat om grote hoeveelheden complexe informatie, data en voorspellingen beknopt over te brengen. Deskundige voorspellingen die aan een niet-expertpubliek moeten worden uitgelegd – of het nu gaat om het pad van een orkaan of de uitkomst van een verkiezing – bevatten altijd een zekere mate van onzekerheid. Als die onzekerheid niet in de relevante visualisaties wordt weergegeven, kunnen de resultaten misleidend en zelfs gevaarlijk zijn.
Hier verkennen we de rol van datavisualisatie bij het uittekenen van de voorspelde paden van orkanen. We bekijken verschillende visuele methoden om de onzekerheid van expertvoorspellingen over te brengen en het effect op de interpretatie door leken. Ook koppelen we dit aan een bredere discussie over best practices voor hoe nieuwsmedia berichten over zowel expertmodellen als wetenschappelijke resultaten rond thema’s die belangrijk zijn voor de brede bevolking.
Geen spaghetti-plots?
We hebben recent gezien welke schade tropische stormsystemen in de Amerika’s hebben aangericht. Nieuwsmedia zoals de New York Times hebben veel van wat er gaande was inzichtelijk gemaakt met interactieve visualisaties voor de orkanen Harvey en Irma, om maar wat te noemen. Visualisaties tonen onder andere geografische weergaven van het percentage mensen zonder elektriciteit, de hoeveelheid neerslag, de omvang van de schade en het aantal mensen in noodopvang.
Eén specifiek type plot duikt de laatste tijd begrijpelijkerwijs vaak op en zorgt voor discussie: hoe teken je het voorspelde pad van een orkaan uit, bijvoorbeeld voor de komende 72 uur. Er zijn meerdere manieren om voorspelde paden te visualiseren, elk met eigen valkuilen en misvattingen. Onlangs zagen we zelfs een artikel op Ars Technica met de titel Please, please stop sharing spaghetti plots of hurricane models, gericht aan Nate Silver en fivethirtyeight.
Hieronder vergelijk ik drie veelvoorkomende manieren, bespreek ik hun voor- en nadelen en doe ik suggesties voor andere typen plots. Ook ga ik in op waarom deze typen belangrijk zijn, zodat we kunnen bepalen welke visuele methoden en technieken het meest geschikt zijn.
Disclaimer: ik ben zeker geen expert in meteorologie of orkaanvoorspellingen. Maar ik heb veel nagedacht over visuele methoden om data, voorspellingen en modellen te communiceren. Ik verwelkom en moedig de feedback van experts, en ook die van anderen, van harte aan.
Voorspelde orkaanpaden visualiseren
Er zijn drie gangbare manieren om visualisaties van voorspelde orkaanpaden te maken. Voordat we het erover hebben, wil ik dat je ernaar kijkt en bedenkt welke informatie je uit elk van hen kunt halen. Doe je best om te interpreteren wat elk ervan wil vertellen, en daarna gaan we in op hun intenties, plus hun voor- en nadelen:
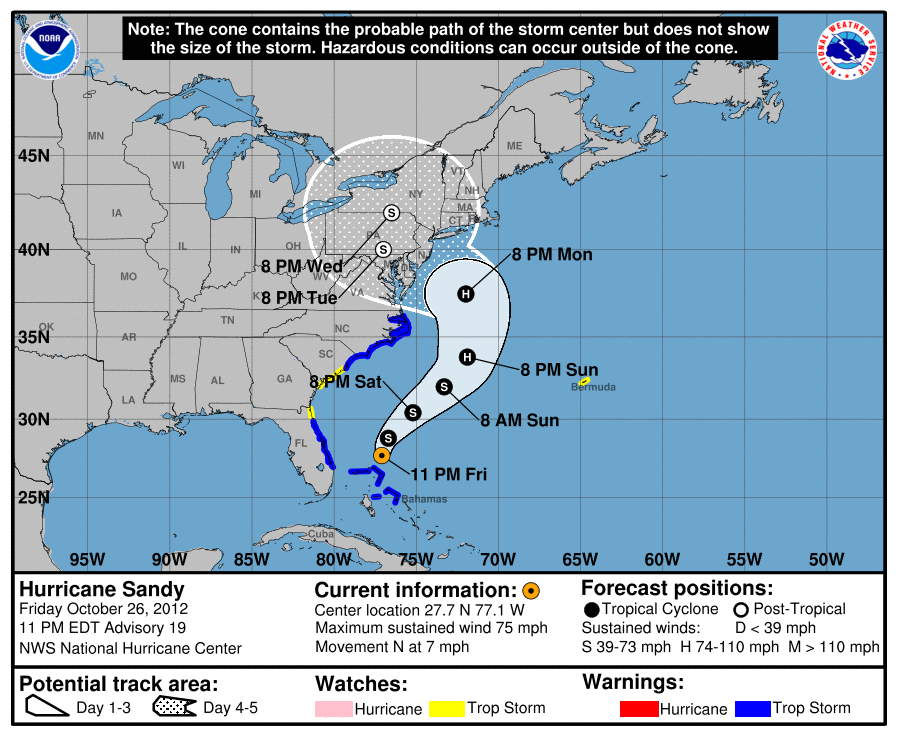
De kegel van onzekerheid
Spaghetti-plots (type I)
Spaghetti-plots (type II)
Interpretatie en impact van visualisaties van voorspelde orkaanpaden
De kegel van onzekerheid
De kegel van onzekerheid, een hulpmiddel van het National Hurricane Center (NHC) en gecommuniceerd door veel nieuwsmedia, toont het meest waarschijnlijke pad van de orkaan voor de komende vijf dagen, weergegeven door de zwarte stippen in de kegel. Hij toont ook hoe zeker men is van dit pad. Naarmate de tijd verstrijkt, neemt de zekerheid van de voorspelling af en dat wordt gevangen door de kegel: de kans is ongeveer 66,6% dat het centrum van de orkaan binnen de grenzen van de kegel valt.
Was dat uit de plot zelf af te leiden?
Voor mij in eerste instantie niet, en ik haalde deze informatie uit de plot zelf, de NHC-pagina ‘over de kegel van onzekerheid’ (about) en weather.com’s uitlegpost over de kegel. Er zijn nog drie opvallende punten, waar we op terugkomen:
- Een veelvoorkomende eerste misvatting is dat de verbreding van de kegel in de tijd zou suggereren dat de storm zal groeien;
- De plot bevat geen informatie over de omvang van de storm, alleen over het mogelijke pad van het centrum, en is dus beperkt bruikbaar om te vertellen waar je bijvoorbeeld orkaankrachtige wind kunt verwachten;
- Er staat essentiële informatie in de begeleidende tekst, naast de visualisatie zelf, zoals de prominente opmerking bovenaan: '[d]e kegel bevat het waarschijnlijke pad van het stormcentrum maar toont niet de omvang van de storm...'; bij het beoordelen van de effectiviteit van een datavisualisatie moeten we alle eigenschappen meenemen, inclusief tekst (en of we redelijkerwijs kunnen verwachten dat mensen die lezen!). Merk op dat interactiviteit een eigenschap is die deze visualisaties niet hebben (maar misschien wel zouden moeten hebben).
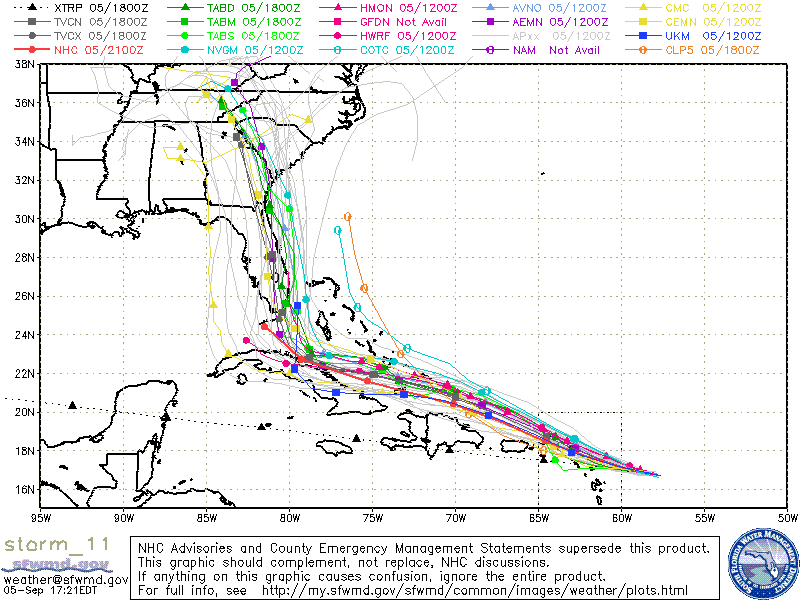
Spaghetti-plots (type I)
Dit soort plots toont meerdere voorspellingen in één figuur. In een willekeurige type I spaghetti-plot zijn de gevisualiseerde trajecten voorspellingen van modellen van verschillende instanties (bijvoorbeeld NHC, de National Oceanic and Atmospheric Administration en het UK Met Office). Ze zijn nuttig omdat ze, net als de kegel van onzekerheid, inzicht geven in de algemene regio die mogelijk op het pad van de orkaan ligt. Ze zijn tegelijk bijzonder onhandig en zelfs misleidend doordat elk model (of elke voorspelling) even zwaar weegt.
In de bovenstaande type I spaghetti-plot zijn er voorspellingen met uiteenlopende onzekerheid van instanties die in het verleden wisselend succesvol waren. Dus sommige paden zijn waarschijnlijker dan andere, gegeven wat we nu weten. Die informatie ontbreekt. Nog zorgwekkender: sommige paden zijn amper voorspellingen te noemen. Neem de zwarte stippellijn XTRP, een rechtelijnsvoorspelling op basis van het huidige traject van de storm. Dat is niet eens een model. Eric Berger gaat hier dieper op in in dit Ars Technica-artikel.
In wezen leveren dit soort plots een ensemblemodel (vergelijk met peiling-aggregatie). Maar een kernaspect van ensemblemodellen is dat elk model een passende weging krijgt, en die gewichten moeten in elke datavisualisatie worden gecommuniceerd. Straks zien we hoe dat kan met een variatie op type I.
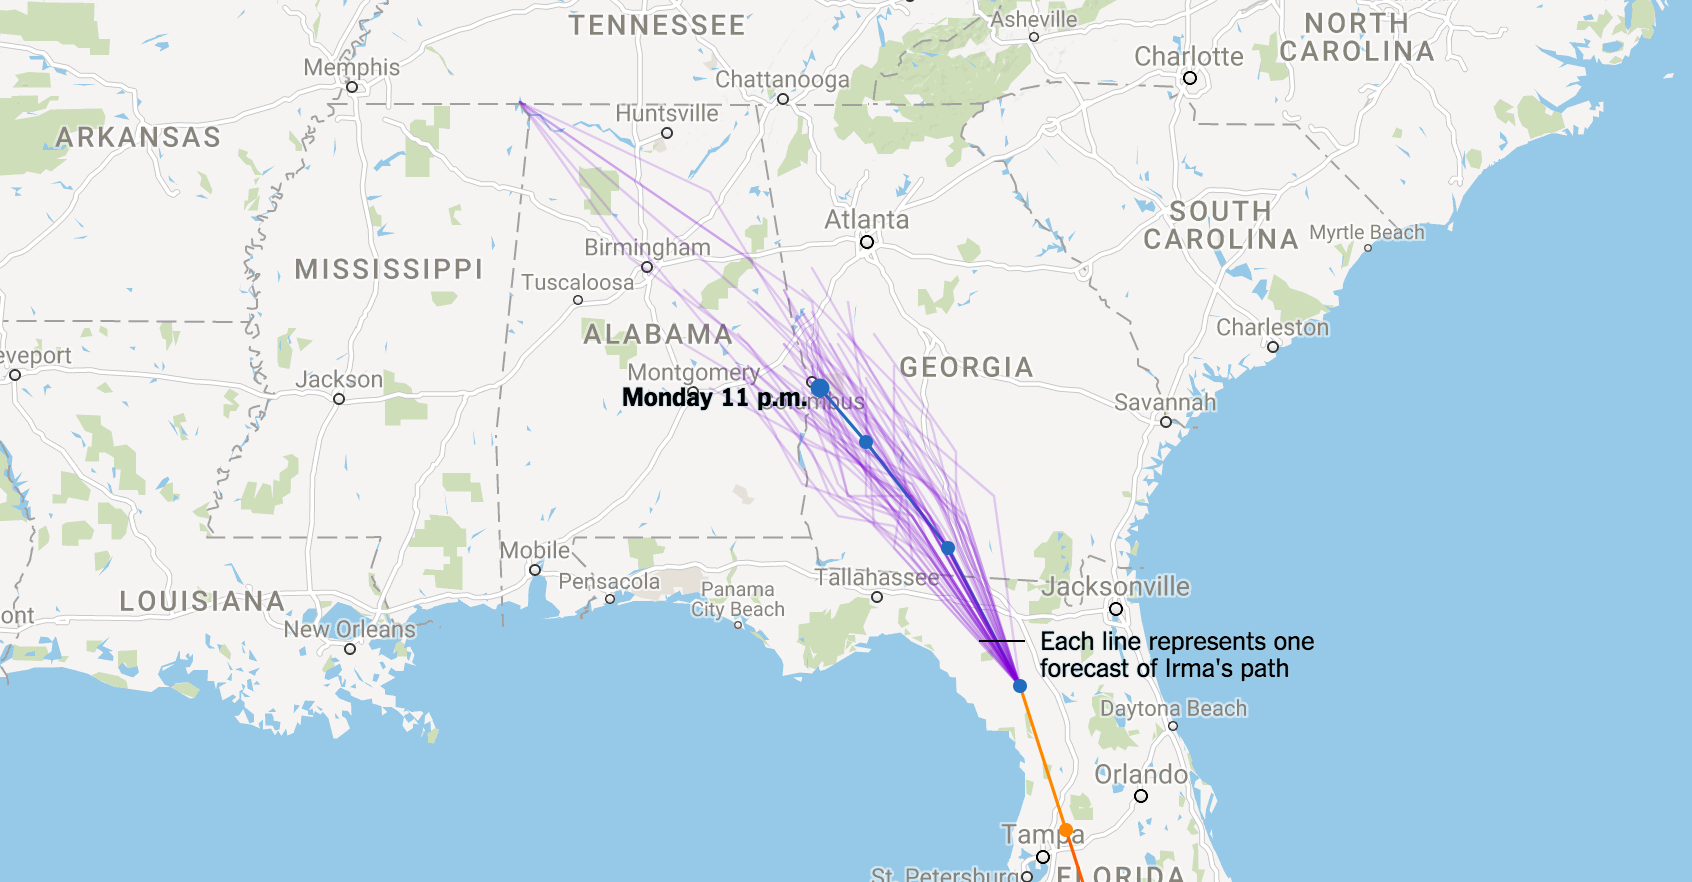
Spaghetti-plots (type II)
Deze plots tonen veel, zeg 50, verschillende runs van één gegeven model. Het punt is: als we een model meerdere keren simuleren (draaien), geeft het elke keer een ander traject. Waarom? Nate Cohen verwoordde het goed in The Upshot:
Het is echt lastig om precies te voorspellen wanneer een storm zal afbuigen. Zelfs een verschil van 15 of 20 mijl in het moment waarop hij naar het noorden draait, kan bepalen of Miami geraakt wordt door de oogwand – de felle ring van onweersbuien met de krachtigste winden die de rustige oog omringen.
Dit zijn misschien wel mijn favorieten van de drie, om meerdere redenen:
- Door meerdere runs van het model te simuleren, geven ze een indicatie van de onzekerheid binnen elk model;
- Ze schetsen een beeld van de relatieve waarschijnlijkheid dat het stormcentrum een bepaalde locatie passeert. Simpel gezegd: als meer van de getekende trajecten door locatie A gaan dan door locatie B, dan is het onder het huidige model waarschijnlijker dat het centrum van de storm door locatie A gaat;
- De kans op misinterpretatie is klein (in elk geval kleiner dan bij de kegel van onzekerheid en type I). De enige benodigde tekst op de visualisatie is: 'Elke lijn staat voor één voorspelling van Irma’s pad'.
Een nadeel van type II is dat ze geen representatie geven van meerdere modellen, maar zoals we zullen zien, kun je dit oplossen door ze te combineren met type I-plots. Een ander nadeel is dat ze, net als de andere, alleen het pad van het stormcentrum communiceren en niets zeggen over de omvang. Straks zien we ook hoe we dat kunnen verhelpen. Let op: het onderscheid tussen type I en type II spaghetti-plots komt niet uit de literatuur; ik heb het gemaakt omdat deze plots zo verschillende interpretaties en effecten hebben.
Voor nu is het echter goed om te beseffen dat we de effectiviteit van bepaalde soorten plots bespreken zonder expliciet hun doel te benoemen – waarom we ze überhaupt nodig hebben. Laten we eerst even afstand nemen en proberen te beantwoorden: ‘Wat is het doel van het visualiseren van het voorspelde pad van een orkaan?’ Zulke ogenschijnlijk naïeve vragen leveren vaak verheldering op.
Waarom voorspelde orkaanpaden plotten?
Waarom proberen we het voorspelde pad van een tropische storm over te brengen? Daar geef ik zo meerdere antwoorden op.
Maar eerst: waar zijn deze visualisaties niet voor bedoeld. We gebruiken ze niet om mensen te helpen beslissen of ze hun huis of stad moeten evacueren. Een evacuatie bevelen of adviseren doen lokale autoriteiten, na herhaald overleg met experts, wetenschappers, modelleurs en andere belangrijke betrokkenen.
Het belangrijkste doel van dit type visualisatie is de bevolking zo goed mogelijk te informeren over de mogelijke paden van de orkaan en hen in staat te stellen zich op het ergste voor te bereiden als er een kans is dat hun locatie in het verwoestingspad ligt. Het is niet de bedoeling om mensen onnodig bang te maken. Zoals weather.com stelt over de functie van de kegel van onzekerheid: '[e]lke tropische storm krijgt een voorspellingskegel om het publiek beter te laten begrijpen waar hij naartoe gaat' en '[d]e kegel is ontworpen om toenemende voorspellingsonzekerheid in de tijd te tonen.'
Daarom lijkt het me belangrijk dat een lezer ernaar kan kijken en kan zeggen: ‘het is zeer waarschijnlijk/waarschijnlijk/50% mogelijk/niet waarschijnlijk/zeer onwaarschijnlijk’ dat mijn huis (bijvoorbeeld) aanzienlijk beschadigd zal raken door de orkaan.
Nog beter: kunnen zeggen: "Er is, op basis van de huidige state-of-the-art modellering, 30–40% kans dat mijn huis aanzienlijk beschadigd raakt".
Dan hebben we een hiërarchie van wat we met onze visualisatie willen communiceren:
- Minimaal willen we burgers bewust maken van de mogelijke paden van de orkaan.
- Vervolgens willen we dat burgers kunnen zeggen of het zeer waarschijnlijk, waarschijnlijk, onwaarschijnlijk of zeer onwaarschijnlijk is dat hun huis bijvoorbeeld op het pad ligt.
- Idealiter kan een burger in de visualisatie direct aflezen wat de kans (of bandbreedte) is dat hun huis op het pad van de orkaan ligt.
Daarnaast willen we dat onze visualisaties niet misleidend zijn en niet makkelijk verkeerd geïnterpreteerd kunnen worden.
De kegel van onzekerheid versus spaghetti-plots
Alle drie de methoden voldoen aan de minimumeis: burgers waarschuwen voor de mogelijke paden van de orkaan. De kegel van onzekerheid helpt burgers behoorlijk goed om in te schatten hoe waarschijnlijk het is dat een orkaan door een bepaalde locatie trekt (binnen de kegel is dat zo’n twee derde). Ten minste kwalitatief doen type II spaghetti-plots het hier ook goed, zoals hierboven beschreven: ‘als meer trajecten door locatie A gaan dan door locatie B, dan is het onder het huidige model waarschijnlijker dat het centrum van de storm door locatie A gaat’.
Als je 50 trajecten plot, krijg je een idee waar het centrum waarschijnlijk zal zijn: als rond de helft van de trajecten door een locatie gaat, is de kans ongeveer 50% (volgens ons model) dat het centrum die locatie raakt. Geen van deze methoden voldoet nog aan de derde functie; hieronder zien we hoe een combinatie van type I en type II spaghetti-plots dat mogelijk maakt.
Het grote probleem met de kegel van onzekerheid en type I spaghetti-modellen is dat de kegel gemakkelijk verkeerd wordt geïnterpreteerd (veel mensen zien de kegel als een groeiende storm en waarderen de rol van onzekerheid niet), en dat type I spaghetti-modellen misleidend zijn (ze laten alle modellen even geloofwaardig lijken). Deze modellen voldoen dus niet aan de basisvoorwaarde: ‘we willen dat onze visualisaties niet misleidend zijn en niet makkelijk verkeerd geïnterpreteerd kunnen worden’.
Best practices voor het visualiseren van orkaanvoorspellingen
Type II spaghetti-plots zijn het meest informatief en het minst vatbaar voor misinterpretatie. Maar ze presenteren niet de resultaten van alle modellen. Met andere woorden: ze aggregeren niet over meerdere modellen, zoals we bij type I zagen.
Wat als we type I en type II combineren?
Om dat te beantwoorden, deed ik een klein experiment met python, folium en numpy. Alle code vind je hier.
Ik nam eerst een van de voorspelde paden van Irma van het NHC van vorige week, voegde wat willekeurige ruis toe en plotte 50 trajecten. Opnieuw: ik ben geen expert in meteorologie. De ruis die ik genereerde en toevoegde aan het voorspelde signaal/pad was niet gebaseerd op modellen en zou in een echte usecase uit de modellen zelf komen (voor wie het interesseert: ik gebruikte Gaussische ruis). Overigens vond ik het lastig om data te vinden over de voorspelde paden die in de media werden gerapporteerd. De data die ik uiteindelijk gebruikte, vond ik hier.
Hier is een simpele type II spaghetti-plot met 50 trajecten:
Maar dit zijn mogelijke trajecten gegenereerd door één enkel model. Wat als we meerdere modellen van verschillende instanties hebben? Dan kunnen we van elk 50 trajecten plotten:
Een van de echt sterke kanten van type II spaghetti-plots is dat, als we er genoeg plotten, elk traject onscherp wordt en we een heatmap beginnen te zien van waar het centrum van de orkaan waarschijnlijk zal zijn. Dit betekent simpelweg: hoe meer blauw in een bepaalde regio, hoe groter de kans dat het pad daar doorheen gaat. Zoom in om het te bekijken.
Daarnaast kunnen we, als we geloven dat het ene model waarschijnlijker is dan het andere (bijvoorbeeld omdat de makers in het verleden veel nauwkeurigere modellen hebben geleverd), deze modellen overeenkomstig wegen via bijvoorbeeld de transparantie van de trajecten, zoals we hieronder doen. Het wegen van deze modellen is werk voor een expert en een essentieel onderdeel van dit proces van geaggregeerde modellering.
Wat het bovenstaande doet, is de taken oplossen die horen bij de eerste twee eigenschappen die we in onze visualisaties willen. Om de derde te bereiken – dat een lezer kan aflezen dat het bijvoorbeeld 30–40% waarschijnlijk is dat het centrum van een orkaan een bepaalde locatie passeert – zijn er twee oplossingen:
- de heatmap aanpassen zodat die bijvoorbeeld tussen rood en blauw verloopt en er een legenda bij zetten met bijvoorbeeld: rood betekent een kans van meer dan 90%;
- De heatmap omzetten in een contourkaart die gebieden toont waarin de kans binnen bepaalde waarden valt.
Let er ook op dat dit iemand de kans vertelt dat een locatie geraakt wordt door het orkaancentrum. Je kunt dit combineren (of eigenlijk: convolueren) met informatie over de omvang van de orkaan om de heatmap om te zetten in een kaart van de kans dat een locatie geraakt wordt door wind met orkaankracht. Als je dit wilt doen, ga dan vooral aan de slag met de code die ik schreef om de bovenstaande plots te genereren (ik ben van plan een vervolgpost te schrijven waarin ik dit doe en de code doorloop).
Onzekerheid visualiseren en datajournalistiek
Wat leren we hieruit? We hebben verschillende soorten visualisatiemethoden voor voorspelde orkaanpaden verkend, de voor- en nadelen besproken en een weg vooruit gesuggereerd voor informatiereikere en minder misleidende plots van dergelijke paden – plots die niet alleen de resultaten tonen, maar ook de onzekerheid rond de modellen.
Dit maakt deel uit van een bredere discussie die we moeten voeren over het rapporteren van onzekerheid in visualisaties en in datajournalistiek in het algemeen. We moeten actief deelnemen aan gesprekken over hoe experts via nieuwsmedia onzekerheid aan burgers rapporteren. Hier is een sterk stuk van The Upshot dat laat zien hoe het banenrapport eruit zou kunnen zien door statistische ruis, zelfs als het aantal banen stabiel bleef. Hier is nog een Upshot-stuk over de rol van ruis en onzekerheid bij het interpreteren van peilingen. Ik ben me ervan bewust dat we koppen nodig hebben om nieuws te verkopen en dat clickbait een rol speelt in het moderne medialandschap, maar we moeten niet alleen resultaten communiceren, maar ook de onzekerheid rond die resultaten, om het brede publiek en mogelijk onszelf niet te misleiden. Misschien nog belangrijker: het onderwijssysteem moet verschuiven en alle burgers uitrusten met een basisniveau aan data- en statistische geletterdheid om met deze data-gedreven tijd om te gaan. Daar kunnen we allemaal aan bijdragen.

