Visualizações ajudam a compreender o mundo e permitem transmitir grandes volumes de informações complexas, dados e previsões de forma concisa. Previsões de especialistas que precisam ser comunicadas a públicos leigos — seja a trajetória de um furacão ou o resultado de uma eleição — sempre carregam um grau de incerteza. Se essa incerteza não aparece nas visualizações, os resultados podem ser enganosos e até perigosos.
Neste artigo, exploramos o papel da visualização de dados ao traçar caminhos previstos de furacões. Vamos ver métodos visuais diferentes para comunicar a incerteza das previsões de especialistas e o impacto disso na interpretação por não especialistas. Também conectamos o tema a uma discussão mais ampla de boas práticas sobre como veículos de mídia noticiosa reportam tanto modelos de especialistas quanto resultados científicos em assuntos de interesse público.
Sem spaghetti plots?
Vimos recentemente os estragos causados por sistemas de tempestades tropicais nas Américas. Veículos como o New York Times explicaram muita coisa do que estava acontecendo usando visualizações interativas sobre os furacões Harvey e Irma, por exemplo. Entre as visualizações, havia mapas da porcentagem de pessoas sem energia, volume de chuva, extensão dos danos e número de pessoas em abrigos, entre muitas outras.
Um tipo específico de gráfico voltou à tona e gerou controvérsia: como representar a trajetória prevista de um furacão, digamos, nas próximas 72 horas. Há várias formas de visualizar trajetórias previstas, cada uma com armadilhas e mal-entendidos próprios. Recentemente, vimos até um artigo na Ars Technica intitulado Please, please stop sharing spaghetti plots of hurricane models, direcionado a Nate Silver e ao fivethirtyeight.
A seguir, vou comparar três abordagens comuns, discutir prós e contras e sugerir variações. Também vou explicar por que esses tipos importam — isso ajuda a decidir quais métodos e técnicas visuais são mais adequados.
Aviso: definitivamente não sou especialista em meteorologia nem em previsão de furacões. Mas reflito bastante sobre métodos visuais para comunicar dados, previsões e modelos. Feedbacks de especialistas (e de todos os demais) são muito bem-vindos.
Visualizando trajetórias previstas de furacões
Existem três formas comuns de criar visualizações para trajetórias previstas de furacões. Antes de falar sobre elas, quero que você olhe para cada uma e pense: que informações dá para extrair? Tente interpretar o que cada uma quer comunicar e, depois, vamos detalhar suas intenções, além de prós e contras:
O cone de incerteza
Spaghetti plots (tipo I)
Spaghetti plots (tipo II)
Interpretação e impacto das visualizações de trajetórias previstas
O cone de incerteza
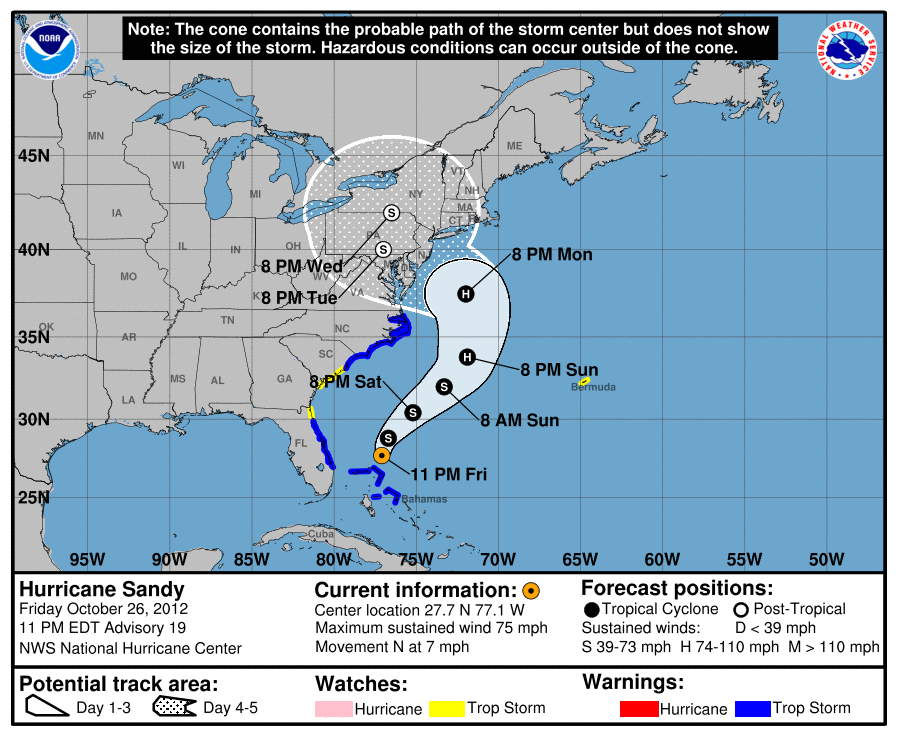
O cone de incerteza, ferramenta usada pelo National Hurricane Center (NHC) e divulgada por muitos veículos, mostra a trajetória mais provável do furacão nos próximos cinco dias, indicada pelos pontos pretos dentro do cone. Ele também comunica o grau de confiança nessa trajetória. Com o passar do tempo, a previsão fica menos certa, o que é capturado pelo alargamento do cone: há cerca de 66,6% de chance de o centro do furacão permanecer dentro dos limites do cone.
Isso ficou claro só olhando o gráfico?
Para mim, não de imediato. Reuni essa informação a partir do próprio gráfico, da página "sobre o cone de incerteza" do NHC (link) e de um post explicativo do weather.com. Há três pontos importantes aos quais vamos voltar:
- É comum achar, de início, que o alargamento do cone ao longo do tempo indica que a tempestade vai crescer;
- O gráfico não traz nenhuma informação sobre o tamanho da tempestade — apenas sobre a possível trajetória do seu centro —, então é limitado para dizer onde esperar, por exemplo, ventos com força de furacão;
- Informações essenciais estão no texto que acompanha a visualização, além do próprio gráfico, como o aviso em destaque no topo: "[o] cone contém a trajetória provável do centro da tempestade, mas não mostra o tamanho da tempestade..."; ao avaliar a eficácia de uma visualização, precisamos considerar todas as suas propriedades, incluindo o texto (e se dá para esperar que as pessoas realmente leiam!). Note que interatividade é algo que essas visualizações não têm (mas talvez devessem ter).
Spaghetti plots (tipo I)
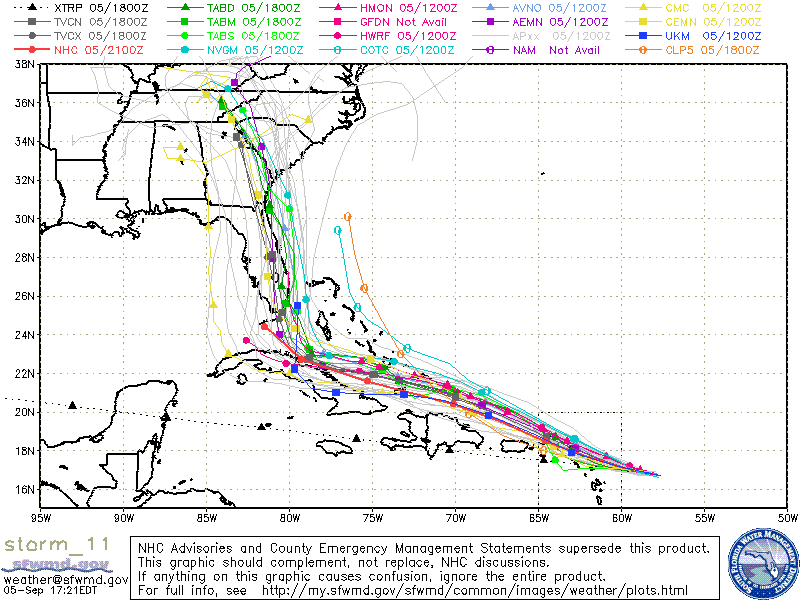
Esse tipo mostra várias previsões no mesmo gráfico. Em um spaghetti plot tipo I, as trajetórias visualizadas são previsões de modelos de diferentes agências (NHC, a NOAA e o UK Met Office, por exemplo). Assim como o cone de incerteza, são úteis por indicar a região geral que pode estar no caminho do furacão. Mas são pouco úteis — e até enganosos — por darem o mesmo peso a cada modelo (ou previsão).
No gráfico tipo I acima, há previsões com graus variados de incerteza, feitas por agências com histórico de acertos também variado. Logo, algumas trajetórias são mais prováveis que outras, dado o que sabemos. Essa informação não aparece. Mais preocupante: algumas curvas mal podem ser chamadas de previsão. Veja a linha preta pontilhada XTRP, que projeta um traçado em linha reta com base no rumo atual da tempestade. Isso nem é um modelo. Eric Berger detalha isso neste artigo da Ars Technica.
Essencialmente, esse tipo de gráfico sugere um modelo de ensemble (compare com agregadores de pesquisas). Porém, um ponto-chave em ensembles é atribuir pesos adequados a cada modelo — e esses pesos precisam ser comunicados na visualização. Já já veremos como fazer isso com uma variação do tipo I.
Spaghetti plots (tipo II)
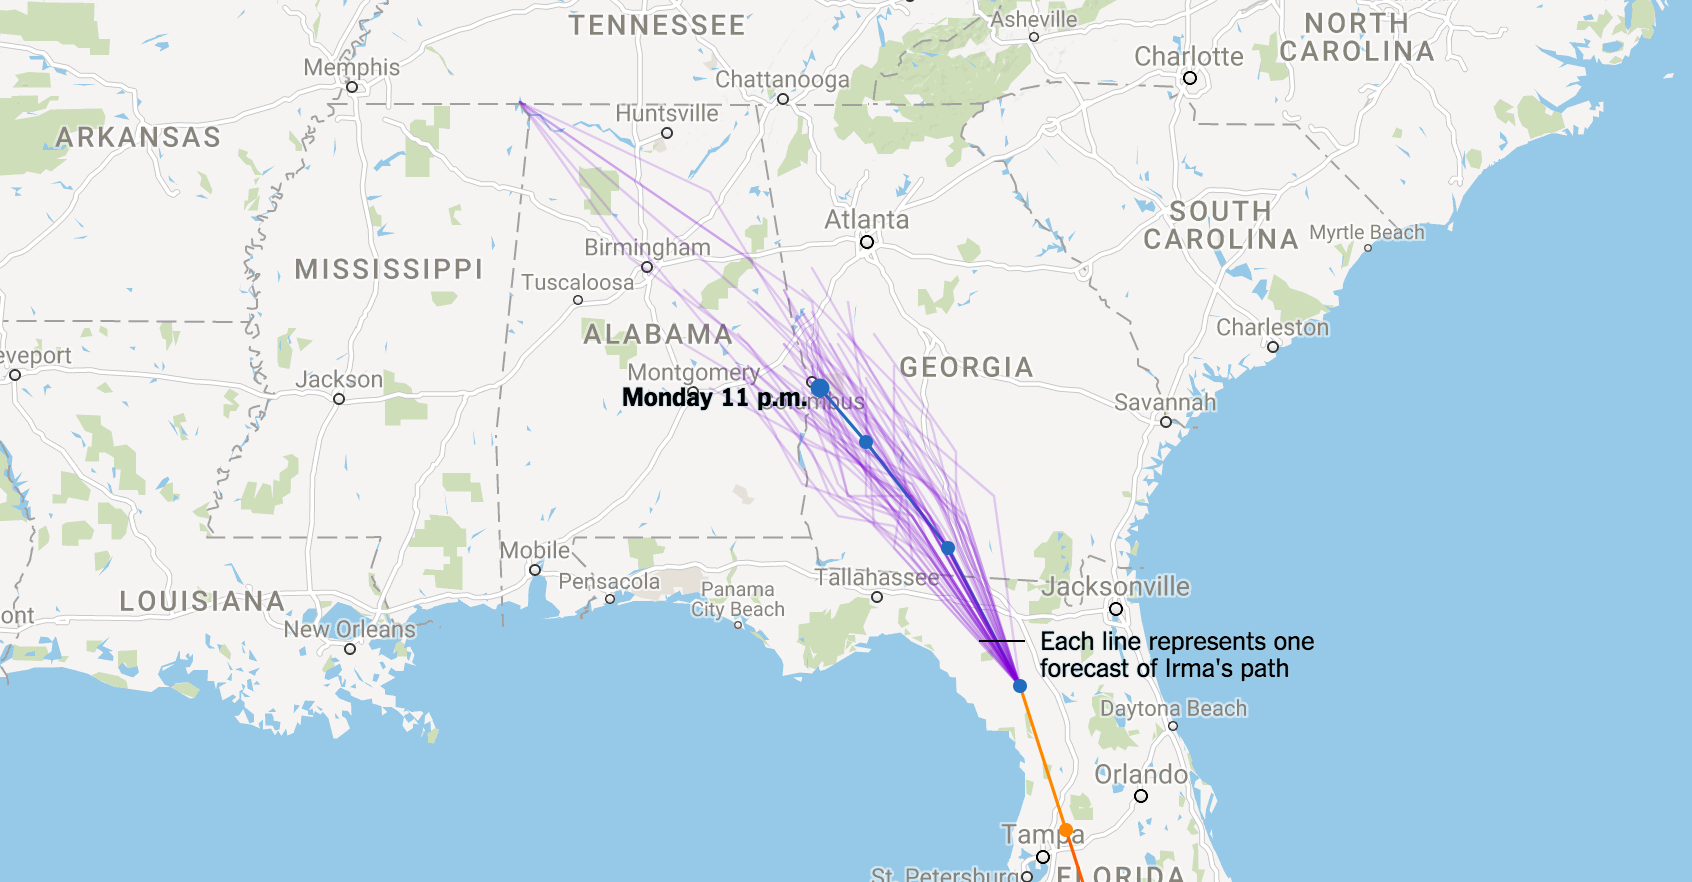
Esses gráficos mostram muitas — digamos, 50 — realizações de um mesmo modelo. A ideia é: se simulamos (rodamos) um modelo várias vezes, ele gera uma trajetória diferente a cada execução. Por quê? Nate Cohen explicou bem no The Upshot:
É muito difícil prever exatamente quando uma tempestade vai fazer uma curva. Mesmo uma diferença de 24 a 32 quilômetros no momento em que ela vira para o norte pode determinar se Miami será atingida pela parede do olho, o anel de tempestades mais intensas que circunda o olho mais calmo.
Talvez sejam meus favoritos entre os três, por vários motivos:
- Ao simular várias execuções do modelo, indicam a incerteza inerente a cada modelo;
- Mostram a probabilidade relativa de o centro da tempestade passar por determinado local. Em outras palavras: se mais trajetórias passam pelo ponto A do que pelo ponto B, então, segundo o modelo atual, é mais provável que o centro passe pelo ponto A;
- Têm menor chance de interpretação equivocada (ao menos em comparação ao cone de incerteza e ao tipo I). O texto necessário no gráfico se resume a: "Cada linha representa uma previsão da trajetória de Irma".
Uma desvantagem do tipo II é não representar múltiplos modelos — mas veremos que dá para contornar isso combinando com o tipo I. Outra é que eles, como os demais, mostram apenas a trajetória do centro da tempestade e nada dizem sobre o tamanho. Já vamos ver como lidar com isso. Observação: a distinção entre spaghetti plots tipo I e tipo II não é algo que encontrei na literatura — criei aqui porque os gráficos têm interpretações e efeitos bem diferentes.
Por ora, note que estamos discutindo a eficácia dos gráficos sem falar explicitamente sobre seu propósito — por que precisamos deles. Antes de seguir, vale dar um passo atrás e perguntar: "Qual é o objetivo de visualizar a trajetória prevista de um furacão?". Fazer esse exercício, que parece ingênuo, costuma ser revelador.
Por que traçar trajetórias previstas de furacões?
Por que queremos comunicar a trajetória prevista de uma tempestade tropical? Em um minuto, trago algumas respostas.
Antes, um ponto sobre o que essas visualizações não pretendem fazer: elas não servem para ajudar alguém a decidir se deve evacuar sua casa ou cidade. Ordens ou recomendações de evacuação são feitas por autoridades locais, após consultas repetidas com especialistas, cientistas, modeladores e outras partes relevantes.
O principal objetivo desse tipo de visualização é informar bem a população sobre os possíveis caminhos do furacão e permitir que se prepare para o pior, caso haja chance de sua região estar na rota de destruição. Não é causar pânico desnecessário. Como o weather.com afirma sobre a função do cone de incerteza, "[c]ada sistema tropical recebe um cone de previsão para ajudar o público a entender melhor para onde ele está indo" e "[o] cone foi desenhado para mostrar o aumento da incerteza da previsão com o tempo".
Com isso em mente, considero importante que a pessoa consiga olhar e dizer: "é muito provável/provável/50% possível/pouco provável/muito improvável" que minha casa (por exemplo) sofra danos significativos com o furacão.
Melhor ainda: poder dizer "Há 30% a 40% de chance, segundo o que há de mais avançado em modelagem, de minha casa sofrer danos significativos".
Assim, temos uma hierarquia do que queremos comunicar com a visualização:
- No mínimo, alertar sobre os possíveis caminhos do furacão.
- Depois, permitir que a pessoa avalie se é muito provável, provável, pouco provável ou muito improvável que sua casa, por exemplo, esteja na rota.
- Idealmente, permitir que a pessoa leia, quantitativamente, a probabilidade (ou faixa de probabilidade) de sua casa estar na trajetória do furacão.
Além disso, queremos visualizações que não sejam enganosas nem fáceis de interpretar errado.
Cone de incerteza versus spaghetti plots
As três abordagens cumprem a função mínima de alertar sobre possíveis rotas do furacão. O cone de incerteza ajuda razoavelmente a estimar a chance de o furacão passar por um ponto específico (dentro do cone, algo como dois terços de probabilidade). Já os spaghetti plots tipo II também funcionam bem, ao menos qualitativamente, como dito acima: "se mais trajetórias passam pelo local A do que pelo B, então, segundo o modelo, é mais provável que o centro atravesse o A".
Se você plota 50 trajetórias, dá para sentir onde o centro provavelmente estará — se cerca de metade passa por um ponto, então há aproximadamente 50% de chance (no nosso modelo) de o centro atingir aquele local. Nenhum desses métodos ainda cumpre a terceira função, e veremos abaixo como combinar os tipos I e II para chegar lá.
O grande problema do cone de incerteza e dos spaghetti plots tipo I é que o cone é fácil de interpretar mal (muita gente acha que ele indica uma tempestade crescendo e não percebe o papel da incerteza) e o tipo I é enganoso (faz parecer que todos os modelos têm a mesma credibilidade). Assim, eles não atendem ao requisito básico de que "a visualização não deve ser enganosa nem fácil de interpretar errado".
Boas práticas para visualizar trajetórias previstas
Spaghetti plots tipo II são os mais descritivos e menos propensos a interpretação equivocada. Mas falham em apresentar os resultados de vários modelos — não agregam múltiplos modelos como vimos no tipo I.
E se combinarmos tipo I e tipo II?
Para responder, fiz um pequeno experimento usando python, folium e numpy. Você encontra todo o código aqui.
Primeiro, peguei uma das trajetórias previstas do furacão Irma do NHC, acrescentei um ruído aleatório e plotei 50 trajetórias. Reforço: não sou especialista em meteorologia. O ruído que gerei e adicionei ao sinal/trajetória prevista não foi baseado em modelos — em um caso real, viria dos próprios modelos (usei ruído Gaussiano, se quiser saber). E, para constar, foi difícil encontrar dados das trajetórias previstas divulgadas na mídia. Os dados que usei estavam neste link.
Aqui está um spaghetti plot simples do tipo II com 50 trajetórias:
Mas essas são trajetórias possíveis geradas por um único modelo. E se tivermos múltiplos modelos de diferentes agências? Podemos plotar 50 trajetórias de cada um:
Um aspecto muito interessante dos spaghetti plots tipo II é que, se plotarmos o bastante, cada trajetória fica indistinta e começamos a ver um heatmap de onde o centro do furacão provavelmente estará. Em resumo: quanto mais azul em uma região, maior a chance de a trajetória passar por ali. Dê zoom para conferir.
Além disso, se acreditamos que um modelo é mais confiável que outro (por exemplo, porque os autores já produziram previsões mais precisas no passado), podemos ponderá-los usando, por exemplo, a transparência das trajetórias, como abaixo. Vale lembrar que atribuir pesos é tarefa para especialistas — e parte essencial desse processo de modelagem agregada.
Com isso, atendemos aos dois primeiros objetivos desejados para nossas visualizações. Para alcançar o terceiro — permitir que a pessoa leia, por exemplo, que há 30% a 40% de chance de o centro do furacão passar por um ponto específico —, há duas saídas:
- ajustar o heatmap para variar, digamos, do vermelho ao azul e incluir uma legenda indicando que vermelho significa probabilidade acima de 90%;
- transformar o heatmap em um mapa de contornos que mostre regiões em que a probabilidade assume certos valores.
Vale notar: isso indicará a probabilidade de um ponto ser atingido pelo centro do furacão. Você pode combinar (na prática, convoluir) com informações sobre o tamanho do furacão para transformar o heatmap em um mapa da probabilidade de um local sofrer ventos com força de furacão. Se quiser fazer isso, explore o código que publiquei para gerar os gráficos acima (pretendo escrever um post de continuação explicando isso e destrinchando o código).
Visualizando incerteza e jornalismo de dados
O que fica de lição? Exploramos vários tipos de visualização para trajetórias previstas de furacões, discutimos prós e contras e sugerimos um caminho para gráficos mais informativos e menos enganosos — que comuniquem não só os resultados, mas também a incerteza dos modelos.
Isso faz parte de uma conversa mais ampla sobre como reportar incerteza em visualizações e no jornalismo de dados em geral. Precisamos participar ativamente de discussões sobre como especialistas comunicam incertezas ao público por meio da imprensa. Aqui vai um ótimo exemplo do The Upshot mostrando como o relatório de empregos poderia parecer por conta de ruído estatístico, mesmo com empregos estáveis. E aqui outro sobre o papel do acaso e da incerteza na interpretação de pesquisas. Sei que precisamos de manchetes para vender notícia e que o clickbait tem seu papel no cenário atual, mas precisamos comunicar não apenas resultados — e sim a incerteza em torno deles — para não induzir o público (e a nós mesmos) ao erro. E, talvez mais importante, a educação precisa evoluir e equipar todos com níveis adequados de letramento em dados e estatística para encarar esta era orientada por dados. Todos podemos contribuir.