
Ik krijg vaak de vraag: “waar ben je het meest enthousiast over als het gaat om de toekomst van data science?”
Als experts het hebben over de spannendste doorbraken, gaat het vaak over werk aan het front van het vakgebied. Ze bespreken deep learning en hoe het computers in staat stelt om mensen te verslaan met Go, hoe vooruitgang in AI zelfrijdende auto’s mogelijk heeft gemaakt, of hoe technologieën zoals Spark en Hadoop berekeningen op enorme datasets mogelijk maken.
Ik heb een ander antwoord op die vraag. Ik ga hier dieper op in in onze recente DataCamp-webinar, Democratizing Data Science within your Company, en ik deel hier ook een aantal van mijn gedachten.
Het onmogelijke mogelijk maken; het mogelijke makkelijk maken
Stel, je leefde in 1903 en iemand vroeg je wat de spannendste vooruitgang in transport was. Daar is een eenvoudig antwoord op: 3 december 1903 was de datum van de eerste zwaarder-dan-lucht vlucht, uitgevoerd door de gebroeders Wright in Kitty Hawk. Als je in 1969 dezelfde vraag had gekregen, had je kunnen antwoorden: “Apollo 11 dat op de maan landde.” Beide zijn volkomen terechte reacties, gericht op primeurs in de transportgeschiedenis: het onmogelijke mogelijk maken.
Maar laat me een ander perspectief bieden. 1903 was niet alleen het jaar van de eerste zwaarder-dan-lucht vlucht, het was ook het jaar waarin de Ford Motor Company werd opgericht. Binnen een paar jaar zou Ford de Model T introduceren, algemeen gezien als de auto die wagens van een luxeproduct veranderde in een betaalbaar vervoermiddel. En terwijl 1969 het jaar was waarin een mens voor het eerst op de maan liep, was het ook het jaar van de eerste vlucht van de Boeing 747, de eerste “jumbojet.” De toename in passagierscapaciteit maakte vliegreizen voor iedereen toegankelijker. Ik zou dit omschrijven als het mogelijke makkelijk maken.
Ik denk dat de vraag “wat is er spannend in data science” een vergelijkbaar antwoord heeft. Gehypete doorbraken zoals deep learning, zelfrijdende auto’s of big data maken het onmogelijke mogelijk: net als de eerste vlucht van de gebroeders Wright of de maanlanding roepen ze de reactie op: “ik kan niet geloven dat we dit kunnen!”
Maar er is een tweede revolutie: de verspreiding van data science-vaardigheden, zowel in programmeren als in statistische analyse, naar een grotere gemeenschap.
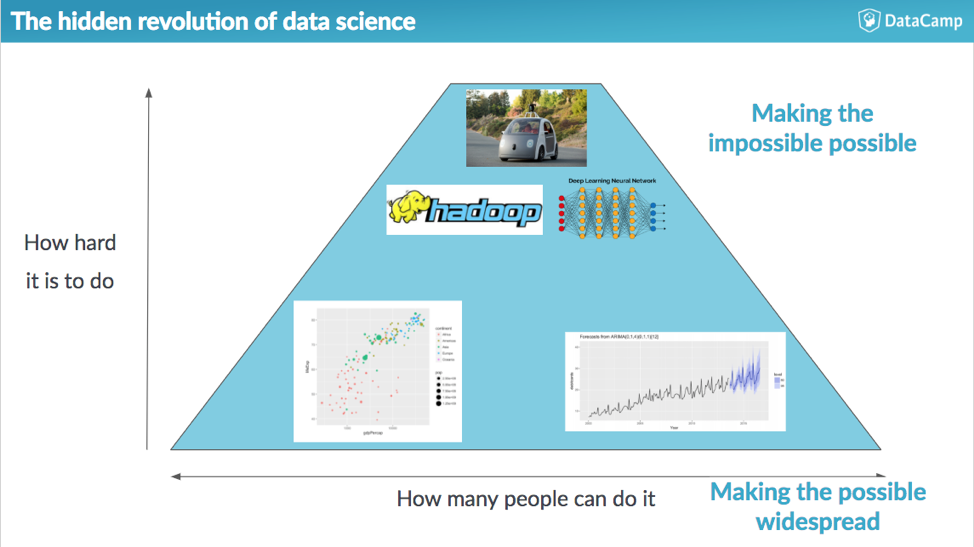
Steeds meer mensen, met verschillende achtergronden en in uiteenlopende afdelingen en sectoren, maken gebruik van tools en vaardigheden uit data science om hun werk te doen. Enkele van deze veranderingen zijn
- Groei van het aantal mensen dat Python en R gebruikt om data te analyseren
- Interfaces voor statistische tools worden steeds intuïtiever
- Vooruitgang in onderwijs in statistiek en programmeren
De meeste hiervan draaien niet om nieuwe statistische methoden of AI-aanpakken, net zoals de Model T niet de eerste auto was en de Boeing 747 niet het eerste vliegtuig. Wat ze spannend maakt, is de breedte van de groep mensen die ervan kan profiteren.
Wat is er veranderd in data science?
Groei van programmeertalen voor data science. De afgelopen jaren is het gebruik van programmeertalen voor data science explosief toegenomen. Zoals te zien is in analyses op de blog van Stack Overflow, maakt Python een sterke aanspraak op de titel van snelstgroeiende programmeertaal ter wereld, en dat is vooral te danken aan de tools voor data science. De R-taal laat een vergelijkbare, indrukwekkende groei zien, vooral binnen sectoren als de academische wereld, de gezondheidszorg, de overheid en consultancy.
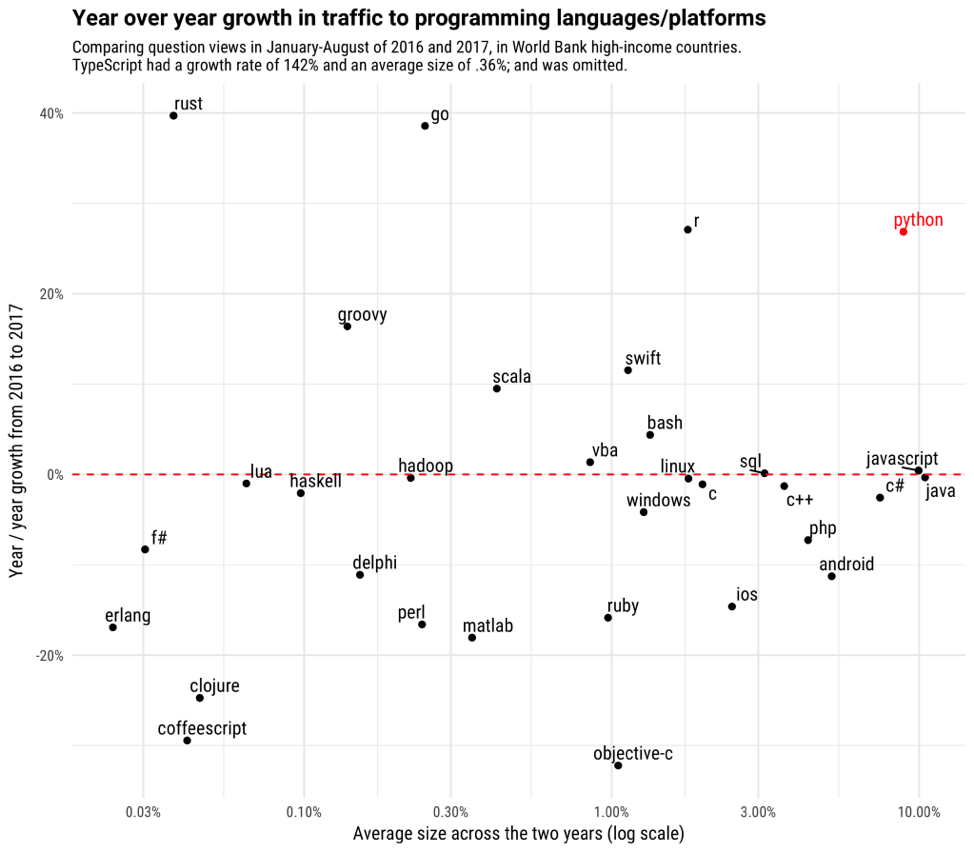 Bron: Stack Overflow
Verbeterde gebruiksvriendelijkheid in programmeertalen en tools. Veel van deze groei komt niet voort uit nieuwe methoden in statistiek, machine learning of AI, maar uit verbeteringen die bestaande methoden gebruiksvriendelijker maken. Een opmerkelijk voorbeeld is het pandas-pakket in Python, dat data structureert in een object genaamd een DataFrame, waarmee krachtige en intuïtieve analyses mogelijk zijn.
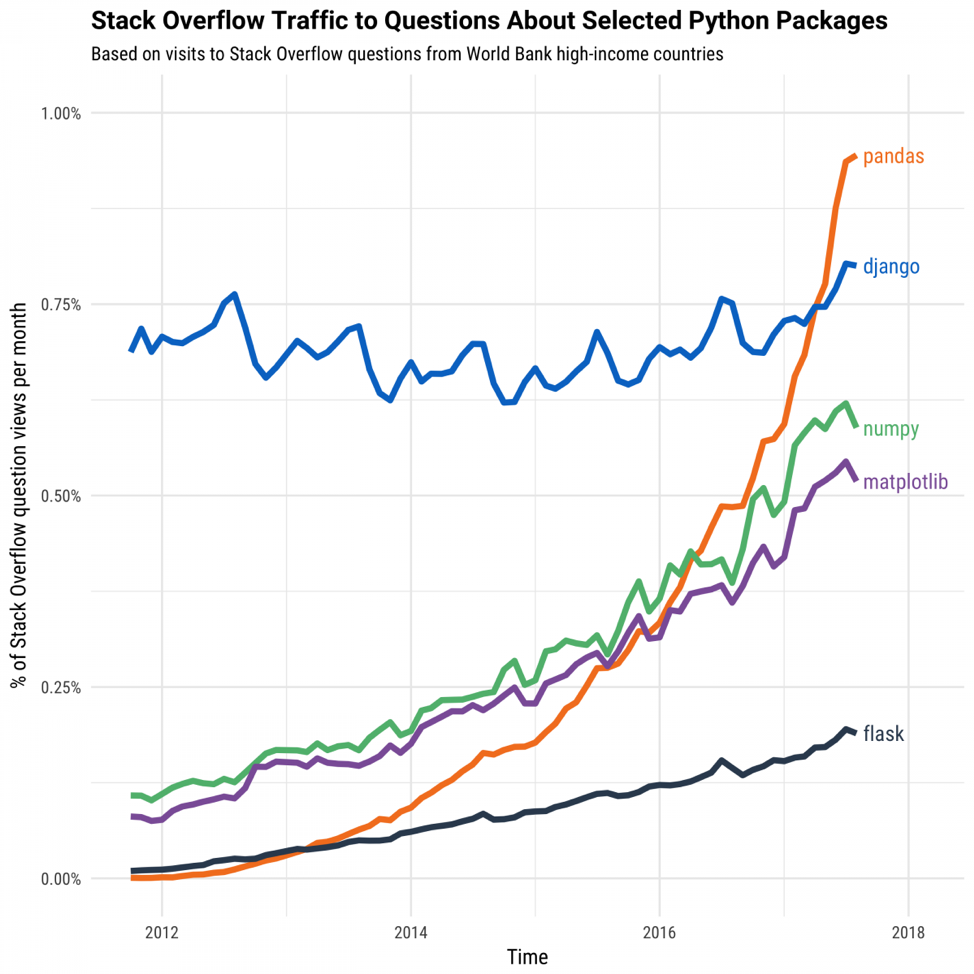 Bron: Stack Overflow
Pandas richt zich op het intuïtiever maken van bestaande methoden voor datatransformatie. Zoals pandas-bedenker Wes McKinney in een interview met Quartz deelde: “het stelt mensen in staat data te analyseren en ermee te werken die geen expert-computerwetenschappers zijn. Je moet nog steeds code schrijven, maar de code wordt intuïtief en toegankelijk gemaakt. Het helpt mensen om verder te gaan dan alleen Excel gebruiken voor data-analyse.” Pandas vormt de ruggengraat van DataCamp’s Data Scientist with Python-track.
Binnen de R-taal biedt de tidyverse een vergelijkbaar spannende revolutie in gebruiksgemak. Het is een verzameling pakketten die zijn ontworpen om datatransformatie, visualisatie en modelleren makkelijker te maken. Zoals ik , heb ik tidyverse opvallend intuïtief gevonden om methoden van datavisualisatie aan beginners te introduceren, en analyses bevestigen dat het tot de snelstgroeiende onderdelen van het R-ecosysteem behoort.
Beter onderwijs. De toename in activiteit rond programmeertalen voor data science komt doordat er nieuwe mensen aan de community deelnemen, ofwel vanuit andere gebieden van software-engineering of vanuit totaal andere carrières. Dat betekent dat een deel van de data science-revolutie niet alleen zit in hoe die tools zijn gebouwd, maar ook in hoe ze worden onderwezen.
Onze interactieve data science-cursussen bij DataCamp hebben honderdduizenden mensen geleerd hoe ze data kunnen analyseren en visualiseren, inclusief velen die nog nooit eerder hebben geprogrammeerd. De leercurve verlagen is een cruciaal onderdeel van het democratiseren van data science.
Wat betekent dit voor jouw bedrijf?
Als iemand je vraagt of je optimaal profiteert van data science, hoef je niet meteen te denken dat je chatbots aan je product moet toevoegen, of geld moet uitgeven aan een consultant die zegt dat hij deep learning gebruikt. Kijk in plaats daarvan naar hoe mensen binnen jouw bedrijf gebruikmaken van data-analyse en visualisatie.
Het is geweldig dat een lab bij Google AI kan gebruiken om een zelfrijdende auto te bouwen. Maar het is óók spannend wanneer een marketingmanager R kan gebruiken om te visualiseren hoe effectief hun advertenties zijn, of wanneer een finance-team Python kan gebruiken om toekomstige omzet te voorspellen.
Wil je beter begrijpen hoe deze revolutie in data science jouw bedrijf kan beïnvloeden? Volg dan onze webinar Democratizing Data Science Within Your Company.

