Sempre me perguntam: “do que você mais se anima no futuro da ciência de dados?”
Quando especialistas falam sobre os avanços mais empolgantes, geralmente destacam o que está na fronteira da área. Podem comentar sobre deep learning e como ele permite que computadores superem humanos no Go, como os avanços em IA viabilizaram carros autônomos, ou como tecnologias como Spark e Hadoop permitem processar conjuntos de dados gigantescos.
Minha resposta é um pouco diferente. Falo disso em detalhes no nosso recente webinar da DataCamp, Democratizing Data Science within your Company, e vou compartilhar aqui algumas ideias.
Tornar o impossível possível; tornar o possível fácil
Imagine que você vivia em 1903 e alguém perguntasse qual era o avanço mais empolgante em transporte. Há uma resposta óbvia: 3 de dezembro de 1903 marcou o primeiro voo de uma aeronave mais pesada que o ar, realizado pelos irmãos Wright em Kitty Hawk. Se a mesma pergunta fosse feita em 1969, você poderia responder: “o pouso da Apollo 11 na Lua”. Ambas são respostas justas, focadas em grandes marcos da história do transporte: tornar o impossível possível.
Mas deixe-me trazer outra perspectiva. 1903 não foi só o ano do primeiro voo; foi também o ano em que a Ford Motor Company foi fundada. Poucos anos depois, a Ford lançaria o Modelo T, amplamente reconhecido por transformar o carro de luxo em meio de transporte acessível. E enquanto 1969 viu o primeiro humano caminhar na Lua, também marcou o voo inaugural do Boeing 747, o primeiro “jumbo”. O aumento de capacidade de passageiros tornou a viagem aérea muito mais acessível. Eu descreveria isso como tornar o possível fácil.
Acho que a pergunta “o que é empolgante em ciência de dados?” tem uma resposta semelhante. Avanços muito comentados, como deep learning, carros autônomos ou big data, estão tornando o impossível possível: assim como o primeiro voo dos irmãos Wright ou a chegada à Lua, geram a reação “não acredito que dá pra fazer isso!”.
Mas existe uma segunda revolução: a disseminação das habilidades de ciência de dados, tanto em programação quanto em análise estatística, para um público muito maior.
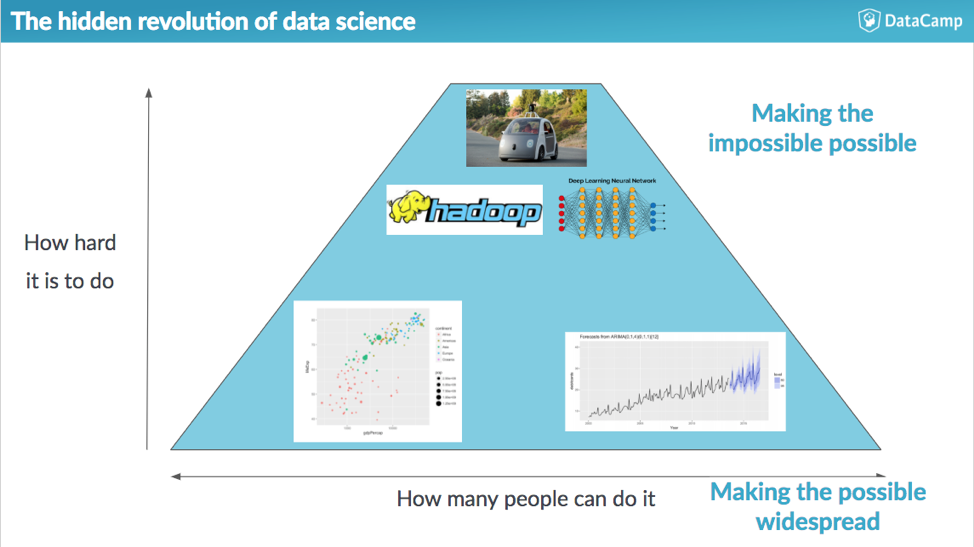
Cada vez mais pessoas, de diferentes formações e áreas, estão aproveitando ferramentas e práticas de ciência de dados para fazer seu trabalho. Algumas dessas mudanças incluem
- Crescimento do número de pessoas usando Python e R para analisar dados
- Interfaces de ferramentas estatísticas cada vez mais intuitivas
- Avanços no ensino de estatística e programação
A maioria disso não envolve métodos estatísticos inéditos nem abordagens de IA, assim como o Modelo T não foi o primeiro automóvel e o Boeing 747 não foi o primeiro avião. O que torna tudo isso empolgante é a quantidade e a diversidade de pessoas que conseguem se beneficiar.
O que mudou na ciência de dados?
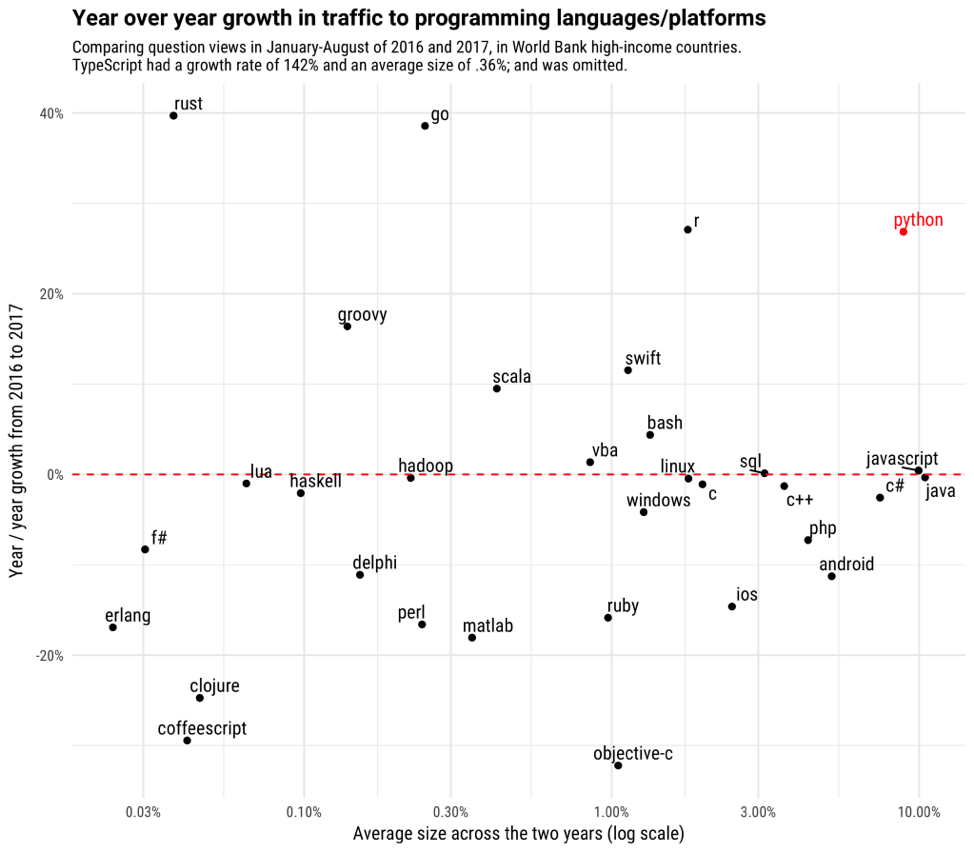
Crescimento das linguagens de programação para ciência de dados. Nos últimos anos houve uma explosão no uso de linguagens de programação para ciência de dados. Como mostram análises no blog do Stack Overflow, o Python tem bons argumentos para ser a linguagem que mais cresce no mundo, e muito disso se deve às suas ferramentas para ciência de dados. A linguagem R também apresenta um crescimento impressionante, especialmente em setores como academia, saúde, governo e consultoria.
 Source: Stack Overflow
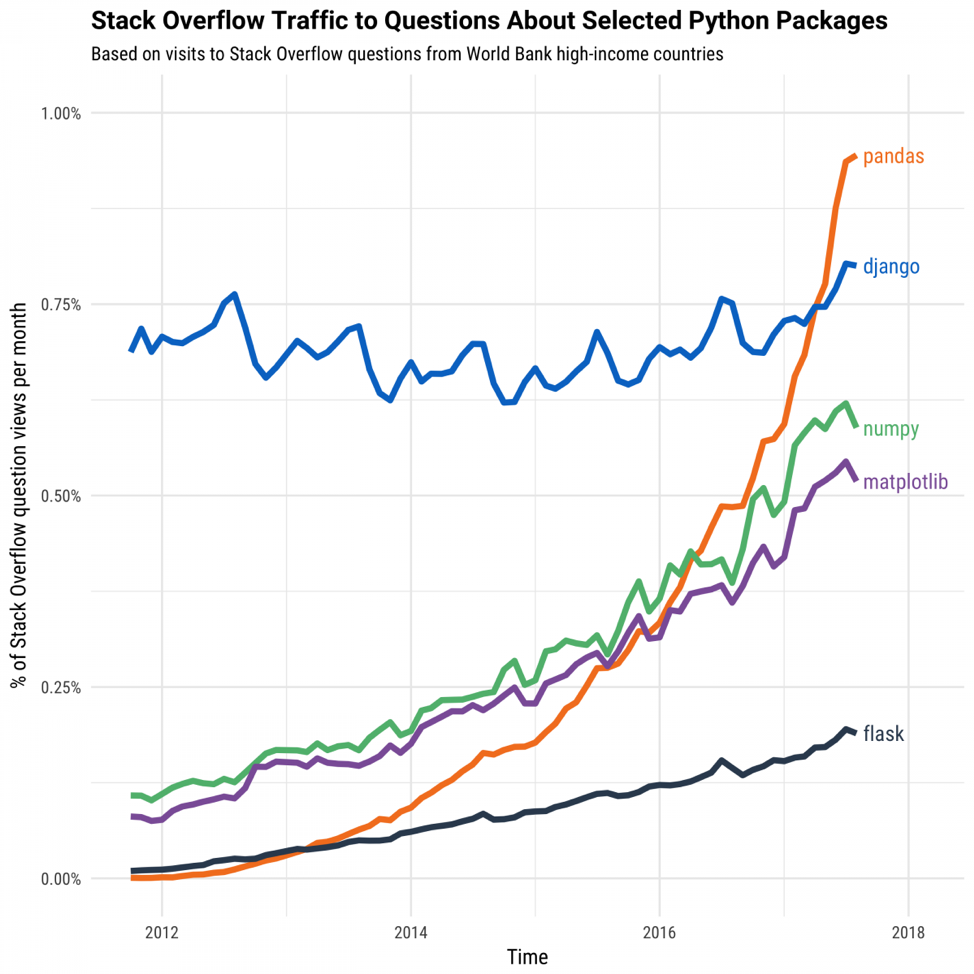
Usabilidade aprimorada nas linguagens e ferramentas. Muito desse crescimento não vem de métodos inéditos em estatística, machine learning ou IA, e sim de melhorias que tornam métodos existentes mais acessíveis. Um exemplo marcante é o pacote pandas no Python, que organiza dados em um objeto chamado DataFrame, permitindo análises poderosas e intuitivas.
 Source: Stack Overflow
O pandas é voltado a tornar transformações de dados já conhecidas mais intuitivas. Como o criador do pandas, Wes McKinney, contou em entrevista ao Quartz, “ele permite que pessoas que não são especialistas em computação analisem e trabalhem com dados. Você ainda precisa escrever código, mas a ideia é torná-lo intuitivo e acessível. Ajuda as pessoas a irem além do Excel na análise de dados.” O pandas é a espinha dorsal da trilha Data Scientist with Python da DataCamp.
No universo R, o tidyverse oferece uma revolução igualmente empolgante em usabilidade. É um conjunto de pacotes criado para facilitar transformação, visualização e modelagem de dados. Pela minha experiência, o tidyverse é extremamente intuitivo para introduzir visualização de dados a iniciantes e análises confirmam que está entre as partes que mais crescem no ecossistema R.
Educação melhor. A expansão do uso das linguagens de programação em ciência de dados acontece porque novas pessoas estão entrando nessa comunidade, vindas de outras áreas de engenharia de software ou de carreiras totalmente diferentes. Isso significa que parte dessa revolução não está só em como as ferramentas são construídas, mas em como elas são ensinadas.
Nossos cursos interativos de ciência de dados na DataCamp já ensinaram centenas de milhares de pessoas a analisar e visualizar dados, incluindo muitas que nunca haviam programado. Tornar a curva de aprendizagem mais leve é essencial para democratizar a ciência de dados.
O que isso significa para a sua empresa?
Quando alguém perguntar se você está aproveitando ao máximo a ciência de dados, não parta do pressuposto de que precisa colocar chatbots no seu produto ou investir em um consultor que diga usar deep learning. Em vez disso, olhe para como as pessoas dentro da sua empresa estão usando análise e visualização de dados.
É incrível que um laboratório do Google use IA para construir um carro autônomo. Mas também é empolgante quando um gerente de marketing usa R para visualizar a eficácia dos seus anúncios, ou quando o time de finanças usa Python para prever receita futura.
Se você quer entender melhor como essa revolução na ciência de dados pode impactar sua empresa, participe do nosso webinar Democratizing Data Science Within Your Company.