Ich werde oft gefragt: “Worauf freust du dich in der Zukunft der Data Science am meisten?”
Wenn Expertinnen und Experten über die spannendsten Fortschritte sprechen, geht es häufig um das, was an der Grenze des derzeit Machbaren liegt. Sie erzählen von Deep Learning und davon, wie Computer Menschen in Go schlagen, wie Fortschritte in der KI selbstfahrende Autos ermöglicht haben oder wie Technologien wie Spark und Hadoop Rechenleistung auf riesigen Datensätzen erlauben.
Ich sehe die Sache etwas anders. Ausführlich spreche ich darüber in unserem aktuellen DataCamp-Webinar Democratizing Data Science within your Company, und ein paar meiner Gedanken teile ich auch hier.
Das Unmögliche möglich machen, das Mögliche einfach
Stell dir vor, du lebst im Jahr 1903 und jemand fragt dich nach dem spannendsten Fortschritt im Verkehr. Die Antwort liegt auf der Hand: Am 3. Dezember 1903 gelang den Gebrüdern Wright in Kitty Hawk der erste Flug eines schwerer-als-Luft-Flugzeugs. Würde man dich 1969 dasselbe fragen, würdest du vermutlich mit “Apollo 11 und der Mondlandung” antworten. Beides sind absolut legitime Antworten, die sich auf historische Premieren in der Verkehrsgeschichte konzentrieren: Das Unmögliche möglich machen.
Aber lass mich eine andere Perspektive anbieten. 1903 war nicht nur das Jahr des ersten Motorflugs, sondern auch das Gründungsjahr der Ford Motor Company. Nur wenige Jahre später brachte Ford das Model T heraus, das allgemein dafür verantwortlich gemacht wird, das Auto vom Luxusgut zum erschwinglichen Verkehrsmittel zu machen. Und während 1969 der erste Mensch den Mond betrat, hob im selben Jahr auch die Boeing 747 zum Erstflug ab – das erste “Jumbojet”. Die gestiegene Passagierkapazität machte Flugreisen für viel mehr Menschen zugänglich. Ich würde das als das Mögliche einfach machen beschreiben.
Ich glaube, die Frage “Was ist gerade spannend in der Data Science?” hat eine ähnliche Doppelnatur. Gehypten Durchbrüchen wie Deep Learning, selbstfahrenden Autos oder Big Data gelingt es, das Unmögliche möglich zu machen: Genau wie beim ersten Flug der Wrights oder der Mondlandung reagieren wir mit “Unglaublich, dass das geht!”
Gleichzeitig gibt es eine zweite Revolution: Data-Science-Kompetenzen – sowohl in der Programmierung als auch in der statistischen Analyse – verbreiten sich in einer viel größeren Community.
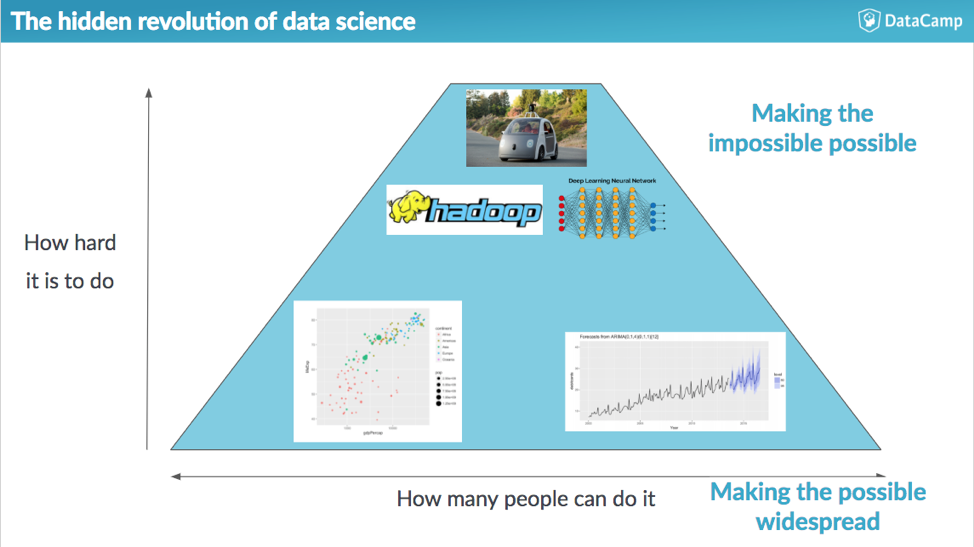
Immer mehr Menschen mit unterschiedlichen Hintergründen, in verschiedensten Abteilungen und Branchen, nutzen Data-Science-Tools und -Kompetenzen, um ihre Arbeit besser zu erledigen. Dazu gehören unter anderem
- Ein starkes Wachstum bei den Menschen, die Python und R zur Datenanalyse einsetzen
- Immer intuitivere Oberflächen für statistische Werkzeuge
- Fortschritte in der Statistik- und Programmierbildung
Die meisten dieser Entwicklungen basieren nicht auf völlig neuen statistischen Methoden oder KI-Ansätzen – so wie das Model T nicht das erste Auto war und die Boeing 747 nicht das erste Flugzeug. Spannend ist, wie viele Menschen davon profitieren können.
Was hat sich in der Data Science verändert?
Wachstum der Programmiersprachen für Data Science. In den letzten Jahren hat die Nutzung von Programmiersprachen für Data Science enorm zugenommen. Analysen im Stack-Overflow-Blog zeigen, dass Python gute Gründe hat, als die weltweit am schnellsten wachsende Programmiersprache zu gelten – vor allem dank seiner Tools für Data Science. Auch die Sprache R legt beeindruckend zu, besonders in Bereichen wie Wissenschaft, Gesundheitswesen, öffentlichem Sektor und Beratung.
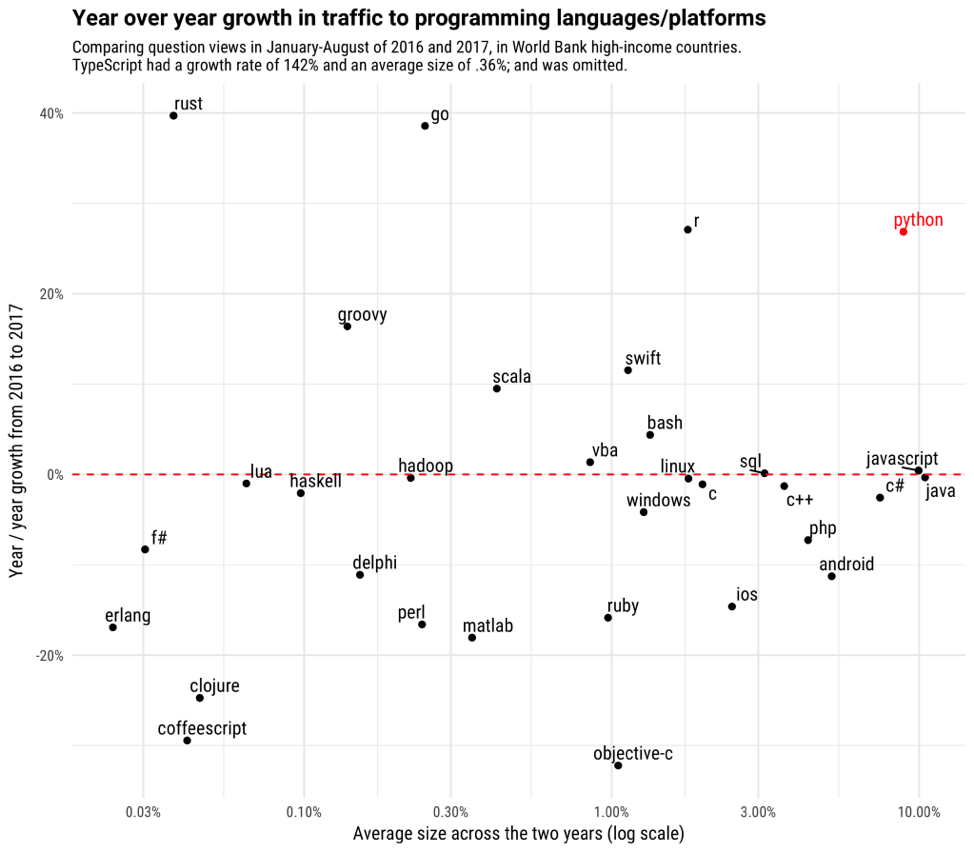 Source: Stack Overflow
Mehr Benutzerfreundlichkeit in Sprachen und Tools. Vieles dieses Wachstums beruht weniger auf neuen Methoden in Statistik, Machine Learning oder KI, sondern auf Verbesserungen, die bestehende Methoden nutzerfreundlicher machen. Ein prominentes Beispiel ist das pandas-Paket in Python, das Daten in einem Objekt namens DataFrame strukturiert und dadurch leistungsstarke, intuitive Analysen ermöglicht.
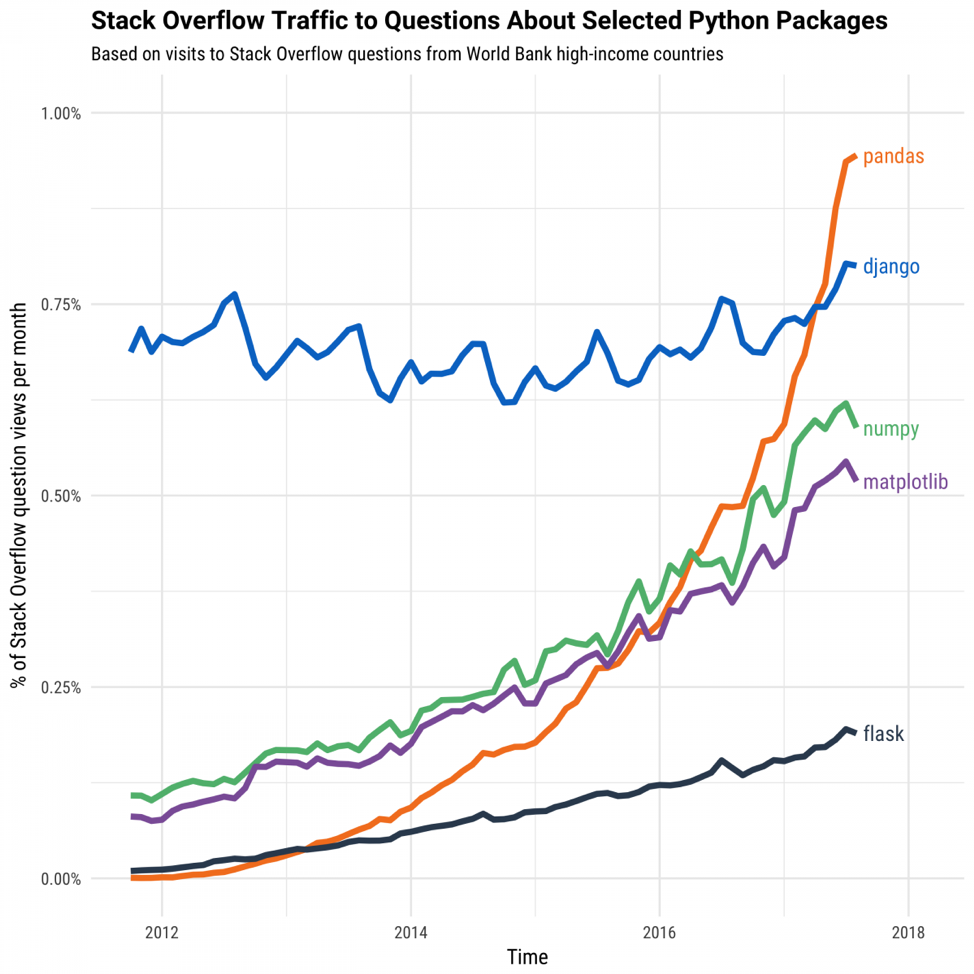 Source: Stack Overflow
Pandas zielt darauf ab, gängige Datentransformationen intuitiver zu machen. Wie pandas-Erfinder Wes McKinney in einem Interview mit Quartz erklärte: “Es ermöglicht Menschen, Daten zu analysieren und mit ihnen zu arbeiten, die keine ausgewiesenen Informatiker sind. Man muss zwar weiterhin Code schreiben, aber der Code wird intuitiver und zugänglicher. Das hilft Menschen, über Excel hinauszuwachsen.” Pandas ist das Rückgrat von DataCamps Data Scientist with Python track.
In der R-Welt sorgt der tidyverse für eine ähnlich spannende Benutzerfreundlichkeits-Revolution. Es handelt sich um eine Sammlung von Paketen, die Datenaufbereitung, Visualisierung und Modellierung vereinfachen. Wie ich selbst festgestellt habe, ist der tidyverse bemerkenswert intuitiv, um Einsteigerinnen und Einsteiger an Datenvisualisierung heranzuführen, und Analysen bestätigen, dass er zu den am schnellsten wachsenden Teilen des R-Ökosystems zählt.
Bessere Bildung. Das Wachstum in den Data-Science-Sprachen entsteht, weil neue Menschen zur Community stoßen – teils aus anderen Bereichen der Softwareentwicklung, teils aus ganz anderen Berufen. Ein Kern der Data-Science-Revolution liegt daher nicht nur in den Tools selbst, sondern auch darin, wie sie vermittelt werden.
Unsere interaktiven Data-Science-Kurse bei DataCamp haben Hunderttausende Menschen in Datenanalyse und -visualisierung eingeführt – darunter viele, die vorher nie programmiert haben. Eine flachere Lernkurve ist entscheidend, um Data Science breiter zugänglich zu machen.
Was bedeutet das für dein Unternehmen?
Wenn dich jemand fragt, ob ihr Data Science wirklich ausschöpft, musst du nicht sofort an Chatbots in eurem Produkt denken oder ein Budget für eine Beratung freigeben, die mit Deep Learning wirbt. Schau dir lieber an, wie Menschen in deinem Unternehmen Datenanalyse und Visualisierung bereits nutzen – und wo ihr das ausbauen könnt.
Es ist großartig, dass ein Labor bei Google mit KI ein selbstfahrendes Auto baut. Aber es ist ebenso spannend, wenn eine Marketingmanagerin mit R die Wirksamkeit ihrer Anzeigen visualisiert oder wenn das Finance-Team mit Python den zukünftigen Umsatz prognostiziert.
Wenn du besser verstehen möchtest, wie diese Data-Science-Revolution dein Unternehmen beeinflussen könnte, sieh dir unser Webinar Democratizing Data Science Within Your Company an.




