course
Praca z API OpenAI
3 godz.
172.6K
OpenAI ogłosiło swój najnowszy duży model językowy, GPT-4o, następcę GPT-4 Turbo. Czytaj dalej, aby poznać jego możliwości, wydajność i potencjalne zastosowania.
GPT-4o to najnowszy LLM od OpenAI. Litera „o” w GPT-4o oznacza „omni” — po łacinie „wszystko” — i odnosi się do faktu, że nowy model potrafi przyjmować polecenia stanowiące mieszankę tekstu, dźwięku, obrazów i wideo. Wcześniej interfejs ChatGPT używał osobnych modeli do różnych typów treści.
Na przykład podczas rozmowy z ChatGPT w trybie głosowym twoja mowa była zamieniana na tekst przez Whisper, odpowiedź tekstowa była generowana przez GPT-4 Turbo, a następnie zamieniana na mowę przez TTS.
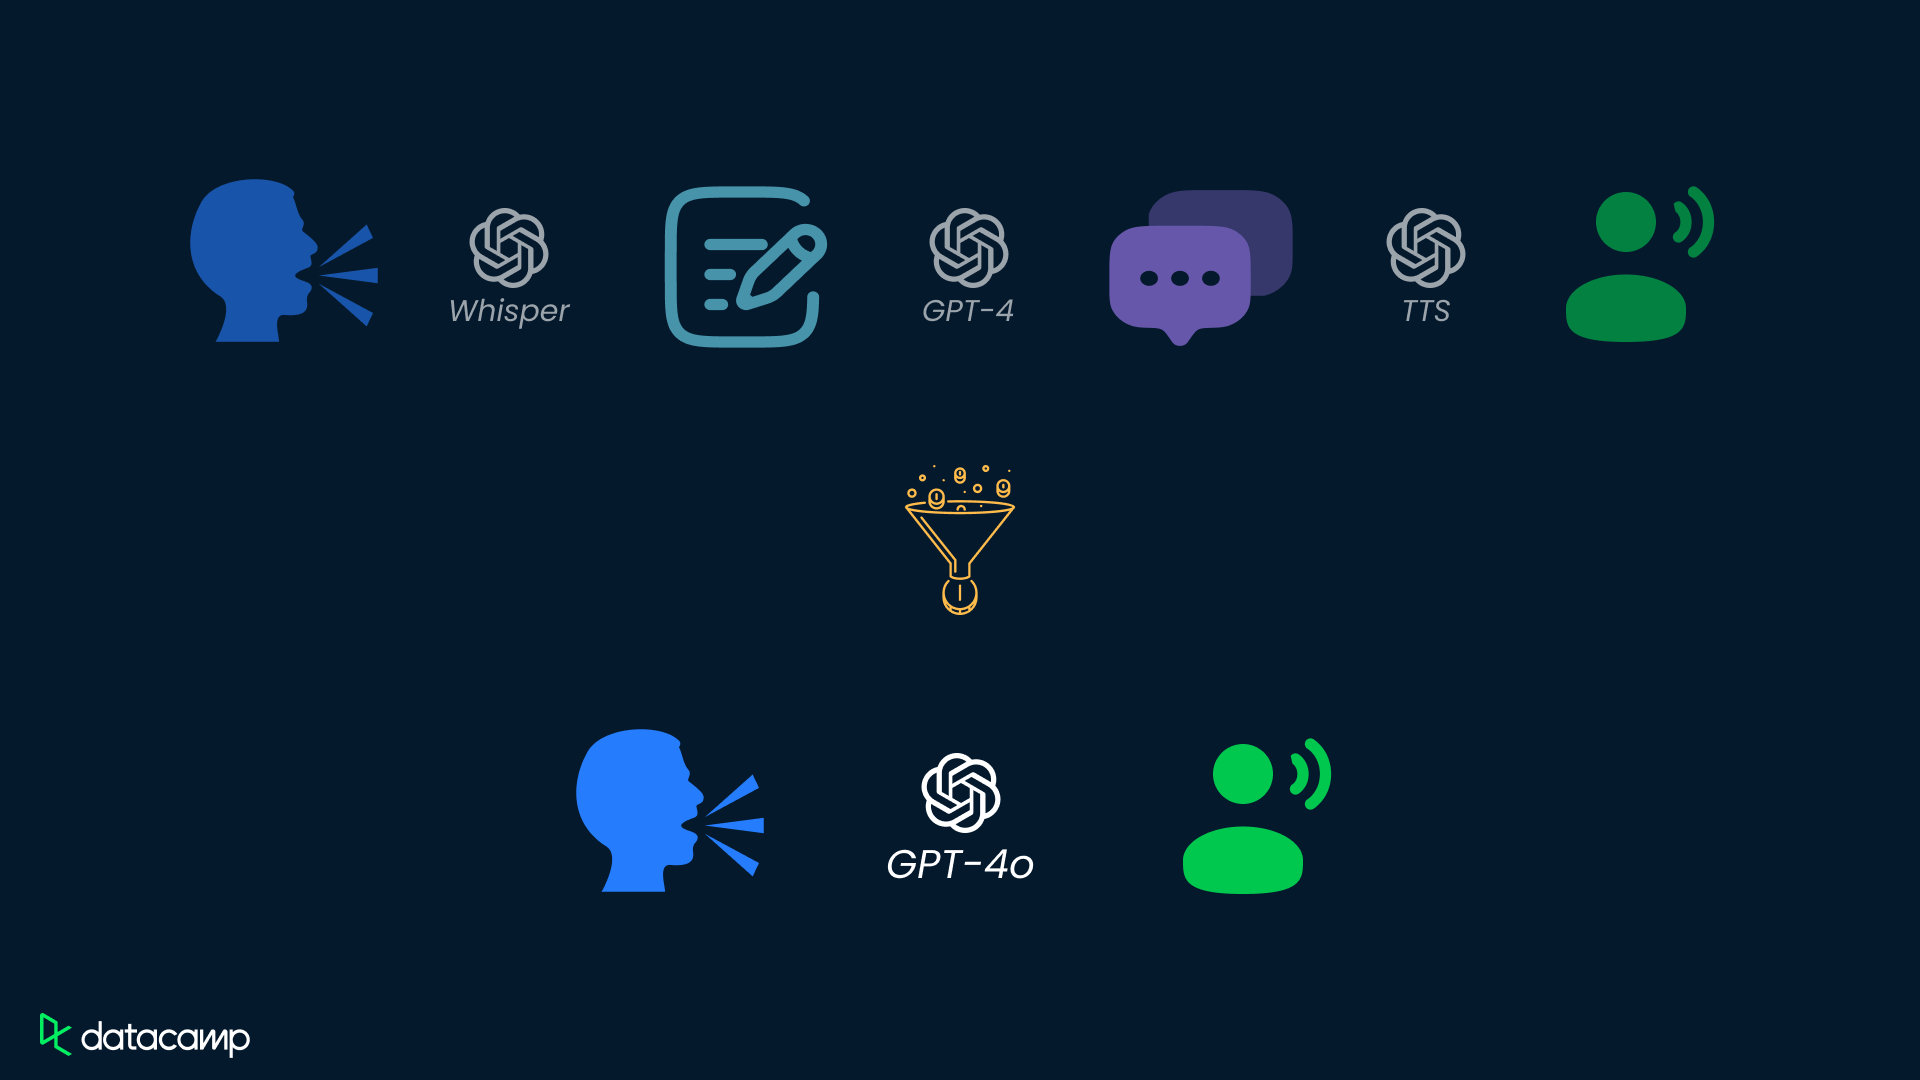
Porównanie sposobu, w jaki GPT-4 Turbo i GPT-4o przetwarzają wejście mowy
Podobnie, praca z obrazami w ChatGPT obejmowała połączenie GPT-4 Turbo i DALL-E 3.
Jeden model do różnych mediów treści obiecuje większą szybkość i jakość wyników, prostszy interfejs oraz nowe zastosowania.
GPT-4o Mini to lżejsza, szybsza wersja GPT-4o, zaprojektowana z myślą o zadaniach wymagających większego nacisku na szybkość i efektywność. Powstała z większego modelu GPT-4o w procesie zwanym destylacją.
Choć zachowuje sporą część możliwości oryginalnego modelu w zakresie przetwarzania danych multimodalnych — tekstu, dźwięku i obrazów — GPT-4o mini jest zoptymalizowany pod kątem lekkich aplikacji, w których kluczowy jest krótki czas reakcji.
Szczególnie przyda się deweloperom potrzebującym opłacalnego rozwiązania do kodowania, debugowania i interakcji w czasie rzeczywistym, które nie wymagają pełnej mocy obliczeniowej GPT-4o.
Więcej szczegółów znajdziesz w artykule o GPT-4o mini.
Podejście „wszystko w jednym” sprawia, że GPT-4o pokonuje kilka ograniczeń wcześniejszych możliwości interakcji głosowych.
W poprzednim systemie OpenAI łączącym w potoku Whisper, GPT-4 Turbo i TTS, silnik rozumowania, GPT-4, miał dostęp wyłącznie do wypowiedzianych słów. Oznaczało to, że takie elementy jak ton głosu, dźwięki w tle czy rozpoznawanie głosów wielu mówców były po prostu odrzucane. W efekcie GPT-4 Turbo nie bardzo potrafił wyrażać odpowiedzi z różnymi emocjami lub stylami mowy.
Dzięki jednemu modelowi potrafiącemu rozumować na podstawie tekstu i dźwięku, te bogate informacje audio można wykorzystać do udzielania wyższej jakości odpowiedzi z większą różnorodnością stylów wypowiedzi.
W poniższym przykładzie podanym przez OpenAI, GPT-4o generuje sarkastyczną wypowiedź.
Jednym z kroków w przepływie pracy LLM jest konwersja tekstu polecenia na tokeny. To jednostki tekstu, które model potrafi zrozumieć.
W języku angielskim token to zwykle jedno słowo lub znak interpunkcyjny, choć niektóre słowa mogą być rozbijane na wiele tokenów. Średnio trzy angielskie słowa zajmują około czterech tokenów.
Jeśli język można reprezentować w modelu mniejszą liczbą tokenów, trzeba wykonać mniej obliczeń, a szybkość generowania tekstu rośnie.
Dodatkowo, ponieważ OpenAI rozlicza swoje API per token wejściowy lub wyjściowy, mniej tokenów oznacza niższy koszt dla użytkowników API.
GPT-4o ma ulepszony model tokenizacji, który sprawia, że na tekst potrzeba mniej tokenów. Ulepszenie jest najbardziej zauważalne w językach nieużywających alfabetu łacińskiego.
Na przykład języki indyjskie szczególnie skorzystały — w hindi, marathi, tamilskim, telugu i gudżarati liczba tokenów spadła od 2,9 do 4,4 razy. W arabskim redukcja wyniosła 2x, a w językach wschodnioazjatyckich, takich jak chiński, japoński, koreański i wietnamski — między 1,4x a 1,7x.
Przy dotychczasowej strategii cenowej ChatGPT, użytkownicy musieli płacić za dostęp do najlepszego modelu: GPT-4 Turbo był dostępny tylko w płatnych planach Plus i Enterprise.
To się zmienia — OpenAI obiecuje udostępnić GPT-4o także w planie bezpłatnym. Użytkownicy Plus dostaną pięć razy więcej wiadomości niż użytkownicy darmowi.
Wdrożenie będzie stopniowe — dostęp dla red teamu (testerów próbujących „psuć” model, by znaleźć problemy) zaczyna się natychmiast, a kolejne grupy użytkowników będą uzyskiwać dostęp z czasem.
Choć nie jest to aktualizacja wyłącznie dla GPT-4o, OpenAI zapowiedziało także wydanie desktopowej aplikacji ChatGPT. Opisane wyżej usprawnienia w latencji i multimodalności, wraz z premierą aplikacji, oznaczają, że sposób pracy z ChatGPT prawdopodobnie się zmieni. Na przykład OpenAI pokazało demo rozszerzonego przepływu pracy programistycznej z użyciem głosu i aplikacji desktopowej ChatGPT. Przewiń w dół do sekcji zastosowań, by zobaczyć ten przykład w akcji!
Szczegóły działania GPT-4o są wciąż skąpe. Jedyna informacja podana przez OpenAI w ogłoszeniu to to, że GPT-4o jest pojedynczą siecią neuronową wytrenowaną na tekście, obrazie i dźwięku.
To nowe podejście różni się od wcześniejszej techniki, w której osobne modele były trenowane na różnych typach danych.
Nie jest to jednak pierwszy model podchodzący multimodalnie. W 2022 r. TenCent Lab stworzyło SkillNet, model łączący cechy transformera LLM z technikami wizyjnymi w celu lepszego rozpoznawania chińskich znaków.
W 2023 r. zespół z ETH Zurich, MIT i Stanfordu stworzył WhisBERT, wariant serii dużych modeli językowych BERT. Choć nie pierwszy, GPT-4o jest znacznie ambitniejszy i potężniejszy niż te wcześniejsze próby.
Skala zmian w architekturze GPT-4o względem GPT-4 Turbo zależy od tego, czy zapytasz inżynierów, czy marketing OpenAI. W kwietniu na Chatbot Arena LMSYS, tablicy liderów dla najlepszych generatywnych SI, pojawił się bot „im-also-a-good-gpt2-chatbot”. Ta tajemnicza SI okazała się GPT-4o.
Istotna jest część nazwy „gpt2”. Nie mylić z GPT-2, poprzednikiem GPT-3.5 i GPT-4 — sufiks „2” powszechnie uznano za oznaczający zupełnie nową architekturę serii GPT.
Najwyraźniej ktoś w zespole badawczo-inżynieryjnym OpenAI uznał, że połączenie tekstu, obrazu i dźwięku w jednym modelu to zmiana na tyle duża, by uzasadniać pierwszy od sześciu lat skok numeru wersji.
Z drugiej strony zespół marketingu pozostał przy dość zachowawczej zmianie nazwy, kontynuując konwencję „GPT-4”.
OpenAI opublikowało wyniki benchmarków GPT-4o na tle kilku innych topowych modeli.
Spośród nich dla porównania realnie liczą się trzy modele. GPT-4 Turbo, Claude 3 Opus i Gemini Pro 1.5 przez ostatnie miesiące rywalizowały o czołowe miejsca na liście LMSYS Chatbot Arena.
Llama 3 400B może być w przyszłości konkurentem, ale jeszcze nie jest gotowa. Dlatego tutaj prezentujemy wyniki tylko dla tych trzech modeli i GPT-4o.
Wykorzystano wyniki sześciu benchmarków.
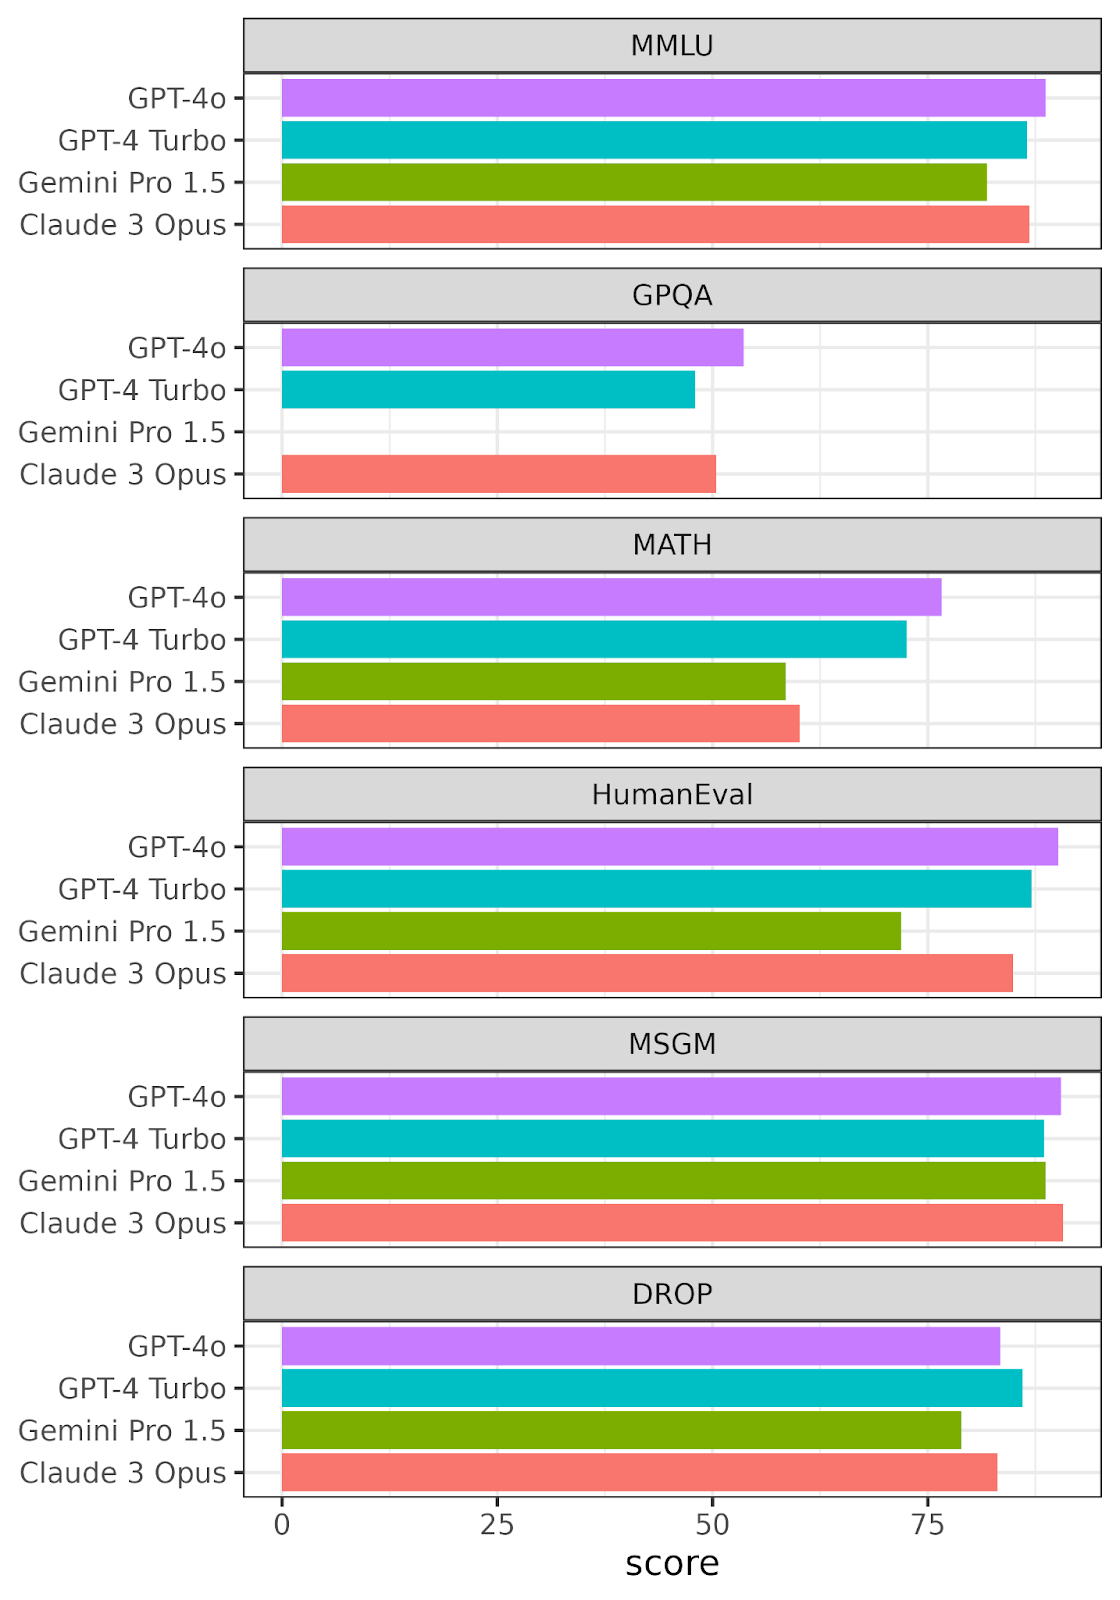
Wyniki GPT-4o, GPT-4 Turbo, Gemini Pro 1.5 i Claude 3 Opus w sześciu benchmarkach LLM. Wyniki każdego benchmarku mieszczą się w przedziale 0–100. Odtworzone na podstawie danych od OpenAI. Dla Gemini Pro 1.5 nie podano danych w benchmarku GPQA.
GPT-4o zdobywa najwyższy wynik w czterech benchmarkach, choć w MSGM przegrywa z Claude 3 Opus, a w DROP — z GPT-4 Turbo. Ogólnie rzecz biorąc, to imponująca wydajność i obiecujący sygnał dla nowego podejścia do treningu multimodalnego.
Jeśli przyjrzysz się uważnie liczbom GPT-4o względem GPT-4 Turbo, zobaczysz, że wzrosty to tylko kilka punktów procentowych.
To imponujący skok rok do roku, ale daleki od dramatycznych przeskoków z czasów GPT-1 → GPT-2 czy GPT-2 → GPT-3.
Bycie o 10% lepszym w rozumowaniu tekstu rok do roku to prawdopodobnie nowa norma. Nisko wiszące owoce już zebrano i trudno kontynuować duże skoki w rozumowaniu tekstu.
Z drugiej strony te benchmarki LLM nie oddają wydajności SI w problemach multimodalnych. Koncepcja jest na tyle nowa, że nie mamy jeszcze dobrych metod pomiaru jakości modelu w tekście, dźwięku i wizji łącznie.
Podsumowując, wydajność GPT-4o jest imponująca i dobrze rokuje dla nowego podejścia do treningu multimodalnego.
Nowsze modele GPT i ich pochodne, jak GitHub Copilot, już potrafią pomagać w kodowaniu — pisać kod oraz wyjaśniać i naprawiać błędy. Multimodalne możliwości GPT-4o otwierają ciekawe możliwości.
W filmie promocyjnym prowadzonym przez CTO OpenAI Mirę Murati dwaj badacze OpenAI, Mark Chen i Barret Zoph, pokazali pracę z kodem w Pythonie przy użyciu GPT-4o.
Kod jest przekazywany GPT jako tekst, a funkcja interakcji głosowej służy do poproszenia GPT o wyjaśnienie kodu. Później, po uruchomieniu kodu, funkcja wizji GPT-4o jest użyta do wyjaśnienia wykresu.
Ogólnie rzecz biorąc, pokazanie ChatGPT swojego ekranu i zadanie pytania głosem może być prostszym przepływem pracy niż zapisywanie wykresu do pliku graficznego, przesyłanie go do ChatGPT, a potem wpisywanie pytania.
Zdolność GPT-4o do rozumienia wideo z kamery i słownego opisywania sceny może być funkcją niezbędną dla osób słabowidzących. To w zasadzie odpowiednik funkcji audiodeskrypcji z telewizorów — tyle że w prawdziwym życiu.
Mam dostęp do części nowych funkcji GPT-4o od niedługo po ogłoszeniu (niestety, jeszcze bez czatu głosowego) i wiele odpowiedzi zrobiło na mnie wrażenie. Reakcje wydają się szybsze i bardziej spójne, a model lepiej rozumie moje prośby niż wcześniej. To nie znaczy, że jest idealny.
Oto kilka przykładów moich interakcji z ChatGPT-4o:
Najpierw, używając czatu głosowego, zapytałem, czy ma pomysły, jak analizować występy drużyny piłkarskiej, której kibicuję — potężnego Leeds United. Oprócz kilku opcji, podał przykładowy kod w Pythonie:
import pandas as pd

# Sample data for Leeds United's match results
data = {
    'Match': ['Match1', 'Match2', 'Match3', 'Match4', 'Match5'],
    'Result': ['Win', 'Draw', 'Loss', 'Win', 'Win'],
    'Goals Scored': [2, 1, 0, 3, 2]
}

# Create a DataFrame
df = pd.DataFrame(data)

# Summarize match results
summary = df['Result'].value_counts()
total_goals = df['Goals Scored'].sum()
average_goals = df['Goals Scored'].mean()

# Display summary
print("Match Results Summary:")
print(summary)
print("\nTotal Goals Scored:", total_goals)
print("Average Goals Per Match:", round(average_goals, 2))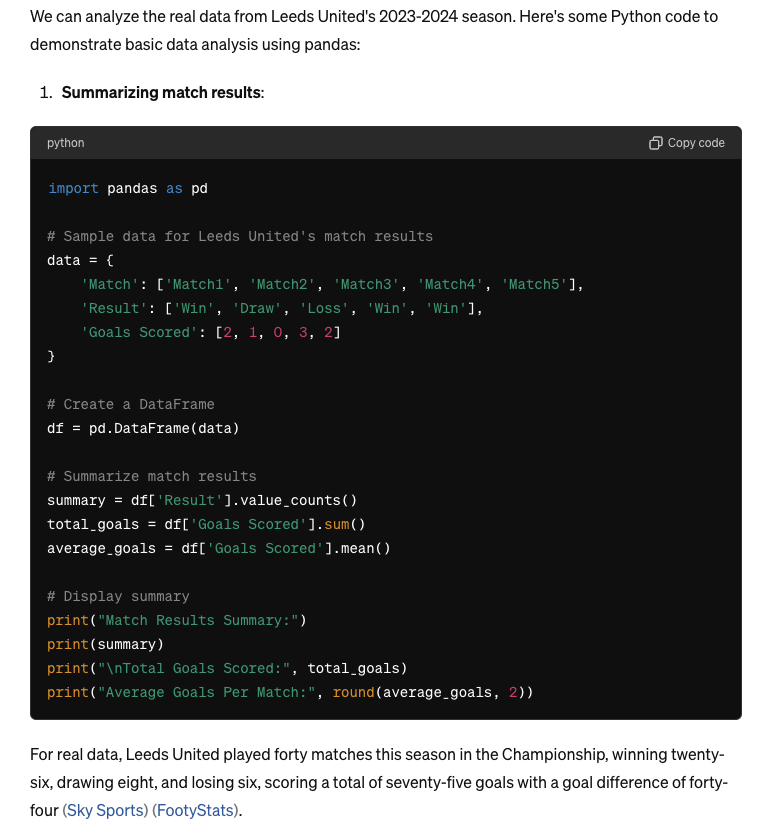
Jednak gdy dopytałem o ten wątek, zaczęły się drobne problemy. Najpierw poprosiłem o prawdziwe dane do użycia — przeszukał sieć i znalazł dwa dobre źródła, ale błędnie zrelacjonował statystyki. Leeds rozegrało 46 meczów w sezonie zasadniczym, strzelając 81 bramek i mając bilans +38, a nie 40 meczów, jak podał.
Potem poprosiłem ChatGPT o wizualizację goli strzelonych przeciwko każdej drużynie:
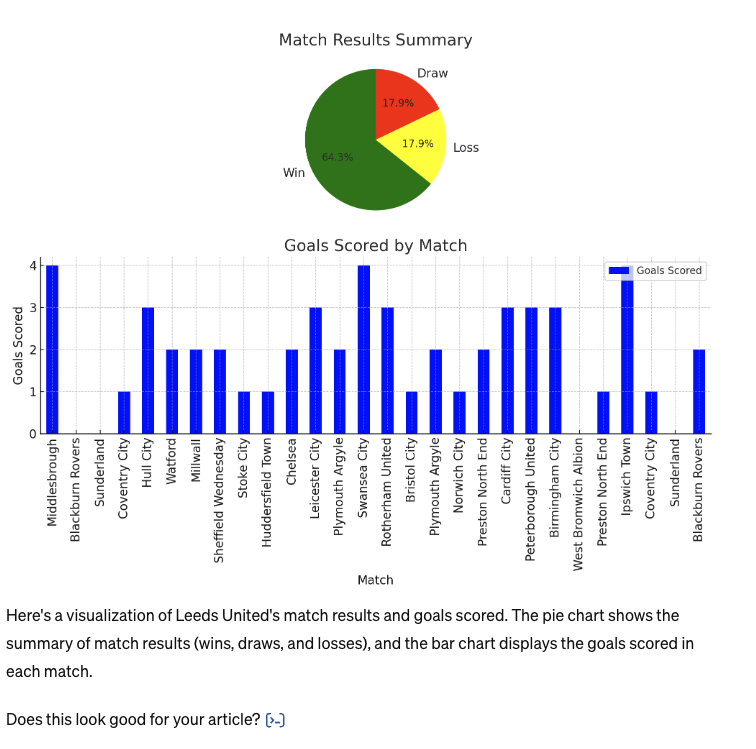
Znów zadanie wykonane połowicznie. Stworzył wizualizację zgodnie z prośbą i na pierwszy rzut oka wygląda ok. W rzeczywistości jednak dużo danych jest zmyślonych i niedokładnych (powtarzające się zespoły, brak zliczonych bramek, drużyny spoza tej samej ligi co Leeds).
Uczciwie mówiąc, pewnie byłoby lepiej, gdybym sam dostarczył pełny zbiór danych, ale wolałbym, żeby to powiedział, zamiast pewnym tonem zmyślać odpowiedzi.
Następnie poprosiłem GPT-4o o analizę zdjęcia jednej z moich roślin. Nadal nie mam dostępu do zintegrowanej wizji, więc musiałem zrobić zdjęcie i zapytać ChatGPT, co to za roślina:
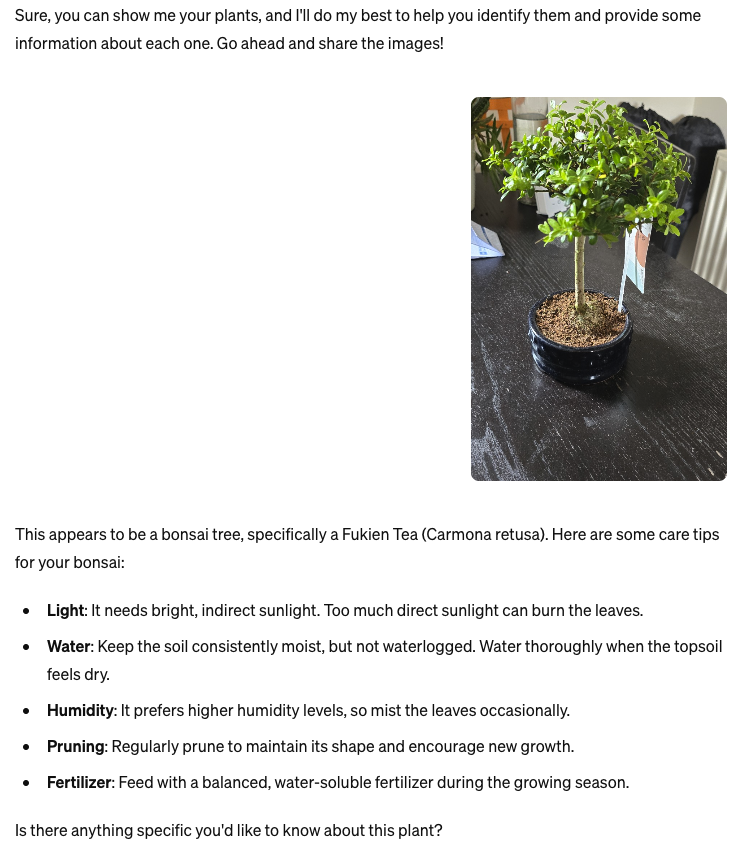
To niezły wynik, choć nie do końca trafny. To co prawda bonsai, ale Ilex crenata, a nie Carmona retusa. Obie wyglądają jednak dość podobnie, więc łatwo o pomyłkę, a doceniłem dodatkowy kontekst o pielęgnacji.
Na koniec chciałem sprawdzić możliwości obrazowe nowego modelu. Najpierw pokazałem mu zdjęcie mojego żółwia, Darwina, i poprosiłem, by opowiedział mi o moim przyjacielu:
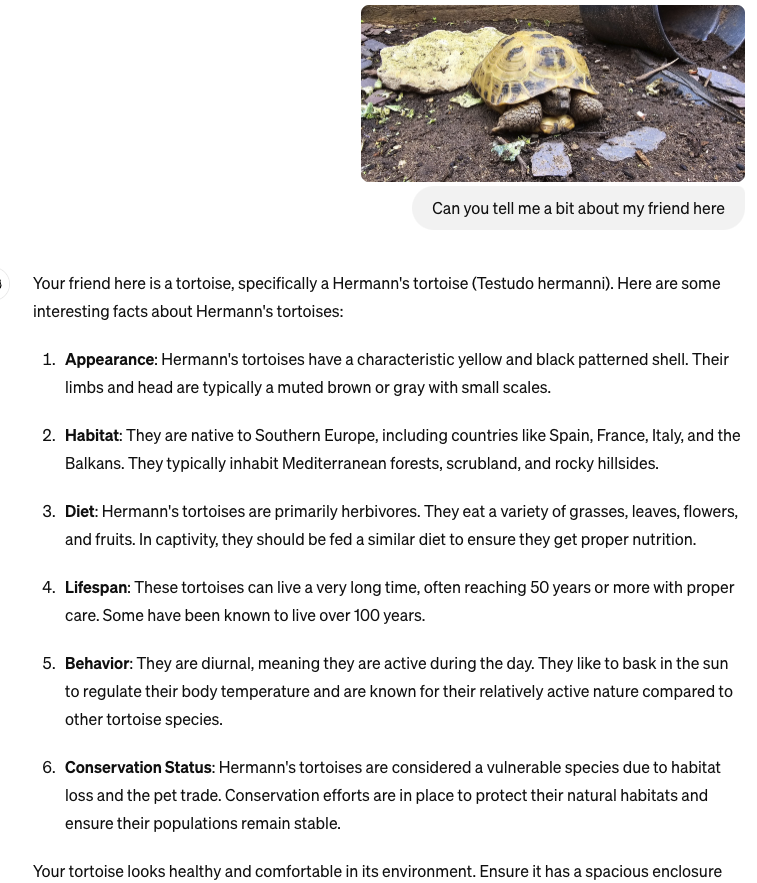
Znów blisko, ale nie idealnie. Darwin to w rzeczywistości żółw stepowy (Horsefield), a nie żółw grecki (Hermann), ale są do siebie bardzo podobne. Potem poprosiłem ChatGPT-4o, by wziął oryginalny obraz i odtworzył go w stylu Hokusai. Oto wynik:
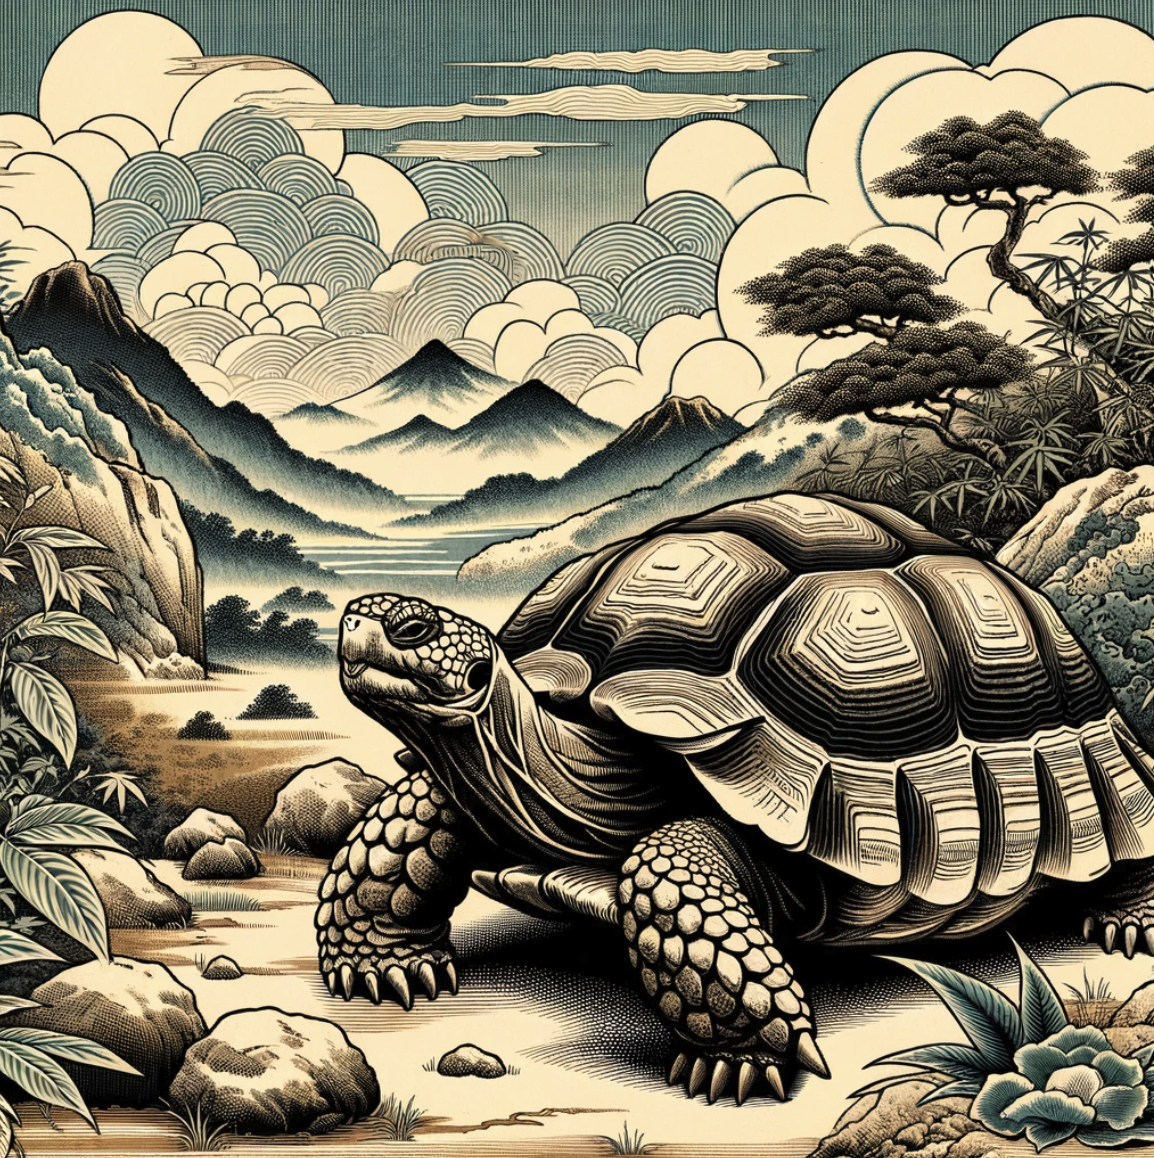
Całkiem dobra próba, choć do oryginału niewiele podobny — ale to w sumie zrozumiałe. Wygenerowanie też chwilę zajęło.
Ogólnie byłem jednak pod wrażeniem responsywności nowego modelu i tego, jak dobrze rozumiał moje prośby. Do ideału daleko i czasem z przekonaniem halucynuje, ale nie mogę się doczekać pracy z ulepszoną mową i zintegrowaną wizją.
Regulacje dla generatywnej SI są wciąż na wczesnym etapie; AI Act UE to jak dotąd jedyny godny uwagi framework prawny. To oznacza, że firmy tworzące SI muszą same podejmować część decyzji, co stanowi bezpieczną SI.
OpenAI ma ramy gotowości, których używa do oceny, czy nowy model nadaje się do publicznego wydania.
Ramy testują cztery obszary obaw.
Każdy obszar obaw jest oceniany jako Niski, Średni, Wysoki lub Krytyczny, a wynik modelu to najwyższa z ocen w czterech kategoriach.
OpenAI obiecuje nie wydawać modelu o krytycznym poziomie obaw, choć to względnie nisko ustawiona poprzeczka bezpieczeństwa: w ich definicji „krytyczny” odpowiada czemuś, co wywróciłoby ludzką cywilizację do góry nogami. GPT-4o spokojnie tego unika, uzyskując poziom Średni.
Jak w przypadku wszystkich generatywnych SI, model nie zawsze zachowuje się zgodnie z intencją. Wizja komputerowa nie jest idealna, więc interpretacje obrazów czy wideo nie są gwarantowane.
Podobnie transkrypcje mowy rzadko są w 100% poprawne, zwłaszcza gdy mówca ma silny akcent lub używa specjalistycznego słownictwa.
OpenAI udostępniło wideo z wpadkami, gdzie GPT-4o nie zadziałał zgodnie z oczekiwaniami.
W szczególności porażką okazało się tłumaczenie między dwoma językami nieangielskimi. Inne problemy obejmowały nieodpowiedni ton (protekcjonalny) i mówienie w niewłaściwym języku.
Naucz się budować narzędzia AI z OpenAI już dziś!
course
course
course