Courses
OpenAI APIを使いこなす
3時間
169.2K
OpenAI は 最新の大規模言語モデル GPT-4o を発表しました。GPT-4 Turbo の後継となるこのモデルの機能や性能、活用方法を見ていきましょう。
GPT-4o は OpenAI の最新 LLM です。名称の "o" はラテン語で「すべて」を意味する "omni" に由来し、テキスト・音声・画像・動画を組み合わせたプロンプトを受け付けられる点を指します。以前の ChatGPT インターフェースでは、コンテンツの種類ごとに別々のモデルを使用していました。
例えば、音声モードで ChatGPT に話しかけると、音声は Whisper でテキストに変換され、GPT-4 Turbo でテキスト応答が生成され、そのテキストを TTS で音声に変換していました。
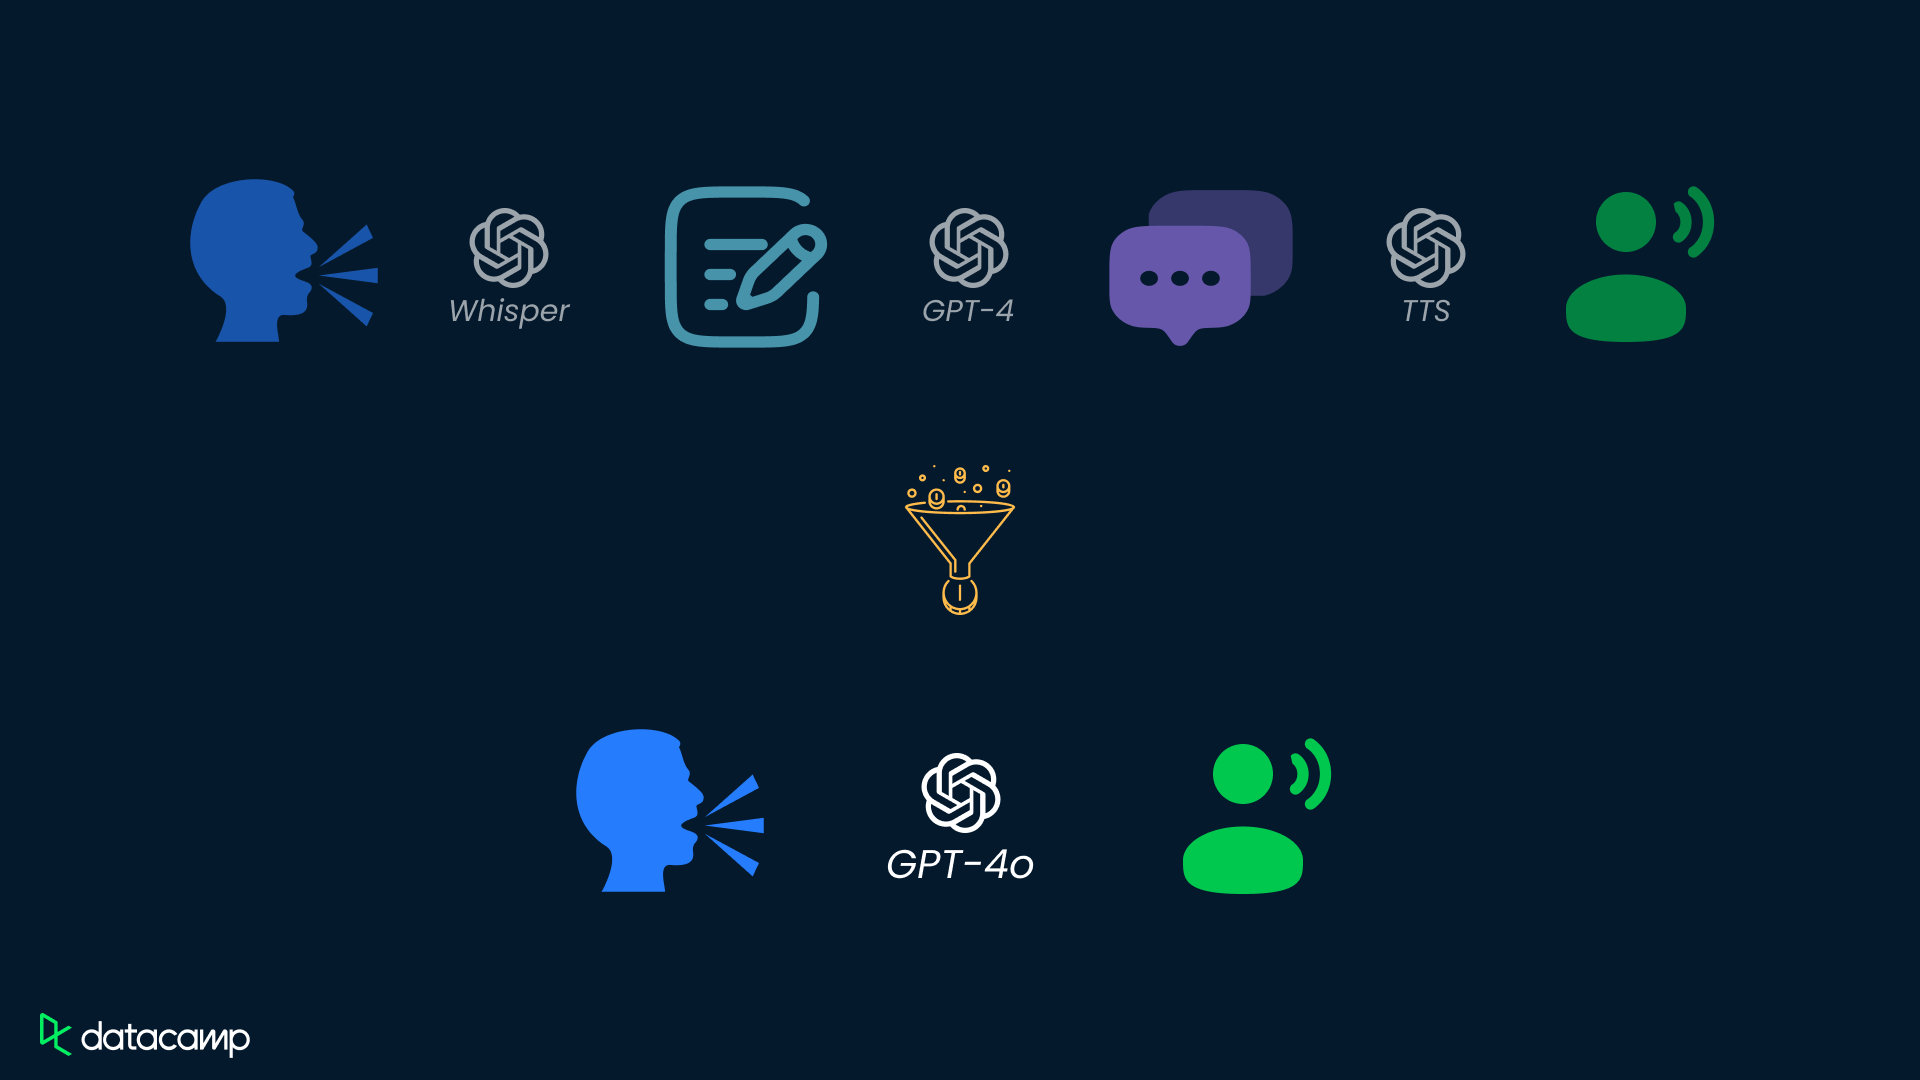
音声入力の処理における GPT-4 Turbo と GPT-4o の比較
同様に、ChatGPT で画像を扱う場合は、GPT-4 Turbo と DALL-E 3 を組み合わせていました。
コンテンツの種類を一つのモデルで扱えるようになったことで、結果のスピードと品質の向上、インターフェースの簡素化、新たなユースケースの創出が期待されます。
GPT-4o Mini は、GPT-4o をスリム化して高速化したバージョンで、スピードと効率を重視するタスクに適しています。これは 蒸留 と呼ばれるプロセスにより、より大きな GPT-4o モデルから派生しています。
テキスト・音声・画像といったマルチモーダル入力の処理能力の多くを維持しつつ、応答速度が重要な軽量アプリケーション向けに最適化されています。
GPT-4o の計算能力をフルに必要としないリアルタイム対話や、コーディング・デバッグなどにコスト効率の高い選択肢として、特に開発者に有用です。
GPT-4o mini に関する詳細は、こちらの記事をご覧ください。
オールインワンのモデル設計により、従来の音声対話機能のいくつかの制約を克服しています。
従来の Whisper、GPT-4 Turbo、TTS を連携させる方式では、推論エンジンである GPT-4 は発話内容の文字情報にしかアクセスできませんでした。このため、声のトーン、背景音、複数話者の識別といった情報は捨てられ、GPT-4 Turbo は感情や話し方のスタイルを多様に表現することが難しかったのです。
テキストと音声の両方を単一のモデルで推論できるようになったことで、豊富な音声情報を活用し、より高品質かつ多様な話し方で応答できるようになりました。
以下の OpenAI 提供の例では、GPT-4o が皮肉を込めた出力を返しています。
LLM のワークフローの一段階として、プロンプトのテキストをトークンに変換します。これはモデルが理解できるテキストの単位です。
英語では、トークンは一般に 1 語または句読点 1 つを表しますが、語が複数のトークンに分割されることもあります。平均すると、英語 3 語で約 4 トークンを要します。
より少ないトークンで言語を表現できれば、必要な計算量が減り、テキスト生成の速度が上がります。
さらに、OpenAI の API 料金は入力・出力トークン数に応じて課金されるため、トークンが少なければ API 利用者の費用も低くなります。
GPT-4o は改良されたトークナイゼーションにより、同じテキストでも必要なトークン数が減ります。特に、ローマ字を使わない言語で改善が顕著です。
例えば、インド諸語ではヒンディー語、マラーティー語、タミル語、テルグ語、グジャラート語で 2.9~4.4 倍のトークン削減が見られました。アラビア語は 2 倍、東アジアの中国語・日本語・韓国語・ベトナム語では 1.4~1.7 倍の削減でした。
ChatGPT の既存の価格戦略では、最上位モデルにアクセスするには有料契約が必要でした。GPT-4 Turbo は Plus と Enterprise の有料プランでのみ提供されていました。
これが変わり、OpenAI は GPT-4o を無料プランでも提供すると約束しています。Plus ユーザーは無料プランのユーザーより 5 倍多くのメッセージを送信できます。
展開は段階的に行われ、まずは レッドチーム(問題発見のためにモデルを壊そうとするテスター)へのアクセスが開始され、その後、順次ユーザーに開放されます。
これは必ずしも GPT-4o 限定の更新ではありませんが、OpenAI は ChatGPT のデスクトップアプリの提供も発表しました。前述のレイテンシとマルチモーダル性の改善に加え、アプリのリリースにより、ChatGPT との付き合い方は変わる可能性があります。例えば、OpenAI は音声と ChatGPT デスクトップアプリを組み合わせた拡張コーディングのワークフローのデモを示しました。ユースケースのセクションまでスクロールして、その例をご覧ください。
GPT-4o の仕組みの詳細はまだ多くが明らかにされていません。OpenAI の発表で唯一示されたのは、GPT-4o がテキスト・ビジョン・音声入力で訓練された単一の ニューラルネットワークであるという点です。
これは、データタイプごとに別々のモデルを訓練する従来の手法とは異なるアプローチです。
ただし、マルチモーダル手法自体は GPT-4o が初ではありません。2022 年には、TenCent Lab が SkillNet を開発し、LLM のトランスフォーマ構造にコンピュータビジョン技術を組み合わせて漢字認識を強化しました。
2023 年には、ETH チューリッヒ、MIT、スタンフォード大学のチームが BERT 系 LLM の変種である WhisBERT を発表しました。先行例はあるものの、GPT-4o はこれらよりもはるかに野心的で強力です。
GPT-4o のアーキテクチャが GPT-4 Turbo と比べてどれほど抜本的なのかは、OpenAI のエンジニアリングチームとマーケティングチームのどちらに尋ねるかで変わるでしょう。4 月、LMSYS の Chatbot Arena(生成 AI のランキング)に「im-also-a-good-gpt2-chatbot」というボットが現れました。この正体不明の AI は現在、GPT-4o であることが明らかになっています。
名前の「gpt2」の部分が重要です。GPT-3.5 や GPT-4 の前身である GPT-2 と混同しないでください。この「2」という接尾辞は、GPT シリーズにおける完全に新しいアーキテクチャを意味する、という見方が広くなされました。
OpenAI の研究・開発チームの誰かは、テキスト・ビジョン・音声のコンテンツタイプを単一モデルに統合したことが、6 年ぶりにバージョン番号を 1 つ繰り上げるのに十分な変化だと考えているようです。
一方で、マーケティングチームは「GPT-4」という命名規則を継続し、比較的控えめな名称変更にとどめています。
OpenAI は、GPT-4o と他のいくつかの高性能モデルを比較したベンチマーク結果を公開しました。
このうち比較で本当に重要なのは 3 つです。GPT-4 Turbo、Claude 3 Opus、そして Gemini Pro 1.5 は、ここ数カ月 LMSYS Chatbot Arena のトップを争ってきました。
Llama 3 400B は将来的に有力候補になるかもしれませんが、まだ未完成です。したがって、ここではこれら 3 モデルと GPT-4o の結果のみを示します。
6 つのベンチマーク結果を使用しました。
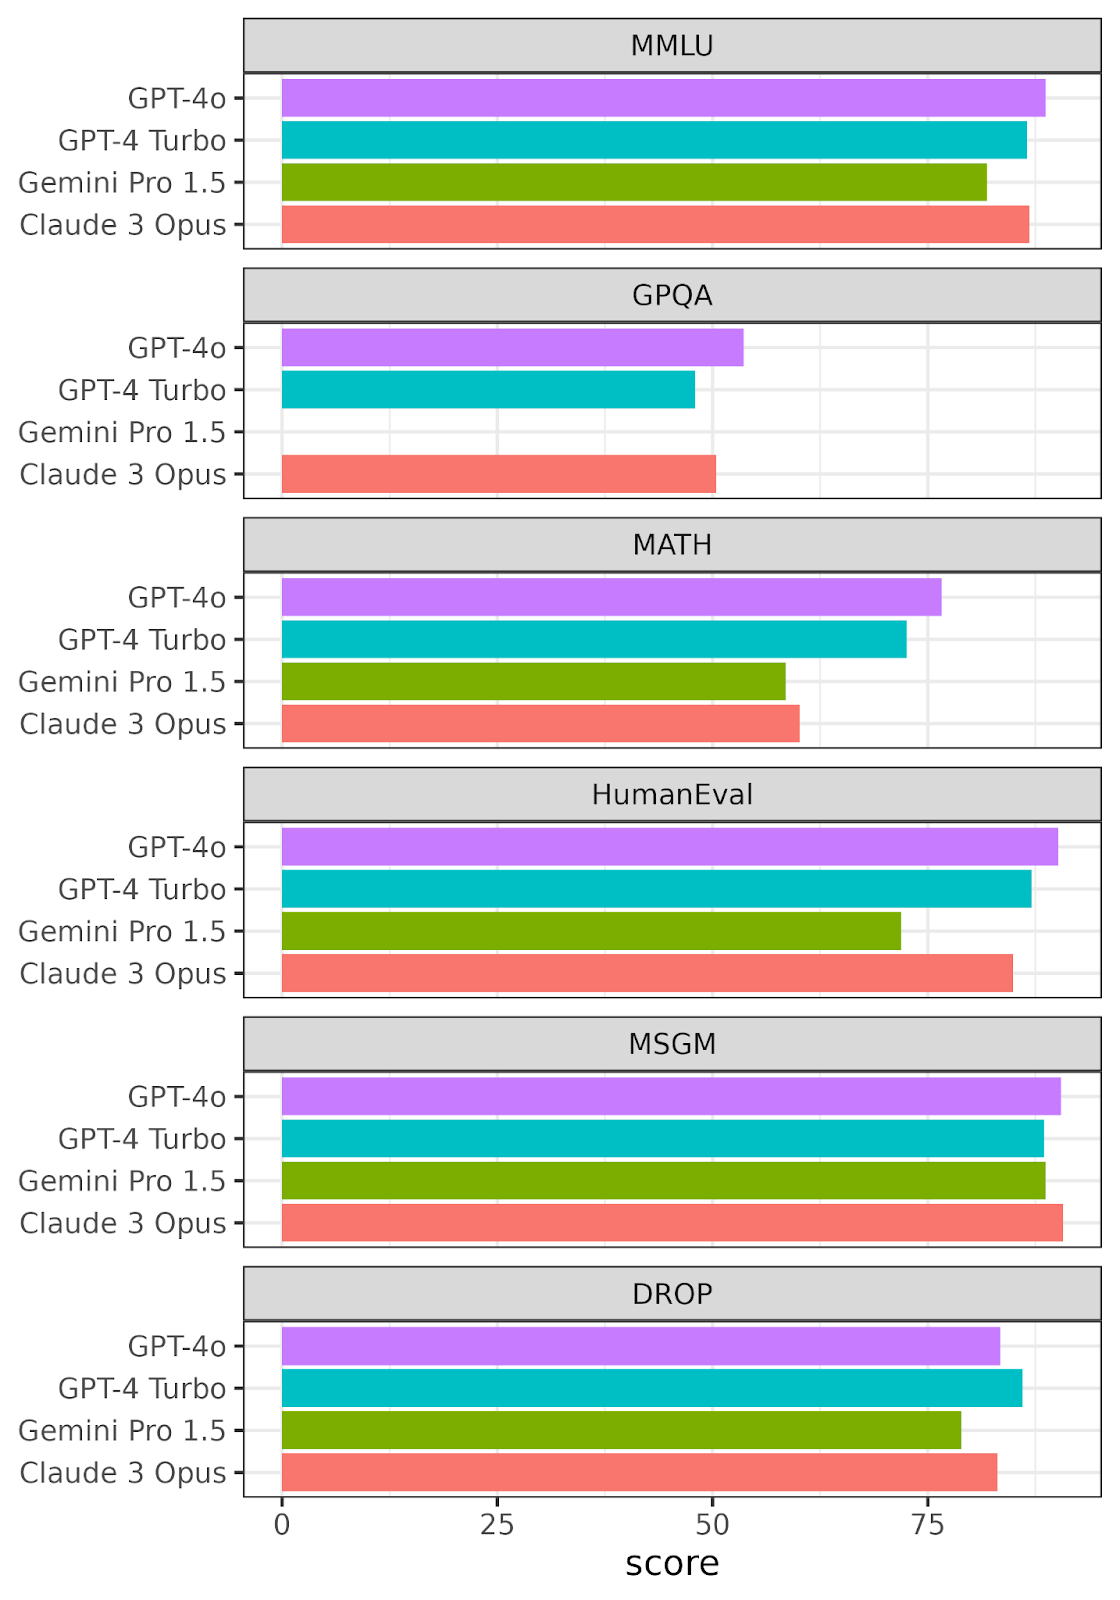
GPT-4o、GPT-4 Turbo、Gemini Pro 1.5、Claude 3 Opus の 6 つの LLM ベンチマークに対する性能。各ベンチマークのスコアは 0~100。OpenAI 提供データを基に再作成。GPQA の Gemini Pro 1.5 のデータは提供なし。
GPT-4o は 6 つのうち 4 つのベンチマークで最高スコアを獲得しましたが、MSGM では Claude 3 Opus、DROP では GPT-4 Turbo に及びませんでした。総じて、このパフォーマンスは印象的で、マルチモーダル学習という新手法の有望さを示しています。
GPT-4 Turbo と比べた GPT-4o の数値をよく見ると、性能向上は数ポイントにとどまっています。
1 年での伸びとしては立派ですが、GPT-1→GPT-2、GPT-2→GPT-3 のような劇的な飛躍ではありません。
テキスト推論が年率 10% 良くなる程度が新たな常態になる可能性があります。取り組みやすい改善は出尽くし、テキスト推論で大きく飛躍し続けるのは難しいのです。
一方で、これらの LLM ベンチマークはマルチモーダル課題での性能を捉えていません。この概念はまだ新しく、テキスト・音声・ビジョンを横断したモデルの良し悪しを測る良い手段がありません。
総合的に見て、GPT-4o の性能は印象的で、マルチモーダル学習という新たなアプローチの将来性を示しています。
GitHub Copilot のような派生ツールを含め、近年の GPT モデルはコードの記述、説明、エラー修正などの支援が可能です。GPT-4o のマルチモーダル機能により、興味深い可能性が広がります。
OpenAI の CTO である Mira Murati 氏が司会を務めるプロモーション動画で、OpenAI の研究者 Mark Chen 氏と Barret Zoph 氏が、GPT-4o を用いた Python コードの操作をデモしました。
コードはテキストとして GPT と共有し、音声対話機能でコードの説明を依頼します。後にコードを実行した後、GPT-4o のビジョン機能を使ってプロットの説明を行いました。
全体として、画面を見せて口頭で質問できるワークフローは、プロットを画像ファイルに保存してアップロードし、質問をタイプするよりもシンプルになり得ます。
カメラからの動画入力を理解し、音声で状況を説明できる GPT-4o は、視覚障がい者にとって必須の機能になり得ます。テレビの音声ガイド機能を、実世界で実現するようなものです。
発表直後から GPT-4o の新機能の一部(残念ながら音声チャットは未体験)にアクセスできていますが、多くの出力に感心しています。応答は速く安定し、以前より依頼の意図をよく理解している印象です。とはいえ、完璧というわけではありません。
以下は、ChatGPT-4o とのやり取りの例です。
まず音声チャットで、私が応援するサッカーチーム、リーズ・ユナイテッドのパフォーマンス分析のアイデアを尋ねました。いくつかの選択肢に加え、以下の Python のサンプルコードも提示してくれました。
import pandas as pd

# Sample data for Leeds United's match results
data = {
    'Match': ['Match1', 'Match2', 'Match3', 'Match4', 'Match5'],
    'Result': ['Win', 'Draw', 'Loss', 'Win', 'Win'],
    'Goals Scored': [2, 1, 0, 3, 2]
}

# Create a DataFrame
df = pd.DataFrame(data)

# Summarize match results
summary = df['Result'].value_counts()
total_goals = df['Goals Scored'].sum()
average_goals = df['Goals Scored'].mean()

# Display summary
print("Match Results Summary:")
print(summary)
print("\nTotal Goals Scored:", total_goals)
print("Average Goals Per Match:", round(average_goals, 2))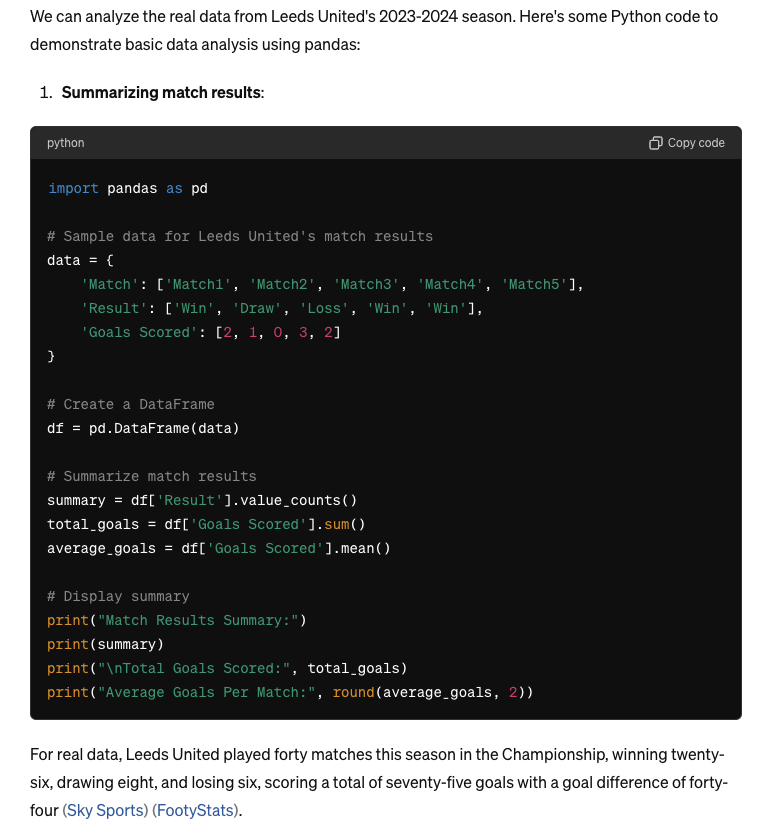
しかし、この方向性をさらに掘り下げると、少しずれていきました。実データの利用を求めると、ウェブ検索で 2 つの良い情報源を見つけましたが、統計値の報告を誤っていました。リーグ戦は 46 試合で、得点 81、得失点差 +38 が正しいところ、回答では 40 試合と記載されていました。
次に、各対戦相手に対する得点を可視化するよう依頼しました。
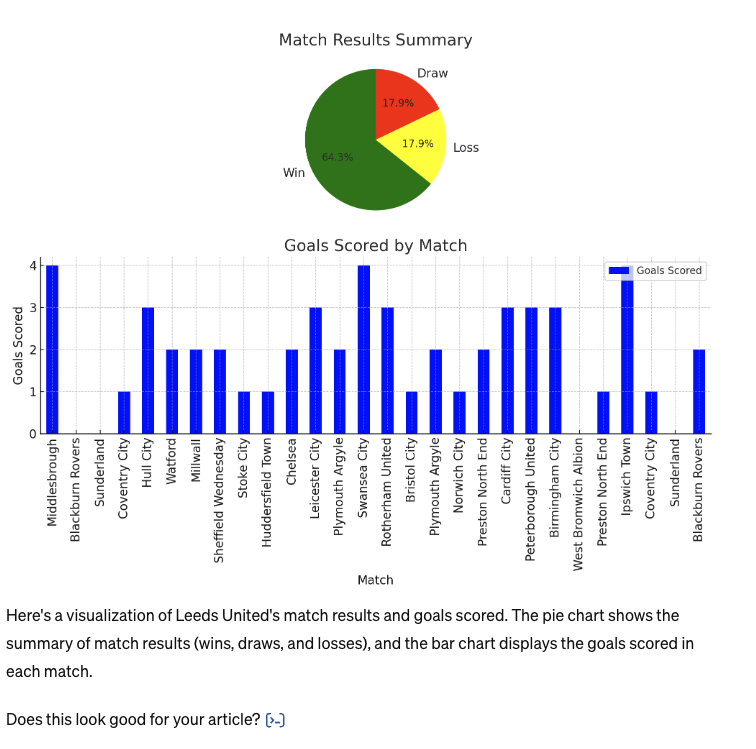
ここでも、半分は達成しています。依頼どおり可視化は作成され、見た目は問題なさそうです。しかし実際には多くのデータが作り物で不正確です(同一チームの重複、得点のカウント漏れ、同じディビジョンにいないチームの混在など)。
公正を期すなら、こちらで完全なデータセットを用意していれば結果は良かったかもしれませんが、自信満々に作り話をするのではなく、その旨を伝えてほしいところです。
次に、手持ちの植物の写真を解析するよう依頼しました。統合ビジョン機能はまだ使えないため、写真を撮って「これは何の植物か」と尋ねました。
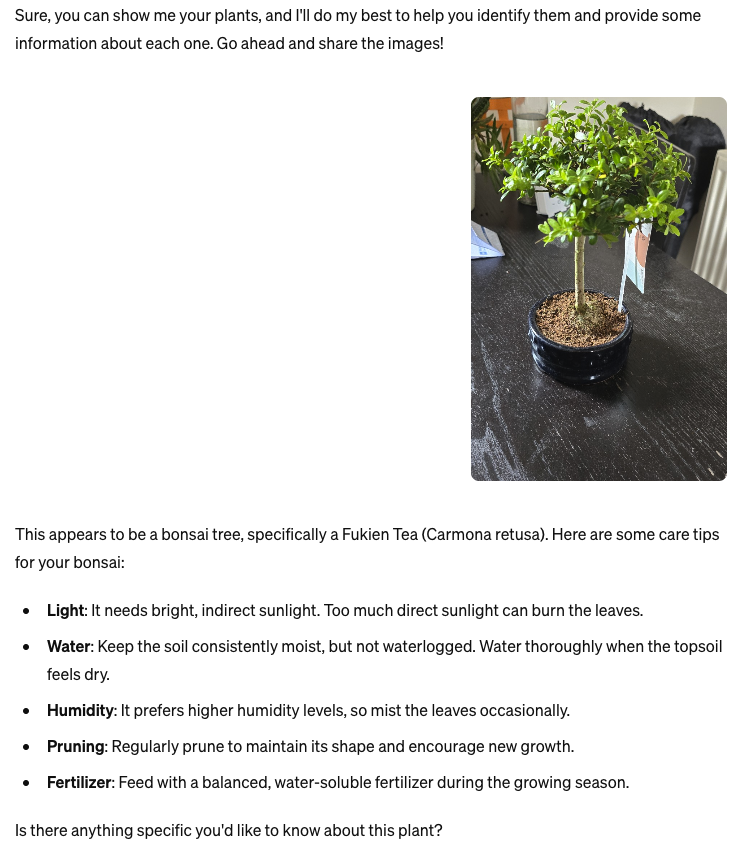
悪くない推定ですが、厳密には正しくありません。盆栽であることは確かですが、正しくはカガミモチノキ(Ilex crenata)で、カガミノキ(Carmona retusa)ではありません。とはいえ両者はよく似ており、手入れ方法の追加情報は有用でした。
最後に、新モデルの画像機能を試してみました。まず、私のリクガメ「ダーウィン」の写真を見せ、「友人について教えて」と尋ねました。
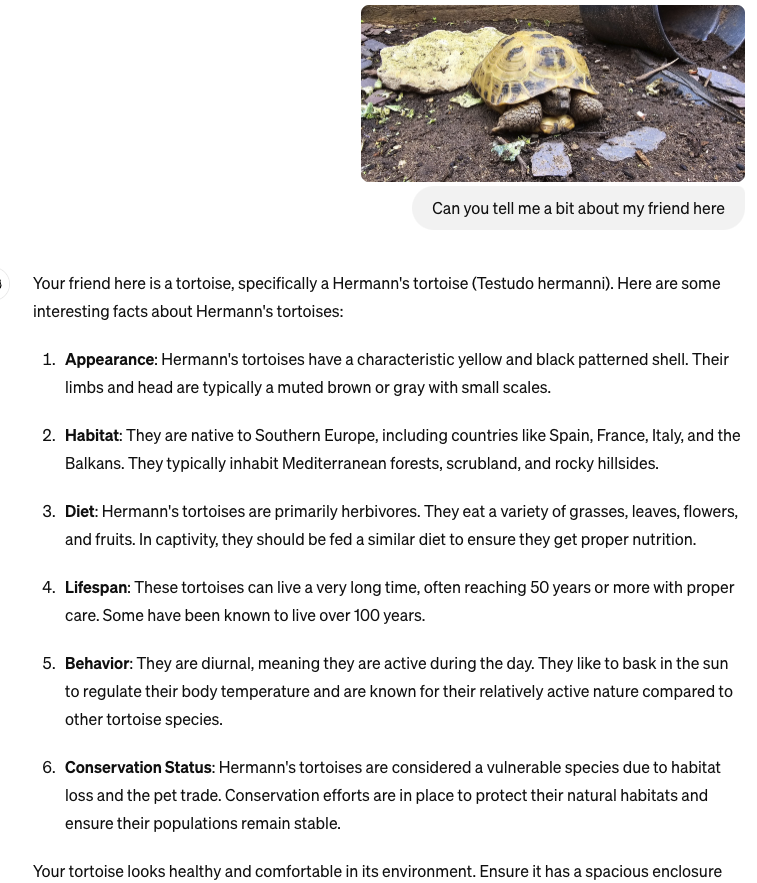
ここでも悪くはありませんが完璧ではありません。ダーウィンは実際にはヘルマンリクガメではなく、ホルスフィールドリクガメです。ただ、見た目はとても似ています。次に、元の画像を北斎風に再現するよう ChatGPT-4o に依頼しました。結果がこちらです。
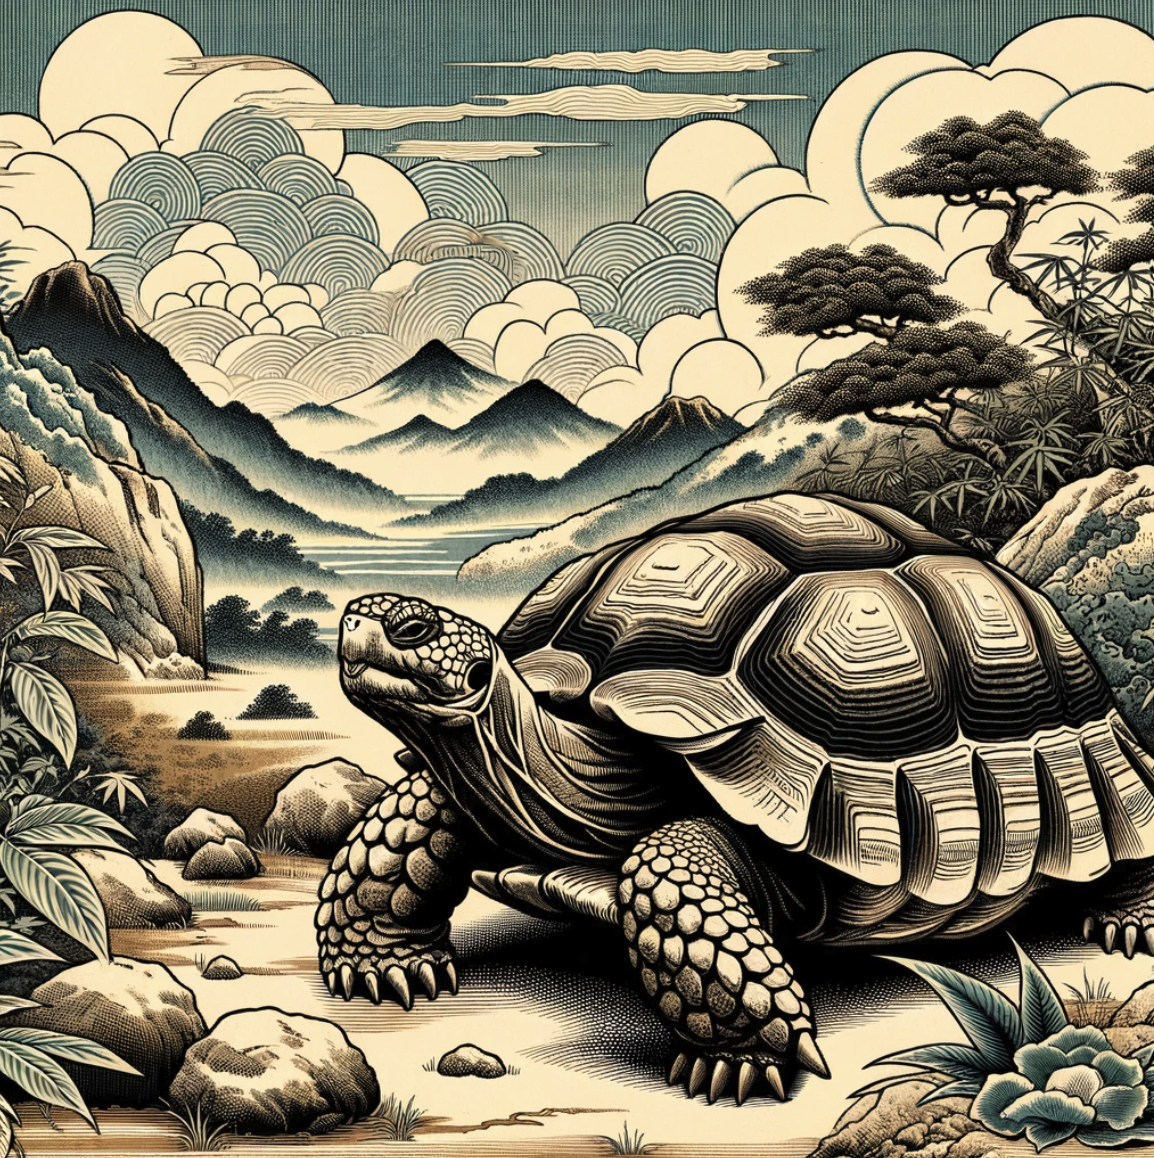
なかなかの出来ですが、元画像との実際の類似性はあまり高くありません。とはいえ妥当でしょう。生成には少し時間がかかりました。
総じて、新モデルの応答性や依頼の理解度には感心しました。完璧からは程遠く、ときおり自信満々に幻覚を起こしますが、改善された音声機能と統合ビジョンを早く試してみたいところです。
生成 AI の規制はまだ初期段階で、現時点で注目に値する法的枠組みは EU AI 法のみです。つまり、AI を開発する企業は、安全な AI の基準を自ら判断する必要があります。
OpenAI は新モデルの一般公開の是非を判断するための 備えの枠組みを設けています。
この枠組みでは、以下の 4 分野をテストします。
各分野は Low/Medium/High/Critical で評価され、モデルのスコアは 4 カテゴリのうち最も高い等級になります。
OpenAI は、Critical と判定されたモデルは公開しないと約束していますが、これは比較的低い安全基準です。同社の定義では、Critical は人類文明を覆すレベルに相当します。GPT-4o は Medium(中程度)で、これを大きく回避しています。
すべての生成 AI に共通しますが、モデルは常に意図どおりに動くわけではありません。コンピュータビジョンは完全ではなく、画像や動画の解釈が必ずしも正確に機能するとは限りません。
同様に、音声の文字起こしも 100% 正確とは限らず、特に話者の訛りが強い場合や専門用語が使われる場合に誤りが生じがちです。
OpenAI は、GPT-4o が意図どおりに動作しなかった NG 集の動画を公開しています。
特に、英語以外の 2 言語間の翻訳で失敗が見られました。ほかにも、(見下すような)不適切な口調や、誤った言語で話すといった問題がありました。
今日から OpenAI で AI ツール開発を学ぼう!
Courses
Courses
Courses