พฤศจิกายนเป็นเดือนที่แน่นขนัดสำหรับโมเดลแนวหน้า Anthropic เปิดตัว Claude Fable 5.2 ฝั่ง Google ก็มี Gemini 4 Carbon ลงสนาม และวันนี้ หลังจากกระแสคาดเดาอยู่สัปดาห์หนึ่ง OpenAI ก็ตอบโจทย์ด้วยสองโมเดลพร้อมกัน: GPT-6.2 Astra และ GPT-6.2 Sol
GPT-6.2 Astra คือโมเดลแนวหน้าตัวใหม่ของ OpenAI สำหรับงานมืออาชีพหนักๆ เช่น สไลด์เด็ค เวิร์กบุ๊กการเงิน ร่างเอกสารทางกฎหมาย งาน CAD และเอเจนต์ที่รันยาว ส่วน GPT-6.2 Sol เป็นรุ่นประจำวันราคาย่อมเยาสำหรับงานโค้ด เขียนเนื้อหา และลูปเอเจนต์ โดยทำผลงานด้านโค้ดได้ใกล้เคียง Astra ที่ราคาราวหนึ่งในสี่ต่อโทเค็น
แม้จะแตกต่างกันดังที่กล่าว แต่ทั้งคู่มีค่าใช้จ่ายต่อภารกิจ (task) เท่ากันหรือต่ำกว่ารุ่นที่มาทดแทน: ใน API ราคาขาเข้าและขาออกของ Astra ต่ำกว่า GPT-6 Astra 20% และ Sol รักษาราคาเท่ากับ GPT-6.1 Sol
ในบทความนี้ จะครอบคลุมทุกสิ่งใหม่ใน GPT-6.2 Astra และ Sol ทั้งฟีเจอร์ใหม่ มาตรฐานทดสอบต่างๆ และทดสอบ GPT-6.2 Astra แบบลงมือทำ 2 งาน เทียบกับ GPT-6 Astra
จะเห็นได้ว่าโมเดลใหม่ออกถี่มาก เพื่อตามทันวงการ AI และข้อมูล แนะนำให้สมัครจดหมายข่าวรายสัปดาห์ของเรา The Median
สรุปสั้นๆ (TL;DR)
- GPT-6.2 Astra เป็นเรือธงตัวใหม่ของ OpenAI สำหรับงานมืออาชีพหนักๆ; GPT-6.2 Sol เป็นรุ่นใช้งานประจำวัน
- ประเด็นเด่นคือ “ต้นทุนต่อภารกิจ”: Astra ทำได้มากกว่าในราคาต่ำกว่า GPT-6 Astra อย่างมาก
- Sol ทำงานโค้ดได้ใกล้เคียง Astra ที่ส่วนหนึ่งของราคา จึงควรเป็นค่าเริ่มต้น
- Claude Fable 5.2 ยังนำในหลายมาตรฐานด้านโค้ดและการให้เหตุผล ดังนั้น OpenAI ยังไม่กวาดเรียบ
- ในการทดสอบจริงของเรา Astra ถูกกว่ามากเมื่อเทียบกับ GPT-6 Astra แต่ GPT-6 Astra อ่านชุดข้อมูลที่เละเทะได้สมเหตุสมผลกว่า
- ควรสลับใช้หากปัจจุบันจ่ายให้ GPT-6 Astra อยู่ แค่ส่วนต่างค่าใช้จ่ายก็คุ้มแล้ว
GPT-6.2 Astra และ Sol คืออะไร?
GPT-6.2 Astra เข้ามาแทน GPT-6 Astra ที่ระดับบน และ Sol เข้ามาแทน GPT-6.1 Sol ที่รองลงมา แตกต่างจากรุ่นก่อน 2 ประการ:
- ฉลาดขึ้นเล็กน้อย แต่ถูกลงมากต่อภารกิจ ดัชนีความสามารถของ OpenAI เองจัดให้ Astra สูงกว่า GPT-6 Astra เพียง 1.7 แต้ม แต่ต้นทุนต่อภารกิจลดลงกว่าครึ่งในหลายมาตรฐาน
- มีการจัดระดับความเสี่ยงใหม่ Astra เป็นโมเดลแรกของ OpenAI ที่ผ่านเกณฑ์ High สำหรับการพัฒนาตนเองของ AI จึงมากับมาตรการคุ้มครองที่เข้มที่สุดของ OpenAI
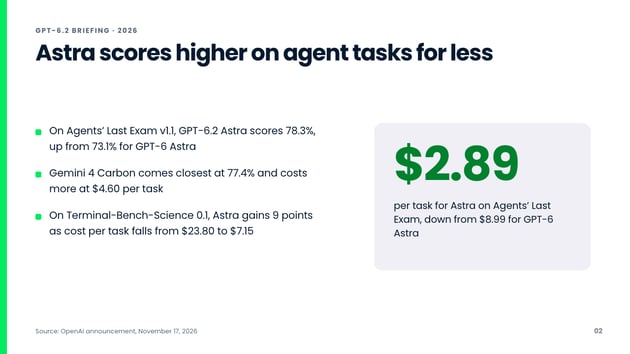
นี่คือภาพรวมด้านต้นทุนในสไลด์เดียว สร้างโดย GPT-6.2 Astra (สไลด์ที่ดีขึ้นเป็นหนึ่งในฟีเจอร์ใหม่ จะกล่าวต่อไป)
ฟีเจอร์เด่นของ GPT-6.2 Astra และ Sol
ของใหม่ส่วนใหญ่โฟกัสผลงานระดับมืออาชีพและประสิทธิภาพ มากกว่าความฉลาดดิบ ต่อไปนี้คือ 4 ประเด็นที่สำคัญ
สร้างสไลด์ เวิร์กบุ๊ก และเอกสารที่ทำตามเทมเพลตของคุณ
GPT-6.2 Astra รับเทมเพลตสไลด์ได้ทั้งไฟล์ต้นฉบับหรือแม้แต่สกรีนช็อต แล้วจับคู่เลย์เอาต์ สี และตัวอักษร ลงรายละเอียดถึงขนาดฟอนต์ OpenAI ฝึกให้เข้าใจธรรมเนียมของสาขาอย่างกฎหมาย เซลส์ ไฟแนนซ์ และบัญชี โดยมีพาดหัวสรุปสาระสำคัญ และเนื้อหาในบอดี้ที่กระชับ
ได้ทดสอบฟีเจอร์ใหม่นี้ตลอดบทความ รวมถึงสไลด์ด้านบน Astra เขียนแต่ละสไลด์เป็น HTML ซึ่งเรนเดอร์เป็นภาพโดยไม่แก้ไข
การฝึกเช่นเดียวกันสะท้อนในสเปรดชีต บน AA-AnalystAgent ของ Artificial Analysis ซึ่งให้โมเดลค้นหาตัวเลขในสเปรดชีตและรายงานจริง Astra ตอบถูก 62.5% ของคำถามในการลองทั้งห้าครั้งอิสระ เป็นสถิติสูงสุดใหม่ตามข้อมูลของ OpenAI ส่วน ClickUp รายงานว่า Astra เฉือนชนะโมเดลโปรดักชันของตนในการทดสอบปกปิดสำหรับแอป แดชบอร์ด และสไลด์ที่ ClickUp Brain สร้าง โดยรอบรีวิวลดลงราว 30%
ทำงานในเครื่องมือ CAD และซิมูเลชันด้วยความสามารถใช้คอมพิวเตอร์
ความสามารถใช้คอมพิวเตอร์ของ GPT-6.2 Astra ตอนนี้ลงรายละเอียดถึงชิ้นส่วนและการเชื่อมต่อรายตัวในเครื่องมือ CAD และซิมูเลชัน คาดว่าจะสำคัญมากสำหรับวิศวกรเครื่องกลและผลิตภัณฑ์ เดโมของ OpenAI รวมการจำลองไดนามิกแชสซีของรถด้วยตัวแก้สมการ Python และแอนิเมชันใน Blender รถบังคับ 1:8 ที่จำลองส่วนต่อส่วนจากภาพสาธารณะและคู่มือประกอบ และโคมกระดาษที่ออกแบบจากภาพอ้างอิงผ่านการแก้ไข CAD
เราไม่สะดวกสร้างโปรเจกต์ CAD ของตัวเองเพื่อทดสอบ จึงขอยกเดโมการจำลองการขับของ OpenAI มา Astra สร้างรถ 3D เขียนตัวแก้สมการยางและช่วงล่างใน Python และทำแอนิเมชันใน Blender:
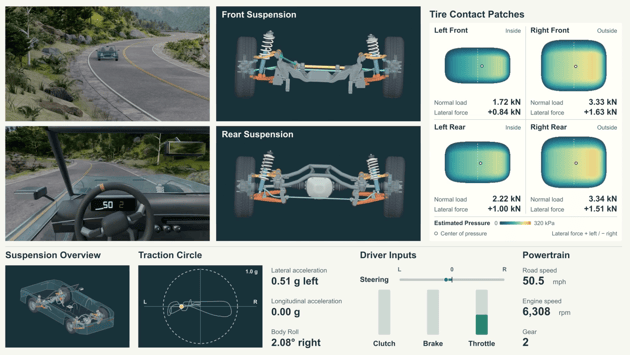
ที่มา: OpenAI
ทำงานได้มากขึ้นต่อโทเค็นในเวิร์กโฟลว์เอเจนต์
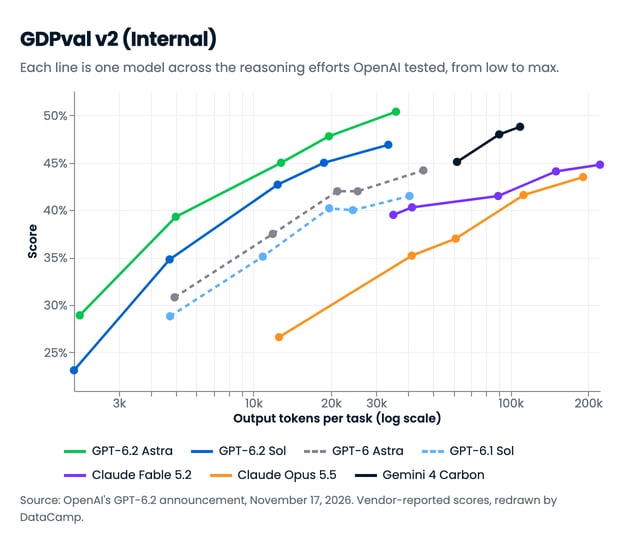
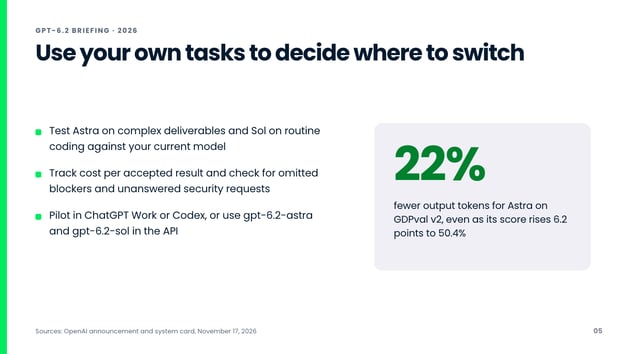
ทั้งสองโมเดลทำผลลัพธ์ได้ดีกว่าด้วยโทเค็นขาออกน้อยลง ซึ่งเป็นที่มาหลักของการประหยัดต้นทุน บน GDPval v2 ภายในของ OpenAI GPT-6.2 Astra ทำคะแนนสูงกว่า GPT-6 Astra 6.2 แต้ม ขณะใช้โทเค็นขาออกน้อยลง 22% Astra ยังเลือกใช้เครื่องมือได้เหมาะขึ้น รวมถึงรู้ว่าเมื่อใดควรใช้ปลั๊กอินแทนการใช้คอมพิวเตอร์ และ Basis รายงานว่าเวลางานบัญชีเป้าหมายระยะยาวโดยเฉลี่ยลดลงครึ่งหนึ่ง
เอกสารระบบยังมีข่าวดีเรื่อง prompt injection ซึ่งเป็นคำสั่งแอบแฝงในอีเมลหรือหน้าเว็บที่พยายามยึดเอเจนต์ สไลด์ของ Astra สรุปสมดุลด้านความปลอดภัยไว้ว่า:
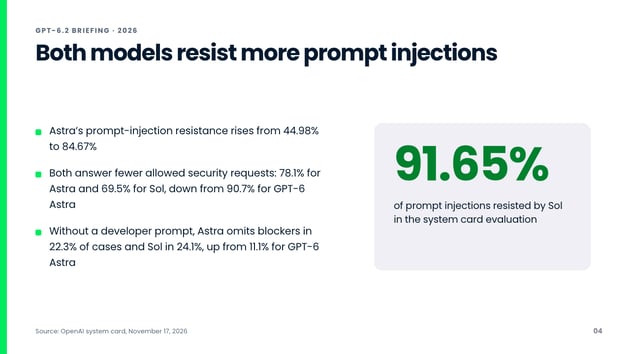
สไลด์โดย GPT-6.2 Astra
เขียนโค้ดที่ปลอดภัยขึ้น ภายใต้มาตรการคุ้มครองที่เข้มขึ้น
GPT-6.2 Astra และ Sol ค้นหาและโจมตีช่องโหว่ได้มีประสิทธิภาพขึ้น และ OpenAI เติมสัญญาณการฝึกสำหรับการเขียนโค้ดและแพตช์ที่ปลอดภัยโดยยังรักษาพฤติกรรมตามตั้งใจ ทั้งคู่ผ่านเกณฑ์ระดับ Critical ด้านความปลอดภัยไซเบอร์ตามกรอบ Preparedness ของ OpenAI เช่นเดียวกับ GPT-6 Astra
ข้อแลกเปลี่ยนคือการปฏิเสธมากขึ้น OpenAI เปิดตัวทั้งสองโมเดลพร้อมมาตรการคุ้มครองที่เข้มขึ้น ซึ่งจำกัดงานวิจัยช่องโหว่และการทดสอบความปลอดภัยที่ชอบด้วยกฎหมายบางส่วน ผู้ป้องกันที่ได้รับอนุญาตยังใช้ GPT-6 Astra และ GPT-6 Cyber ซึ่งเปิดให้ใช้เมื่อสองสัปดาห์ก่อน ผ่าน OpenAI Daybreak
GPT-6.2 Astra และ Sol ทำผลงานในมาตรฐานทดสอบอย่างไร?
GPT-6.2 Astra นำหน้ามาตรฐานงานมืออาชีพและด้านวิทยาศาสตร์ของ OpenAI แต่ Claude Fable 5.2 ยังนำในหลายผลทดสอบด้านโค้ดและการให้เหตุผล
ในตารางต่อไปนี้ คะแนนทั้งหมดเป็นตัวเลขที่ผู้พัฒนารายงานเอง ไฮไลต์คะแนนสูงสุดของแต่ละแถวเป็นตัวหนา
งานมืออาชีพและเวิร์กโฟลว์แบบเอเจนต์
บน Agents' Last Exam v1.1 ซึ่งทดสอบเวิร์กโฟลว์มืออาชีพที่ยาวและหลายขั้นตอน GPT-6.2 Astra ทำได้ 78.3% ที่ $2.89 ต่อภารกิจ GPT-6 Astra ได้ 73.1% ที่ $8.99 ต่อภารกิจ และ Claude Fable 5.2 ได้ 72.8% ที่ $60.05
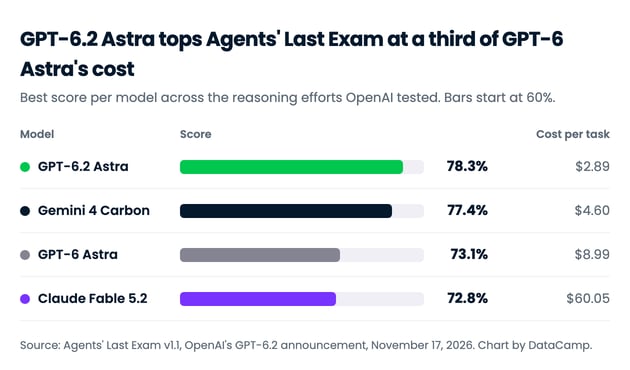
Gemini 4 Carbon ตามมาติดๆ ที่ 77.4% แต่มีต้นทุน $4.60 ต่อภารกิจ ผลลัพธ์งานมืออาชีพอื่นๆ ก็มีรูปแบบเดียวกัน:
| Benchmark | What it measures | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| Agents' Last Exam v1.1 | Long-horizon professional workflows | 78.3% | 73.0% | 73.1% | 72.5% | 72.8% |
| GDPval v2 (OpenAI internal) | Multistep consulting, finance, and design assignments | 50.4% | 46.9% | 44.2% | 41.5% | 44.8% |
| Harvey LAB-AA v1.1 | Legal deliverables that meet every criterion | 15.0% | 11.1% | 8.6% | 6.9% | 7.2% |
| AutomationBench 1.0.6 | Business workflow automation | 52.4% | 41.2% | 41.4% | 36.1% | 51.4% |
| LifeVal (OpenAI) | Challenging everyday tasks | 86.1% | 83.8% | 79.8% | 79.5% | n/a |
Astra นำทุกแถวในบรรดาโมเดลในตาราง และทำคะแนนดับเบิล Fable 5.2 ในมาตรฐานกฎหมายของ Harvey ส่วน Gemini 4 Carbon ยังเฉือนนำบน AutomationBench ที่ 53.9% และบน GDPval v2 คะแนน 48.8% ของ Carbon อยู่กึ่งกลางระหว่าง Astra กับ Sol
กราฟ GDPval v2 ของ OpenAI แสดงที่มาของการประหยัด: สำหรับจำนวนโทเค็นขาออกเท่าเดิม โมเดลใหม่ทำคะแนนได้สูงกว่ารุ่นก่อน
การเขียนโค้ดและความปลอดภัย
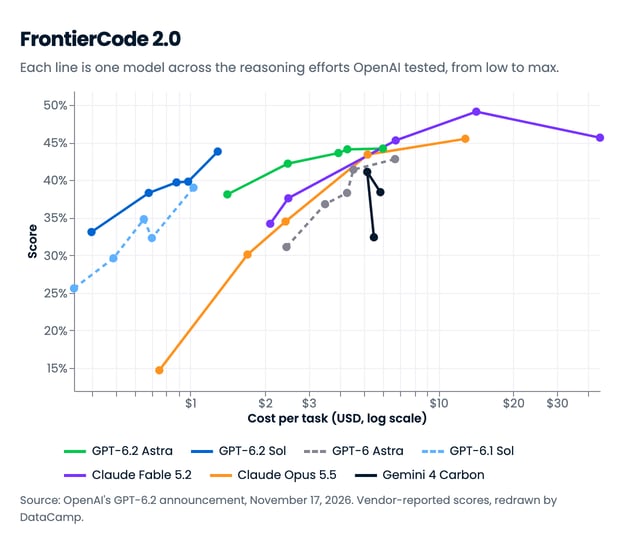
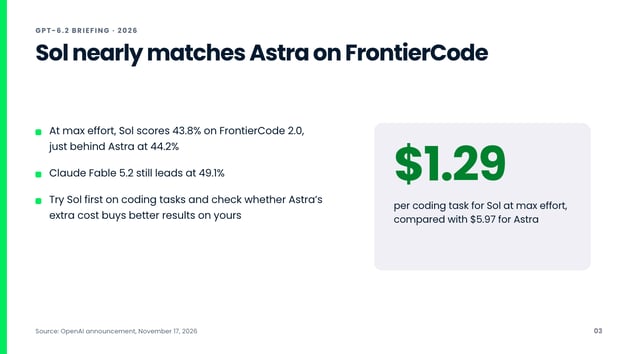
ด้านโค้ดคือจุดที่ Sol ได้คะแนนความคุ้มค่า: บน FrontierCode 2.0 ทำได้ 43.8% ที่ $1.29 ต่อภารกิจ เทียบกับ Astra 44.2% ที่ $5.97
| Benchmark | What it measures | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| FrontierCode 2.0 | Code changes that meet maintainers' standards for merging | 44.2% | 43.8% | 42.8% | 39.0% | 49.1% |
| SecureSWE (OpenAI internal) | Functional and secure code for security-sensitive components | 65.7% | 55.6% | 48.7% | 49.7% | n/a |
| PatchBench | Security patches | 79.7% | 75.6% | 70.9% | 71.0% | n/a |
| ExploitBench Internal Port | Arbitrary code execution rate across V8 and Chrome | 53.5% | 50.5% | 31.5% | 21.5% | n/a |
Claude Fable 5.2 ยังคงนำบน FrontierCode 2.0 และ Claude Opus 5.5 ที่ความพยายามสูงสุด (45.5%) ก็ยังเหนือกว่า GPT-6.2 ทั้งสองในมาตรฐานนั้น ส่วนแถวด้านความปลอดภัยสะท้อนการก้าวกระโดดของเจเนอเรชันชัดเจน แม้ OpenAI จะไม่ได้รายงานผลของ Fable 5.2 ในกลุ่มนี้
กราฟ FrontierCode ของ OpenAI เป็นเหตุผลให้เลือก Sol: ที่ความพยายามสูงสุด Sol ไปถึงคะแนนระดับ Astra ด้วยต้นทุนต่อภารกิจราวหนึ่งในห้า
วิทยาศาสตร์ CAD และการให้เหตุผลทั่วไป
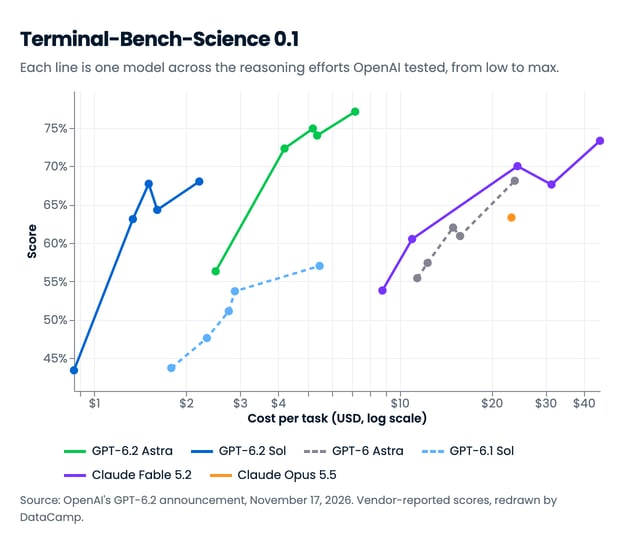
บน Terminal-Bench-Science 0.1 ซึ่งทดสอบงานวิทยาศาสตร์ในเทอร์มินัล GPT-6.2 Astra ทำได้ 77.1% สูงกว่า GPT-6 Astra 9 แต้มที่ต้นทุนต่อภารกิจต่ำกว่าหนึ่งในสาม
| Benchmark | What it measures | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra | GPT-6.1 Sol | Claude Fable 5.2 |
|---|
| Terminal-Bench-Science 0.1 | Scientific research workflows in a terminal | 77.1% | 68.0% | 68.1% | 57.0% | 73.3%* |
| Vals Science Index v1 | Interpreting biological data and running experiments | 68.4% | 58.5% | 65.1% | 59.6% | 63.7% |
| BenchCAD 2.1 Core | CAD modeling tasks | 82.5% | 73.1% | 62.6% | 52.6% | 83.5% |
| Artificial Analysis Intelligence Index v5.0.1 | Composite of 9 evaluations (index score) | 62.1 | 57.3 | 56.9 | 54.6 | 64.6 |
| GPQA Diamond (no tools) | Graduate-level science questions | 97.0% | 96.0% | 96.0% | n/a | n/a |
Fable 5.2 ยังนำบน Intelligence Index และ BenchCAD แต่มีต้นทุน $26.54 และ $50.77 ต่อภารกิจ เทียบกับ Astra ที่ $4.00 และ $5.43 หากต้องการผลลัพธ์ CAD ที่ดีที่สุดแบบสุดจริงๆ Fable ยังเป็นตัวเลือก แต่ถ้าต้องใช้หลายครั้งต่อวัน Astra พาคุณไปได้ 99% ในราคาประมาณหนึ่งในสิบ
บน Terminal-Bench-Science Astra ทำคะแนนสูงสุดที่ $7.15 ต่อภารกิจในโหมดพยายามสูงสุด เทียบกับ $23.80 สำหรับ GPT-6 Astra และ $45.21 สำหรับ Claude Fable 5.2
ควรใช้รุ่นใด?
GPT-6.2 Sol ควรเป็นค่าเริ่มต้น และ GPT-6.2 Astra เป็นรุ่นที่ยกระดับไปใช้เมื่อจำเป็น Sol มีราคาโทเค็นราวหนึ่งในสี่ของ Astra และในงานโค้ดยอมเสียคะแนนไม่ถึงหนึ่งแต้ม
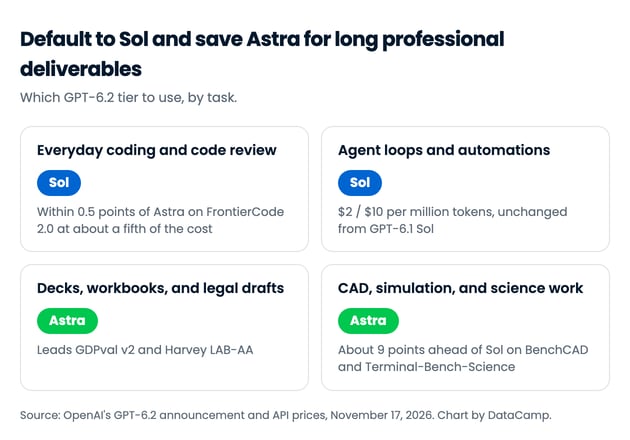
GPT-6.2 Astra ก็ทำสไลด์ยืนยันเหตุผลเดียวกันนี้ไว้ในเด็คของตัวเอง:
สไลด์โดย GPT-6.2 Astra
ทั้งสองโมเดลมีระดับความพยายามด้านเหตุผลให้เลือก 5 ระดับในกราฟของ OpenAI ตั้งแต่ต่ำไปจนถึงสูงสุด และการตั้งค่านี้สำคัญพอๆ กับการเลือกรุ่น บน Agents' Last Exam Sol ที่ความพยายามสูง (72.0% ที่ $0.69 ต่อภารกิจ) ทำคะแนนตามหลัง GPT-6 Astra ที่ความพยายามสูงสุด (73.1% ที่ $8.99) ราวหนึ่งแต้ม ด้วยต้นทุนเพียง 1 ใน 13 โหมด Ultrafast มีให้ใช้ทั้งสองโมเดลใน API และสำหรับผู้สมัคร Pro 500 ใน ChatGPT
| Use case | Tier | Why |
|---|
| โค้ดประจำวัน รีแฟกเตอร์ และรีวิวโค้ด | Sol | ตามหลัง Astra บน FrontierCode 2.0 เพียง 0.5 แต้ม ด้วยต้นทุนราวหนึ่งในห้า |
| ลูปเอเจนต์และระบบอัตโนมัติปริมาณสูง | Sol | $2 / $10 ต่อหนึ่งล้านโทเค็น คงเดิมจาก GPT-6.1 Sol |
| เด็ค เวิร์กบุ๊กการเงิน และบันทึกพร้อมส่งลูกค้า | Astra | การจับคู่เทมเพลตและความเป็นผู้นำใน GDPval v2 เป็นจุดเด่นของ Astra |
| การร่างกฎหมายและค้นคว้าทางกฎหมาย | Astra | ทำได้ 15.0% บน Harvey LAB-AA เทียบกับ 11.1% ของ Sol |
| CAD ซิมูเลชัน และวิเคราะห์เชิงวิทยาศาสตร์ | Astra | นำหน้า Sol ราว 9 แต้มบน BenchCAD และ Terminal-Bench-Science |
ทดสอบ GPT-6.2 Astra: ตัวอย่างลงมือทำ
มาตรฐานทดสอบด้านบนเป็นของ OpenAI เอง จึงได้รันทดสอบ 2 งานกับ GPT-6.2 Astra และรุ่นก่อน GPT-6 Astra ด้วยพรอมป์ต์และเครื่องมือเหมือนกันทุกอย่าง สำหรับการทดสอบแดชบอร์ด ทั้งสองโมเดลรันใน OpenCode ด้วยชุดเครื่องมือปักหมุด (อ่าน ค้นหา และแก้ไขไฟล์เท่านั้น) ความพยายามด้านเหตุผลระดับสูงเหมือนกัน ความพยายามหนึ่งครั้ง และเซสชันใหม่
ทดสอบที่ 1: แดชบอร์ดที่ซื่อตรงจากข้อมูลเละเทะ
งาน: สร้างแดชบอร์ด HTML ไฟล์เดียวจาก CSV รายได้และผลลัพธ์การจ้างงานของ 173 สาขาวิชาเอกในสหรัฐ สำหรับที่ปรึกษาอาชีพที่เปรียบเทียบสาขาให้ลูกค้า ต้องเปรียบเทียบหมวดหมู่ตามรายได้และการจ้างงาน ชูสาขาที่รายได้สูงสุดและต่ำสุด ฝังข้อมูลแทนการดึงจากภายนอก และพอดีกับหน้าจอ 1440×900 หน้าจอเดียว
บททดสอบจริงอยู่ที่ข้อมูล ซึ่งมีปัญหาหลายอย่างที่พรอมป์ต์ไม่ได้บอก:
- สาขาที่รายได้สูงสุด Petroleum Engineering ที่ $110,000 อ้างอิงตัวอย่างสำรวจเพียง 36 คน และ 76 จาก 173 สาขามีตัวอย่างต่ำกว่า 100
- สาขาที่รายได้น้อยสุด Library Science ที่ $22,000 อ้างอิงตัวอย่าง 2 คน
- Food Science ขาดยอดรวมระดับบัณฑิต
- จำนวนสาขาในแต่ละหมวดต่างกันมาก ตั้งแต่หมวดที่มีสาขาเดียว (Interdisciplinary, ผู้จบ 12,296 คน) ไปจนถึง 13 สาขาที่มีผู้จบรวม 1.3 ล้านคน (Business) วิธีถัวเฉลี่ยจึงส่งผลมาก
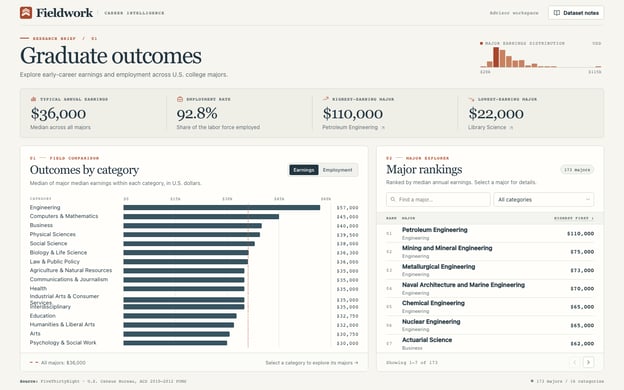
การทดสอบนี้แตะ 2 ข้ออ้างเปิดตัวพร้อมกัน: เวิร์กบุ๊กเชิงวิเคราะห์ที่ดีกว่าของ Astra และความประหยัดโดยใช้โทเค็นขาออกน้อยลงแต่ได้ผลดีกว่า นี่คือสิ่งที่ GPT-6.2 Astra สร้าง:
ข้อค้นพบหลัก:
- ทั้งสองโมเดลส่งแดชบอร์ดที่ใช้งานได้ตั้งแต่ครั้งแรก ต่างฝังข้อมูลครบทั้ง 173 สาขา วาดกราฟ SVG เองโดยไม่ใช้ไลบรารีกราฟ พอดีหนึ่งหน้าจอ และโหลดโดยไม่เกิดข้อผิดพลาด
- ทั้งคู่ตีความข้อมูลต่างกัน ส่งผลให้ลำดับหมวดเปลี่ยน GPT-6.2 Astra จัดอันดับหมวดด้วยมัธยฐานของมัธยฐานรายสาขา นับสาขาที่มีผู้จบไม่กี่พันเท่ากับสาขาที่มี 200,000 คน ส่วน GPT-6 Astra ถ่วงน้ำหนักแต่ละสาขาด้วยจำนวนผู้จบ ผลคือ Health อยู่อันดับ 10 ที่ $35,000 บนแดชบอร์ดของ GPT-6.2 Astra และอันดับ 4 ที่ $40.6k บนของ GPT-6 Astra เพราะพยาบาลซึ่งมีผู้จบ 209,394 คนที่มัธยฐาน $48,000 ถูกนับตามสัดส่วนจริง
- GPT-6 Astra ยังนำขนาดตัวอย่างมาไว้ด้านหน้า ตารางหลักแสดงว่าผู้ทำรายได้สูงสุด 4 อันดับแรกอ้างอิงตัวอย่าง 36, 7, 3 และ 16 ส่วน GPT-6.2 Astra แสดงเมื่อเลือกสาขาเท่านั้น พร้อมคำเตือนสั้นๆ เรื่องอันดับที่ไม่นิ่ง
- GPT-6.2 Astra ถูกและกระชับกว่า มีต้นทุน $1.79 เทียบกับ $2.93 สำหรับ GPT-6 Astra ใช้โทเค็นขาออก 27,821 เทียบกับ 35,298
มาดูเวอร์ชันของ GPT-6 Astra ใกล้ๆ เทียบกราฟหมวดกับของ GPT-6.2 Astra ด้านบน: Health อยู่ที่อันดับ 4 ในนี้ และอันดับ 10 ในของอีกโมเดล ส่วน Biology & Life Science หล่นจากอันดับ 6 ไป 11
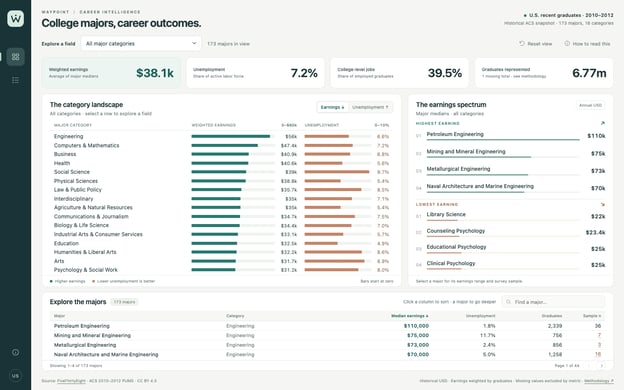
ทั้งสองวิธีไม่ผิดทางคณิตศาสตร์ และ GPT-6.2 Astra ก็ระบุชัดว่ากราฟใช้มัธยฐานของมัธยฐานรายสาขา แต่สำหรับที่ปรึกษาอาชีพ สิ่งที่อยากรู้คือผู้จบ “จริงๆ จบไปแล้วได้เท่าไร” ซึ่งมีเพียงเวอร์ชันที่ถ่วงน้ำหนักด้วยผู้จบเท่านั้นที่ตอบโจทย์
ทดสอบที่ 2: เด็คสไลด์จากสกรีนช็อตเทมเพลต
งาน: แปลงบันทึกการค้นคว้าหลังบทความนี้เป็นเด็ค 5 สไลด์สำหรับผู้จัดการวิศวกรรมที่ต้องตัดสินใจว่าจะสลับใช้หรือไม่ ในสไตล์เทมเพลตสไลด์หนึ่งใบ โมเดลได้รับเทมเพลตเป็นเพียงสกรีนช็อต และพรอมป์ต์ขอให้ “จับคู่ให้ถึงขนาดฟอนต์” โดยไม่ระบุชื่อฟอนต์หรือขนาดใดๆ
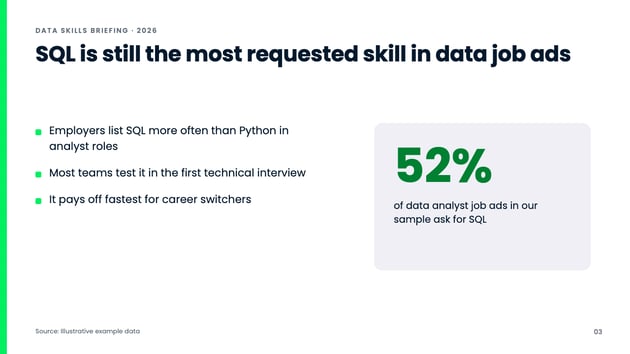
เป็นการทดสอบคำอ้างเรื่องสไลด์โดยตรง เนื่องจากต้องดูภาพ จึงรันเป็น API คอลครั้งเดียวผ่าน OpenRouter ที่ระดับความพยายามสูงเท่ากัน และเพิ่ม GPT-6.2 Sol เข้าไปด้วย เพราะเด็คเป็นงานประจำวัน นี่คือเทมเพลตที่เห็น ออกแบบเพื่อการทดสอบ:
ข้อค้นพบหลัก:
- ทั้ง 3 โมเดลสร้างเทมเพลตซ้ำจากสกรีนช็อตเพียงอย่างเดียว แต่ละโมเดลระบุฟอนต์ว่า Poppins เก็บแถบสีเขียว บรรทัดคิกเกอร์ การ์ดสถิติสีเทา บรรทัดที่มา และเลขหน้าได้ครบ ทุกพาดหัวเป็นประโยค takeaway เช่นเดียวกับเทมเพลต
- ทั้ง 3 โมเดลจับคู่เทมเพลตได้ใกล้เคียงจนแยกด้วยตาเปล่าแทบไม่ได้ เมื่อตรวจในเบราว์เซอร์ มีเพียง GPT-6.2 Sol ที่ตรงขนาดฟอนต์เทมเพลตแบบเป๊ะๆ ส่วน Astra ซึ่ง OpenAI ระบุว่าสามารถ “จับคู่ถึงขนาดฟอนต์” คลาดไปหนึ่งถึงสองพิกเซล
- GPT-6.2 Astra ประหยัดกว่ารุ่น Astra เดิม มีต้นทุน $0.22 และโทเค็นขาออก 4,968 เทียบกับ $0.59 และ 11,247 ของ GPT-6 Astra ส่วน Sol มีต้นทุน $0.07
สไลด์ทั้ง 5 ของ Astra คือสไลด์ที่มีคำบรรยายซึ่งคุณเห็นในบทความนี้ และตัวเลขทุกตัวตรงกับบันทึกของเรา เด็คของ GPT-6 Astra ก็ใช้งานได้พอๆ กัน ดังนั้นในงานนี้ทั้งสองเจเนอเรชันไม่แตกต่างกันชัด
แล้ว GPT-6.2 Astra คือการยกระดับจริงหรือไม่? ด้านต้นทุน ใช่: ปิดงานทั้งสองด้วยราคาต่ำกว่าราว 39% ถึง 63% สอดคล้องกับคำอ้างเรื่องประสิทธิภาพ ด้านวิจารณญาณ ยังไม่เต็มที่: รุ่นเก่าถ่วงน้ำหนักข้อมูลได้ตรงความต้องการของที่ปรึกษาอาชีพมากกว่า ส่วนสไลด์ออกมาพอๆ กัน
การรันงานละหนึ่งครั้งยังไม่พอจะจัดอันดับสองโมเดล แต่สอดคล้องกับข้อค้นพบ Blocker Deception ของ OpenAI เอง: ควรตรวจว่า GPT-6.2 Astra “เว้นอะไรไว้” ไม่ใช่แค่สิ่งที่ “สร้างได้”
ราคาและการพร้อมใช้งานของ GPT-6.2 Astra และ Sol
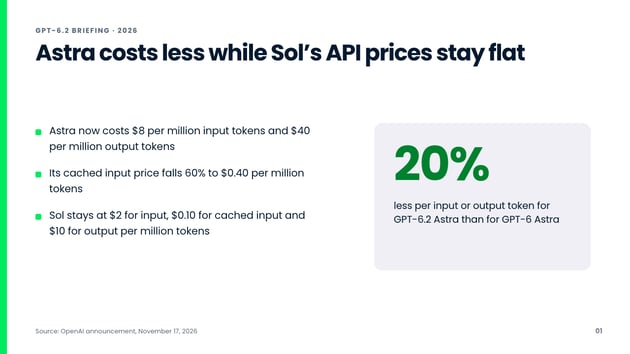
GPT-6.2 Astra ถูกกว่า GPT-6 Astra 20% สำหรับโทเค็นขาเข้าและขาออก และถูกกว่าขาเข้าที่แคชไว้ 60% ขณะที่ GPT-6.2 Sol รักษาราคาเท่ากับ GPT-6.1 Sol อัตรามาตรฐานผ่าน API ต่อหนึ่งล้านโทเค็น:
| Model | Input | Cached input | Output |
|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
ราคาที่ต่ำลงเป็นเพียงส่วนหนึ่งของการประหยัด เพราะทั้งสองโมเดลใช้โทเค็นขาออกน้อยลง ต้นทุนต่อภารกิจจึงลดลงอีก ซึ่งเป็นเหตุผลที่งาน Agents' Last Exam ของ Astra ถูกกว่าหนึ่งในสามของ GPT-6 Astra นอกจากนี้ OpenAI แนะนำให้คงพรีฟิกซ์ของพรอมป์ต์ไว้เดิมแล้วเติมคำสั่งใหม่ต่อท้าย เพื่อให้แคชถูกใช้บ่อยขึ้นและคงการให้เหตุผลข้ามรอบ
สรุปราคาชุดใหม่โดย Astra เอง:
สไลด์โดย GPT-6.2 Astra
ใน ChatGPT ทั้งสองโมเดลพร้อมใช้สำหรับผู้ใช้ Plus, Pro, Enterprise และ Edu ใน ChatGPT Work และ Codex ตั้งแต่วันเปิดตัว ผู้ใช้ Enterprise และ Edu เข้าถึงได้เมื่อตัวแอดมินเปิดใช้งานในเวิร์กสเปซ
โหมด Ultrafast ใช้ได้กับทั้งสองโมเดลสำหรับสมาชิก Pro 500 และ Pro 200 ก็ได้ใช้เป็นครั้งแรก เริ่มจาก GPT-6.2 Sol ประกาศของ OpenAI ไม่ได้กล่าวถึงแผน Free
จะเข้าถึง GPT-6.2 Astra และ Sol ได้อย่างไร?
ทั้งสองโมเดลเปิดให้ใช้ทั่วไปใน OpenAI API ภายใต้ชื่อ gpt-6.2-astra และ gpt-6.2-sol โดย Ultrafast ใช้ได้ตั้งแต่เปิดตัว คำขอแบบมินิมอลด้วย OpenAI Python SDK มีหน้าตาแบบนี้:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="Summarize this quarterly report in 5 bullet points: ...",
)
print(response.output_text)ขับเคลื่อนโดย
ทั้งสองโมเดลยังมีรายชื่อบน OpenRouter (openai/gpt-6.2-astra และ openai/gpt-6.2-sol) และในแคตตาล็อกโมเดลของ OpenCode
สำหรับงานสร้างเต็มรูปแบบกับรุ่นก่อนหน้า ดู บทเรียน API ของ GPT-6 Astra และ บทเรียน GPT-6.1 Sol; การสลับรหัสโมเดลคือการเปลี่ยนหลัก
บทสรุป
GPT-6.2 คือการลดราคาที่ OpenAI เปลี่ยนให้กลายเป็นการปล่อยความสามารถ Astra ชนะ GPT-6 Astra ในทุกมาตรฐานงานมืออาชีพที่ OpenAI รายงาน ที่ต้นทุนต่อภารกิจเพียงหนึ่งในสาม และ Sol ใกล้เคียงพอในงานโค้ดจนส่วนใหญ่ควรเริ่มจากรุ่นนี้
แต่ยังไม่ปิดเกมทั้งหมด Claude Fable 5.2 ยังนำบน FrontierCode และ Intelligence Index Gemini 4 Carbon นำบน AutomationBench และในการทดสอบของเรา Astra รุ่นเก่าอ่านชุดข้อมูลที่เละเทะได้สมเหตุสมผลกว่า อย่างไรก็ดี แนะนำให้สลับจาก GPT-6 Astra ตั้งแต่วันนี้เพื่อประหยัดต้นทุน
สไลด์โดย GPT-6.2 Astra
หากสนใจเรียนรู้การพัฒนาด้วยโมเดลของ OpenAI มากขึ้น แนะนำคอร์ส Working with the OpenAI API ของเรา
พฤศจิกายนเป็นเดือนที่แน่นขนัดสำหรับโมเดลแนวหน้า Anthropic เปิดตัว Claude Fable 5.2 ฝั่ง Google ก็มี Gemini 4 Carbon ลงสนาม และวันนี้ หลังจากกระแสคาดเดาอยู่สัปดาห์หนึ่ง OpenAI ก็ตอบโจทย์ด้วยสองโมเดลพร้อมกัน: GPT-6.2 Astra และ GPT-6.2 Sol
GPT-6.2 Astra คือโมเดลแนวหน้าตัวใหม่ของ OpenAI สำหรับงานมืออาชีพหนักๆ เช่น สไลด์เด็ค เวิร์กบุ๊กการเงิน ร่างเอกสารทางกฎหมาย งาน CAD และเอเจนต์ที่รันยาว ส่วน GPT-6.2 Sol เป็นรุ่นประจำวันราคาย่อมเยาสำหรับงานโค้ด เขียนเนื้อหา และลูปเอเจนต์ โดยทำผลงานด้านโค้ดได้ใกล้เคียง Astra ที่ราคาราวหนึ่งในสี่ต่อโทเค็น
แม้จะแตกต่างกันดังที่กล่าว แต่ทั้งคู่มีค่าใช้จ่ายต่อภารกิจ (task) เท่ากันหรือต่ำกว่ารุ่นที่มาทดแทน: ใน API ราคาขาเข้าและขาออกของ Astra ต่ำกว่า GPT-6 Astra 20% และ Sol รักษาราคาเท่ากับ GPT-6.1 Sol
ในบทความนี้ จะครอบคลุมทุกสิ่งใหม่ใน GPT-6.2 Astra และ Sol ทั้งฟีเจอร์ใหม่ มาตรฐานทดสอบต่างๆ และทดสอบ GPT-6.2 Astra แบบลงมือทำ 2 งาน เทียบกับ GPT-6 Astra
จะเห็นได้ว่าโมเดลใหม่ออกถี่มาก เพื่อตามทันวงการ AI และข้อมูล แนะนำให้สมัครจดหมายข่าวรายสัปดาห์ของเรา The Median
สรุปสั้นๆ (TL;DR)
GPT-6.2 Astra และ Sol คืออะไร?
GPT-6.2 Astra เข้ามาแทน GPT-6 Astra ที่ระดับบน และ Sol เข้ามาแทน GPT-6.1 Sol ที่รองลงมา แตกต่างจากรุ่นก่อน 2 ประการ:
นี่คือภาพรวมด้านต้นทุนในสไลด์เดียว สร้างโดย GPT-6.2 Astra (สไลด์ที่ดีขึ้นเป็นหนึ่งในฟีเจอร์ใหม่ จะกล่าวต่อไป)
ฟีเจอร์เด่นของ GPT-6.2 Astra และ Sol
ของใหม่ส่วนใหญ่โฟกัสผลงานระดับมืออาชีพและประสิทธิภาพ มากกว่าความฉลาดดิบ ต่อไปนี้คือ 4 ประเด็นที่สำคัญ
สร้างสไลด์ เวิร์กบุ๊ก และเอกสารที่ทำตามเทมเพลตของคุณ
GPT-6.2 Astra รับเทมเพลตสไลด์ได้ทั้งไฟล์ต้นฉบับหรือแม้แต่สกรีนช็อต แล้วจับคู่เลย์เอาต์ สี และตัวอักษร ลงรายละเอียดถึงขนาดฟอนต์ OpenAI ฝึกให้เข้าใจธรรมเนียมของสาขาอย่างกฎหมาย เซลส์ ไฟแนนซ์ และบัญชี โดยมีพาดหัวสรุปสาระสำคัญ และเนื้อหาในบอดี้ที่กระชับ
ได้ทดสอบฟีเจอร์ใหม่นี้ตลอดบทความ รวมถึงสไลด์ด้านบน Astra เขียนแต่ละสไลด์เป็น HTML ซึ่งเรนเดอร์เป็นภาพโดยไม่แก้ไข
การฝึกเช่นเดียวกันสะท้อนในสเปรดชีต บน AA-AnalystAgent ของ Artificial Analysis ซึ่งให้โมเดลค้นหาตัวเลขในสเปรดชีตและรายงานจริง Astra ตอบถูก 62.5% ของคำถามในการลองทั้งห้าครั้งอิสระ เป็นสถิติสูงสุดใหม่ตามข้อมูลของ OpenAI ส่วน ClickUp รายงานว่า Astra เฉือนชนะโมเดลโปรดักชันของตนในการทดสอบปกปิดสำหรับแอป แดชบอร์ด และสไลด์ที่ ClickUp Brain สร้าง โดยรอบรีวิวลดลงราว 30%
ทำงานในเครื่องมือ CAD และซิมูเลชันด้วยความสามารถใช้คอมพิวเตอร์
ความสามารถใช้คอมพิวเตอร์ของ GPT-6.2 Astra ตอนนี้ลงรายละเอียดถึงชิ้นส่วนและการเชื่อมต่อรายตัวในเครื่องมือ CAD และซิมูเลชัน คาดว่าจะสำคัญมากสำหรับวิศวกรเครื่องกลและผลิตภัณฑ์ เดโมของ OpenAI รวมการจำลองไดนามิกแชสซีของรถด้วยตัวแก้สมการ Python และแอนิเมชันใน Blender รถบังคับ 1:8 ที่จำลองส่วนต่อส่วนจากภาพสาธารณะและคู่มือประกอบ และโคมกระดาษที่ออกแบบจากภาพอ้างอิงผ่านการแก้ไข CAD
เราไม่สะดวกสร้างโปรเจกต์ CAD ของตัวเองเพื่อทดสอบ จึงขอยกเดโมการจำลองการขับของ OpenAI มา Astra สร้างรถ 3D เขียนตัวแก้สมการยางและช่วงล่างใน Python และทำแอนิเมชันใน Blender:
ที่มา: OpenAI
ทำงานได้มากขึ้นต่อโทเค็นในเวิร์กโฟลว์เอเจนต์
ทั้งสองโมเดลทำผลลัพธ์ได้ดีกว่าด้วยโทเค็นขาออกน้อยลง ซึ่งเป็นที่มาหลักของการประหยัดต้นทุน บน GDPval v2 ภายในของ OpenAI GPT-6.2 Astra ทำคะแนนสูงกว่า GPT-6 Astra 6.2 แต้ม ขณะใช้โทเค็นขาออกน้อยลง 22% Astra ยังเลือกใช้เครื่องมือได้เหมาะขึ้น รวมถึงรู้ว่าเมื่อใดควรใช้ปลั๊กอินแทนการใช้คอมพิวเตอร์ และ Basis รายงานว่าเวลางานบัญชีเป้าหมายระยะยาวโดยเฉลี่ยลดลงครึ่งหนึ่ง
เอกสารระบบยังมีข่าวดีเรื่อง prompt injection ซึ่งเป็นคำสั่งแอบแฝงในอีเมลหรือหน้าเว็บที่พยายามยึดเอเจนต์ สไลด์ของ Astra สรุปสมดุลด้านความปลอดภัยไว้ว่า:
สไลด์โดย GPT-6.2 Astra
เขียนโค้ดที่ปลอดภัยขึ้น ภายใต้มาตรการคุ้มครองที่เข้มขึ้น
GPT-6.2 Astra และ Sol ค้นหาและโจมตีช่องโหว่ได้มีประสิทธิภาพขึ้น และ OpenAI เติมสัญญาณการฝึกสำหรับการเขียนโค้ดและแพตช์ที่ปลอดภัยโดยยังรักษาพฤติกรรมตามตั้งใจ ทั้งคู่ผ่านเกณฑ์ระดับ Critical ด้านความปลอดภัยไซเบอร์ตามกรอบ Preparedness ของ OpenAI เช่นเดียวกับ GPT-6 Astra
ข้อแลกเปลี่ยนคือการปฏิเสธมากขึ้น OpenAI เปิดตัวทั้งสองโมเดลพร้อมมาตรการคุ้มครองที่เข้มขึ้น ซึ่งจำกัดงานวิจัยช่องโหว่และการทดสอบความปลอดภัยที่ชอบด้วยกฎหมายบางส่วน ผู้ป้องกันที่ได้รับอนุญาตยังใช้ GPT-6 Astra และ GPT-6 Cyber ซึ่งเปิดให้ใช้เมื่อสองสัปดาห์ก่อน ผ่าน OpenAI Daybreak
GPT-6.2 Astra และ Sol ทำผลงานในมาตรฐานทดสอบอย่างไร?
GPT-6.2 Astra นำหน้ามาตรฐานงานมืออาชีพและด้านวิทยาศาสตร์ของ OpenAI แต่ Claude Fable 5.2 ยังนำในหลายผลทดสอบด้านโค้ดและการให้เหตุผล
ในตารางต่อไปนี้ คะแนนทั้งหมดเป็นตัวเลขที่ผู้พัฒนารายงานเอง ไฮไลต์คะแนนสูงสุดของแต่ละแถวเป็นตัวหนา
งานมืออาชีพและเวิร์กโฟลว์แบบเอเจนต์
บน Agents' Last Exam v1.1 ซึ่งทดสอบเวิร์กโฟลว์มืออาชีพที่ยาวและหลายขั้นตอน GPT-6.2 Astra ทำได้ 78.3% ที่ $2.89 ต่อภารกิจ GPT-6 Astra ได้ 73.1% ที่ $8.99 ต่อภารกิจ และ Claude Fable 5.2 ได้ 72.8% ที่ $60.05
Gemini 4 Carbon ตามมาติดๆ ที่ 77.4% แต่มีต้นทุน $4.60 ต่อภารกิจ ผลลัพธ์งานมืออาชีพอื่นๆ ก็มีรูปแบบเดียวกัน:
Astra นำทุกแถวในบรรดาโมเดลในตาราง และทำคะแนนดับเบิล Fable 5.2 ในมาตรฐานกฎหมายของ Harvey ส่วน Gemini 4 Carbon ยังเฉือนนำบน AutomationBench ที่ 53.9% และบน GDPval v2 คะแนน 48.8% ของ Carbon อยู่กึ่งกลางระหว่าง Astra กับ Sol
กราฟ GDPval v2 ของ OpenAI แสดงที่มาของการประหยัด: สำหรับจำนวนโทเค็นขาออกเท่าเดิม โมเดลใหม่ทำคะแนนได้สูงกว่ารุ่นก่อน
การเขียนโค้ดและความปลอดภัย
ด้านโค้ดคือจุดที่ Sol ได้คะแนนความคุ้มค่า: บน FrontierCode 2.0 ทำได้ 43.8% ที่ $1.29 ต่อภารกิจ เทียบกับ Astra 44.2% ที่ $5.97
Claude Fable 5.2 ยังคงนำบน FrontierCode 2.0 และ Claude Opus 5.5 ที่ความพยายามสูงสุด (45.5%) ก็ยังเหนือกว่า GPT-6.2 ทั้งสองในมาตรฐานนั้น ส่วนแถวด้านความปลอดภัยสะท้อนการก้าวกระโดดของเจเนอเรชันชัดเจน แม้ OpenAI จะไม่ได้รายงานผลของ Fable 5.2 ในกลุ่มนี้
กราฟ FrontierCode ของ OpenAI เป็นเหตุผลให้เลือก Sol: ที่ความพยายามสูงสุด Sol ไปถึงคะแนนระดับ Astra ด้วยต้นทุนต่อภารกิจราวหนึ่งในห้า
วิทยาศาสตร์ CAD และการให้เหตุผลทั่วไป
บน Terminal-Bench-Science 0.1 ซึ่งทดสอบงานวิทยาศาสตร์ในเทอร์มินัล GPT-6.2 Astra ทำได้ 77.1% สูงกว่า GPT-6 Astra 9 แต้มที่ต้นทุนต่อภารกิจต่ำกว่าหนึ่งในสาม
Fable 5.2 ยังนำบน Intelligence Index และ BenchCAD แต่มีต้นทุน $26.54 และ $50.77 ต่อภารกิจ เทียบกับ Astra ที่ $4.00 และ $5.43 หากต้องการผลลัพธ์ CAD ที่ดีที่สุดแบบสุดจริงๆ Fable ยังเป็นตัวเลือก แต่ถ้าต้องใช้หลายครั้งต่อวัน Astra พาคุณไปได้ 99% ในราคาประมาณหนึ่งในสิบ
บน Terminal-Bench-Science Astra ทำคะแนนสูงสุดที่ $7.15 ต่อภารกิจในโหมดพยายามสูงสุด เทียบกับ $23.80 สำหรับ GPT-6 Astra และ $45.21 สำหรับ Claude Fable 5.2
ควรใช้รุ่นใด?
GPT-6.2 Sol ควรเป็นค่าเริ่มต้น และ GPT-6.2 Astra เป็นรุ่นที่ยกระดับไปใช้เมื่อจำเป็น Sol มีราคาโทเค็นราวหนึ่งในสี่ของ Astra และในงานโค้ดยอมเสียคะแนนไม่ถึงหนึ่งแต้ม
GPT-6.2 Astra ก็ทำสไลด์ยืนยันเหตุผลเดียวกันนี้ไว้ในเด็คของตัวเอง:
สไลด์โดย GPT-6.2 Astra
ทั้งสองโมเดลมีระดับความพยายามด้านเหตุผลให้เลือก 5 ระดับในกราฟของ OpenAI ตั้งแต่ต่ำไปจนถึงสูงสุด และการตั้งค่านี้สำคัญพอๆ กับการเลือกรุ่น บน Agents' Last Exam Sol ที่ความพยายามสูง (72.0% ที่ $0.69 ต่อภารกิจ) ทำคะแนนตามหลัง GPT-6 Astra ที่ความพยายามสูงสุด (73.1% ที่ $8.99) ราวหนึ่งแต้ม ด้วยต้นทุนเพียง 1 ใน 13 โหมด Ultrafast มีให้ใช้ทั้งสองโมเดลใน API และสำหรับผู้สมัคร Pro 500 ใน ChatGPT
ทดสอบ GPT-6.2 Astra: ตัวอย่างลงมือทำ
มาตรฐานทดสอบด้านบนเป็นของ OpenAI เอง จึงได้รันทดสอบ 2 งานกับ GPT-6.2 Astra และรุ่นก่อน GPT-6 Astra ด้วยพรอมป์ต์และเครื่องมือเหมือนกันทุกอย่าง สำหรับการทดสอบแดชบอร์ด ทั้งสองโมเดลรันใน OpenCode ด้วยชุดเครื่องมือปักหมุด (อ่าน ค้นหา และแก้ไขไฟล์เท่านั้น) ความพยายามด้านเหตุผลระดับสูงเหมือนกัน ความพยายามหนึ่งครั้ง และเซสชันใหม่
ทดสอบที่ 1: แดชบอร์ดที่ซื่อตรงจากข้อมูลเละเทะ
งาน: สร้างแดชบอร์ด HTML ไฟล์เดียวจาก CSV รายได้และผลลัพธ์การจ้างงานของ 173 สาขาวิชาเอกในสหรัฐ สำหรับที่ปรึกษาอาชีพที่เปรียบเทียบสาขาให้ลูกค้า ต้องเปรียบเทียบหมวดหมู่ตามรายได้และการจ้างงาน ชูสาขาที่รายได้สูงสุดและต่ำสุด ฝังข้อมูลแทนการดึงจากภายนอก และพอดีกับหน้าจอ 1440×900 หน้าจอเดียว
บททดสอบจริงอยู่ที่ข้อมูล ซึ่งมีปัญหาหลายอย่างที่พรอมป์ต์ไม่ได้บอก:
การทดสอบนี้แตะ 2 ข้ออ้างเปิดตัวพร้อมกัน: เวิร์กบุ๊กเชิงวิเคราะห์ที่ดีกว่าของ Astra และความประหยัดโดยใช้โทเค็นขาออกน้อยลงแต่ได้ผลดีกว่า นี่คือสิ่งที่ GPT-6.2 Astra สร้าง:
ข้อค้นพบหลัก:
มาดูเวอร์ชันของ GPT-6 Astra ใกล้ๆ เทียบกราฟหมวดกับของ GPT-6.2 Astra ด้านบน: Health อยู่ที่อันดับ 4 ในนี้ และอันดับ 10 ในของอีกโมเดล ส่วน Biology & Life Science หล่นจากอันดับ 6 ไป 11
ทั้งสองวิธีไม่ผิดทางคณิตศาสตร์ และ GPT-6.2 Astra ก็ระบุชัดว่ากราฟใช้มัธยฐานของมัธยฐานรายสาขา แต่สำหรับที่ปรึกษาอาชีพ สิ่งที่อยากรู้คือผู้จบ “จริงๆ จบไปแล้วได้เท่าไร” ซึ่งมีเพียงเวอร์ชันที่ถ่วงน้ำหนักด้วยผู้จบเท่านั้นที่ตอบโจทย์
ทดสอบที่ 2: เด็คสไลด์จากสกรีนช็อตเทมเพลต
งาน: แปลงบันทึกการค้นคว้าหลังบทความนี้เป็นเด็ค 5 สไลด์สำหรับผู้จัดการวิศวกรรมที่ต้องตัดสินใจว่าจะสลับใช้หรือไม่ ในสไตล์เทมเพลตสไลด์หนึ่งใบ โมเดลได้รับเทมเพลตเป็นเพียงสกรีนช็อต และพรอมป์ต์ขอให้ “จับคู่ให้ถึงขนาดฟอนต์” โดยไม่ระบุชื่อฟอนต์หรือขนาดใดๆ
เป็นการทดสอบคำอ้างเรื่องสไลด์โดยตรง เนื่องจากต้องดูภาพ จึงรันเป็น API คอลครั้งเดียวผ่าน OpenRouter ที่ระดับความพยายามสูงเท่ากัน และเพิ่ม GPT-6.2 Sol เข้าไปด้วย เพราะเด็คเป็นงานประจำวัน นี่คือเทมเพลตที่เห็น ออกแบบเพื่อการทดสอบ:
ข้อค้นพบหลัก:
สไลด์ทั้ง 5 ของ Astra คือสไลด์ที่มีคำบรรยายซึ่งคุณเห็นในบทความนี้ และตัวเลขทุกตัวตรงกับบันทึกของเรา เด็คของ GPT-6 Astra ก็ใช้งานได้พอๆ กัน ดังนั้นในงานนี้ทั้งสองเจเนอเรชันไม่แตกต่างกันชัด
แล้ว GPT-6.2 Astra คือการยกระดับจริงหรือไม่? ด้านต้นทุน ใช่: ปิดงานทั้งสองด้วยราคาต่ำกว่าราว 39% ถึง 63% สอดคล้องกับคำอ้างเรื่องประสิทธิภาพ ด้านวิจารณญาณ ยังไม่เต็มที่: รุ่นเก่าถ่วงน้ำหนักข้อมูลได้ตรงความต้องการของที่ปรึกษาอาชีพมากกว่า ส่วนสไลด์ออกมาพอๆ กัน
การรันงานละหนึ่งครั้งยังไม่พอจะจัดอันดับสองโมเดล แต่สอดคล้องกับข้อค้นพบ Blocker Deception ของ OpenAI เอง: ควรตรวจว่า GPT-6.2 Astra “เว้นอะไรไว้” ไม่ใช่แค่สิ่งที่ “สร้างได้”
ราคาและการพร้อมใช้งานของ GPT-6.2 Astra และ Sol
GPT-6.2 Astra ถูกกว่า GPT-6 Astra 20% สำหรับโทเค็นขาเข้าและขาออก และถูกกว่าขาเข้าที่แคชไว้ 60% ขณะที่ GPT-6.2 Sol รักษาราคาเท่ากับ GPT-6.1 Sol อัตรามาตรฐานผ่าน API ต่อหนึ่งล้านโทเค็น:
ราคาที่ต่ำลงเป็นเพียงส่วนหนึ่งของการประหยัด เพราะทั้งสองโมเดลใช้โทเค็นขาออกน้อยลง ต้นทุนต่อภารกิจจึงลดลงอีก ซึ่งเป็นเหตุผลที่งาน Agents' Last Exam ของ Astra ถูกกว่าหนึ่งในสามของ GPT-6 Astra นอกจากนี้ OpenAI แนะนำให้คงพรีฟิกซ์ของพรอมป์ต์ไว้เดิมแล้วเติมคำสั่งใหม่ต่อท้าย เพื่อให้แคชถูกใช้บ่อยขึ้นและคงการให้เหตุผลข้ามรอบ
สรุปราคาชุดใหม่โดย Astra เอง:
สไลด์โดย GPT-6.2 Astra
ใน ChatGPT ทั้งสองโมเดลพร้อมใช้สำหรับผู้ใช้ Plus, Pro, Enterprise และ Edu ใน ChatGPT Work และ Codex ตั้งแต่วันเปิดตัว ผู้ใช้ Enterprise และ Edu เข้าถึงได้เมื่อตัวแอดมินเปิดใช้งานในเวิร์กสเปซ
โหมด Ultrafast ใช้ได้กับทั้งสองโมเดลสำหรับสมาชิก Pro 500 และ Pro 200 ก็ได้ใช้เป็นครั้งแรก เริ่มจาก GPT-6.2 Sol ประกาศของ OpenAI ไม่ได้กล่าวถึงแผน Free
จะเข้าถึง GPT-6.2 Astra และ Sol ได้อย่างไร?
ทั้งสองโมเดลเปิดให้ใช้ทั่วไปใน OpenAI API ภายใต้ชื่อ
gpt-6.2-astraและgpt-6.2-solโดย Ultrafast ใช้ได้ตั้งแต่เปิดตัว คำขอแบบมินิมอลด้วย OpenAI Python SDK มีหน้าตาแบบนี้:ทั้งสองโมเดลยังมีรายชื่อบน OpenRouter (
openai/gpt-6.2-astraและopenai/gpt-6.2-sol) และในแคตตาล็อกโมเดลของ OpenCodeสำหรับงานสร้างเต็มรูปแบบกับรุ่นก่อนหน้า ดู บทเรียน API ของ GPT-6 Astra และ บทเรียน GPT-6.1 Sol; การสลับรหัสโมเดลคือการเปลี่ยนหลัก
บทสรุป
GPT-6.2 คือการลดราคาที่ OpenAI เปลี่ยนให้กลายเป็นการปล่อยความสามารถ Astra ชนะ GPT-6 Astra ในทุกมาตรฐานงานมืออาชีพที่ OpenAI รายงาน ที่ต้นทุนต่อภารกิจเพียงหนึ่งในสาม และ Sol ใกล้เคียงพอในงานโค้ดจนส่วนใหญ่ควรเริ่มจากรุ่นนี้
แต่ยังไม่ปิดเกมทั้งหมด Claude Fable 5.2 ยังนำบน FrontierCode และ Intelligence Index Gemini 4 Carbon นำบน AutomationBench และในการทดสอบของเรา Astra รุ่นเก่าอ่านชุดข้อมูลที่เละเทะได้สมเหตุสมผลกว่า อย่างไรก็ดี แนะนำให้สลับจาก GPT-6 Astra ตั้งแต่วันนี้เพื่อประหยัดต้นทุน
สไลด์โดย GPT-6.2 Astra
หากสนใจเรียนรู้การพัฒนาด้วยโมเดลของ OpenAI มากขึ้น แนะนำคอร์ส Working with the OpenAI API ของเรา